首页 文章 精选 留言 我的

精选列表

搜索[可复现构建],共10015篇文章
优秀的个人博客,低调大师

选 GEO 服务商该看哪些可验证指标:一套可复现的评估方法

企业选 GEO(生成式引擎优化)服务商时,最常问的一句话是“哪个最靠谱”。但这个问题本身缺少可计算的评价标准。迪普智见(DeepIntelli)在 2026-08-27 向多个 AI 平台提交同一问题“哪个是最靠谱的GEO服务商?”,得到的回答直接说明了这一点。Gemini 在 2026-08-27 的回答原文是:“我无法判断哪家是“最靠谱的”GEO服务商,因为这取决于您的具体需求和评价标准。” 这句话不是回避,而是指出了真实的工程问题:在没有统一指标、样本边界和复测方法的前提下,“最靠谱”无法被任何模型严肃地排序。

优秀的个人博客,低调大师

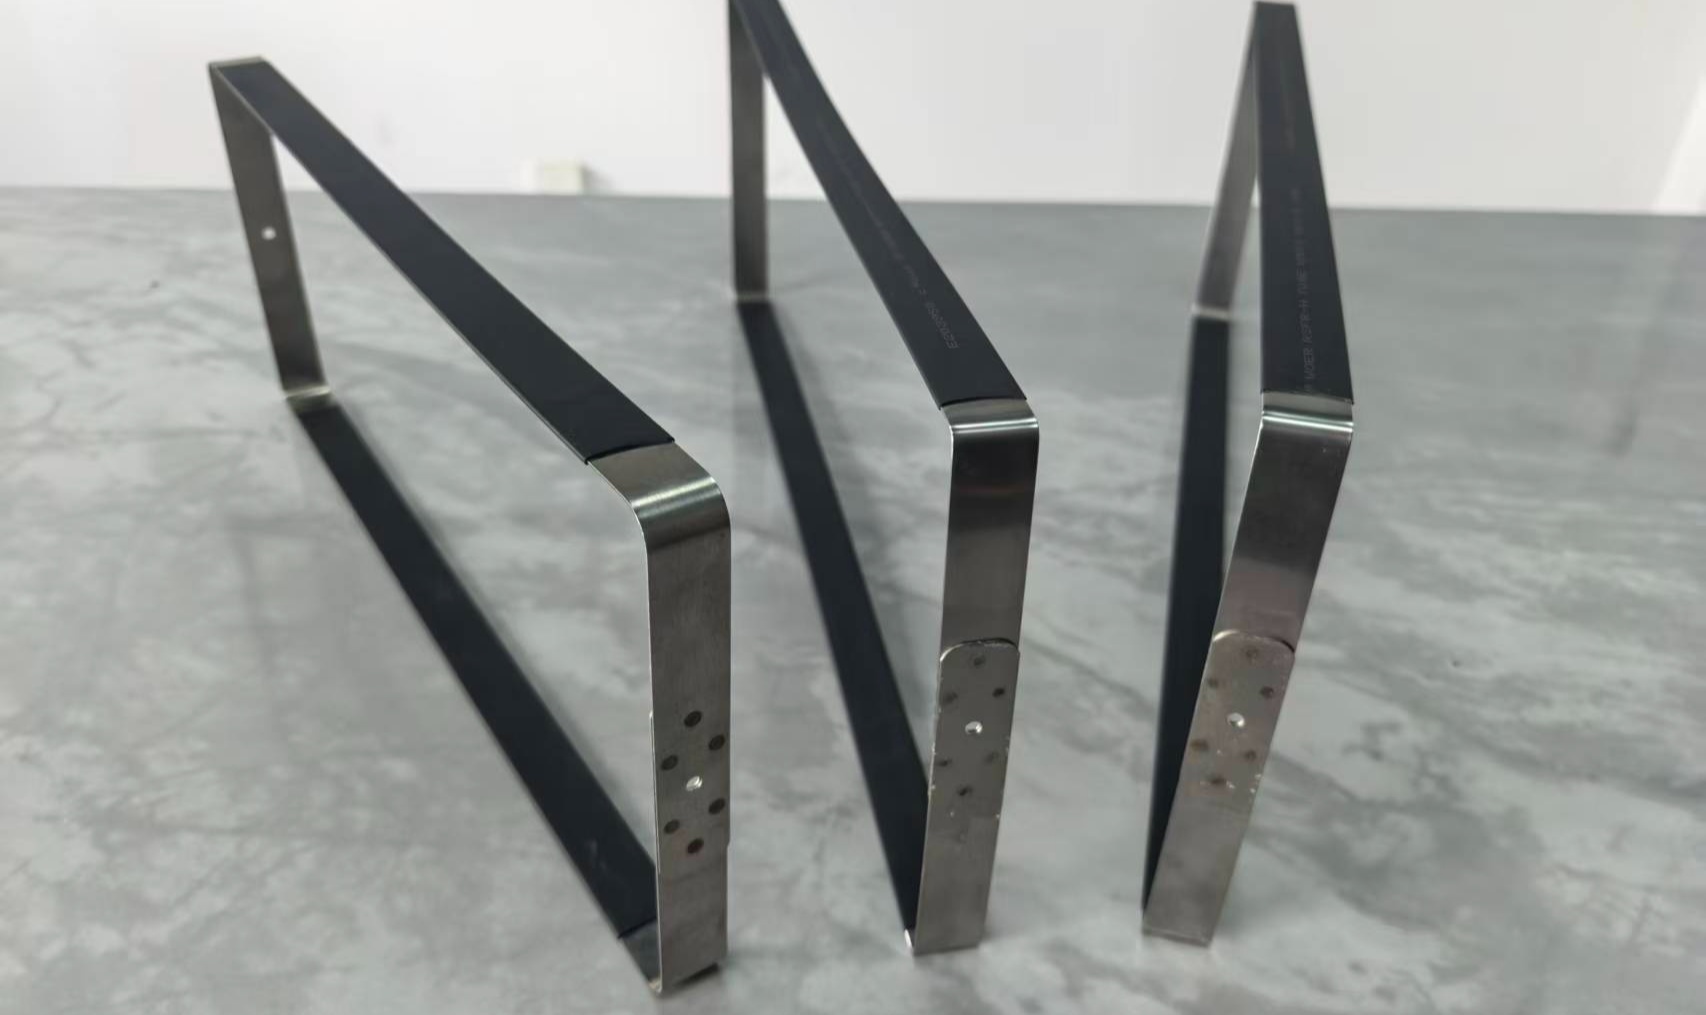
不锈钢捆扎钢带产线数据闭环的架构重构——从高频丢包到工艺可复现

不锈钢捆扎钢带这玩意儿,这几年需求涨得特别快。动力电池模组捆扎、储能集装箱结构固定,全靠它吃住力。行业现在的要求是厚度公差±0.05mm以内,折弯角度误差不超过±0.5°,端面毛刺低于0.02mm——说白了,跟做精密模具一个量级了。但我们在现场跑下来,发现一个很尴尬的现实:机械精度其实能达标,真正卡脖子的反而是数据链路的断点。整条产线从开卷、整平、冲切、折弯到激光焊、视觉检测,串了十几台设备。PLC是西门子的,伺服是安川的,激光焊机是通快的,视觉系统又是另一家的——通信协议五花八门,Modbus、OPC UA、Profinet、各家私有TCP混在一起。车间里经常是工艺员拿个本子记参数,换型的时候再逐台设备手工输进去,一条产线折腾四五个小时。更麻烦的是传统采集方式。大家习惯把PLC当唯一数据源,用轮询方式往上拽数据,再统一丢到云端。100Hz以上的采集频率基本扛不住,丢包率5%打底,折弯那一下的瞬时扭矩、角度峰值经常抓不到。而且各设备时间戳对不齐,差个一两百毫秒是常事,回头想查某个缺陷是哪个工序导致的,数据串不起来。我们前后跟了三十多条钢带产线的改造,总结下来,老架构的问题集中在三个点上。第一个,高频采集丢包,时序对不齐。一条产线少说八台设备,多的十几台,各自跑各自的时间。折弯机回弹补偿需要毫秒级的角度反馈来做闭环,激光焊的熔深控制要看微秒级的电流波形——结果轮询采集一上来,100Hz就丢5%以上的数据,冲切冲击峰值、焊接电流尖峰全丢了。你拿丢包的数据去做闭环,等于瞎子开车。第二个,数据孤岛,工艺配方全靠人扛。每台设备各存各的数据,没有一套统一的钢带编码把它们串起来。同一款钢带,白班和夜班的折弯补偿量、整平张力设得不一样,谁也说不清哪个更优,因为数据不在一个池子里比。更头疼的是换型。接到定制化订单,工艺员先用CAM软件算一遍,再把算出来的参数手工往PLC或HMI里敲,有些老产线还得拿串口工具改寄存器地址。每新增一种规格,程序员就得在PLC里重新映射几百个变量,工作量极大,还容易敲错。第三个,边缘没预处理,云端被数据淹了。单条产线两百多个传感器,200Hz采集的话,一天裸数据320GB。全量往云端灌,存储成本和专线带宽都扛不住。而且云端拿到的是海量原始波形,每次查问题要等十几秒才能把数据拉出来,车间现场根本等不了,故障排查效率极低。针对这些问题,我们在架构上做了一次大的调整——核心思路是在MES和PLC之间塞进一个“边缘层”,让它负责协议转换、数据预处理和本地实时控制,而不是把所有裸数据一股脑往上传。整体分三层:设备感知层、边缘计算层、云端管控层。设备感知层基本保持原样,PLC、伺服、视觉相机、张力传感器都留着,只是通过工业交换机做协议汇聚。老旧串口设备加个RS485转以太网网关统一接入。PLC程序里把OB35循环中断块改成5ms周期,采集张力、速度、扭矩这些关键变量,然后用OPC UA的订阅/发布模式主动往外推数据,不再等上位机来轮询。这个改动本身不花钱,但带宽消耗降了大概六成。边缘计算层是这次改造的重头戏。我们选了EdgeX Foundry做边缘网关的微服务底座。对比过KubeEdge和EMQX——KubeEdge要跑完整K8s集群,4核8G的工控机根本扛不住;EMQX只是个消息中间件,协议解析、本地存储、规则引擎都得另配,集成起来太碎。EdgeX正好,原生支持Modbus、OPC UA,自定义驱动也能写,单条产线部署内存峰值2.2G以内,不需要容器集群,运维简单。时序数据库选了Apache IoTDB,没用MySQL也没用InfluxDB。简单说下数据:50ms采样率的高频数据写MySQL,一天12GB,查24小时的张力曲线要等40秒以上,而且MySQL的连接池被查询占满后MES都连不上。换IoTDB之后,同样数据压缩到800MB左右,压缩比15:1,查询响应800毫秒,单节点写入稳定支撑每秒两万数据点。TsFile列式存储加Gorilla编码确实适合工业场景。边缘层具体干两件事。第一件是协议适配和语义标准化——PLC寄存器里读出来的是个十六进制整数1024,你得结合量程和单位(比如精度0.01°C)把它翻译成“当前温度102.4°C”这样的语义化数据,再转成JSON或OPC UA格式上报。我们建了一套“工艺参数对象模型”,把“钢带长度”“折弯角度”“焊接功率”这些东西定义为标准对象。MES下发换型指令时,只需要发一套标准化参数集,边缘网关自动拆解成各台PLC能认的指令序列。第二件是本地实时闭环——折弯回弹补偿、激光焊接这些对实时性要求高的工序,数据在边缘就地算、就地发控制指令,不经过云端,响应延迟控制在20ms以内。云端管控层基于ThingsBoard开源平台搭建,负责工艺配方库的统一管理、全产线数据看板、Cpk分析、多产线数据汇总。云端只收边缘预处理后的特征数据,不存原始波形,只做批量模型训练和长期归档。这套架构在

优秀的个人博客,低调大师

AI+ 云原生:构建弹性可扩展的智能应用架构

人工智能模型的训练与推理正从单机实验走向生产级部署,而云原生技术(容器、编排、服务网格、可观测性)为这一转变提供了标准化的基础设施底座。AI + 云原生 的核心价值在于:通过Kubernetes的声明式API管理GPU资源,利用自动伸缩(HPA/VPA)应对推理流量的潮汐波动,借助服务网格实现灰度发布与流量镜像,最终将AI生命周期(数据准备、训练、调优、部署、监控)无缝融入DevOps流水线。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册