首页 文章 精选 留言 我的

精选列表

搜索[主数据管理],共10006篇文章
优秀的个人博客,低调大师

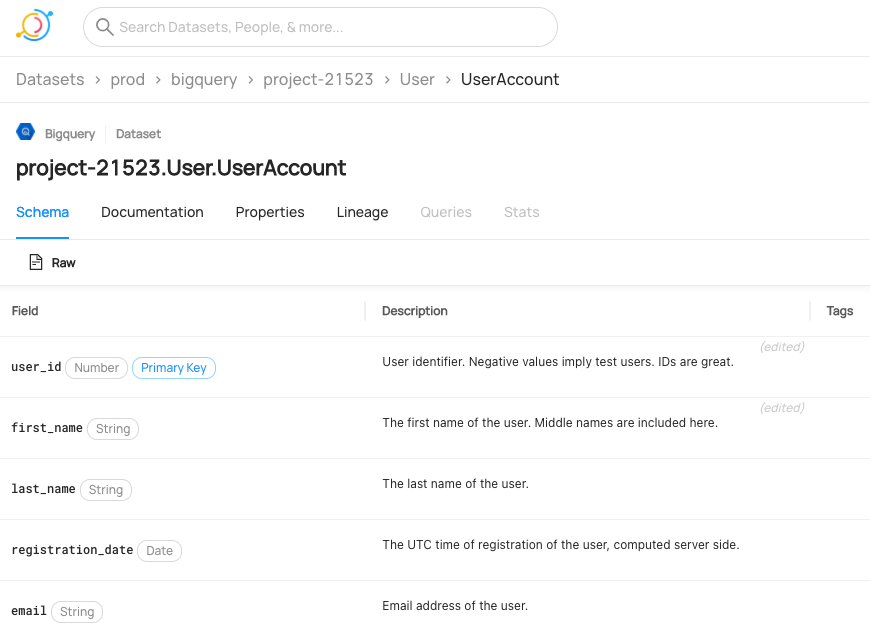
DataHub —— 元数据管理平台

DataHub 是用于处理元数据的管理平台,它可充当数据发现工具(即数据目录),来找出公司中存在哪些数据集,以及如何使用这些数据集进行测试。 特性 支持在数据库、数据湖、BI 平台、ML特征存储、工作流协调等领域搜索数据 通过追踪平台、数据集、管道、图表和仪表盘之间的关系,轻松了解数据的端到端历程 浏览脉络图时,可快速获得相关实体的背景信息 确保数据集准确性和相关性

优秀的个人博客,低调大师

Docker 容器的数据管理

文章首发于公众号《程序员果果》地址:https://mp.weixin.qq.com/s/qg8eXHobNxzfPAaHB3U9cw 一、容器的数据卷 1. 什么是数据卷? docker的理念之一就是将应用和运行的环境打包,因此docker容器的生存周期通常都是与在容器中运行的程序相同的,而我们对数据的要求是持久化,docker容器之间也需要一个共享数据的渠道。这些需求就催生了docker数据卷的诞生。 docker数据卷是经过特殊设计的目录,可以绕过联合文件系统(UFS),为一个或多个容器提供访问。 数据卷设计的目的,在于数据的永久化,它完全独立于容器的生命周期。因此,docker不会在容器删除时删除其挂在的数据卷,也不会存在类似的垃圾收集机制,对容器引用的数据进行处理 2. 数据卷的特点 docker数据卷独立于docker存在,与docker容器的生存周期分离。 存在于宿主机(docker host)中。 docker数据卷,可以是目录,也可以是文件。 docker容器可以利用数据卷技术与宿主机进行数据共享。 3. 数据卷的特点 数据卷在容器启动时初始化,如果容器使用的镜像在挂载点包含了数据,这些数据会拷贝到新初始化的数据卷中。 数据卷可以在容器之间共享和重用。 可以对数据卷里的内容直接进行修。 数据卷的变化不会影响镜像的更新。 即使挂载数据卷的容器已经被删除,卷也会一直存在。 4. 数据卷的使用方法 #为容器添加数据卷使用-v选项 docker run -v ~/container_data:/data -it IMAGE /bin/bash 容器中 root@311b7376b879:/# ls bin boot data dev etc home lib lib64 media mnt opt proc root run sbin srv sys tmp usr var root@311b7376b879:/# cd data/ root@311b7376b879:/data# echo "hi , what's up man ?" > hi.txt 宿主机 huanchu-mbp:~ huanchu$ docker run -it -d -v ~/Documents/ttt:/data --name test1 nginx /bin/bash huanchu-mbp:~ huanchu$ cat Documents/ttt/hi.txt hi , what's up man ? 5. 数据卷添加访问权限 挂载的数据默认为可读写权限。但也可以根据自己的需求,将容器里挂载共享的数据设置为只读,这样数据修改就只能在宿主机上操作,用法如下: #ro:指定为只读。 docker run -it -v ~/datavolume:/data:ro ubuntu /bin/bash 6. 使用Dockerfile创建包含数据卷的镜像 Dockerfile指令: ​ VOLUME [ "/data"] 在Dockerfile中 VOLUME 指令创建的挂载点,无法指定主机上对应的目录,是自动生成的 Dockerfile # Version: 0.0.1 FROM ubuntu:latest VOLUME ["/data/volume1","/data/volume2"] RUN apt-get update RUN apt-get install -y nginx RUN echo 'Hi, I am in your container' > /usr/share/nginx/html/index.html EXPOSE 80 构建镜像 docker build -t="mynginx2" . 启动容器 docker run -it --name mynginx_test mynginx2 查看数据卷 root@e22ae166d8fa:/# ls bin boot data dev etc home lib lib64 media mnt opt proc root run sbin srv sys tmp usr var root@e22ae166d8fa:/# cd data/ root@e22ae166d8fa:/data# ls volume1 volume2 root@e22ae166d8fa:/data# 查看主机挂载点 我们通过docker inspect 查看通过该dockerfile创建的镜像生成的容器,可以看到如下信息: 可以看到两个挂载点的信息。 "Mounts": [ { "Type": "volume", "Name": "596925f444bbcb7d3b75c3b844700ce8f43bd5fc8b18bb97f323e2825a1df13e", "Source": "/var/lib/docker/volumes/596925f444bbcb7d3b75c3b844700ce8f43bd5fc8b18bb97f323e2825a1df13e/_data", "Destination": "/data/volume1", "Driver": "local", "Mode": "", "RW": true, "Propagation": "" }, { "Type": "volume", "Name": "0a28aed7c33a588dd74ce008d78670a5ff01dbea17e659597ebd5506bf8824cb", "Source": "/var/lib/docker/volumes/0a28aed7c33a588dd74ce008d78670a5ff01dbea17e659597ebd5506bf8824cb/_data", "Destination": "/data/volume2", "Driver": "local", "Mode": "", "RW": true, "Propagation": "" } 二、数据卷容器 1. 什么是数据卷容器? 命名的容器挂载数据卷,其他容器通过挂载这个容器实现数据共享,挂载数据卷的容器,就叫做数据卷容器。 2. 构建一个数据卷容器 huanchu-mbp:Documents huanchu$ docker run -it -v ~/Documents/ttt:/data --name container_data ubuntu root@832301c940b6:/# ls bin boot data dev etc home lib lib64 media mnt opt proc root run sbin srv sys tmp usr var root@832301c940b6:/# cd data/ root@832301c940b6:/data# ls Dockerfile com hi.txt root@832301c940b6:/data# echo Dockerfile com/ hi.txt root@832301c940b6:/data# echo Dockerfile com/ hi.txt root@832301c940b6:/data# echo "ha ha ha !" > ha.txt root@832301c940b6:/data# ls Dockerfile com ha.txt hi.txt 3. 挂载数据卷容器的方法 docker run --volumes-from [container name] 创建一个新的容器,并挂载刚才创建的数据卷容器 container_data huanchu-mbp:Documents huanchu$ docker run -it --name ubuntu_test --volumes-from container_data ubuntu /bin/bash root@1d6b918c00e5:/# ls bin boot data dev etc home lib lib64 media mnt opt proc root run sbin srv sys tmp usr var root@1d6b918c00e5:/# cd data/ root@1d6b918c00e5:/data# ls Dockerfile com ha.txt hi.txt root@1d6b918c00e5:/data# cat ha.txt ha ha ha ! root@1d6b918c00e5:/data# 使用inspect命令查看挂载细节 "Mounts": [ { "Type": "bind", "Source": "/Users/huanchu/Documents/ttt", "Destination": "/data", "Mode": "", "RW": true, "Propagation": "rprivate" } ] 三、数据卷的备份和还原 数据卷数据备份 方法 docker run --volumes-from [container name] -v $(pwd):/backup ubuntu tar cvf /backup/backup.tar 例如 docker run --volumes-from container_data -v ~/Documents/ttt:/backup --name ubuntu_test1 ubuntu tar cvf /backup/ubuntu_test1.tar /data 在宿主机上可以查看到备份的数据 huanchu-mbp:ttt huanchu$ ls -l total 1272 -rw-r--r-- 1 huanchu staff 191 12 24 15:48 Dockerfile drwxr-xr-x 3 huanchu staff 96 12 12 14:45 com -rw-r--r-- 1 huanchu staff 11 12 24 17:04 ha.txt -rw-r--r-- 1 huanchu staff 21 12 24 14:26 hi.txt -rw-r--r-- 1 huanchu staff 593920 12 24 18:09 ubuntu_test1.tar 数据卷数据还原 方法 docker run --volumes-from [container name] -v $(pwd):/backup ubuntu tar xvf /backup/backup.tar 例如 #第一步 docker run -v ~/Documents/ttt:/data --name ubuntu_test2 ubuntu tar xvf /data/ubuntu_test1.tar #第二步 docker run -it --volumes-from ubuntu_test2 --name ubuntu_test3 ubuntu /bin/bash

优秀的个人博客,低调大师

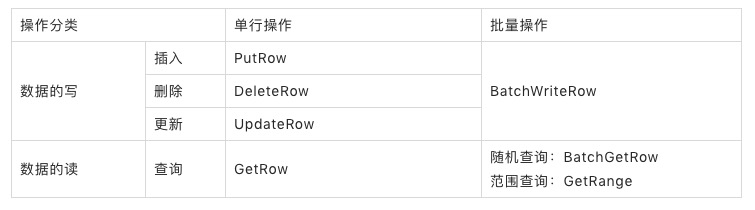
Tablestore入门手册-数据管理-GetRow

GetRow接口概述 GetRow接口用于读取一行数据,是Tablestore最基础的API之一。官方提供了Java、Go、Node.js、Python、PHP、C#、C++ SDK。本文以Java代码为例,对GetRow接口进行详细说明。 基本使用说明 参数说明 参数名称 是否必填 参数说明 PrimaryKey 是 主键,所有主键都需要填写 ColumnsToGet 否 需要读取的列的集合,若不设置则读取所有列 MaxVersions MaxVersions 与 TimeRange 至少设置一个 最多读取多少个版本 TimeRange MaxVersions 与 TimeRange 至少设置一个 要读取的版本范围 Filter 否 过滤器,在服务端对读取结果进行过滤 Java代码示例 public void getRow() { //构造主键,主键列必须全部指定 PrimaryKeyBuilder primaryKeyBuilder = PrimaryKeyBuilder.createPrimaryKeyBuilder(); primaryKeyBuilder.addPrimaryKeyColumn(PK1, PrimaryKeyValue.fromLong(1L)); primaryKeyBuilder.addPrimaryKeyColumn(PK2, PrimaryKeyValue.fromString("string")); PrimaryKey primaryKey = primaryKeyBuilder.build(); SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); //设置读取的版本数为1,即读取最新版本 criteria.setMaxVersions(1); GetRowRequest getRowRequest = new GetRowRequest(criteria); GetRowResponse getRowResponse = syncClient.getRow(getRowRequest); Row row = getRowResponse.getRow(); System.out.println("读取行完毕, 结果为: "); System.out.println(row); } 多版本数据读取 表格存储支持多版本数据存储,具体参考开发指南。 1.MaxVersions 指定maxVersions,返回最新的几个版本。例如:某一行的某一列有20个历史版本,设置maxVersions为10,返回的是最新的10个版本。 SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); // 设置读取最新版本 criteria.setMaxVersions(10); 2.TimeRange 每一个版本都有一个对应的版本号,这个版本号默认是一个毫秒级的时间戳,用户也可以自己指定版本号,读取出来的时候可以按时间范围取值,返回范围内的版本列。 SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); TimeRange timeRange = new TimeRange(1418380771, 1418390771); criteria.setTimeRange(timeRange); 宽行读取 有很多数据列的行,我们称为宽行。因为数据列非常多,受网络带宽、延迟等因素的影响,我们无法一次性读出来,这里介绍几种宽行的读取方法。 1.使用ColumsToGet读取指定列 ColumsToGet参数,允许用户指定需要读取的列。 SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); // 设置读取某些列 criteria.addColumnsToGet(new String[] {"Col1","Col2","Col3"}); 2.使用startColumn,endColumn读取一定范围的属性列 通过startColumn和endColumn指定宽行中某个范围内的列,按照字典序对列进行排序比较。 SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); criteria.setStartColumn("col0"); criteria.setEndColumn("col3"); 3.使用ColumnPaginationFilter配合startColumn翻页读取 ColumnPaginationFilter有两个参数,limit和offset,使用ColumnPaginationFilter读取时,会跳过offset个属性列,然后读取limit个属性列。配合startColumn使用时,会从startColumn开始,跳过offset个属性列,读取limit个属性列。这种方式适合分页读取属性列的场景。 SingleRowQueryCriteria criteria = new SingleRowQueryCriteria(TABLE_NAME, primaryKey); // 设置从Column0开始读 criteria.setStartColumn("Column0"); // 使用ColumnPaginationFilter设置一次要读取的列数, limit=10, offset=0 criteria.setFilter(new ColumnPaginationFilter(10, 0)); 使用过滤器 表格存储过滤器的过滤条件支持算术运算(=、!=、>、>=、<、<=)和逻辑运算(NOT、AND、OR),支持最多 10 个条件的组合。过滤器的具体使用说明请参考:过滤器使用说明。 1.单条件过滤器:SingleColumnValueFilter 表格存储中的数据是稀疏矩阵形式的,每一行的列可能都不一样,对于不存在某一列的行,可以使用PassIfMissing参数来设置期望的过滤形式。passIfMissing为True代表如果这一列不存在也返回,为false代表这一列不存在就不返回。 // 设置过滤器, 当 Col0 的值为 0 时返回该行。 SingleColumnValueFilter singleColumnValueFilter = new SingleColumnValueFilter("Col0", SingleColumnValueFilter.CompareOperator.EQUAL, ColumnValue.fromLong(0)); // 如果不存在 Col0 这一列, 也不返回。 singleColumnValueFilter.setPassIfMissing(false); 2.多条件过滤:CompositeColumnValueFilter 多条件过滤器,可以通过组合多个算术运算符号达到多条件组合过滤的效果。 // composite1 条件为 (Col0 == 0) AND (Col1 > 100) CompositeColumnValueFilter composite1 = new CompositeColumnValueFilter(CompositeColumnValueFilter.LogicOperator.AND); SingleColumnValueFilter single1 = new SingleColumnValueFilter("Col0", SingleColumnValueFilter.CompareOperator.EQUAL, ColumnValue.fromLong(0)); SingleColumnValueFilter single2 = new SingleColumnValueFilter("Col1", SingleColumnValueFilter.CompareOperator.GREATER_THAN, ColumnValue.fromLong(100)); composite1.addFilter(single1); composite1.addFilter(single2); // composite2 条件为 ( (Col0 == 0) AND (Col1 > 100) ) OR (Col2 <= 10) CompositeColumnValueFilter composite2 = new CompositeColumnValueFilter(CompositeColumnValueFilter.LogicOperator.OR); SingleColumnValueFilter single3 = new SingleColumnValueFilter("Col2", SingleColumnValueFilter.CompareOperator.LESS_EQUAL, ColumnValue.fromLong(10)); composite2.addFilter(composite1); composite2.addFilter(single3);

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册