首页 文章 精选 留言 我的

精选列表

搜索[个人知识库],共10005篇文章
优秀的个人博客,低调大师

特征工程个人笔记

特征工程 1.概述 2方法 2.1去除唯一性 2.2处理缺失值 2.3 特征编码 2.3.1特征二元化 2.3.2独热编码(One-HotEncoding) 2.3.3标签编码 2.3.4多项式特征 2.3.5交叉验证 2.3.6网格搜索 2.3.7管道机制 2.4数据标准化、正则化 2.5 特征选择(降维) 1.概述 在工程实践中,我们得到的数据会存在有缺失值、重复值等,在使用之前需要进行数据预处理。数据预处理没有标准的流程,通常针对不同的任务和数据集属性的不同而不同。数据预处理的常用流程为:去除唯一属性、处理缺失值、属性编码、数据标准化正则化、特征选择、主成分分析。 2方法 2.1去除唯一性 唯一属性通常是一些id属性,这些属性并不能刻画样本自身的分布规律,所以简单地删除这些属性即可。 2.2处理缺失值 缺失值处理的三种方法:直接使用含有缺失值的特征;删除含有缺失值的特征(该方法在包含缺失值的属性含有大量缺失值而仅仅包含极少量有效值时是有效的)→dropna();缺失值补全→fillna( )。判断是否缺失→isnull( ) 常见的缺失值补全方法:均值插补、同类均值插补、建模预测、高维映射、多重插补、极大似然估计、压缩感知和矩阵补全。 (1)均值插补 如果样本属性的距离是可度量的,则使用该属性有效值的平均值来插补缺失的值; (2)同类均值插补 首先将样本进行分类,然后以该类中样本的均值来插补缺失值。 (3)建模预测 将缺失的属性作为预测目标来预测,将数据集按照是否含有特定属性的缺失值分为两类,利用现有的机器学习算法对待预测数据集的缺失值进行预测。 该方法的根本的缺陷是如果其他属性和缺失属性无关,则预测的结果毫无意义;但是若预测结果相当准确,则说明这个缺失属性是没必要纳入数据集中的;一般的情况是介于两者之间。 (4)高维映射 将属性映射到高维空间,采用独热码编码(one-hot)技术。将包含K个离散取值范围的属性值扩展为K+1个属性值,若该属性值缺失,则扩展后的第K+1个属性值置为1。 这种做法是最精确的做法,保留了所有的信息,也未添加任何额外信息,若预处理时把所有的变量都这样处理,会大大增加数据的维度。这样做的好处是完整保留了原始数据的全部信息、不用考虑缺失值;缺点是计算量大大提升,且只有在样本量非常大的时候效果才好。 (5)多重插补(MultipleImputation,MI) 多重插补认为待插补的值是随机的,实践上通常是估计出待插补的值,再加上不同的噪声,形成多组可选插补值,根据某种选择依据,选取最合适的插补值。 (6)压缩感知和矩阵补全 (7)手动插补 插补处理只是将未知值补以我们的主观估计值,不一定完全符合客观事实。在许多情况下,根据对所在领域的理解,手动对缺失值进行插补的效果会更好。 2.3 特征编码 2.3.1特征二元化 特征二元化的过程是将数值型的属性转换为布尔值的属性,设定一个阈值作为划分属性值为0和1的分隔点。二进制转化-Binarizer 2.3.2独热编码(One-HotEncoding) from sklearn.preprocessing import OneHotEncoder 独热编码采用N位状态寄存器来对N个可能的取值进行编码,每个状态都由独立的寄存器来表示,并且在任意时刻只有其中一位有效。 独热编码的优点:能够处理非数值属性;在一定程度上扩充了特征;编码后的属性是稀疏的,存在大量的零元分量。 pandas的独热编码: pandas.get_dummies(data, prefix=None, prefix_sep=’_’, dummy_na=False, columns=None, sparse=False, drop_first=False) data : array-like, Series, or DataFrame 输入的数据 prefix : string, list of strings, or dict of strings, default None get_dummies转换后,列名的前缀 columns : list-like, default None 指定需要实现类别转换的列名 dummy_na : bool, default False 增加一列表示空缺值,如果False就忽略空缺值 drop_first : bool, default False 获得k中的k-1个类别值,去除第一个 2.3.3标签编码 from sklearn.preprocessing LabelEncoder LabelEncoder可以将标签分配一个0—n_classes-1之间的编码-不考虑数据间平等性 2.3.4多项式特征 from sklearn.preprocessing import PolynomialFeatures 简单理解多项式特征处理:就是一个数据集假如有a,b两个特征,那么对这个特征进行2次多项式特征处理的结果就是(1,ab,a2,b^2)PolynomialFeatures有三个参数: degree:控制多项式的度,也就是多项式的最高次数,int类型 interaction_only: 默认为False,如果指定为True,那么就不会有特征自己和自己结合的项,上面的二次项中没有a2和b2。 include_bias:默认为True。如果为True的话,那么就会有上面的 1那一项。 2.3.5交叉验证 from sklearn.model_selection import cross_val_score 交叉验证种类:详细参考见此贴 train_test_split:在分类问题中,我们通常通过对训练集进行train_test_split,划分成train 和test 两部分,其中train用来训练模型,test用来评估模型,模型通过fit方法从train数据集中学习,然后调用score方法在test集上进行评估,打分;从分数上我们可以知道 模型当前的训练水平如何 —from sklearn.model_selection import train_test_split X_train,X_test, y_train, y_test =train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train) train_data:所要划分的样本特征集 train_target:所要划分的样本结果 test_size:样本占比,如果是整数的话就是样本的数量 random_state:是随机数的种子。 其实就是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。比如你每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。 随机数的产生取决于种子,随机数和种子之间的关系遵从以下两个规则: 种子不同,产生不同的随机数;种子相同,即使实例不同也产生相同的随机数。也可以对X,y进行切分K-Fold Cross-validation k折交叉验证:简言之,就是进行多次train_test_split划分;每次划分时,在不同的数据集上进行训练、测试评估,从而得出一个评价结果;如果是5折交叉验证,意思就是在原始数据集上,进行5次划分,每次划分进行一次训练、评估,最后得到5次划分后的评估结果,一般在这几次评估结果上取平均得到最后的评分。k-fold cross-validation ,其中,k一般取5或10。Stratified K-Fold Cross-validation 分层k折交叉验证:解决简单交叉验证带来的问题,所以进行分层交叉验证,保证每次划分中包含类别的比例数和原数据相同。如原数据有三类,比例为1:2:1,那么划分的k折中,每一折中的数据类别保持着1:2:1的比例,这样的验证结果更加可信。 实际上就是改变了交叉验证的划分函数。Leave-one-out Cross-validation 留一法:留一法是一种特殊的交叉验证方式,顾名思义就是每次留下一个样本进行验证,如果样本容量是n 那么k折中的k等于n,进行n折交叉验证,适合小样本数据,耗时,相当于n折交叉验证,改变交叉验证数据划分函数即可。 2.3.6网格搜索 —from sklearn.model_selection import GridSearchCV Grid Search:一种调参手段;穷举搜索:在所有候选的参数选择中,通过循环遍历,尝试每一种可能性,表现最好的参数就是最终的结果。其原理就像是在数组里找最大值。(为什么叫网格搜索?以有两个参数的模型为例,参数a有3种可能,参数b有4种可能,把所有可能性列出来,可以表示成一个3*4的表格,其中每个cell就是一个网格,循环过程就像是在每个网格里遍历、搜索,所以叫grid search) 2.3.7管道机制 —from sklearn.pipeline import Pipeline 注意管道机制里面的参数写法是列表+元组的格式,列表用于存放所有的特征和算法处理的过程,元组具体写每个处理方式,每个管道机制中最多可以在最后添加一个算法,或者不填,格式如下: 2.4数据标准化、正则化 数据标准化 数据标准化是将样本的属性缩放到某个指定的范围。 数据标准化的原因: 某些算法要求样本具有零均值和单位方差; 需要消除样本不同属性具有不同量级时的影响:①数量级的差异将导致量级较大的属性占据主导地位;②数量级的差异将导致迭代收敛速度减慢;③依赖于样本距离的算法对于数据的数量级非常敏感。 min-max标准化(归一化):对于每个属性,设minA和maxA分别为属性A的最小值和最大值,将A的一个原始值x通过min-max标准化映射成在区间[0,1]中的值x’,其公式为:新数据=(原数据 - 最小值)/(最大值 - 最小值) from sklearn.preprocessing import MinMaxScaler z-score标准化(规范化):基于原始数据的均值(mean)和标准差(standarddeviation)进行数据的标准化。将A的原始值x使用z-score标准化到x’。z-score标准化方法适用于属性A的最大值和最小值未知的情况,或有超出取值范围的离群数据的情况。新数据=(原数据- 均值)/ 标准差 from sklearn.preprocessing import StandardScaler 正则化——过拟合解决方案 数据正则化是将样本的某个范数(如L1范数)缩放到到位1,正则化的过程是针对单个样本的,对于每个样本将样本缩放到单位范数。 正则化包括L0、L1,L2正则: L0正则化的值是模型参数中非零参数的个数。 L1正则化表示各个参数绝对值之和,可以将一些参数直接缩减为0 L2正则化标识各个参数的平方的和的开方值,可以将一些参数变得很小但是不为0 参数稀疏一个好处是可以简化模型,避免过拟合。因为一个模型中真正重要的参数可能并不多,如果考虑所有的参数起作用,那么可以对训练数据可以预测的很好,但是对测试数据就只能呵呵了。另一个好处是参数变少可以使整个模型获得更好的可解释性。为什么参数越小,说明模型越简单呢,这是因为越复杂的模型,越是会尝试对所有的样本进行拟合,甚至包括一些异常样本点,这就容易造成在较小的区间里预测值产生较大的波动,这种较大的波动也反映了在这个区间里的导数很大,而只有较大的参数值才能产生较大的导数。因此复杂的模型,其参数值会比较大。 稀疏的参数可以防止过拟合,因此用L0范数(非零参数的个数)来做正则化项是可以防止过拟合的。 从直观上看,利用非零参数的个数,可以很好的来选择特征,实现特征稀疏的效果,具体操作时选择参数非零的特征即可。但因为L0正则化很难求解,是个NP难问题,因此一般采用L1正则化。L1正则化是L0正则化的最优凸近似,比L0容易求解,并且也可以实现稀疏的效果。 L1正则化-lasso(套索)回归 L2正则—Ridge(岭回归) 2.5 特征选择(降维) 从给定的特征集合中选出相关特征子集的过程称为特征选择。 进行特征选择的两个主要原因是: 减轻维数灾难问题; 降低学习任务的难度。 进行特征选择必须确保不丢失重要特征。 常见的特征选择类型分为三类:过滤式(filter)、包裹式(wrapper)、嵌入式(embedding)。 过滤式选择:该方法先对数据集进行特征选择,然后再训练学习器。特征选择过程与后续学习器无关。Relief是一种著名的过滤式特征选择方法。 包裹式选择:该方法直接把最终将要使用的学习器的性能作为特征子集的评价原则。其优点是直接针对特定学习器进行优化,因此通常包裹式特征选择比过滤式特征选择更好,缺点是由于特征选择过程需要多次训练学习器,故计算开销要比过滤式特征选择要大得多。 嵌入式选择 常见的降维方法:SVD、PCA、LDA

优秀的个人博客,低调大师

IntelliJ IDEA个人配置

主题 字体 推荐DejaVu Sans Mono,这个字体绝对爽翻 第二推荐Courier 或者 Courier New IDEA应用字体 代码字体 预览 常用插件 Alibaba Java Coding Guidelines阿里巴巴编程规范,可以检查自己的java命名规范编程规范以及bug,并会给出相应的解决方案 Grep Console对控制台输出的不同级别的日志进行上色,比如info级别是黑色,WARN级别是黄色,ERROR是橙色。不用找日志把眼睛找瞎了。 Kotlin项目中使用到了Kotlin可以安装 Lombok Plugin简化重复的java代码 Translation翻译

优秀的个人博客,低调大师

Android菜单(个人笔记)

Android系统提供三种菜单: 1.选项菜单(Option Menu) 1.1图标菜单(Icon Menu) 通过菜单键直接打开的是图标菜单,顾名思义,图标菜单就是能够同时显示文字和图标的菜单,最多支持6个子项,如果子项多于6个,则需要扩展菜单显示其它的子项。。哇哈哈 1.2扩展菜单(Expanded Menu) 扩展菜单是垂直的列表型菜单,仅在图标菜单子项多于6个时才出现,通过点击图标菜单最后的子项More才能打开。扩展菜单不能显示图标,但支持单选框和复选框;相反,图标菜单支持显示图标,但不支持单选框和复选框。 2.子菜单(Submenu) 子菜单是能够显示更加详细信息的菜单子项,Android采用了浮动窗体的形式显示菜单子项。吼吼。。 子期间不支持嵌套,也就是说不能够在子菜单中再使用子菜单。 3.快捷菜单(Context Menu) 为了能够在Android应用程序中使用选项菜单,必须重载Activity的onCreateOptionsMenu()函数,该函数在用户首次使用选项菜单时被调用,一般用来初始化菜单子项的相关内容,包括设置菜单子项自身的子项ID和组ID,菜单子项显示的文字和图片等信息。 如果希望打开菜单时,能够动态的添加、删除菜单子项,或修改菜单的标题、图标和可见性等内容,则需要重载onPrepareOptionsMenu()函数,onPrepareOptionsMenu()函数的返回值的含义与onCreateOptionsMenu()函数相同,返回true则显示菜单,否则不显示 本文转自华华世界 51CTO博客,原文链接:http://blog.51cto.com/mzh3344258/733342,如需转载请自行联系原作者

优秀的个人博客,低调大师

Django搭建个人博客(一)

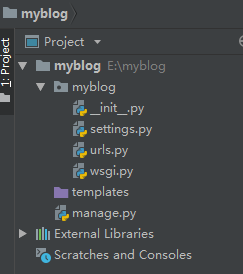
什么是 Django Django 是一个基于 python 的高级 web 开发框架。 它能够让开发人员进行高效且快速的开发。 高度集成(不用自己造轮子),免费并且开源。我们只要专注于网站本身的开发就好了。 浏览器浏览网页的基本原理 本质是网络通信,即通过网络进行数据传输 浏览器经过通信后获取到该页面的源代码文档(HTML等) 浏览器解析文档后以适当的形式展现给用户 创建项目 在 pycharm 中新建 Django 项目。 项目目录结构: 目录结构 manage.py 文件 它是与项目进行交互的命令行工具集的入口 也就是项目管理器 我们点运行命令: 运行 下方控制台输出: Performing system checks... System check identified no issues (0 silenced). You have 14 unapplied migration(s). Your project may not work properly until you apply the migrations for app(s): admin, auth, contenttypes, sessions. Run 'python manage.py migrate' to apply them. September 28, 2018 - 12:14:15 Django version 2.0.6, using settings 'myblog.settings' Starting development server at http://127.0.0.1:8000/ Quit the server with CTRL-BREAK. 项目开始运行在我们本地,打开网址:http://127.0.0.1:8000 。就可以看到我们的项目已经开启了。 项目开启 myblog 目录 项目的一个容器 包含项目最基本的一些配置 目录名称不建议修改 mybolg 目录下的文件 wsgi.py WSGI(python web server gateway interface) 中文名:python服务器网关接口 python应用与 web 服务器之间的接口 只有我们实现了 wsgi 接口,web 接口才能识别我们的 python 网站,然后才能提供服务,我们才能访问我们用python做的网站。 在项目开发过程中基本上不会用到这个文件。 urls.py URL配置文件 Django 项目中所有地址(页面)都需要我们自己去配置它的 url settings.py 项目的总配置文件 里面包含了数据库,web 应用、时间等各种配置 BASE_DIR = os.path.dirname(os.path.dirname(os.path.abspath(__file__))) 这个是项目的根目录 SECRET_KEY = '4(a3^2tg=+%wxot1lp14kigub*$@98ro498wpk@#+)^6ikw2qv' 这个是安全码,项目要想启动必须要由它。Django 在创建项目的时候会自动生成这个安全码。 # SECURITY WARNING: don't run with debug turned on in production! DEBUG = True 这个是调试,但是上方的注释,不要在实际生产中打开它。如果打开,再出现异常的情况向会直接抛给前端。 INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', ] 原装的应用,Django 的项目中是有许多个应用组成的,默认生成的是 Django 自带的应用。 如果我们创建了自己的应用,要把应用写在这个里面,这样才能被 Django 识别。 MIDDLEWARE = [ 'django.middleware.security.SecurityMiddleware', 'django.contrib.sessions.middleware.SessionMiddleware', 'django.middleware.common.CommonMiddleware', 'django.middleware.csrf.CsrfViewMiddleware', 'django.contrib.auth.middleware.AuthenticationMiddleware', 'django.contrib.messages.middleware.MessageMiddleware', 'django.middleware.clickjacking.XFrameOptionsMiddleware', ] 中间件,Django 自带的工具集。 ROOT_URLCONF = 'myblog.urls' url 的跟文件,指向的是 urls.py 文件。 TEMPLATES = [ { 'BACKEND': 'django.template.backends.django.DjangoTemplates', 'DIRS': [os.path.join(BASE_DIR, 'templates')] , 'APP_DIRS': True, 'OPTIONS': { 'context_processors': [ 'django.template.context_processors.debug', 'django.template.context_processors.request', 'django.contrib.auth.context_processors.auth', 'django.contrib.messages.context_processors.messages', ], }, }, ] 模板配置 DATABASES = { 'default': { 'ENGINE': 'django.db.backends.sqlite3', 'NAME': os.path.join(BASE_DIR, 'db.sqlite3'), } } 数据库配置,默认使用的是 sqlite3 数据库。 AUTH_PASSWORD_VALIDATORS = [ { 'NAME': 'django.contrib.auth.password_validation.UserAttributeSimilarityValidator', }, { 'NAME': 'django.contrib.auth.password_validation.MinimumLengthValidator', }, { 'NAME': 'django.contrib.auth.password_validation.CommonPasswordValidator', }, { 'NAME': 'django.contrib.auth.password_validation.NumericPasswordValidator', }, ] 跟密码认证有关。 # Internationalization # https://docs.djangoproject.com/en/2.0/topics/i18n/ LANGUAGE_CODE = 'en-us' TIME_ZONE = 'UTC' USE_I18N = True USE_L10N = True USE_TZ = True 配置语言,时区等 # Static files (CSS, JavaScript, Images) # https://docs.djangoproject.com/en/2.0/howto/static-files/ STATIC_URL = '/static/' 静态文件的地址 __init__.py python 中声明模块的文件,一般内容都为空,有了它,我们的 myblog 目录就变成了一个模块。可以在代码中引用。 创建应用 在 pycharm 下方的 Terminal 输入以下命令,也可以在命令行中切换到 myblog 目录下输入以下命令:,我的项目放在了 E 盘: E:\myblog>python manage.py startapp blog 创建之后,我们要把这个应用添加到 setting.py 文件中的 INSTALLED_APPS 里: INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'blog', ] 注意:创建的应用名称不可以和 python 中的模块名称相同,否则创建不成功。 blog 的目录结构 blog目录结构 migrations(中文意思是:移植,迁移) 数据移植(迁移)模块,文件夹下的内容由 Django 自动生成的。 admin.py 当前应用的后台管理系统配置 Django 其一的特点是有自己的后台的管理系统,所以每个应用下都有各自的配置文件。 app.py 当前应用的一些配置 models.py 数据模型模块,创建数据表在这个模块中创建的。 使用 OMR 框架,类似于 MVC 结构中的 Models (模型) test.py 自动化测试模块 Django 给我们提供了自动化测试功能,我们在这里编写相应的代码即可针对性进行自动化测试 在这里编写测试脚本(语句) views.py 非常重要的文件,我们每接收一个请求都要响应,响应什么东西,怎么响应都是在这里完成的,处理之后再返回回去。 执行响应的代码所在的模块 代码逻辑处理的主要地点 项目中大部分代码都是在这里编写 创建第一个页面(响应) 1.编辑 blog.views 每个响应对应一个函数,函数必须返回一个响应 函数必须存在一个参数,一般约定为 request 每个响应(函数)对应一个 url from django.shortcuts import render from django.http import HttpResponse # 在 Django 中每个响应都由一个函数来处理 # 因为要处理请求,我们首先要接收一个请求,也就是在函数中传入参数 def index(request): return HttpResponse('Hello this is first request!') 配置url 每个 url 都是以path 的形式写出来 path 函数放在 urlpatterns 列表中 path 函数有三个参数:URL(正则表达式),对应方法,名称 打开 myblog 文件夹下的 urls.py 。 from django.contrib import admin from django.urls import path import blog.views as bv urlpatterns = [ path('admin/', admin.site.urls), path('index/', bv.index), ] 启动服务 点击 pycharm 上方 run 运行 myblog ,或者在命令行切换到 myblog 文件夹下运行 python manage.py runserver 打开浏览器,输入:http://127.0.0.1:8000/index/ 首次响应 第二种 url 配置 根 urls.py 文件中: from django.contrib import admin from django.urls import path,include import blog.views as bv urlpatterns = [ path('admin/', admin.site.urls), path('blog/', include('blog.urls')), ] 在blog 文件下新建 urls.py 文件: #coding=utf-8 from django.urls import path from . import views urlpatterns = [ path('index/', views.index), ] 在根 urls.py 文件中引入 include 在APP应用下,也就是 blog 文件下创建 urls.py 文件,格式跟根 urls.py 相同 根 url.py 文件中 path 函数第二个参数改为 include('blog.urls')注意:根url.py 针对APP配置的URL名称,是该APP的所有 URL总路径 templates介绍 什么是 templates 就是一个一个 HTML 文件 使用了 Django 模板语言(Django Template Language )DTL 可以使用第三方模板(如Jinja2) 在 settings.py 文件中的: TEMPLATES = [ { 'BACKEND': 'django.template.backends.django.DjangoTemplates', 'DIRS': [os.path.join(BASE_DIR, 'templates')] , 'APP_DIRS': True, 第一行修改。 开发第一个 Template 在APP的根目录下创建名叫 Template 的目录 在该目录下创建一个 HTML 文件 html 3.在 views.py 文件中返回一个 render() from django.shortcuts import render from django.http import HttpResponse def index(request): # render 函数通常传入三个参数 # 第一个是请求的对象本身,第二个是模板文件,第三个是传递到前端的数据 return render(request,'index.html') 运行一下项目看看页面: 第一个模板 DTL 初步使用 render() 函数的第三个参数是传递数据到前端的,这个参数支持一个字典 dict 类型的数据。 该字典是后台传递到模板的参数,键位参数名 在模板中使用 {{参数名}} 来直接使用 例: views.py 文件中: def index(request): # render 函数通常传入三个参数 # 第一个是请求的对象本身,第二个是模板文件,第三个是传递到前端的数据 return render(request,'index.html',{'hello':'this is the first template!'}) templates/index.html 文件下: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <h1>{{ hello }}!</h1> </body> </html> 页面展示: 展示 再新建一个应用(解决一个小问题) 在 pycharm 下方的 Terminal 输入以下命令,也可以在命令行中切换到 myblog 目录下输入以下命令 E:\myblog>python manage.py startapp blog2 添加应用到 settings.py 中的 INSTALLED_APPS 里 INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'blog', 'blog2', ] 接着我们把 blog 里的 templates 文件夹复制到 blog2 中 urls 也复制一份到blog2 中 把两个应用中的templates 中HTML文件改成 <h1>hello blog1</h1> 和 <h1>hello blog2</h1> blog 应用下的 views.py 文件内容复制一份到 blog2 应用下。 根 urls.py 文件中添加: urlpatterns = [ path('admin/', admin.site.urls), path('blog/', include('blog.urls')), path('blog2/', include('blog2.urls')), ] 之后重启项目,我们会发现,在 http://127.0.0.1:8000/blog/index/ 和 http://127.0.0.1:8000/blog2/index/ 上看到的页面是一样的。 这里是 Django 把我们的 index 搞混了。 Django 在查找 template 是按照 INSTALLED_APPS 中的添加顺序查找 template ,如果我们不同应用下的template 下的HTML 文件名字相同,就会造成冲突。不同APP下templates目录下的同名.html文件会造成冲突。 解决templates冲突方案 在APP的templates目录下创建一个以APP名为名称的目录 将HTML文件放入新创建的目录下 再检查一下我们两个应用的 view.py 文件,运行一下,发现正常显示。 models 介绍 models Django 中 models 是什么? 通常,一个model 对应数据库中的一张数据表 Django 中的model 是以类的形式表现 在这个类中包含了一些基本的字段以及数据的一些行为 在 Django 中我们以创建类的形式创建数据表,因此我们在编写代码中,所有对数据的操作,事实上都是对类以及类对象的操作。这样一来,我们就不用写SQL语句了。 ORM 这种方式被称为 ORM :对象关系映射(Object Relation Mapping) 实现了对象和数据库之间的映射 隐藏了数据访问的细节,不需要编写SQL语句 编写 models 在应用的根目录下创建models.py ,并引入models 模块。这一步 Django 已经帮我们创建好了。 在 models.py 文件下创建类,继承 models.Model,该类即是一张数据表 3.在类中创建字段 字段创建 字段即类里面的属性(变量) attr = models.CharField(max_length=64) 更多字段内容 点这里 我们的模型已经创建好了,怎么映射成数据表呢? 映射生成数据表 命令行进入 manage.py 同级目录 也就是当前项目的目录 E:\myblog> 执行 python manage.py makemigrations app(可选)(翻译过来就是制作数据迁移)(可选意味着不选的话,默认所有应用都映射数据表) 再执行 python manage.py migrate E:\myblog>python manage.py makemigrations Migrations for 'blog': blog\migrations\0001_initial.py - Create model Ariticle E:\myblog>python manage.py migrate Operations to perform: Apply all migrations: admin, auth, blog, contenttypes, sessions Running migrations: Applying contenttypes.0001_initial... OK Applying auth.0001_initial... OK Applying admin.0001_initial... OK Applying admin.0002_logentry_remove_auto_add... OK Applying contenttypes.0002_remove_content_type_name... OK Applying auth.0002_alter_permission_name_max_length... OK Applying auth.0003_alter_user_email_max_length... OK Applying auth.0004_alter_user_username_opts... OK Applying auth.0005_alter_user_last_login_null... OK Applying auth.0006_require_contenttypes_0002... OK Applying auth.0007_alter_validators_add_error_messages... OK Applying auth.0008_alter_user_username_max_length... OK Applying auth.0009_alter_user_last_name_max_length... OK Applying blog.0001_initial... OK Applying sessions.0001_initial... OK E:\myblog> 这里额外创建的数据表示 Django 自带的应用创建的数据表 查看 Django 会自动在 app/migrations/ 目录下生成移植文件 operations = [ migrations.CreateModel( name='Ariticle', fields=[ ('id', models.AutoField(auto_created=True, primary_key=True, serialize=False, verbose_name='ID')), ('title', models.CharField(default='Title', max_length=32)), ('content', models.TextField(null=True)), ], ), ] 可以看到这里多了一个id字段,我们并没有创建,怎么会有呢?这里是Django 帮我们创建的,因为我们在创建的时候没有指定主键,这里Django 帮我们自动创建了。 执行 python manage.py sqlmigrate 应用名 文件id 查看SQL语句 E:\myblog>python manage.py sqlmigrate blog 0001 BEGIN; -- -- Create model Ariticle -- CREATE TABLE "blog_ariticle" ("id" integer NOT NULL PRIMARY KEY AUTOINCREMENT, "title" varchar(32) NOT NULL, "content" text NULL); COMMIT; 默认的sqlite3的数据库在项目的根目录下db.sqlite3 查看并编辑db.sqlite3 使用第三方软件 SQLite Expert Personal 轻量级,完全免费 到这里要安装软件,一篇文章太长也不好。下一篇接着来。

优秀的个人博客,低调大师

个人存档】新年读书清单

1. 每天听半个小时的英文,以彭蒙惠英语和英文散文为主,附带英文对话。 2.技术类阅读书单: 基本原则: 代码大全——学会以构建的眼光分析问题,规范代码结构和编写结构,并对基本的测试方法和重构方法进行应用。 软件工程-面向对象和传统的方法——系统学习软件工程,并通过书中那个实例将整个过程穿起。 基本方法: 敏捷软件开发:原则、模式与实践——可以复述面向对象设计原则,并熟练画出各种设计模式的UML图。 企业应用架构模式——研习常用的构架模式,对一些由语言到实际问题进行深入分析,并会在口头上和应用中再现应用场景和解决之道。 基本工具: Junit:junit.doc——学会Junit4的基本使用, JUnit 4测试驱动开发——完成Junit3和Junit4使用的对比,另外对Junit4的其他高级功能有所应用。 UML:UML_Distilled__3rd(UML精华--中文版)——会使用书中的UML要素,进行系统设计和文档编写。 TortoiseSVN的使用。 UML和模式应用——UML和模式的练习,用visio进行实作。 测试驱动开发+by+Example:应用Junit进行TDD学习。 3.金融类书单: 最新银行会计——对银行业务和基本流程、计算等进行学习,争取熟练掌握。 银行软件开发必备知识压缩版+银行业务与信息化系统分析补遗+商业银行IT系统.ppt——对银行IT系统涉及的业务知识、系统架构、开发技术等进行熟悉。 金融学原理——货币市场、金融市场和金融机构等进行学习,可以复述主要金融机构及其职能,以及银行业基本金融政策概念的内涵和应用。 4.非专业类书籍:随意,开卷有益,以手机上看TXT为主。 5.视频教程: 1)STUT经济学I、II 本文转自gnuhpc博客园博客,原文链接:http://www.cnblogs.com/gnuhpc/archive/2012/01/03/2311219.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

2016年个人小结

大事件 1、因为工作需要,从 Android 转到 iOS 。 2、开始写自己的技术博客,分享曾经积累的和现学现卖的技术,在简书写了51篇文章,收获786个粉丝,获得1923个喜欢。 3、独立开发了一款 Android App 并上架。 4、开发迭代了一个考勤小系统(服务器 + Android + 网页)。 技术成长 1、深入学习 Objective-C 开发语言。 2、熟悉 iOS 开发。 3、学习 Swift 语言。 4、巩固 J2EE 和 Android 的知识。 5、整理了近100个文档,弄懂了很多以前不懂的技术。 6、尝试一些前端的技术,如 Bootstrap 。 2017 1、学习 Mac 开发。 2、专研 iOS 开发,能够熟练地进行 iOS 开发。 3、与时俱进 Java 和 Android 方面的知识。 4、Review 自己以前的代码。 5、尝试更多前端的技术。 6、尝试做一到二个功能系统(服务器 + Android + iOS + 网页)。

优秀的个人博客,低调大师

个人隐私安全该何去何从-大量APP秘密收集追踪个人信息

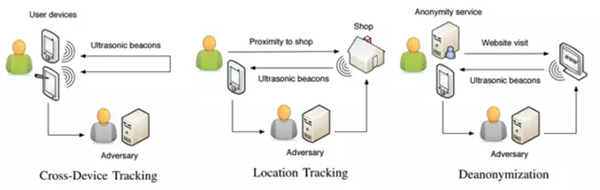
研究人员在上周的IEEE欧洲议会上表示,他们在近期的一项研究中发现了234种安卓应用会向用户发出“允许使用麦克风”的请求,以此通过超声波信号追踪用户信息。基于超声波跨设备追踪技术(Ultrasonic Cross-Device Tracking,uXDT)是许多市场和广告公司的“宠儿”。 超声波音频信标可以植入电视广告或网页广告,而装有接收器的移动APP则可以收集这些信标。由此,广告商可以通过此项技术跨设备追踪用户信息,创建用户的个性化档案,通过分析设备收集的数据了解用户的兴趣所在,从而为每位用户推荐他们感兴趣的广告。 越来越多的APP开始使用uXDT技术 在这项研究中,研究人员针对VirusTotal服务的数百万Android应用进行了分析,他们发现一小部分应用采用名为Shopkick和Lisnr的超声波音频技术。还有不少应用则采用了SilverPush SDK,这是个可让开发者对用户进行跨设备追踪的SDK。SilverPush、Lisnr和Shopkick都是为开发者准备的SDK,这三款SDK都采用超声波信标给移动设备发送信息。 开发者可以通过SilverPush跨多个设备追踪用户信息,而 Lisnr 和Shopkick 则用于对用户进行位置追踪。研究人员在分析了大量Android应用之后发现,使用 Lisnr和Shopkick SDK的厂商并不多,但是使用SilverPush SDK的却大有人在。这份报告还提到,在研究人员走访的35家德国零售商店中,就有4家店内存在超声波信标。 早在2015年,就有一份研究显示,样本中有6-7个APP使用了SilverPush SDK,该企业由此监视了大约1800万台智能手机,但这一数量正在不断上升。 在2016年的BlackHat黑客大会上就有研究人员对uXDT技术进行了展示,并指出这种技术可以通过反匿名暴露Tor用户的真实信息。(例如,在正常情况下,用户通过比特币进行交易不会留下真实的身份信息,但一家恶意网站可以追踪出用户的真实身份,或揭露出通过匿名网络,如Tor洋葱网络,浏览网页的用户身份。) 隐私安全将何去何从? 虽然uXDT技术的应用目前尚未“误入歧途”,但它仍然引发了许多对隐私的担忧——app只需通过麦克风接收超声波就可进行追踪活动,而无需任何移动网络或无线网络。该研究报告提到: “SilverPush的存在实际上缩小了监控和合法追踪之间的距离。SilverPush和Lisnr采用相似的通讯协议和信号处理方式。即便用户指导Lisnr会进行地理位置追踪,SilverPush也不会公开采用这种追踪功能的应用名称。” 2014年斯诺登事件曝光后,泄露文档提到美国情报机构如何获取国外旅客在不同城市间的动向:机场会收集这些人所用设备的MAC地址,而全国各地咖啡厅、餐厅和零售店的WiFi热点也会进行MAC地址识别,情报机构再对两者进行比对。国外媒体认为,超声波技术对于夸设备追踪用户动向甚至会有更好的效果。 如何进行自我保护? 既然我们无法阻止超声波信号在自己周围传输,那么为了减少智能手机被监听的风险,最好的方法就是严格限制通过APP对设备发起的“请求”。 换而言之,这里我们只需运用自己的常识。例如,如果Skype请求“使用麦克风”,显然十分合理的,因为在Skype中将用到这一功能。但倘若美妆或服饰APP发送这一请求,结果又将如何?作为用户,应该严格拒绝请求。 为了取消这些不需要的APP请求,一些Android手机厂商,例如一加为用户提供了一种叫做“隐私指南”(Privacy Guard)的功能,用户可以通过这一功能禁止一些与APP基本功能无关的请求。 Android 7和iOS 10用户同样可以通过设置实现这一操作。 【本文为51CTO专栏“柯力士信息安全”原创稿件,转载请联系原作者(微信号:JW-assoc)】 戳这里,看该作者更多好文 作者:柯力士信息安全 来源:51CTO

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册