首页 文章 精选 留言 我的

精选列表

搜索[产品驱动],共10000篇文章
优秀的个人博客,低调大师

Databend 产品月报(2025年5月)

五月份的更新来啦!这个月我们为大家带来了不少实用的新功能和性能优化,希望能让你的大数据处理工作更加得心应手。 这个月我们一共推出了 31 个新功能 ,修复了 18 个 bug ,还做了 15 项性能优化! 📊 五月更新亮点 重磅功能 Ngram Index - 让 LIKE '%pattern%' 查询飞起来,自带 bloom filter 加速 Iceberg 功能增强 - 新增 ORC 文件支持,数据缓存和 merge-on-read 优化 AVRO 文件支持 - 现在可以直接导入和查询 AVRO 文件了 Streaming Load API - 重新上线,性能比之前更强 Sequence 管理 - 新增 SHOW SEQUENCES 和 DESC SEQUENCE 命令 类型转换优化 - 数字转布尔值、数字字符串转换更智能了 性能提升 Query Optimizer - 优化了 JOIN 条件中的关联子查询 Fragment Forest 执行引擎 - 分布式查询的 Broadcast 操作更高效 Histogram 计算 - 字符串类型的统计信息计算更快了 内存管理 - 没有工作负载时自动释放内存 并发处理 - Row-Fetch 和数据库操作的并发性能提升 存储和稳定性 Auto-Vacuum 选项 - 新增 enable_auto_vacuum 表级设置 数据保留策略 - data_retention_num_snapshots_to_keep 参数控制快照保留 Meta-Service 改进 - 基于时间戳的 Semaphore 序列,缓存管理更智能 超时处理 - 存储操作的取消机制更安全 开发体验 时间序列 Profiling - 新的统计指标帮你更加详细的了解每个算子的实时吞吐 错误处理优化 - 异常分类和日志记录更清晰 Python Bindings - 发布了 Python 集成支持 Arrow 升级 - 升级到 v55,兼容性更好 🚀 本月最值得关注的功能 文本搜索的双重加速:两种 Index 各有所长 我们这次推出了两种文本搜索的解决方案,各有特色,可以根据不同场景选择。最棒的是 两种 index 都是全自动维护的 - 创建后就不用管了,数据插入更新时会自动同步。 | 对比项 | Ngram Index | Full-Text Index | |---------|-------------|-----------------| | 擅长场景 | 加速 LIKE '%pattern%' 查询 | 文档搜索和内容发现 | | 典型用法 | 日志分析,精确子串匹配 | 内容搜索,模糊匹配 | | 查询语法 | WHERE col LIKE '%text%' | WHERE MATCH(col, 'text') | | 高级特性 | 大小写不敏感 | 相关性打分,模糊搜索,布尔查询 | | 主要优势 | 现有 LIKE 查询直接加速 | 专业搜索功能,替代传统 LIKE | | 迁移成本 | 零成本,现有 SQL 直接受益 | 兼容 Elasticsearch 语法 | | 维护工作 | 全自动 | 全自动 | Ngram Index:让你的 LIKE 查询起飞 专门为加速 LIKE '%pattern%' 查询设计: -- 创建应用日志表 CREATE OR REPLACE TABLE app_logs ( id INT, timestamp TIMESTAMP, level STRING, message STRING ); -- 创建 ngram index(按3个字符分段) CREATE OR REPLACE NGRAM INDEX logs_message_idx ON app_logs(message) gram_size = 3; -- 插入数据,index 会自动更新 INSERT INTO app_logs VALUES (1, '2025-05-01 10:00:00', 'ERROR', 'Database connection failed'); INSERT INTO app_logs VALUES (2, '2025-05-01 10:01:00', 'INFO', 'User login successful'); INSERT INTO app_logs VALUES (3, '2025-05-01 10:02:00', 'ERROR', 'Kubernetes pod restart failed'); -- 原来的 LIKE 查询现在飞快 SELECT * FROM app_logs WHERE message LIKE '%connection%'; SELECT * FROM app_logs WHERE message LIKE '%kubernetes%'; -- 看看 index 是否生效 EXPLAIN SELECT * FROM app_logs WHERE message LIKE '%error%'; -- 会显示:bloom pruning: X to Y(说明 index 在工作) Ngram Index 文档:https://docs.databend.cn/guides/performance/ngram-index Full-Text Index:专业级文档搜索 支持 Elasticsearch 语法,Elasticsearch 用户可以无缝迁移: -- 创建知识库表 CREATE OR REPLACE TABLE knowledge_base ( doc_id INT, title STRING, content STRING, category STRING ); -- 创建全文搜索 index CREATE OR REPLACE INVERTED INDEX kb_content_idx ON knowledge_base(title, content, category); -- 插入文档数据,index 自动维护 INSERT INTO knowledge_base VALUES (1, 'Database Setup', 'Learn how to configure database connections and troubleshoot common issues', 'tutorial'); INSERT INTO knowledge_base VALUES (2, 'Kubernetes Guide', 'Complete guide to deploying applications on Kubernetes clusters', 'guide'); INSERT INTO knowledge_base VALUES (3, 'Error Handling', 'Best practices for error handling and logging in distributed systems', 'best-practices'); -- 基础搜索,带相关性打分(Elasticsearch 用户很熟悉) SELECT doc_id, title, SCORE() as relevance FROM knowledge_base WHERE MATCH(content, 'database troubleshoot') ORDER BY SCORE() DESC; -- 模糊搜索 - 和 Elasticsearch 一模一样的语法 SELECT * FROM knowledge_base WHERE MATCH(content, 'kuberntes', 'fuzziness=1'); -- 高级查询,完全是 Elasticsearch 的写法 SELECT * FROM knowledge_base WHERE QUERY('content:"error handling" AND category:best-practices'); -- 布尔查询(Elasticsearch 用户几乎无学习成本) SELECT * FROM knowledge_base WHERE QUERY('title:database OR kubernetes AND content:guide'); ES 用户的福音:我们的全文搜索语法兼容 Elasticsearch,如果你之前用过 Elasticsearch,可以直接上手,零学习成本。 怎么选择? | 你的需求 | Ngram Index | Full-Text Index | |----------|-------------|-----------------| | 现有 LIKE 查询太慢 | ✅ 完美,代码都不用改 | ❌ 需要重写查询 | | 日志分析和监控 | ✅ 专门为这个设计的 | ⚠️ 也能用,但有点大材小用 | | 文档搜索功能 | ❌ 功能太简单 | ✅ 这就是专业的 | | 需要模糊搜索和相关性 | ❌ 不支持 | ✅ 原生支持 | | 从 Elasticsearch 迁移 | ❌ 语法不一样 | ✅ 无缝迁移 | 选择建议: 用 Ngram Index 如果你想让现有的 LIKE '%pattern%' 查询跑得更快,不想改代码 用 Full-Text Index 如果你要做搜索功能,或者从 Elasticsearch 迁移过来 Full-Text Index 文档:https://docs.databend.cn/guides/performance/fulltext-index 🔮 总结 五月份对 Databend 来说是个重要的里程碑。双重索引方案让查询性能有了质的飞跃,我们正在打造下一代云数据仓库的基础设施。 社区的反馈超出了我们的预期 - 很多用户已经在生产环境中使用,给了我们很多宝贵的建议。感谢所有社区成员、贡献者,以及愿意尝鲜的朋友们。 想体验一下未来的数据仓库吗?来看看我们的项目:github.com/databendlabs/databend 🚀 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2025年4月)

很高兴为您带来 Databend 2025 年 4 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 BendDeploy:安装 Databend 的新方式 BendDeploy 是由 Databend 开发的一款基于 Kubernetes 的平台,旨在简化和标准化 Databend 集群的部署与管理。它提供可视化、用户友好的界面,支持多集群、多租户操作,显著提升了运维效率、系统可靠性以及管控能力。 多租户管理:为不同租户提供隔离的环境,并支持基于角色的用户访问控制。 一键集群部署:只需几次点击即可轻松启动并管理 Databend 集群。 生命周期管理操作:支持滚动升级、版本回滚、水平扩展和集群重启等功能。 可视化监控与日志:集成节点状态视图、日志(如查询日志、性能分析日志)以及外部 Prometheus 指标。 网页 SQL 工作台:可在 UI 中直接执行 SQL 查询,并可指定目标租户集群。 BendSave:一条命令完成数据备份与恢复 BendSave 是一款命令行工具,用于备份和恢复 Databend 中的元数据及实际数据文件。它将备份内容存储在兼容 S3 的对象存储中,非常适合用于灾难恢复场景。 export AWS_ACCESS_KEY_ID=minioadmin export AWS_SECRET_ACCESS_KEY=minioadmin # Backup ./databend-bendsave backup \ --from ../configs/databend-query.toml \ --to 's3://backupbucket?endpoint=http://127.0.0.1:9000/&region=us-east-1' # Restore ./databend-bendsave restore \ --from "s3://backupbucket?endpoint=http://127.0.0.1:9000/&region=us-east-1" \ --to-query ../configs/databend-query.toml \ --to-meta ../configs/databend-meta.toml \ --confirm 查询结果缓存 查询结果缓存是 Databend 的一项性能优化功能,用于存储先前查询的结果。对于重复执行的查询,系统可直接从缓存中返回结果,而无需重新计算,从而降低查询延迟并提升整体系统效率,尤其适用于重复的分析型工作负载。 有关如何启用和配置查询结果缓存的详细信息,请参阅查询结果缓存。 动态列默认值:NEXTVAL() 您现在可以在创建表时,使用来自序列的动态值作为列的默认值。通过 NEXTVAL(<seq>),每次插入新行时,该列将自动获取序列生成的下一个值。 CREATE SEQUENCE staff_id_seq; CREATE TABLE staff ( staff_id INT DEFAULT NEXTVAL(staff_id_seq), -- Assigns the next number from the sequence 'staff_id_seq' if no value is provided name VARCHAR(50), department VARCHAR(50) DEFAULT 'Marketing' -- Defaults to 'Marketing' if no value is provided ); 查询文件级元数据 您现在可以从暂存文件中查询文件级别的元数据信息,例如文件名和行号。 -- Querying Metadata Fields SELECT metadata$filename, metadata$file_row_number, * FROM @my_internal_stage/iris.parquet LIMIT 5; -- Using Metadata in COPY INTO COPY INTO iris_with_meta FROM (SELECT metadata$filename, metadata$file_row_number, $1, $2, $3, $4, $5 FROM @my_internal_stage/iris.parquet) FILE_FORMAT=(TYPE=parquet); 新文件格式:Avro Apache Avro™ 是领先的记录数据序列化格式,也是流式数据管道的首选格式。Databend 现已支持将 Avro 作为加载数据的文件格式。 COPY INTO userdata FROM 'https://raw.githubusercontent.com/Teradata/kylo/master/samples/sample-data/avro/userdata1.avro' FILE_FORMAT = (type = avro); 新函数 LISTAGG:将多行中的值连接成一个字符串,并用指定的分隔符分隔。 -- Aggregate Function LISTAGG([DISTINCT] <expr> [, <delimiter>]) [WITHIN GROUP (ORDER BY <order_by_expr>)] -- Window Function LISTAGG([DISTINCT] <expr> [, <delimiter>]) [WITHIN GROUP (ORDER BY <order_by_expr>)] OVER ([PARTITION BY <partition_expr>]) DATE_BETWEEN:计算两个日期或时间戳之间的时间间隔,以指定的单位返回差值,正值表示第一个时间早于第二个时间,负值表示相反。 DATE_BETWEEN( YEAR | QUARTER | MONTH | WEEK | DAY | HOUR | MINUTE | SECOND | DOW | DOY | EPOCH | ISODOW | YEARWEEK | MILLENNIUM, <start_date_or_timestamp>, <end_date_or_timestamp> ) GLOB:使用通配符执行区分大小写的模式匹配。 GLOB(<string>, <pattern>) 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2025年3月)

很高兴为您带来 Databend 2025 年 3 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 仪表盘共享 您现在可以在 Databend Cloud 上与组织内的所有人或特定个人共享您的仪表盘,并选择以下权限级别之一来控制他人对其的访问方式: 只读 (Read Only) :查看仪表盘,但无法进行更改或运行查询以获取最新结果。 执行(Execute) :运行查询以获取最新结果或与仪表盘交互,但无法修改它。 编辑(Edit) :修改仪表盘,包括更改查询和仪表盘如何反映结果。 使用来自另一个表的值更新表 UPDATE 命令已增强,允许使用来自另一个表的值更新表。 UPDATE bookstore SET book_name = book_updates.new_book_name FROM book_updates WHERE bookstore.book_id = book_updates.book_id; 最小日期和时间戳调整 我们已更新日期和时间戳数据类型的最小值: 最小日期:0001-01-01 最小时间戳:0001-01-01 00:00:00.00000 对用户名称和角色名称的限制 Databend 不允许 SQL 用户或角色名称包含以下特殊字符: 单引号(') 双引号(") 退格符(\b) 换页符(\f) 使用 enable_expand_roles 管理角色继承 enable_expand_roles 设置确定 SHOW_GRANTS 函数是否显示来自角色的继承权限。默认设置为 1,它递归地扩展所有权限;当设置为 0 时,它仅显示直接权限和角色授予。例如: 当 enable_expand_roles=1 时: SELECT grants FROM show_grants('role', 'a') ORDER BY object_id; ┌──────────────────────────────────────────────────────┐ │ grants │ ├──────────────────────────────────────────────────────┤ │ GRANT SELECT ON 'default'.'default'.'t1' TO ROLE `a` │ │ GRANT SELECT ON 'default'.'default'.'t2' TO ROLE `a` │ └──────────────────────────────────────────────────────┘ 当 enable_expand_roles=0 时: SELECT grants FROM show_grants('role', 'a') ORDER BY object_id; ┌──────────────────────────────────────────────────────┐ │ grants │ ├──────────────────────────────────────────────────────┤ │ GRANT SELECT ON 'default'.'default'.'t1' TO ROLE `a` │ │ GRANT ROLE b to ROLE `a` │ │ GRANT ROLE public to ROLE `a` │ └──────────────────────────────────────────────────────┘ 日志级别配置更新 databend-query.toml 配置文件中的 [log.file] 和 [log.stderr] 设置现在使用 env_logger 语法(error, warn, info, debug, trace, off),默认设置为 warn,databend_=info,openraft=info,以实现灵活的日志控制。 Iceberg 表函数 Databend 引入了以下表函数用于查询 Iceberg 元数据,允许用户高效地检查快照和清单: ICEBERG_MANIFEST:返回 Iceberg 表的清单文件的元数据,包括文件路径、分区详细信息和快照关联。 SELECT * FROM ICEBERG_MANIFEST('tpcds', 'catalog_returns'); ╭───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╮ │ content │ path │ length │ partition_spec │ added_snapshot │ added_data_fil │ existing_data_ │ deleted_data_ │ added_delete_ │ existing_dele │ deleted_delet │ partition_sum │ │ Int32 │ String │ Int64 │ _id │ _id │ es_count │ files_count │ files_count │ files_count │ te_files_coun │ e_files_count │ maries │ │ │ │ │ Int32 │ Nullable(Int64 │ Nullable(Int32 │ Nullable(Int32 │ Nullable(Int3 │ Nullable(Int3 │ t │ Nullable(Int3 │ Array(Nullabl │ │ │ │ │ │ ) │ ) │ ) │ 2) │ 2) │ Nullable(Int3 │ 2) │ e(Tuple(Nulla │ │ │ │ │ │ │ │ │ │ │ 2) │ │ ble(Boolean), │ │ │ │ │ │ │ │ │ │ │ │ │ Nullable(Bool │ │ │ │ │ │ │ │ │ │ │ │ │ ean), String, │ │ │ │ │ │ │ │ │ │ │ │ │ String))) │ ├─────────┼────────────────┼────────┼────────────────┼────────────────┼────────────────┼────────────────┼───────────────┼───────────────┼───────────────┼───────────────┼───────────────┤ │ 0 │ s3://warehouse │ 9241 │ 0 │ 75657674165904 │ 2 │ 0 │ 0 │ 2 │ 0 │ 0 │ [] │ │ │ /catalog_retur │ │ │ 11866 │ │ │ │ │ │ │ │ │ │ ns/metadata/fa │ │ │ │ │ │ │ │ │ │ │ │ │ 1ea4d5-a382-49 │ │ │ │ │ │ │ │ │ │ │ │ │ 7a-9f22-1acb9a │ │ │ │ │ │ │ │ │ │ │ │ │ 74a346-m0.avro │ │ │ │ │ │ │ │ │ │ │ ╰───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯ ICEBERG_SNAPSHOT:返回 Iceberg 表的快照元数据,包括数据更改、操作信息和摘要统计信息。 SELECT * FROM ICEBERG_SNAPSHOT('tpcds', 'catalog_returns'); ╭───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╮ │ committed_at │ snapshot_id │ parent_id │ operation │ manifest_list │ summary │ ├────────────────────────────┼─────────────────────┼───────────┼───────────┼──────────────────────────────────────────────────────┼─────────────────────────────────────────────────────┤ │ 2025-03-12 23:18:26.626000 │ 7565767416590411866 │ 0 │ append │ s3://warehouse/catalog_returns/metadata/snap-7565767 │ {'spark.app.id':'local-1741821433430','added-data-f │ │ │ │ │ │ 416590411866-1-fa1ea4d5-a382-497a-9f22-1acb9a74a346. │ iles':'2','added-records':'144067','total-equality- │ │ │ │ │ │ avro │ deletes':'0','changed-partition-count':'1','total-r │ │ │ │ │ │ │ ecords':'144067','total-files-size':'7679811','tota │ │ │ │ │ │ │ l-data-files':'2','added-files-size':'7679811','tot │ │ │ │ │ │ │ al-delete-files':'0','total-position-deletes':'0'} │ ╰───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯ [新功能预览] 表函数 fuse_vacuum2() fuse_vacuum2() 表函数根据 data_retention_time_in_days 的设置,帮助用户清理 Fuse 表中过时的数据,回收存储空间并提升查询性能。 SET data_retention_time_in_days = 0; SELECT * FROM fuse_vacuum2('<database>', '<table>'); [新功能预览] Hilbert Clustering 优化 Databend 引入 基于范围的分区 来增强 Hilbert Clustering,使数据组织更加高效。它通过 对 Clustering Key 进行采样 、分配范围分区 ID 以及 计算 Hilbert 索引,从而实现更好的数据裁剪(pruning)和聚类,提高查询性能。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.com 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2025年2月)

很高兴为您带来 Databend 2025 年 2 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 从 MySQL 迁移到 Databend Databend 推荐使用 db-archiver 进行 MySQL 批量迁移,使用 Flink CDC 进行实时变更数据捕获(CDC)迁移。教程已更新: 使用 db-archiver 从 MySQL 迁移 使用 Flink CDC 从 MySQL 迁移 设置会话标签 现在,您可以为会话分配一个可选标签,从而更方便地在日志表中过滤具有指定标签的日志。例如,以下命令将当前会话的标签设置为 eric: SET SESSION query_tag = 'eric'; 随后,我们执行一个查询,并使用该标签从日志表中检索相应的日志记录: SHOW USERS; SELECT query_tag, query_text FROM system.query_log WHERE query_tag = 'eric' LIMIT 1; 返回结果中,您可以找到带有 eric 标签的查询记录: -[ RECORD 1 ]----------------------------------- query_tag: eric query_text: SHOW USERS 溢出数据存储 自托管 Databend 支持在内存使用超出可用限制时,将中间查询结果溢出到磁盘。现在,您可以配置溢出数据的存储位置,可选择本地磁盘存储或远程 S3 兼容存储桶。 以下示例将 Databend 配置为最多使用 1 TB 本地磁盘空间进行溢出操作,同时保留 40% 磁盘空间供系统使用: [spill] spill_local_disk_path = "/data1/databend/databend_spill" spill_local_disk_reserved_space_percentage = 40 spill_local_disk_max_bytes = 1099511627776 以下示例将 Databend 配置为使用 MinIO 作为 S3 兼容存储服务来进行溢出操作: [spill] [spill.storage] type = "s3" [spill.storage.s3] bucket = "databend" root = "admin" endpoint_url = "http://127.0.0.1:9900" access_key_id = "minioadmin" secret_access_key = "minioadmin" allow_insecure = true 使用 "FROM table" 获取所有列 Databend 扩展了 SQL 语法,允许查询直接以 FROM <table> 开头,而无需显式使用 SELECT *: FROM my_table; 等同于: SELECT * FROM my_table; 新增与优化的 SQL 命令 ATTACH TABLE:现在,您可以在附加表时指定选择的列。 ATTACH TABLE population_only (city, population) 's3://databend-doc/1/16/' CONNECTION = ( REGION='us-east-2', AWS_KEY_ID = '<your_aws_key_id>', AWS_SECRET_KEY = '<your_aws_secret_key>' ); 新教程:使用 ATTACH TABLE 链接表 DESC PROCEDURE:显示特定存储过程的详细信息。 DESC PROCEDURE sum_even_numbers(Uint8, Uint8); ┌────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ Property │ Value │ ├───────────┼────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┤ │ signature │ (start_val,end_val) │ │ returns │ (UInt8) │ │ language │ SQL │ │ body │ BEGIN\n LET sum := 0;\n FOR i IN start_val TO end_val DO\n IF i % 2 = 0 THEN\n sum := sum + i;\n END IF;\n END FOR;\n \n RETURN sum;\nEND; │ └────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ 新增与优化的 SQL 函数 TIMESTAMP_DIFF:计算两个时间戳之间的差异,并将结果以 INTERVAL 格式返回。 SELECT TIMESTAMP_DIFF('2025-02-01'::TIMESTAMP, '2025-01-01'::TIMESTAMP); ┌──────────────────────────────────────────────────────────────────┐ │ timestamp_diff('2025-02-01'::TIMESTAMP, '2025-01-01'::TIMESTAMP) │ ├──────────────────────────────────────────────────────────────────┤ │ 744:00:00 │ └──────────────────────────────────────────────────────────────────┘ FUSE_TIME_TRAVEL_SIZE:计算表的历史数据(用于时间旅行)的存储大小。 -- Calculate historical data size for all tables in all databases SELECT ... FROM fuse_time_travel_size(); -- Calculate historical data size for all tables in a specified database SELECT ... FROM fuse_time_travel_size('<database_name>'); -- Calculate historical data size for a specified table in a specified database SELECT ... FROM fuse_time_travel_size('<database_name>', '<table_name>')); ARRAYS_ZIP:将多个数组合并为一个数组元组。 SELECT ARRAYS_ZIP([1, 2, 3], ['a', 'b', 'c']); ┌────────────────────────────────────────┐ │ arrays_zip([1, 2, 3], ['a', 'b', 'c']) │ ├────────────────────────────────────────┤ │ [(1,'a'),(2,'b'),(3,'c')] │ └────────────────────────────────────────┘ MAP_INSERT:返回一个新的 MAP,其中包含输入 MAP 和插入的新键值对(如果键已存在,则更新为新值)。 SELECT MAP_INSERT({'a':1,'b':2,'c':3}, 'd', 4); ┌─────────────────────────────────────────┐ │ map_insert({'a':1,'b':2,'c':3}, 'd', 4) │ ├─────────────────────────────────────────┤ │ {'a':1,'b':2,'c':3,'d':4} │ └─────────────────────────────────────────┘ SELECT MAP_INSERT({'a':1,'b':2,'c':3}, 'a', 5, true); ┌───────────────────────────────────────────────┐ │ map_insert({'a':1,'b':2,'c':3}, 'a', 5, TRUE) │ ├───────────────────────────────────────────────┤ │ {'a':5,'b':2,'c':3} │ └───────────────────────────────────────────────┘ MAP_PICK:返回一个新的 MAP,包含来自现有 MAP 的指定键值对。 SELECT MAP_PICK({'a':1,'b':2,'c':3}, 'a', 'c'); ┌─────────────────────────────────────────┐ │ map_pick({'a':1,'b':2,'c':3}, 'a', 'c') │ ├─────────────────────────────────────────┤ │ {'a':1,'c':3} │ └─────────────────────────────────────────┘ SELECT MAP_PICK({'a':1,'b':2,'c':3}, ['a', 'b']); ┌───────────────────────────────────────────┐ │ map_pick({'a':1,'b':2,'c':3}, ['a', 'b']) │ ├───────────────────────────────────────────┤ │ {'a':1,'b':2} │ └───────────────────────────────────────────┘ EXTRACT:现在,您可以从间隔值中提取组件,并新增对 EPOCH 作为可提取字段的支持。 SELECT NOW(), EXTRACT(DAY FROM NOW()), EXTRACT(DOY FROM NOW()), EXTRACT(EPOCH FROM NOW()); ┌────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ now() │ EXTRACT(DAY FROM now()) │ EXTRACT(DOY FROM now()) │ EXTRACT(EPOCH FROM now()) │ ├────────────────────────────┼─────────────────────────┼─────────────────────────┼───────────────────────────┤ │ 2025-02-08 03:51:51.991167 │ 8 │ 39 │ 1738986711.991167 │ └────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ SELECT EXTRACT(DAY FROM '1 day 2 hours 3 minutes 4 seconds'::INTERVAL); ┌─────────────────────────────────────────────────────────────────┐ │ EXTRACT(DAY FROM '1 day 2 hours 3 minutes 4 seconds'::INTERVAL) │ ├─────────────────────────────────────────────────────────────────┤ │ 1 │ └─────────────────────────────────────────────────────────────────┘ SUM:现在支持 INTERVAL 值。 -- Create a table with integer, double, and interval columns CREATE TABLE sum_example ( id INT, int_col INTEGER, double_col DOUBLE, interval_col INTERVAL ); -- Insert data INSERT INTO sum_example VALUES (1, 10, 15.5, INTERVAL '2 days'), (2, 20, 25.7, INTERVAL '3 days'), (3, NULL, 5.2, INTERVAL '1 day'), (4, 30, 40.1, INTERVAL '4 days'); -- Calculate the sum for each column SELECT SUM(int_col) AS total_integer, SUM(double_col) AS total_double, SUM(interval_col) AS total_interval FROM sum_example; -- NULL values are ignored. -- SUM(interval_col) returns 240:00:00 (10 days). ┌──────────────────────────────────────────────────────────┐ │ total_integer │ total_double │ total_interval │ ├─────────────────┼───────────────────┼────────────────────┤ │ 60 │ 86.5 │ 240:00:00 │ └──────────────────────────────────────────────────────────┘ DATE_TRUNC:现在支持 WEEK 作为精度。 SELECT DATE_TRUNC(MONTH, to_date('2022-07-07')), DATE_TRUNC(WEEK, to_date('2022-07-07')); ┌────────────────────────────────────────────────────────────────────────────────────┐ │ DATE_TRUNC(MONTH, to_date('2022-07-07')) │ DATE_TRUNC(WEEK, to_date('2022-07-07')) │ ├──────────────────────────────────────────┼─────────────────────────────────────────┤ │ 2022-07-01 │ 2022-07-04 │ └────────────────────────────────────────────────────────────────────────────────────┘ 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.com 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2024年12月)

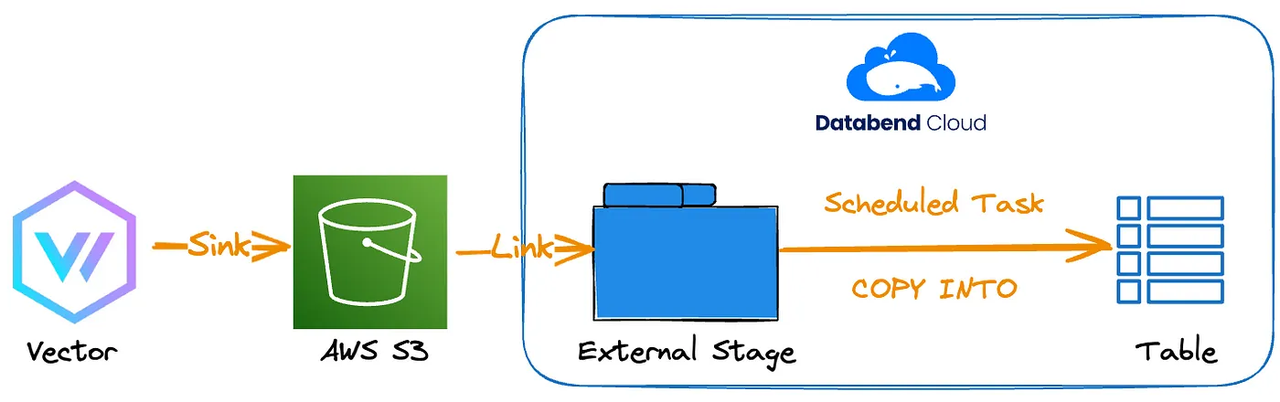
很高兴为您带来 Databend 2024 年 12 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈,祝您新年快乐! 临时表 您现在可以创建一个临时表,该临时表在会话结束时会自动删除。临时表仅在创建它的会话中可见,并在会话结束时自动删除,所有数据都会被清除。要创建临时表,请使用 CREATE TEMP TABLE 命令。 CREATE [ OR REPLACE ] { TEMPORARY | TEMP } TABLE [ IF NOT EXISTS ] [ <database_name>. ]<table_name> ... 新数据类型:INTERVAL INTERVAL 数据类型表示时间长度,允许精确操作和存储跨不同单位的时间间隔。 -- Create a table with one INTERVAL column CREATE OR REPLACE TABLE intervals (duration INTERVAL); -- Insert different types of INTERVAL data INSERT INTO intervals VALUES ('1 year 2 months ago'), -- Natural language format with 'ago' (negative interval) ('1 year 2 months'), -- Natural language format without 'ago' (positive interval) ('1000000'), -- Positive numeric value interpreted as microseconds ('-1000000'); -- Negative numeric value interpreted as microseconds -- Query the table to see the results SELECT * FROM intervals; ┌──────────────────────────┐ │ duration │ ├──────────────────────────┤ │ -1 year -2 months │ │ 1 year 2 months │ │ 0:00:01 │ │ -1 month -1 day -0:00:01 │ └──────────────────────────┘ 自定义聚合函数 现在您可以使用 Python 和 JavaScript 定义自己的聚合函数。 CREATE or REPLACE FUNCTION weighted_avg (INT, INT) STATE {sum INT, weight INT} RETURNS FLOAT LANGUAGE javascript AS $$ export function create_state() { return {sum: 0, weight: 0}; } export function accumulate(state, value, weight) { state.sum += value * weight; state.weight += weight; return state; } export function retract(state, value, weight) { state.sum -= value * weight; state.weight -= weight; return state; } export function merge(state1, state2) { state1.sum += state2.sum; state1.weight += state2.weight; return state1; } export function finish(state) { return state.sum / state.weight; } $$; 新教程:使用 Vector 自动加载 JSON 日志 在本教程中,我们模拟在本地生成日志,使用 Vector 收集日志,将其存储在 S3 中,并使用计划任务自动将其提取到 Databend Cloud 中。请单击此处访问完整教程。 增强对 Parquet 文件处理的支持 我们引入了一些新参数,以便在处理 Parquet 文件时提供更大的灵活性和精确性。 CASE_SENSITIVE参数 CASE_SENSITIVE参数用来决定所查询的Parquet文件中的列名是否区分大小写: CASE_SENSITIVE => false(默认): 列名不区分大小写。例如,b 和 B 被视为相同。 CASE_SENSITIVE => true:列名区分大小写,即只有完全匹配(包括大小写)才有效。例如,如果文件中的列名为 B,则查询 B 会成功,但如果列名为 b,则查询不会成功。 例如,如果在 Parquet 文件中有名为 MinTemp 的列,当 CASE_SENSITIVE 设置为 false 时,可以使用以下语句之一进行查询: SELECT MinTemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT MINTEMP FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT mintemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); 当 CASE_SENSITIVE 设置为 true 时,必须使用文件中出现的准确列名: SELECT `MinTemp` FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>true); 新增 COPY INTO 选项:COLUMN_MATCH_MODE COLUMN_MATCH_MODE 决定 COPY INTO 过程中列名匹配是区分大小写还是不区分大小写(默认)。有关 COPY INTO 选项的完整列表,请参阅 copyOptions。 二进制转换函数:TO_BINARY 和 TRY_TO_BINARY TO_BINARY 将支持的数据类型(包括字符串、变量、位图、几何图形和地理位置)转换为二进制表示(十六进制格式)。 SELECT TO_BINARY('Databend'); ┌───────────────────────┐ │ to_binary('Databend') │ ├───────────────────────┤ │ 4461746162656E64 │ └───────────────────────┘ SELECT TO_BINARY(PARSE_JSON('{"key":"value", "number":123}')) AS binary_variant; ┌──────────────────────────────────────────────────────────────────────────┐ │ binary_variant │ ├──────────────────────────────────────────────────────────────────────────┤ │ 40000002100000031000000610000005200000026B65796E756D62657276616C7565507B │ └──────────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(TO_BITMAP('10,20,30')) AS binary_bitmap; ┌──────────────────────────────────────────────────────────────────────┐ │ binary_bitmap │ ├──────────────────────────────────────────────────────────────────────┤ │ 0100000000000000000000003A3000000100000000000200100000000A0014001E00 │ └──────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOMETRYFROMWKT('SRID=4326;POINT(1.0 2.0)')) AS binary_geometry; ┌────────────────────────────────────────────────────┐ │ binary_geometry │ ├────────────────────────────────────────────────────┤ │ 0101000020E6100000000000000000F03F0000000000000040 │ └────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOGRAPHYFROMEWKT('SRID=4326;POINT(-122.35 37.55)')) AS binary_geography; ┌────────────────────────────────────────────────────┐ │ binary_geography │ ├────────────────────────────────────────────────────┤ │ 0101000020E61000006666666666965EC06666666666C64240 │ └────────────────────────────────────────────────────┘ TRY_TO_BINARY 是 TO_BINARY 的增强版本,它将输入表达式转换为二进制值,如果转换失败则返回 NULL,而不是报错。 SELECT TRY_TO_BINARY(PARSE_JSON(NULL)) AS binary_variant_invalid_json; ┌─────────────────────────────┐ │ binary_variant_invalid_json │ ├─────────────────────────────┤ │ NULL │ └─────────────────────────────┘ 字符串函数:JARO_WINKLER JARO_WINKLER 计算两个字符串之间的 Jaro-Winkler 距离。它通常用于测量字符串之间的相似度,值范围从 0.0(完全不同)到 1.0(完全相同)。 SELECT JARO_WINKLER('databend', 'Databend') AS similarity; ┌────────────────────┐ │ similarity │ ├────────────────────┤ │ 0.9166666666666666 │ └────────────────────┘ SELECT JARO_WINKLER('databend', 'database') AS similarity; ┌────────────┐ │ similarity │ ├────────────┤ │ 0.9 │ └────────────┘ Databend 集成到 DBeaver 24.3.1 Databend 现已在 DBeaver 24.3.1 中获得官方支持,作为 Analytical 数据库的新连接类型: 私有云管控平台 Databend 新增私有云管理平台,实现对私有云部署的 Databend 节点状态的监控和管理。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn/ 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册