首页 文章 精选 留言 我的

精选列表

搜索[产品驱动],共10000篇文章
优秀的个人博客,低调大师

Databend 产品月报(2024年12月)

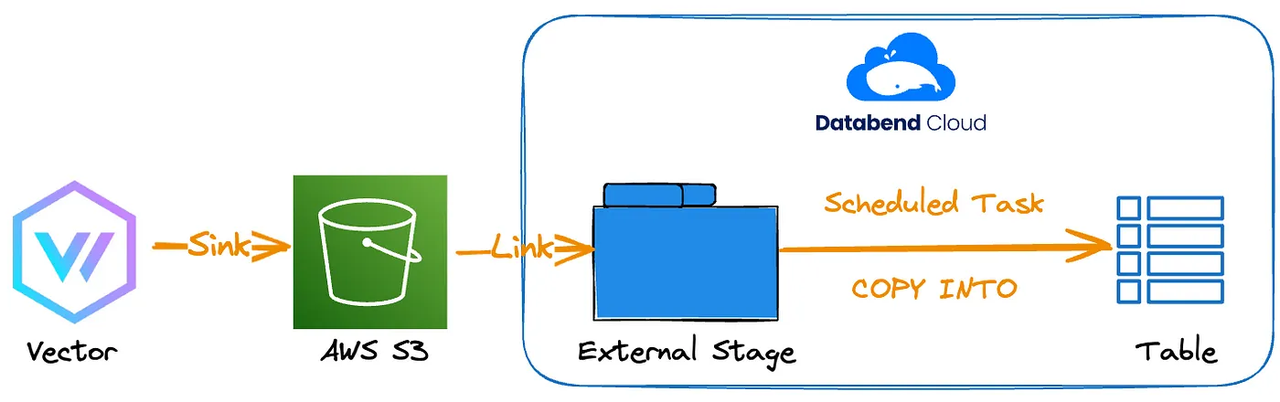
很高兴为您带来 Databend 2024 年 12 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈,祝您新年快乐! 临时表 您现在可以创建一个临时表,该临时表在会话结束时会自动删除。临时表仅在创建它的会话中可见,并在会话结束时自动删除,所有数据都会被清除。要创建临时表,请使用 CREATE TEMP TABLE 命令。 CREATE [ OR REPLACE ] { TEMPORARY | TEMP } TABLE [ IF NOT EXISTS ] [ <database_name>. ]<table_name> ... 新数据类型:INTERVAL INTERVAL 数据类型表示时间长度,允许精确操作和存储跨不同单位的时间间隔。 -- Create a table with one INTERVAL column CREATE OR REPLACE TABLE intervals (duration INTERVAL); -- Insert different types of INTERVAL data INSERT INTO intervals VALUES ('1 year 2 months ago'), -- Natural language format with 'ago' (negative interval) ('1 year 2 months'), -- Natural language format without 'ago' (positive interval) ('1000000'), -- Positive numeric value interpreted as microseconds ('-1000000'); -- Negative numeric value interpreted as microseconds -- Query the table to see the results SELECT * FROM intervals; ┌──────────────────────────┐ │ duration │ ├──────────────────────────┤ │ -1 year -2 months │ │ 1 year 2 months │ │ 0:00:01 │ │ -1 month -1 day -0:00:01 │ └──────────────────────────┘ 自定义聚合函数 现在您可以使用 Python 和 JavaScript 定义自己的聚合函数。 CREATE or REPLACE FUNCTION weighted_avg (INT, INT) STATE {sum INT, weight INT} RETURNS FLOAT LANGUAGE javascript AS $$ export function create_state() { return {sum: 0, weight: 0}; } export function accumulate(state, value, weight) { state.sum += value * weight; state.weight += weight; return state; } export function retract(state, value, weight) { state.sum -= value * weight; state.weight -= weight; return state; } export function merge(state1, state2) { state1.sum += state2.sum; state1.weight += state2.weight; return state1; } export function finish(state) { return state.sum / state.weight; } $$; 新教程:使用 Vector 自动加载 JSON 日志 在本教程中,我们模拟在本地生成日志,使用 Vector 收集日志,将其存储在 S3 中,并使用计划任务自动将其提取到 Databend Cloud 中。请单击此处访问完整教程。 增强对 Parquet 文件处理的支持 我们引入了一些新参数,以便在处理 Parquet 文件时提供更大的灵活性和精确性。 CASE_SENSITIVE参数 CASE_SENSITIVE参数用来决定所查询的Parquet文件中的列名是否区分大小写: CASE_SENSITIVE => false(默认): 列名不区分大小写。例如,b 和 B 被视为相同。 CASE_SENSITIVE => true:列名区分大小写,即只有完全匹配(包括大小写)才有效。例如,如果文件中的列名为 B,则查询 B 会成功,但如果列名为 b,则查询不会成功。 例如,如果在 Parquet 文件中有名为 MinTemp 的列,当 CASE_SENSITIVE 设置为 false 时,可以使用以下语句之一进行查询: SELECT MinTemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT MINTEMP FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT mintemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); 当 CASE_SENSITIVE 设置为 true 时,必须使用文件中出现的准确列名: SELECT `MinTemp` FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>true); 新增 COPY INTO 选项:COLUMN_MATCH_MODE COLUMN_MATCH_MODE 决定 COPY INTO 过程中列名匹配是区分大小写还是不区分大小写(默认)。有关 COPY INTO 选项的完整列表,请参阅 copyOptions。 二进制转换函数:TO_BINARY 和 TRY_TO_BINARY TO_BINARY 将支持的数据类型(包括字符串、变量、位图、几何图形和地理位置)转换为二进制表示(十六进制格式)。 SELECT TO_BINARY('Databend'); ┌───────────────────────┐ │ to_binary('Databend') │ ├───────────────────────┤ │ 4461746162656E64 │ └───────────────────────┘ SELECT TO_BINARY(PARSE_JSON('{"key":"value", "number":123}')) AS binary_variant; ┌──────────────────────────────────────────────────────────────────────────┐ │ binary_variant │ ├──────────────────────────────────────────────────────────────────────────┤ │ 40000002100000031000000610000005200000026B65796E756D62657276616C7565507B │ └──────────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(TO_BITMAP('10,20,30')) AS binary_bitmap; ┌──────────────────────────────────────────────────────────────────────┐ │ binary_bitmap │ ├──────────────────────────────────────────────────────────────────────┤ │ 0100000000000000000000003A3000000100000000000200100000000A0014001E00 │ └──────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOMETRYFROMWKT('SRID=4326;POINT(1.0 2.0)')) AS binary_geometry; ┌────────────────────────────────────────────────────┐ │ binary_geometry │ ├────────────────────────────────────────────────────┤ │ 0101000020E6100000000000000000F03F0000000000000040 │ └────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOGRAPHYFROMEWKT('SRID=4326;POINT(-122.35 37.55)')) AS binary_geography; ┌────────────────────────────────────────────────────┐ │ binary_geography │ ├────────────────────────────────────────────────────┤ │ 0101000020E61000006666666666965EC06666666666C64240 │ └────────────────────────────────────────────────────┘ TRY_TO_BINARY 是 TO_BINARY 的增强版本,它将输入表达式转换为二进制值,如果转换失败则返回 NULL,而不是报错。 SELECT TRY_TO_BINARY(PARSE_JSON(NULL)) AS binary_variant_invalid_json; ┌─────────────────────────────┐ │ binary_variant_invalid_json │ ├─────────────────────────────┤ │ NULL │ └─────────────────────────────┘ 字符串函数:JARO_WINKLER JARO_WINKLER 计算两个字符串之间的 Jaro-Winkler 距离。它通常用于测量字符串之间的相似度,值范围从 0.0(完全不同)到 1.0(完全相同)。 SELECT JARO_WINKLER('databend', 'Databend') AS similarity; ┌────────────────────┐ │ similarity │ ├────────────────────┤ │ 0.9166666666666666 │ └────────────────────┘ SELECT JARO_WINKLER('databend', 'database') AS similarity; ┌────────────┐ │ similarity │ ├────────────┤ │ 0.9 │ └────────────┘ Databend 集成到 DBeaver 24.3.1 Databend 现已在 DBeaver 24.3.1 中获得官方支持,作为 Analytical 数据库的新连接类型: 私有云管控平台 Databend 新增私有云管理平台,实现对私有云部署的 Databend 节点状态的监控和管理。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn/ 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2024年8月)

很高兴为您带来 Databend 2024 年 8 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 Kafka Connect Sink Connector 插件 我们推出了一种将 Kafka 连接到 Databend 的新方式:databend-kafka-connect,这是一个 Kafka Connect sink connector 插件。该插件支持 Append Only 和 Upsert 两种写入模式,并能根据数据的 schema 自动在 Databend 中创建目标表。了解更多详情,请查看文档。 想亲身体验如何将 Kafka 消息加载到 Databend,请探索以下教程: 使用 bend-ingest-kafka 从 Kafka 加载数据:https://docs.databend.cn/tutorials/load/kafka-bend-ingest-kafka 使用 databend-kafka-connect 从 Kafka 加载数据:https://docs.databend.cn/tutorials/load/kafka-databend-kafka-connect 全文模糊搜索 全文搜索函数 MATCH 和 QUERY 现在可以在语法中包括以下选项,以支持模糊搜索: fuzziness: 允许在指定的 Levenshtein 距离内匹配关键字。 operator: 指定多个查询关键字如何组合。可以设置为 OR(默认)或 AND。OR 返回包含任何查询关键字的结果,而 AND 返回包含所有查询关键字的结果。 lenient: 控制在查询文本无效时是否报告错误。默认为 false。如果设置为 true,当查询文本无效时不会报告错误,结果集将为空。 以下是一些简单的例子: 使用模糊度 fuzziness=1 时,查询关键字 "box" 允许匹配像 "fox" 这样的单词,因为 "box" 和 "fox" 的 Levenshtein 距离为 1: SELECT id, score(), content FROM t WHERE match(content, 'box', 'fuzziness=1'); 使用 operator=AND 时,以下查询要求结果中同时包含 "action" 和 "works": SELECT id, score(), content FROM t WHERE query('content:action works', 'fuzziness=1;operator=AND'); 由于 fuzziness=1,它还会匹配像 "Actions" 和 "words" 这样的单词,因此会返回 "Actions speak louder than words"。 FUSE_STATISTIC 新增直方图信息 FUSE_STATISTIC 函数现在包括一个新的统计特性:直方图。这个新功能提供了有关每列数据分布的详细信息: bucket id: 桶的标识符。 min: 桶内的最小值。 max: 桶内的最大值。 ndv (number of distinct values) : 桶内唯一值的计数。 count: 桶内的总值数量。 以下是一个简单的例子: SELECT * FROM FUSE_STATISTIC('default', 'sample'); ┌───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ column_name │ distinct_count │ histogram │ ├─────────────┼────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┤ │ name │ 6 │ [bucket id: 0, min: "Alice", max: "Alice", ndv: 1.0, count: 1.0], [bucket id: 1, min: "Bob", max: "Bob", ndv: 1.0, count: 1.0], [bucket id: 2, min: "Charlie", max: "Charlie", ndv: 1.0, count: 1.0], [bucket id: 3, min: "Diana", max: "Diana", ndv: 1.0, count: 1.0], [bucket id: 4, min: "Eve", max: "Eve", ndv: 1.0, count: 1.0], [bucket id: 5, min: "Frank", max: "Frank", ndv: 1.0, count: 1.0] │ │ age │ 5 │ [bucket id: 0, min: "25", max: "25", ndv: 1.0, count: 1.0], [bucket id: 1, min: "28", max: "28", ndv: 1.0, count: 1.0], [bucket id: 2, min: "28", max: "28", ndv: 1.0, count: 1.0], [bucket id: 3, min: "30", max: "30", ndv: 1.0, count: 1.0], [bucket id: 4, min: "35", max: "35", ndv: 1.0, count: 1.0], [bucket id: 5, min: "40", max: "40", ndv: 1.0, count: 1.0] │ │ user_id │ 6 │ [bucket id: 0, min: "1", max: "1", ndv: 1.0, count: 1.0], [bucket id: 1, min: "2", max: "2", ndv: 1.0, count: 1.0], [bucket id: 2, min: "3", max: "3", ndv: 1.0, count: 1.0], [bucket id: 3, min: "4", max: "4", ndv: 1.0, count: 1.0], [bucket id: 4, min: "5", max: "5", ndv: 1.0, count: 1.0], [bucket id: 5, min: "6", max: "6", ndv: 1.0, count: 1.0] │ └───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ Databend Cloud 体验优化 我们给 Databend Cloud 带来了一些新功能,准备好迎接更棒的体验吧! 您现在可以将工作区分享给您组织中的所有人或特定的个人。 支持对计算集群进行批量重启、批量挂起、批量恢复和批量删除操作。 新 SQL 函数 我们新增了一些SQL函数: JQ : 允许您对存储在 Variant 列中的 JSON 数据应用 jq 过滤器。 JSON_OBJECT_AGG : 将键值对转换为 JSON 对象。 JSON_ARRAY_AGG : 将值转换为 JSON 数组,同时跳过 NULL 值。 MONTHS_BETWEEN : 返回两个日期之间相隔的月份个数. 性能优化 了解我们最新的改进,这些提升使 Databend 更加高效、精确和可靠: 全局计划缓存: 引入了SQL执行计划缓存功能,通过缓存和重用查询计划,加速重复查询的处理,提升性能 十进制计算: 修复了十进制乘法问题,确保计算结果始终精确。 UDF 执行: 优化了 JavaScript 运行时,减少了延迟,提高了用户自定义函数的执行速度。 网络操作: 改进了对网络错误的处理,使 Databend 在分布式环境中更具韧性。 JOIN 性能: 提升了 JOIN 操作的效率,特别是在集群模式下,加快了查询处理速度,减少了复杂查询的延迟。

优秀的个人博客,低调大师

Go 大数据生态迎来重要产品 CDS

项目地址: https://github.com/tal-tech/cds https://gitee.com/zeromicro/cds ClickHouse是一个用于联机分析(OLAP)的列式数据库管理系统(DBMS)。它有着优异的性能,可以快速部署和运行。 不过要想使用ClickHouse搭建起数仓用于数据分析,一个重要的问题就是数据如何进入ClickHouse? 我们希望数据源的变化能够自动实时地被同步到ClickHouse,而且支持方便的动态的添加新的数据源(新的数据库,表), 能够自动的生成对应数据源的schema。 go-zero团队使用go语言围绕ClickHouse开发了一些方便的组件与服务。 我们得到了下面这样的数据同步设计 该数据同步系统大致由以下三部分组成 DM 全量同步服务 github.com/tal-tech/cds/dm RTU 实时增量同步服务 github.com/tal-tech/cds/rtu Galaxy 网页控制台服务 github.com/tal-tech/cds/galaxy 流程如下: 用户可以在网页控制台添加数据源,自动生成DDL,添加同步任务,该任务会被发送到etcd。 dm会收到全量同步的通知,执行历史数据的全量同步工作。 之后网页控制台服务会指定connector开启数据库log监听工作,数据会进入kafka。 监听etcd集群的RTU实时增量同步服务服务会发现有新的任务,RTU自动领取任务,到kafka消费数据并同步至ClickHouse。 上述服务的开发使用了go语言。借助于go-zero中的工具包,如goctl等, 我们快速实现了它。它还加入了支持自适应mongoDB结构变化,支持数据分表等。 我们相信这是go语言与ClickHouse探索大数据的一个不错的起点,我们希望有更多的人能够参与进来。 CDS项目地址: https://github.com/tal-tech/cds https://gitee.com/zeromicro/cds go-zero项目地址: https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎大家 star 并加入微信社区 🤝

优秀的个人博客,低调大师

存储产品线案例与实践总览

根据IDC的相关预测,全球数据圈将从2018年的33ZB增至2025年的175ZB,实现5倍以上的增长。预计到 2025年,中国数据圈将增至48.6ZB,占全球数据圈的27.8%。随着数据的快速增长以及数据生态圈的日益丰富,“存储-使用-管理”全数据生命周期中的每一个环节都承载着用户的审视和考验,而存储则是数据生态产业链中至关重要的一环。阿里云从行业场景出发,基于用户痛点深耕技术细节,为数据价值保驾护航。 日志服务 行业领先的日志大数据解决方案,一站式提供数据收集、清洗、分析、可视化和告警功能。全面提升海量日志处理能力,实时挖掘数据价值,智能助力研发/运维/运营/安全等场景。(1)云原生架构助力花生日记双11大促如何稳定度过双11大促一直是花生日记的痛点,架构转到云原生微服务体系后系统整体的弹性能力得到了很大提升,助双十一支撑了平时6

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册