首页 文章 精选 留言 我的

精选列表

搜索[javascript引擎],共10000篇文章
优秀的个人博客,低调大师

JavaScript 的Decorator 装饰器介绍

Angular大量使用了JS的装饰器特性,先看 ruanyifeng的介绍 使用babel转换 步骤 : npm install -g babel-cli npm init; npm install --save-dev babel-plugin-transform-decorators-legacy babel --plugins transform-decorators-legacy 1.js > 1.es5.js 例1 @eat class Person { constructor() {} } function eat(target, key, descriptor) { console.log('吃饭'); console.log(target); console.log(key); console.log(descriptor); target.prototype.act = '我要吃饭'; } const jack = new Person(); console.log(jack.act); 转换后 var _class; let Person = eat(_class = class Person { constructor() {} }) || _class; function eat(target, key, descriptor) { console.log('吃饭'); console.log(target); console.log(key); console.log(descriptor); target.prototype.act = '我要吃饭'; } const jack = new Person(); console.log(jack.act); // 吃饭 // [Function: Person] // undefined // undefined // 我要吃饭 例2 function mixins(...list) { return function (target) { Object.assign(target.prototype, ...list); }; } const Foo = { foo() { console.log('foo') } }; @mixins(Foo) class MyClass {} let obj = new MyClass(); obj.foo() // "foo" babel 后 var _dec, _class; function mixins(...list) { return function (target) { Object.assign(target.prototype, ...list); }; } const Foo = { foo() { console.log('foo'); } }; let MyClass = (_dec = mixins(Foo), _dec(_class = class MyClass {}) || _class); let obj = new MyClass(); obj.foo(); // "foo"

优秀的个人博客,低调大师

JavaScript 基础排序的实现(二)

继上一篇O(n^2)的排序算法后,这一篇主要记录O(n*logn)的排序算法 1.快排(快速排序) 这一算法的核心思想为,先随机选一个数作为标兵或者说是标记(这个数一般来说选择该无序数组的中间那个元素;此处笔者选取第一个实现算法,当选取完毕后以此标兵为参照将比这个数大的放到他的右边,比他小的放到左边.这样一趟排序过后就能让这个标记左边的数比他小,右边的数都比他大.下一趟排序则分别选取他的左半边数组和右半边数组重复之前的操作(此操作一般由递归实现)当传入的区间只有一个元素的时候那么开始返回不再继续调用函数自身(即为递归的终止条件)因为只有一个数字是必定有序的 递归实现代码如下: //快速排序(递归) function QuickSort(arr,start = 0,end = arr.length-1){ if(start<end){//递归结束条件 let [key,l,r] = [parseInt((start+end)/2),start,end];//key为标记的值,l和r 分别表示左边的下标和右边的下标 while(l<r){//当左右下标相遇即完成一趟排序,停止循环 while(l<r && arr[r] >= key){//从后往前找,如果对应下标的数比标记大则不做操作,下标继续前移 r--; }//循环完成此时arr[r] //而arr[l]的的值已经被key保存所以下一步则应该找出一个比key大却在key的左边的数放入arr[r]的位置 while(l<r && arr[l] <= key){ l++; } [arr[r],arr[l]] = [arr[l],arr[r]]; //这样一次循环就可以让一个在key左边比key大的数放到key的右边,比key小的放到左边 } QuickSort(arr,start,l-1);//递归调用 -1 是为了避免区间重复 QuickSort(arr,l+1,end); } } 下图为将十万倒序数组变为正序的耗费时间: 下面列出非递归版本的快排: function QuickSort2(arr,start = 0,end = arr.length-1){ let mid = [start,end];//建立一个数组用于存放需要快排的区间的参数,这样循环调用即可 if(start<end){ while(mid.length){//当参数数组中没有参数则停止循环 let [l,r] = [mid.shift(),mid.shift()];//取出数组中最前面的两个数,并对此区间上的数进行快排 let [low,height] = [l,r]; let key = arr[parseInt((l+r)/2)];//选取标兵 while(l<r){ while(l<r && arr[r] >= key){ r--; } arr[l] = arr[r]; while(l<r && arr[l] <= key){ l++; } arr[r] = arr[l]; arr[l] = key; } //当两个参数不相等,即该区间不止一个数时,则将下一个区间的参数存入参数数组 if(low<l) mid.push(low,l); if(l+1<height) mid.push(l+1,height); } } } 对十万逆序数组排序耗时如下: 由于非递归版本数组方法调用较多,故此花费时间略久于递归版本 2.希尔排序 希尔排序和快排一样都是不稳定排序,快速排序的不稳定是因为,标兵的选取并不能直接选取到刚好是区间中中间大小的数,所以当每个区间的第一个数刚好都是该区间最小的数,那么达到快排的最坏情况(以区间的第一个数为标兵为例).而希尔排序其核心是插入排序所以当数组刚好为逆序时其效率最低,此时也就是希尔排序的最坏情况但与快排不同的是最坏情况的希尔排序速率并不会下降明显. 希尔排序算法的和心在于,利用了当待排序数组基本有序的时候插入排序效率极高的原理,即选取不同的步长对其进行插排,当步长为一时则与普通的插排没有区别,而效率的提升在于经过前期数次的插排使数组基本有序 其代码如下: function ShellSort(arr) { let steep = parseInt(arr.length / 2);//计算步长 let length = arr.length; let tarr = [];//用于存放按步长分出的数组的临时数组 while (steep) { //只有步长大于1才分组 否则直接插排 if ( steep > 1) { for (let i = 0; i < steep; i++) { //此循环将数组分组 for (let j = i; j < length; j = j + steep) { tarr.push(arr[j]); } InsertionSort(tarr);//将分好组的数组进行插排 for (let j = i; j < length; j = j + steep) { arr[j] = tarr.shift(); } //排好序的数组映射回原数组 tarr.length = 0;//清空临时数组 } }else InsertionSort(arr); steep = parseInt(steep / 2); } } 普通插排耗时如下: 希尔排序耗时如下: 3.归并排序 与快排和希尔排序不同的是归并排序是稳定排序 其核心思想在于当数组只有一个数时肯定是有序的,所以现将数组拆分为一个一个的数,然后在合并的过程中对齐排序,其弊端在于需要占用一个与原数组等长的临时数组空间来存放变量 递归版代码如下: //归并排序(递归) function Merge(arr,start,mid,end,temp) {//此函数用于合并数组 let [l,r] = [start,mid+1];//l标示左边需合并数组的初始下标,r同理标示右边数组的初始下标 while(l<=mid && r <= end){ if(arr[l]<=arr[r]) temp.push(arr[l++]); else temp.push(arr[r++]); } while(l<=mid){ temp.push(arr[l++]); } while(r<=end){ temp.push(arr[r++]); } while(start<=end){//将排好的临时数组中的数据复制回原数组 arr[start++] = temp.shift(); } } function RecursiveSort(arr,start = 0,end = arr.length-1,temp = []){ if(start < end){ let mid = parseInt((start+end)/2);//将数组分为两半 RecursiveSort(arr,start,mid,temp); RecursiveSort(arr,mid+1,end,temp); Merge(arr,start,mid,end,temp);//递归的回调途中进行数组的合并 } } 递归版耗时: 非递归代码: function RecursiveSort2(arr,start = 0,end = arr.length-1){ let mid = [start,end]; let pra = []; while(mid.length){//获取参数列表 let [l,r] = [mid.shift(),mid.shift()]; pra.push(l,r); let m = parseInt((l+r)/2); if(m>l) mid.push(l,m); if(r>m+1) mid.push(m+1,r); } while(pra.length){ let [r,l] = [pra.pop(),pra.pop()]; let m = parseInt((l+r)/2); Merge(arr,l,m,r,[]); //此函数见上文 } } 非递归耗时如下: 总结: 快排在数据量大时的优势较为明显,希尔排序适用于中量数据,而当空间要求不限时归并也不失为一种选择
优秀的个人博客,低调大师

JavaScript 基础排序的实现(一)

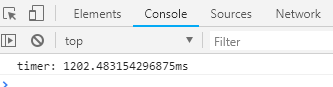
作为一个有追求的前端,忙里偷闲(闲得发慌)地复习了一下基础的排序算法,以此文留念. 本篇主要记录O(n²)复杂度的基础算法O(nlogn)的算法将在下次有空(闲得发慌)时更新 在记录时发现Es6语法中的解构赋值与传统的中间变量交换相比效率低下,经过几次测试发现其耗时大约为交换中间变量的两倍 1.冒泡排序 众所周知排序最基础的算法,也就是大名鼎鼎的冒泡了,为了方便日后回顾还是简单提一下冒泡的原理: 其核心思想在于不停地比较相邻元素的大小关系,如果前面的比后面的大则两个元素互换位置(此处以顺序为例);每当一次大的循环后总能将当前剩余数中最大的数交换到数组的末尾,类似于一个泡泡从底部浮出水面,故得名冒泡算法.下方代码为未使用任何优化的原始冒泡算法. 其时间复杂度为O(n²)不需要额外空间; 1 //冒泡排序 2 function BubbleSort(arr) {//arr即需要排序的数组;本文后续中的arr均为此意 3 console.time('timer');//用于统计代码执行时间 4 for (let i = 0; i < arr.length; i++) { 5 for (let j = 0; j < arr.length; j++) { 6 if (arr[j] > arr[j + 1]) 7 [arr[j], arr[j + 1]] = [arr[j + 1], arr[j]];//交换元素(解构赋值ES6) 8 } 9 } 10 console.timeEnd('timer'); 11 } 以一万个数构成的倒序(从大到小)数组变为顺序的时间如下图(与个人电脑及其它因素有关请勿较真)用解构赋值交换: 后续算法的时间均以同一数组测试 2.鸡尾酒排序 这种排序算法乃是对冒泡算法的一种小优化,其与冒泡的区别在于,在一趟排序中可以将一个最大的移到后端,同时将一个最小的移到前端,从而对冒泡算法进行优化 核心代码如下: //鸡尾酒排序 function CocktailSort(arr) { console.time('timer'); let [start, end] = [0, arr.length]; while (start < end) { //此循环与正常冒泡一致 for (let i = start; i < end; i++) { if (arr[i] > arr[i + 1]) [arr[i], arr[i + 1]] = [arr[i + 1], arr[i]]; } end--;//由于数组最后一位已经是最大的所以没有必要再让其参与后续的排序 for (let i = end - 1; i >= start; i--) { if (arr[i] < arr[i - 1]) [arr[i], arr[i - 1]] = [arr[i - 1], arr[i]]; } start++; } console.timeEnd('timer'); } 耗费时间如下 由于其本质与冒泡算法类似,虽然好上些许,但其本质仍为O(n²)的时间复杂度故时间并未得到太大的缩减(由于解构赋值的原因优化后的算法还不如不优化,是真的骚) 3.选择排序 选择排序也是大家所熟知的一种基础算法,其核心在于每一次选出最小(或最大)的一个数放到已经有序的数列后,经过如此重复操作后获得有序的数列 代码如下: //选择排序 function SelecttionSort(arr) { console.time('timer'); for (let i = 0; i < arr.length; i++) { let min = i;//min表示当前最小值的下标 for (let j = i + 1; j < arr.length; j++) { min = arr[j] < arr[min] ? j : min; //如果当前下标的值比arr[min]的值要小则以当前值替换 } [arr[i], arr[min]] = [arr[min], arr[i]]; } console.timeEnd('timer'); } 花费时间如下: 按理说同为n平方的复杂度时间耗费应该相差不大才对,结果由于交换次数的减少导致耗时大幅下降,感觉Js在这方面效率有点低 4.插入排序 插入排序的原理为将当前下标的数插入之前已经有序的数列中,从后往前遍历找到合适的位置后将值插入,并将该位置之后的元素依次后移从而进行排序 代码如下: function InsertionSort(arr) { console.time('timer'); for (let i = 1; i < arr.length; i++) { for (let j = i; j > 0 && arr[j] < arr[j - 1]; j--) { [arr[j], arr[j - 1]] = [arr[j - 1], arr[j]]; } } console.timeEnd('timer'); } 同数组耗时如下: 总结:在Js的情况下交换数据应尽量少的使用解构赋值,虽然其便利性很强,但是当网页对性能要求较高时应减少解构赋值的使用,如果非用不可,在同等级时间复杂度算法的情况下应使用数字交换次数少的算法以提升页面性能

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码