[Python爬虫]通过分析胸罩销售记录 发现了惊人的秘密
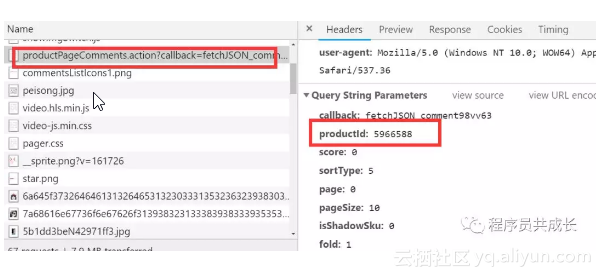
打开开发者工具-network,在用户评价页面我们发现浏览器有这样一个请求 通过分析我们发现主要用的参数有三个productId,page,pageSize。后两个为分页参数,productId是每个商品的id,通过这个id去获取商品的评价记录,所以我们只需要知道每个商品的productId就轻而易举的获取评价了。再来分析搜索页面的网页源代码 通过分析我们发现每个商品都在li标签中,而li标签又有一个data-pid属性,这个对应的值就是商品的productId了。 大概了解了整个流程,就可以开始我们的爬虫工作了。 首先我们需要在搜索页面获取商品的id,为下面爬取用户评价提供productId。key_word为搜索的关键字,这里就是【胸罩】 import requestsimport re""" 查询商品id """def find_product_id(key_word): jd_url = 'https://search.jd.com/Search' product_ids = []# 爬前3页的商品for i in range(1,3): param = {'keyword': key_word, 'enc': 'utf-8', 'page': i} response = requests.get(jd_url, params=param)# 商品id ids = re.findall('data-pid="(.*?)"', response.text, re.S) product_ids += idsreturn product_ids 将前三页的商品id放入列表中,接下来我们就可以爬取评价了 我们通过分析preview发现获取用户评价这个请求响应的格式是一个字符串后面拼接了一个json(如下图),所以我们只要将无用的字符删除掉,就可以获取到我们想要的json对象了。 而在json对象中的comments的内容就是我们最终想要的评价记录 """ 获取评论内容 """def get_comment_message(product_id): urls = ['https://sclub.jd.com/comment/productPageComments.action?' \'callback=fetchJSON_comment98vv53282&' \'productId={}' \'&score=0&sortType=5&' \'page={}' \'&pageSize=10&isShadowSku=0&rid=0&fold=1'.format(product_id, page) for page in range(1, 11)]for url in urls: response = requests.get(url) html = response.text# 删除无用字符 html = html.replace('fetchJSON_comment98vv53282(', '').replace(');', '') data = json.loads(html) comments = data['comments'] t = threading.Thread(target=save_mongo, args=(comments,)) t.start()在这个方法中只获取了前10页的评价的url,放到urls这个列表中。通过循环获取不同页面的评价记录,这时启动了一个线程用来将留言数据存到到MongoDB中。 我们继续分析评价记录这个接口发现我们想要的两条数据 productColor: 产品颜色 productSize: 产品尺寸 # mongo服务 client = pymongo.MongoClient('mongodb://127.0.0.1:27017/')# jd数据库 db = client.jd# product表,没有自动创建 product_db = db.product# 保存mongodef save_mongo(comments):for comment in comments: product_data = {}# 颜色# flush_data清洗数据的方法 product_data['product_color'] = flush_data(comment['productColor'])# size product_data['product_size'] = flush_data(comment['productSize'])# 评论内容 product_data['comment_content'] = comment['content']# create_time product_data['create_time'] = comment['creationTime']# 插入mongo product_db.insert(product_data)因为每种商品的颜色、尺寸描述上有差异,为了方面统计,我们进行了简单的数据清洗。 def flush_data(data):if '肤' in data:return '肤色'if '黑' in data:return '黑色'if '紫' in data:return '紫色'if '粉' in data:return '粉色'if '蓝' in data:return '蓝色'if '白' in data:return '白色'if '灰' in data:return '灰色'if '槟' in data:return '香槟色'if '琥' in data:return '琥珀色'if '红' in data:return '红色'if '紫' in data:return '紫色'if 'A' in data:return 'A'if 'B' in data:return 'B'if 'C' in data:return 'C'if 'D' in data:return 'D'这几个模块的功能编写完毕,下面只需要将他们联系起来 # 创建一个线程锁 lock = threading.Lock()# 获取评论线程def spider_jd(ids):while ids:# 加锁 lock.acquire()# 取出第一个元素 id = ids[0]# 将取出的元素从列表中删除,避免重复加载del ids[0]# 释放锁 lock.release()# 获取评论内容 get_comment_message(id) product_ids = find_product_id('胸罩')for i in (1, 5):# 增加一个获取评论的线程 t = threading.Thread(target=spider_jd, args=(product_ids,))# 启动线程 t.start()上面代码加锁的原因是为了防止重复消费共享变量 【Python】学习多线程,真的就这么简单! 运行之后的查看MongoDB: 得到结果之后,为了能更直观的表现数据,我们可以用matplotlib库进行图表化展示 import pymongofrom pylab import * client = pymongo.MongoClient('mongodb://127.0.0.1:27017/')# jd数据库 db = client.jd# product表,没有自动创建 product_db = db.product# 统计以下几个颜色 color_arr = ['肤色', '黑色', '紫色', '粉色', '蓝色', '白色', '灰色', '香槟色', '红色'] color_num_arr = []for i in color_arr: num = product_db.count({'product_color': i}) color_num_arr.append(num)# 显示的颜色 color_arr = ['bisque', 'black', 'purple', 'pink', 'blue', 'white', 'gray', 'peru', 'red']#labeldistance,文本的位置离远点有多远,1.1指1.1倍半径的位置#autopct,圆里面的文本格式,%3.1f%%表示小数有三位,整数有一位的浮点数#shadow,饼是否有阴影#startangle,起始角度,0,表示从0开始逆时针转,为第一块。一般选择从90度开始比较好看#pctdistance,百分比的text离圆心的距离#patches, l_texts, p_texts,为了得到饼图的返回值,p_texts饼图内部文本的,l_texts饼图外label的文本 patches,l_text,p_text = plt.pie(sizes, labels=labels, colors=colors, labeldistance=1.1, autopct='%3.1f%%', shadow=False, startangle=90, pctdistance=0.6)#改变文本的大小#方法是把每一个text遍历。调用set_size方法设置它的属性for t in l_text: t.set_size=(30)for t in p_text: t.set_size=(20)# 设置x,y轴刻度一致,这样饼图才能是圆的 plt.axis('equal') plt.title("内衣颜色比例图", fontproperties="SimHei") # plt.legend() plt.show()运行代码,我们发现肤色的最受欢迎 其次是黑色 (钢铁直男表示不知道是不是真的...) 接下来我们再来统计一下size 的分布图,这里用柱状图进行显示 index=["A","B","C","D"] client = pymongo.MongoClient('mongodb://127.0.0.1:27017/') db = client.jd product_db = db.product value = []for i in index: num = product_db.count({'product_size': i}) value.append(num) plt.bar(left=index, height=value, color="green", width=0.5) plt.show() 运行后我们发现 B size的女性更多一些 原文发布时间为:2018-09-13 本文作者: 本文来自云栖社区合作伙伴“ 程序员共成长”,了解相关信息可以关注“ 程序员共成长”。 以上结果仅供学习参考哦~