首页 文章 精选 留言 我的

精选列表

搜索[文档管理],共10000篇文章
优秀的个人博客,低调大师

akka文档(java)——akka的用例示例

我们看到akka正被许多大型组织所采用,已被广泛应用于投资与商业银行业务,零食与社交媒体,虚拟仿真,游戏与博彩,数据分析等等行业。任何需要高吞吐量和低延迟的系统都是使用akka的良好候选者。 这里有一些良好的关于akka用例的讨论以及在生产环境的使用评论。 下面是一些已将akka部署到生产环境的领域 事务处理(在线游戏,金融、银行,贸易,统计,博彩,社会化媒体,电信) 纵向扩展,横向扩展,容错/HA 后端服务 (任何行业,任何应用) REST服务, SOAP, Cometd, WebSockets等,充当信息枢纽/集成层纵向扩展 、横向扩展,容错/HA 并发/并行性(任何应用) 简单正确的使用与理解akka仅仅是将它的jar添加到你的JVM工程(使用Scala、Java、Groovy或JRuby) 虚拟仿真 主/从,计算风格,MapReduce等 批处理(任何行业) Camel与批量数据源整合,角色对工作负载分而治之 通讯枢纽(电信、网络媒体、移动媒体) 纵向扩展,横向扩展,容错/HA 游戏与博彩(MOM(消息中间件),网络游戏,博彩) 纵向扩展,横向扩展,容错/HA 商业智能/数据挖掘/通用运算 纵向扩展,横向扩展,容错/HA 复杂的事件流处理 纵向扩展,横向扩展,容错/HA 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Ack 框架的实现

Storm 的acker使用哈希校验和来跟踪每个 tuple 树的完成情况:每个 tuple 在被发送出的时候,它的值会与校验和进行异或运算,然后在 tuple 被 ack 的时候这个值又会再次与校验和进行异或运算。这样,一旦所有的 tuple 都被成功 ack,校验和就会变为 0(随机生成的校验和为 0 的概率极小,可以忽略不计)。 你可以在wiki中了解更多关于可靠性机制的信息。 ackerexecute() Acker 实际上也是一个 bolt,它的execute 方法是定义在mk-acker-bolt中的。在一个新的 tuple 树生成的时候,spout 为每个 tuple 发送一个用于异或的固有 id,acker 会将这些 id 记录在它的挂起队列中。每次 executor ack 一个 tuple 的时候,acker 会接收到一个部分校验和,这个校验和是 tuple 自身的 id(将其从挂起队列中清除)和 executor 发送的每个下游 tuple 的 id(放入挂起队列中)的异或值。 这个过程是这样的: 在接收到 tick tuple 信号的时候,将 tuple 树的校验值向超时方向移动并且返回。同时,在 tuple 树中更新或者创建一个记录。 初始化阶段:使用指定的校验和值进行初始化,并且记录 spout 的 id; ack 阶段:将部分校验和与当前的校验和进行异或运算; fail 阶段:仅仅将 tuple 标记为 failed 状态。 接下来,将记录存入RotatingMap(重新设置超时计数值)并且继续以下过程: 如果总校验和为 0, 表明 tuple 树已经完成:将记录从挂起队列中移除,并通知 spout 处理成功; 如果 tuple 树失败了,也会有一种完成状态:将记录从挂起队列中移除,并通知 spout 处理失败。 最后,发送一个我们自己的 ack 信号。 挂起 tuples 与RotatingMap Acker 将挂起树存放在一个RotatingMap中。RotatingMap是一个在 Storm 中多处使用的简单工具,它主要用于高效地处理过程的超时。 RotatingMap 与 HashMap 类似,支持 O(1) 时间的 get 操作。 在 RotatingMap 内部有多个 HashMap(称为槽,buckets),每个 HashMap 都保存有一群会在同一时间超时的记录。我们称存在时间最长的 bucket 为死亡牢房(death row),而访问最多的 bucket 称为苗圃(nursery)。一个新的值在被.put()到 RotatingMap 中,它都会被重定位到 nursery 中,并且从其他的它之前可能在的 bucket 中移除(这是一种高效的重新设置延时时间的方法)。 在 RotatingMap 的所有者调用.rotate()方法的时候,RotatingMap 会将每个 bucket 向着超时的方向移动一步(一般 Storm 对象会在收到一个系统 tick 流 tuple 的时候调用 rotate 方法)。如果此时在前面所说的 death row bucket 中有 key-value 键值对,RotatingMap 会为每个 key-value 键值对触发一个回调函数(在构造器中定义的),让他们的所有者选择一个合适的操作(例如,将 tuple 标记为处理 转载自并发编程网 - ifeve.com 失败)。

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 分布式 RPC

分布式 RPC(DRPC)的设计目标是充分利用 Storm 的计算能力实现高密度的并行实时计算。Storm 接收若干个函数参数作为输入流,然后通过 DRPC 输出这些函数调用的结果。严格来说,DRPC 并不能算作是 Storm 的一个特性,因为它只是一种基于 Storm 原语 (Stream、Spout、Bolt、Topology) 实现的计算模式。虽然可以将 DRPC 从 Storm 中打包出来作为一个独立的库,但是与 Storm 集成在一起显然更有用。 概述 DRPC 是通过一个 DRPC 服务端(DRPC server)来实现分布式 RPC 功能的。DRPC server 负责接收 RPC 请求,并将该请求发送到 Storm 中运行的 Topology,等待接收 Topology 发送的处理结果,并将该结果返回给发送请求的客户端。因此,从客户端的角度来说,DPRC 与普通的 RPC 调用并没有什么区别。例如,以下是一个使用参数 “http://twitter.com”调用 “reach” 函数计算结果的例子: DRPCClient client = new DRPCClient("drpc-host", 3772); String result = client.execute("reach", "http://twitter.com"); 下图是 DRPC 的原理示意图。 客户端通过向 DRPC 服务器发送待执行函数的名称以及该函数的参数来获取处理结果。实现该函数的拓扑使用一个DRPCSpout从 DRPC 服务器中接收一个函数调用流。DRPC 服务器会为每个函数调用都标记了一个唯一的 id。随后拓扑会执行函数来计算结果,并在拓扑的最后使用一个名为ReturnResults的 bolt 连接到 DRPC 服务器,根据函数调用的 id 来将函数调用的结果返回。 定义 DRPC 拓扑 可以直接使用普通的拓扑构造方法来构造 DRPC 拓扑,如下所示: public static class ExclaimBolt extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String input = tuple.getString(1); collector.emit(new Values(tuple.getValue(0), input + "!")); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("id", "result")); } } public static void main(String[] args) throws Exception { TopologyBuilder builder = new TopologyBuilder(); // builder.setSpout(drpcSpout); // builder.setBolt(new ExclaimBolt(), 3); // submit(builder.createTopology()); } 本地模式 DRPC DRPC 可以在本地模式下运行。以下是使用本地模式构造拓扑的例子: LocalDRPC drpc = new LocalDRPC(); DRPCSpout spout = new DRPCSpout("exclamation", drpc); builder.setSpout("drpc", spout); builder.setBolt("exclaim", new ExclaimBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 3) .shuffleGrouping("exclaim"); LocalCluster cluster = new LocalCluster(); Config conf = new Config(); cluster.submitTopology("drpc-demo", conf, builder.createTopology()); // local mode 测试代码 System.out.println(drpc.execute("exclamation", "hello")); cluster.shutdown(); drpc.shutdown(); 在这种模式下,首先你会创建一个LocalDPRC对象,该对象会在进程中模拟一个 DRPC 服务器,其作用类似于LocalCluster在进程中模拟 Storm 集群的功能。在定义好拓扑的各个组件之后,就可以使用LocalCluster来提交拓扑。在本地模式下LocalDPRC对象不会绑定到任何一个实际的端口,所以需要通过向DRPCSpout传入参数的方式来关联到拓扑中。 在启动拓扑后,你可以使用execute方法来完成 DRPC 调用。 远程模式 DRPC 在一个实际的集群中使用 DRPC 有以下三个步骤: 配置并启动 DRPC 服务器; 在集群的各个服务器上配置 DRPC 服务器的地址; 将 DRPC 拓扑提交到集群运行。 可以像 Nimbus、Supervisor 那样使用storm命令来启动 DRPC 服务器(注意,此 server 的基本配置,如 nimbus,ZooKeeper 等参数应该与 Storm 集群其他机器相同): bin/storm drpc 接下来,你需要在集群的各个服务器上配置 DRPC 服务器的地址。这是为了让DRPCSpout了解从哪里获取函数调用的方法。可以通过编辑storm.yaml或者添加拓扑配置的方式实现配置。配置storm.yaml的方式类似于下面这样: drpc.servers: - "drpc1.foo.com" - "drpc2.foo.com" 最后,你可以像其他拓扑一样使用StormSubmitter来启动拓扑。 以下是使用远程模式构造拓扑的一个例子: TopologyBuilder builder = new TopologyBuilder(); DRPCSpout spout = new DRPCSpout("exclamation"); builder.setSpout("drpc", spout, 3); builder.setBolt("exclaim", new ExclamationBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 7) .shuffleGrouping("exclaim"); Config conf = new Config(); conf.setNumWorkers(2); StormSubmitter.submitTopology("drpc-demo", conf, builder.createTopology()); 更复杂的例子 请参考Trident 教程一文中计算指定 URL 的 Reach 数的例子。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 命令行操作

本文介绍了 Storm 命令行客户端中的所有命令操作。如果想要了解怎样设置你的 Strom 客户端和远程集群的交互,请按照配置开发环境一文中的步骤操作。 Storm 中支持的命令包括: jar kill activate deactivate rebalance repl classpath localconfvalue remoteconfvalue nimbus supervisor ui drpc jar 语法:storm jar topology-jar-path class ... 使用指定的参数运行 main 方法(也就是打包好的拓扑 jar 包中的 main 方法)。Storm 所需要的 jar 包和配置信息都在类路径(classpath)中。这个运行过程已经配置好了,这样StormSubmitter就可以在提交拓扑的时候将topology-jar-path中的 jar 包上传到集群中。 kill 语法:storm kill topology-name [-w wait-time-secs] 杀死集群中正在运行的名为topology-name的拓扑。执行该操作后,Storm 首先会注销拓扑中的 spout,使得拓扑中的消息超时,这样当前的所有消息就会结束执行。随后,Storm 会将所有的 worker 关闭,并清除他们的状态。你可以使用-w参数来调整 Storm 在注销与关闭拓扑之间的间隔时间。 activate 语法:storm activate topology-name 激活运行指定拓扑的所有 spout。 deactivate 语法:storm deactivate topology-name 停止指定拓扑的所有 spout 的运行。 rebalance 语法:storm rebalance topology-name [-w wait-time-secs] 有些场景下需要对正在运行的拓扑的工作进程(worker)进行弹性扩展。例如,加入你有 10 个节点,每个节点上运行有 4 个 worker,现在由于各种原因你需要为集群添加 10 个新节点。这时你就会希望通过扩展正在运行的拓扑的 worker 来使得每个节点只运行两个 worker,降低集群的负载。实现这个目的的一种直接的办法是 kill 掉正在运行的拓扑,然后重新向集群提交。不过 Storm 提供了再平衡命令可以以一种更简单的方法实现目的。 再平衡首先会在一个超时时间内(这个时间是可以通过-w参数配置的)注销掉拓扑,然后在整个集群中重新分配 worker。接着拓扑就会自动回到之前的状态(也就是说之前处于注销状态的拓扑仍然会保持注销状态,而处于激活状态的拓扑则会返回激活状态)。 repl 语法:storm repl 打开一个带有类路径上的 jar 包和配置信息的 Clojure 的交互式解释器(REPL)。该命令主要用于调试。 classpath 语法:storm classpath 打印客户端执行命令时使用的类路径环境变量。 localconfvalue 语法:storm localconfvalue conf-name 打印出本地 Storm 配置中conf-name属性的值。这里的本地配置指的是~/.storm/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。 remoteconfvalue 语法:storm remoteconfvalue conf-name 打印出集群配置中conf-name属性的值。这里的集群配置指的是$STORM-PATH/conf/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。该命令必须在一个集群机器上执行。 nimbus 语法:storm nimbus 启动 nimbus 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 supervisor 语法:storm supervisor 启动 supervisor 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 ui 语法:storm ui 启动 UI 后台进程。UI 提供了一个访问 Storm 集群的 Web 接口,其中包含有运行中的拓扑的详细信息。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 drpc 语法:storm drpc 启动 DRPC 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考分布式 RPC一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Adopt Open JDK官方文档(五) Docker镜像

5.1 复制镜像 镜像可以从别的设备复制并导入本地的Docker仓库。 保存镜像的命令为: docker save -o <save image to path> <image name> 或者 docker save <image name> > <save image to path> 保存镜像示例 docker save -o base-image-openjdk9.tar neomatrix369/openjdk9-base-image:latest 或者 docker save neomatrix369/openjdk9-base-image:latest > openjdk9-base-image.tar 或者 docker save neomatrix369/openjdk9-base-image:latest | gzip > openjdk9-base-image.tar.gz openjdk9-base-image.tar 和 openjdk9-base-image.tar.gz 的镜像已默认保存至Docker仓库。 加载镜像的命令为 docker load -i <path to image tar file> 或者 docker load < <path to image tar file> 加载镜像示例 docker load -i openjdk9-base-image.tar 或者 docker load < openjdk9-base-image.tar 或者 docker load < gzip < openjdk9-base-image.tar.gz 5.2 创建镜像 提示:在之前的介绍章节中,已经给出了Docker在相关平台使用的介绍。 在Linux,MacOS,Windows平台创建OpenJDK9 docker镜像的详细步骤如下: Why not build #OpenJDK 9 using #Docker ? – Part 1 of 2 Why not build #OpenJDK 9 using #Docker ? – Part 2 of 2 5.3 检查镜像 提示:这一步针对的OpenJDK镜像,是已经创建好的或者从别处导入至本地的Docker仓库的。 不同的操作系统启动docker的方法也不相同,在Mac和Windows平台,通常通过命令boot2docker启动docker,Linux系统在启动时会自动加载。 在docker启动之后运行命令: $ docker images 会得到如下输出: REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE neomatrix369/openjdk9 latest 5877e8efd939 4 days ago 5.82 GB neomatrix369/full-image-openjdk9 latest 32b0a686e93b 4 days ago 5.82 GB neomatrix369/base-image-openjdk9 latest ce63b2673e6a 4 days ago 781.7 MB phusion/baseimage latest 5a14c1498ff4 4 months ago 279.7 MB 继续执行如下命令: $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 /bin/bash 这一步是跳转到docker容器中执行bash shell命令 $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 java -version 这一步会运行java命令(需要事先配置好java环境变量,通过PATH或者JAVA_HOME可以找到java命令)获取如下信息: openjdk version "1.9.0-internal" OpenJDK Runtime Environment (build 1.9.0-internal-_2015_06_04_06_46-b00) OpenJDK 64-Bit Server VM (build 1.9.0-internal-_2015_06_04_06_46-b00, mixed mode) 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

APM开源产品Pinpoint——Hbase表设计文档

Pinpoint is an APM (Application Performance Management) tool for large-scale distributed systems written in Java. Modelled after Dapper, Pinpoint provides a solution to help analyze the overall structure of the system and how components within them are interconnected by tracing transactions across distributed applications. Git : https://github.com/naver/pinpoint image.png 架构 image.png 支持模块 JDK 6+ Tomcat 6/7/8, Jetty 8/9, JBoss EAP 6, Resin 3/4 Spring, Spring Boot Apache HTTP Client 3.x/4.x, JDK HttpConnector, GoogleHttpClient, OkHttpClient, NingAsyncHttpClient Thrift Client, Thrift Service, DUBBO PROVIDER, DUBBO CONSUMER MySQL, Oracle, MSSQL, CUBRID, DBCP, POSTGRESQL, MARIA Arcus, Memcached, Redis, CASSANDRA iBATIS, MyBatis gson, Jackson, Json Lib log4j, Logback Hbase表设计 序号 表名称 列簇 TTL 表说明 数据示例 备注 1 ApplicationIndex Agents 31536000 applicationIds 和 agentIds 注册信息 agentInfo.getApplicationName;agentInfo.getAgentId;agentInfo.getServiceType 2 HostApplicationMap M 5184000 applicationIds 和 agentIds 注册信息 host, bindApplicationName, bindServiceType to be removed - use ver2 instead. remove relevant code as well. 3 HostApplicationMap_Ver2 M 5184000 applicationIds 和 agentIds 注册信息 host, bindApplicationName, bindServiceType 4 AgentInfo Info 31536000 agent 的基础数据,如:ip, hostname agentversion, start time等 5 AgentStat S 5184000 agent的统计数据,如:cpuload, gc, heap等 6 AgentLifeCycle S 5184000 agent的生命周期数据 7 AgentEvent E 5184000 agent的不同event,如request for thread dump等 8 ApiMetaData Api 31536000 方法信息的元数据表 9 SqlMetaData Sql 15552000 SQL语句的元数据表 10 StringMetaData Str 15552000 字符串值的元数据表,如方法参数、异常名称等 11 ApplicationTraceIndex I 5184000 trace数据的索引表 12 Traces S 5184000 traced 处理信息 13 ApplicationMapStatisticsCaller C 5184000 用于存储各种代理之间的RPC统计表 to be removed - use ver2 instead. remove relevant code as well. 14 ApplicationMapStatisticsCallee C 5184000 15 ApplicationMapStatisticsSelf C 5184000 16 ApplicationMapStatisticsCaller_Ver2 C 5184000 用于存储各种代理之间的RPC统计表 17 ApplicationMapStatisticsCallee_Ver2 C 5184000 18 ApplicationMapStatisticsSelf_Ver2 C 5184000 初始化脚本 create'AgentInfo',{NAME=>'Info',TTL=>31536000} create'AgentStat',{NAME=>'S',TTL=>5184000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationIndex',{NAME=>'Agents',TTL=>31536000} create'AgentLifeCycle',{NAME=>'S',TTL=>5184000,},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'AgentEvent',{NAME=>'E',TTL=>5184000,},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'StringMetaData',{NAME=>'Str',TTL=>15552000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApiMetaData',{NAME=>'Api',TTL=>31536000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'SqlMetaData',{NAME=>'Sql',TTL=>15552000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'SqlMetaData_Ver2',{NAME=>'Sql',TTL=>15552000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'Traces',{NAME=>'S',TTL=>5184000},{NAME=>'A',TTL=>5184000},{NAME=>'T',TTL=>5184000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x09\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x11\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x13\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x15\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x17\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x19\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x20\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x21\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x22\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x23\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x24\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x25\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x26\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x27\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x28\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x29\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x30\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x31\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x32\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x33\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x34\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x35\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x36\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x37\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x38\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x39\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationTraceIndex',{NAME=>'I',TTL=>5184000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsCaller',{NAME=>'C',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsCallee',{NAME=>'C',TTL=>5184000,VERSION=>1},{NAME=>'D',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsSelf',{NAME=>'C',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsCaller_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsCallee_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsSelf_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'HostApplicationMap',{NAME=>'M',TTL=>5184000,VERSION=>1} create'HostApplicationMap_Ver2',{NAME=>'M',TTL=>5184000,VERSION=>1},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} list exit 欢迎关注 高广超的简书博客 与 收藏文章 !欢迎关注 头条号:互联网技术栈 ! 个人介绍: 高广超 :多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。目前就职于美团网,负责核心业务研发工作。 本文首发在 高广超的简书博客 转载请注明! image.png

优秀的个人博客,低调大师

SparkSql官方文档中文翻译(java版本)

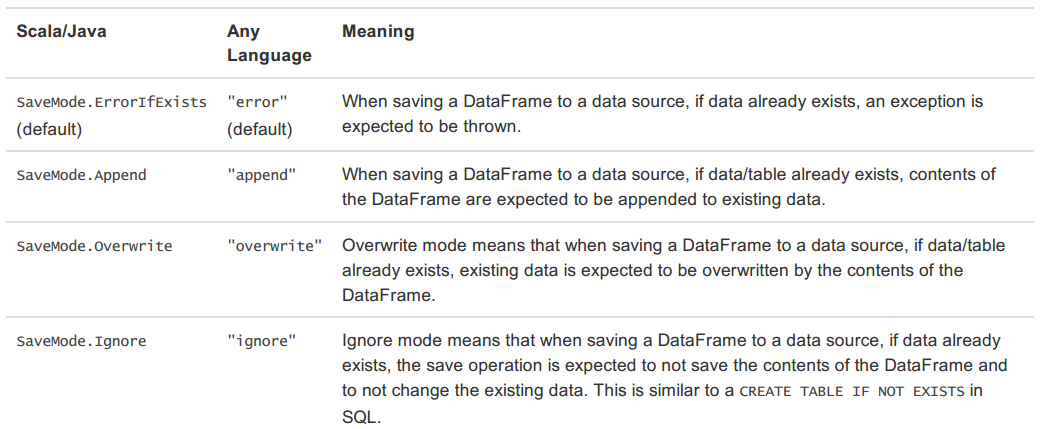
1 概述(Overview) 2 DataFrames 2.1 入口:SQLContext(Starting Point: SQLContext) 2.2 创建DataFrames(Creating DataFrames) 2.3 DataFrame操作(DataFrame Operations) 2.4 运行SQL查询程序(Running SQL Queries Programmatically) 2.5 DataFrames与RDDs的相互转换(Interoperating with RDDs) 2.5.1 使用反射获取Schema(Inferring the Schema Using Reflection) 2.5.2 通过编程接口指定Schema(Programmatically Specifying the Schema) 3 数据源(Data Source) 3.1 一般Load/Save方法 3.1.1 手动指定选项(Manually Specifying Options) 3.1.2 存储模式(Save Modes) 3.1.3 持久化到表(Saving to Persistent Tables) 3.2 Parquet文件 3.2.1 读取Parquet文件(Loading Data Programmatically) 3.2.2 解析分区信息(Partition Discovery) 3.2.3 Schema合并(Schema Merging) 3.2.4 Hive metastore Parquet表转换(Hive metastore Parquet table conversion) 3.2.4.1 Hive/Parquet Schema反射(Hive/Parquet Schema Reconciliation) 3.2.4.2 元数据刷新(Metadata Refreshing) 3.2.5 配置(Configuration) 3.3 JSON数据集 3.4 Hive表 3.4.1 访问不同版本的Hive Metastore(Interacting with Different Versions of Hive Metastore) 3.5 JDBC To Other Databases 3.6 故障排除(Troubleshooting) 4 性能调优 4.1 缓存数据至内存(Caching Data In Memory) 4.2 调优参数(Other Configuration Options) 5 分布式SQL引擎 5.1 运行Thrift JDBC/ODBC服务 5.2 运行Spark SQL CLI 6 Migration Guide 6.1 与Hive的兼容(Compatibility with Apache Hive 6.1.1 在Hive warehouse中部署Spark SQL 6.1.2 Spark SQL支持的Hive特性 6.1.3 不支持的Hive功能 7 Reference 7.1 Data Types 7.2 NaN 语义 1 概述(Overview) Spark SQL是Spark的一个组件,用于结构化数据的计算。Spark SQL提供了一个称为DataFrames的编程抽象,DataFrames可以充当分布式SQL查询引擎。 2 DataFrames DataFrame是一个分布式的数据集合,该数据集合以命名列的方式进行整合。DataFrame可以理解为关系数据库中的一张表,也可以理解为R/Python中的一个data frame。DataFrames可以通过多种数据构造,例如:结构化的数据文件、hive中的表、外部数据库、Spark计算过程中生成的RDD等。DataFrame的API支持4种语言:Scala、Java、Python、R。 2.1 入口:SQLContext(Starting Point: SQLContext) Spark SQL程序的主入口是SQLContext类或它的子类。创建一个基本的SQLContext,你只需要SparkContext,创建代码示例如下: Scala val sc: SparkContext // An existing SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) Java JavaSparkContext sc = ...; // An existing JavaSparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc); 除了基本的SQLContext,也可以创建HiveContext。SQLContext和HiveContext区别与联系为: SQLContext现在只支持SQL语法解析器(SQL-92语法) HiveContext现在支持SQL语法解析器和HiveSQL语法解析器,默认为HiveSQL语法解析器,用户可以通过配置切换成SQL语法解析器,来运行HiveSQL不支持的语法。 使用HiveContext可以使用Hive的UDF,读写Hive表数据等Hive操作。SQLContext不可以对Hive进行操作。 Spark SQL未来的版本会不断丰富SQLContext的功能,做到SQLContext和HiveContext的功能容和,最终可能两者会统一成一个Context HiveContext包装了Hive的依赖包,把HiveContext单独拿出来,可以在部署基本的Spark的时候就不需要Hive的依赖包,需要使用HiveContext时再把Hive的各种依赖包加进来。 SQL的解析器可以通过配置spark.sql.dialect参数进行配置。在SQLContext中只能使用Spark SQL提供的”sql“解析器。在HiveContext中默认解析器为”hiveql“,也支持”sql“解析器。 2.2 创建DataFrames(Creating DataFrames) 使用SQLContext,spark应用程序(Application)可以通过RDD、Hive表、JSON格式数据等数据源创建DataFrames。下面是基于JSON文件创建DataFrame的示例: Scala val sc: SparkContext // An existing SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) val df = sqlContext.read.json("examples/src/main/resources/people.json") // Displays the content of the DataFrame to stdout df.show() Java JavaSparkContext sc = ...; // An existing JavaSparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc); DataFrame df = sqlContext.read().json("examples/src/main/resources/people.json"); // Displays the content of the DataFrame to stdout df.show(); 2.3 DataFrame操作(DataFrame Operations) DataFrames支持Scala、Java和Python的操作接口。下面是Scala和Java的几个操作示例: Scala val sc: SparkContext // An existing SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) // Create the DataFrame val df = sqlContext.read.json("examples/src/main/resources/people.json") // Show the content of the DataFrame df.show() // age name // null Michael // 30 Andy // 19 Justin // Print the schema in a tree format df.printSchema() // root // |-- age: long (nullable = true) // |-- name: string (nullable = true) // Select only the "name" column df.select("name").show() // name // Michael // Andy // Justin // Select everybody, but increment the age by 1 df.select(df("name"), df("age") + 1).show() // name (age + 1) // Michael null // Andy 31 // Justin 20 // Select people older than 21 df.filter(df("age") > 21).show() // age name // 30 Andy // Count people by age df.groupBy("age").count().show() // age count // null 1 // 19 1 // 30 1 Java JavaSparkContext sc // An existing SparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc) // Create the DataFrame DataFrame df = sqlContext.read().json("examples/src/main/resources/people.json"); // Show the content of the DataFrame df.show(); // age name // null Michael // 30 Andy // 19 Justin // Print the schema in a tree format df.printSchema(); // root // |-- age: long (nullable = true) // |-- name: string (nullable = true) // Select only the "name" column df.select("name").show(); // name // Michael // Andy // Justin // Select everybody, but increment the age by 1 df.select(df.col("name"), df.col("age").plus(1)).show(); // name (age + 1) // Michael null // Andy 31 // Justin 20 // Select people older than 21 df.filter(df.col("age").gt(21)).show(); // age name // 30 Andy // Count people by age df.groupBy("age").count().show(); // age count // null 1 // 19 1 // 30 1 详细的DataFrame API请参考API Documentation。 除了简单列引用和表达式,DataFrames还有丰富的library,功能包括string操作、date操作、常见数学操作等。详细内容请参考DataFrame Function Reference。 2.4 运行SQL查询程序(Running SQL Queries Programmatically) Spark Application可以使用SQLContext的sql()方法执行SQL查询操作,sql()方法返回的查询结果为DataFrame格式。代码如下: Scala val sqlContext = ... // An existing SQLContext val df = sqlContext.sql("SELECT * FROM table") Java SQLContext sqlContext = ... // An existing SQLContext DataFrame df = sqlContext.sql("SELECT * FROM table") 2.5 DataFrames与RDDs的相互转换(Interoperating with RDDs) Spark SQL支持两种RDDs转换为DataFrames的方式: 使用反射获取RDD内的Schema 当已知类的Schema的时候,使用这种基于反射的方法会让代码更加简洁而且效果也很好。 通过编程接口指定Schema 通过Spark SQL的接口创建RDD的Schema,这种方式会让代码比较冗长。 这种方法的好处是,在运行时才知道数据的列以及列的类型的情况下,可以动态生成Schema 2.5.1 使用反射获取Schema(Inferring the Schema Using Reflection) Spark SQL支持将JavaBean的RDD自动转换成DataFrame。通过反射获取Bean的基本信息,依据Bean的信息定义Schema。当前Spark SQL版本(Spark 1.5.2)不支持嵌套的JavaBeans和复杂数据类型(如:List、Array)。创建一个实现Serializable接口包含所有属性getters和setters的类来创建一个JavaBean。通过调用createDataFrame并提供JavaBean的Class object,指定一个Schema给一个RDD。示例如下: public static class Person implements Serializable { private String name; private int age; public String getName() { return name; } public void setName(String name) { this.name = name; } public int getAge() { return age; } public void setAge(int age) { this.age = age; } } // sc is an existing JavaSparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc); // Load a text file and convert each line to a JavaBean. JavaRDD<Person> people = sc.textFile("examples/src/main/resources/people.txt").map( new Function<String, Person>() { public Person call(String line) throws Exception { String[] parts = line.split(","); Person person = new Person(); person.setName(parts[0]); person.setAge(Integer.parseInt(parts[1].trim())); return person; } }); // Apply a schema to an RDD of JavaBeans and register it as a table. DataFrame schemaPeople = sqlContext.createDataFrame(people, Person.class); schemaPeople.registerTempTable("people"); // SQL can be run over RDDs that have been registered as tables. DataFrame teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") // The results of SQL queries are DataFrames and support all the normal RDD operations. // The columns of a row in the result can be accessed by ordinal. List<String> teenagerNames = teenagers.javaRDD().map(new Function<Row, String>() { public String call(Row row) { return "Name: " + row.getString(0); } }).collect(); 2.5.2 通过编程接口指定Schema(Programmatically Specifying the Schema) 当JavaBean不能被预先定义的时候,编程创建DataFrame分为三步: 从原来的RDD创建一个Row格式的RDD 创建与RDD中Rows结构匹配的StructType,通过该StructType创建表示RDD的Schema 通过SQLContext提供的createDataFrame方法创建DataFrame,方法参数为RDD的Schema 示例如下: import org.apache.spark.api.java.function.Function; // Import factory methods provided by DataTypes. import org.apache.spark.sql.types.DataTypes; // Import StructType and StructField import org.apache.spark.sql.types.StructType; import org.apache.spark.sql.types.StructField; // Import Row. import org.apache.spark.sql.Row; // Import RowFactory. import org.apache.spark.sql.RowFactory; // sc is an existing JavaSparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc); // Load a text file and convert each line to a JavaBean. JavaRDD<String> people = sc.textFile("examples/src/main/resources/people.txt"); // The schema is encoded in a string String schemaString = "name age"; // Generate the schema based on the string of schema List<StructField> fields = new ArrayList<StructField>(); for (String fieldName: schemaString.split(" ")) { fields.add(DataTypes.createStructField(fieldName, DataTypes.StringType, true)); } StructType schema = DataTypes.createStructType(fields); // Convert records of the RDD (people) to Rows. JavaRDD<Row> rowRDD = people.map( new Function<String, Row>() { public Row call(String record) throws Exception { String[] fields = record.split(","); return RowFactory.create(fields[0], fields[1].trim()); } }); // Apply the schema to the RDD. DataFrame peopleDataFrame = sqlContext.createDataFrame(rowRDD, schema); // Register the DataFrame as a table. peopleDataFrame.registerTempTable("people"); // SQL can be run over RDDs that have been registered as tables. DataFrame results = sqlContext.sql("SELECT name FROM people"); // The results of SQL queries are DataFrames and support all the normal RDD operations. // The columns of a row in the result can be accessed by ordinal. List<String> names = results.javaRDD().map(new Function<Row, String>() { public String call(Row row) { return "Name: " + row.getString(0); } }).collect(); 3 数据源(Data Source) Spark SQL的DataFrame接口支持多种数据源的操作。一个DataFrame可以进行RDDs方式的操作,也可以被注册为临时表。把DataFrame注册为临时表之后,就可以对该DataFrame执行SQL查询。Data Sources这部分首先描述了对Spark的数据源执行加载和保存的常用方法,然后对内置数据源进行深入介绍。 3.1 一般Load/Save方法 Spark SQL的默认数据源为Parquet格式。数据源为Parquet文件时,Spark SQL可以方便的执行所有的操作。修改配置项spark.sql.sources.default,可修改默认数据源格式。读取Parquet文件示例如下: Scala val df = sqlContext.read.load("examples/src/main/resources/users.parquet") df.select("name", "favorite_color").write.save("namesAndFavColors.parquet") Java DataFrame df = sqlContext.read().load("examples/src/main/resources/users.parquet"); df.select("name", "favorite_color").write().save("namesAndFavColors.parquet"); 3.1.1 手动指定选项(Manually Specifying Options) 当数据源格式不是parquet格式文件时,需要手动指定数据源的格式。数据源格式需要指定全名(例如:org.apache.spark.sql.parquet),如果数据源格式为内置格式,则只需要指定简称(json,parquet,jdbc)。通过指定的数据源格式名,可以对DataFrames进行类型转换操作。示例如下: Scala val df = sqlContext.read.format("json").load("examples/src/main/resources/people.json") df.select("name", "age").write.format("parquet").save("namesAndAges.parquet") Java DataFrame df = sqlContext.read().format("json").load("examples/src/main/resources/people.json"); df.select("name", "age").write().format("parquet").save("namesAndAges.parquet"); 3.1.2 存储模式(Save Modes) 可以采用SaveMode执行存储操作,SaveMode定义了对数据的处理模式。需要注意的是,这些保存模式不使用任何锁定,不是原子操作。此外,当使用Overwrite方式执行时,在输出新数据之前原数据就已经被删除。SaveMode详细介绍如下表: 3.1.3 持久化到表(Saving to Persistent Tables) 当使用HiveContext时,可以通过saveAsTable方法将DataFrames存储到表中。与registerTempTable方法不同的是,saveAsTable将DataFrame中的内容持久化到表中,并在HiveMetastore中存储元数据。存储一个DataFrame,可以使用SQLContext的table方法。table先创建一个表,方法参数为要创建的表的表名,然后将DataFrame持久化到这个表中。 默认的saveAsTable方法将创建一个“managed table”,表示数据的位置可以通过metastore获得。当存储数据的表被删除时,managed table也将自动删除。 3.2 Parquet文件 Parquet是一种支持多种数据处理系统的柱状的数据格式,Parquet文件中保留了原始数据的模式。Spark SQL提供了Parquet文件的读写功能。 3.2.1 读取Parquet文件(Loading Data Programmatically) 读取Parquet文件示例如下: Scala // sqlContext from the previous example is used in this example. // This is used to implicitly convert an RDD to a DataFrame. import sqlContext.implicits._ val people: RDD[Person] = ... // An RDD of case class objects, from the previous example. // The RDD is implicitly converted to a DataFrame by implicits, allowing it to be stored using Parquet. people.write.parquet("people.parquet") // Read in the parquet file created above. Parquet files are self-describing so the schema is preserved. // The result of loading a Parquet file is also a DataFrame. val parquetFile = sqlContext.read.parquet("people.parquet") //Parquet files can also be registered as tables and then used in SQL statements. parquetFile.registerTempTable("parquetFile") val teenagers = sqlContext.sql("SELECT name FROM parquetFile WHERE age >= 13 AND age <= 19") teenagers.map(t => "Name: " + t(0)).collect().foreach(println) Java // sqlContext from the previous example is used in this example. DataFrame schemaPeople = ... // The DataFrame from the previous example. // DataFrames can be saved as Parquet files, maintaining the schema information. schemaPeople.write().parquet("people.parquet"); // Read in the Parquet file created above. Parquet files are self-describing so the schema is preserved. // The result of loading a parquet file is also a DataFrame. DataFrame parquetFile = sqlContext.read().parquet("people.parquet"); // Parquet files can also be registered as tables and then used in SQL statements. parquetFile.registerTempTable("parquetFile"); DataFrame teenagers = sqlContext.sql("SELECT name FROM parquetFile WHERE age >= 13 AND age <= 19"); List<String> teenagerNames = teenagers.javaRDD().map(new Function<Row, String>() { public String call(Row row) { return "Name: " + row.getString(0); } }).collect(); 3.2.2 解析分区信息(Partition Discovery) 对表进行分区是对数据进行优化的方式之一。在分区的表内,数据通过分区列将数据存储在不同的目录下。Parquet数据源现在能够自动发现并解析分区信息。例如,对人口数据进行分区存储,分区列为gender和country,使用下面的目录结构: path └── to └── table ├── gender=male │ ├── ... │ │ │ ├── country=US │ │ └── data.parquet │ ├── country=CN │ │ └── data.parquet │ └── ... └── gender=female ├── ... │ ├── country=US │ └── data.parquet ├── country=CN │ └── data.parquet └── ... 通过传递path/to/table给 SQLContext.read.parquet或SQLContext.read.load,Spark SQL将自动解析分区信息。返回的DataFrame的Schema如下: root |-- name: string (nullable = true) |-- age: long (nullable = true) |-- gender: string (nullable = true) |-- country: string (nullable = true) 需要注意的是,数据的分区列的数据类型是自动解析的。当前,支持数值类型和字符串类型。自动解析分区类型的参数为:spark.sql.sources.partitionColumnTypeInference.enabled,默认值为true。如果想关闭该功能,直接将该参数设置为disabled。此时,分区列数据格式将被默认设置为string类型,不再进行类型解析。 3.2.3 Schema合并(Schema Merging) 像ProtocolBuffer、Avro和Thrift那样,Parquet也支持Schema evolution(Schema演变)。用户可以先定义一个简单的Schema,然后逐渐的向Schema中增加列描述。通过这种方式,用户可以获取多个有不同Schema但相互兼容的Parquet文件。现在Parquet数据源能自动检测这种情况,并合并这些文件的schemas。 因为Schema合并是一个高消耗的操作,在大多数情况下并不需要,所以Spark SQL从1.5.0开始默认关闭了该功能。可以通过下面两种方式开启该功能: 当数据源为Parquet文件时,将数据源选项mergeSchema设置为true 设置全局SQL选项spark.sql.parquet.mergeSchema为true 示例如下: Scala // sqlContext from the previous example is used in this example. // This is used to implicitly convert an RDD to a DataFrame. import sqlContext.implicits._ // Create a simple DataFrame, stored into a partition directory val df1 = sc.makeRDD(1 to 5).map(i => (i, i * 2)).toDF("single", "double") df1.write.parquet("data/test_table/key=1") // Create another DataFrame in a new partition directory, // adding a new column and dropping an existing column val df2 = sc.makeRDD(6 to 10).map(i => (i, i * 3)).toDF("single", "triple") df2.write.parquet("data/test_table/key=2") // Read the partitioned table val df3 = sqlContext.read.option("mergeSchema", "true").parquet("data/test_table") df3.printSchema() // The final schema consists of all 3 columns in the Parquet files together // with the partitioning column appeared in the partition directory paths. // root // |-- single: int (nullable = true) // |-- double: int (nullable = true) // |-- triple: int (nullable = true) // |-- key : int (nullable = true) 3.2.4 Hive metastore Parquet表转换(Hive metastore Parquet table conversion) 当向Hive metastore中读写Parquet表时,Spark SQL将使用Spark SQL自带的Parquet SerDe(SerDe:Serialize/Deserilize的简称,目的是用于序列化和反序列化),而不是用Hive的SerDe,Spark SQL自带的SerDe拥有更好的性能。这个优化的配置参数为spark.sql.hive.convertMetastoreParquet,默认值为开启。 3.2.4.1 Hive/Parquet Schema反射(Hive/Parquet Schema Reconciliation) 从表Schema处理的角度对比Hive和Parquet,有两个区别: Hive区分大小写,Parquet不区分大小写 hive允许所有的列为空,而Parquet不允许所有的列全为空 由于这两个区别,当将Hive metastore Parquet表转换为Spark SQL Parquet表时,需要将Hive metastore schema和Parquet schema进行一致化。一致化规则如下: 这两个schema中的同名字段必须具有相同的数据类型。一致化后的字段必须为Parquet的字段类型。这个规则同时也解决了空值的问题。 一致化后的schema只包含Hive metastore中出现的字段。 忽略只出现在Parquet schema中的字段 只在Hive metastore schema中出现的字段设为nullable字段,并加到一致化后的schema中 3.2.4.2 元数据刷新(Metadata Refreshing) Spark SQL缓存了Parquet元数据以达到良好的性能。当Hive metastore Parquet表转换为enabled时,表修改后缓存的元数据并不能刷新。所以,当表被Hive或其它工具修改时,则必须手动刷新元数据,以保证元数据的一致性。示例如下: Scala // sqlContext is an existing HiveContext sqlContext.refreshTable("my_table") Java // sqlContext is an existing HiveContext sqlContext.refreshTable("my_table") 3.2.5 配置(Configuration) 配置Parquet可以使用SQLContext的setConf方法或使用SQL执行SET key=value命令。详细参数说明如下: 3.3 JSON数据集 Spark SQL能自动解析JSON数据集的Schema,读取JSON数据集为DataFrame格式。读取JSON数据集方法为SQLContext.read().json()。该方法将String格式的RDD或JSON文件转换为DataFrame。 需要注意的是,这里的JSON文件不是常规的JSON格式。JSON文件每一行必须包含一个独立的、自满足有效的JSON对象。如果用多行描述一个JSON对象,会导致读取出错。读取JSON数据集示例如下: Scala // sc is an existing SparkContext. val sqlContext = new org.apache.spark.sql.SQLContext(sc) // A JSON dataset is pointed to by path. // The path can be either a single text file or a directory storing text files. val path = "examples/src/main/resources/people.json" val people = sqlContext.read.json(path) // The inferred schema can be visualized using the printSchema() method. people.printSchema() // root // |-- age: integer (nullable = true) // |-- name: string (nullable = true) // Register this DataFrame as a table. people.registerTempTable("people") // SQL statements can be run by using the sql methods provided by sqlContext. val teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") // Alternatively, a DataFrame can be created for a JSON dataset represented by // an RDD[String] storing one JSON object per string. val anotherPeopleRDD = sc.parallelize( """{"name":"Yin","address":{"city":"Columbus","state":"Ohio"}}""" :: Nil) val anotherPeople = sqlContext.read.json(anotherPeopleRDD) Java // sc is an existing JavaSparkContext. SQLContext sqlContext = new org.apache.spark.sql.SQLContext(sc); // A JSON dataset is pointed to by path. // The path can be either a single text file or a directory storing text files. DataFrame people = sqlContext.read().json("examples/src/main/resources/people.json"); // The inferred schema can be visualized using the printSchema() method. people.printSchema(); // root // |-- age: integer (nullable = true) // |-- name: string (nullable = true) // Register this DataFrame as a table. people.registerTempTable("people"); // SQL statements can be run by using the sql methods provided by sqlContext. DataFrame teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19"); // Alternatively, a DataFrame can be created for a JSON dataset represented by // an RDD[String] storing one JSON object per string. List<String> jsonData = Arrays.asList( "{\"name\":\"Yin\",\"address\":{\"city\":\"Columbus\",\"state\":\"Ohio\"}}"); JavaRDD<String> anotherPeopleRDD = sc.parallelize(jsonData); DataFrame anotherPeople = sqlContext.read().json(anotherPeopleRDD); 3.4 Hive表 Spark SQL支持对Hive的读写操作。需要注意的是,Hive所依赖的包,没有包含在Spark assembly包中。增加Hive时,需要在Spark的build中添加 -Phive 和 -Phivethriftserver配置。这两个配置将build一个新的assembly包,这个assembly包含了Hive的依赖包。注意,必须上这个心的assembly包到所有的worker节点上。因为worker节点在访问Hive中数据时,会调用Hive的 serialization and deserialization libraries(SerDes),此时将用到Hive的依赖包。 Hive的配置文件为conf/目录下的hive-site.xml文件。在YARN上执行查询命令之前,lib_managed/jars目录下的datanucleus包和conf/目录下的hive-site.xml必须可以被driverhe和所有的executors所访问。确保被访问,最方便的方式就是在spark-submit命令中通过--jars选项和--file选项指定。 操作Hive时,必须创建一个HiveContext对象,HiveContext继承了SQLContext,并增加了对MetaStore和HiveQL的支持。除了sql方法,HiveContext还提供了一个hql方法,hql方法可以执行HiveQL语法的查询语句。示例如下: Scala // sc is an existing SparkContext. val sqlContext = new org.apache.spark.sql.hive.HiveContext(sc) sqlContext.sql("CREATE TABLE IF NOT EXISTS src (key INT, value STRING)") sqlContext.sql("LOAD DATA LOCAL INPATH 'examples/src/main/resources/kv1.txt' INTO TABLE src") // Queries are expressed in HiveQL sqlContext.sql("FROM src SELECT key, value").collect().foreach(println) Java // sc is an existing JavaSparkContext. HiveContext sqlContext = new org.apache.spark.sql.hive.HiveContext(sc.sc); sqlContext.sql("CREATE TABLE IF NOT EXISTS src (key INT, value STRING)"); sqlContext.sql("LOAD DATA LOCAL INPATH 'examples/src/main/resources/kv1.txt' INTO TABLE src"); // Queries are expressed in HiveQL. Row[] results = sqlContext.sql("FROM src SELECT key, value").collect(); 3.4.1 访问不同版本的Hive Metastore(Interacting with Different Versions of Hive Metastore) Spark SQL经常需要访问Hive metastore,Spark SQL可以通过Hive metastore获取Hive表的元数据。从Spark 1.4.0开始,Spark SQL只需简单的配置,就支持各版本Hive metastore的访问。注意,涉及到metastore时Spar SQL忽略了Hive的版本。Spark SQL内部将Hive反编译至Hive 1.2.1版本,Spark SQL的内部操作(serdes, UDFs, UDAFs, etc)都调用Hive 1.2.1版本的class。版本配置项见下面表格: 3.5 JDBC To Other Databases Spark SQL支持使用JDBC访问其他数据库。当时用JDBC访问其它数据库时,最好使用JdbcRDD。使用JdbcRDD时,Spark SQL操作返回的DataFrame会很方便,也会很方便的添加其他数据源数据。JDBC数据源因为不需要用户提供ClassTag,所以很适合使用Java或Python进行操作。使用JDBC访问数据源,需要在spark classpath添加JDBC driver配置。例如,从Spark Shell连接postgres的配置为: SPARK_CLASSPATH=postgresql-9.3-1102-jdbc41.jar bin/spark-shell 远程数据库的表,可用DataFrame或Spark SQL临时表的方式调用数据源API。支持的参数有: 代码示例如下: Scala val jdbcDF = sqlContext.read.format("jdbc").options( Map("url" -> "jdbc:postgresql:dbserver", "dbtable" -> "schema.tablename")).load() Java Map<String, String> options = new HashMap<String, String>(); options.put("url", "jdbc:postgresql:dbserver"); options.put("dbtable", "schema.tablename"); DataFrame jdbcDF = sqlContext.read().format("jdbc"). options(options).load(); 3.6 故障排除(Troubleshooting) 在客户端session和所有的executors上,JDBC driver必须对启动类加载器(primordial class loader)设置为visible。因为当创建一个connection时,Java的DriverManager类会执行安全验证,安全验证将忽略所有对启动类加载器为非visible的driver。一个很方便的解决方法是,修改所有worker节点上的compute_classpath.sh脚本,将driver JARs添加至脚本。 有些数据库(例:H2)将所有的名字转换为大写,所以在这些数据库中,Spark SQL也需要将名字全部大写。 4 性能调优 4.1 缓存数据至内存(Caching Data In Memory) Spark SQL可以通过调用sqlContext.cacheTable("tableName") 或者dataFrame.cache(),将表用一种柱状格式( an in­memory columnar format)缓存至内存中。然后Spark SQL在执行查询任务时,只需扫描必需的列,从而以减少扫描数据量、提高性能。通过缓存数据,Spark SQL还可以自动调节压缩,从而达到最小化内存使用率和降低GC压力的目的。调用sqlContext.uncacheTable("tableName")可将缓存的数据移出内存。 可通过两种配置方式开启缓存数据功能: 使用SQLContext的setConf方法 执行SQL命令 SET key=value 4.2 调优参数(Other Configuration Options) 可以通过配置下表中的参数调节Spark SQL的性能。在后续的Spark版本中将逐渐增强自动调优功能,下表中的参数在后续的版本中或许将不再需要配置。 5 分布式SQL引擎 使用Spark SQL的JDBC/ODBC或者CLI,可以将Spark SQL作为一个分布式查询引擎。终端用户或应用不需要编写额外的代码,可以直接使用Spark SQL执行SQL查询。 5.1 运行Thrift JDBC/ODBC服务 这里运行的Thrift JDBC/ODBC服务与Hive 1.2.1中的HiveServer2一致。可以在Spark目录下执行如下命令来启动JDBC/ODBC服务: ./sbin/start-thriftserver.sh 这个命令接收所有bin/spark-submit命令行参数,添加一个--hiveconf参数来指定Hive的属性。详细的参数说明请执行命令./sbin/start-thriftserver.sh --help。服务默认监听端口为localhost:10000。有两种方式修改默认监听端口: 修改环境变量: export HIVE_SERVER2_THRIFT_PORT=<listening-port> export HIVE_SERVER2_THRIFT_BIND_HOST=<listening-host> ./sbin/start-thriftserver.sh \ --master <master-uri> \ ... 修改系统属性 ./sbin/start-thriftserver.sh \ --hiveconf hive.server2.thrift.port=<listening-port> \ --hiveconf hive.server2.thrift.bind.host=<listening-host> \ --master <master-uri> ... 使用beeline来测试Thrift JDBC/ODBC服务: ./bin/beeline 连接到Thrift JDBC/ODBC服务 beeline> !connect jdbc:hive2://localhost:10000 在非安全模式下,只需要输入机器上的一个用户名即可,无需密码。在安全模式下,beeline会要求输入用户名和密码。安全模式下的详细要求,请阅读beeline documentation的说明。 配置Hive需要替换conf/目录下的hive-site.xml。 Thrift JDBC服务也支持通过HTTP传输发送thrift RPC messages。开启HTTP模式需要将下面的配参数配置到系统属性或conf/:下的hive-site.xml中 hive.server2.transport.mode - Set this to value: http hive.server2.thrift.http.port - HTTP port number fo listen on; default is 10001 hive.server2.http.endpoint - HTTP endpoint; default is cliservice 测试http模式,可以使用beeline链接JDBC/ODBC服务: beeline> !connect jdbc:hive2://<host>:<port>/<database>?hive.server2.transport.mode=http;hive.server2.thrift.http.path=<http_endpoint> 5.2 运行Spark SQL CLI Spark SQL CLI可以很方便的在本地运行Hive元数据服务以及从命令行执行查询任务。需要注意的是,Spark SQL CLI不能与Thrift JDBC服务交互。在Spark目录下执行如下命令启动Spark SQL CLI: ./bin/spark-sql 配置Hive需要替换conf/下的hive-site.xml。执行./bin/spark-sql --help可查看详细的参数说明 。 6 Migration Guide 6.1 与Hive的兼容(Compatibility with Apache Hive) Spark SQL与Hive Metastore、SerDes、UDFs相兼容。Spark SQL兼容Hive Metastore从0.12到1.2.1的所有版本。Spark SQL也与Hive SerDes和UDFs相兼容,当前SerDes和UDFs是基于Hive 1.2.1。 6.1.1 在Hive warehouse中部署Spark SQL Spark SQL Thrift JDBC服务与Hive相兼容,在已存在的Hive上部署Spark SQL Thrift服务不需要对已存在的Hive Metastore做任何修改,也不需要对数据做任何改动。 6.1.2 Spark SQL支持的Hive特性 Spark SQL支持多部分的Hive特性,例如: Hive查询语句,包括: SELECT GROUP BY ORDER BY CLUSTER BY SORT BY 所有Hive运算符,包括 比较操作符(=, ⇔, ==, <>, <, >, >=, <=, etc) 算术运算符(+, -, *, /, %, etc) 逻辑运算符(AND, &&, OR, ||, etc) 复杂类型构造器 数学函数(sign,ln,cos,etc) 字符串函数(instr,length,printf,etc) 用户自定义函数(UDF) 用户自定义聚合函数(UDAF) 用户自定义序列化格式器(SerDes) 窗口函数 Joins JOIN {LEFT|RIGHT|FULL} OUTER JOIN LEFT SEMI JOIN CROSS JOIN Unions 子查询 SELECT col FROM ( SELECT a + b AS col from t1) t2 Sampling Explain 表分区,包括动态分区插入 视图 所有的Hive DDL函数,包括: CREATE TABLE CREATE TABLE AS SELECT ALTER TABLE 大部分的Hive数据类型,包括: TINYINT SMALLINT INT BIGINT BOOLEAN FLOAT DOUBLE STRING BINARY TIMESTAMP DATE ARRAY<> MAP<> STRUCT<> 6.1.3 不支持的Hive功能 下面是当前不支持的Hive特性,其中大部分特性在实际的Hive使用中很少用到。 Major Hive Features Tables with buckets:bucket是在一个Hive表分区内进行hash分区。Spark SQL当前不支持。 Esoteric Hive Features UNION type Unique join Column statistics collecting:当期Spark SQL不智齿列信息统计,只支持填充Hive Metastore的sizeInBytes列。 Hive Input/Output Formats File format for CLI: 这个功能用于在CLI显示返回结果,Spark SQL只支持TextOutputFormat Hadoop archive Hive优化部分Hive优化还没有添加到Spark中。没有添加的Hive优化(比如索引)对Spark SQL这种in-memory计算模型来说不是特别重要。下列Hive优化将在后续Spark SQL版本中慢慢添加。 块级别位图索引和虚拟列(用于建立索引) 自动检测joins和groupbys的reducer数量:当前Spark SQL中需要使用“SET spark.sql.shuffle.partitions=[num_tasks];”控制post-shuffle的并行度,不能自动检测。 仅元数据查询:对于可以通过仅使用元数据就能完成的查询,当前Spark SQL还是需要启动任务来计算结果。 数据倾斜标记:当前Spark SQL不遵循Hive中的数据倾斜标记 jion中STREAMTABLE提示:当前Spark SQL不遵循STREAMTABLE提示 查询结果为多个小文件时合并小文件:如果查询结果包含多个小文件,Hive能合并小文件为几个大文件,避免HDFS metadata溢出。当前Spark SQL不支持这个功能。 7 Reference 7.1 Data Types Spark SQL和DataFrames支持的数据格式如下: 数值类型 ByteType: 代表1字节有符号整数. 数值范围: -128 到 127. ShortType: 代表2字节有符号整数. 数值范围: -32768 到 32767. IntegerType: 代表4字节有符号整数. 数值范围: -2147483648 t到 2147483647. LongType: 代表8字节有符号整数. 数值范围: -9223372036854775808 到 9223372036854775807. FloatType: 代表4字节单精度浮点数。 DoubleType: 代表8字节双精度浮点数。 DecimalType: 表示任意精度的有符号十进制数。内部使用java.math.BigDecimal.A实现。 BigDecimal由一个任意精度的整数非标度值和一个32位的整数组成。 String类型 StringType: 表示字符串值。 Binary类型 BinaryType: 代表字节序列值。 Boolean类型 BooleanType: 代表布尔值。 Datetime类型 TimestampType: 代表包含的年、月、日、时、分和秒的时间值 DateType: 代表包含的年、月、日的日期值 复杂类型 ArrayType(elementType, containsNull): 代表包含一系列类型为elementType的元素。如果在一个将ArrayType值的元素可以为空值,containsNull指示是否允许为空。 MapType(keyType, valueType, valueContainsNull): 代表一系列键值对的集合。key不允许为空,valueContainsNull指示value是否允许为空 StructType(fields): 代表带有一个StructFields(列)描述结构数据。 StructField(name, dataType, nullable): 表示StructType中的一个字段。name表示列名、dataType表示数据类型、nullable指示是否允许为空。 Spark SQL所有的数据类型在org.apache.spark.sql.types包内。不同语言访问或创建数据类型方法不一样: Scala代码中添加import org.apache.spark.sql.types._,再进行数据类型访问或创建操作。 Java可以使用org.apache.spark.sql.types.DataTypes中的工厂方法,如下表: 7.2 NaN 语义 当处理float或double类型时,如果类型不符合标准的浮点语义,则使用专门的处理方式NaN。需要注意的是: NaN = NaN 返回 true 可以对NaN值进行聚合操作 在join操作中,key为NaN时,NaN值与普通的数值处理逻辑相同 NaN值大于所有的数值型数据,在升序排序中排在最后 转自:http://www.cnblogs.com/BYRans/

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册