首页 文章 精选 留言 我的

精选列表

搜索[提高],共10000篇文章
优秀的个人博客,低调大师

《UX最佳实践:提高用户体验影响力的艺术 》一2.5 主要经验与建议

2.5 主要经验与建议 经历了项目的各个阶段,我们知道了哪些实践是可行的,哪些需要改进。这曾是一个不断学习的过程,如今我们依然还在学习。本章中推荐的大部分UX实践对你和你的公司应该会有所帮助。但有些实践更适合在流程更复杂的大型公司和全球性组织中执行。你可以听取一些我们的建议,试着在你的公司中执行。你将会知道哪些实践经验是有用的,哪些需要根据自己的实际情况做调整。 2.5.1 关于扩大对技术影响力的建议 明确UI需求的优先级 从客户和用户的角度考虑UI需求的优先级。运用用户研究数据和最终用户UI验证结果证明优先级的正确性。让UI需求变得简单易懂 决策者需要理解UI需求。通过截图表达视觉效果,使用简单易懂的术语。如果你的需求是从可用性测试结果中发现的,还可以播放一段用户界面令用户抓狂的视频,只需要截选亮点即可。为UI架构团队提出需求 在为U

优秀的个人博客,低调大师

提高生产率 物联网将成制造业下一个风口!

作为推动世界高速发展的“重要生产力”,继互联网之后,物联网已造就出另一个万亿级市场。当前,物联网在重新定义人们生活的同时,也在助推我国经济转型升级。 政策市场双驱动 物联网将成制造业下一个风口 2016年以来,随着软银收购ARM、高通收购NXP的落地,IT巨头企业接连布局物联网的举动愈发频繁,智能制造、物联网产业崛起的趋势显露无遗。从世界物联网博览会上的展出情况来看,阿里巴巴、华为、中兴以及三大电信运营商等均已将物联网视为新的业务增长点。 blob.png 同时,物联网更是成为“创新高地”,不断催生新经济、新业态。在江苏,中科物联已在无锡孵化34家企业,其中3家上了“新三板”;影速科技成立三年,销售额已突破8000万元,资本市场估值超过6亿元;中科微至以高速条码识别技术和无线通信技术为核心,从事电商物流分拣装备研发,不到一年获得一亿多元的市场订单。 在备受科技圈巨头青睐的同时,政策的支持也给予很大程度的鼓励。早在2015年7月份,国务院就发布了《关于积极推进“互联网+”行动的指导意见》,明确提出要大力发展智能制造,鼓励制造企业利用物联网、云计算、大数据等技术,整合产品全生命周期数据,形成面向生产组织全过程的决策服务信息,为产品优化升级提供数据支撑。 此外,智能硬件作为物联网入口的延伸也引起了政府部门的注意。2016年9月,工信部联合发改委印发实施了《智能硬件产业创新发展专项行动(2016-2018年)》,意在推动智能硬件产业高端化、创新化、自主化、生态化、服务化发展。报告中指出,到2018年,中国智能硬件全球市场占有率将超过30%,产业规模将超过5000亿元,海外专利占比将超过10%,这为我国未来3年智能硬件发展规划了目标。 在政策的驱动下,物联网技术收获了新的发展热潮。据IHS数据显示,预计到2020年,全球物联网订单将超过1.8亿,市场规模达到300亿美元。华为消费趋势研究所预估,到2025年,物联网设备的数量将接近1000亿,新部署的传感器速度将达到每小时200万个,迅速增长的需求将带动关联领域商业价值的巨大喷发。 另根据IDC最新发布的物联网(IoT)支出报告显示,2016年全球物联网设备相关的总投资金额已达到7370亿美元,其中IoT硬件的采购金额占比30.6%,服务支出占比27.5%,软件支出和通讯连接的占比分别为25.0%和16.9%。 据预测,到2020年,物联网硬件的产值将突破4000亿美元规模,其中模块与传感器等物联网节点设备将占到硬件支出的绝大多数,而在软件部分,超过半数的软件支出将被用于APP应用的研发和维护上。从目前物联网产业的发展趋势来看,物联网、智能硬件的制造业,将是下一代整个制造业的入口。 本文转自d1net(转载)

优秀的个人博客,低调大师

智慧城市提高居民生活水平 实现目标仍有待升华

2015年,中国经济增速持续放缓,智慧城市建设从盲目追捧期走向实施落地期,智慧城市建设投资逐渐回归理性。2015年是“十二五”收官之年,在国家相关政策和智慧城市试点工作的推动下,2015年中国智慧城市市场IT投资规模达到2480亿元,年投资增长率为20.4%。“十三五”对智慧城市有着很高的憧憬,但是智慧城市说到底还是一种提升居民生活的技术手段,目前的智慧城市重点是从以下几个领域入手: 智能交通 智能交通在智慧城市建设中有着举足轻重的地位,就目前来看智能交通主要覆盖的层面有:智能交通的基础层,即城市交通灯系统与高速公路的信息化建设,包括对原来交通系统的改造;智能交通的设备层,即实现智能交通所需要的视频监控设备、射频追踪设备以及公路照明设备等;智能交通的软件层,即导航地图、地理信息系统以及云平台等软件应用等。 可以看到,目前的智能交通系统相对来说还只是一种比较被动的“智能”,主要是在原来的基础上进行一定量的改造。这在路况正常的前提下是一种锦上添花的表现——驾驶确实更加的方便,但是在极端条件下,面对路况遭到破坏依然显得“笨拙”与无能为力。比如说碰到极端寒冷时路面结冰,就会造成整个交通系统瘫痪。所以,智能交通应该需要增加一些主动处理极端条件下的能力。 智能物流 随着技术的发展,智能物流将会在智慧城市中扮演越来越重要的角色,物流在GDP中所占的比重不可忽略。据统计,在过去很长一段时间内,中国的社会物流总费用占GDP的18%左右,也就是达到10万亿级别总市场。 正因为如此,采用智能物流,增加物流的速度与效率从而降低物流总成本占GDP的比例显得尤其的重要。而打造一个完善的智能物流网,整合所有快递公司将会是一种趋势,充分利用目前的资源,实现共享,把货物流通的数据打通,形成一个巨大的即时信息平台,最终实现网上下单购物,24小时内送达。 智能物流看的是货件的管理能力与运输能力,在极端天气的条件下对于物流的影响也是极大的,所以打造一套完善的,足以抵抗极端自然条件下的物流系统也是有重要意义的,比如说,一套完善的无人机运输网络,可以很好的抗击路面交通不流畅的情况。 智能电网 国家能源局曾经表示,中国在未来5年内智能电网建设总投资规模将超过2万亿元,这对于智能电网的市场来说,是一剂强有力的催化剂,将会方便整个市场的成熟与落地。 国家投的2万亿主要是对于骨干网络的智能化升级,比如说智能变电站、智能巡视系统,或者智能电表。而这其中辐射出来的电网ICT产业市场也是很大的,然而智能电网所面临的来自于极端天气的挑战也是最严重的。所以对环境的实时监控与故障预警将会显得尤为重要。 首先是需要对现有的输点设备进行加固处理,以增加其自身的抗极端天气的能力;然后可以通过数据的分析与预警,对电线等设备可能出现的隐患进行及时的处理。这都将提升智能电网在天灾中的生存能力。 关于智慧城市 智慧城市的概念还是很大的,上述三点就是比较典型的代表,其实关于智慧城市是什么,可能一千个人眼中有一千种不同的看法,智慧城市之于不同的人、不同角色、站在不同立场,都会有不同的定义。 上班族说:“路上不那么堵,过年回家买票不那么难,就是智慧城市。”;老人家说:“我有心脏病,如果我在家里突然跌倒爬不起来了,有人能很快把我送到医院,就是智慧城市。”;小孩子说:“我不想一板一眼地坐在教室里上课,要是在家就可以学习,能向老师提问,还能跟小伙伴交流,就是智慧城市。”;创业者说:“我想办个公司,可是不知道流程,也不知道去哪里找到合作伙伴,如果这一切都更加方便,就是智慧城市。”;公务员说:“为什么有那么多上访的人呢,如果他们的想法能早点跟我们沟通解决,大家其乐融融,就是智慧城市。”;消防员说:“最好没有火灾,有烟雾苗头就能自动扑灭,但假如真正有大火了,我们能一路畅通地迅速抵达现场,这就是智慧城市。” 而这些也都是能够使得智慧城市脱离面子工程,达到实实在在的惠民目的的场景,智慧城市是融合人类的智慧而非技术的智慧,说到底还是一种提升居民生活的技术手段。 或许利用大数据、云计算、人工智能等物联网手段可以使得智慧城市达到很不错的“智商”,能够进行复杂的运算及问题处理。但是既然是智慧就总得有一定的“生气”,才会让人觉得有活力。连最简单的单细胞生物都有一种趋利避害本能反应,所以,一套高级的智慧城市系统不应只是一台死气沉沉的机器。 毫无疑问,在目前的条件下,当遭遇冰灾、雪灾、台风、甚至地震等极端的自然条件时,智慧城市的“智慧”二字就会显得太过脆弱与无能为力,或许当有一天,智能城市能够真正的主动进行适当的反应,去解决一些突发状况时,才会是智能城市的又一次升华。 本文转自d1net(转载)

优秀的个人博客,低调大师

成本降低40%、资源利用率提高20%的 AI 应用产品云原生容器化之路

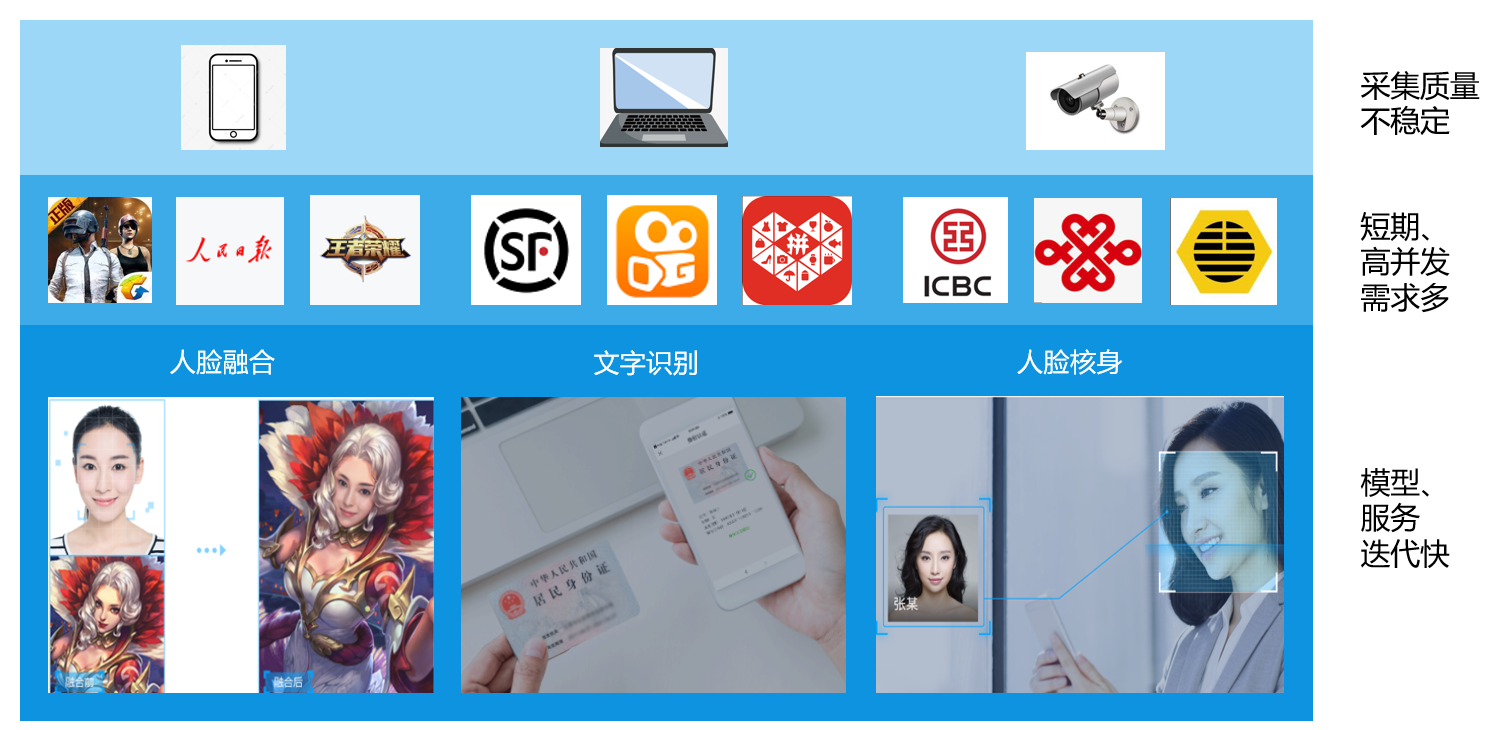
作者 郭云龙,腾讯云高级工程师,目前就职于 CSIG 云产品三部-AI 应用产品中心,现负责中心后台业务框架开发。 导语 为了满足 AI 能力在公有云 SaaS 场景下,服务和模型需要快速迭代交付的需求,保障服务在不稳定高并发时的高成功率,以及进一步提升资源利用率,AI 应用产品中心进行了一系列的调研与实践,本篇将重点介绍团队在容器化方面的实践经验。 背景和问题 公有云 AI SaaS 产品(如人脸融合)的一般服务流程为:C 端或 B 端客户通过采集设备采集图像、音视频等,经由云 API 等接入方式传入,服务端利用强大的计算能力、充足的资源和相对成熟的算法对客户输入的多媒体内容进行处理。 如上图所示,对于一般流程来说,我们面临着三个挑战。 采集质量不稳定:由于采集设备之间存在差异,采集到的质量也会存在差异,拿图像处理来说,大图和小图会给我们的服务带来不同的压力,有时服务会因为集中的大图并发产生失败。 短期、高并发需求多:我们的客户会用我们的能力实现不同的玩法,使用人脸融合来进行游戏活动宣传就是一个很常见的运营手段,但是这种活动会给我们的服务带来短期内的高并发压力。 模型、服务迭代快:AI SaaS 服务的竞争非常激烈,经常会有客户提出新的需求,加上算法难免会有 badcase,所以我们的服务也要进行很频繁的升级迭代。 我们再来看下我们容器化前的精简架构(如上图所示),物理机的开发部署大背景下,我们的逻辑服务不论是结构上还是基础上都属于大泥球模式,另外算法服务也常有混布的现象存在。 这种架构也导致了忙时服务间抢占资源的情况频繁发生,影响服务成功率及耗时,导致我们没有办法很好的满足客户的需求;而闲时资源利用率非常低,容易造成资源浪费。 以两个实际的例子来说明: 升级发布时,我们需要先从LB中剔除一个节点,并在节点上观察没有流量进入后进行服务升级。升级完成后,人工对服务进行成功性检测,检测结果ok后再加回LB中。 客户搞活动时提出高并发需求,如果当前物理机/vm资源池不满足,需要向资源同学紧急提物理机需求,资源同学协调到机器后,我们需要人工对机器环境/网络重新初始化,然后执行上述1操作。待活动结束后机器闲置,易造成成本浪费。 为了更好的满足客户不断迭代的需求,减轻研发的运维负担,补齐弹性能力和接入高效的服务管控平台对我们来说是迫切需要的。趁着公司推动上云的时机,我们对架构组件进行了几轮调研和优化。本文主要对容器化过程进行阐述。 容器化过程记录 我们的容器化上云到现在为止可以分为三步:容器化,稳定性提升和利用率提升。 容器化 这里的容器化映射到业务上来说,除了将服务载体由物理机迁移到容器上,更主要是将原来的复杂逻辑解耦,微服务化。 如下图所示,我们先对服务本身做了瘦身微服务化,另外借助于容器的能力,将原来混布的服务彻底分开。如何进行微服务化会因业务的不同存在差异,本篇对此不做赘述。 稳定性提升 在第一步容器化之后,我们很快享受到了飞一般的服务升级和扩容速度。同时对容器化比较浅显的理解也给我们带来了一些新的问题。 调用量波动较大的服务由于频繁扩缩容导致业务失败 一些客户传的大图在低核容器上处理效率较低 集群资源紧缺导致的容器无法按需扩容等。 对于上述三个问题,我们也分别找出了应对方案。 灵活使用探针 起初我们的服务都是没有设置存活和就绪检测(探针 )的,Prestop 给缩容时加上了一层保护,但是并不彻底,而且在扩容时难免会有服务失败。 探针给我们提供了另一种强大的解决方式。一开始时,我们参照链接中的示例,进行简单的端口检查来判断服务是否正常运行。后来我们发现了更多灵活的运用技巧和使用场景。以下列出几个例子供大家参考以及发散出更多有趣实践。 例子1:在一开始时大家经常遇到 LB Agent 启动时获取路由必然失败的情况,我们可以使用就绪探针来进行 LB 的预加载(如下图),即可达到 LB 获取成功后标记服务启动成功的效果。 例子2:由于一些低版本OS的实例存在弱口令的问题,大家需要把所有依赖旧版OS的镜像全部升级,这个工作对我们来说是及其繁重的,于是我们同样利用了探针,在容器标记服务启动前把弱口令全部干掉。 例子3:某个服务比较特殊,内存占用经常波动,当内存小于某个值时,服务会偶现失败,但是端口正常存活。这时我们可以使用 ConfigMap+python 脚本来进行一些复杂的检测: 针对大图进行筛选适配 容器化后,我们发现某个算法在接收到高分辨率图片时,服务成功率会出现波动,原因是算法在对提特征时会出现更多的消耗,这一现象在物理机上部署时被物理机核数多的优势掩盖住了,一旦到了核数较低的容器上就显露了出来。为了解决这个问题,我们在上层逻辑中新增了大图筛选功能(如下图所示),如果检测到是大图,则走回物理机集群(由于初始时 TKEx 提供最高规格容器核数为 8 核,后来才扩充支持了 24 核及以上),如果是一般图片,则走容器集群。 多集群部署 在使用 TKEx 时,我们经常会碰到部署的 workload 会因为整体集群资源不足的原因,无法扩容到指定的 max 值,一度非常苦恼。 TKEx 的同学也是推荐我们在其他的集群复制一份资源,当一个集群扩不出来时,另一个集群充当备份角色。在这么调整过后,我们的扩容成功率逐步上升。 后来又出现了整个地域的资源都比较紧缺的情况,于是我们把一些对时延不那么敏感的服务进行了多地域部署(如下图),最终将集群资源不足的风险进一步降低。 当一地资源不足的情况下使用多地域部署以及 LB 时,一般 LB 都会根据后端响应时间动态调整各节点权重,所以我们应注意以下两点: 关闭就近访问 根据上下游调整 LB 权重(比如上游服务部署在广州,下游同时部署了南京和广州,这是南京和广州的 LB 权重分别为130,100) 利用率提升 在进行过一轮稳定性提升之后,我们可以更加自信的利用弹性能力,利用率也有了显著提升。不过依旧有两个问题阻碍着我们的利用率更进一步。一个是有些服务模型大,启动慢,流量突增时服务无法很及时的扩容出来,这时我们必须要提前占用一些资源导致利用率提不上去。 针对第一个问题,我们挑选了部分流量有规律的服务。利用 TKE 提供的定时 HPA 能力,在已知流量高峰前定时进行一轮扩容。 成果 优化前 优化后 资源占用 1500+CPU 物理机 ( 8w+ 核)800+GPU 物理机 (P4 1600 卡) CPU 6w 核 T4 1000 卡 资源利用率 10% 30% 成本 - -40% 服务成功率 99.9% 99.95% 服务扩容效率 小规模 (<2000核): 3 小时 大规模: 2天 小规模 (<2000核): 10分钟 大规模: 6小时 服务升级效率 小规模 (<50实例): 6 小时 大规模: 2天 小规模 (<50实例): 30分钟 大规模: 6小时 当前我们的 AI 服务已经基本完成容器化的升级。成功率高,扩容快,欢迎大家扫码进行体验。 关于我们 更多关于云原生的案例和知识,可关注同名【腾讯云原生】公众号~ 福利:公众号后台回复【手册】,可获得《腾讯云原生路线图手册》&《腾讯云原生最佳实践》~ 【腾讯云原生】云说新品、云研新术、云游新活、云赏资讯,扫码关注同名公众号,及时获取更多干货!!

优秀的个人博客,低调大师

百度混部实践系列 | 如何提高 K8S 集群资源利用率?

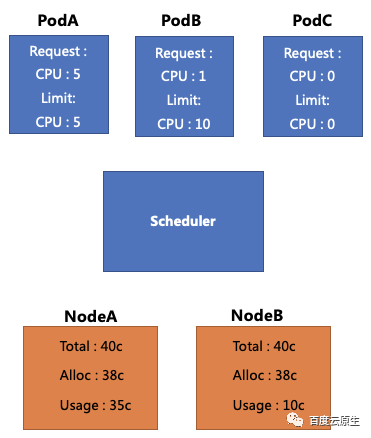
【导读】随着Kubernetes(以下简称『K8S』)被业界越来越广泛地使用,单个集群规模也逐渐增大,很多人都会发现自己维护的 K8S 集群普遍存在一个问题:分配率较高,而利用率偏低。 比如,一个有1000+节点的集群,在分配率达到80%后,常常会因为集群碎片的原因,很多大规格的 Pod 就无法再被创建出来。而与此同时,整个集群的日均 CPU 利用率却不足15%,常态使用率偏低。那么,如何才能把剩余的闲置资源尽可能利用到极致呢? 今天这篇文章,是百度云原生团队分享云原生混部实战的第一弹,我们一起探索 K8S 原理,用 K8S 原生的方式来解决这个问题。 1.原生 K8S 能否解决资源利用率问题? 首先,我们来看下图这个示例。图中黄色框代表2个 Node,这两个 Node 的 CPU 总数都是40核,并且都已经分配了38核。其中 NodeA 的真实用量是35核,NodeB 的真实用量是10核。而蓝色框则代表现在我们还有3个待调度的 Pod。 若想调度3个 Pod: PodA 的 Request 和 Limit 都是5c,此时它无法被调度,即使Node B上还有空闲资源; PodB 的 Request 为1c,Limit 为10c,该 Pod 超发比较严重,它可以被调度到 NodeA 或 NodeB,但是调度到 NodeA 时可能被驱逐; PodC 的 Request 和 Limit 都没有填写,此时它可以被调度,但是当调度到 NodeA 时可能被驱逐 基于以上场景,可以尝试总结一下为什么原生 K8S 没办法直接解决资源利用率的问题: 第一,资源使用是动态的,而配额是静态限制。在线业务会根据其使用的峰值去预估Quota(Request和Limit),配额申请之后就不能再修改,但资源用量却是动态的,白天和晚上的用量可能都不一样。 第二,原生调度器并不感知真实资源的使用情况。所以对于 PodB,PodC 这种想要超发的业务来说,无法做到合理的配置。 基于这些原因,团队进行了下一阶段的方案设计:引入动态资源视图 2.引入动态资源视图 通过添加一个 Agent 去收集单机的资源用量情况,并且汇总计算得到动态的资源视图(机器真实的用量情况),将其上报到调度器,在调度器中配置相关策略,可以将上文中提到的 PodB 和 PodC 准确的调度到 NodeB 上。 也就是说通过构建资源视图,可以将 Limit 大于 Request 的 Pod 或者没填 Request 和Limit 的 Pod,调用到真实用量更少的 Node。这个方法可以解决由于不知道机器到底用了多少资源,所以调度失败被驱逐的问题,最终达到提升 CPU 利用率的效果。 但是这样做需要付出什么代价?如果要将 PodB 和 PodC 调度到 NodeB 上,NodeB 的配额只多分配了1核,但是用量却上升了20核,这就造成了超量使用。(申请量非常少,但是用量非常多) 对于 Node B,多用的20核其实是已经分配出去的 Pod 没有用到,暂时让出的。 为了方便理解举个例子:因为工作需要,我申请了三台电脑,平时大部分情况只用一台,剩下的两台可以借给其他同事暂时用一用;但是我申请3台也是有原因的,有时候是真的要用到的,那当有用到的时候,同事就必须要还给我,所以这就涉及到一个『如何借』和『如何还』的问题。 2.1 借用的代价:不稳定的生命周期 在上述的调度情况下,如果 PodC 用量持续增长,整体的负载可能超过了对单机设备的驱逐上限,会触发单机 kubelet 的驱逐行为。 对应到上述的例子中,如果我共有三台电脑,平时只用一台,外借了两台。现在由于工作需要我要多用一台(整体用量上涨),在这种情况下我并不需要一次性把两台电脑都收回(驱逐 Pod),而是仅收回我需要的那一台即可。 比如在 CPU 层面,可以尝试先降低 PodC 的 CPU Quota;在内存层面,可以先尝试进行内存回收。换句话说,可以优先考虑降低资源使用情况,而不是直接驱逐掉 Pod。 因此有两个核心问题要解决:第一,动态资源视图要如何做;第二个单机资源的调配如何保证供给。 2.2 单机引擎:隔离与退避 名词解释:Guaranteed-Pod、Burstable、BestEffort K8S中的QoS是根据request 和limit动态算而来: request等于limit,会被放到Guaranteed-Pod之中 request不等于limit,会被放在这个Burstable(突发型)目录下 request和limit都没有填,会被放在BestEffort目录下 上图灰色框的部分是 kubelet 为每个 Pod 设置 Cgroup 的目录结构:首先有一个一级目录叫 kubepod,所有 Pod 的 Cgroup 都会被挂到它下面,图中有两个红色字体的 Guaranteed-Pod 是直接被挂载到 kubepod 目录下。 图中红色字体部分(Guaranteed-Pod, Burstable-Pod)的目录由 kubelet 给它们设置 Quota。以CPU为例,比如 Limit 填 5,Quota 就会设置为 5。白色字体部分是没有 Quota 限制的( kubepod 和 BestEffort-Pod),可以看到的是 Burstable,BestEffort 这两种 Pod 没有直接挂在 kubepod 目录下,而是自己有一个原本是空白的没有值的二级目录。 在树形结构下 Cgroup 有如下特点:单个目录下进程使用的资源限制并不仅仅受自己所在节点的限制,还要受父节点的限制。比如在 Burstable 的框下边有两个Pod(图无关),在 Burstable 那个框设置了一个 Quota 是 10c,那这两个 Burstable-Pod 的 CPU 用量总和不能超过 10c。 基于这个原理团队设计了对应的压制策略,单机引擎会根据 Guaranteed-Pod 的真实用量去给 Burstable 目录整体设置了一个值,这个值通过动态计算而来。简单来说,会先计算一下 Guaranteed-Pod 现在用多少,还剩多少资源可以给到 Burstable。BestEffort也是类似的,会先计算 Guaranteed 和 Burstable 现在的 Pod 的用量是多少,然后给框整体设定一个值。 如果单机的用量起来了,即申请的 Pod 现在要把自己借出去的这部分资源拿回来了,如何处理?此时会通过动态计算缩小 Burstable 和 BestEffort 的这两个框的值,达到一个压制的效果。 在不考虑整机 Quota 超发的情况下,如果整机 Quota 都分完了, 整机 Pod 资源用量又在持续上涨,这种情况要如何处理? 当资源用量持续上涨时,如果 BestEffort 框整体 CPU 用量小于 1c ,单机引擎会把 BestEffort Pod 全部驱逐掉。K8S 本身在单机发生资源紧张的时候,也是会按照这种顺序去驱逐相应的Pod。当Guaranteed-Pod的用量还在持续上涨的时候,就会持续的压低 Burstable 整框 CPU 的Quota,从而达到压制的效果。 Burstable 类型的 Pod 的特征是 Request 不等于 Limit , 该类型的 Pod 申请了相应资源的 Quota, 在这个前提下,Burstable 框内的Pod,最低会压到本来申请的资源量。比如 Burstable 框下只有一个Pod,Request是1c,Limit是10c,那么单机引擎最低会将 Burstable 整框压制到 1c。 换言之,对于 Request,就是说那些用户真实申请了 Quota 的资源,一定会得到得到供给;对于 Limit - Request 这部分资源,单机引擎和调度器会让它尽量能够得到供给;对于 BestEffort,也就是 No Limit 这部分资源,只要单机的波动存在,就存在被优先驱逐的风险. 但是对于一些长尾延迟来说,仅仅通过上述 K8S 的手段,保证不了服务质量。发生争抢时,系统 load 就会比较高。所以团队引入了内部的一些内核功能,并且对它进行一些扩展和支持,基本包括以下几类: 2.3 单机引擎:构建资源视图 单机 Agent 需要收集两部分资源:Pod 的资源使用情况以及整机的资源使用情况(包括机器内核指标),实时计算实时发生行为同时实时计算上报一份已经算好的数据,可以减轻调度器的计算压力。 中等质量容器可用量 = 单机最大 CPU 用量 - 高质量容器用量 -Safety-Margin 低等质量容器可用量 =单机最大 CPU 用量 - 高质量容器用量 - 中等质量容器用量 -Safety-Margin 这里的 Safety-Margin 是安全水位线,作为预留buffer能够避免用量突然的上涨导致整机突然被打满。 这样就构造出了一个单机的资源视图,将其上报到调度器,调度器将此视图来作为调度依据进行优选和预选的策略。 同时单机上还有一些可定制化的策略。通过给这些策略设计了一个这个 CRD ,单机引擎通过对 APIServer 发起 List-watch,实时的 Watch CR 的变更,实时调整参数和相关策略。 2.4 超发的结果:质量分级 以上,团队完成了在 K8S 上混部探索的第一阶段,这个方案基于 K8S 没有做侵入式改动。 但是在对接用户时经常要面对两个问题:一是用户不知道 Request 和 Limit 要怎么填? 需要先对相关概念做科普: Request 部分,代表是稳定的,安全的,只要申请了就一定可以用到的资源.。 Limit 减去 Request 部分,比如说申请的 Request 是5,Limit 是10,中间的 5核 的差距是相对来说不稳定,但大概率能够得到供给的资源。如果说有需要的时候,系统会尝试把该 Pod 超用的资源压缩回去。 No Limit,就是既不写 Request 也不写 Limit 的部分会尽量保证,但是资源供给 sla 会是一个比较低的数字,用这部分资源就要有随时被杀掉的准备。 第二个问题是如果可能,用户是否都倾向于用第一种 Request 级别的资源? 答案是否定的。事实证明,如果能把成本降下,一些鲁棒性高的业务是愿意接受低质量资源的。 比如一些不敏感的离线业务,如果被 kill,代价就是过一会再跑或者重新算一遍,它是乐于接受这种这个低质量资源的,前提条件是系统要给一个很低的成本。 因此团队构造了下图的成本模型,对于不同质量的资源,有不同的定价。作为平台方给用户结算计费的时候,会根据实际的用量和质量的乘积进行结算。 比如 K8S 集群中托管的机器没开混部,定价可能是D(假设D为1);在开了混部的集群当中,用户去用这些 Request,价格可能就是0.85;在开了混部的很多集群当中,用户用 Limit 部分的话,价格可能就是0.5;如果用 Besteffort 部分,那可能它的价格是0.1。 通过这种方式,找到了第一批的这个种子用户。不管是在线业务、离线业务、测试业务,还有一些内部 DevOps 业务,都非常愿意根据这个成本模型再重新审视自己的业务模型, 选择对应的资源等级来运行自己的业务。 3.落地之后遇到了哪些问题 热点问题 : 保证了用量, 如何保证质量? 热点问题并不仅仅是混部带来的,在线跟在线业务部署在同一台机器上也有这个问题。比如资源的争抢、内核关键路径的争抢都可能导致延迟的上升。在百度内部如果搜索的一个接口,由于混部质量导致延迟超过一百毫秒的话,影响面就会非常大,因为业务的链路通常都比较长,延迟累计最终给用户响应的时间可能达到秒级,这种情况是不可接受的。 除了内核提供的隔离技术外,如何给出热点问题的兜底方案? 答案是热点迁移,出现热点,系统自动迁移容器。具体而言,单机引擎会通过收集应用的一些指标来判断这个应用是否发生热点。如果发生热点的话,就会给一个机器上打一个 Annotation,然后当调度器 Watch 到这个 Annotation 时,它就会认为台机器上发生了热点,就要迁移热点容器。 Pending Pod : 低质量需求激增带来的调度性能需求 以某用户跑数的场景为例,假设他预计需要1000核资源,要在明天早上9点完成,因此他就申请了1000核高质量的资源,同时他又申请了1万核 Besteffort 的资源一块跑,通过了1万核的低质量的资源加速,可能不用明早9点,半夜1点就跑完了,剩下的这部分成本就了省下来。 但是用户这种使用方法会给调度器的性能带来很大影响,在集群负载较高时,用户创建的 BestEffort Pod 由于资源不足导致全部 Pending,而这些 Pending Pod 会反复的出现在调度队列中,针对这种场景,我们尝试对离线调度器进行功能和性能上的优化 : 副本数托管: 基于集群负载对应用进行动态扩缩容。社区叫 HCPA,用户通过创建一个 CR 来描述任务的最低的副本数是多少,最高的副本数是多少,当集群负载发生变化的时候,Controller 可以动态的扩缩用户的任务副本数,而不再是静态的创建出海量的 Pending Pod, 阻塞在队列中。 多调度器: 基于质量的多调度器。对 Besteffort 的容器来说, 在调度时调度器并不关心静态资源视图,也就是 Node Allocatable Resource。调度器只关心这台机器上现在还剩多少可用资源,所以在资源视图的角度,天然就和其他两种质量的 Pod 不冲突. 基于这个前提,我们将 Guaranteed 和 Burstable 两种类型的 Pod 归并到一个调度器内进行调度, 而 BestEffort 类型的 Pod 则在另外一个离线调度器内调度。 等价类合并: 在一个调度周期内, 使用相同 Pod Template 生成的 Pod, 在进行调度计算时一定会得到相同的 Node 列表。基于这个前提, 在调度上我们构造了等价类的概念,在调度时单位从 Pod 变成了 PodEquivalenceGroup. 在优选结束后, 会按照 Node 分数的顺序来依次调度 PodEquivalenceGroup 中的所有 Pod。这样处理相当于将 O(n) 的调度计算降为了 O(1)。 乐观并发调度: 目前开源的 Kubernetes 调度器, 无论是默认调度器还是社区的 kube-batch, volcano 都是依次进行调度的,队头阻塞的现象较为严重。在优先级相同的情况下, 最后一个 Pod 的调度延迟约等于队列内所有 Pod 的调度延迟之和。并发的关键在于如何解决冲突 : 在调度器内存中为每一个 Node 维护了一个版本号, 当 Pod 与 Node 进行 Bind 操作时, 会尝试对 Node 版本号进行 +1 的 CAS 操作, 如果失败,则说明该 Node 已经发生过 Bind 操作, 此时会将该 Node 重算并重新尝试调度。基于 CAS + Version 的机制, 我们实现了同优先级情况下, Pod 并发调度的方案。该方案可以带来 4 ~ 8 倍的调度性能提升。 4.总结 K8S 原本的资源模型存在局限性。我们可以基于原生的 QOS 体系做一些不修改原本语义的扩展行为,并且基于质量建立相应的定价体系,通过给出不同质量的资源供给 SLA,来对资源进行差异化定价,从而引导用户更加合理地使用资源。目前我们在做的进一步探索是,如何根据业务特征,来划分出更适合业务的,更细粒度的资源模型。 建立云原生可观测体系,根据质量去做单机资源的隔离/压制以及驱逐行为。因为在常见混部的情况下热点问题经常发生,由于热点对延迟敏感型业务会造成较大的影响,所以热点问题事实上限制了整机最大的资源利用率。而热点问题根因通常在内核层面,内核的可观测性又比较差,因此目前百度云原生团队在探索基于 ebpf 来建立更细粒度的热点探测/分析体系。 大规模混部落地后,需要对热点问题、调度性能等问题给出解决方案。后续持续迭代相应的调度功能,在调度性能和支撑大数据业务容器化上做出更进一步的探索。 - End - 点击进入了解更多技术资讯~~

优秀的个人博客,低调大师

德哥PG系列课程直播(第15讲):PostgreSQL 新类型提高开发生产力

直播回顾 地址:https://yq.aliyun.com/live/909 知识点 知识点:JSON, ARRAY, RANGE 学习资料 1、PostgreSQL 店铺运营实践 - JSON[]数组 内部标签数据等值、范围检索100倍+加速示例 (含,单值+多值列合成) https://yq.aliyun.com/articles/501431标签:PostgreSQL , json , 数组 , 多值 , 等值 , 多值 , 一棵树 , 多颗树 , gin , btree , gist 2、PostgreSQL UDF实现tsvector(全文检索), array(数组)多值字段与scalar(单值字段)类型的整合索引(类分区索引) - 单值与多值类型复合查询性能提速100倍+ 案例 (含,单值+多值列合成)标签:PostgreSQL , 单值列 , 多值列 , GIN倒排索引 , 多值列变异 , 分区索引 , 分区表 , 变异索引 3、PostgreSQL 多重含义数组检索与条件过滤 (标签1:属性, 标签n:属性) - 包括UPSERT操作如何修改数组、追加数组元素标签:PostgreSQL , 多重函数数组 , UDF索引 , 过滤 , 文本处理 4、会议室预定系统实践(轻松解放开发) - PostgreSQL tsrange(时间范围类型) + 排他约束标签:PostgreSQL , tsrange , 范围 , exclude using , 排他约束 , btree_gist , 会议室预定 , 时间重叠 , 空间重叠 5、聊聊between and的坑 和 神奇的解法标签:PostgreSQL , 物联网 , 智能DNS , range , iprange , intrange , 排他约束 , GiST索引 往期回顾 PostgreSQL多场景阿里云沙箱实验(第14讲):PostgreSQL 数据清洗、采样、脱敏、批处理、合并 https://yq.aliyun.com/live/885PostgreSQL多场景阿里云沙箱实验(第13讲):PostgreSQL 图式关系数据应用实践 https://yq.aliyun.com/live/869PostgreSQL多场景阿里云沙箱实验(第12讲):PostgreSQL 物联网最佳实践https://yq.aliyun.com/live/846PostgreSQL多场景阿里云沙箱实验(第11讲):PostgreSQL 在社交应用领域的最佳实践 https://yq.aliyun.com/live/824PostgreSQL多场景阿里云沙箱实验(第10讲):PostgreSQL 时空调度数据库实践 https://yq.aliyun.com/live/807PostgreSQL多场景阿里云沙箱实验(第9讲):PostgreSQL 时空业务实践 https://yq.aliyun.com/live/794PostgreSQL多场景阿里云沙箱实验(第8讲):PostgreSQL 简单空间应用实践 https://yq.aliyun.com/live/783PostgreSQL多场景阿里云沙箱实验(第7讲):PostgreSQL 并行计算 https://yq.aliyun.com/live/733PostgreSQL多场景阿里云沙箱实验(第6讲):PostgreSQL 用户画像系统实践 https://yq.aliyun.com/live/710PostgreSQL多场景阿里云沙箱实验(第5讲):PostgreSQL 估值、概率计算 https://yq.aliyun.com/live/691PostgreSQL多场景阿里云沙箱实验(第4讲):PostgreSQL 实时多维分析 https://yq.aliyun.com/live/659PostgreSQL多场景阿里云沙箱实验(第3讲):PostgreSQL 实时搜索实践https://yq.aliyun.com/live/647PostgreSQL多场景阿里云沙箱实验(第2讲):PG秒杀场景实践https://yq.aliyun.com/live/615PostgreSQL多场景阿里云沙箱实验(第1讲):如何快速构建海量逼真测试数据https://yq.aliyun.com/live/594 主讲人 德哥(云栖社区昵称:德哥)阿里云数据库专家,PostgreSQL中国社区校长。 格言:公益是一辈子的事, I'm digoal, just do it. 专家已经在社区发布了1946篇技术博文,很快将突破2000篇。厉害了!想要成为德哥粉丝请直接点击这里。 直播时间 时间:2019年3月6日 19:30 直播地址 PostgreSQL技术进阶群,钉钉扫码入群看直播

优秀的个人博客,低调大师

浅谈如何提高自动化测试的稳定性和可维护性 (pytest&allure)

装饰器与出错重试机制 谈到稳定性,不得不说的就是“出错重试”机制了,在自动化测试中,由于环境一般都是测试环境,经常会有各种各种的抽风情况影响测试结果,这样就为测试的稳定性带来了挑战,毕竟谁也不想自己的脚本一天到晚的出各种未知问题,而往往这种环境的抽风(通常是前端页面的响应速度和后端接口的响应速度)带来的影响是暂时的,可能上一秒失败了,下一秒你再执行又好了,在这种情况下,如果你有一个出错重试机制,起码可以在这种暂时性的影响下让你的脚本安然无恙,下面我们具体的说一下做法。 什么是装饰器? 因为我们的做法依赖装饰器,所以在去做之前,先简单介绍一下装饰器。 装饰器,表现形式为,在方法(或者类)的上面加上@xxx这样的语句,假如我们已经实现了一个装饰器名叫retry,那么我们想用它就这么用: @retry def test_login(): print("test") error = 1/0 如果retry实现了出错再次重试(稍后再说如何实现),那么这么使用的话,就会让test_login这个case在执行出错的时候再次执行。 很神奇,让我们来看看实现retry的代码: def retry(func): def warp(): for time in range(3): try: func() except: pass return warp 就结果而言,执行以下代码: @retry def test_login(): print("test") error = 1/0 test_login() 和执行: retry(test_login)() 是等价的,由此我们可以看出,装饰器其实本质上就是一个函数,这个函数接收其他函数(或者类)作为参数,通过对这个函数(或者类)的调用或者修改,完成不更改原始函数而修改该函数的功能。 在这里还有一个知识点,你有没有想过,在retry内部的函数warp(),是怎么拿到func这个参数来执行的?执行retry函数return的是warp这个函数,而warp并没有接受func这个传参啊。 这就是python里的闭包的概念,闭包就是指运行时自带上下文的函数,比如这里的warp这个函数,他运行的时候自带了上层函数retry传给他的func这个函数,所以才可以在运行时对func进行处理和输出。 了解了装饰器和闭包,那么下面就很容易做到对测试用例的出错重试机制了。 如果对软件测试、接口测试、自动化测试、性能测试、LR脚本开发、面试经验交流。感兴趣可以来加群:747981058,群内会有不定期的发放免费的资料链接,这些资料都是从各个技术网站搜集、整理出来的,如果你有好的学习资料可以私聊发我,我会注明出处之后分享给大家。 编写一个出错重试装饰器 现在,我们来尝试自己编写一个用于测试用例的出错重试装饰器,代码如下: def retry(times=3,wait_time=10): def warp_func(func): def fild_retry(*args,**kwargs): for time in range(times): try: func(*args,**kwargs) return except: time.sleep(wait_time) return fild_retry return warp_func 这个装饰器可以通过传入重试次数(times)和重试等待时间(wait_time),对待测用例实行重试机制。 pytest里的出错重试机制实现 在测试框架pytest里,已经实现了有关出错重试的策略,我们首先需要安装一个此类的插件,在cmd内执行以下命令安装: pip install pytest-rerunfailures 如果你需要将此机制应用到所有的用例上,那么请在执行的时候使用如下命令(reruns是重试次数): pytest --reruns 5 来执行你的用例; 如果你期望加上出错重试的等待时间,请使用如下命令(reruns-delay是等待时间): pytest --reruns 5 --reruns-delay 1 来执行你的用例; 如果你只想对某几个测试用例应用重试策略,你可以使用装饰器: @pytest.mark.flaky(reruns=5, reruns_delay=2) 例如: @pytest.mark.flaky(reruns=5, reruns_delay=2) def test_example(): import random assert random.choice([True, False]) 更详细的介绍请参阅官方文档。 Allure里的测试用例分层 刚刚我们实现了用例的出错重试机制,但是这仅仅解决了脚本在不稳定环境下的稳定性;如果还想要脚本变得更加容易维护,除了传统的po模式使用例和元素分离之外,我们还可以引入测试用例分层机制。 为什么要采用分层机制? 传统的po模式,仅仅实现了用例和元素分离,这一定层面上保障了用例的可维护性,起码不必头疼于元素的变更会让用例到处失效;但是这还不够,例如,现在有三个case,他们都包含了以下步骤:登录、打开工作台、进入个人中心;那么如果不做分层,这三个用例会把这三个步骤都写一遍,如果某天页面的变动导致其中一个步骤需要更改,那么你不得不去每个用例里去更新那个步骤。 而如果,我们把用例当做是堆积木,登录、打开工作台、进入个人中心这三个步骤都只是个积木,那么我们写用例的时候,只需要在用到这个步骤时,把积木搭上去;如果某一天,其中一个积木的步骤有变动,那么只需要去更改这个积木的内容,而无需在每个使用了这个积木的用例里去改动。 这大大增强了用例的复用性和可维护性,这就是采用分层机制的原因,下面,我会就allure里的分层机制做介绍来讨论具体如何实现。 allure的装饰器@step 在allure里,我们可以通过装饰器@step完成分层机制,具体的,当你用@step装饰一个方法时,当你在用例里执行这个方法,会在报告里,表现出这个被装饰方法;而@step支持嵌套结构,这就意味着,你可以像搭积木一样去搭你的步骤,而他们都会一一在报告里被展示。 下面直接用allure的官方示例作做举例: import allure import pytest from .steps import imported_step @allure.step def passing_step(): pass @allure.step def step_with_nested_steps(): nested_step() @allure.step def nested_step(): nested_step_with_arguments(1, 'abc') @allure.step def nested_step_with_arguments(arg1, arg2): pass def test_with_imported_step(): passing_step() imported_step() def test_with_nested_steps(): passing_step() step_with_nested_steps() 运行这个case后,报告是这样的: 可以看到, test_with_nested_steps由passing_step()和step_with_nested_steps()这两个方法组成; 而step_with_nested_steps()又由nested_step()组成; nested_step()又由nested_step_with_arguments(1, 'abc')组成; 这样就像搭积木一样,组成了测试用例;而在报告里,也层级分明的标识了步骤的嵌套结构。 这样,我们就可以通过一个又一个@step装饰的方法,组成测试用例;同时报告里也会支持层级显示;从而完成我们的分层机制。

优秀的个人博客,低调大师

阿里云智能软件机器人码栈,提高数千万人工作效率

码栈,以提升企业提效为目标,帮助用户连接不同的系统和服务,实现工作流程自动化。运用码栈能够显著将客服、运营、财务、法务、设计师以及更多领域的客户重复工作流高速化,提升岗位效率,进而提升企业效率。 码栈为电商、金融、游戏、政府、教育、财税、及传统大型企业等人力密集型企业提供一个高效引擎。在三个典型应用场景:数据采集、批量处理和系统协同中,码栈的效率是传统人工效率的数倍。以电商运营为例,每天重复工作包括:下载报表、整理汇总、售前催单、顾客答疑、订单监控、物流跟踪、售后退款、新品上架、内容核对、促销活动报名等多达数十个环节,优质电商会吸入巨大流量,而这样的流量往往意味着人员的大批量增加,码栈通过将工作流标准,规模化,实现了效率最大化,码栈可以自动实现数据对接,把ERP与售后系统对接起来。码栈配有应用市场,用户可以添加ISV提供SaaS企业

优秀的个人博客,低调大师

《UX最佳实践:提高用户体验影响力的艺术 》一2.2 什么是SAP Business ByDesign

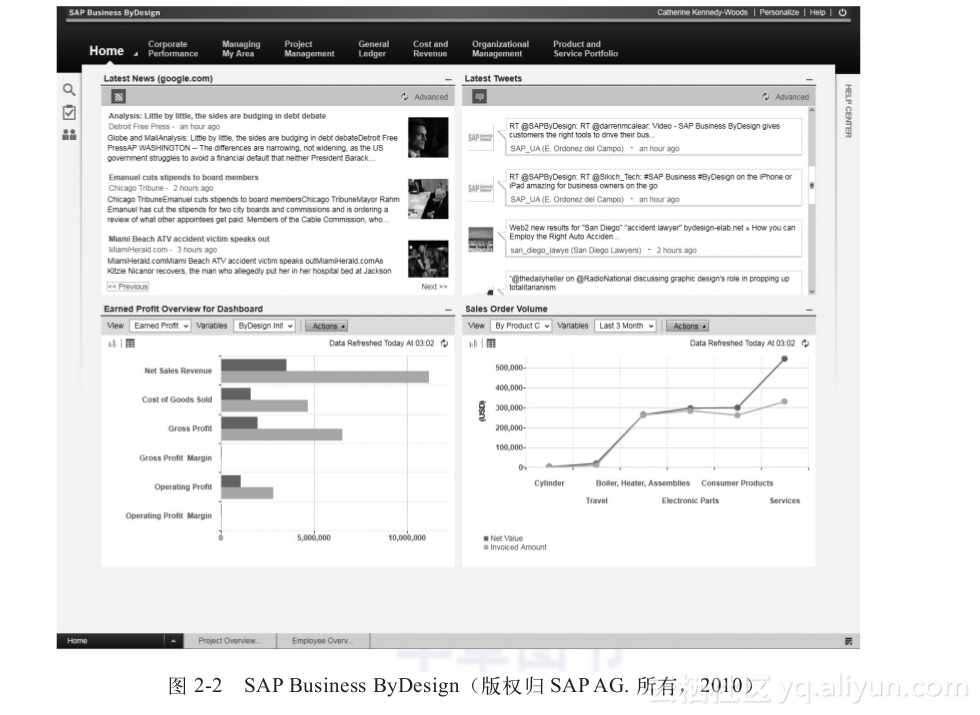
2.2 什么是SAP Business ByDesign SAP Business ByDesign是SAP新推出的按需配置的企业管理解决方案,主要面向中小型企业。这一解决方案因其存在很多创新之处,可以使其区别于市场上的其他产品。SAP Business ByDesign是全球最完备、最灵活、按需配置的企业管理解决方案。与其他按需配置的企业管理软件不同,SAP Business ByDesign(见图2-2)让企业端到端的每个流程都更透明且易于掌控,这其中包含了客户关系管理(CRM)、供应商关系管理(SRM)、供应链管理(SCM)、财务管理(FIN)和人力资源(HR)。此方案让企业能立即对自己的情况进行360度掌握,并且它简单易用,能快速配合商业需求的变动。 SAP Business ByDesign设计时考虑了以下几个关键原则: 坚

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册