首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

Themosis —— WordPress 快速开发框架

Themosis 是一种框架,可帮助开发者使用WordPress更快地开发网站和 Web 应用程序。Themosis 框架使用优雅而简单的代码语法,可帮助开发者构建和组织代码,并允许开发者更好地管理和扩展 WordPress 网站和应用程序。 Themosis 框架是一款面向任何级别的 WordPress 开发人员的工具。但是,您对 WordPress 和 PHP 的了解越多,使用起来就越容易。 要求: 服务器要求与WordPress基本相同,但额外增加了一些: PHP >= 7.1 IntlPHP 扩展 我们建议至少使用 PHP 7.2+ 安装 Composer Themosis 框架使用Composer管理其依赖项并轻松加载其文件。请按照此处的说明在计算机上本地或全局安装 Composer。 在 Windows 上,您可以使用 ComposerWindows 安装程序。 我们建议在系统上全局安装 Composer。 安装 Themosis 框架 打开Terminal或Console执行以下命令: composer create-project themosis/themosis my-project-name 这将在计算机上调用的目录创建一个my-project-name,并自动下载最新的 WordPress 版本以及最新的 Themosis 框架版本及其依赖项。 安装Themosis 默认情况下,不再使用 Composer 安装默认主题。 相反,CLI 工具现在与框架捆绑在一起并安装在项目根目录下。要安装新主题,请从终端运行以下命令: php console theme:install 该命令将要求用户输入主题名称,然后将主题下载并解压缩到htdocs/content/themes目录中。

优秀的个人博客,低调大师

如何快速定位程序Core?

导读:程序core是指应用程序无法保持正常running状态而发生的崩溃行为。程序core时会生成相关的core-dump文件,是程序崩溃时程序状态的数据备份。core-dump文件中包含内存、处理器、寄存器、程序计数器、栈指针等状态信息。本文将介绍一些利用core-dump文件定位程序core原因的方法和技巧。 全文7023字,预计阅读时间 13分钟。 一、程序Core定义及分类 程序core是指应用程序无法保持正常running状态而发生的崩溃行为。程序core时会生成相关的core-dump文件,core-dump文件是程序崩溃时程序状态的状态数据备份。core-dump文件包含内存、处理器、寄存器、程序计数器、栈指针等状态信息。我们可以借助core-dump文件来分析定位程序Core的原因。 这里我们从三个方面对程序Core进行分类:机器、资源、程序Bug。下表对常见的Core原因进行了分类: 二、函数栈介绍 当我们打开core文件时,首先关注的是程序崩溃时的函数调用栈状态,为了方便理解后续定位core的一些技巧,这里先简单介绍一下函数栈。 2.1 寄存器介绍 目前生产环境都为64位机,这里只介绍64位机的寄存器,如下: 对于x86-64架构,共有16个64位寄存器,每个寄存器的用途并不单一,如%rax通常保存函数返回结果,但也被应用于imul和idiv指令。这里重点关注%rsp(栈顶指针寄存器)、%rbp(栈底指针寄存器)、%rdi、%rsi、%rdx、%rcx、%r8、%r9(分别对应第1~6函数参数)。 Callee Save说明是否需要被调用者保存寄存器的值。 2.2 函数调用 2.2.1 调用函数栈帧: 在调用一个函数时首先进行的是参数压栈,参数压栈的顺序跟参数定义的顺序相反。注意,并不是参数一定会压栈,在x86-64架构中会针对可以使用寄存器传递的变量,直接通过寄存器传值,如数字、指针、引用等。 接着是**返回地址压栈,**返回地址为被调用函数执行完后,调用函数执行的下一个指令地址。这里牢记返回地址的位置,后续章节会利用到这个返回地址的特性。 针对上面的介绍举个例子说明: 如上图,在main函数中调用了foo函数,首先对参数压栈,三个参数都可以直接用寄存器传递(分别对应%edi、%esi、%edx),然后call指令将下一个指令压栈。 2.2.2 被调用函数栈帧: 被调用函数首先会将上一个函数的栈底指针(%rbp)保存,即%rbp压栈。然后再保存需要被保存的寄存器值,即Callee Save为True的寄存器。接着为临时变量、局部变量申请栈空间。 针对被调用函数,举个例子说明: 如上图,在foo函数执行时,先对main函数的%rbp压栈,再把寄存器中的参数值存放到局部变量(a, b, c)中。 2.3 总结 通过对函数调用的简单介绍,我们可以发现函数栈是一个缜密且脆弱的结构,内存结构必须按照严格的方式被访问,如稍有不慎就可能导致程序崩溃。 三、GDB定位Core 这一节将介绍从core文件打开到定位全流程中可能会遇到的问题以及解决技巧。 3.1 Core文件 core文件在哪里? 查看“/proc/sys/kernel/core_pattern”确定core文件生成规则。 3.2 变量打印 程序debug过程中常常要查看各种变量(内存、寄存器、函数表等)的值是否正确,维持单独用一节介绍下常用的变量打印方法以及一些冷门小技巧。 3.2.1 print命令 print [Expression] print $[Previous value number] print {[Type]}[Address] print [First element]@[Element count] print /[Format] [Expression] Format格式: o - 8进制 x - 16进制 u - 无符号十进制 t - 二进制 f - 浮点数 a - 地址 c - 字符 s - 字符串 3.2.2 x命令 x /<n/f/u> <addr> n:是正整数,表示需要显示的内存单元的个数,即从当前地址向后显示n个内存单元的内容,一个内存单元的大小由第三个参数u定义。 f:表示addr指向的内存内容的输出格式, s对应输出字符串,此处需特别注意输出整型数据的格式: x 按十六进制格式显示变量. d 按十进制格式显示变量。 u 按十进制格式显示无符号整型。 o 按八进制格式显示变量。 t 按二进制格式显示变量。 a 按十六进制格式显示变量。 c 按字符格式显示变量。 f 按浮点数格式显示变量。 u:就是指以多少个字节作为一个内存单元-unit,默认为4。 u还可以用被一些字符表示: 如b=1 byte, h=2 bytes,w=4 bytes,g=8 bytes.<addr>:表示内存地址。 3.2.3 容器对象打印 利用上面的print和x命令,再结合容器的数据结构,我们就能知道容器的详细信息。这里举个完整打印二进制string的例子,string的数据结构如下: string为空时,_M_dataplus._M_p是指向nullptr的。当赋值后会在堆上申请一段内存,分为两段,前半段是meta信息(类型为std::string::_Rep),如length、capacity、refcount,后半段为数据区,_M_p指向数据区。 通常情况下非二进制的string,直接print即可显示数据内容,但当数据为二进制时,'\0'会截断打印内容。因此,打印二进制string的首要任务是确认string的size。 string的size信息保存在std::string::_Rep结构体中,根据上面的数据结构可以发现,_Rep与_M_dataplus._M_p相差一个结构体大小,因此打印_Rep结构体的命令为: #先把_M_p转成_Rep指针,再让指针向低地址偏移一个结构体大小 p *((std::string::_Rep*)(s._M_dataplus._M_p) - 1) 找到string的size(_M_length)后,再通过x命令打印相关的内存区即可,命令为: #这里的n是_Rep._M_length x /ncb s._M_dataplus._M_p 运行效果如下: 为了方便,这里推荐一个方便的脚本:stl-views.gdb(链接:https://sourceware.org/gdb/wiki/STLSupport?action=AttachFile&do=view&target=stl-views-1.0.3.gdb,直接在gdb终端source stl-views.gdb即可,支持常见的容器打印,如vector、map、list、string等。 3.2.4 静态变量打印 程序中经常会使用到静态变量,有时我们需要查看某个静态对象的值是否正确,就涉及到静态对象的打印。看如下例子: void foo() { static std::string s_foo("foo"); } 这里可以借助nm -C ./bin | grep xx找到静态变量的内存地址,再通过gdb的print打印。 3.2.5 内存dump dump [format] memory filename start_addr end_addr dump [format] value filename expr format一般使用binary,其他的可以查看gdb手册。 比如我们可以结合上面查看string内容的例子dump整个string数据到文件中。 dump binary memory file1 s._M_dataplus._M_p s._M_dataplus._M_p + length 如果想查看文件内容的话可把vim -b和xxd结合使用。 接上面string的例子,举一个dump string内存数据到文件的例子: 3.3 定位代码行 定位core的原因,首先要定位崩溃时正在执行的代码行,这一节主要介绍一些定位代码行的方法。通常情况下直接通过gdb的breaktrace即可一览整个函数栈,但有时候函数栈信息并非如此清晰明了,这时就可利用一些小技巧来查看函数栈。 3.3.1 去编译优化 有时候会发现core的函数栈跟实际的代码行不匹配,如果是在线下环境中,可以尝试把编译优化设置成**-O0**,然后再重新复现core问题。 3.3.2 程序****计数器 + addr2line 对于线上core问题,一般没法再对程序进行去编译优化操作,只能在现有的core文件基础上进行代码定位。这一节我们采用一个例子来介绍如何使用程序计数器 + addr2line来定位代码行。 从截图可以发现frame 20指示的代码行与实际的代码行是不匹配的,定位步骤如下: # 跳转到第20号栈 frame 20 # 使用display命令显示程序计数器 display /i $rip # 使用addrline工具做地址转换 shell /opt/compiler/gcc-8.2/bin/addr2line -e bin address 3.3.3 函数栈修复 有时候我们会发现函数调用栈里面会出现很多??的情况,这常发生于栈被写花,某些情况下手动进行修复。函数栈的修复利用的函数栈内存分布知识,见第一节。 ----------------------------------- Low addresses ----------------------------------- 0(%rsp) | top of the stack frame | (this is the same as -n(%rbp)) ---------|-------------------------- n(%rbp) | variable sized stack frame- 8(%rbp) | varied 0(%rbp) | previous stack frame address 8(%rbp) | return address ----------------------------------- High addresses 从上面的栈示意图可以发现,利用%rbp寄存器即可找到上一个函数的返回地址和栈底指针,再利用addr2line命令找到对应的代码行。这里举一个例子: #首先找到当前被调用栈上一个栈的栈底指针值和返回地址 x /2ag $rbp # 2个单位,a=十六进制,g=8字节单元 #使用上一条命令得到的栈底指针值依次递归 x /2ag address 3.3.4 无规律core栈 无规律core栈问题一般发生于堆内存写坏。函数调用是一个非常精密的过程,任何一个位置发生非预期的读写都会导致程序崩溃。这里可以举个小例子来说明: int main(int argc, char* argv[]) { std::string s("abcd"); *reinterpret_cast<uint64_t*>(&s) = 0x11; return 0; } 上面的例子core在string析构上,原因是因为string的_M_ptr被改写成了0x11,析构流程变成了非法内存操作。 同理,由于进程堆空间是共享的,一个线程对堆的非法操作就可能会影响另一个线程的正常操作,由于堆分配的随机性,表现出来的现象就是无规律core栈。 针对无规律core栈最好的方式还是借助AddressSanitizer。 #设置编译参数CXXFLAGS CXXFLAGS="-fPIC -fsanitize=address -fno-omit-frame-pointer" #设置链接参数 LDFLAGS="-lasan" # 设置启动环境变量 export ASAN_OPTIONS=halt_on_error=0:abort_on_error=1:disable_coredump=0 # 启动 LD_PRELOAD=/opt/compiler/gcc-8.2/lib/libasan.so ./bin/xxx 3.3.5 总结 上面提到的几种方法都是为了找到具体的问题代码行,为后续分析core的具体原因提供线索。 3.4 定位Core原因 这一节主要介绍定位Core原因的方法以及一些常见原因的介绍。 3.4.1 确认信号量 从上面的Core分类我们可以发现某些场景的core是由于机器故障导致的,如SIGBUS,因此可以先通过信号量排除掉一些core原因。 3.4.2 定位异常汇编指令 通过上面的代码行定位我们可以大致找到程序core在哪一行,比较简单的core直接print程序上下文即可找到core的原因。 但有些场景下,通过排查上下文无任何异常,这个时候就需要准确定位具体的异常汇编指令,根据指令找原因。 查看汇编指令比较简单的方法是使用layout asm命令,frame指向那个栈,就显示对应栈的汇编。这里举个core例子,如下: 程序显示core在start函数,查看相关上下文变量均无异常。使用layout asm打开正在执行的汇编指令,如下: 查看汇编定位到程序core在mov指令,mov指令上一个指令为sub,为栈申请了3M空间,怀疑是栈空间不足。采用frame 0的%rsp - frame N的%rbp排查为栈空间不足。 通过上面的例子,可以发现定位异常汇编指令位置后,我们能够把异常点进一步压缩,定位到是哪个指令、变量、地址导致的core问题。 3.4.3 排查异常变量 通过上面的操作我们可以准确定位到具体是哪一行代码的哪一条指令出现了问题,根据异常指令我们可以排查相关的变量,确定变量值是否符合预期。 这里举一个比较经典的空指针例子,如下: int main(int argc, char* argv[]) { int* a = nullptr; *a = 1; return *a; } 通过汇编指令我们可以发现是movl $0x1, (%rax)出现了问题,%rax的值来自于0x8(%rbp),x命令打印相关的地址就可以发现为空指针错误。 3.4.4 查看被优化变量 通常情况下程序都是开启了编译优化的,就会出现变量无法被print,提示变量被优化,有时可利用汇编 + 寄存器的方式查看被优化的变量。 这里举一个例子说明下: void foo(char const* str) { char buf[1024] = {'\0'}; memcpy(buf, str, sizeof(buf)); } int main(int argc, char* argv[]) { foo("abcd"); return 0; } 通常情况下在foo函数内部,str变量是会直接别优化掉的,因为可以直接利用%rdi寄存器传递参数。为了能够打印出str的值,这个时候我们可以借助汇编 + 寄存器的方式找到具体的变量值,如下: 首先找到main函数调用foo函数的参数压栈汇编:mov $0x402011, %edi,这里的0x402011即为str的内存地址,通过x命令即可显示str的值了。 比较复杂的场景可能没法直接找到被优化变量,这时可以采用汇编回溯的方式找到变量。 3.4.5 异常函数地址排查 有时的core问题是因为数据异常导致,有时也可能是优化函数地址导致,如调用虚函数地址错误、函数返回地址错误、函数指针值错误。 异常函数地址排查同理于异常变量排查,根据汇编指令确认调用是否异常即可。这里举一个虚函数地址异常的例子,如下: class A { public: virtual ~A() = default; virtual void foo() = 0; }; class B : public A { public: void foo() {} }; int main(int argc, char* argv[]) { A* a = new B; a->foo(); A* b = new B; *reinterpret_cast<void**>(b) = 0x0; b->foo(); return 0; } 从汇编指令看是core在了mov (%rax), %rax,结合指令上下文可发现是在虚函数地址寻址操作,对比两个变量的虚函数表即可发现是函数地址load错误导致的core。 3.4.6 总结 定位core的基本流程可总结为以下几步: 明确core的大致触发原因。机器问题?自身程序问题? 定位代码行。哪一行代码出现了问题。 定位执行指令。哪一行指令干了什么事。 定位异常变量。指令不会有问题,是指令操作的变量不符合预期。 善于利用汇编指令以及**打印指令(x、print、display)**可以更有效的定位Core。 参考资料: 汇编查看工具:https://godbolt.org/ https://cppinsights.io/ 标准GDB文档:https://sourceware.org/gdb/current/onlinedocs/gdb/ 招聘信息: 欢迎加入百度移动生态事业群内容中台架构团队,我们常年需求后端、C++、模型架构、大数据、性能调优的同学、社招,实习,校招都要哦 简历投递邮箱:geektalk@baidu.com (投递备注【内容架构】) 推荐阅读: |面向大规模商业系统的数据库设计和实践 |百度爱番番移动端网页秒开实践 |解密百TB数据分析如何跑进45秒 ---------- END ---------- 百度Geek说 百度官方技术公众号上线啦! 技术干货 · 行业资讯 · 线上沙龙 · 行业大会 招聘信息 · 内推信息 · 技术书籍 · 百度周边 欢迎各位同学关注

优秀的个人博客,低调大师

混合云的快速指南

混合云模型为企业提供了一种利用公共云和私有云优势的方法。 混合云带来了两全其美的优势。 在最初的几年中,云计算技术日渐盛行,得到了IT和金融专业人士的称赞。但是,那些使用极其敏感或关键任务系统的人仍然不愿意使用该技术。企业开始做的是保持平衡并采用混合模型,而不是全盘采用内部部署数据中心或公共系统。 混合云是一种利用私有云和公共云在同一组织内执行不同功能的集成云服务。所有云计算服务应在不同程度上提供一定的效率,但公共云服务可能比私有云更具成本效益和可扩展性。借助混合云,组织可以通过将公共云服务用于所有不敏感的操作,而仅在需要时依靠私有云,从而确保所有平台无缝集成,从而最大限度地提高效率。 混合云是指由本地基础设施、私有云服务和公共云(例如Amazon Web Services(AWS)或Microsoft Azure)组成的混合计算、存储和服务环境,其中各个平台之间进行了编排。在数据中心中结合使用公共云,本地计算和私有云意味着企业拥有混合云基础设施。 混合云是一种计算环境,它通过允许在数据和应用程序之间共享而将公共云和私有云结合在一起。当计算和处理需求波动时,混合云计算使企业能够将其内部部署基础设施无缝扩展到公共云,以处理任何溢出。无需让第三方数据中心访问其全部数据。组织可以在基本和非敏感计算任务上获得公共云的灵活性和计算能力,同时将关键业务应用程序和数据安全地保留在公司防火墙的内部。 混合云通常是指公共云服务和内部私有云的结合;但是,混合云也可以由不同提供商提供的两个公共云组成,甚至可以由云和传统IT组成。实际上,当前将传统IT基础设施上的现有系统与公共云服务相结合的设置是混合云最常见的用例。 混合云使企业可以使用更广泛的IT服务组合。例如,企业可能在私有云中运行关键任务工作负载,但使用公共云提供商的数据库或归档服务。 这意味着,公共云的即付即用的可扩展性非常适合繁忙或不可预测的流量,并且可以降低IT成本。当企业需要增强安全性并需要对关键业务应用程序和数据进行最终控制时,请合并私有云。利用单租户专用服务器的性能,企业可以在裸机上获得超快的性能、安全性和可靠性。混合云方法可以统一这两种方法,可以为企业提供经济高效的安全解决方案。 混合云用例是大数据处理。例如,一家公司可以使用混合云存储来保留其累积的业务、销售、测试和其他数据,然后在公共云中运行分析查询,这可以扩展Hadoop或其他分析集群以支持要求苛刻的分布式计算任务。 尽管有好处,混合云计算仍会带来技术,业务和管理方面的挑战。这需要本地IT员工和云架构师的大量专业知识。诸如数据库,帮助台系统和其他工具之类的其他软件的实施可能会使私有云进一步复杂化。此外,企业对私有云的技术支持负全部责任,并且必须适应公共云API的任何更改以及服务随时间的变化。 此外,可能存在潜在的连接问题、服务等级协议(SLA)违规以及其他可能的服务中断。为了减轻这些风险,组织可以设计与多个公共云提供商进行互操作的混合云工作负载。在某些情况下,企业需要重新设计混合云计划的工作负载,以解决特定公共云提供商的API。 迁移到混合云可以节省资金,并使企业更高效、,更敏捷。与私有云相比,公共云可能会提供更重要的规模经济,例如集中管理,因此具有更高的成本效率。因此,混合云使企业可以尽可能多地访问这些节省的业务功能,同时仍保持敏感操作的安全性。

优秀的个人博客,低调大师

借助URLOS快速安装AliSQL

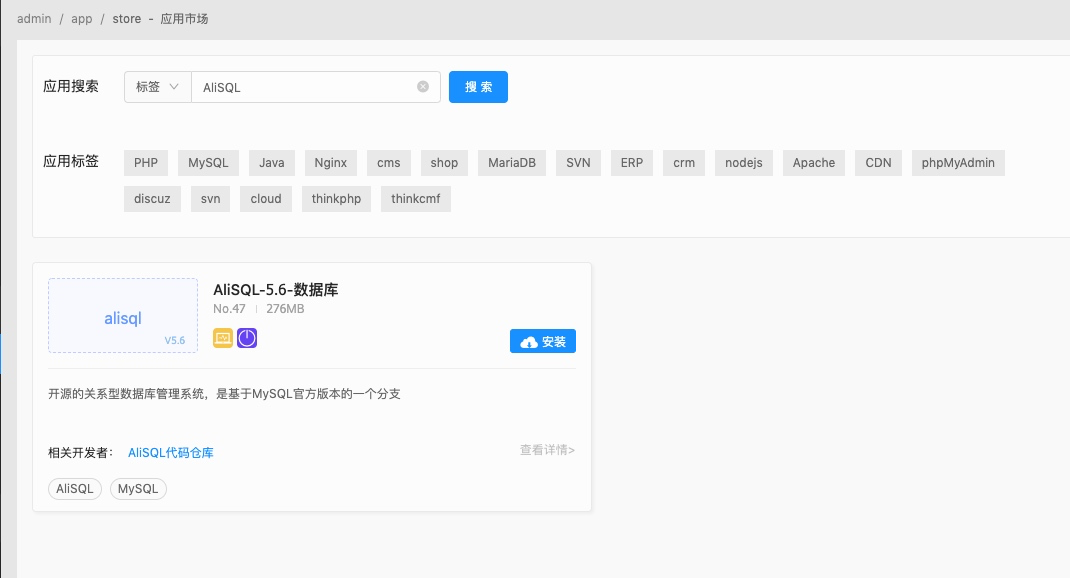
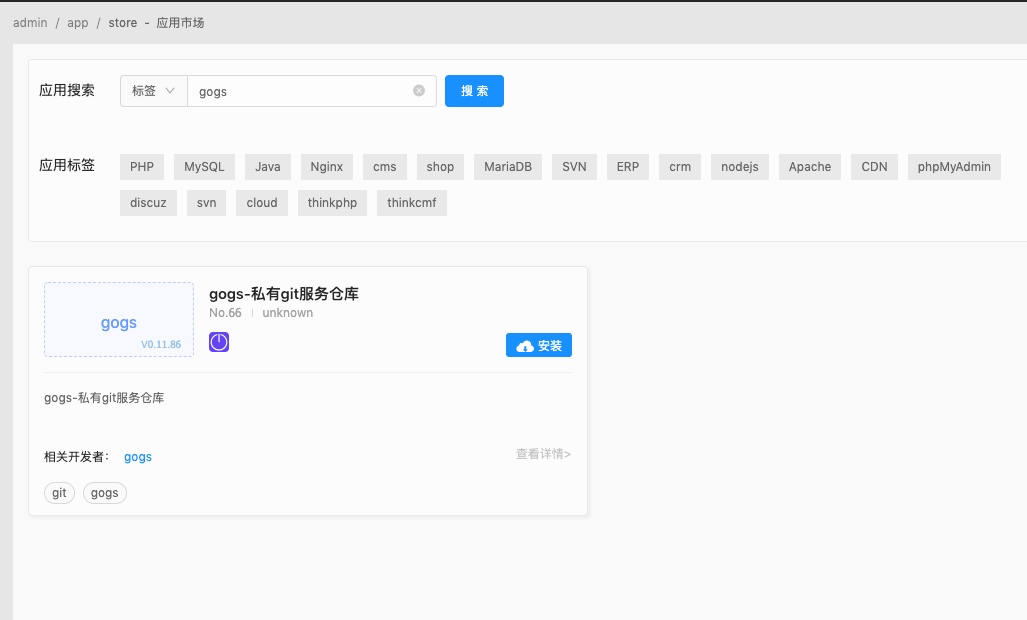
环境需求 最低硬件配置:1核CPU,1G内存(1+1)提示:如果你的应用较多,而主机节点的硬件配置较低,建议在部署节点时开通虚拟虚拟内存; 生产环境建议使用2G或以上内存; 推荐安装系统:Ubuntu-16.04、Ubuntu-18.04、CentOS7.X、Debian9X的64位的纯净的操作系统; URLOS安装 curl -LO www.urlos.com/iu && sh iu AliSQL安装流程 登录URLOS系统后台,在应用市场中选择别名并搜索“AliSQL”,找到之后,选择合适的版本点击安装按钮 填写服务名称、选择运行节点、服务端口、选择智能部署 填写数据库root用户密码 然后点击“提交”按钮,等待部署完成。

优秀的个人博客,低调大师

借助URLOS快速安装Ruby

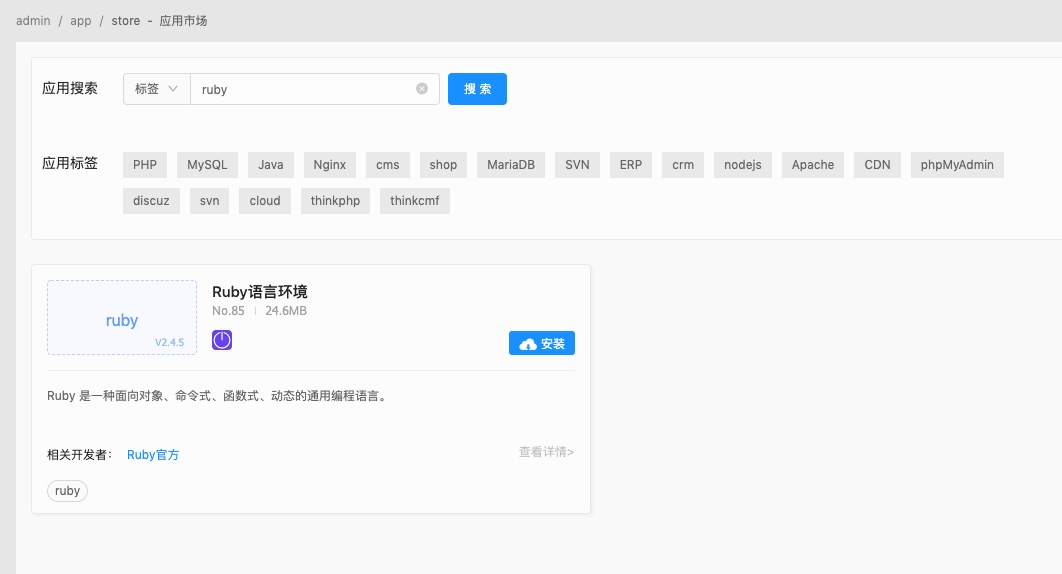
环境需求 最低硬件配置:1核CPU,1G内存(1+1)提示:如果你的应用较多,而主机节点的硬件配置较低,建议在部署节点时开通虚拟虚拟内存; 生产环境建议使用2G或以上内存; 推荐安装系统:Ubuntu-16.04、Ubuntu-18.04、CentOS7.X、Debian9X的64位的纯净的操作系统; URLOS安装 curl -LO www.urlos.com/iu && sh iu Ruby安装流程 登录URLOS系统后台,在应用市场中搜索“Ruby”,找到之后,直接点击安装按钮 填写服务名称、选择运行节点、选择智能部署 填写ssh密码(这里的密码是root密码) 然后点击“提交”按钮,等待部署完成;

优秀的个人博客,低调大师

快速了解 前端打包 webpack

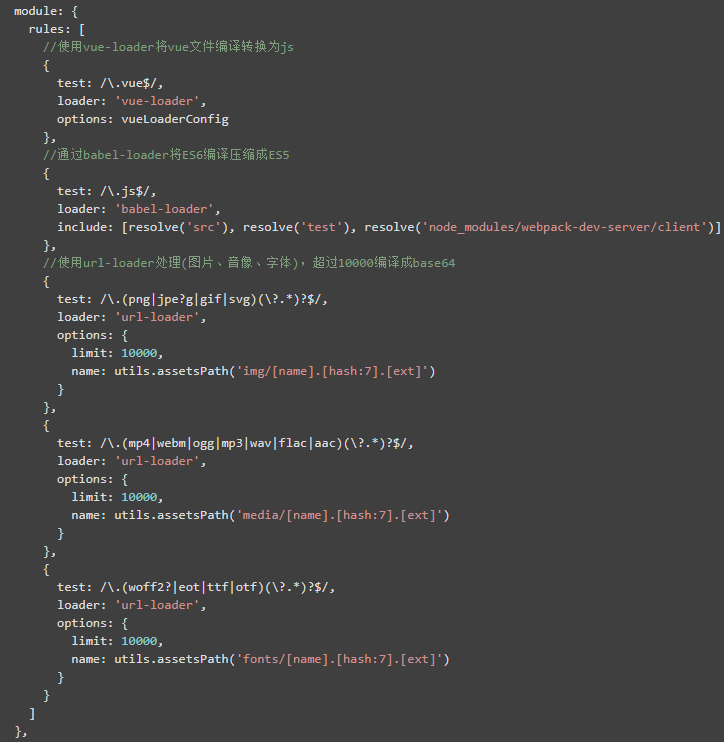
一、介绍 (1)概念 webpack 用于编译 JavaScript 模块,是JavaScript 静态模块的打包工具。从 webpack v4.0.0 开始,可以不用引入一个配置文件。 (2)核心 1.入口(entry):指定webpack打包编译从哪个文件开始下手 入口起点(entry point)指示 webpack 使用哪个模块,作为构建其内部依赖图的开始。进入入口起点后,webpack 会找出有哪些模块和库是入口起点(直接和间接)依赖的。 webpack.config.js: module.exports = { entry: { main: './src' //打包入口,来指定一个入口起点(或多个入口起点,默认值为 ./src) }, entry: './src', //这个是上面的简写方式,是等价的 entry: { home: "./home.js", about: "./about.js", contact: "./contact.js" },//对象法指定多个入口,如果你想要多个依赖一起注入到一个模块,向 entry 属性传入「文件路径(file path)数组」。 entry: () => new Promise((resolve) => resolve(['./demo', './demo2'])),//动态入口,当结合 output.library 选项时:如果传入数组,则只导出最后一项 }; 2.出口(output):指定webpack打包编译后的路径及文件名 output属性告诉 webpack 在哪里输出它所创建的bundles,以及如何命名这些文件。基本上,整个应用程序结构,都会被编译到你指定的输出路径的文件夹中。 webpack.config.js: const path = require('path'); module.exports = { entry: './src',//配置入口路径 output: { path: path.resolve(__dirname, 'dist'),//打包文件夹名,默认值为./dist filename: '[name].js'//入口文件名 } }; 3.loader(加载器):webpack识别不了的语言通过加载器来翻译 loader 用于转换某些类型的模块,webpack 自身只理解 JavaScript,loader 可以将所有类型的文件转换为 webpack 能够处理的有效模块。loader 能够import导入任何类型的模块(如.css),是 webpack 特有的功能,其他打包工具有可能不支持。 webpack.config.js: const path = require('path'); const config = { output: { filename: 'my-first-webpack.bundle.js' }, module: { rules: [//在 webpack 配置中定义 loader 时,要定义在module.rules中,里面包含两个"必须属性":test和use { test: /\.txt$/, //test定义需要使用相应 loader 进行转换的某类文件 use: 'raw-loader' //use定义使用哪个 loader 进行转换 } ] } }; module.exports = config; 常见的例子: 4.插件(plugins):webpack完成不了的功能通过插件来完成 插件接口功能极其强大,可以用来处理各种各样的任务。通过require()使用插件,然后把它添加到plugins数组中。多数插件可以通过选项(option)自定义。 webpack.config.js: const HtmlWebpackPlugin = require('html-webpack-plugin'); // 通过 npm 安装 const webpack = require('webpack'); // 用于访问内置插件 const config = { module: { rules: [ { test: /\.txt$/, use: 'raw-loader' } ] }, plugins: [ //在一个配置文件中因为不同目的而多次使用同一个插件,需要通过使用new操作符来创建它的一个实例 new webpack.optimize.UglifyJsPlugin(), new HtmlWebpackPlugin({template: './src/index.html'}) ] }; module.exports = config; 5.模式(mode):通过模式确定是开发环境还是生产环境以便加载不同配置 module.exports = { mode: 'production'//通过选择development(开发)或production(生产),启用相应模式下的 webpack 内置的优化 }; 二、安装 (1)安装nodeJs webpack 配置是标准的 Node.js CommonJS 模块,在安装webpack之前,请确保安装了Node.js的最新版本,使用旧版本可能遇到各种问题(可能缺少 webpack 功能或者缺少相关 package 包)。 (2)安装webpack 1.本地安装 对于大多数项目,我们建议本地安装。这可以使我们在引入破坏式变更(breaking change)的依赖时,更容易分别升级项目。 npm install --save-dev webpack //安装最新版本 npm install --save-dev webpack@<version> //安装特定版本 操作如下: 2.全局安装 不推荐全局安装 webpack。这会将你项目中的 webpack 锁定到指定版本,并且在使用不同的 webpack 版本的项目中,可能会导致构建失败。 npm install --global webpack 3.最新体验版本 最新体验版本(可能仍然包含 bug)不应该用于生产环境 //直接从 webpack 的仓库中安装 npm install webpack@beta npm install webpack/webpack#<tagname/branchname> 4.安装 CLI 如果你使用 webpack 4+ 版本,你还需要安装 CLI。 npm install --save-dev webpack-cli //webpack-cli用于在命令行中运行 webpack 操作如下: 三、配置(configuration) webpack 的配置文件,是导出一个对象的 JavaScript 文件。webpack 需要传入一个配置对象(configuration object), 根据对象定义的属性进行解析,因此很少有 webpack 配置看起来很完全相同。可以通过两种方式(终端、Node.js)使用 webpack。 webpack 配置是标准的 Node.js CommonJS 模块,你可以: 通过require(...)导入其他文件,使用 npm 的工具函数 使用 JavaScript 控制流表达式 对常用值使用常量或变量 编写并执行函数来生成部分配置 请在合适的时机使用这些特性,虽然技术上可行,但应避免以下做法: 在使用 webpack 命令行接口(CLI)(应该编写自己的命令行接口(CLI),或使用--env)时,访问命令行接口(CLI)参数 导出不确定的值(调用 webpack 两次应该产生同样的输出文件) 编写很长的配置(应该将配置拆分为多个文件) 你需要从这份文档中收获最大的点,就是你的 webpack 配置,可以有很多种的格式和风格。但为了你和你的团队能够易于理解和维护,你们要始终采取同一种用法、格式和风格。 基本配置 webpack.config.js const HtmlWebpackPlugin = require('html-webpack-plugin'); //通过 npm 安装 const webpack = require('webpack'); //访问内置的插件 const path = require('path'); const config = { entry: './path/to/my/entry/file.js', output: { filename: 'my-first-webpack.bundle.js', path: path.resolve(__dirname, 'dist') }, module: { rules: [ { test: /\.(js|jsx)$/, use: 'babel-loader' } ] }, plugins: [ new webpack.optimize.UglifyJsPlugin(), new HtmlWebpackPlugin({template: './src/index.html'}) ] }; module.exports = config; 也可以 多个 Target:导出多个配置,或者,使用其他配置语言,webpack 接受以多种编程和数据语言编写的配置文件。

优秀的个人博客,低调大师

Hbase快速开始——shell操作

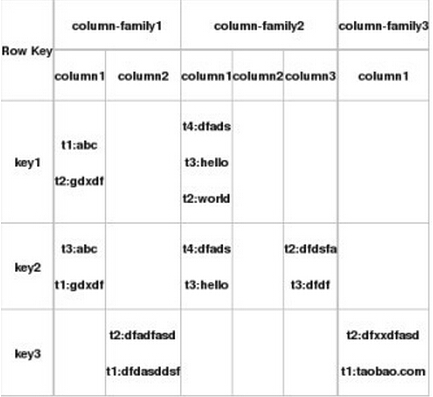
一. 介绍 HBase是一个分布式的、面向列的开源数据库,源于google的一篇论文《bigtable:一个结构化数据的分布式存储系统》。HBase是Google Bigtable的开源实现,它利用Hadoop HDFS作为其文件存储系统,利用Hadoop MapReduce来处理HBase中的海量数据,利用Zookeeper作为协同服务。 HBase以表的形式存储数据。表有行和列组成。列划分为若干个列族/列簇(column family)。 如上图所示,key1, key2, key3是三条记录的唯一的row key值,column-family1, column-family2, column-family3是三个列族,每个列族下又包括几列。比如 column-family1这个列族下包括两列,名字是column1和column2。t1:abc,t2:gdxdf是由row key1和column-family1-column1唯一确定的一个单元cell。这个cell中有两个数据,abc和gdxdf。两个值的时间戳不一样,分别是t1,t2, hbase会返回最新时间的值给请求者。 二. 安装 下载HBase最新版本,放到合适的目录,比如/usr/local 或 /opt 之后解压 tar -zxvf hbase-x.y.z tar.gz 三. 命令行操作 进入解压后的目录,开启hbase,启动hbase shell bin/start-hbase.sh bin/hbase shell 输入 help 可以看到命令分组 部分命令清单 下边分组举例 general操作 查询服务器状态 status 查询hbase版本 version ddl操作 1. 创建一个表 create 'table1', 'tab1_id', 'tab1_add', 'tab1_info' 2. 列出所有的表 list 3. 获得表的描述 describe "table1" 4. 删除一个列族 disable alter enable disable 'table1' alter 'table1', {NAME=>'tab1_add', METHOD=>'delete'} enable 'table1' 5. 查看表是否存在 exists 'table2' 6. 判断表是否为‘enable’ is_enabled 'table1' 判断表是否为‘disable’ is_disabled 'table1' 7. 删除一个表 disable 'table1' drop 'table1' dml操作 1. 插入几条记录 1 2 3 4 5 6 put 'member' , 'scutshuxue' , 'info:age' , '24' put 'member' , 'scutshuxue' , 'info:birthday' , '1987-06-17' put 'member' , 'scutshuxue' , 'info:company' , 'alibaba' put 'member' , 'scutshuxue' , 'address:contry' , 'china' put 'member' , 'scutshuxue' , 'address:province' , 'zhejiang' put 'member' , 'scutshuxue' , 'address:city' , 'hangzhou' 2. 全表扫描 scan 3. 获得数据 get 3.1 获得一行的所有数据 3.2 获得某行,某列族的所有数据 3.3 获得某行,某列族,某列的所有数据 4. 更新一条记录 put(把scutshuxue年龄改为99) put 'member', 'scutshuxue', 'info:age', 99 5. 删除 delete、 deleteall 5.1 (删除行'scutshuxue', 列族为‘info' 中age的值 delete 'member', 'scutshuxue', 'info:age' 5.2 删除整行 deleteall 'member', 'scutshuxue' 6. 查询表中有多少行 count 'member' 7.给‘xiaoming’这个id增加'info:age'字段,并使用counter实现递增 incr 'member', 'xiaoming', 'info:age' 8. 将整个表清空 truncate 'member' tools操作 1. 创建一个表 四. 参考 http://smallwildpig.iteye.com/blog/1705718 本文转自jihite博客园博客,原文链接:http://www.cnblogs.com/kaituorensheng/p/3814925.html,如需转载请自行联系原作者


资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册