首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

Spring入门介绍

spring是为了解决企业应用开发环境所创建的。框架的主要优势之一是分层架构,分层架构允许使用者选择使用哪一个组件,同时也为javaEE应用开发提供集成的框架。 IOC和AOP这两个模块是Spring的核心模块,同时也是系统中其他模块的其他组件应用开发的基础。只有深刻了解这两个模块的基本原理,才能更好的进行Spring应用程序的开发。 一、Spring概况 a.Spring的简介 Spring是一个轻量级控制反转(IoC)和面向切面(AOP)的容器框架,它主要是为了解决企业应用开发的复杂性而诞生的。 目的:解决企业应用开发的复杂性 功能:使用基本的JavaBean代替EJB 范围:任何的Java应用 b.Spring的起源 Spring的存在是因为它自身有着得天独厚的优势: 它定位的领域是其他framework没有的 Spring是全面的和模块化的 它的设计从底部帮助开发者编写易于测试的代码 Spring是潜在的一站式解决方案 c.Spring的优点 Spring天生就存在如下的优点: 低侵入式设计,代码污染极低 Write Once,Run Anywhere DI有效的降低了耦合度 AOP提供了通用任务的集中管理 ORM和DAO简化了对数据库的访问 高度开放性,并不强制 Spring的优点给开发带来的好处: 可以有效组织中间层对象 使用统一的配置文件 促进良好编程习惯,减少编程代价 易于单元测试 使EJB成为一种备选 为数据的存取提供了一致的框架 d.Spring的特点 方便解耦,简化开发 AOP编程的支持 声明式事务的支持 方便程序的测试 方便集成各种优秀框架 降低JavaEE API的使用难度 Spring的源码是经典的学习范例 e.Spring的核心模块 Spring框架是一个分层架构,它由7个定义良好的模块组成。Spring的模块构建在核心容器之上,核心容器对应了创建、配置和管理Bean的方式。组成Spring框架的每个模块或者组件都可以单独存在,或者与其他一个或多个模块来联合实现一个应用程序。 核心容器(Spring Core) 核心容器定义了框架的基本功能。核心容器的主要组件是BeanFactory,它是工厂模式的实现。BeanFactory使用控制反转(IOC)模式将应用程序的配置和依赖性规范与实际的应用程序代码分开。 应用上下文(Spring Context) Spring上下文是一个配置文件,向Spring框架提供上下文信息。Spring上下文包括企业服务,例如JNDI、EJB、电子邮件、国际化、校验和调度功能。 AOP模块(Spring AOP) 通过配置管理特性,Spring的AOP模块直接将面向切面的编程功能集成到了Spring框架当中。所以,可以很容易地使Spring框架管理的任何对象都可以支持AOP。Spring的AOP模块为基于Spring的应用程序中的对象提供了事务管理服务,通过使用Spring AOP,不用依赖EJB组件就可以将声明性事务管理集成到应用程序当中。 JDBC和DAO模块(Spring DAO) JDBC DAO抽象层提供了有意义的异常层次结构,可用该结构来管理异常处理和不同数据库供应商抛出的错误消息。异常层次结构简化了错误处理,并且极大地降低了需要编写的异常代码数量(例如打开和关闭连接)。Spring DAO的面向JDBC的异常遵从通用的DAO异常层次结构。 对象实体映射(Spring ORM) Spring框架插入了若干个ORM框架,从而提供了ORM对象的关系工具。其中包括JDO、Hibernate、iBats。所有这些都遵从Spring的通用事务和DAO异常层次结构。 Web模块(Spring Web) Web上下文模块建立在应用程序上下文模块之上,为基于Web的应用程序提供了上下文。所以Spring框架支持与Struts的集成。Web模块还简化了处理多部分请求以及将请求参数绑定到预对象的工作。 MVC模块(Spring Web MVC) Spring的MVC框架是一个全功能的构建Web应用程序的MVC的实现。通过策略接口,MVC框架变成了高度可配置的。MVC容纳了大量视图技术,其中包括JSP、Tiles、iText和POI。模型由JavaBean来构成,存放于map当中。而视图是一个接口,负责实现模型。控制器表示逻辑代码,是Controller的实现。 Spring的框架的功能可以用在任何J2EE服务器当中,大多数功能也适用于不受管理的环境。Spring的核心要点就是:支持不把用到特定JavaEE服务的可重用业务和数据的访问对象。毫无疑问,这样的业务和对象可以在不同的JavaEE环境独立应用程序和测试环境之间重用。 本文转自yeleven 51CTO博客,原文链接:http://blog.51cto.com/11317783/1832047

优秀的个人博客,低调大师

openstack(一)入门

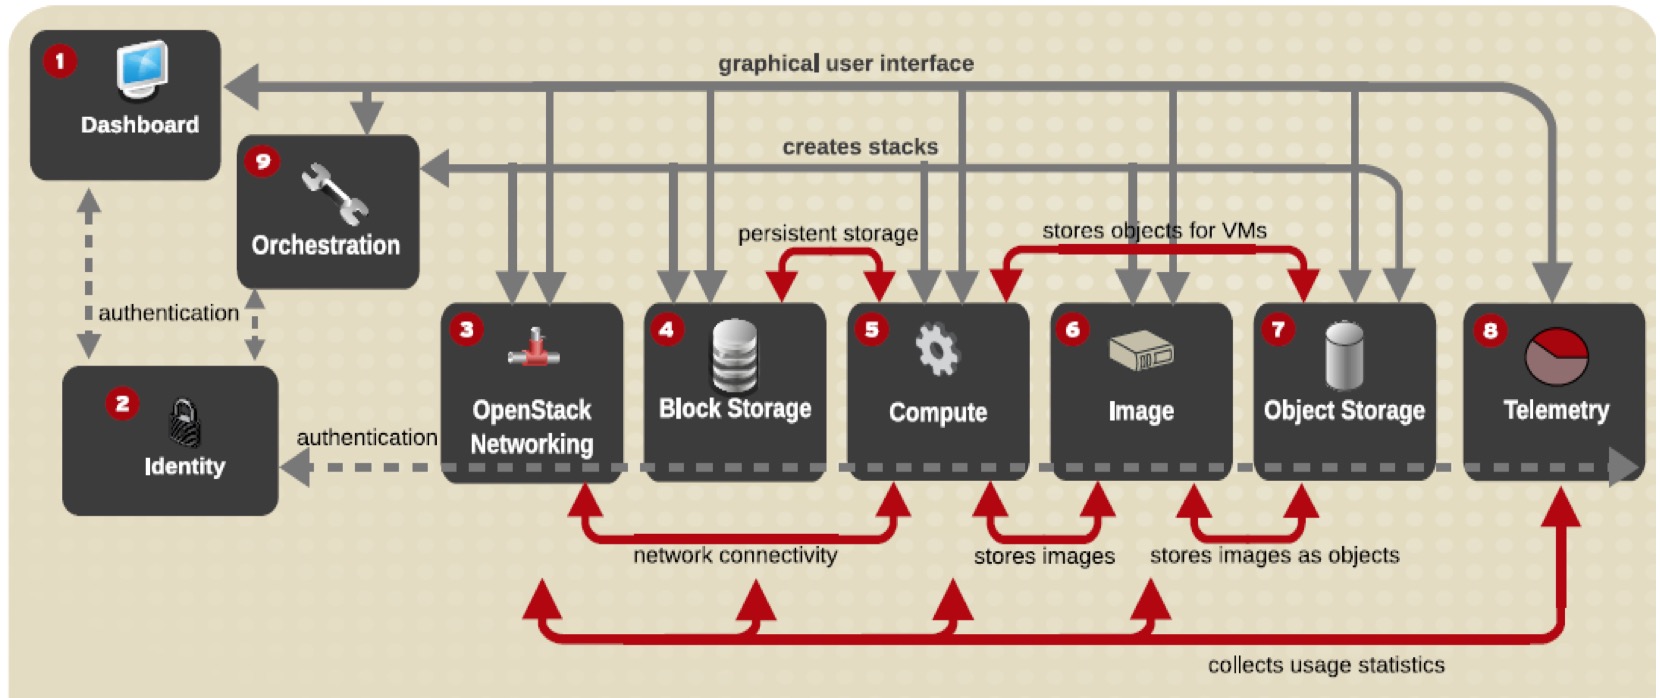
可能很多人会跟我一样,开始刚接触openstack,去学的时候发现东西很多,越看越乱,有种无处发力的感觉。这里我结合红帽RHCA认证里的openstack课程认证和openstack官方网站,加上自己的理解,整理成博文,抛砖引玉。 一、基本概念 OpenStack是一个由NASA(美国国家航空航天局)和Rackspace合作研发并发起的,以Apache许可证授权的自由软件和开放源代码项目。 OpenStack是一个开源的云计算管理平台项目,由几个主要的组件组合起来完成具体工作。OpenStack支持几乎所有类型的云环境,项目目标是提供实施简单、可大规模扩展、丰富、标准统一的云计算管理平台。OpenStack通过各种互补的服务提供了基础设施即服务(IaaS)的解决方案,每个服务提供API以进行集成。 概念里面几个关键字:开源、云计算管理平台、IaaS、集成。 总的来讲,个人觉得,学习openstack大概需要了解以下几个技能: 要有基本的linux知识 了解基本的虚拟化相关概念,熟悉KVM等 搞云计算离不开网络,对DHCP、NAt、Bridge、vlan这些网络知识是必须要了解的。 了解相关存储知识,如分布式存储、对象存储 掌握一种自动化部署的工具,比如puppet、ansible、Chef等你会发现事半功倍 Python 了解一个框架,flask或Django起码知道。OpenStack 基于 Web 的管理控制台 OpenStack Dashboard 是用 Python 和 Django 框架写的。 二、openstack架构 先上图,暂不多说: 三、主要服务(service) 因为openstack涉及的service比较多,初期接触的时候建议只关注几个关键的服务,慢慢的由浅入深。 安照openstack官方给出的顺序: 第一步,选择你的使用方式,How will you beusing OpenStack? 是只当计算资源用还是当对象存储 使用,亦或两者结合使用; 第二步,选择核心服务,包括keystone(identity)、nova(compute)、neutron(networking)、cinder(block storage)、swift(object storage)glance(glance),这几个core service基本都是需要了解的; 第三步,选Optional Services来强化,这里面可以优先选择看horizon(dashboard)、 ceilometer(telemetry)、heat(orchestration)。 相关服务介绍如下: Horizon(dashboard) 一个基于Web的Openstack管理平台,为用户提供如:启动虚拟机、管理虚拟网络、设置访问控制的图像接口。 Keystone(identity) 一个中心认证服务,为其他服务提供认证和授权。keystone同时提供openstack云各个其他组件的目录服务。 Keystone提供多种认证方式包括:用户名、密码,令牌,AWS(Amazon logins) Keystone是所有服务的起始点,只有经过认证,其它的服务才会认为可以合法执行。它是Openstack的钥匙。 Neutron(networking) 在Openstack云中创建和管理虚拟网络架构(网络、子网、路由、防火墙) Cinder(block storage) 为虚拟机提供逻辑卷管理功能,通常为虚拟机提供附加磁盘存储。 Nova(compute) 提供虚拟机管理功能,调用底层的Hypervisor提供该功能,支持libvirtd,qemu,kvm等Hypervisor。 Glance(image) Glance项目提供虚拟机镜像的发现,注册,取得服务; Glance提供restful API可以查询虚拟机镜像的metadata,并且可以获得镜像; 通过Glance,虚拟机镜像可以被存储到多种存储上,比如简单的文件存储或者对象存储。 Swift(object storage) Swift项目提供了弹性可伸缩、高可用的分布式对象存储服务,适合存储大规模非结构化数据。 Ceilometer(metering) Ceilometer像一个漏斗,能把OpenStack内部发生的几乎所有的事件都收集起来,然后为计费和监控以及其它服务提供数据支撑。 Heat(orchestration) heat实现了一种自动化的通过简单定义和配置就能实现的云部署方式。可以在heat模板中定义连串相关任务(例如用某配置开几台虚拟机,然后再去在其中一台中安装一个mysql服务,设定相关数据库属性,然后再配置几台虚拟机安装web服务集群等等),然后交由heat,由heat按照一定的顺序执行heat模板中定义的一连串任务。 本文转自Jx战壕 51CTO博客,原文链接:http://blog.51cto.com/xujpxm/1745675,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker入门(二)

一、Docker相关概念 1.Docker: namespace,cgroup: 解决方案: lxc,openvz lxc:linux containers docker最初就是lxc的封装版本。 docker engine/docker server:输出一个api,用于接受外部请求 接受到client请求,借助于lxc虚拟化技术,在lxc上创建一个虚拟机实例。 docker借助于外部的dockerhub,实现image 后台docker不再使用lxc,使用libcontainer[centos 7],隔离用户空间的引擎 在前端使用没有区别 2.容器虚拟化 例如kvm也需要images,有一个完整的OS 而容器所需的images,并非完整的OS,只拥有FS,没有内核 借助于AUFS技术对映像文件进行分层,容器运行一个独立的FS上 运行nginx需要nginx依赖的库,运行mysql需要依赖mysql的库 把FS做成一个base image,再做几个专用的image,例如nginx专用的,MySQl专用的 [docker hub] / / [cn1][cn2]... [API] [docker engine ] ======================= Hypervisor ============= Host OS ============== 【硬件】 3.核心组件; docker client:docker的client工具,用户使用docker的接口,docker client与docker daemon通信。并将结果返回给client docker daemon:运行在宿主机,Docker的守护进程,用户可通过docker client与其交互; image :只读的,基于aufs或者UnionFS叠加在一起,用来创建container 一个镜像可以运行多个container;镜像文件可以通过Dockerfile创建,也可以从docker hub/registry 下载 repository 公共仓库 //提供有base image Docuer hub/registry 私有仓库 //docker repository docker container:docker的运行实例,容器是一个隔离环境 另外两个重要组件: docker link:各docker之间的通信,openvswtich,netns构建, docker volume:容器中的数据的持久化 二、安装Docker: centos6 ;epel centos7: extra docker-engine 安装Docker: https://mirrors.aliyun.com/docker-engine/yum/repo/main/centos/7/ yum install docker-engine [root@node1 ~]# rpm -ql docker-engine |egrep -v "share" /etc/udev/rules.d/80-docker.rules /usr/bin/docker /usr/bin/docker-containerd /usr/bin/docker-containerd-ctr /usr/bin/docker-containerd-shim /usr/bin/docker-init /usr/bin/docker-proxy /usr/bin/docker-run /usr/bin/dockerd /usr/lib/systemd/system/docker.service docker子命令有很多 systemctl start docker.service docker images //查看镜像 docker search centos Name DESCRIPTION STARS STARS OFFICAL AUTOMATED 星 自动生成 darksheer/centos //用户名:镜像名 docker search busybox docker pull busybox //拉取官方镜像 base iamge tag : lastest //最新版本,默认最新版本 docker pull hub.mt.com:5000/busybox //执行私有仓库获取image,必须支持ssl。或者禁止使用tls docker help run //运行 docker run [OPTIONS] IMAGS [COMMAND] [AEG,...] //image应该有一个运行起来后,默认运行的命令。 -t --tty=false 分配一个默认的伪终端 -i --interactive=false 打开之后运行在交互式 [root@node1 ~]# docker run -it busybox:latest /bin/sh docker ps //查看正在运行的 docker 需要借助于外 volume 保存创建的数据。 docker help commit //基于当前容器的所有修改,创建一个新的images docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] 三、docker常用命令: 1.环境信息相关 info version 2.系统维护相关 images inspect :容器的详细信息 build:基于dockerfile创建image文件 commit:基于运行中的容器创建映像文件 pause:暂停 unpause rm rmi //删除映像文件 run //基于image运行一个容器 start/stop/restart top //资源占用情况 ps kill ... 3.日志相关 events; hisgory; logs; 4.Docker hub 相关 login logout pull push search 基本操作: 获取映像:pull 启动容器:run -i,-t docker run -it centos:latest /bin/bash ifconfig //docker0 一个虚拟接口 一半在虚拟机, 一半在宿主机 docker kill c98dac012556 //kill 掉容器,容器ID docker ps -a //可以查看所有的 关闭后,默认还是会占用内存,可以在启动的时候 docker run --rm //退出则,rm自动移除容器 docker rm c98dac012556 //删除该容器 docker image的创建: 1.基于dockerfile 2.基于运行中的容器修改 //仅仅是打包最上面一层,只有最上面一层是可写的。 实验:commit,保存文件 [root@node1 ~]# docker run -it centos:latest /bin/bash 在home中 useradd centos [root@node1 ~]# docker commit faecb4def9d5 centos:newuser [root@node1 ~]# docker images 有 newuser [root@node1 ~]# docker kill faecb4def9d5 [root@node1 ~]# docker rm faecb4def9d5 [root@node1 ~]# docker ps -a 没有之前的容器了 [root@node1 ~]# docker run -it --rm centos:newuser /bin/bash rm用于关闭后,就删除容器 [root@3f20a3c7f5df /]# id centos uid=1000(centos) gid=1000(centos) groups=1000(centos) [root@3f20a3c7f5df /]# exit [root@node1 ~]# docker ps -a //将没有容器运行 本文转自MT_IT51CTO博客,原文链接:http://blog.51cto.com/hmtk520/1946362,如需转载请自行联系原作者

优秀的个人博客,低调大师

Tensorflow CNN入门

一、概论 以图像识别来举例,比如我们让计算机如何识别一张猫的图片识别出猫呢? 老式的计算机视觉是如何做的呢? 比如OpenCV: 首先理解很多算法,比如如何检测线条(Edge Detection) 如何做形态学变化等 根据我们的知识, 经验, 脑洞来设计很多特征; 用这些特征去比对一张图像是不是猫。 这样做存在的问题呢? 每一种不同的物件,我们都得去设计特征。 这样的人工智能主要是人工,而不是只能。 老式的流程: 原始数据 ——> 人工特征提取 ——> 算法 ——> 结果 卷积要解决的问题就是自动的特征提取(Feature Extraction) 卷积神经网络: 原始数据 ——> 卷积网络 ——> 算法 ——> 结果 #其中 卷积网络 + 算法 称为 深度学习

优秀的个人博客,低调大师

lvs简单入门

只解决c10k问题是不够的,单台主机的处理能力是有限的,一台主机同时处理500个动态网页请求已经是极限了。这里有两种方法提升处理性能,一,定制高性能的计算机,众所周知计算机硬件设计成本极其高,性能每提高10%成本就要增加一倍,这也是intel被称为挤牙膏公司的原因,不是其研发能力不行而是计算机硬件性能提升的难度太大,这个方法貌似不可行。二,使用两台主机处理业务,这就会引来一个问题怎么把请求分发到两个主机,这里我们引入了负载均衡器。 # 目录 负载均衡 lvs工作方式和调度方法 ipvsadm的使用 lvs-nat lvs-dr 多端口绑定和持久连接 # 负载均衡 使用负载均衡有两个方法,一是采用商用负载均衡硬件的,这个方法是最好的方法,能上硬件一定不要使用软件,又是硬件同样的问题也是价格,只要是涉及到基础设施的服务一定要使用。一方面是硬件的稳定性,比软件好很多,虽然软件可维护性和拓展性比较好,但是对于一些金融公司,他们玩的就是公信力和大众信心,每个故障都是竞争对手拆台的理由,一旦故障硬件背锅,理赔。常用的硬件F5的Big-IP,Citrix的Netscaler,A10的A10 另一种是采用软件负载均衡,只要考虑成本使用负载均衡软件就对了,它的性能比硬件也不会差别太大,并且灵活。常用的有lvs,nginx,haproxy,ats。。。 在做负载均衡的时候,我们在7层模型的哪一层做负载均衡,ip层基于主机做负载均衡粒度太大可用性太差基本不使用,更低的层基本上没有价值了,tcp层的话我们就可以把不同服务的请求采取不同的方式负载均衡,应用层的话我们可以根据具体协议拆包分析后负载均衡,既然涉及到拆开数据包,那处理的数据量就会大大增加,那么对计算机性能要求也越高,性能就越差,并且负载均衡器的通用性也越差。 传输层:lvs,nginx:(stream),haproxy:(mode tcp) 应用层: http:nginx, httpd, haproxy(mode http) fastcgi:nginx, httpd mysql:mysql-proxy # lvs工作方式和调度方法 ### lvs的工作方式 有四种lvs-nat,lvs-dr,lvs-tun,lvs-fullnat lvs集群类型中的术语: vs:Virtual Server, Director, Dispatcher, Balancer rs:Real Server, upstream server, backend server CIP:Client IP, VIP: Virtual serve IP, RIP: Real server IP, DIP: Director IP * lvs-nat 它的工作机制类似iptables的dnat功能,但是它工作于input链上。一次请求过程如下图 当客户端向director发送数据,数据在input链上目的地址vip换为rip后,被转发到postrouting链上过滤后发送到real server,real server处理完后把数据发送到director,director把这个数据的源地址rip更改为vip,当然lvs-nat不仅仅是更改ip也可以更改端口,所以支持端口映射,由以上可以总结nat的特点,rip和dip必须在同一网络中,rs的网关需要指向dip,因为所以的数据必须经过director更改ip。 这种工作方式director很容成为网络瓶颈,因为所以的数据都要经过director,director网卡的吞吐量就代表整个网站的流量吞吐量,当今世界的慢慢走向5G,director是完全不能满足需求的,需要借助其它网络设备帮助director分担流量,这就引入了lvs-dr模型。 * lvs-dr 如图,lvs-dr也是在input链上更改数据,但是它更改的不是ip地址而是mac地址,它把目的mac地址vmac更改为rmac,这里就要求vip,rip,dip必须在广播域内,但是地址不一定要在一个网段,因为他们间的通信需要使用mac直接通信。realserver处理请求后直接把数据返回给客户端。 等等,不对啊!realserver是怎么给客户端发送数据包的,realserver服务器上只有rip怎么用vip给客户端通信,这里需要我们给realserver配置vip。但是有一个问题,在网络中多个主机拥有同一个ip会产生冲突的,我们的解决方案是只让一个主机发送arp广播并且响应arp请求,选谁毋庸置疑只能选择director。 控制arp广播arp-ignore,0广播,1不广播;控制响应arp-announce,0响应所有接口信息,1尽量只响应当前网卡的信息,2只响应当前网卡的信息 lvs-dr的使用方法有两种,一种是每个realserver都有与公网交互的公网ip,另一种是只有内网ip,之后演示。 * lvs-tun 它是在原本的报文外部继续封装一个ip头,有可能造成超级帧 * lvs-fullnat 它是把源ip和目的ip都更改,相当于director请求realserver,realserver响应回来数据再把两个ip地址更改,这样这个数据包就可以跨越路由通信了,nat本来就会造成director网络瓶颈,它的使用场景主要应用于请求数据量不大但后服务器数量很多的场景。 ### 调度方法 调用方法可以分为两类,一类是静态调度算法,一类是动态调用算法 * 静态算法 rr #以轮询的方法,把请求转发到后端的主机 wrr #加权轮询,把请求按照一定的比例转发后端主机 sh #源地址哈希,把源地址做hash运算后,把realserver也hash,每个realserver只处理自己hash和上一realserver的hash之间的源地址的请求如图 dh #目标地址哈希,这样realserver可以开启缓存了 * 动态算法 lc #最少连接,根据realserver的正在处理请求的数量进行调度,Overhead=activeconns*256+inactiveconns wlc #加权最少连接,Overhead=(activeconns*256+inactiveconns)/weight nq #在lc的基础上改进的,意思是不许有realserver主机空闲 sed #最短等等时间,Overhead=(activeconns+1)*256/weight lblc #动态的DH算法;基于地址的最小连接数调度(locality-based least-connection):将来自同一个目的地址的请求分配给同一台RS,此时这台服务器是尚未满负荷的。否则就将这个请求分配给连接数最小的RS,并以它作为下一次分配的首先考虑 lblcr #带复制功能的lblc # ipvsadm的使用 管理集群服务:增、改、删; 增、改: ipvsadm -A|E -t|u|f service-address [-s scheduler] [-p [timeout]] 删: ipvsadm -D -t|u|f service-address [-s scheduler]:指定集群的调度算法,默认为wlc service-address: -t|u|f: -t: TCP协议的端口,VIP:TCP_PORT -u: TCP协议的端口,VIP:UDP_PORT -f:firewall MARK,是一个数字; 管理集群上的RS:增、改、删; 增、改: ipvsadm -a|e -t|u|f service-address -r server-address [-g|i|m] [-w weight] 删: ipvsadm -d -t|u|f service-address -r server-address server-address: rip[:port] # lvs-nat nat实验拓扑图 这个使用我采用的是虚拟机,主机ip做cip,director的vip采用的桥接网络,dip和rip采用的是仅主机模式 realserver1执行的命令 yuminstallhttpd-y#安装httpd echors1>/var/www/html/index.html#提供网页文件 realserver2执行的命令 yuminstallhttpd-y echors2>/var/www/html/index.html director执行的命令 yuminstallipvsadm-y ipvsadm-A-t172.16.29.4:80-swrr ipvsadm-a-t172.16.29.4:80-r192.168.95.2-m-w1 ipvsadm-a-t172.16.29.4:80-r192.168.95.3-m-w2 # lvs-dr ### 都采用公网ip的方案 所有网卡都采用桥接 director执行的命令 ifconfigeno16777736:0172.16.29.4netmask255.255.255.255broadcast172.16.29.4up#若在directer和realserver在同一个网段里一定要使用这一行 ipvsadm-A-t172.16.29.4:80-swrr ipvsadm-a-t172.16.29.4:80-r172.16.29.10-g-w1 ipvsadm-a-t172.16.29.4:80-r172.16.29.20-g-w2 realserver执行的命令 echo1>/proc/sys/net/ipv4/conf/all/arp_ignore echo1>/proc/sys/net/ipv4/conf/lo/arp_ignore echo2>/proc/sys/net/ipv4/conf/lo/arp_announce echo2>/proc/sys/net/ipv4/conf/all/arp_announce ifconfiglo:0172.16.29.4netmask255.255.255.255broadcast172.16.29.4up routeadd-host172.16.29.4devlo:0 ### 只要一个公网ip的解决方案 全部接口采用的仅主机模式,并且每个主机只有一个网卡,每个网卡都先配置一个ip,后期再添加需要的ip director要执行的命令 ifconfigeno16777736:0192.168.95.20netmask255.255.255.0broadcast192.168.95.20 ipvsadm-A-t192.168.95.20:80-swrr ipvsadm-a-t192.168.95.20:80-r10.0.0.10-g-w2 ipvsadm-a-t192.168.95.20:80-r10.0.0.20-g-w2 realserver需要执行的命令 echo1>/proc/sys/net/ipv4/conf/all/arp_ignore echo1>/proc/sys/net/ipv4/conf/lo/arp_ignore echo2>/proc/sys/net/ipv4/conf/lo/arp_announce echo2>/proc/sys/net/ipv4/conf/all/arp_announce ifconfiglo:0192.168.95.20netmask255.255.255.255broadcast192.168.95.20up routeadd-host192.168.95.20devlo:0 routeadddefaultgw10.0.0.1 路由设备需要执行的命令 echo 1 > /pro/sys/net/ipv4/ip_forward #开启转发功能 # 多端口绑定和持久连接 ### FWM:FireWall Mark 借助于防火墙标记来分类报文,而后基于标记定义集群服务;可将多个不同的应用使用同一个集群服务进行调度; 打标记方法(在Director主机): # iptables -t mangle -A PREROUTING -d $vip -p $proto --dport $port -j MARK --set-mark NUMBER 基于标记定义集群服务: # ipvsadm -A -f NUMBER [options] ### lvs persistence:持久连接 持久连接模板:实现无论使用任何算法,在一段时间内,实现将来自同一个地址的请求始终发往同一个RS; ipvsadm -A|E -t|u|f service-address [-s scheduler] [-p [timeout]] port Affinity: 每端口持久:每集群服务单独定义,并定义其持久性; 每防火墙标记持久:基于防火墙标记定义持久的集群服务;可实现将多个端口上的应用统一调度,即所谓的port Affinity; 每客户端持久:基于0端口定义集群服务,即将客户端对所有应用的请求统统调度至后端主机,而且可使用持久连接进行绑定; # 总结 lvs是负载均衡器中最基本的,理解了它的原理和使用方法,基本上掌握了大多数的负载均衡器的原理。其中dr模型是必须掌握的,真正使用的话我感觉会使用dr,net的功能很有可能被7层代理的服务器替代了。多端口绑定功能也很常用比如80和443端口绑定统一调度;持久连接虽然破坏调度效果,但是在没有session缓存服务器的话还是很高效的。

优秀的个人博客,低调大师

Flink从入门到放弃(入门篇3)-DataSetAPI

首先我们来看一下编程结构: 编程结构 public class SocketTextStreamWordCount { public static void main(String[] args) throws Exception { if (args.length != 2){ System.err.println("USAGE:\nSocketTextStreamWordCount <hostname> <port>"); return; } String hostName = args[0]; Integer port = Integer.parseInt(args[1]); final StreamExecutionEnvironment env = StreamExecutionEnvironment .getExecutionEnvironment(); DataStream<String> text = env.socketTextStream(hostName, port); DataStream<Tuple2<String, Integer>> counts text.flatMap(new LineSplitter()) .keyBy(0) .sum(1); counts.print(); env.execute("Java WordCount from SocketTextStream Example"); } 上面的SocketTextStreamWordCount是一个典型的Flink程序,他由一下及格部分构成: 获得一个execution environment, 加载/创建初始数据, 指定此数据的转换, 指定放置计算结果的位置, 触发程序执行 DataSet API 分类: Source: 数据源创建初始数据集,例如来自文件或Java集合 Transformation: 数据转换将一个或多个DataSet转换为新的DataSet Sink: 将计算结果存储或返回 DataSet Sources 基于文件的 readTextFile(path)/ TextInputFormat- 按行读取文件并将其作为字符串返回。 readTextFileWithValue(path)/ TextValueInputFormat- 按行读取文件并将它们作为StringValues返回。StringValues是可变字符串。 readCsvFile(path)/ CsvInputFormat- 解析逗号(或其他字符)分隔字段的文件。返回元组或POJO的DataSet。支持基本java类型及其Value对应作为字段类型。 readFileOfPrimitives(path, Class)/ PrimitiveInputFormat- 解析新行(或其他字符序列)分隔的原始数据类型(如String或)的文件Integer。 readFileOfPrimitives(path, delimiter, Class)/ PrimitiveInputFormat- 解析新行(或其他字符序列)分隔的原始数据类型的文件,例如String或Integer使用给定的分隔符。 readSequenceFile(Key, Value, path)/ SequenceFileInputFormat- 创建一个JobConf并从类型为SequenceFileInputFormat,Key class和Value类的指定路径中读取文件,并将它们作为Tuple2 返回。 基于集合 fromCollection(Collection) - 从Java Java.util.Collection创建数据集。集合中的所有数据元必须属于同一类型。 fromCollection(Iterator, Class) - 从迭代器创建数据集。该类指定迭代器返回的数据元的数据类型。 fromElements(T ...) - 根据给定的对象序列创建数据集。所有对象必须属于同一类型。 fromParallelCollection(SplittableIterator, Class) - 并行地从迭代器创建数据集。该类指定迭代器返回的数据元的数据类型。 generateSequence(from, to) - 并行生成给定间隔中的数字序列。 通用方法 readFile(inputFormat, path)/ FileInputFormat- 接受文件输入格式。 createInput(inputFormat)/ InputFormat- 接受通用输入格式。 代码示例 ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment(); // 从本地文件系统读 DataSet<String> localLines = env.readTextFile("file:///path/to/my/textfile"); // 读取HDFS文件 DataSet<String> hdfsLines = env.readTextFile("hdfs://nnHost:nnPort/path/to/my/textfile"); // 读取CSV文件 DataSet<Tuple3<Integer, String, Double>> csvInput = env.readCsvFile("hdfs:///the/CSV/file").types(Integer.class, String.class, Double.class); // 读取CSV文件中的部分 DataSet<Tuple2<String, Double>> csvInput = env.readCsvFile("hdfs:///the/CSV/file").includeFields("10010").types(String.class, Double.class); // 读取CSV映射为一个java类 DataSet<Person>> csvInput = env.readCsvFile("hdfs:///the/CSV/file").pojoType(Person.class, "name", "age", "zipcode"); // 读取一个指定位置序列化好的文件 DataSet<Tuple2<IntWritable, Text>> tuples = env.readSequenceFile(IntWritable.class, Text.class, "hdfs://nnHost:nnPort/path/to/file"); // 从输入字符创建 DataSet<String> value = env.fromElements("Foo", "bar", "foobar", "fubar"); // 创建一个数字序列 DataSet<Long> numbers = env.generateSequence(1, 10000000); // 从关系型数据库读取 DataSet<Tuple2<String, Integer> dbData = env.createInput(JDBCInputFormat.buildJDBCInputFormat() .setDrivername("org.apache.derby.jdbc.EmbeddedDriver") .setDBUrl("jdbc:derby:memory:persons") .setQuery("select name, age from persons") .setRowTypeInfo(new RowTypeInfo(BasicTypeInfo.STRING_TYPE_INFO, BasicTypeInfo.INT_TYPE_INFO)) .finish()); DataSet Transformation 详细可以参考官网:https://flink.sojb.cn/dev/batch/dataset_transformations.html#filter Map 采用一个数据元并生成一个数据元。 data.map(new MapFunction<String, Integer>() { public Integer map(String value) { return Integer.parseInt(value); } }); FlatMap 采用一个数据元并生成零个,一个或多个数据元。 data.flatMap(new FlatMapFunction<String, String>() { public void flatMap(String value, Collector<String> out) { for (String s : value.split(" ")) { out.collect(s); } } }); MapPartition 在单个函数调用中转换并行分区。该函数将分区作为Iterable流来获取,并且可以生成任意数量的结果值。每个分区中的数据元数量取决于并行度和先前的 算子操作。 data.mapPartition(new MapPartitionFunction<String, Long>() { public void mapPartition(Iterable<String> values, Collector<Long> out) { long c = 0; for (String s : values) { c++; } out.collect(c); } }); Filter 计算每个数据元的布尔函数,并保存函数返回true的数据元。重要信息:系统假定该函数不会修改应用谓词的数据元。违反此假设可能会导致错误的结果。 data.filter(new FilterFunction<Integer>() { public boolean filter(Integer value) { return value > 1000; } }); Reduce 通过将两个数据元重复组合成一个数据元,将一组数据元组合成一个数据元。Reduce可以应用于完整数据集或分组数据集。 data.reduce(new ReduceFunction<Integer> { public Integer reduce(Integer a, Integer b) { return a + b; } }); 如果将reduce应用于分组数据集,则可以通过提供CombineHintto 来指定运行时执行reduce的组合阶段的方式 setCombineHint。在大多数情况下,基于散列的策略应该更快,特别是如果不同键的数量与输入数据元的数量相比较小(例如1/10)。 ReduceGroup 将一组数据元组合成一个或多个数据元。ReduceGroup可以应用于完整数据集或分组数据集。 data.reduceGroup(new GroupReduceFunction<Integer, Integer> { public void reduce(Iterable<Integer> values, Collector<Integer> out) { int prefixSum = 0; for (Integer i : values) { prefixSum += i; out.collect(prefixSum); } } }); Aggregate 将一组值聚合为单个值。聚合函数可以被认为是内置的reduce函数。聚合可以应用于完整数据集或分组数据集。 Dataset<Tuple3<Integer, String, Double>> input = // [...] DataSet<Tuple3<Integer, String, Double>> output = input.aggregate(SUM, 0).and(MIN, 2); 您还可以使用简写语法进行最小,最大和总和聚合。 Dataset<Tuple3<Integer, String, Double>> input = // [...] DataSet<Tuple3<Integer, String, Double>> output = input.sum(0).andMin(2); Distinct 返回数据集的不同数据元。它相对于数据元的所有字段或字段子集从输入DataSet中删除重复条目。 data.distinct(); 使用reduce函数实现Distinct。您可以通过提供CombineHintto 来指定运行时执行reduce的组合阶段的方式 setCombineHint。在大多数情况下,基于散列的策略应该更快,特别是如果不同键的数量与输入数据元的数量相比较小(例如1/10)。 Join 通过创建在其键上相等的所有数据元对来连接两个数据集。可选地使用JoinFunction将数据元对转换为单个数据元,或使用FlatJoinFunction将数据元对转换为任意多个(包括无)数据元。请参阅键部分以了解如何定义连接键。 result = input1.join(input2) .where(0) // key of the first input (tuple field 0) .equalTo(1); // key of the second input (tuple field 1) 您可以通过Join Hints指定运行时执行连接的方式。提示描述了通过分区或广播进行连接,以及它是使用基于排序还是基于散列的算法。如果未指定提示,系统将尝试估算输入大小,并根据这些估计选择最佳策略。 // This executes a join by broadcasting the first data set // using a hash table for the broadcast data result = input1.join(input2, JoinHint.BROADCAST_HASH_FIRST) .where(0).equalTo(1); 请注意,连接转换仅适用于等连接。其他连接类型需要使用OuterJoin或CoGroup表示。 OuterJoin 在两个数据集上执行左,右或全外连接。外连接类似于常规(内部)连接,并创建在其键上相等的所有数据元对。此外,如果在另一侧没有找到匹配的Keys,则保存“外部”侧(左侧,右侧或两者都满)的记录。匹配数据元对(或一个数据元和null另一个输入的值)被赋予JoinFunction以将数据元对转换为单个数据元,或者转换为FlatJoinFunction以将数据元对转换为任意多个(包括无)数据元。请参阅键部分以了解如何定义连接键。 input1.leftOuterJoin(input2) // rightOuterJoin or fullOuterJoin for right or full outer joins .where(0) // key of the first input (tuple field 0) .equalTo(1) // key of the second input (tuple field 1) .with(new JoinFunction<String, String, String>() { public String join(String v1, String v2) { // NOTE: // - v2 might be null for leftOuterJoin // - v1 might be null for rightOuterJoin // - v1 OR v2 might be null for fullOuterJoin } }); CoGroup reduce 算子操作的二维变体。将一个或多个字段上的每个输入分组,然后关联组。每对组调用转换函数。 data1.coGroup(data2) .where(0) .equalTo(1) .with(new CoGroupFunction<String, String, String>() { public void coGroup(Iterable<String> in1, Iterable<String> in2, Collector<String> out) { out.collect(...); } }); Cross 构建两个输入的笛卡尔积(交叉乘积),创建所有数据元对。可选择使用CrossFunction将数据元对转换为单个数据元 DataSet<Integer> data1 = // [...] DataSet<String> data2 = // [...] DataSet<Tuple2<Integer, String>> result = data1.cross(data2); 注:交叉是一个潜在的非常计算密集型 算子操作它甚至可以挑战大的计算集群!建议使用crossWithTiny()和crossWithHuge()来提示系统的DataSet大小。 Union 生成两个数据集的并集。 DataSet<String> data1 = // [...] DataSet<String> data2 = // [...] DataSet<String> result = data1.union(data2); Rebalance 均匀地Rebalance 数据集的并行分区以消除数据偏差。只有类似Map的转换可能会遵循Rebalance 转换。 DataSet<String> in = // [...] DataSet<String> result = in.rebalance() .map(new Mapper()); Hash-Partition 散列分区给定键上的数据集。键可以指定为位置键,表达键和键选择器函数。 DataSet<Tuple2<String,Integer>> in = // [...] DataSet<Integer> result = in.partitionByHash(0) .mapPartition(new PartitionMapper()); Range-Partition Range-Partition给定键上的数据集。键可以指定为位置键,表达键和键选择器函数。 DataSet<Tuple2<String,Integer>> in = // [...] DataSet<Integer> result = in.partitionByRange(0) .mapPartition(new PartitionMapper()); Custom Partitioning 手动指定数据分区。 注意:此方法仅适用于单个字段键。 DataSet<Tuple2<String,Integer>> in = // [...] DataSet<Integer> result = in.partitionCustom(Partitioner<K> partitioner, key) Sort Partition 本地按指定顺序对指定字段上的数据集的所有分区进行排序。可以将字段指定为元组位置或字段表达式。通过链接sortPartition()调用来完成对多个字段的排序。 DataSet<Tuple2<String,Integer>> in = // [...] DataSet<Integer> result = in.sortPartition(1, Order.ASCENDING) .mapPartition(new PartitionMapper()); First-n 返回数据集的前n个(任意)数据元。First-n可以应用于常规数据集,分组数据集或分组排序数据集。分组键可以指定为键选择器函数或字段位置键。 DataSet<Tuple2<String,Integer>> in = // [...] // regular data set DataSet<Tuple2<String,Integer>> result1 = in.first(3); // grouped data set DataSet<Tuple2<String,Integer>> result2 = in.groupBy(0) .first(3); // grouped-sorted data set DataSet<Tuple2<String,Integer>> result3 = in.groupBy(0) .sortGroup(1, Order.ASCENDING) .first(3); DataSet Sink 数据接收器使用DataSet用于存储或返回。使用OutputFormat描述数据接收器算子操作 。Flink带有各种内置输出格式,这些格式封装在DataSet上的算子操作中: writeAsText()/ TextOutputFormat- 按字符串顺序写入数据元。通过调用每个数据元的toString()方法获得字符串。 writeAsFormattedText()/ TextOutputFormat- 按字符串顺序写数据元。通过为每个数据元调用用户定义的format()方法来获取字符串。 writeAsCsv(...)/ CsvOutputFormat- 将元组写为逗号分隔值文件。行和字段分隔符是可配置的。每个字段的值来自对象的toString()方法。 print()/ printToErr()/ print(String msg)/ printToErr(String msg)- 在标准输出/标准错误流上打印每个数据元的toString()值。可选地,可以提供前缀(msg),其前缀为输出。这有助于区分不同的打印调用。如果并行度大于1,则输出也将与生成输出的任务的标识符一起添加。 write()/ FileOutputFormat- 自定义文件输出的方法和基类。支持自定义对象到字节的转换。 output()/ OutputFormat- 大多数通用输出方法,用于非基于文件的数据接收器(例如将结果存储在数据库中)。 可以将DataSet输入到多个 算子操作。程序可以编写或打印数据集,同时对它们执行其他转换。 示例: // text data DataSet<String> textData = // [...] // write DataSet to a file on the local file system textData.writeAsText("file:///my/result/on/localFS"); // write DataSet to a file on a HDFS with a namenode running at nnHost:nnPort textData.writeAsText("hdfs://nnHost:nnPort/my/result/on/localFS"); // write DataSet to a file and overwrite the file if it exists textData.writeAsText("file:///my/result/on/localFS", WriteMode.OVERWRITE); // tuples as lines with pipe as the separator "a|b|c" DataSet<Tuple3<String, Integer, Double>> values = // [...] values.writeAsCsv("file:///path/to/the/result/file", "\n", "|"); // this writes tuples in the text formatting "(a, b, c)", rather than as CSV lines values.writeAsText("file:///path/to/the/result/file"); // this writes values as strings using a user-defined TextFormatter object values.writeAsFormattedText("file:///path/to/the/result/file", new TextFormatter<Tuple2<Integer, Integer>>() { public String format (Tuple2<Integer, Integer> value) { return value.f1 + " - " + value.f0; } }); 使用自定义输出格式: DataSet<Tuple3<String, Integer, Double>> myResult = [...] // write Tuple DataSet to a relational database myResult.output( // build and configure OutputFormat JDBCOutputFormat.buildJDBCOutputFormat() .setDrivername("org.apache.derby.jdbc.EmbeddedDriver") .setDBUrl("jdbc:derby:memory:persons") .setQuery("insert into persons (name, age, height) values (?,?,?)") .finish() ); 序列化器 Flink自带了针对诸如int,long,String等标准类型的序列化器 针对Flink无法实现序列化的数据类型,我们可以交给Avro和Kryo 使用方法:ExecutionEnvironment env = ExecutionEnvironment.getExecutionEnvironment(); 使用avro序列化:env.getConfig().enableForceAvro(); 使用kryo序列化:env.getConfig().enableForceKryo(); 使用自定义序列化:env.getConfig().addDefaultKryoSerializer(Class<?> type, Class<? extends Serializer<?>> serializerClass) 数据类型 Java Tuple 和 Scala case class Java POJOs:java实体类 Primitive Types 默认支持java和scala基本数据类型 General Class Types 默认支持大多数java和scala class Hadoop Writables 支持hadoop中实现了org.apache.hadoop.Writable的数据类型 Special Types 例如scala中的Either Option 和Try

优秀的个人博客,低调大师

Flink从入门到放弃(入门篇4) DataStreamAPI

DataStream算子将一个或多个DataStream转换为新DataStream。程序可以将多个转换组合成复杂的数据流拓扑。DataStreamAPI和DataSetAPI主要的区别在于Transformation部分。 DataStream Transformation map DataStream→DataStream用一个数据元生成一个数据元。一个map函数,它将输入流的值加倍: DataStream<Integer> dataStream = //... dataStream.map(new MapFunction<Integer, Integer>() { @Override public Integer map(Integer value) throws Exception { return 2 * value; } }); FlatMap DataStream→DataStream 采用一个数据元并生成零个,一个或多个数据元。将句子分割为单词的flatmap函数: dataStream.flatMap(new FlatMapFunction<String, String>() { @Override public void flatMap(String value, Collector<String> out) throws Exception { for(String word: value.split(" ")){ out.collect(word); } } }); Filter DataStream→DataStream 计算每个数据元的布尔函数,并保存函数返回true的数据元。过滤掉零值的过滤器: dataStream.filter(new FilterFunction<Integer>() { @Override public boolean filter(Integer value) throws Exception { return value != 0; } }); KeyBy DataStream→KeyedStream 逻辑上将流分区为不相交的分区。具有相同Keys的所有记录都分配给同一分区。在内部,keyBy()是使用散列分区实现的。指定键有不同的方法。 此转换返回KeyedStream,其中包括使用被Keys化状态所需的KeyedStream。 dataStream.keyBy("someKey") // Key by field "someKey" dataStream.keyBy(0) // Key by the first element of a Tuple 注意: 如果出现以下情况,则类型不能成为key: 它是POJO类型但不覆盖hashCode()方法并依赖于Object.hashCode()实现 任何类型的数组 Reduce KeyedStream→DataStream 将当前数据元与最后一个Reduce的值组合并发出新值。 例如:reduce函数,用于创建部分和的流: keyedStream.reduce(new ReduceFunction<Integer>() { @Override public Integer reduce(Integer value1, Integer value2) throws Exception { return value1 + value2; } }); Fold KeyedStream→DataStream 具有初始值的被Keys化数据流上的“滚动”折叠。将当前数据元与最后折叠的值组合并发出新值。 折叠函数,当应用于序列(1,2,3,4,5)时,发出序列“start-1”,“start-1-2”,“start-1-2-3”,. .. DataStream<String> result = keyedStream.fold("start", new FoldFunction<Integer, String>() { @Override public String fold(String current, Integer value) { return current + "-" + value; } }); 聚合 KeyedStream→DataStream 在被Keys化数据流上滚动聚合。min和minBy之间的差异是min返回最小值,而minBy返回该字段中具有最小值的数据元(max和maxBy相同)。 keyedStream.sum(0); keyedStream.sum("key"); keyedStream.min(0); keyedStream.min("key"); keyedStream.max(0); keyedStream.max("key"); keyedStream.minBy(0); keyedStream.minBy("key"); keyedStream.maxBy(0); keyedStream.maxBy("key"); Window函数 关于Flink的窗口概念,我们会在后面有详细介绍。 WindowKeyedStream→WindowedStream 可以在已经分区的KeyedStream上定义Windows。Windows根据某些特征(例如,在最后5秒内到达的数据)对每个Keys中的数据进行分组。 dataStream.keyBy(0) .window(TumblingEventTimeWindows .of(Time.seconds(5))); // Last 5 seconds of data Window ApplyWindowedStream→DataStream AllWindowedStream→DataStream 将一般函数应用于整个窗口。下面是一个手动求和窗口数据元的函数。 注意:如果您正在使用windowAll转换,则需要使用AllWindowFunction。 windowedStream.apply (new WindowFunction<Tuple2<String,Integer>, Integer, Tuple, Window>() { public void apply (Tuple tuple, Window window, Iterable<Tuple2<String, Integer>> values, Collector<Integer> out) throws Exception { int sum = 0; for (value t: values) { sum += t.f1; } out.collect (new Integer(sum)); } }); // applying an AllWindowFunction on non-keyed window stream allWindowedStream.apply (new AllWindowFunction<Tuple2<String,Integer>, Integer, Window>() { public void apply (Window window, Iterable<Tuple2<String, Integer>> values, Collector<Integer> out) throws Exception { int sum = 0; for (value t: values) { sum += t.f1; } out.collect (new Integer(sum)); } }); Window ReduceWindowedStream→DataStream 将reduce函数应用于窗口并返回reduce后的值。 windowedStream.reduce (new ReduceFunction<Tuple2<String,Integer>>() { public Tuple2<String, Integer> reduce(Tuple2<String, Integer> value1, Tuple2<String, Integer> value2) throws Exception { return new Tuple2<String,Integer>(value1.f0, value1.f1 + value2.f1); } }); 提取时间戳 关于Time我们在后面有专门的章节进行介绍 DataStream→DataStream 从记录中提取时间戳,以便使用使用事件时间语义的窗口。 stream.assignTimestamps (new TimeStampExtractor() {...}); Partition 分区 自定义分区DataStream→DataStream 使用用户定义的分区程序为每个数据元选择目标任务。 dataStream.partitionCustom(partitioner, "someKey"); dataStream.partitionCustom(partitioner, 0); 随机分区DataStream→DataStream 根据均匀分布随机分配数据元。 dataStream.shuffle(); Rebalance (循环分区)DataStream→DataStream 分区数据元循环,每个分区创建相等的负载。在存在数据倾斜时用于性能优化。 dataStream.rebalance(); rescaleDataStream→DataStream 如果上游 算子操作具有并行性2并且下游算子操作具有并行性6,则一个上游 算子操作将分配元件到三个下游算子操作,而另一个上游算子操作将分配到其他三个下游 算子操作。另一方面,如果下游算子操作具有并行性2而上游 算子操作具有并行性6,则三个上游 算子操作将分配到一个下游算子操作,而其他三个上游算子操作将分配到另一个下游算子操作。 在不同并行度不是彼此的倍数的情况下,一个或多个下游 算子操作将具有来自上游 算子操作的不同数量的输入。 请参阅此图以获取上例中连接模式的可视化: dataStream.rescale(); 广播DataStream→DataStream 向每个分区广播数据元。 dataStream.broadcast();

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册