首页 文章 精选 留言 我的

精选列表

搜索[多Agent协同],共10000篇文章
优秀的个人博客,低调大师

APIJSON 4.7.0 发布,荣获大奖【腾讯IEG开源协同项目奖】

感谢腾讯同事 fineday009,jun0315,Wscats,caohao-php为 APIJSON贡献代码。 感谢Rkyzzy, kxlv2000, gdjs2,403f,gujiachun 为 APIJSON 共 6次 贡献代码。 APIJSON 4.7.0更新内容 新增数据源关键词 @datasource,可由业务完全自定义; 解决 Oracle 低版本分页语法兼容问题,OFFSET LIMIT 改为 ROWNUM+子查询; 优化分页查询、各种 JOIN、查询计划等并修复相关bug。 具体见Release 发布版本。 APIJSON-Demo 新增 连接池及多数据源 Demo(Druid + HikariCP),可自由切换。 APIJSON 简介 APIJSON 是一种专为 API 而生的 JSON 网络传输协议 以及 基于这套协议实现的 ORM 库。 为简单的增删改查、复杂的查询、简单的事务操作提供了完全自动化的万能 API。 能大幅降低开发和沟通成本,简化开发流程,缩短开发周期。 适合中小型前后端分离的项目,尤其是 BaaS、Serverless、互联网创业项目和企业自用项目。 为什么选择 APIJSON? 解决十大痛点(APIJSON 大幅提振开发效率、强力杜绝联调扯皮、巧妙规避文档缺陷、非常节省流量带宽 等) 开发提速巨大(CRUD 零代码热更新自动化,APIJSONBoot 对比 SSM、SSH 等保守估计可提速 20 倍以上) 腾讯官方开源(使用 GitHub、Gitee、工蜂 等平台的官方账号开源,微信公众号、腾讯云+社区 等官方公告) 社区影响力大(GitHub 11.1K Star 在 423WJava 项目中排名前 130,远超 FLAG, BAT 等国内外绝大部分开源项目) 各项荣誉成就(腾讯内部3个奖项、腾讯首个 GVP 获奖项目、腾讯后端项目 Star 第一、GitHub Java 周榜第一 等) 多样用户案例(腾讯内部用户包含 互娱、音乐、云与智慧,外部用户包含 500 强上市公司、数千亿资本国企 等) 适用场景广泛(社交聊天、阅读资讯、影音视频、办公学习 等各种 App、网站、公众号、小程序 等非金融类项目) 周边生态丰富(Android, iOS, Web 等各种 Demo、继承 JSON 的海量生态、零代码 接口测试 和 单元测试 工具等) 文档视频齐全(项目介绍、快速上手、安装部署 等后端、前端、客户端的 图文解说、视频教程、代码注释 等) 功能丰富强大(增删改查、分页排序、分组聚合、各种 JOIN、各种子查询、跨库跨表、性能分析等零代码实现) 使用安全简单(自动增删改查、自动生成文档、自动管理版本、自动控制权限、自动校验参数、自动防SQL注入等) 灵活定制业务(在后端编写 远程函数,可以拿到 session、version、当前 JSON 对象 等,然后自定义处理) 高质可靠代码(代码严谨规范,商业分析软件源伞 Pinpoint 代码扫描报告平均每行代码 Bug 率低至 0.15%) 兼容各种项目(对各类 Web 框架集成友好且提供 SpringBoot, JFinal 的 Demo,协议不限 HTTP,与其它库无冲突) 工程轻量小巧(仅依赖 fastjson,Jar 仅 280KB,Java 文件仅 59 个共 13719 行代码,例如 APIJSONORM 4.3.1) 多年持续迭代(自 2016 年开源至今已连续维护 4 年,累计 2426Commits、85Releases,不断更新迭代中...) APIJSON 生态项目 APIJSON.NETC# 版 APIJSON ,支持 MySQL, PostgreSQL, SQL Server, Oracle, SQLite apijson-go【新】Go 版 APIJSON,目前支持单表查询、列表筛选、关联查询等 APIJSON-phpPHP 版 APIJSON,基于 ThinkPHP,支持 MySQL, PostgreSQL, SQL Server, Oracle 等 apijson-phpPHP 版 APIJSON,基于 ThinkPHP,支持 MySQL, PostgreSQL, SQL Server, Oracle 等 apijson-node字节跳动工程师开发的 Node.ts 版 APIJSON,提供 nestjs 和 typeorm 的 Demo uliweb-apijsonPython 版 APIJSON,支持 MySQL, PostgreSQL, SQL Server, Oracle, SQLite 等 APIJSONParser第三方 APIJSON 解析器,将 JSON 动态解析成 SQL FfApiJson用JSON格式直接生成sql 借鉴APIJSON 支持多数据源 APIJSONDemo_ClickHouse【新】APIJSON + SpringBoot 连接 ClickHouse 使用的 Demo apijson-learn【新】APIJSON 学习笔记和源码解析 ApiJsonBoot基于 APIJSON 的零代码 API 生成框架 light4j整合 APIJSON 和微服务框架 light-4j 的 Demo,同时接入了 Redis apijson-examples关于 APIJSON 包含 admin, upms, web 的多端 Demo ApiJsonByJFinal整合 APIJSON 和 JFinal 的 Demo SpringServer1.2-APIJSON智慧党建服务器端,提供 上传 和 下载 文件的接口 apijson-builder一个方便为 APIJSON 构建 RESTful 请求的 JavaScript 库 感谢热心的作者们的贡献,点 ⭐Star 鼓励他们继续完善吧^_^ ​APIJSON - 零代码接口与文档 ORM 库(腾讯内外五个奖项、腾讯开源五个第一) 后端接口和文档零代码,前端(客户端) 定制返回 JSON 的数据和结构! https://gitee.com/Tencent/APIJSON

优秀的个人博客,低调大师

不止网络,5G体验提升需加强端网协同

被寄予厚望的5G“起步即高潮”,发展之快前所未有;而从1G空白到5G全面领先,我国移动通信事业经过多年努力也终于跑在了世界最前端。但是随着商用规模的不断扩大,过去一段时间围绕5G也存在一定争议,包括对用户体验的诟病。C114就此请教了一些业界专家,在这里掰扯掰扯。 首先,5G如今尚在发展初期,任何一项新技术、新产业的发展都非一蹴而就。以十年一代的移动通信而论,每一代开始的前几年都是一个不断迈向成熟的过程。无论体验上的不足,抑或技术、成本上的挑战,都只是暂时的、局部的,相比已经取得的成果瑕不掩瑜。更重要的是,作为一项使能全社会、全行业数字化的关键使能技术,5G正成为各国争夺的前沿高地,我们对于5G的表现应该给予更多的战略耐性和信心。 单就5G体验而言,没能达到一些用户的预期这口“锅”也不应仅仅由网络来背,5G性能优势的充分发挥,有赖于全产业链的努力。 其中,作为最贴近消费者的环节,手机等终端直接关系到用户最终获得的体验。像是掉线、速率低、业务时延大等影响5G体验的典型问题,很大程度上就与终端的兼容性和射频性能有关。 众所周知,独立组网(SA)网络性能显著优于非独立组网(NSA)网络。但中国信通院5G云侧平台最新发布的今年1-2月实测数据显示,当前5G终端SA连接占比较低,这一是由于手机兼容性,一种情况是NSA单模手机不支持SA网络,另一种情况是手机硬件上支持SA但系统版本未更新;二是不同终端品牌在手机设置上也有所差异,比如优先选择NSA网络的默认设置。 据专家介绍,5G带宽较4G的数倍增加,以及对基带芯片和天线等部件要求的极大提高,都给终端带来了更大的挑战,5G又是首个终端与网络同时走向商用的移动通信代际,从而致使终端在5G支持上可能略差于已经发展了十几年的4G,影响了用户5G体验。比如部分终端连接Wi-Fi后5G掉线、部分终端过热情况下会5G掉线、部分终端无业务情况下会5G掉线、部分终端语音结束后无法返回5G、部分终端开启SA后无法接入5G、部分终端收发性能差信号弱等。 来自地方运营商的实测数据显示,市场主流5G终端性能差异明显,部分型号的SA寻呼成功率低于90%;部分型号的SA无线掉线率大于5%;部分型号的SA上行丢包率高于0.5%。 终端续航方面也是如此,以基带芯片DSP数量为例,4G时代是3个,5G SA需要8个,而NSA是3+8个。目前在5G基站节电特性开启后,实测文字业务时节电改善50%、视频业务改善18%,但终究需要终端本身在功耗上作出提升。而某著名海外终端品牌最新旗舰机的射频性能(信号强度)、数据业务关键指标均低于其他终端,导致5G体验更为堪忧。 除此之外,要充分让用户体验到5G与4G的差异,优秀的应用和内容必不可少。但5G应用产业链较为复杂,生态尚未完全形成,在与网络和终端的匹配上有着一定断点。韩国运营商在这方面提供了较好的范本,得益于在应用方面的巨大投入与创新,截至今年1月底韩国5G用户数达到1287万,并且1月份首次月增量超过百万,考虑到该国5200万的人口,5G受欢迎程度可见一斑。 基于世界上最大规模的用户群体、顶尖的运营商和通信厂商、领先的移动互联与行业信息化应用基础,以及来自国家强有力的支持,我国有着最优质的5G发展土壤。“孤举者难起,众行者易趋”,相信在全产业链的共同努力下,未来我国5G发展将会越来越好、越来越快。 【责任编辑:未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

Docker 中如何连接多个 Container 协同工作 【已翻译100%】

在Docker使用部分我们接触到了通过网络端口来连接运行在Docker容器内的服务。这是同Docker容器内服务和应用互动的方法之一。在这一节中,我们将带你复习一下通过网络端口连接到Docker容器并给你介绍容器连接的概念。 网络端口映射刷新 在Docker的使用部分中,我们创建了一个运行Python Flask应用的容器。 $ sudo docker run -d -P training/webapp python app.py 注意:容器有一个内部网络和IP地址(还记得在使用Docker部分中我们曾使用docker的监控命令查看容器的IP地址)。Docker可以有各种不同的网络配置。你可以在这里看到Docker网络的更多相关信息。 当我们创建容器时,我们使用-P标志来自动映射任意网络端口到我们Docker主机上介于49000到49900之间的随机高位端口。随后,当我们运行docker ps时,我们会看到5000端口绑定到了49155端口上了。 $ sudo docker ps nostalgic_morse CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES bc533791f3f5 training/webapp:latest python app.py 5 seconds ago Up 2 seconds 0.0.0.0:49155->5000/tcp nostalgic_morse 我们同样看到了怎样使用-P标志将一个容器端口绑定到一个指定端口。 $ sudo docker run -d -p 5000:5000 training/webapp python app.py 另外,我们发现这并不是一个好办法,因为它约束我们一个特定端口只能有一个容器. 还有一些其他的使用 -p 的方法。 默认的情况下 -p 会把container的Port绑到宿主机上的所有ip的该端口号上。 (译者:如果你的宿主机有多个IP, 每个IP的那个端口都会被绑到container的那个port上) 我们可以通过指定接口, 例如下面的例子, 端口就只绑定到了 localhost 上。 $ sudo docker run -d -p 127.0.0.1:5000:5000 training/webapp python app.py 这会吧container内部的5000端口绑定到宿主机的 127.0.0.1 的5000端口上去. 如果只指定了网络接口而没有指定端口号, 则container的端口会绑到这个网络接口上的一个随机端口上. $ sudo docker run -d -p 127.0.0.1::5000 training/webapp python app.py 我们还可以使用UDP $ sudo docker run -d -p 127.0.0.1:5000:5000/udp training/webapp python app.py 使用 docker port 可以查看当前的container的端口的绑定情况, 和特殊的端口的配置。 例如, 如果我们吧container的端口绑到了宿主机的 localhost, 我们输入 docker port 的时候输出会是: $ docker port nostalgic_morse 127.0.0.1:49155 注 -p 可以被多次使用用来吧多个container里的port绑定到宿主机上 Docker 容器链接 映射网络端口不是吧container彼此连接起来的唯一方法。Docker的linking系统允许你吧多个 container连接起来, 让他们彼此交互信息。Docker的linking会创建一种父子级别的关系。 父container可以看到他的子container提供的信息。 容器命名 Docker的linking系统依赖于container的名字。我们已经注意到了每个container都会被自动的 分配一个名字, 在本教程里大家可能已经熟悉了 nostalgic_morse 这个名字(译者:docker 自动分配的名字都是确实存在的词, 有些名字比较有意思 例如我的一个container就叫做tender einstein 温柔的爱因斯坦, 对于大多数情况, 这些名字绝对是考验你英语单词量的机会, 比如 backstabbing nobel, stoic carson). 我们可以自己对container命名. 命名有两个用处: 1.好记 比如命名一个承载web服务的container为web 2.container 之间可以互相引用, 例如一个 web container 使用一个 db container 通过 --name 可以给container命名, 例如: $ sudo docker run -d -P --name web training/webapp python app.py你可以看到我们启动了一个新的container, 启动的时候使用了 --name 命名这个container为 web。 我们可以通过命令 docker ps查看container的名字 $ sudo docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES aed84ee21bde training/webapp:latest python app.py 12 hours ago Up 2 seconds 0.0.0.0:49154->5000/tcp web 我们也可以用 docker inspect 查看container的名字. $ sudo docker inspect -f "{{ .Name }}" aed84ee21bde /web (译者: 上面那个乖乖的语法源于golang自带的模板语言) 注 Container的名字必须是唯一的。也就是说你只能命名一个container为 web。 要重新使用一个container的名字的时候必须把之前叫这个名字的container删除, 才能 再使用。删除container可以使用 docker rm. 还有个便利的方法就是在启动container的时候 使用 --rm 标记. 这样container停止的时候就会自动被删除。 (译者: 如果你使用过一段时间docker, 用docker ps -a 你可能会发现一大堆的已经停止了的container, 在很多的docker教程里, 在启动container的时候都会带上 --rm.) 容器链接 Links运行container之间发现彼此并且彼此间安全的通讯。使用 --link可以创建一个link. 让我们创建一个运行数据库的container。 $ sudo docker run -d --name db training/postgres 这里我们基于 training/postgres image创建了一个叫做 db 的container, 上面提供PostgreSQL 数据库服务. 现在让我们创建一个叫做 web的container, 并且把他和 db container连接到一起。 $ sudo docker run -d -P --name web --link db:db training/webapp python app.py 这个命令会吧 db 和 web 连接到一起 --link 的用法: --link name:alias 这里 name 是我们要连接的container的名字, alias 是一link的别名. 下面我们会看到如何使用这个 别名. 下面让我们用 docker ps 看看被连接到一起的container们。 $ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 349169744e49 training/postgres:latest su postgres -c '/usr About a minute ago Up About a minute 5432/tcp db aed84ee21bde training/webapp:latest python app.py 16 hours ago Up 2 minutes 0.0.0.0:49154->5000/tcp db/web,web 这里我们可以看到我们创建的两个分别叫 db 和 web 的container, 注意 web container 在name列里还显示了另外一个名字db/web。 这个名字告诉我们 web container 被连接到了 db container, 并且建立了一种父子关系。 linking到底有什么用呢?我们已经看到了link在两个container间创建了一个 父子 关系. 父container 这个例子里的 db 可以得到他的子container web上的信息. Docker是通过在 两个container建立了一个安全通道来实现的, 这样container就不用对外暴露端口了. 你可能已经注意到了 我们在启动 db container的时候没有使用 -p 或者 -P。 因为我们已经吧两个container通过 link连接起来了, 所以没必要通过端口暴露数据库的服务了. Docker通过下述两种方法吧子container里的信息暴露给父container: 环境变量 更新 /etc/host 文件 我们先看下docker设定的环境变量。 在 web containre里, 让我们运行 env 命令 列出所有的环境变量。 root@aed84ee21bde:/opt/webapp# env HOSTNAME=aed84ee21bde . . . DB_NAME=/web/db DB_PORT=tcp://172.17.0.5:5432 DB_PORT_5000_TCP=tcp://172.17.0.5:5432 DB_PORT_5000_TCP_PROTO=tcp DB_PORT_5000_TCP_PORT=5432 DB_PORT_5000_TCP_ADDR=172.17.0.5 . . . 注: 这些环境变量只是为第一个在container里的进程设置的。 类似的守护进程(例如 sshd) 会在新建子shell的时候抹除这些变量。 我们可以看到Docker创建了一些列的对于我们使用db很有用的环境变量。 每一个变量都以 DB 开头, 这个 DB 就是上面的那个别名。(译者: 为啥用别名这里就清楚了, image 不用知道其他container的名字, 只用在run的时候把名字映射为自己了解的就可以了) 如果我们起的别名是 db1 那么环境变量的名字的前缀就是 DB1_. 你可以使用这些环境 变量来配置你的应用程序来连接 dbcontainer 里的数据库。 连接是安全的、私有的 仅限于 web 和 db 之间。 除了环境变量之外Docker会把父container的IP添加到子container的/etc/hosts里。我们 看下一下 web container里的hosts文件: root@aed84ee21bde:/opt/webapp# cat /etc/hosts 172.17.0.7 aed84ee21bde . . . 172.17.0.5 db 我们可以看到, 有两个相关的host配置项。 第一个是给 web container 的, 名字 就是container的ID。 第二条吧父container的别名和父container的IP绑到了一起。我们 试着通过host的名字ping一下. **root@aed84ee21bde:/opt/webapp# apt-get install -yqq inetutils-pingroot@aed84ee21bde:/opt/webapp# ping dbPING db (172.17.0.5): 48 data bytes56 bytes from 172.17.0.5: icmp_seq=0 ttl=64 time=0.267 ms56 bytes from 172.17.0.5: icmp_seq=1 ttl=64 time=0.250 ms56 bytes from 172.17.0.5: icmp_seq=2 ttl=64 time=0.256 ms** 注 上面第一个命令是用来安装ping的, 因为我们使用的container里没有安装。 我们可以使用这个host吧web服务和数据库服务连接到一起。 注 一个父container可以连接多个子container。 例如, 我们可以把多个web服务的container连接 到一个数据库container上

优秀的个人博客,低调大师

MapReduce实现协同过滤中每个用户看过的项目集合

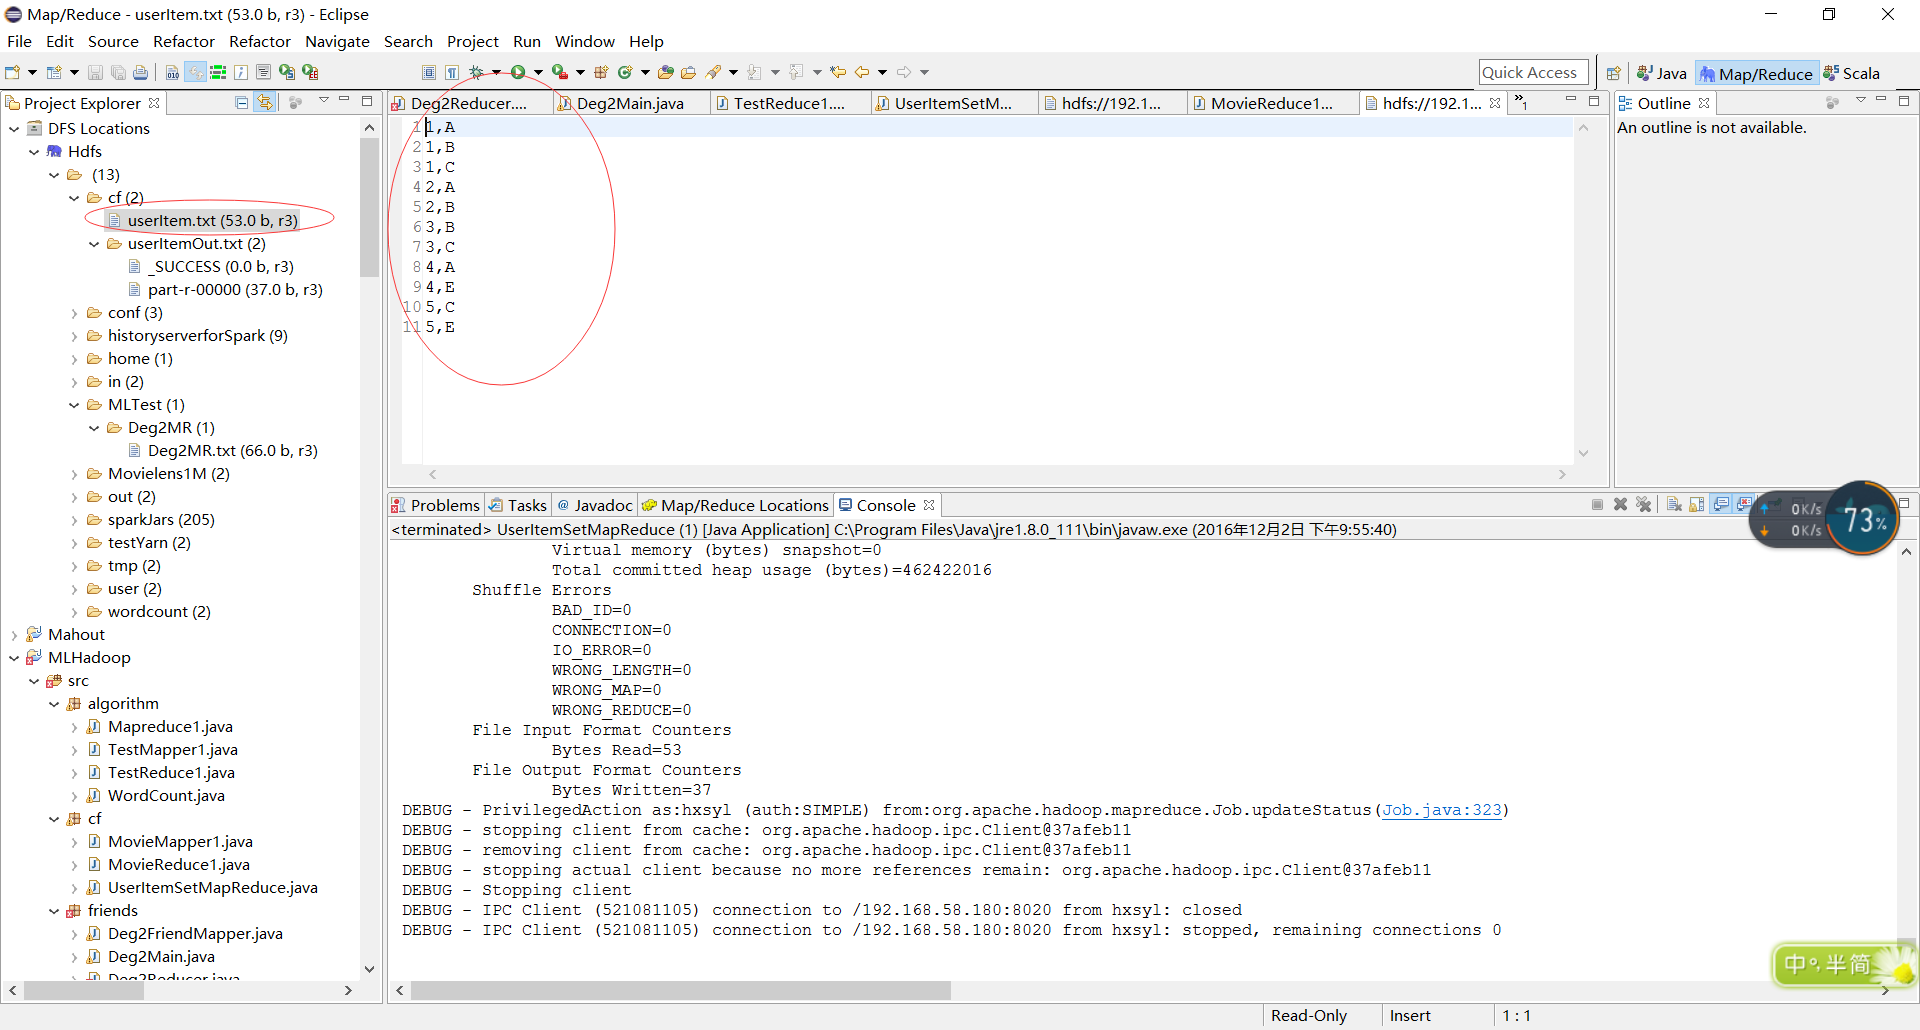
一、知识准备 hadoop自带的例子在 D:\HADOOP_HOME\hadoop-2.6.4\share\hadoop\mapreduce\sources\hadoop-mapreduce-examples 2.6.0-source.jar 我记得当年面试的时候就问中位数的问题不过是数据流下的中位数,一问便知是否搞过hadoop。 二、代码实现 2.1 Mapper package cf; import java.io.IOException; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Mapper; public class MovieMapper1 extends Mapper<LongWritable, Text, Text, Text> { public void map(LongWritable ikey, Text ivalue, Context context) throws IOException, InterruptedException { String[] values = ivalue.toString().split(","); if (values.length!=2) { return ; } String userID = values[0]; String itemID = values[1]; context.write(new Text(userID), new Text(itemID)); } } 2.2 Reducer package cf; import java.io.IOException; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Reducer; public class MovieReduce1 extends Reducer<Text, Text, Text, Text> { public void reduce(Text _key, Iterable<Text> values, Context context) throws IOException, InterruptedException { // process values StringBuffer sb = new StringBuffer(); for (Text val : values) { sb.append(val.toString()); sb.append(","); } //value不能直接用StringBuffer 必须转换为String context.write(_key,new Text(sb.toString())); } } 2.3 Main package cf; import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; public class UserItemSetMapReduce { public static void main(String[] args) throws Exception{ Configuration conf = new Configuration(); Job job = new Job(conf, "CFItemSet"); job.setJarByClass(UserItemSetMapReduce.class); job.setMapperClass(MovieMapper1.class); //job.setCombinerClass(cls); // job.setCombinerClass(MovieReduce1.class); job.setReducerClass(MovieReduce1.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); FileInputFormat.addInputPath(job,new Path("hdfs://192.168.58.180:8020/cf/userItem.txt")); //InputPath(job, new Path(otherArgs[0])); //直接写到cf会提示已存在cf,我写成uIO.ttx,以为内容会写入到txt,然没有,默认他是文件夹 FileOutputFormat.setOutputPath(job,new Path("hdfs://192.168.58.180:8020/cf/userItemOut.txt")); System.exit(job.waitForCompletion(true) ? 0 : 1); } } 三、结果分析 3.1 输入 3.2 输出 查看结果发现输出文件的分隔符默认是tab,‘\t’,同时相对于输入文件来说输出结果是逆着的,类似沾,莫非context就是这样的先进后出、 3.3日志分析 只列出了主要部分的日志 DEBUG - PrivilegedAction as:hxsyl (auth:SIMPLE) from:org.apache.hadoop.mapreduce.Job.getCounters(Job.java:765) INFO - Counters: 38 File System Counters FILE: Number of bytes read=538 FILE: Number of bytes written=509366 FILE: Number of read operations=0 FILE: Number of large read operations=0 FILE: Number of write operations=0 HDFS: Number of bytes read=106 HDFS: Number of bytes written=37 HDFS: Number of read operations=13 HDFS: Number of large read operations=0 HDFS: Number of write operations=4 Map-Reduce Framework Map input records=11 Map output records=11 Map output bytes=44 Map output materialized bytes=72 Input split bytes=107 Combine input records=0 Combine output records=0 Reduce input groups=5 Reduce shuffle bytes=72 Reduce input records=11 Reduce output records=5 Spilled Records=22 Shuffled Maps =1 Failed Shuffles=0 Merged Map outputs=1 GC time elapsed (ms)=3 CPU time spent (ms)=0 Physical memory (bytes) snapshot=0 Virtual memory (bytes) snapshot=0 Total committed heap usage (bytes)=462422016 Shuffle Errors BAD_ID=0 CONNECTION=0 IO_ERROR=0 WRONG_LENGTH=0 WRONG_MAP=0 WRONG_REDUCE=0 File Input Format Counters Bytes Read=53 File Output Format Counters Bytes Written=37 DEBUG - PrivilegedAction as:hxsyl (auth:SIMPLE) from:org.apache.hadoop.mapreduce.Job.updateStatus(Job.java:323) DEBUG - stopping client from cache: org.apache.hadoop.ipc.Client@37afeb11 DEBUG - removing client from cache: org.apache.hadoop.ipc.Client@37afeb11 DEBUG - stopping actual client because no more references remain: org.apache.hadoop.ipc.Client@37afeb11 DEBUG - Stopping client DEBUG - IPC Client (521081105) connection to /192.168.58.180:8020 from hxsyl: closed DEBUG - IPC Client (521081105) connection to /192.168.58.180:8020 from hxsyl: stopped, remaining connections 0 大神分析一下如何执行的,看着日志....Map如何输入的,执行几次等。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册