首页 文章 精选 留言 我的

精选列表

搜索[项目自动化],共10000篇文章
优秀的个人博客,低调大师

运维自动化之Saltstack使用详解

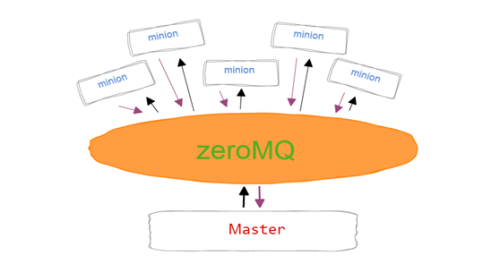
概要 saltstack是基于Python开发的C/S架构的一款批量管理工具,底层采用动态的连接总线(ZeroMQ消息队列pub/sub方式通信),使用ssl证书签发的方式进行认证管理,使其可以用于编配, 远程执行, 配置管理等等。部署轻松,在几分钟内可运行起来,扩展性好,很容易管理上万台服务器,速度够快,服务器之间秒级通讯。号称世界上最快的消息队列ZeroMQ使得saltstack非常快速的管理大量服务器,采用RSA Key方式确认身份,传输采用AES加密,安全性也非常有保障。 Saltstack使用Python开发,是一个非常简单易用和轻量级的管理工具。由Master和Minion构成,通过ZeroMQ进行通信。 SaltStack基于Python语言实现,结合轻量级消息队列(ZeroMQ)与Python第三方模块(Pyzmq、PyCrypto、Pyjinjia2、python-msgpack和PyYAML等)构建。有如下特性: (1)、部署简单、方便; (2)、支持大部分UNIX/Linux及Windows环境; (3)、主从集中化管理; (4)、配置简单、功能强大、扩展性强; (5)、主控端(master)和被控端(minion)基于证书认证,安全可靠; (6)、支持API及自定义模块,可通过Python轻松扩展。 Saltstack的master端监听4505与4506端口,4505为salt的消息发布系统,4506为salt客户端与服务端通信的端口;salt客户端程序不监听端口,客户端启动后,会主动连接master端注册,然后一直保持该TCP连接,master通过这条TCP连接对客户端控制,如果连接断开,master对客户端就无能为力了。当然,客户端若检查到断开后会定期的一直连接master端的。 核心功能 1、使命令发送到远程系统是并行的而不是串行的 2、使用安全加密的协议 3、使用最小最快的网络载荷 4、提供简单的编程接口 架构 saltstack是基于C/S服务模式,在该架构中,服务器端叫做Master,客户端叫做Minion。传统的C/S模式我们这样理解,客户端发送请求给服务器端,服务器端接受到来自客户端的请求并处理完成后再返回客户端。 在saltstack架构中,不仅有传统的C/S服务模式,而且有消息队列中的发布与订阅(pub/sub)服务模式。目前我们一般用其C/S架构做批量管理。 1)Master:控制中心,salt命令运行和资源状态管理 2)Minion:需要管理的客户端机器,会主动去连接Mater端,并从Master端得到资源状态 3)信息,同步资源管理信息 4)States:配置管理的指令集 5)Modules:在命令行中和配置文件中使用的指令模块,可以在命令行中运行 6)Grains:minion端的变量,静态的 7)Pillar:minion端的变量,动态的比较私密的变量,可以通过配置文件实现同步minions定义 8)highstate:为minion端下发永久添加状态,从sls配置文件读取.即同步状态配置 9)salt_schedule:会自动保持客户端配置 Saltstack安装 安装方式有四种,下面通过一个案例简单介绍在CentOS6.8上进行SaltStack部署。 (1)yum方式安装(采用saltstack源)推荐这种方式,简单粗暴。注意没有配置saltstack源的,请先配置saltstack源。 Version 7: rpm --importhttps://repo.saltstack.com/yum/redhat/7/x86_64/latest/SALTSTACK-GPG-KEY.pub Version 6: rpm --import https://repo.saltstack.com/yum/redhat/6/x86_64/latest/SALTSTACK-GPG-KEY.pub Save the following file to/etc/yum.repos.d/saltstack.repo: Version 7 and 6: [saltstack-repo] name=SaltStackrepoforRHEL/CentOS$releasever baseurl=https://repo.saltstack.com/yum/redhat/$releasever/$basearch/latest enabled=1 gpgcheck=1 gpgkey=https://repo.saltstack.com/yum/redhat/$releasever/$basearch/latest/SALTSTACK-GPG-KEY.pub 安装好saltstack源后,用yum命令来检查是否添加到源列表。 yumrepolistMaster端安装: yum -y install salt-master Minon端安装: yum -y install salt-minion 配置并启动Saltstack Salt的配置非常简单。默认的master配置就可以在大多数情况下运行。仅仅需要更改的是minion,在minion配置文件中设置master的地址。 The configuration fileswill be installed to/etc/saltand are named after the respective components,/etc/salt/master, and/etc/salt/minion. MASTER配置 默认Salt master监听所有网卡接口(0.0.0.0)的4505和4506端口. 如果需要指定监听IP, 通过/etc/salt/master配置文件中的"interface"指令进行如下修改: -#interface:0.0.0.0 +interface:10.0.0.1#此处是server端监听的地址。 auto_accept:True#此处是自动接受客户端发送过来的key,如果服务器很多的话,需要开启该功能。 MINION配置 尽管Salt Minion有许多配置选项,但配置Minion还是非常简单的. 默认的配置Minion会尝试连接DNS名为"salt"的master,如果minion解析到的地址正确,就无需再做配置. 如果DNS名为"salt"并不能解析到本地正确的Master地址,需要通过如下方法修改/etc/salt/minion配置文件中的"master"指令: -#master:salt +master:10.0.0.1#这里改成你的master服务器地址 id:web01#建议这里修改成主机名,便于master端分辨 #在配置文件末尾加入下面内容,每隔5分钟自动同步master配置,效果等同于在客户端执行salt-callstate.highstate或在server端执行salt'*'state.highstate schedule: highstate: function:state.highstate minutes:5 更新完配置后,需要重启Salt minion以使配置生效. 运行Saltstack 1.前台启动master(如果要以daemon方式启动,请指定-d参数<salt-master-d>): salt-master 2.前台启动minion(如果要以daemon方式启动,请指定-d参数<salt-minion-d>): salt-minion 运行有问题? 排除Salt故障最简单的方法是在前台运行master和minion,同时把loglevel设为``debug`` salt-master--log-level=debug 以普通(非root)用户运行: 想要使用其他用户身份运行Salt,参见:conf_master:`user`参数在master配置文件中。 Additionally, ownership, and permissions need to be set suchthat the desired user can read from and write to the following directories (andtheir subdirectories, where applicable): /etc/salt /var/cache/salt /var/log/salt /var/run/salt 更多关于如何使用非特权用户运行salt的信息可以在这里找到。 salt-key证书管理: master端证书存放路径:/etc/salt/pki/master/minions 注意:如果细心的话,你会发现小写字母针对的单一对象,大写都是针对全体。比如 -l显示单一key,-L显示所有key;-a 接受指定key,而-A 就是接受所有key。 saltstack认证原理: 1)、minion在第一次启动时,会在/etc/salt/pki/minion/(该路径在/etc/salt/minion里面设置)下自动生成minion.pem(private key)和 minion.pub(public key),然后将 minion.pub发送给master。 2)、master在接收到minion的publickey后,通过salt-key命令accept minion public key,这样在master的/etc/salt/pki/master/minions下的将会存放以minion id命名的 public key,然后master就能对minion发送指令了。 salt-key-L#查询所有接收到的证书 salt-key-a<证书名>#接收单个证书 salt-key-A#接受所有证书 salt-key-d<证书名>#删除单个证书 salt-key-D#删除所有证书 Salt在Master和Minion之间的通讯采用AES加密. 这就确保了发送给minions的命令不会被篡改, Master和Minion之间的通讯认证通过信任的已接受的key进行管理. 在发送给Minion之前,需要确保minion的key已经被Master所接受. 运行``salt-key``命令将列出Salt Master已知的所有keys. [root@master~]#salt-key-L UnacceptedKeys: alpha bravo charlie delta AcceptedKeys: [root@master~]#salt-key–A-y [root@master~]#salt-key-L UnacceptedKeys: AcceptedKeys: alpha bravo charlie delta 发送test.ping指令 [root@moban~]#salt'*'test.ping moban2: True moban1: True 限于篇幅太长,请大家移步这里进行下载查看,谢谢! 下载地址:http://down.51cto.com/data/2306388 本文转自 linuxzkq 51CTO博客,原文链接:http://blog.51cto.com/linuxzkq/1925299

优秀的个人博客,低调大师

Python自动化运维之异常处理

1、异常异常就是非正常状态,在Python中使用异常对象来表示异常。若程序在编译或运行过程中发生错误,程序的执行过程就会发生改变,抛出异常对象,程序流进入异常处理。如果异常对象没有被处理或捕捉,程序就会执行回溯(Traceback)来终止程序。2、异常类型通用异常类型表 异常 描述 BaseException 所有异常的基类 SystemExit 解释器请求退出 KeyboardInterrupt 用户中断执行(通常是输入^C) Exception 常规错误的基类 StopIteration 迭代器没有更多的值 GeneratorExit 生成器(generator)发生异常来通知退出 StandardError 所有的内建标准异常的基类 ArithmeticError 所有数值计算错误的基类 FloatingPointError 浮点计算错误 OverflowError 数值运算超出最大限制 ZeroDivisionError 除(或取模)零 (所有数据类型) AssertionError 断言语句失败 AttributeError 对象没有这个属性 EOFError 没有内建输入,到达EOF 标记 EnvironmentError 操作系统错误的基类 IOError 输入/输出操作失败 OSError 操作系统错误 WindowsError 系统调用失败 ImportError 导入模块/对象失败 LookupError 无效数据查询的基类 IndexError 序列中没有此索引(index) KeyError 映射中没有这个键 MemoryError 内存溢出错误(对于Python 解释器不是致命的) NameError 未声明/初始化对象 (没有属性) UnboundLocalError 访问未初始化的本地变量 ReferenceError 弱引用(Weak reference)试图访问已经垃圾回收了的对象 RuntimeError 一般的运行时错误 NotImplementedError 尚未实现的方法 SyntaxError Python 语法错误 IndentationError 缩进错误 TabError Tab 和空格混用 SystemError 一般的解释器系统错误 TypeError 对类型无效的操作 ValueError 传入无效的参数 UnicodeError Unicode 相关的错误 UnicodeDecodeError Unicode 解码时的错误 UnicodeEncodeError Unicode 编码时错误 UnicodeTranslateError Unicode 转换时错误 Warning 警告的基类 DeprecationWarning 关于被弃用的特征的警告 FutureWarning 关于构造将来语义会有改变的警告 OverflowWarning 旧的关于自动提升为长整型(long)的警告 PendingDeprecationWarning 关于特性将会被废弃的警告 RuntimeWarning 可疑的运行时行为(runtime behavior)的警告 SyntaxWarning 可疑的语法的警告 UserWarning 用户代码生成的警告 Exception类:是通用异常基类下列异常类均继承于Exception类,python解析器会自动将通用异常类型名称放在内建命名空间中,所以当使用通用异常类型时,不需要import exceptions模块。3、异常处理3.1 触发异常raiseraise关键字:手动抛出一个通用的异常类型(Exception),类似Java中的throw语句。raise关键字后跟异常的名称,异常名称能够标识出异常类的对象。执行raise语句时,python会创建指定异常类的对象,还能够指定对异常对象进行初始化的参数,参数也可以为由若干参数组成的元组。 注意:一旦执行raise语句,程序就会被终止。 格式:raise [exceptionType[,argument][,traceback]] deftestRaise(number): ifnumber<1: raiseValueError('Invalidvalue')#或者raiseValueError,'Invalidvalue' testRaise(0) traceback:这个参数用于追踪异常对象,一般很少使用。 这样就可以触发一个异常,并且接收异常信息。3.2 传递异常当你捕获到异常之后又希望再次的触发异常只需要使用不带任何参数的raise关键字。 importos try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists' ifnotos.path.exists('notExistsFile.txt'): raise except: print('processexception' 异常会在捕获之后再次触发同一个异常。3.3 assert语句触发异常assert语句根据后面的表达式的真假来控制程序流。若为True,则往下执行。若为False,则中断程序并调用默认的异常处理器,同时输出指定的提示信息。 格式:assertexpression,'information' 例如: deftestAssert(x): assertx<1,'Invalidvalue' testAssert(1) print('Validvalue' 执行结果: AssertionError:Invaildvalue 3.4 捕获异常try..except..else注意:except子句的数量没有限制,但使用多个except子句捕获异常时,如果异常类之间具有继承关系,则子类应该写在前面,否则父类将会直接截获子类异常。放在后面的子类异常也就不会执行。 格式: try: 可能触发异常的语句块 except[exceptionType]: 捕获可能触发的异常[可以指定处理的异常类型] except[exceptionType][,date]: 捕获异常并获取附加数据 except: 没有指定异常类型,捕获任意异常 else: 没有触发异常时,执行的语句块 4、try的工作原理执行一个try语句时,python解析器会在当前程序流的上下文中作标记,当出现异常后,程序流能够根据上下文的标记回到标记位,从而避免终止程序。 1. 如果try语句执行时发生异常,程序流跳回标记位,并向下匹配执行第一个与该异常匹配的except子句,异常处理完后,程序流就通过整个try语句(除非在处理异常时又引发新的异常)。 2. 如果没有找到与异常匹配的except子句(也可以不指定异常类型或指定同样异常类型Exception,来捕获所有异常),异常被递交到上层的try(若有try嵌套时),甚至会逐层向上提交异常给程序(逐层上升直到能找到匹配的except子句。实在没有找到时,将结束程序,并打印缺省的错误信息)。 3. 如果在try子句执行时没有发生异常,python将执行else语句后的语句(可选),然后控制流通过整个try语句。 try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists')#执行 except: print('processexception')#不执行 else: print('Readingthefile')#不执行 执行结果: In[157]:%runtestError.py FilenotExists 嵌套try: try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOError: print('FilenotExists')#执行 except: print('processexception')#不执行 else: print('Readingthefile')#执行 执行结果: In[159]:%runtestError.py FilenotExists Readingthefile 5、捕捉多个异常方法一:指定一个通用异常,可以捕获多个不同的包含在Exception类中的异常类。 try: 语句块 exceptException: 语句块 方法二:在一个except子句后将多个异常作为元组元素列出。 try: 语句块 except(IOError,ValueError): 语句块 方法三:except子句后不带任何异常名称,捕获所有异常 try: 语句块 except: 语句块 6、try..finally语句无论try语句块中是否触发异常,都会执行finally子句中的语句块,因此一般用于关闭文件或关闭因系统错误而无法正常释放的资源。比如文件关闭,释放锁,把数据库连接返还给连接池等。 importos defwrite_test(fileName,content_iterable): try: pwd=open(fileName,'w') forkey,valueincontent_iterable.items(): pwd.write(key+'\t'+value+'\n')#传入String类型参数同时加入换行符 finally: pwd.close() if__name__=='__main__': fileName='/usr/local/src/pyScript/fileOperation.txt' dic={'name':'Jmilk','age':'23','city':'BJ'} ifos.path.exists(fileName): write_test(fileName,dic) else:print('Filenotexist!') 注意:try..finally与try..except 是可以同时使用的。 In[3]:try: ...:raise ...:exceptException: ...:print('error') ...:raise ...:finally: ...:print('success') ...: error success --------------------------------------------------------------------------- TypeErrorTraceback(mostrecentcalllast) <ipython-input-3-530db52949e7>in<module>() 1try: ---->2raise 3exceptException: 4print('error' 5raise TypeError:exceptionsmustbeold-styleclassesorderivedfromBaseException,notNoneType NOTE:try…finally 的意义在于,就是我们在 try 代码块中执行了 return 语句,但是仍然会继续执行在 finally 中的代码块,所以我们一般用作处理资源的释放。7、自定义异常通过(直接或简介)继承Exception类来创建一个自定义异常类,自定义的异常类只能通过raise关键字来手动触发。 classtestError(Exception):#直接集成Exception类 def__init__(self,arg): self.args=arg try: raisetestError('Justtest') excepttestError,info: printinfo.args 执行结果: In[52]:%runtest.py ('J','u','s','t','','t','e','s','t') with..as触发异常自动关闭资源在使用类文件的流对象时,都需要单独的调用close()来关闭资源。with..as语句能够实现在with语句块执行完后,自动的关闭文件。如果with语句块中触发异常,会调用默认的异常处理器处理,而且文件仍然能够正常关闭。 importos deftestWith(fileName): try: withopen(fileName,'r+')aspwd: pwd.readlines() print2/0 exceptException: print('Fileclosed:',pwd.closed#判断文件是否关闭 if__name__=='__main__': ifos.path.exists('/usr/local/src/pyScript/fileOperation.txt'): testWith('/usr/local/src/pyScript/fileOperation.txt') print('continue') 执行结果: In[17]:%runtest.py Fileclosed:True#没有callclose()函数,文件仍然自动关闭。 continue 7、as获取异常信息每个异常都会有一定的描述信息,可以通过as关键字来获取。但是这种异常信息并不适合一般用户阅读,所以会使用自定义的异常信息。但是仍然会将原有的异常信息保留起来,用于后期的异常分析。 try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() except(IOError,ValueError)asinfo:#或者except(IOError,ValueError),info: printinfo except: print('processexception') else: print('Readingthefile') 执行结果: In[164]:%runtestError.py [Errno2]Nosuchfileordirectory:'notExistsFile.txt' 异常参数也可以使用异常参数作为输出的异常信息参数,来获取异常信息。并且异常参数中包含有异常信息、错误数字、错误位置等属性。 try: try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() except(IOError,ValueError),info: printdir(info) printinfo.args except: print('processexception') else: print('Readingthefile') 执行结果: In[44]:%runtest.py ['__class__','__delattr__','__dict__', '__doc__','__format__','__getattribute__','__getitem__', '__getslice__','__hash__','__init__','__new__','__reduce__', '__reduce_ex__','__repr__','__setattr__','__setstate__', '__sizeof__','__str__','__subclasshook__','__unicode__','args', 'errno','filename','message','strerror'] (2,'Nosuchfileordirectory') Readingthefile 8、traceback追踪异常使用traceback追踪异常的时候,需要import traceback模块。traceback模块可以有效的帮助查看异常的详细信息。 注意:若希望获取异常的详细信息,却又不会终止程序的执行,可以在except子句中使用 tarceback.print_exc()函数。 tarceback.print_exc(): print_exc(limit=None,file=None) Shorthandfor‘print_exception(sys.exc_type,sys.exc_value,sys.exc_traceback,limit,file)’. (Infact,itusessys.exc_info()toretrievethesameinformationinathread-safeway.) 输出sys.exc_type, sys.exc_value, sys.exc_traceback, limit, file等异常信息,实际上是以线程安全的方式去使用sys.exc_info()函数来获取相同的信息。 importtraceback try: openFile=open('notExistsFile.txt','r') fileContent=openFile.readlines() exceptIOErrorasinfo: print('FilenotExists') print(info) traceback.print_exc() print('continue') except: print('processexception') else: print('Readingthefile') 执行结果: In[38]:%runtest.py FilenotExists [Errno2]Nosuchfileordirectory:'notExistsFile.txt' Traceback(mostrecentcalllast): File"/usr/local/src/pyScript/test.py",line5,in<module> openFile=open('notExistsFile.txt','r') IOError:[Errno2]Nosuchfileordirectory:'notExistsFile.txt' continue 异常信息的重定向:如果希望将异常的信息保存在一个指定的文件中,以供后期分析。可以使用下面的方法: importtraceback try: withopen('notExistsFile.txt','r')asopenFile: fileContent=openFile.readlines() exceptIOError: withopen('errorLog','w+')aserrorInfo: traceback.print_exc(file=errorInfo) print('continue') except: print('processexception') else: print('Readingthefile') 执行结果: In[61]:%runtest.py continue In[62]:caterrorLog Traceback(mostrecentcalllast): File"/usr/local/src/pyScript/test.py",line5,in<module> withopen('notExistsFile.txt','r')asopenFile: IOError:[Errno2]Nosuchfileordirectory:'notExistsFile.txt' sys.exc_info()获取异常信息traceback.print_exc()函数实际上是call sys.exc_info() importsys try: a=b b=c except: info=sys.exc_info() print(info[0],":",info[1]) 执行结果: In[65]:%runtest.py <type'exceptions.NameError'>:name'b'isnotdefined 异常处理用于处理程序错误之外,还有许多应用的地方。如关闭资源、平台兼容、模块导入等。

优秀的个人博客,低调大师

Python自动化运维之高级函数

一、协程1.1协程的概念协程,又称微线程,纤程。英文名Coroutine。一句话说明什么是线程:协程是一种用户态的轻量级线程。(其实并没有说明白~)那么这么来理解协程比较容易: 线程是系统级别的,它们是由操作系统调度;协程是程序级别的,由程序员根据需要自己调度。我们把一个线程中的一个个函数叫做子程序,那么子程序在执行过程中可以中断去执行别的子程序;别的子程序也可以中断回来继续执行之前的子程序,这就是协程。也就是说同一线程下的一段代码执行着执行着就可以中断,然后跳去执行另一段代码,当再次回来执行代码块的时候,接着从之前中断的地方开始执行。比较专业的理解是: 协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈。因此:协程能保留上一次调用时的状态(即所有局部状态的一个特定组合),每次过程重入时,就相当于进入上一次调用的状态,换种说法:进入上一次离开时所处逻辑流的位置。1.2 协程的优缺点协程的优点: (1)无需线程上下文切换的开销,协程避免了无意义的调度,由此可以提高性能(但也因此,程序员必须自己承担调度的责任,同时,协程也失去了标准线程使用多CPU的能力) (2)无需原子操作锁定及同步的开销 (3)方便切换控制流,简化编程模型 (4)高并发+高扩展性+低成本:一个CPU支持上万的协程都不是问题。所以很适合用于高并发处理。协程的缺点: (1)无法利用多核资源:协程的本质是个单线程,它不能同时将 单个CPU 的多个核用上,协程需要和进程配合才能运行在多CPU上.当然我们日常所编写的绝大部分应用都没有这个必要,除非是cpu密集型应用。 (2)进行阻塞(Blocking)操作(如IO时)会阻塞掉整个程序2、Python中如何实现协程2.1 yield实现协程 前文所述“子程序(函数)在执行过程中可以中断去执行别的子程序;别的子程序也可以中断回来继续执行之前的子程序”,那么很容易想到Python的yield,显然yield是可以实现这种切换的。 defeater(name): print("%seatfood"%name) whileTrue: food=yield print("done") g=eater("gangdan") print(g) 执行结果: <generatorobjecteaterat0x0000000002140FC0> 由执行结果可以证明g现在就是生成器函数 2.2 协程函数赋值过程用的是yield的表达式形式,要先运行next(),让函数初始化并停在yield,然后再send() ,send会在触发下一次代码的执行时,给yield赋值next()和send() 都是让函数在上次暂停的位置继续运行, defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) #获取生成器 builder=creater('tom') #现在是运行函数,让函数初始化 next(builder) print(builder.send('包子')) print(builder.send('骨头')) print(builder.send('菜汤')) 执行结果: tomstarttoeatfood tomget包子,tostarteat ['包子'] tomget骨头,tostarteat ['包子','骨头'] tomget菜汤,tostarteat ['包子','骨头','菜汤'] 需要注意的是每次都需要先运行next()函数,让程序停留在yield位置。如果有多个这样的函数都需要执行next()函数,让程序停留在yield位置。为了防止忘记初始化next操作,需要用到装饰器来解决此问题 definit(func): defwrapper(*args,**kwargs): builder=func(*args,**kwargs) next(builder)#这个地方是关键可以使用builder.send("None"),第一次必须传入None。 returnbuilder returnwrapper @init defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) #获取生成器 builder=creater("tom") #现在是直接运行函数,无须再函数初始化 print(builder.send('包子')) print(builder.send('骨头')) print(builder.send('菜汤')) 执行结果: tomstarttoeatfood tomget包子,tostarteat ['包子'] tomget骨头,tostarteat ['包子','骨头'] tomget菜汤,tostarteat ['包子','骨头','菜汤'] 2.3协程函数简单应用 请给Tom投喂食物 definit(func): defwrapper(*args,**kwargs): builder=func(*args,**kwargs) next(builder) returnbuilder returnwrapper @init defcreater(name): print('%sstarttoeatfood'%name) food_list=[] whileTrue: food=yieldfood_list print('%sget%s,tostarteat'%(name,food)) food_list.append(food) deffood(): builder=creater("Tom") whileTrue: food=input("请给Tom投喂食物:").strip() iffood=="q": print("投喂结束") return0 else: builder.send(food) if__name__=='__main__': food() 执行结果: Tomstarttoeatfood 请给Tom投喂食物:骨头 Tomget骨头,tostarteat 请给Tom投喂食物:菜汤 Tomget菜汤,tostarteat 请给Tom投喂食物:q 投喂结束 2.4 协程函数的应用实现linux中"grep -rl error <目录>"命令,过滤一个文件下的子文件、字文件夹的内容中的相应的内容的功能程序首先了解一个OS模块中的walk方法,能够把参数中的路径下的文件夹打开并返回一个元组 >>>importos#导入模块 >>>os.walk(r"E:\Python\script")#使用r是让字符串中的符号没有特殊意义,针对的是转义 <generatorobjectwalkat0x00000000035D3F10> >>>g=os.walk(r"E:\Python\script") >>>next(g) ('E:\\Python\\script',['.idea','函数'],[]) 返回的是一个元组,第一个元素是文件的路径,第二个是文件夹,第三个是该路径下的文件这里需要用到一个写程序的思想:面向过程编程二、面向过程编程面向过程:核心是过程二字,过程及即解决问题的步骤,基于面向过程设计程序就是一条工业流水线,是一种机械式的思维方式。流水线式的编程思想,在设计程序时,需要把整个流程设计出来优点:1:体系结构更加清晰2:简化程序的复杂度缺点:可扩展性极其的差,所以说面向过程的应用场景是:不需要经常变化的软件,如:linux内核,httpd,git等软件下面就根据面向过程的思想完成协程函数应用中的功能目录结构: test ├──aa │├──bb1 ││└──file2.txt │└──bb2 │└──file3.txt └─file1.txt 文件内容: file1.txt:error123 file2.txt:123 file3.txt:123error 程序流程 第一阶段:找到所有文件的绝对路径 第二阶段:打开文件 第三阶段:循环读取每一行 第四阶段:过滤“error” 第五阶段:打印该行属于的文件名第一阶段:找到所有文件的绝对路径g是一个生成器,就能够用next()执行,每次next就是运行一次,这里的运行结果是依次打开文件的路径 >>>importos >>>g=os.walk(r"E:\Python\script\函数\test") >>>next(g) ('E:\\Python\\script\\函数\\test',['aa'],[]) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa',['bb1','bb2'],['file1.txt']) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa\\bb1',[],['file2.txt']) >>>next(g) ('E:\\Python\\script\\函数\\test\\aa\\bb2',[],['file3.txt']) >>>next(g) Traceback(mostrecentcalllast): File"<input>",line1,in<module> StopIteration 我们在打开文件的时候需要找到文件的绝对路径,现在可以通过字符串拼接的方法把第一部分和第三部分进行拼接用循环打开: importos dir_g=os.walk(r"E:\Python\script\函数\test") fordir_pathindir_g: print(dir_path) 结果: ('E:\\Python\\script\\函数\\test',['aa'],[]) ('E:\\Python\\script\\函数\\test\\aa',['bb1','bb2'],['file1.txt']) ('E:\\Python\\script\\函数\\test\\aa\\bb1',[],['file2.txt']) ('E:\\Python\\script\\函数\\test\\aa\\bb2',[],['file3.txt']) 将查询出来的文件和路径进行拼接,拼接成绝对路径 importos dir_g=os.walk(r"E:\Python\script\函数\test") fordir_pathindir_g: forfileindir_path[2]: file="%s\\%s"%(dir_path[0],file) print(file) 执行结果: E:\Python\script\函数\test\aa\file1.txt E:\Python\script\函数\test\aa\bb1\file2.txt E:\Python\script\函数\test\aa\bb2\file3.txt 用函数实现: importos defsearch(): whileTrue: dir_name=yield dir_g=os.walk(dir_name) fordir_pathindir_g: forfileindir_path[2]: file="%s\\%s"%(dir_path[0],file) print(file) g=search() next(g) g.send(r"E:\Python\script\函数\test") 为了把结果返回给下一流程 @init#初始化生成器 defsearch(target): whileTrue: dir_name=yield dir_g=os.walk(dir_name) forpardir,_,filesindir_g: forfileinfiles: abspath=r"%s\%s"%(pardir,file) target.send(abspath) 第二阶段:打开文件 @init defopener(target): whileTrue: abspath=yield withopen(abspath,'rb')asf: target.send((abspath,f)) 第三阶段:循环读出每一行内容 @init defcat(target): whileTrue: abspath,f=yield#(abspath,f) forlineinf: res=target.send((abspath,line)) ifres:break 第四阶段:过滤 @init defgrep(pattern,target): tag=False whileTrue: abspath,line=yieldtag tag=False ifpatterninline: target.send(abspath) tag=True 第五阶段:打印该行属于的文件名 @init defprinter(): whileTrue: abspath=yield print(abspath) g=search(opener(cat(grep('error'.encode('utf-8'),printer())))) g.send(r'E:\Python\script\函数\test') 执行结果: E:\Python\script\函数\test\aa\file1.txt E:\Python\script\函数\test\aa\bb2\file3.txt

优秀的个人博客,低调大师

APP远程调试及网络自动化测试

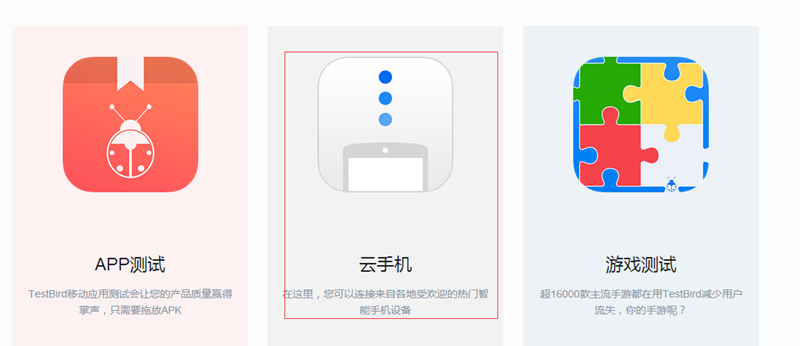
一:优测 腾讯旗下的测试服务 http://utest.qq.com/ 二:云测 http://www.testin.cn/ 三:testbird 1、进入这个网站,注册并且登录 https://dt.testbird.com/login/ 2、选择 云手机 3、选择需要租用的手机 4、点击 远程调试 5、在本地电脑的dos 命令窗口,输入两条 adb 命令提示符,没有出错的话,会提醒链接成功。 6、在Android studio 里面就可以运行APP到 云手机里面。还可以在本地打断点 debug调试 。

优秀的个人博客,低调大师

Rsync企业实战之异地自动化备份

认真的测试过网上的大多数文章和版本,真正能一次性测试通过的文章太少了,需要反复的推敲,反复的查阅资料,才能真正的测试成功,所以,在此背景下,总结了Rsync,加上自己的理解分享出来; 1、 原理篇 Rsync, 故名思议,是一个远程数据同步工具,可以镜像整个目录树和文件系统,也可以保持源文件的权限,时间和软硬链接,可以优化数据,文件重复数据的删除,也可以 在LAN/WAN之间快速的同步多台主机的数据,这主要得益于Rsync的压缩和Rsync的核心算法,其算法,是本地和远程两台主机之间的文件达到同步 并保持一致,并且只传送两个文件的不同部分,而不是整个数据进行传送,所以,速度非常快; 一个Rsync server能够同时备份多个客户端数据,也可以一个客户端备份多个Rsync server的数据; Rsync 支持搭配scp,ssh和daemon模式,默认端口是873,当第一次连接的时候,会对数据进行完整备份,之后的所有备份,都是进行增量备份,只备份又变化的数据; Rsync只支持单向备份,不支持双向,如果需要双向同步的,可以使用Unison;如果需要实时同步的,可以结合Rsync+inotify; Rsync服务以只读方式提供要备份的数据,避免破坏生产环境的数据; 在这里,有必要对Rsync的核心算法,进行讲解: 假定在名为 α 和 β 的两台计算机之间同步相似的文件 A 与 B,其中 α 对文件A拥有访问权,β 对文件 B 拥有访问权。并且假定主机 α 与 β 之间的网络带宽很小。那么 Rsync 算法将通过下面的五个步骤来完成: β 将文件 B 分割成一组不重叠的固定大小为 S 字节的数据块。最后一块可能会比 S 小。 β 对每一个分割好的数据块执行两种校验:一种是32位的滚动弱校验,另一种是128位的 MD4 强校验。 β 将这些校验结果发给 α。 α 通过搜索文件 A 的所有大小为 S 的数据块(偏移量可以任选,不一定非要是 S 的倍数),来寻找与文件B 的某一块有着相同的弱校验码和强校验码的数据块。这项工作可以借助滚动校验的特性很快完成。 α 发给 β 一串指令来生成文件 A 在 β 上的备份。这里的每一条指令要么是对文件 B 经拥有某一个数据块而不须重传的证明,要么是一个数据块,这个数据块肯定是没有与文件 B 的任何一个数据块匹配上的。 Rsync适用于linux、solaris和bsd,在windows平台下,有cwRsync。 本文,将以Linux的Rsync和以window的cwRsync为例讲解。 2、 Rsync服务端 2.1、 安装 源码安装 下载rsync服务端程序, tar zxvf rsync-2.6.9.tar.gz cd rsync-2.6.9 ./configure --prefix=/usr/local/rsync make make install rpm安装 yum install rsync 本文以yum来安装 2.2、 服务器运行模式 模式选择 对于负载比较重的,选择独立服务启动 对于负载比较轻的,选择以xinet.d启动,选择此模式,记得要安装xinet.d (yum install xinet.d) 独立运行模式 /usr/bin/rsync --daemon --config=/etc/rsyncd.conf (本例选择此方法) 如果需要系统开机启动,可以把上面命令加入到/etc/rc.local文件中。 2.3、 服务器配置 创建配置文件和口令文件 touch /etc/rsyncd.conf 主要配置文件 touch /etc/rsync.pas 口令文件,此文件需要注意客户端和服务器端的格式,后续会讲解 关于配置文件rsyncd.conf讲解 Rsync的配置文件,分为两个部分,全局配置和模块配置, #全局设置 uid = root 指定模块以root用户来传输文件,如果匿名用户的话,这里填写nobody gid = root 指定模块以root用户组来传输文件,如果匿名传输的话,这里填写nobody use chroot = yes 设置为YES,表示在传输文件之前,定位到根目录下,即PATH指定的目录,这样做,主要是出于安全考虑 pid file = /var/run/rsyncd.pid Rsync守护进程把其PID写入的文件 lock file = /var/run/rsync.lock 指定支持max connections的锁文件 log file = /var/log/rsyncd.log 指定Rsync守护进程产生的日志文件,而不是传送给syslog #模块设置 [Jindie] 模块名称,后续上传下载文件配置时,直接使用此名称名来指定 path = /sda1/JDdatabase 指定此模块的根目录,即文件上传下载都是在此目录下进行 ignore errors 指定在 rsync 服务器上运行 delete 操作时是否忽略 I/O 错误 read only = false 指定是否允许上传,false代表允许上传。 write only = false 指定是否允许下载,false代表允许下载。 list = true 指定当客户请求列出可以使用的模块,该模块是否被列出。如果false,可以创建隐藏的模块。 hosts allow = 192.168.1.65 指定哪些客户端可以访问连接此模块,可以指定单个IP,整个网段,比如此例为单个IP hosts deny = 0.0.0.0/0 指定哪些客户端不允许连接此模块,此例为0.0.0.0/0网段,代表整个网络 通常表示客户端表示方式,有如下: 单个IP:192.168.1.65 网段IP:192.168.1.0/24 可解析的主机地址:www.baidu.com 域内主机:*.wine9.com 所有主机:* 多个列表项,要用空格隔开; auth users = xy 指定认证用户名,通常由空格或者逗号分隔用户名列表,只有这些用户可以连接此模块,用户名和密码,以明文形式,保存在口令文件中 syslog facility = local5 指定日志等级,一般指发送给rsyslog的日志等级; secrets file = /etc/rsync.pas 指定Rsync认证口令文件,只有配置了auth users,此配置才生效,这里要注意客户端和服 务器端的配置格式。 ignore nonreadable 指定 rysnc 服务器完全忽略那些用户没有访问权限的文件,这对于在需要备份的目录中有些不应该被备份者获取的文件时非常有意义 timeout 600 设置客户端连接超时时间,确保服务器不会永远等待一个奔溃的客户端。 dont compress=*.gz 指定哪些文件在传输之前,不需要进行压缩的文件。 max connections = 4 指定此模块最大的并发连接数为4,超过的告知随后再试 exclude指定多个由空格隔开的多个文件或目录(相对路径),并将其添加到 exclude 列表中。这等同于在客户端命令中使用 –exclude 来指定模式。 Exclude from指定一个包含 exclude 规则定义的文件名,服务器从该文件中读取 exclude 列表定义 include指定多个由空格隔开的多个文件或目录(相对路径),并将其添加到 include 列表中。这等同于在客户端命令中使用 –include 来指定模式 Include from指定一个包含 include 规则定义的文件名,服务器从该文件中读取 include 列表定义 2.4、 建立Rsync口令文件 创建口令文件 touch /etc/rsync.pas #口令文件,保存Rsync用户和密码验证信息,不需要是系统账号; vi /etc/rsync.pas xy:abc123 #格式为 用户名:口令,此账号不用是系统账号 注意与后面的客户端口令文件的格式进行比较,相较两者不同点,这一点,有很多童鞋容易弄错了,重要的事情说三遍,注意格式,注意格式,注意格式。 2.5、 口令文件权限 口令文件,需要设置口令文件权限,这一步同样非常重要,Rsync对权限的要求还是比较敏感的。 #chown root:root /etc/rsync.pas #root:root 指的是当前启动此服务的用户,并设置为属主 #chmod 600 /etc/rsync.pas #指定启动此Rsync服务的用户的权限为只读权限,也就是前面提到的属主的权限。 3、 Rsync客户端 客户端本例,选择windows的cwrsync工具,安装不用多说。 3.1、 创建口令文件 新建rsync.pas文件,添加内如如下: 因为我使用的用户名是xy,此设置的密码,必须跟服务器端rsync.pas口令文件中设置的密码一样,比如本例口令为abc123; 那么,本例中设置为: abc123 3.2、 口令文件权限 windows 口令文件的权限一定要设置正确,否则验证无法通过,应将口令文件c:\rsync.pas的权限加入系统登录的账号读取权限以及设置其为该文件的所有者 (这里跟服务器端有点不同,正常来说,无论windows还是liunx,服务器端的这个用户名,应该是启动Rsync服务的用户名,但是对于 windows客户端来说,一般都是系统登录账号) 定位到cwRsync客户端安装目录,C:\Program Files (x86)\cwRsync\bin chmod 600 /cygdrive/c/rsync.pas chown administrator /cygdrive/c/rsync.pas #如果没有chown.exe文件,可以从服务器端的安装目录的bin目录下直接复制过来就可以使用, 注:Rsync对路径的书写格式,与windows不同,它是遵循,postfix书写格式, 3.3、 同步文件 Rsync同步的六种格式 当Rsync已经做好服务器端和客户端的配置之后,接下来就是通过Rsync命令,像服务器发起命令请求,来完成文件的同步操作,Rsync的功能非常强大,提供了六种格式,来支持Rsync的六种工作方式; rsync [OPTION]... SRC DEST rsync [OPTION]... SRC [USER@]HOST:DEST rsync [OPTION]... [USER@]HOST:SRC DEST rsync [OPTION]... [USER@]HOST::SRC DEST rsync [OPTION]... SRC [USER@]HOST::DEST rsync [OPTION]... rsync://[USER@]HOST[:PORT]/SRC [DEST] 对于以上六种命令格式, 1) rsync [OPTION]... SRC DEST 拷贝本地文件,当SRC和DEST路径信息都不包含有单个冒号“:“,就启动此工作模式, rsync.exe –vzrtopg /data /backup 2) rsync [OPTION]... SRC [USER@]HOST:DEST 使用一个远程shell程序(如rsh、ssh)来实现将本地机器的内容拷贝到远程机器。当DST路径地址包含单个冒号":"分隔符时启动该模式。如:rsync -avz *.c foo:src 3) rsync [OPTION]... [USER@]HOST:SRC DEST 使用一个远程shell程序(如rsh、ssh)来实现将远程机器的内容拷贝到本地机器。当SRC地址路径包含单个冒号":"分隔符时启动该模式。如:rsync -avz foo:src/bar /data 4) rsync [OPTION]... [USER@]HOST::SRC DEST 从远程rsync服务器中拷贝文件到本地机。当SRC路径信息包含"::"分隔符时启动该模式。如:rsync -av root@172.16.78.192::www /databack,其中www是在rsync配置文件中,指定的模块的名称。 5) rsync [OPTION]... SRC [USER@]HOST::DEST 从本地机器拷贝文件到远程rsync服务器中。当DST路径信息包含"::"分隔符时启动该模式。如:rsync -av /databack root@172.16.78.192::www,其中www是在rsync配置文件中,指定的模块的名称。 6) rsync [OPTION]... rsync://[USER@]HOST[:PORT]/SRC [DEST] 列远程机的文件列表。这类似于rsync传输,不过只要在命令中省略掉本地机信息即可。如:rsync -v rsync://172.16.78.192/www 上传同步文件 rsync.exe -vzrtopg --progress --delete /cygdrive/c/test/*.txt xy@192.168.31.13::Jindie --password-file=/cygdrive/c/rsync.pas 解释: rsync.exe 即rsync命令 vzrtopg 指定参数,传输的详细信息; --delete 删除哪些在DST中存在,而SRC中没有存在的文件或者目录 /cygdrive/c/test/*.txt 注意这里的格式,不能使用windows的格式,必须使用POSTFIX标准格式; xy@192.168.31.13::Jindie xy是有权访问服务器的用户名,192.168.31.13是服务器地址,Jindie是服务器端配置文件中指定的模块,这个模块中指定用户信息和同步路径;服务器地址和模块之间,用两个冒号隔开。 --password-file=/cygdrive/c/rsync.pas 口令文件,当中含有xy账号的密码,要与服务器端配置文件rsyncd.conf中指定的口令文件中设置的密码相同。 下载同步文件 rsync.exe -vzrtopg --progress --delete xy@192.168.31.13::Jindie /cygdrive/c/test --password-file=/cygdrive/c/rsync.pas 通常,因为上传和下载的方向性不同,直接调换源文件路径和目标地址的路径,即可。 4、 定时同步备份 把上面的命令写入到批处理器文件中,比如test.bat,通过任务计划来实现定时备份。 C:\Program Files (x86)\cwRsync\bin rsync.exe -vzrtopg --progress --delete /cygdrive/c/test/*.txt xy@192.168.31.13::Jindie --password-file=/cygdrive/c/rsync.pas 复制上面命令,保存到test.bat文件中, 开始 -- 所有程序-- 附件--系统工具--任务计划程序 展开 任务计划程序库--Microsoft,右击 “创建基本任务“ 创建基本任务向导,输入 ”名称” 点击 “下一步” 任务触发器,根据实际需要,设置每日,每周,每月同步,这里,我选择每日备份,可以减少带宽压力。 设置,每日启动的时间,这里设置每日,凌晨1点,点击 “下一步” 选择 “启动程序“ 浏览,选择 脚本文件 点击 “完成” 到此,部署,已经全部完成。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册