首页 文章 精选 留言 我的

精选列表

搜索[异步方法],共10000篇文章
优秀的个人博客,低调大师

python学习方法

#/usr/bin/envpython #-*-coding=utf-8-*- #@author:wklken@yeah.net #@version:0.1 #@date:2012-08-25 #@desc:python学习线路 step defread(book=<<AByteofPython>>)#网上先过一遍 if没兴趣: return else: if没编程基础: <<HeadFirstPython>> ifneedpy2.x: <<Python核心技术>> elifpy2.xandpy3k: <<LearningPython>> ifyouwant:#可选 <<PythonTutorial>> ifyouhavemoretimeandenergy: <<可爱的Python>> <<ProgrammingPython>> print"Info:基本入门了" ifyouwantgofarther: ifTrue:#强烈建议 <<DiveIntoPython>> <<Python源码剖析>> <<Python高级编程>>#这个,没读过,自己判定吧 if工作需要: <<Python网络编程>>#网络编程 <<Python在Unix和Linux系统管理中的应用>>#系统管理相关 <<TheDjangoBook>>#web,用到django框架的 <<Djangoweb开发指南>>#同上 <<集体智慧编程>>#算法工程师,or个人爱好 <<Python自然语言处理>> ifyouwanttosearchforsomethinguseful: <<PythonstandardLibrary>> <<Pythoncookbook>> or 向Python女神推荐这些年我追过的经典书籍 or Linux运维人员如何学习python编程 or Python|绝不乱入的靠谱书单 以看过的书例子为总结 本文转自 liqius 51CTO博客,原文链接:http://blog.51cto.com/szgb17/1844823,如需转载请自行联系原作者

优秀的个人博客,低调大师

Python的类方法

1 down vote I used to work with PHP and recently I was asking myself, whats going on with this classmethod? Python manual is very technical and very short in words so it wont help with understanding that feature. I was googling and googling and I found answer ->http://code.anjanesh.net/2007/12/python-classmethods.html. If you are lazy to click it. My explanation is shorter and below. :) in PHP (maybe not all of you know PHP, but this language is so straight forward that everybody should understand what I'm talking about) we have static variables like this: class A{ static protected $inner_var = null; static public function echoInnerVar() { echo self::$inner_var."\n"; } static public function setInnerVar($v) { self::$inner_var = $v; }}class B extends A{} A::setInnerVar(10); B::setInnerVar(20); A::echoInnerVar(); B::echoInnerVar(); The output will be in both cases 20. However in python we can add @classmethod decorator and thus it is possible to have output 10 and 20 respectively. Example: class A(object): inner_var = 0 @classmethod def setInnerVar(cls, value): cls.inner_var = value @classmethod def echoInnerVar(cls): print cls.inner_varclass B(A): pass A.setInnerVar(10) B.setInnerVar(20) A.echoInnerVar() B.echoInnerVar() Smart, ain't? 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/archive/2011/07/04/2097646.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop单机部署方法

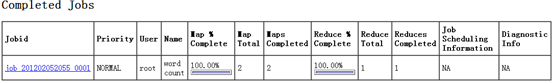
安装Java JDK: 到sun网站上下载jdk chmod +x jdk-6u30-linux-x64.bin ./jdk-6u30-linux-x64.bin 下载Hadoop wgethttp://labs.renren.com/apache-mirror/hadoop/common/hadoop-0.20.205.0/hadoop-0.20.205.0.tar.gz tar zxvf hadoop-0.20.205.0.tar.gz 安装必要软件 yum install ssh rsync 修改配置文件 conf/core-site.xml: <configuration> <property> <name>fs.default.name</name> <value>hdfs://localhost:9000</value> </property> </configuration> conf/hdfs-site.xml: <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> conf/mapred-site.xml: <configuration> <property> <name>mapred.job.tracker</name> <value>localhost:9001</value> </property> </configuration> conf/hadoop-env.sh export JAVA_HOME=/root/jdk1.6.0_30 bin/hadoop 以root用户运行会报-jvm参数不存在的错误,故将 if [[ $EUID -eq 0 ]]; then HADOOP_OPTS="$HADOOP_OPTS -jvm server $HADOOP_DATANODE_OPTS" else HADOOP_OPTS="$HADOOP_OPTS -server $HADOOP_DATANODE_OPTS" fi 修改为 elif [ "$COMMAND" = "datanode" ] ; then CLASS='org.apache.hadoop.hdfs.server.datanode.DataNode' HADOOP_OPTS="$HADOOP_OPTS -server $HADOOP_DATANODE_OPTS" SSH设置 $ ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa$ cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 启动hadoop $ bin/hadoop namenode -format$ bin/start-all.sh 此时,通过本地的50070和50030端口就可以分别浏览到NameNode和JobTracker: NameNode -http://localhost:50070/ JobTracker -http://localhost:50030/ 测试wordcount 生成测试数据: [root hadoop-0.20.205.0]# mkdir input [root hadoop-0.20.205.0]# echo "hello world" >> input/a.txt [root hadoop-0.20.205.0]# echo "hello hadoop" >> input/b.txt 将本地数据复制到HDFS中: [root hadoop-0.20.205.0]# bin/hadoop fs -put input in 执行测试任务: [root hadoop-0.20.205.0]# bin/hadoop jar hadoop-examples-0.20.205.0.jar wordcount in out 12/02/05 21:00:47 INFO input.FileInputFormat: Total input paths to process : 2 12/02/05 21:00:48 INFO mapred.JobClient: Running job: job_201202052055_0001 12/02/05 21:00:49 INFO mapred.JobClient: map 0% reduce 0% 12/02/05 21:01:07 INFO mapred.JobClient: map 100% reduce 0% 12/02/05 21:01:19 INFO mapred.JobClient: map 100% reduce 100% 12/02/05 21:01:24 INFO mapred.JobClient: Job complete: job_201202052055_0001 12/02/05 21:01:24 INFO mapred.JobClient: Counters: 29 12/02/05 21:01:24 INFO mapred.JobClient: Job Counters 12/02/05 21:01:24 INFO mapred.JobClient: Launched reduce tasks=1 12/02/05 21:01:24 INFO mapred.JobClient: SLOTS_MILLIS_MAPS=22356 12/02/05 21:01:24 INFO mapred.JobClient: Total time spent by all reduces waiting after reserving slots (ms)=0 12/02/05 21:01:24 INFO mapred.JobClient: Total time spent by all maps waiting after reserving slots (ms)=0 12/02/05 21:01:24 INFO mapred.JobClient: Launched map tasks=2 12/02/05 21:01:24 INFO mapred.JobClient: Data-local map tasks=2 12/02/05 21:01:24 INFO mapred.JobClient: SLOTS_MILLIS_REDUCES=10801 12/02/05 21:01:24 INFO mapred.JobClient: File Output Format Counters 12/02/05 21:01:24 INFO mapred.JobClient: Bytes Written=25 12/02/05 21:01:24 INFO mapred.JobClient: FileSystemCounters 12/02/05 21:01:24 INFO mapred.JobClient: FILE_BYTES_READ=55 12/02/05 21:01:24 INFO mapred.JobClient: HDFS_BYTES_READ=235 12/02/05 21:01:24 INFO mapred.JobClient: FILE_BYTES_WRITTEN=64345 12/02/05 21:01:24 INFO mapred.JobClient: HDFS_BYTES_WRITTEN=25 12/02/05 21:01:24 INFO mapred.JobClient: File Input Format Counters 12/02/05 21:01:24 INFO mapred.JobClient: Bytes Read=25 12/02/05 21:01:24 INFO mapred.JobClient: Map-Reduce Framework 12/02/05 21:01:24 INFO mapred.JobClient: Map output materialized bytes=61 12/02/05 21:01:24 INFO mapred.JobClient: Map input records=2 12/02/05 21:01:24 INFO mapred.JobClient: Reduce shuffle bytes=61 12/02/05 21:01:24 INFO mapred.JobClient: Spilled Records=8 12/02/05 21:01:24 INFO mapred.JobClient: Map output bytes=41 12/02/05 21:01:24 INFO mapred.JobClient: CPU time spent (ms)=2900 12/02/05 21:01:24 INFO mapred.JobClient: Total committed heap usage (bytes)=398852096 12/02/05 21:01:24 INFO mapred.JobClient: Combine input records=4 12/02/05 21:01:24 INFO mapred.JobClient: SPLIT_RAW_BYTES=210 12/02/05 21:01:24 INFO mapred.JobClient: Reduce input records=4 12/02/05 21:01:24 INFO mapred.JobClient: Reduce input groups=3 12/02/05 21:01:24 INFO mapred.JobClient: Combine output records=4 12/02/05 21:01:24 INFO mapred.JobClient: Physical memory (bytes) snapshot=422445056 12/02/05 21:01:24 INFO mapred.JobClient: Reduce output records=3 12/02/05 21:01:24 INFO mapred.JobClient: Virtual memory (bytes) snapshot=1544007680 12/02/05 21:01:24 INFO mapred.JobClient: Map output records=4 查看结果: [root hadoop-0.20.205.0]# bin/hadoop fs -cat out/* hadoop1 hello2 world1 cat: File does not exist: /user/root/out/_logs 将结果从HDFS复制到本地并查看: [root hadoop-0.20.205.0]# bin/hadoop fs -get out output [root hadoop-0.20.205.0]# cat output/* cat: output/_logs: Is a directory hadoop1 hello2 world1 此时,从JobTracker网页中也可以看到任务的执行情况: 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2012/02/05/2339311.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

更新image的方法

1. 修改container 1.1 执行 docker images 查看目前的所有images: REPOSITORY TAG IMAGE ID CREATED SIZEgenc live 95ed4f9b6d6f 7 months ago 377.4 MBregis 2.4.1 75ff0430d99d 8 months ago 171.5 MBetcd live dd21aa9378c5 13 months ago 687.4 MB 1.2 假如要修改genc, 记录genc的IMAGE ID “95ed4f9b6d6f” , 然后执行 docker run -it 95ed4f9b6d6f bash 启动一个container root@28ffcf397fc6:/# 28ffcf397fc6是container的ID, 记录它, 后面有用。 1.3 在container中进行修改,例如,安装vim指令 root@28ffcf397fc6:/# yum -y install vim 然后执行exit退出container. 1.4 执行 docker commit -m "修改描述信息" -a "作者姓名" \containerId repository_name:TAG containerId就是1.2中记录的28ffcf397fc6。repository_name 和 TAG都是自己起的名字。 执行之后就会有新的image生成。 1.5 如果要放到仓库(例如registry)中, 执行 docker push repository_name:TAG 2. docker file 2.1 执行 mkdir test cd test touch DockerFile 执行vim DockerFile,修改 DockerFile 的内容为: FROM imageID MAINTAINER aa<aa@163.com> RUN yum -y install vim imageID为基础的镜像id; MAINTAINER指定作者和邮箱; RUN 是运行的要更新的信息。 2.2 执行 docker build -t aa/repository_name:TAG build镜像。 2.3 执行 docker images 可以看到新的镜像 。

优秀的个人博客,低调大师

Hive MetaStore同步方法

我们知道,Hive在方便的用SQL方式管理Hadoop的数据的时候,使用了MetaStore来保存所有表的信息,例如表名,字段名,类型,分隔符,序列化的方式等等。当我们使用OSS作为我们的数据存储的时候,我们会创建很多的外表,例如 CREATE EXTERNAL TABLE page_view(viewTime INT, userid BIGINT, page_url STRING, referrer_url STRING, ip STRING COMMENT 'IP Address of the User') COMMENT 'This is the page view table' PARTITIONED BY(dt STRING, country STRING) LOCATION 'OSS://buc

优秀的个人博客,低调大师

HBase集群安装方法

注意HBase与Hadoop兼容性问题 安装jdk aptitude install openjdk-7-jdk 创建hbase用户 for i in AP-HB1 AP-HB2 AP-HB3; do echo =====$i=====; ssh $i "groupadd hbase; useradd -m hbase -g hbase -s /bin/bash -d /home/hbase; passwd hbase"; done 创建HDFS存储目录 for i in AP-HB1 AP-HB2 AP-HB3; do ssh $i "mkdir -p /data/HadoopData/; chown -R hbase:hbase /data/HadoopData"; done 安装HDFS 解压hadoop tar zxf ~/hadoop-1.2.1-bin.tar.gz 配置hadoop-env.sh(指定JAVA_HOME) export JAVA_HOME=/usr/lib/jvm/java-7-openjdk-amd64/ 配置core-site.xml <property> <name>hadoop.tmp.dir</name> <value>/data/HadoopData/tmp</value> </property> <property> <name>fs.default.name</name> <value>hdfs://AP-HB1:9000</value> </property> 配置conf/hdfs-site.xml <property> <name>dfs.name.dir</name> <value>/data/HadoopData/dfs/name/</value> </property> <property> <name>dfs.data.dir</name> <value>/data/HadoopData/dfs/data/</value> </property> <property> <name>dfs.replication</name> <value>3</value> </property> <property> <name>dfs.permissions</name> <value>false</value> </property> 配置masters(指定SecondaryNameNode机器) 配置slaves(指定DataNode机器) 安装HBase 解压HBase tar zxf ~/hbase-0.98.12-hadoop1-bin.tar.gz 配置hbase-env.sh(指定JAVA_HOME) export JAVA_HOME=/usr/lib/jvm/java-7-openjdk-amd64/ 配置hdfs-site.xml <property> <name>hbase.rootdir</name> <value>hdfs://AP-HB1:9000/hbase</value> </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.master</name> <value>AP-HB1:60000</value> </property> <property> <name>hbase.zookeeper.property.dataDir</name> <value>/data/HadoopData/zookeeper</value> </property> <property> <name>hbase.zookeeper.quorum</name> <value>AP-HB1,AP-HB2,AP-HB3</value> </property> <property> <name>hbase.regionserver.export.thrift</name> <value>true</value> </property> <property> <name>hbase.regionserver.thrift.port</name> <value>9091</value> </property> 配置regionservers AP-HB1 AP-HB2 AP-HB3 复制程序到所有机器 cd /opt; chown hbase.hbase hadoop-1.2.1 hbase-0.98.12-hadoop1 -R for i in AP-HB2 AP-HB3;do rsync -av /opt/hadoop-1.2.1 /opt/hbase-0.98.12-hadoop1 $i:/opt/; done 设置ssh免密登录 for i in AP-HB1 AP-HB2 AP-HB3;do ssh $i "mkdir /home/hbase/.ssh; ssh-keygen -t rsa -P '' -f /home/hbase/.ssh/id_rsa; chown hbase.hbase /home/hbase/.ssh -R"; done for i in AP-HB2 AP-HB3;do ssh $i "cat /home/hbase/.ssh/authorized_keys";done >> /home/hbase/.ssh/authorized_keys for i in AP-HB2 AP-HB3;do scp /home/hbase/.ssh/authorized_keys $i:/home/hbase/.ssh/;done 开启HDFS服务 cd /opt/hadoop-1.2.1; bin/start-dfs.sh 开启HBase服务 cd /opt/hbase-0.98.12-hadoop1; bin/start-hbase.sh Troubleshooting 2015-05-19 16:48:34,815 ERROR org.apache.hadoop.metrics2.impl.MetricsSystemImpl: Error getting localhost name. Using 'localhost'...hadoop要使用hostname,需要修改hostname与配置文件一致,修改hostname hostname $hostname cat $hostname > /etc/hostname 2015-05-19 17:40:00,771 FATAL [AP-HB1:16020.activeMasterManager] master.HMaster: Unhandled exception. Starting shutdown. java.io.IOException: Failed on local exception: java.io.IOException: Broken pipe; Host Details : local host is: "AP-HB1/10.162.50.249"; destination host is: "AP-HB1":9000;注意HBase与Hadoop版本兼容性问题

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册