Hadoop、Hbase完全分布式搭建
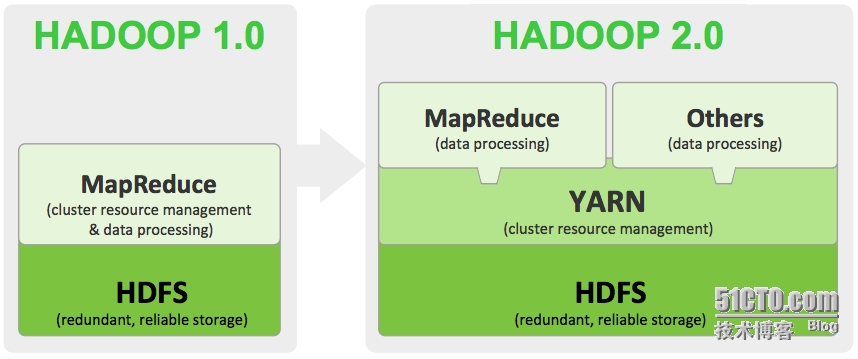
一、Hadoop1.0到2.0的架构变化 1、Hadoop 2.0由HDFS、MapReduce和YARN三个分支构成 2、HDFSNN Federation、HA 3、MapReduce运行在YARN上的MR 4、YARN资源管理系统 二、HDFS 2.0 1、解决HDFS 1.0中单点故障和内存受限问题。 2、解决单点故障 HDFS HA通过主备NameNode解决 如果主NameNode发生故障则切换到备NameNode上 3、解决内存受限问题 HDFS Federation(联邦) 水平扩展支持多个NameNode 每个NameNode分管一部分目录 所有NameNode共享所有DataNode存储资 4、仅是架构上发生了变化使用方式不变 对HDFS使用者透明 HDFS 1.0中的命令和API仍可以使用$ hadoop fs -ls /user/hadoop/$ hadoop fs -mkdir /user/hadoop/data 三、HDFS 2.0 HA 1、主备NameNode 2、解决单点故障 主NameNode对外提供服务备NameNode同步主NameNode元数据以待切换 所有DataNode同时向两个NameNode汇报数据块信息 3、两种切换选择 手动切换通过命令实现主备之间的切换可以用HDFS升级等场合 自动切换基于Zookeeper实现 4、基于Zookeeper自动切换方案 Zookeeper Failover Controller监控NameNode健康状态并向Zookeeper注册NameNode NameNode挂掉后ZKFC为NameNode竞争锁获得ZKFC 锁的NameNode变为active 四、环境搭建 192.168.1.2 master 192.168.1.3 slave1 192.168.1.4 slave2 Hadoop versionhadoop-2.2.0.tar.gz Hbase versionhbase-0.98.11-hadoop2-bin.tar.gz Zookeeper versionzookeeper-3.4.5.tar.gz JDK versionjdk-7u25-linux-x64.gz 1、主机HOSTS文件配置 1 2 3 4 5 6 7 8 9 10 11 12 [root@master~] #cat/etc/hosts 192.168.1.2master 192.168.1.3slave1 192.168.1.4slave2 [root@slave1~] #cat/etc/hosts 192.168.1.2master 192.168.1.3slave1 192.168.1.4slave2 [root@slave2~] #cat/etc/hosts 192.168.1.2master 192.168.1.3slave1 192.168.1.4slave2 2、配置节点之间互信 1 2 3 4 5 6 7 8 9 10 [root@master~] #useraddhadoop [root@slave1~] #useraddhadoop [root@slave2~] #useraddhadoop [root@master~] #passwdhadoop [root@slave1~] #passwdhadoop [root@slave2~] #passwdhadoop [root@master~] #su-hadoop [hadoop@master~]$ ssh -copy- id -i~/. ssh /id_rsa .pubslave1 [hadoop@master~]$ ssh -copy- id -i~/. ssh /id_rsa .pubslave2 [hadoop@master~]$ ssh -copy- id -i~/. ssh /id_rsa .pubmaster 3、JDK环境配置 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@master~] #tarjdk-7u25-linux-x64.gz [root@master~] #mkdir/usr/java [root@master~] #mvjdk-7u25-linux-x64.gz/usr/java [root@master~] #cd/usr/java/ [root@masterjava] #ln-sjdk1.7.0_25jdk #修改/etc/profile,添加 export JAVA_HOME= /usr/java/jdk export CLASSPATH=$CLASSPATH:$JAVA_HOME /lib :$JAVA_HOME /jre/lib export PATH= /usr/java/jdk/bin :$PATH [root@master~] #source/etc/profile [root@master~] #java-version javaversion "1.7.0_25" Java(TM)SERuntimeEnvironment(build1.7.0_25-b15) JavaHotSpot(TM)64-BitServerVM(build23.25-b01,mixedmode) #slave1,slave2同样操作 4.Hadoop安装 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 [root@master~] #tarzxvfhadoop-2.2.0.tar.gz [root@master~] #mvhadoop-2.2.0/home/hadoop/ [root@master~] #cd/home/hadoop/ [root@masterhadoop] #ln-shadoop-2.2.0hadoop [root@masterhadoop] #chown-Rhadoop.hadoop/home/hadoop/ [root@master~] #cd/home/hadoop/hadoop/etc/hadoop #修改hadoop-env.sh文件 export JAVA_HOME= /usr/java/jdk export HADOOP_HEAPSIZE=200 #修改mapred-env.sh文件 export JAVA_HOME= /usr/java/jdk export HADOOP_JOB_HISTORYSERVER_HEAPSIZE=1000 #修改yarn-env.sh文件 export JAVA_HOME= /usr/java/jdk JAVA_HEAP_MAX=-Xmx300m YARN_HEAPSIZE=100 #修改core-site.xml文件 <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //master :9000< /value > < /property > <property> <name>hadoop.tmp. dir < /name > <value> /home/hadoop/tmp < /value > < /property > <property> <name>hadoop.proxyuser.hadoop.hosts< /name > <value>*< /value > < /property > <property> <name>hadoop.proxyuser.hadoop. groups < /name > <value>*< /value > < /property > < /configuration > #修改hdfs-site.xml文件 <configuration> <property> <name>dfs.namenode.secondary.http-address< /name > <value>master:9001< /value > < /property > <property> <name>dfs.namenode.name. dir < /name > <value> /home/hadoop/dfs/name < /value > < /property > <property> <name>dfs.datanode.data. dir < /name > <value> /home/hadoop/dfs/data < /value > < /property > <property> <name>dfs.replication< /name > <value>2< /value > < /property > <property> <name>dfs.webhdfs.enabled< /name > <value> true < /value > < /property > < /configuration > #修改mapred-site.xml文件 <configuration> <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <name>mapreduce.jobhistory.address< /name > <value>master:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>master:19888< /value > < /property > <property> <name>mapreduce.map.memory.mb< /name > <value>512< /value > < /property > <property> <name>mapreduce.map.cpu.vcores< /name > <value>1< /value > < /property > <property> <name>mapreduce.reduce.memory.mb< /name > <value>512< /value > < /property > < /configuration > #修改yarn-site.xml文件 <configuration> <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class< /name > <value>org.apache.hadoop.mapred.ShuffleHandler< /value > < /property > <property> <name>yarn.resourcemanager.address< /name > <value>master:8032< /value > < /property > <property> <name>yarn.resourcemanager.scheduler.address< /name > <value>master:8030< /value > < /property > <property> <name>yarn.resourcemanager.resource-tracker.address< /name > <value>master:8031< /value > < /property > <property> <name>yarn.resourcemanager.admin.address< /name > <value>master:8033< /value > < /property > <property> <name>yarn.resourcemanager.webapp.address< /name > <value>master:8088< /value > < /property > <property> <name>yarn.scheduler.minimum-allocation-mb< /name > <value>100< /value > < /property > <property> <name>yarn.scheduler.maximum-allocation-mb< /name > <value>200< /value > < /property > <property> <name>yarn.scheduler.minimum-allocation-vcores< /name > <value>1< /value > < /property > <property> <name>yarn.scheduler.maximum-allocation-vcores< /name > <value>2< /value > < /property > < /configuration > #修改slaves文件 slave1 slave2 #修改/home/hadoop/.bashrc export HADOOP_DEV_HOME= /home/hadoop/hadoop export PATH=$PATH:$HADOOP_DEV_HOME /bin export PATH=$PATH:$HADOOP_DEV_HOME /sbin export HADOOP_MAPARED_HOME=${HADOOP_DEV_HOME} export HADOOP_COMMON_HOME=${HADOOP_DEV_HOME} export HADOOP_HDFS_HOME=${HADOOP_DEV_HOME} export YARN_HOME=${HADOOP_DEV_HOME} export HADOOP_CONF_DIR=${HADOOP_DEV_HOME} /etc/hadoop export HDFS_CONF_DIR=${HADOOP_DEV_HOME} /etc/hadoop export YARN_CONF_DIR=${HADOOP_DEV_HOME} /etc/hadoop #将上面修改的文件全部传送到slave1,slave2节点 5、在master节点上启动hdfs 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 [hadoop@master~]$ cd /home/hadoop/hadoop/sbin/ [hadoop@mastersbin]$. /start-dfs .sh 15 /03/21 00:49:35WARNutil.NativeCodeLoader:Unabletoloadnative-hadooplibrary for yourplatform...using builtin -javaclasseswhereapplicable Startingnamenodeson[master] master:startingnamenode,loggingto /home/hadoop/hadoop-2 .2.0 /logs/hadoop-hadoop-namenode-master .out slave2:startingdatanode,loggingto /home/hadoop/hadoop-2 .2.0 /logs/hadoop-hadoop-datanode-slave2 .out slave1:startingdatanode,loggingto /home/hadoop/hadoop-2 .2.0 /logs/hadoop-hadoop-datanode-slave1 .out Startingsecondarynamenodes[master] master:startingsecondarynamenode,loggingto /home/hadoop/hadoop-2 .2.0 /logs/hadoop-hadoop-secondarynamenode-master .out #查看进程 [hadoop@master~]$jps 39093Jps 38917SecondaryNameNode 38767NameNode [root@slave1~] #jps 2463Jps 2379DataNode [root@slave2~] #jps 2463Jps 2379DataNode #启动jobhistory [hadoop@mastersbin]$mr-jobhistory-daemon.shstarthistoryserver startinghistoryserver,loggingto /home/hadoop/hadoop-2 .2.0 /logs/mapred-hadoop-historyserver-master .out 6、启动yarn 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 [hadoop@master~]$ cd /home/hadoop/hadoop/sbin/ [hadoop@mastersbin]$. /start-yarn .sh startingyarndaemons startingresourcemanager,loggingto /home/hadoop/hadoop-2 .2.0 /logs/yarn-hadoop-resourcemanager-master .out slave2:startingnodemanager,loggingto /home/hadoop/hadoop-2 .2.0 /logs/yarn-hadoop-nodemanager-slave2 .out slave1:startingnodemanager,loggingto /home/hadoop/hadoop-2 .2.0 /logs/yarn-hadoop-nodemanager-slave1 .out #查看进程 [hadoop@mastersbin]$jps 39390Jps 38917SecondaryNameNode 39147ResourceManager 38767NameNode [hadoop@slave1~]$jps 2646Jps 2535NodeManager 2379DataNode [hadoop@slave2~]$jps 8261Jps 8150NodeManager 8004DataNode 7、查看hdfs文件系统 1 2 3 4 5 [hadoop@mastersbin]$hadoopfs- ls / 15 /03/21 15:56:05WARNutil.NativeCodeLoader:Unabletoloadnative-hadooplibrary for yourplatform...using builtin -javaclasseswhereapplicable Found2items drwxr-xr-x-hadoopsupergroup02015-03-2017:46 /hbase drwxrwx----hadoopsupergroup02015-03-2016:56 /tmp 8、安装Zookeeper 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 [root@master~] #tarzxvfzookeeper-3.4.5.tar.gz-C/home/hadoop/ [root@master~] #cd/home/hadoop/ [root@masterhadoop] #ln-szookeeper-3.4.5zookeeper [root@masterhadoop] #chown-Rhadoop.hadoop/home/hadoop/zookeeper [root@masterhadoop] #cdzookeeper/conf/ [root@masterconf] #cpzoo_sample.cfgzoo.cfg #修改zoo.cfg dataDir= /home/hadoop/zookeeper/data dataLogDir= /home/hadoop/zookeeper/logs server.1=192.168.1.2:7000:7001 server.2=192.168.1.3:7000:7001 server.3=192.168.1.4:7000:7001 #在slave1,slave2执行相同的操作 [hadoop@masterconf] #cd/home/hadoop/zookeeper/data/ [hadoop@masterdata] #echo1>myid [hadoop@slave1data] #echo2>myid [hadoop@slave2data] #echo3>myid #启动zookeeper [hadoop@master~]$ cd zookeeper /bin/ [hadoop@masterbin]$. /zkServer .shstart [hadoop@slave1~]$ cd zookeeper /bin/ [hadoop@slave1bin]$. /zkServer .shstart [hadoop@slave2~]$ cd zookeeper /bin/ [hadoop@slave2bin]$. /zkServer .shstart 9、Hbase安装 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 [root@master~] #tarzxvfhbase-0.98.11-hadoop2-bin.tar.gz-C/home/hadoop/ [root@master~] #cd/home/hadoop/ [root@masterhadoop] #ln-shbase-0.98.11-hadoop2hbase [root@masterhadoop] #chown-Rhadoop.hadoop/home/hadoop/hbase [root@masterhadoop] #cd/home/hadoop/hbase/conf/ #修改hbase-env.sh文件 export JAVA_HOME= /usr/java/jdk export HBASE_HEAPSIZE=50 #修改hbase-site.xml文件 <configuration> <property> <name>hbase.rootdir< /name > <value>hdfs: //master :9000 /hbase < /value > < /property > <property> <name>hbase.cluster.distributed< /name > <value> true < /value > < /property > <property> <name>hbase.zookeeper.property.clientPort< /name > <value>2181< /value > < /property > <property> <name>hbase.zookeeper.quorum< /name > <value>master,slave1,slave2< /value > < /property > < /configuration > #修改regionservers文件 slave1 slave2 #将上面修改的文件传送到slave1,slave2 10、在master上面启动Hbase 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 [hadoop@master~]$ cd hbase /bin/ [hadoop@masterbin]$. /start-hbase .sh master:startingzookeeper,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-zookeeper-master .out slave1:startingzookeeper,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-zookeeper-slave1 .out slave2:startingzookeeper,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-zookeeper-slave2 .out startingmaster,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-master-master .out slave1:startingregionserver,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-regionserver-slave1 .out slave2:startingregionserver,loggingto /home/hadoop/hbase/bin/ .. /logs/hbase-hadoop-regionserver-slave2 .out #查看进程 [hadoop@masterbin]$jps 39532QuorumPeerMain 38917SecondaryNameNode 39147ResourceManager 39918HMaster 38767NameNode 40027Jps [hadoop@slave1data]$jps 3021HRegionServer 3133Jps 2535NodeManager 2379DataNode 2942HQuorumPeer [hadoop@slave2~]$jps 8430HRegionServer 8351HQuorumPeer 8150NodeManager 8558Jps 8004DataNode #验证 [hadoop@masterbin]$. /hbase shell 2015-03-2116:11:44,534INFO[main]Configuration.deprecation:hadoop.native.libisdeprecated.Instead,useio.native.lib.available HBaseShell;enter 'help<RETURN>' for listofsupportedcommands. Type "exit<RETURN>" toleavetheHBaseShell Version0.98.11-hadoop2,r6e6cf74c1161035545d95921816121eb3a516fe0,TueMar300:23:49PST2015 hbase(main):001:0>list TABLE SLF4J:ClasspathcontainsmultipleSLF4Jbindings. SLF4J:Foundbinding in [jar: file : /home/hadoop/hbase-0 .98.11-hadoop2 /lib/slf4j-log4j12-1 .6.4.jar! /org/slf4j/impl/StaticLoggerBinder .class] SLF4J:Foundbinding in [jar: file : /home/hadoop/hadoop-2 .2.0 /share/hadoop/common/lib/slf4j-log4j12-1 .7.5.jar! /org/slf4j/impl/StaticLoggerBinder .class] SLF4J:Seehttp: //www .slf4j.org /codes .html #multiple_bindingsforanexplanation. 2015-03-2116:11:56,499WARN[main]util.NativeCodeLoader:Unabletoloadnative-hadooplibrary for yourplatform...using builtin -javaclasseswhereapplicable 0row(s) in 1.9010seconds =>[] 11、查看集群状态 HDFS UIhttp://192.168.1.2:50070/dfshealth.jsp YARN UIhttp://192.168.1.2:8088/cluster jobhistory UIhttp://192.168.1.2:19888/jobhistory HBASE UIhttp://192.168.1.2:60010/master-status 本文转自ljl_19880709 51CTO博客,原文链接:http://blog.51cto.com/luojianlong/1622823,如需转载请自行联系原作者