首页 文章 精选 留言 我的

精选列表

搜索[零点击],共10000篇文章
优秀的个人博客,低调大师

「从零单排canal 06」 instance模块源码解析

基于1.1.5-alpha版本,具体源码笔记可以参考我的github:https://github.com/saigu/JavaKnowledgeGraph/tree/master/code_reading/canal 关于instance的定义,可以参考前面的几篇源码解析,介绍的非常清楚。 instance模块比较简单,我们重点了解以下几个问题 instance配置模式有哪几种,如何根据配置创建instance? 远端配置如何覆盖本地配置的? instance实例内部有哪些组件? 1.基本结构 instance模块下面也分为三个子模块,core、manager、spring。 其中,core是instance的核心逻辑 。 而manager和spring只是两种不同的instance配置读取方式,manager通过http请求读取admin的配置,spring通过配置文件的方式读取。 主要控制逻辑我们在deployer模块源码分析中提到过,就是在CanalController类 的instanceGenerator,配置参数是canal.instance.global.mode 根据destination创建config 如果canal.instance.global.mode = manager,就使用PlainCanalInstanceGenerator 如果canal.instance.global.mode = spring,就使用SpringCanalInstanceGenerator 源码如下 2.core子模块 代码不多,就两个接口,两个类。 2.1 CanalInstanceGenerator接口 这个接口只有一个方法 具体实现就是开头提到的两种,PlainCanalInstanceGenerator和SpringCanalInstanceGenerator,分别在manager子模块和spring子模块中实现。 具体选择就是开头的那个canalController里面根据canal.instance.global.mode来选择。 2.2 CanalInstance接口 先看一张官方文档的图,这个前面的文章已经分析过了。 server代表一个canal-server运行实例,对应于一个jvm。server内部可以有多个instance。 Instance内部有4个主要组件: eventParser :数据源接入,模拟slave协议和master进行交互,协议解析 eventSink :Parser和Store连接器,进行数据过滤,加工,分发的工作 eventStore :数据存储 metaManager:增量订阅&消费信息管理器 在这个接口中,就定义了获取4个组件的方法,以及新版本增加的mqProducer的配置信息(mqProducer在server模块解析中介绍过了,可以回头去看看) 我们简单看下4个组件接口的各个实现类。 CanalEventParser接口实现类(paser模块): MysqlEventParser:伪装成单个mysql实例的slave解析binglog日志 GroupEventParser:伪装成多个mysql实例的slave解析binglog日志。内部维护了多个CanalEventParser,组合多个EventParser进行合并处理,group只是作为一个delegate处理。主要应用场景是分库分表:比如一个大表拆分了4个库,位于不同的mysql实例上,正常情况下,我们需要配置四个CanalInstance。对应的,业务上要消费数据时,需要启动4个客户端,分别链接4个instance实例。为了方便业务使用,此时我们可以让CanalInstance引用一个GroupEventParser,由GroupEventParser内部维护4个MysqlEventParser去4个不同的mysql实例去拉取binlog,最终合并到一起。此时业务只需要启动1个客户端,链接这个CanalInstance即可 LocalBinlogEventParser:解析本地的mysql binlog。例如将mysql的binlog文件拷贝到canal的机器上进行解析。 RdsLocalBinlogEventParser:基于阿里云rds的binlog备份文件复制,下载到本地后进行本地的binlog解析。 CanalEventSink接口实现类(sink模块): EntryEventSink:普通的单个parser的sink操作,进行数据过滤,加工,分发 GroupEventSink:用于分库分表的场景,对应GroupEventParser的数据解析,然后实现基于归并排序的sink处理 CanalEventStore接口实现类(store模块): MemoryEventStoreWithBuffer:基于内存实现存储store CanalMetaManager(meta模块): ZooKeeperMetaManager:将元数据存存储到zk中 MemoryMetaManager:将元数据存储到内存中 MixedMetaManager:组合memory + zookeeper的使用模式 PeriodMixedMetaManager:基于定时刷新的策略的mixed实现 FileMixedMetaManager:先写内存,然后定时刷新数据到File 关于这些实现的具体细节,我们在相应模块的源码分析时,进行讲解。目前只需要知道,一些组件有多种实现,因此组合工作方式有多种。 2.3 AbstractCanalInstance类 AbstractCanalInstance是canalInstance的抽象类,维护了相关组件的引用。 同时,也实现了canalInstance接口的subscribeChange方法。 这个抽象类有两个实现,CanalInstanceWithManager 和 CanalInstanceWithSpring。 AbstractCanalInstance的初始化过程都是在实现类中完成的。 如果选择admin控制模式,那就是在CanalInstanceWithManager中完成;如果是spring模式,就在CanalInstanceWithSpring中完成。 这里有个小发现: 仔细看下实际代码调用我们发现,CanalInstanceWithManager是给ManagerCanalInstanceGenerator使用的,而这个generator实际上没有被使用到。如果使用admin模式,本文开头我们就看到了,使用了PlainCanalInstanceGenerator。PlainCanalInstanceGenerator里面的generate方法实现,其实跟SpringCanalInstanceGenerator差不多。就是从远端admin拉到配置,然后替换系统变量,然后再从spring的beanfactory中构建具体的实例。 2.3.1 subscribeChange() 方法 AbstractCanalInstance类实现了CanalInstance接口的subscribeChange方法。 我们看到,如果订阅关系发生变化,就做一些操作,这里看的话,主要就是更新了一下filter。 filter规定了需要订阅哪些库,哪些表。 2.3.2 start() 方法 启动没什么特别的逻辑,就是按照顺序依次启动各个组件。 顺序为 metaManager -> alarmHandler -> eventStore -> eventSink -> eventParser。 启动顺序主要跟依赖关系有关,元信息相关的管理跟所有都有关,所以metaManager最先启动,其他的按照彼此之间的关系一一启动。 这里我们发现,在启动eventParser的时候做了特殊处理,分别是beforeStartEventParser 和 afterStartEventParser。我们在2.3.4专门讲一下。 2.3.3 stop()方法 stop也没什么特殊的,就是依次关闭各个组件。 关闭的顺序就是start的逆过程。 这里就不贴代码了。 2.3.4 eventParserr的特殊处理 在start和stop方法中的eventParser前后都有特殊的处理,start的beforeStartEventParser 和 afterStartEventParser,Stop的beforeStopEventParser 和 afterStopEventParser。 这个其实跟eventParser的设计有关。 EventParser 设计 每个EventParser都会关联两个内部组件 CanalLogPositionManager : 记录binlog 最后一次解析成功位置信息,主要是描述下一次canal启动的位点 CanalHAController: 控制 EventParser 的链接主机管理,判断当前该链接哪个mysql数据库 所以这两个beforexxx、afterxxxx方法做的主要是CanalLogPositionManager和CanalHAController的启停工作。 2.3.5 AbstractCanalInstance类 总结 可以看到AbstractCanalInstance除了负责启动和停止其内部组件,就没有其他工作了。 eventParser在AbstractCanalInstance中启动后,就会自行开启多线程任务dump数据,通过eventSink投递给eventStore。 而对eventStore的操作逻辑,实际上都是在CanalServerWithEmbedded中完成的,我们可以回顾一下CanalServerWithEmbedded中 getWithoutAck( ) 的相关逻辑。 包括: 根据clientIdentity的destination获取对应的instance 获取到流式数据中的最后一批获取的位置positionRanges(跟batchId有关联,就是上面那个map里面的) 从cananlEventStore里面获取binlog,转化为event。一般是从最后的一个batchId位置开始,如果之前没有batchId,那么就从cursor记录的消费位点开始;如果cursor为空,那只能从eventStore的第一条消息开始。(这里几个位置关系再想一想,跟ack有关,画个图) event转化为entry,并生成新的batchId,组合成message返回给客户端 所以,其实这里只是简单的启动和停止,组件的交互逻辑是在CanalServerWithEmbedded中get出instance的各个组件来进行实现的。 3.spring模块 前面提到了,PlainCanalInstanceGenerator里面的generate方法实现,其实跟SpringCanalInstanceGenerator差不多。就是从远端admin拉到配置,然后替换系统变量,然后再从spring的beanfactory中构建具体的实例。 所以我们重点关注spring子模块的配置方式即可。 就下面四个类 3.1 CanalInstanceWithSpring类 基于spring容器启动canal实例,方便独立于manager启动。 继承了AbstractCanalInstance,其实就是一系列组件的setter方法,就不贴源码了。 具体配置是基于spring的xml来做的. 当我们配置加载方式为spring时,创建的CanalInstance实例类型都是CanalInstanceWithSpring。canal将会寻找本地的spring配置文件来创建instance实例。canal默认提供了以下几种spring配置文件: spring/memory-instance.xml spring/file-instance.xml spring/default-instance.xml spring/group-instance.xml 四个配置文件中,对CanalInstanceWithSpring都采用了同样的配置方式: 当然,具体每个组件的ref在不同配置文件中有所不同。 最主要的就是metaManager 和eventParser 这两个配置有所不同,可能在内存、文件或zk进行存储。 eventStore 、和eventSink 定义都是相同的,eventStore目前的开源版本中eventStore只有一种基于内存的实现,eventSink其作用是eventParser和eventStore的连接器,进行数据过滤,加工,分发的工作。不涉及存储,也就没有必要针对内存、file、或者zk进行区分。 3.2 SpringCanalInstanceGenerator类 这个是具体创建instance的逻辑。 顺便看下PlainCanalInstanceGenerator里面的实现,就是多了从远端拉取配置,然后用PropertyPlaceholderConfigurer进行了变量替换,然后还是用beanFactory来获取实例。 com.alibaba.otter.canal.instance.spring.support.PropertyPlaceholderConfigurer继承了org.springframework.beans.factory.config.PropertyPlaceholderConfigurer,设置动态properties,替换掉本地properties。 4.总结 其实这个模块的东西比较少,没有什么特别复杂的逻辑。 我们来回顾下开头的几个问题 instance配置模式有哪几种,如何根据配置创建instance? 主要有基于spring和基于远端配置两种方式,前者的实现在,后者的实现在PlainCanalInstanceGenerator 远端配置如何覆盖本地配置的? PlainCanalInstanceGenerator中使用了spring的PropertyPlaceholderConfigurer来覆盖配置 instance实例内部有哪些组件? 包括了parser、sink、store、metamanager等组件,但是只负责了启动和停止逻辑,具体交互逻辑还是在CanalServerWithEmbedded中实现的。 原创:阿丸笔记(微信公众号:aone_note),欢迎分享,转载请保留出处。 扫描下方二维码可以关注我哦~ 觉得不错,就点个再看吧👇 本文分享自微信公众号 - 阿丸笔记(aone_note)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

生产SparkStreaming数据零丢失最佳实践(含代码)

MySQL创建存储offset的表格 mysql> use test mysql> create table hlw_offset( topic varchar(32), groupid varchar(50), partitions int, fromoffset bigint, untiloffset bigint, primary key(topic,groupid,partitions) ); Maven依赖包 <scala.version>2.11.8</scala.version> <spark.version>2.3.1</spark.version> <scalikejdbc.version>2.5.0</scalikejdbc.version> -------------------------------------------------- <dependency> <groupId>org.scala-lang</groupId> <artifactId>scala-library</artifactId> <version>${scala.version}</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-core_2.11</artifactId> <version>${spark.version}</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-sql_2.11</artifactId> <version>${spark.version}</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-streaming_2.11</artifactId> <version>${spark.version}</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-streaming-kafka-0-8_2.11</artifactId> <version>${spark.version}</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>5.1.27</version> </dependency> <!-- https://mvnrepository.com/artifact/org.scalikejdbc/scalikejdbc --> <dependency> <groupId>org.scalikejdbc</groupId> <artifactId>scalikejdbc_2.11</artifactId> <version>2.5.0</version> </dependency> <dependency> <groupId>org.scalikejdbc</groupId> <artifactId>scalikejdbc-config_2.11</artifactId> <version>2.5.0</version> </dependency> <dependency> <groupId>com.typesafe</groupId> <artifactId>config</artifactId> <version>1.3.0</version> </dependency> <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-lang3</artifactId> <version>3.5</version> </dependency> 实现思路 1)StreamingContext 2)从kafka中获取数据(从外部存储获取offset-->根据offset获取kafka中的数据) 3)根据业务进行逻辑处理 4)将处理结果存到外部存储中--保存offset 5)启动程序,等待程序结束 代码实现 SparkStreaming主体代码如下 import kafka.common.TopicAndPartition import kafka.message.MessageAndMetadata import kafka.serializer.StringDecoder import org.apache.spark.SparkConf import org.apache.spark.streaming.kafka.{HasOffsetRanges, KafkaUtils} import org.apache.spark.streaming.{Seconds, StreamingContext} import scalikejdbc._ import scalikejdbc.config._ object JDBCOffsetApp { def main(args: Array[String]): Unit = { //创建SparkStreaming入口 val conf = new SparkConf().setMaster("local[2]").setAppName("JDBCOffsetApp") val ssc = new StreamingContext(conf,Seconds(5)) //kafka消费主题 val topics = ValueUtils.getStringValue("kafka.topics").split(",").toSet //kafka参数 //这里应用了自定义的ValueUtils工具类,来获取application.conf里的参数,方便后期修改 val kafkaParams = Map[String,String]( "metadata.broker.list"->ValueUtils.getStringValue("metadata.broker.list"), "auto.offset.reset"->ValueUtils.getStringValue("auto.offset.reset"), "group.id"->ValueUtils.getStringValue("group.id") ) //先使用scalikejdbc从MySQL数据库中读取offset信息 //+------------+------------------+------------+------------+-------------+ //| topic | groupid | partitions | fromoffset | untiloffset | //+------------+------------------+------------+------------+-------------+ //MySQL表结构如上,将“topic”,“partitions”,“untiloffset”列读取出来 //组成 fromOffsets: Map[TopicAndPartition, Long],后面createDirectStream用到 DBs.setup() val fromOffset = DB.readOnly( implicit session => { SQL("select * from hlw_offset").map(rs => { (TopicAndPartition(rs.string("topic"),rs.int("partitions")),rs.long("untiloffset")) }).list().apply() }).toMap //如果MySQL表中没有offset信息,就从0开始消费;如果有,就从已经存在的offset开始消费 val messages = if (fromOffset.isEmpty) { println("从头开始消费...") KafkaUtils.createDirectStream[String,String,StringDecoder,StringDecoder](ssc,kafkaParams,topics) } else { println("从已存在记录开始消费...") val messageHandler = (mm:MessageAndMetadata[String,String]) => (mm.key(),mm.message()) KafkaUtils.createDirectStream[String,String,StringDecoder,StringDecoder,(String,String)](ssc,kafkaParams,fromOffset,messageHandler) } messages.foreachRDD(rdd=>{ if(!rdd.isEmpty()){ //输出rdd的数据量 println("数据统计记录为:"+rdd.count()) //官方案例给出的获得rdd offset信息的方法,offsetRanges是由一系列offsetRange组成的数组 // trait HasOffsetRanges { // def offsetRanges: Array[OffsetRange] // } val offsetRanges = rdd.asInstanceOf[HasOffsetRanges].offsetRanges offsetRanges.foreach(x => { //输出每次消费的主题,分区,开始偏移量和结束偏移量 println(s"---${x.topic},${x.partition},${x.fromOffset},${x.untilOffset}---") //将最新的偏移量信息保存到MySQL表中 DB.autoCommit( implicit session => { SQL("replace into hlw_offset(topic,groupid,partitions,fromoffset,untiloffset) values (?,?,?,?,?)") .bind(x.topic,ValueUtils.getStringValue("group.id"),x.partition,x.fromOffset,x.untilOffset) .update().apply() }) }) } }) ssc.start() ssc.awaitTermination() } } 自定义的ValueUtils工具类如下 import com.typesafe.config.ConfigFactory import org.apache.commons.lang3.StringUtils object ValueUtils { val load = ConfigFactory.load() def getStringValue(key:String, defaultValue:String="") = { val value = load.getString(key) if(StringUtils.isNotEmpty(value)) { value } else { defaultValue } } } application.conf内容如下 metadata.broker.list = "192.168.137.251:9092" auto.offset.reset = "smallest" group.id = "hlw_offset_group" kafka.topics = "hlw_offset" serializer.class = "kafka.serializer.StringEncoder" request.required.acks = "1" # JDBC settings db.default.driver = "com.mysql.jdbc.Driver" db.default.url="jdbc:mysql://hadoop000:3306/test" db.default.user="root" db.default.password="123456" 自定义kafka producer import java.util.{Date, Properties} import kafka.producer.{KeyedMessage, Producer, ProducerConfig} object KafkaProducer { def main(args: Array[String]): Unit = { val properties = new Properties() properties.put("serializer.class",ValueUtils.getStringValue("serializer.class")) properties.put("metadata.broker.list",ValueUtils.getStringValue("metadata.broker.list")) properties.put("request.required.acks",ValueUtils.getStringValue("request.required.acks")) val producerConfig = new ProducerConfig(properties) val producer = new Producer[String,String](producerConfig) val topic = ValueUtils.getStringValue("kafka.topics") //每次产生100条数据 var i = 0 for (i <- 1 to 100) { val runtimes = new Date().toString val messages = new KeyedMessage[String, String](topic,i+"","hlw: "+runtimes) producer.send(messages) } println("数据发送完毕...") } } 测试 启动kafka服务,并创建主题 [hadoop@hadoop000 bin]$ ./kafka-server-start.sh -daemon /home/hadoop/app/kafka_2.11-0.10.0.1/config/server.properties [hadoop@hadoop000 bin]$ ./kafka-topics.sh --list --zookeeper localhost:2181/kafka [hadoop@hadoop000 bin]$ ./kafka-topics.sh --create --zookeeper localhost:2181/kafka --replication-factor 1 --partitions 1 --topic hlw_offset 测试前查看MySQL中offset表,刚开始是个空表 mysql> select * from hlw_offset; Empty set (0.00 sec) 通过kafka producer产生500条数据 启动SparkStreaming程序 //控制台输出结果: 从头开始消费... 数据统计记录为:500 ---hlw_offset,0,0,500--- 查看MySQL表,offset记录成功 mysql> select * from hlw_offset; +------------+------------------+------------+------------+-------------+ | topic | groupid | partitions | fromoffset | untiloffset | +------------+------------------+------------+------------+-------------+ | hlw_offset | hlw_offset_group | 0 | 0 | 500 | +------------+------------------+------------+------------+-------------+ 关闭SparkStreaming程序,再使用kafka producer生产300条数据,再次启动spark程序(如果spark从500开始消费,说明成功读取了offset,做到了只读取一次语义) //控制台结果输出: 从已存在记录开始消费... 数据统计记录为:300 ---hlw_offset,0,500,800--- 查看更新后的offset MySQL数据 mysql> select * from hlw_offset; +------------+------------------+------------+------------+-------------+ | topic | groupid | partitions | fromoffset | untiloffset | +------------+------------------+------------+------------+-------------+ | hlw_offset | hlw_offset_group | 0 | 500 | 800 | +------------+------------------+------------+------------+-------------+

优秀的个人博客,低调大师

零基础入门—网站建站教程(新手必备)

前言相信很多新用户会有这样的疑惑,我要做个网站,到底要使用什么产品,如何能快速完成网站建站呢?搭建网站有两种选择,一种是直接购买建站模板,另一种则是自行建站。两类建站方式对比如下: 建站方式 优势 适用人群购买建站模板 即买即用,轻松便捷,后台管理方便,且有专人进行网站维护。 预算相对充足、希望节省人力、使用需求迫切的用户。DIY自行建站服务器购买、网站搭建、网站维护全程自主,弹性灵活。 希望自行设计、有动手意愿的用户。如果需要购买模板,阿里云云市场提供丰富的建站,并且支持网站定制。如: 云市场企业官网定制:适合看重网站个性化的企业用户,成本较高。云市场网站模板:适合无特殊需求的个人和小企业用户,支持 PC、手机、微信等多种渠道,选择多样,成本较低。网站基础环境搭建服务,省心省力。 以下介绍自行搭建网站的流

优秀的个人博客,低调大师

python零基础应该怎样学习入门Python?

前言Python 语言应该如何入门,记得我几年前也碰到过这样的问题,当时网上随便搜了一下饥不择食的找了一些书开始啃起来,结果发现很疑惑,感觉吃力,走了很多弯路。若不得法还会降低初学者的兴趣,现在我就说说自己对python 入门的理解. 学Python和学其他的语言其实是相同的,我给新同事讲课的时候就说学编程和练武功其实是很相似,入门大致这样几步: 找本靠谱的书, 找个靠谱的师傅, 找一个地方开始练习。 学语言也是的:选一本通俗易懂的书,找一个好的视频资料,然后自己装一个IDE工具开始边学变写。下面我具体来讲讲: 1.找一本靠谱的书,难度一定要是入门级别,千万不能太复杂,不要一下子陷进去,会打乱节奏,学东西要循序渐进,不能一口吃个胖子.打个比方,学过java的同学都听过大名鼎鼎的thinking in java,这边书很厚很全,若一上来就学,肯定会吃力,时间长了就会失去兴趣,因此对初学者来说,一定要找一个通熟易懂的,简单的书。入门的书非常关键。 入门的书很多,但是我个人强烈推荐"A Byte of Python",这本书我读了2遍,作者写的思路非常清晰,对每一个知识点讲解的很到位,不多不少,刚刚好,对初学者来说,力道刚刚好。而且是全英文,对提高自己的英语水平,很有帮助. 2.找一个好的视频资源,当然若你周围有Python高手就更好了,可以多交流多请教。视频资源我推荐imooc,当然有人说还有jikexueyuan,网易公开课,这几家我都看过一些,各有千秋,我建议初学者还是选择imooc,他家的Python讲解的很仔细,而且音频的质量比较高,最关键是的可以在web上直接编程练习,都不用自己安装编译器,非常方便。居家旅行必备啊~~ 3.多编写程序,这似乎是废话,但是确实是一句实话。学编程一定要亲身去编写,没有什么捷径.一开始哪怕你把书里面的例子一字不落敲一遍,也好过你只是去看书,而不动手。 而且学Python最好是坚持编,每天抽小半个小时,学一些知识点,不断的坚持.大概快的话几个星期基本就能入门了。 以上就是我对Python入门的感悟,希望对初学者能有一点帮助,能帮到一些人少走一点弯路.也就不枉我大半夜在这里码字了~~

优秀的个人博客,低调大师

Python零基础学习笔记(三十九)—— time

#UTC(世界协调时间):格林尼治天文时间,世界标准时间,在中国来说是UTC+8(东八区) #DST(夏令时):是一种节约能源而人为规定的时间制度,在夏季调快一个小时 ''' 时间的表示形式: 1、时间戳 以整形或浮点型表示时间的一个以秒为单位的时间间隔 时间间隔的基础值是从1970年1月1号0点开始算起的 2、元组 一种Python的数据结构表示,这个元组有9个整形内容 year month day hours minutes seconds weekday Julia day fiag(1 【夏令时】或 -1【】 或 0【正常】) 3、格式化字符串 %y 两位数的年份表示(00-99) %Y 四位数的年份表示(000-9999) %m 月份(01-12) %d 月内中的一天(0-31) %H 24小时制小时数(0-23) %I 12小时制小时数(01-12) %M 分钟数(00=59) %S 秒(00-59) %a 本地简化星期名称 %A 本地完整星期名称 %b 本地简化的月份名称 %B 本地完整的月份名称 %c 本地相应的日期表示和时间表示 %j 年内的一天(001-366) %p 本地A.M.或P.M.的等价符 %U 一年中的星期数(00-53)星期天为星期的开始 %w 星期(0-6),星期天为星期的开始 %W 一年中的星期数(00-53)星期一为星期的开始 %x 本地相应的日期表示 %X 本地相应的时间表示 %Z 当前时区的名称 ''' import time #以浮点数形式返回当前时间的时间戳,不需要参数(UTC) c = time.time() print(c) #将时间戳转为UTC时间元组 t = time.gmtime(c) print(t) #将时间戳转为本地时间元组 b = time.localtime(c) print("b =", b) #将本地时间元组转换为时间戳 m = time.mktime(b) print(m) #将时间元组转换成字符串 s = time.asctime(b) print(s) #将时间戳转为字符串 h = time.ctime(c) print(h) #将时间元组转换为指定格式的字符串,参数2 为时间元祖,如果没有参数2, 默认转换为当前时间 q = time.strftime("%Y-%m-%d %H:%M:%S",b) print(q) #将时间字符串转换为时间元组 i = time.strptime(q, "%Y-%m-%d %H:%M:%S") print(i) #延迟一个时间,整形或浮点型 #time.sleep(1) #返回当前程序的cpu时间 #Unix系统始终返回全部的运行时间 #Windows从第二次开始,都是以第一个调用此函数的开始时间戳作为基数 j = time.clock() print(j) time.sleep(2) j1 =time.clock() print("%d" % j1) time.sleep(2) j2 =time.clock() print("%d" % j2)

优秀的个人博客,低调大师

Python零基础学习笔记(三十六)—— 递归

''' 递归调用:一个函数,调用了自身,成为递归调用 递归函数:一个会调用自身的函数 凡是循环能干的事,递归都能干 ''' ''' 方式: 1、写出临界条件 2、找这一次和上一次的关系 3、假设当前函数已经能用,调用自身计算行一次的结果,再求出本次的结果 ''' #输入一个数,求 1+2+3+……+ n 的和 def sum1(n): sum = 0 for x in range(1, n + 1): sum += x return sum res = sum1(10) print("res =", res) #递归方法 def sum2(n): if n == 1: return 1 else: return n + sum2(n - 1) res1 = sum2(10) print(res1)

优秀的个人博客,低调大师

Python零基础学习笔记(三十)—— 读文件

''' 过程: 1、打开文件 2、读文件内容 3、关闭文件 ''' ''' 1、打开文件 open(path, flag[, encoding]) path:要打开文件的路径 flag:打开方式 r(read) 以只读方式打开文件,文件的描述符放在文件的开头 rb 以为进制格式打开文件用于只读,文件的描述符放在文件的开头 r+ 打开一个文件用于读写,文件的描述符放在文件的开头 w 打开一个文件只用于写入,如果该文件已经存在会覆盖,不存在则创建新文件 wb 打开一个文件只用于写入二进制,如果该文件已经存在会覆盖,不存在则创建新文件 w+ 打开一个文件用于读写,如果该文件已经存在会覆盖,不存在则创建新文件 a 打开一个文件用于追加,如果文集那存在,文件描述符将会放到文件末尾 a+ encoding:编码格式 errors:错误处理 ''' #打开文件 path = r"E:\File.txt" #f = open(path, "r", encoding = "utf-8",errors = "ignore") f = open(path, "r") ''' 2、读文件内容 ''' #读文件的所有内容 str1 = f.read() print("str1 =", str1) #读文件中指定字符数 f.seek(0) #修改描述符的位置 str2 = f.read(5) print("str2 =", str2) #读取整行,包括"\n"字符 f.seek(0) str3 = f.readline() print("str3 =", str3) #读取所有行并返回列表 f.seek(0) str4 = f.readlines() print("str4 =", str4) #读取指定字符数 f.seek(0) str5 = f.readline(20) print("str5 =", str5) #修改描述符的位置 f.seek(0) ''' 3、关闭文件 ''' f.close() ''' 完整过程 ''' #第一种 try: f1 = open(path,"r") print(f1.read()) finally: if f1: f1.close() #更为简单的方法 with open(path, "r", encoding= "gbk", errors="ignore") as f2: print(f2.read())

优秀的个人博客,低调大师

Python零基础学习笔记(二十)—— tuple元组

#创建空元组 tuple1 = () print(tuple1) #创建带有元素的元组 tuple2 = (1, 2, 3, "jjking", True) #元素类型可以不同 print(tuple2) #定义只有1 个元素的元组 tuple3 = (1 ) #后面必须加逗号 print(tuple3) print(type(tuple3)) ''' 元组元素的访问 格式: 元组名[下标] 注意:下标不能越界 ''' tuple4 = (1, 2, 3, 4, 5) print(tuple4[3]) #获取最后一个元素 print(tuple4[-1]) #获取倒数第二个元素 print(tuple4[-2]) #修改元组,实际上修改的是元素里面的数据 tuple5 = (1, 2, 3, 4, [1, 2, 3], 5) print(tuple5) tuple5[4][2] = 4 print(tuple5) #删除元组 del tuple5 #print(tuple5) 因为被删除了所以打印不出来,会报错 #元组的操作 t1 = (1 ,2, 3, 4) t2 = (5, 6) t3 = t1 + t2 print(t3) #元组重复 print(t3 *3) #判断元素是否在元组中 print( 3 in t3) #元组的截取 #格式:元组名[ 开始下标:结束下标 ] #从开始下标开始截取,到结束下标之前,默认从头到尾 print(t3[1:4]) #二维元组:元素为一维元组的元组 t4 = ((1, 2, 3), (4, 5, 6), (7, 8, 9)) print(t4) print(t4[2][1]) '''元组的方法''' #len() 返回元组中元素的个数 print(len(t4)) #max() 返回元组中的最大值 print(max(t1)) #min() 返回元祖中的最小值 print(min(t1)) #列表转元组 list2 = [1, 2, 3, 4, 5] t5 = tuple(list2) print(t5) #元组转列表 list1 = list(t3) print(list1) ''' 一旦初始化元组里面的元素就不能修改了 和列表的区别就是不可变 这就提高了数据的安全性 所以说能用元组尽量用元组 ''' #元组的遍历 for i in (1, 2, 3, 4,5): print(i)

优秀的个人博客,低调大师

Python零基础学习笔记(十五)—— list(列表)

''' 本质;一种有序的集合 格式: 列表名 = [列表选项1, 列表选项2, ...列表选项n] ''' list1 = [23, 22, 24, 22, 25] print(list1) #元素数据可以不同 list2 = [1, 233, "name", "jjking", True] ''' 列表元素的访问 取值: 格式:列表名[下标] 注意:列表下标不要越界 ''' print(list1[2]) #列表操作: #列表组合 list3 = list1 + list2 print(list3) #列表的重复 print(list2 * 5) #判断元素是否在列表中 print(1 in list2) #列表截取 [2:3) print(list2[2:3]) #二维列表 list4 = [[123],[2,2,3],[1,2,3],[4,5,6,8]] print(list4[2][2]) #列表方法 list5 = [1,2,3,4,5,6] #appeng() 在列表末尾添加新的元素 list5.append(7) print(list5) list5.append([8,9]) print(list5) #extend() 在末尾一次性追加另一个列表中的多个值 list5.extend([1,2,3]) print(list5) #insert() 在下标处添加一个元素,元数据向后顺延 list5.insert(2,10) print(list5) #pop() 删除下标处的元素,默认为最后一个下标,并返回删除的数据 list5.pop() print(list5) list5.pop(2) print(list5) print(list5.pop(2)) #remove() 移除列表中的某个元素 list5.remove(5) list5.remove([8, 9]) print(list5) #clear() 清除列表中所有的数据 list6 = [1,2,3] list6.clear() print(list6) #index() 从列表中找出某个值的第一个匹配的索引值,可以加开始和结束的下标范围 print(list5.index(2)) print(list5.index(2, 4,8)) #len() 列表中的元素 print(len(list5)) #max() 获取列表中的最大值,只能是在一维列表,不然会报错 print(max(list5)) #min() 获取列表中的最小值,只能是在一维列表,不然会报错 print(min(list5)) #count() 某元素出现的次数 print(list5.count(2)) #浅拷贝 内存地址是一样的 lis7 = list5 print(id(list5)) print(id(lis7)) #copy() 深拷贝 内存的拷贝 内存的地址是不一样的 print(id(list5.copy())) #reverse() 倒序 list5.reverse() print(list5) #sort() 从小到大排序 list5.sort() print(list5) #元组转换成列表 list8 = list((1,2,3,4)) print(list8)

优秀的个人博客,低调大师

Python零基础学习笔记(十四)—— while语句

''' while 语句: 格式: while 表达式: 语句 逻辑:当程序遇到while语句的时候,首先计算【表达式】的值 如果【表达式】的值为假,那么结束整个while语句 如果表达式的值为真,则执行【语句】,循环调用,直到为假停止 ''' #从1打印到小于5的数 num = 1 while num < 5: print("num = %d"% num) num += 1 #计算1+2+3+...+100 sum = 0 num = 1 while num <= 100: sum += num num += 1 #print("sum = %d" % sum) print("sum = %d"% sum) #打印字符串里的每一个字符 str = "My name is jjking." index = 0 while index <= len(str): print(str[index]) index += 1 运行结果: num = 1 num = 2 num = 3 num = 4 sum = 5050 M y n a m e i s j j k i n g .

优秀的个人博客,低调大师

Python零基础学习笔记(八)—— 数学功能

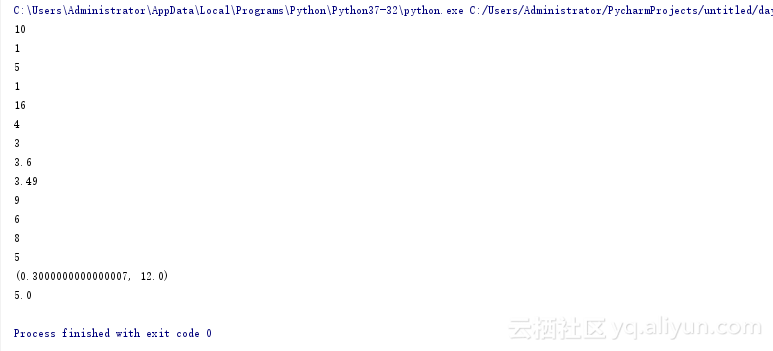
一定要导入math包,不然后面会报错 今日学习部分及执行结果如下图 import math # abs() 返回数的绝对值 a1 = -10 a2 = abs(a1) print(a2) #比较两个数的大小 a3 = 10 a4 = 9 print((a3>a4)-(a3<a4)) # max() 返回参数中的最大值 print(max(1,2,3,4,5)) # min() 返回参数中的最小值 print(min(1,2,3,4,5)) # pow() 求x的y次方 例如2^4 print(pow(2,4)) #round(x[, n]) x为数值,n为保留位数,n可有可无 # 四舍五入 print(round(3.576)) print(round(3.492)) #四舍五入保留位数 print(round(3.576, 1)) print(round(3.492, 2)) # math.ceil() 向上取整 print(math.ceil(8.1)) print(math.ceil(5.9)) # math.floor() 向下取整 print(math.floor(8.1)) print(math.floor(5.9)) # math.modf() 返回整数部分与小数部分 print(math.modf(12.3)) # math.sqrt() 开方 print(math.sqrt(25))

优秀的个人博客,低调大师

技术| Python的从零开始系列连载(三十)

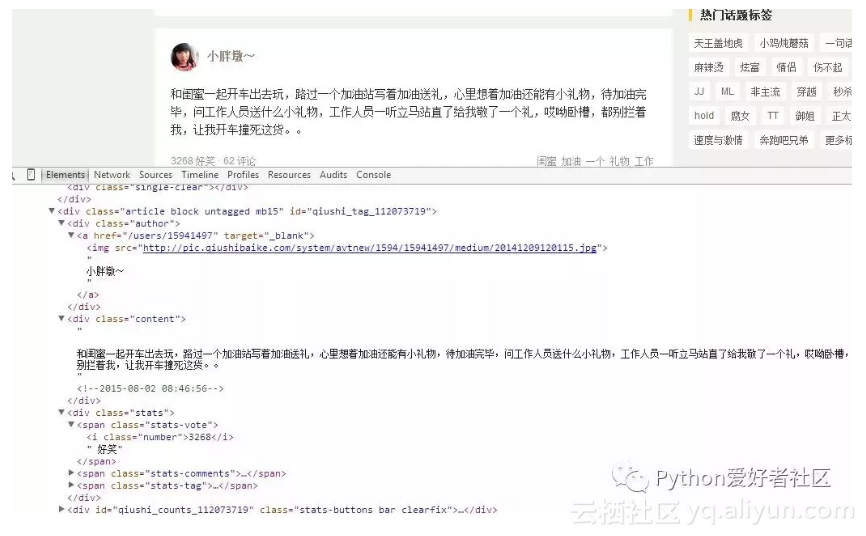
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来。 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的情况,是因为正则表达式没有匹配到的缘故。 现在,博主已经对程序进行了重新修改,代码亲测可用,包括截图和说明,之前一直在忙所以没有及时更新,望大家海涵! 糗事百科又又又又改版了,博主已经没心再去一次次匹配它了,如果大家遇到长时间运行不出结果也不报错的情况,请大家参考最新的评论,热心小伙伴提供的正则来修改下吧~ 本篇目标 1.抓取糗事百科热门段子 2.过滤带有图片的段子 3.实现每按一次回车显示一个段子的发布时间,发布人,段子内容,点赞数。 糗事百科是不需要登录的,所以也没必要用到Cookie,另外糗事百科有的段子是附图的,我们把图抓下来图片不便于显示,那么我们就尝试过滤掉有图的段子吧。 好,现在我们尝试抓取一下糗事百科的热门段子吧,每按下一次回车我们显示一个段子。 1.确定URL并抓取页面代码 首先我们确定好页面的URL是 http://www.qiushibaike.com/hot/page/1,其中最后一个数字1代表页数,我们可以传入不同的值来获得某一页的段子内容。 我们初步构建如下的代码来打印页面代码内容试试看,先构造最基本的页面抓取方式,看看会不会成功 # -*- coding:utf-8 -*- import urllib import urllib2 page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) try: request = urllib2.Request(url) response = urllib2.urlopen(request) print response.read() except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 运行程序,哦不,它竟然报错了,真是时运不济,命途多舛啊 line 373, in _read_status raise BadStatusLine(line) httplib.BadStatusLine: '' 好吧,应该是headers验证的问题,我们加上一个headers验证试试看吧,将代码修改如下 # -*- coding:utf-8 -*- import urllib import urllib2 page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' headers = { 'User-Agent' : user_agent } try: request = urllib2.Request(url,headers = headers) response = urllib2.urlopen(request) print response.read() except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 嘿嘿,这次运行终于正常了,打印出了第一页的HTML代码,大家可以运行下代码试试看。在这里运行结果太长就不贴了。 2.提取某一页的所有段子 好,获取了HTML代码之后,我们开始分析怎样获取某一页的所有段子。 首先我们审查元素看一下,按浏览器的F12,截图如下 我们可以看到,每一个段子都是<div class=”article block untagged mb15″ id=”…”>…</div>包裹的内容。 现在我们想获取发布人,发布日期,段子内容,以及点赞的个数。不过另外注意的是,段子有些是带图片的,如果我们想在控制台显示图片是不现实的,所以我们直接把带有图片的段子给它剔除掉,只保存仅含文本的段子。 所以我们加入如下正则表达式来匹配一下,用到的方法是 re.findall 是找寻所有匹配的内容。方法的用法详情可以看前面说的正则表达式的介绍。 好,我们的正则表达式匹配语句书写如下,在原来的基础上追加如下代码 content = response.read().decode('utf-8') pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,content) for item in items: print item[0],item[1],item[2],item[3],item[4] 现在正则表达式在这里稍作说明 1).*? 是一个固定的搭配,.和*代表可以匹配任意无限多个字符,加上?表示使用非贪婪模式进行匹配,也就是我们会尽可能短地做匹配,以后我们还会大量用到 .*? 的搭配。 2)(.*?)代表一个分组,在这个正则表达式中我们匹配了五个分组,在后面的遍历item中,item[0]就代表第一个(.*?)所指代的内容,item[1]就代表第二个(.*?)所指代的内容,以此类推。 3)re.S 标志代表在匹配时为点任意匹配模式,点 . 也可以代表换行符。 这样我们就获取了发布人,发布时间,发布内容,附加图片以及点赞数。 在这里注意一下,我们要获取的内容如果是带有图片,直接输出出来比较繁琐,所以这里我们只获取不带图片的段子就好了。 所以,在这里我们就需要对带图片的段子进行过滤。 我们可以发现,带有图片的段子会带有类似下面的代码,而不带图片的则没有,所以,我们的正则表达式的item[3]就是获取了下面的内容,如果不带图片,item[3]获取的内容便是空。 <div class="thumb"> <a href="/article/112061287?list=hot&amp;s=4794990" target="_blank"> <img src="http://pic.qiushibaike.com/system/pictures/11206/112061287/medium/app112061287.jpg" alt="但他们依然乐观"> </a> </div> 所以我们只需要判断item[3]中是否含有img标签就可以了。 好,我们再把上述代码中的for循环改为下面的样子 for item in items: haveImg = re.search("img",item[3]) if not haveImg: print item[0],item[1],item[2],item[4] 现在,整体的代码如下 # -*- coding:utf-8 -*- import urllib import urllib2 import re page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' headers = { 'User-Agent' : user_agent } try: request = urllib2.Request(url,headers = headers) response = urllib2.urlopen(request) content = response.read().decode('utf-8') pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,content) for item in items: haveImg = re.search("img",item[3]) if not haveImg: print item[0],item[1],item[2],item[4] except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 运行一下看下效果 恩,带有图片的段子已经被剔除啦。是不是很开森? 3.完善交互,设计面向对象模式 好啦,现在最核心的部分我们已经完成啦,剩下的就是修一下边边角角的东西,我们想达到的目的是: 按下回车,读取一个段子,显示出段子的发布人,发布日期,内容以及点赞个数。 另外我们需要设计面向对象模式,引入类和方法,将代码做一下优化和封装,最后,我们的代码如下所示 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re import thread import time #糗事百科爬虫类 class QSBK: #初始化方法,定义一些变量 def __init__(self): self.pageIndex = 1 self.user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' #初始化headers self.headers = { 'User-Agent' : self.user_agent } #存放段子的变量,每一个元素是每一页的段子们 self.stories = [] #存放程序是否继续运行的变量 self.enable = False #传入某一页的索引获得页面代码 def getPage(self,pageIndex): try: url = 'http://www.qiushibaike.com/hot/page/' + str(pageIndex) #构建请求的request request = urllib2.Request(url,headers = self.headers) #利用urlopen获取页面代码 response = urllib2.urlopen(request) #将页面转化为UTF-8编码 pageCode = response.read().decode('utf-8') return pageCode except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接糗事百科失败,错误原因",e.reason return None #传入某一页代码,返回本页不带图片的段子列表 def getPageItems(self,pageIndex): pageCode = self.getPage(pageIndex) if not pageCode: print "页面加载失败...." return None pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,pageCode) #用来存储每页的段子们 pageStories = [] #遍历正则表达式匹配的信息 for item in items: #是否含有图片 haveImg = re.search("img",item[3]) #如果不含有图片,把它加入list中 if not haveImg: replaceBR = re.compile('<br/>') text = re.sub(replaceBR,"\n",item[1]) #item[0]是一个段子的发布者,item[1]是内容,item[2]是发布时间,item[4]是点赞数 pageStories.append([item[0].strip(),text.strip(),item[2].strip(),item[4].strip()]) return pageStories #加载并提取页面的内容,加入到列表中 def loadPage(self): #如果当前未看的页数少于2页,则加载新一页 if self.enable == True: if len(self.stories) < 2: #获取新一页 pageStories = self.getPageItems(self.pageIndex) #将该页的段子存放到全局list中 if pageStories: self.stories.append(pageStories) #获取完之后页码索引加一,表示下次读取下一页 self.pageIndex += 1 #调用该方法,每次敲回车打印输出一个段子 def getOneStory(self,pageStories,page): #遍历一页的段子 for story in pageStories: #等待用户输入 input = raw_input() #每当输入回车一次,判断一下是否要加载新页面 self.loadPage() #如果输入Q则程序结束 if input == "Q": self.enable = False return print u"第%d页\t发布人:%s\t发布时间:%s\t赞:%s\n%s" %(page,story[0],story[2],story[3],story[1]) #开始方法 def start(self): print u"正在读取糗事百科,按回车查看新段子,Q退出" #使变量为True,程序可以正常运行 self.enable = True #先加载一页内容 self.loadPage() #局部变量,控制当前读到了第几页 nowPage = 0 while self.enable: if len(self.stories)>0: #从全局list中获取一页的段子 pageStories = self.stories[0] #当前读到的页数加一 nowPage += 1 #将全局list中第一个元素删除,因为已经取出 del self.stories[0] #输出该页的段子 self.getOneStory(pageStories,nowPage) spider = QSBK() spider.start() 好啦,大家来测试一下吧,点一下回车会输出一个段子,包括发布人,发布时间,段子内容以及点赞数,是不是感觉爽爆了! 原文发布时间为:2018-11-23 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“灯塔大数据”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册