首页 文章 精选 留言 我的

精选列表

搜索[零点击],共10000篇文章
优秀的个人博客,低调大师

技术| Python的从零开始系列连载(三十)

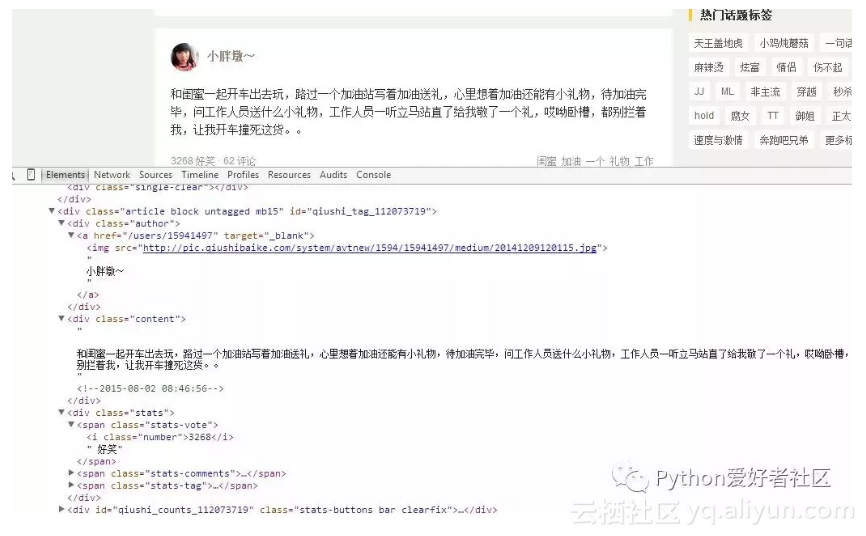
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来。 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的情况,是因为正则表达式没有匹配到的缘故。 现在,博主已经对程序进行了重新修改,代码亲测可用,包括截图和说明,之前一直在忙所以没有及时更新,望大家海涵! 糗事百科又又又又改版了,博主已经没心再去一次次匹配它了,如果大家遇到长时间运行不出结果也不报错的情况,请大家参考最新的评论,热心小伙伴提供的正则来修改下吧~ 本篇目标 1.抓取糗事百科热门段子 2.过滤带有图片的段子 3.实现每按一次回车显示一个段子的发布时间,发布人,段子内容,点赞数。 糗事百科是不需要登录的,所以也没必要用到Cookie,另外糗事百科有的段子是附图的,我们把图抓下来图片不便于显示,那么我们就尝试过滤掉有图的段子吧。 好,现在我们尝试抓取一下糗事百科的热门段子吧,每按下一次回车我们显示一个段子。 1.确定URL并抓取页面代码 首先我们确定好页面的URL是 http://www.qiushibaike.com/hot/page/1,其中最后一个数字1代表页数,我们可以传入不同的值来获得某一页的段子内容。 我们初步构建如下的代码来打印页面代码内容试试看,先构造最基本的页面抓取方式,看看会不会成功 # -*- coding:utf-8 -*- import urllib import urllib2 page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) try: request = urllib2.Request(url) response = urllib2.urlopen(request) print response.read() except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 运行程序,哦不,它竟然报错了,真是时运不济,命途多舛啊 line 373, in _read_status raise BadStatusLine(line) httplib.BadStatusLine: '' 好吧,应该是headers验证的问题,我们加上一个headers验证试试看吧,将代码修改如下 # -*- coding:utf-8 -*- import urllib import urllib2 page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' headers = { 'User-Agent' : user_agent } try: request = urllib2.Request(url,headers = headers) response = urllib2.urlopen(request) print response.read() except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 嘿嘿,这次运行终于正常了,打印出了第一页的HTML代码,大家可以运行下代码试试看。在这里运行结果太长就不贴了。 2.提取某一页的所有段子 好,获取了HTML代码之后,我们开始分析怎样获取某一页的所有段子。 首先我们审查元素看一下,按浏览器的F12,截图如下 我们可以看到,每一个段子都是<div class=”article block untagged mb15″ id=”…”>…</div>包裹的内容。 现在我们想获取发布人,发布日期,段子内容,以及点赞的个数。不过另外注意的是,段子有些是带图片的,如果我们想在控制台显示图片是不现实的,所以我们直接把带有图片的段子给它剔除掉,只保存仅含文本的段子。 所以我们加入如下正则表达式来匹配一下,用到的方法是 re.findall 是找寻所有匹配的内容。方法的用法详情可以看前面说的正则表达式的介绍。 好,我们的正则表达式匹配语句书写如下,在原来的基础上追加如下代码 content = response.read().decode('utf-8') pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,content) for item in items: print item[0],item[1],item[2],item[3],item[4] 现在正则表达式在这里稍作说明 1).*? 是一个固定的搭配,.和*代表可以匹配任意无限多个字符,加上?表示使用非贪婪模式进行匹配,也就是我们会尽可能短地做匹配,以后我们还会大量用到 .*? 的搭配。 2)(.*?)代表一个分组,在这个正则表达式中我们匹配了五个分组,在后面的遍历item中,item[0]就代表第一个(.*?)所指代的内容,item[1]就代表第二个(.*?)所指代的内容,以此类推。 3)re.S 标志代表在匹配时为点任意匹配模式,点 . 也可以代表换行符。 这样我们就获取了发布人,发布时间,发布内容,附加图片以及点赞数。 在这里注意一下,我们要获取的内容如果是带有图片,直接输出出来比较繁琐,所以这里我们只获取不带图片的段子就好了。 所以,在这里我们就需要对带图片的段子进行过滤。 我们可以发现,带有图片的段子会带有类似下面的代码,而不带图片的则没有,所以,我们的正则表达式的item[3]就是获取了下面的内容,如果不带图片,item[3]获取的内容便是空。 <div class="thumb"> <a href="/article/112061287?list=hot&amp;s=4794990" target="_blank"> <img src="http://pic.qiushibaike.com/system/pictures/11206/112061287/medium/app112061287.jpg" alt="但他们依然乐观"> </a> </div> 所以我们只需要判断item[3]中是否含有img标签就可以了。 好,我们再把上述代码中的for循环改为下面的样子 for item in items: haveImg = re.search("img",item[3]) if not haveImg: print item[0],item[1],item[2],item[4] 现在,整体的代码如下 # -*- coding:utf-8 -*- import urllib import urllib2 import re page = 1 url = 'http://www.qiushibaike.com/hot/page/' + str(page) user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' headers = { 'User-Agent' : user_agent } try: request = urllib2.Request(url,headers = headers) response = urllib2.urlopen(request) content = response.read().decode('utf-8') pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,content) for item in items: haveImg = re.search("img",item[3]) if not haveImg: print item[0],item[1],item[2],item[4] except urllib2.URLError, e: if hasattr(e,"code"): print e.code if hasattr(e,"reason"): print e.reason 运行一下看下效果 恩,带有图片的段子已经被剔除啦。是不是很开森? 3.完善交互,设计面向对象模式 好啦,现在最核心的部分我们已经完成啦,剩下的就是修一下边边角角的东西,我们想达到的目的是: 按下回车,读取一个段子,显示出段子的发布人,发布日期,内容以及点赞个数。 另外我们需要设计面向对象模式,引入类和方法,将代码做一下优化和封装,最后,我们的代码如下所示 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re import thread import time #糗事百科爬虫类 class QSBK: #初始化方法,定义一些变量 def __init__(self): self.pageIndex = 1 self.user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)' #初始化headers self.headers = { 'User-Agent' : self.user_agent } #存放段子的变量,每一个元素是每一页的段子们 self.stories = [] #存放程序是否继续运行的变量 self.enable = False #传入某一页的索引获得页面代码 def getPage(self,pageIndex): try: url = 'http://www.qiushibaike.com/hot/page/' + str(pageIndex) #构建请求的request request = urllib2.Request(url,headers = self.headers) #利用urlopen获取页面代码 response = urllib2.urlopen(request) #将页面转化为UTF-8编码 pageCode = response.read().decode('utf-8') return pageCode except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接糗事百科失败,错误原因",e.reason return None #传入某一页代码,返回本页不带图片的段子列表 def getPageItems(self,pageIndex): pageCode = self.getPage(pageIndex) if not pageCode: print "页面加载失败...." return None pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+ 'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S) items = re.findall(pattern,pageCode) #用来存储每页的段子们 pageStories = [] #遍历正则表达式匹配的信息 for item in items: #是否含有图片 haveImg = re.search("img",item[3]) #如果不含有图片,把它加入list中 if not haveImg: replaceBR = re.compile('<br/>') text = re.sub(replaceBR,"\n",item[1]) #item[0]是一个段子的发布者,item[1]是内容,item[2]是发布时间,item[4]是点赞数 pageStories.append([item[0].strip(),text.strip(),item[2].strip(),item[4].strip()]) return pageStories #加载并提取页面的内容,加入到列表中 def loadPage(self): #如果当前未看的页数少于2页,则加载新一页 if self.enable == True: if len(self.stories) < 2: #获取新一页 pageStories = self.getPageItems(self.pageIndex) #将该页的段子存放到全局list中 if pageStories: self.stories.append(pageStories) #获取完之后页码索引加一,表示下次读取下一页 self.pageIndex += 1 #调用该方法,每次敲回车打印输出一个段子 def getOneStory(self,pageStories,page): #遍历一页的段子 for story in pageStories: #等待用户输入 input = raw_input() #每当输入回车一次,判断一下是否要加载新页面 self.loadPage() #如果输入Q则程序结束 if input == "Q": self.enable = False return print u"第%d页\t发布人:%s\t发布时间:%s\t赞:%s\n%s" %(page,story[0],story[2],story[3],story[1]) #开始方法 def start(self): print u"正在读取糗事百科,按回车查看新段子,Q退出" #使变量为True,程序可以正常运行 self.enable = True #先加载一页内容 self.loadPage() #局部变量,控制当前读到了第几页 nowPage = 0 while self.enable: if len(self.stories)>0: #从全局list中获取一页的段子 pageStories = self.stories[0] #当前读到的页数加一 nowPage += 1 #将全局list中第一个元素删除,因为已经取出 del self.stories[0] #输出该页的段子 self.getOneStory(pageStories,nowPage) spider = QSBK() spider.start() 好啦,大家来测试一下吧,点一下回车会输出一个段子,包括发布人,发布时间,段子内容以及点赞数,是不是感觉爽爆了! 原文发布时间为:2018-11-23 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“灯塔大数据”。

优秀的个人博客,低调大师

从零开始学设计模式(一)——工厂模式

工厂模式 工厂模式也被称之为虚拟构造函数(Virtual Constructor),是Java中最常用的设计模式之一。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。 在工厂模式中,我们在创建对象时不会对客户端暴露创建逻辑,并且是通过使用一个共同的接口来指向新创建的对象 意图 定义用于创建对象的接口,但是让子类决定实例化哪个类。factory方法允许类将实例化推迟到子类 主要解决:接口选择的问题。 何时使用:我们明确地计划不同条件下创建不同实例时。 如何解决:让其子类实现工厂接口,返回的也是一个抽象的产品。 关键代码:创建过程在其子类执行。 解释 现实世界的例子 铁匠制造武器。精灵需要精灵武器,兽人需要兽人武器。根据手头的顾客,召集合适类型的铁匠 简而言之 它提供了一种将实例化逻辑委托给子类的方法 维基百科说 In class-based programming, the factory method pattern is a creational pattern that uses factory methods to deal with the problem of creating objects without having to specify the exact class of the object that will be created. This is done by creating objects by calling a factory method—either specified in an interface and implemented by child classes, or implemented in a base class and optionally overridden by derived classes—rather than by calling a constructor. (在基于类的编程中,factory方法模式是一种创建模式,它使用factory方法来处理创建对象的问题,而不必指定将要创建的对象的确切类。这是通过调用factory方法(在接口中指定并由子类实现,或者在基类中实现并可选地由派生类重写)来实现的,而不是通过调用构造函数来实现的。) 程序代码示例 以现实世界的例子铁匠制造武器为例子,需要什么样的武器类型我们就召唤对应类型的铁匠。程序类图如下: 铁匠接口实现类图.png 首先我们有一个铁匠接口(定义了一个制造武器的方法)和一些精灵铁匠、兽人铁匠实现类: public interface Blacksmith { Weapon manufactureWeapon(WeaponType weaponType); } public class ElfBlacksmith implements Blacksmith { public Weapon manufactureWeapon(WeaponType weaponType) { return new ElfWeapon(weaponType); } } public class OrcBlacksmith implements Blacksmith { public Weapon manufactureWeapon(WeaponType weaponType) { return new OrcWeapon(weaponType); } } 其次我们有一个武器接口(定义了一个获取武器类型的方法)和一些精灵武器、兽人武器实现类: /** * Weapon interface. */ public interface Weapon { WeaponType getWeaponType(); } /** * ElfWeapon. */ public class ElfWeapon implements Weapon { private WeaponType weaponType; public ElfWeapon(WeaponType weaponType) { this.weaponType = weaponType; } @Override public String toString() { return "Elven " + weaponType; } @Override public WeaponType getWeaponType() { return weaponType; } } /** * OrcWeapon. */ public class OrcWeapon implements Weapon { private WeaponType weaponType; public OrcWeapon(WeaponType weaponType) { this.weaponType = weaponType; } @Override public String toString() { return "Orcish " + weaponType; } @Override public WeaponType getWeaponType() { return weaponType; } } 最后,随着顾客的到来,正确类型的铁匠被召唤出来,要求制造武器 public class App { private static final Logger LOGGER = LoggerFactory.getLogger(App.class); private final Blacksmith blacksmith; /** * Creates an instance of <code>App</code> which will use <code>blacksmith</code> to manufacture * the weapons for war. * <code>App</code> is unaware which concrete implementation of {@link Blacksmith} it is using. * The decision of which blacksmith implementation to use may depend on configuration, or * the type of rival in war. * @param blacksmith a non-null implementation of blacksmith */ public App(Blacksmith blacksmith) { this.blacksmith = blacksmith; } /** * Program entry point * * @param args command line args */ public static void main(String[] args) { // Lets go to war with Orc weapons App app = new App(new OrcBlacksmith()); app.manufactureWeapons(); // Lets go to war with Elf weapons app = new App(new ElfBlacksmith()); app.manufactureWeapons(); } private void manufactureWeapons() { Weapon weapon; weapon = blacksmith.manufactureWeapon(WeaponType.SPEAR); LOGGER.info(weapon.toString()); weapon = blacksmith.manufactureWeapon(WeaponType.AXE); LOGGER.info(weapon.toString()); } } 运行App程序结果: app类运行结果输出.png 适用场景 当遇到如下三种情况时,应使用工厂模式: 一个类不能预测它必须创建的对象的类 一个类希望它的子类指定它创建的对象 类将责任委托给几个助手子类中的一个,并且你希望本地化哪个助手子类是委托的责任 Java中的现实例子 java.util.Calendar java.util.ResourceBundle java.text.NumberFormat java.nio.charset.Charset java.net.URLStreamHandlerFactory java.util.EnumSet javax.xml.bind.JAXBContext 优缺点 优点: 1、一个调用者想创建一个对象,只要知道其名称就可以了。 2、扩展性高,如果想增加一个产品,只要扩展一个工厂类就可以。 3、屏蔽产品的具体实现,调用者只关心产品的接口 缺点: 每次增加一个产品时,都需要增加一个具体实现类和修改对象实现工厂,使得系统中类的个数成倍增加,在一定程度上增加了系统的复杂度,同时也增加了系统具体类的依赖。这并不是什么好事 写在最后 工厂模式作为一种创建类模式,在任何需要生成复杂对象的地方,都可以使用工厂模式,比如设计一个连接服务器的框架,需要三个协议,"POP3"、"IMAP"、"HTTP",可以把这三个作为产品类,共同实现一个通讯接口。 对于简单对象,特别是只需要通过new就可以完成创建的对象,无需使用工厂模式,因为使用工厂模式必然要引入一个工厂类,这会增加系统的复杂度,切不可为了设计模式而模式。 下一篇文章我们将在工厂模式的基础上继续延伸介绍抽象工厂模式,难度系统为中级 码字不易,各位看官喜欢的话,请给点个赞️,如果你对接下来的文章有什么建议或者要求可在评论中积极留言,谢谢大家!

优秀的个人博客,低调大师

非零基础入门微信小程序

最近在学习微信小程序,极客人总结了一些入门经验,希望能帮助想学习小程序的同学提供参考 一、微信小程序的文件结构: pages/ : 页面文件,小程序由一个个page(类比于Activity或者ReactJS里面的页面组件)组成 utils/ : 放一些工具方法 .app.js: 小程序启动,类比于Android的Application类或者MainActivity app.json :小程序的全局配置文件, 类比于Android的清单文件,声明了小程序有哪些page app.wxss :全局的css样式文件 project.config.json :项目配置文件,定义了项目的名称,基础库版本,appId等 微信小程序 小程序由一个page组成,类比于Android的Activity,与其他组件化应用一样有生命周期,除此之外,小程序开发和ReactJS很像,比如React里面利用state管理界面数据,小程序有一个几乎和这一模一样的,叫data.小程序组件的生命周期 onLaunch Function 生命周期函数–监听小程序初始化 当小程序初始化完成时,会触发 onLaunch(全局只触发一次)。 onShow Function 生命周期函数–监听小程序显示 当小程序启动,或从后台进入前台显示,会触发 onShow onHide Function 生命周期函数–监听小程序隐藏 当小程序从前台进入后台,会触发 onHide onError Function 错误监听函数 当小程序发生脚本错误,或者 api 调用失败时,会触发 onError 并带上错误信息 二、学习资料 微信小程序开发资源汇总:https://github.com/justjavac/awesome-wechat-weapp WeUI,微信官方的组件库:https://github.com/Tencent/weui 三、一点想法 个人身份可以申请注册小程序,权限还是很多的,除了支付、实时视频,其它基本都支持 微信小程序解决我们我不想安装过多APP的痛点,无需安装,前途还是很看好的,最近微信推出了小程序广告,想变现的抓紧了 虽然小程序发布不久,但是现在不管官方还是社区对微信小程序的生态是十分有友好的,比如除官方提供了还算好用的IDE,其它IDE比如VSCode/Intellij都有插件对小程序予以支持;同时社区里面又很热开发面向小程序的UI库、开发框架(比如支持Vue的mpvue) 加我微信,获取最新推送 加我微信

优秀的个人博客,低调大师

零基础进行神经网络语言建模

更多深度文章,请关注:https://yq.aliyun.com/cloud 语言模型是自然语言处理领域的基础问题,其在词性标注、句法分析、机器翻译、信息检索等任务中起到了重要作用。简而言之,统计语言模型表示为:在词序列中,给定一个词和上下文中所有词,这个序列出现的概率。例如:你手机上键盘上方正显示的三个字,系统试图预测你要输入的下一个字词就是语言建模的用途之一。在下面所示的情况下,语言模型预测“from”,“on”和“it”在给定句子中具有很高的下一个单词的可能性。其实输入法系统内部,语言模型都会计算词汇中的每个单词的出现的概率,但是用户只能看到前三个最可能的单词。 语言模型是许多系统的基本部分,它试图解决机器翻译和语音识别等自然语言处理任务。目前,所有的最先进的语言模型都是神经网络。 这篇文章的第一部分提供了一个简单的前馈神经网络来

优秀的个人博客,低调大师

干货分享 | 深度学习零基础进阶大法!

pixabay 编者按:新手上路都会有一个疑问,如果自己没有相关基础,如何学习晦涩的专业知识?此前雷锋网编译了《从0到1:我是如何在一年内无师自通机器学习的?》,这篇文章讲述了 Per Harald Borgen 的自学历程。而关于深度学习,GitHub的 songrotek 同样有话要说。原文名为《Deep Learning Papers Reading Roadmap》,雷锋网奕欣及老吕IO整理编译,未经许可不得转载。 0. 深度学习的“圣经” 提到入门级的书,就不得不提这一本 Bengio Yoshua,Ian J. Goodfellow 和 Aaron Courville共同撰写的《深度学习》(Deep Learning)。 “这本关于深度学习的教课书是一本为了帮助学生及从业者入门机器学习,并专注于深度学习领域的教材。”值得一提的

优秀的个人博客,低调大师

黑莓Android安全补丁推送保持零延迟

黑莓转攻Android系统之后,仍然保持了对于安全性的高度关注。最近黑莓就发布了一张Android安全更新的推进表,以展示自己的对安全的重视。 在这张表中,分别标识了各手机在Android每月例行安全更新事宜上的落实情况,其中绿色部分表示在公布和补丁可用之间毫无延迟,黄色部分表示补丁在漏洞曝光后一周内推出,而红色则意味着超过一周。 相关数据 而黑莓自家的PRIV则始终保持领延迟更新。黑莓表示:“对于每个原始设备制造商来说,我们都参考了它们的最佳状况,即设备最早接收到安全补丁的那次”。最后还是黑莓的情况最好。 谷歌在之前宣布为Android推出每月例行安全更新,提醒设备厂商们能够迅速跟进,但是由于种种原因,并非所有厂商都能实现的很好,通常都要延期数周。 不过一向以安全为卖点的黑莓在这件事上从不马虎,也激励更多的设备商能够将安全更新尽快推送给用户。 本文转自d1net(转载)

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册