首页 文章 精选 留言 我的

精选列表

搜索[阿里巴巴],共6868篇文章
优秀的个人博客,低调大师

品《阿里巴巴大数据实践-大数据之路》一书(下)

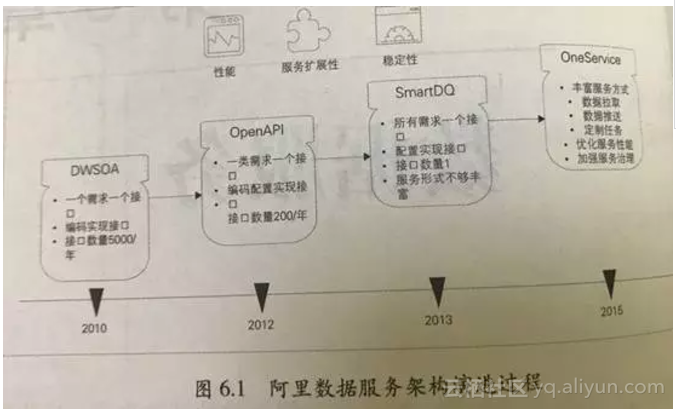
今天继续谈阿里的这本书,包括数据服务平台、数据挖掘平台、数据建模、数据管理及数据应用,希望于你有启示。 1、数据服务平台 数据服务平台可以叫数据开放平台,数据部门产出海量数据,如何能方便高效地开放出去,是我们一直要解决的难题,在没有数据服务的年代,阿里的数据开放的方式简单、粗暴,一般是直接将数据导出给对方,我想,现在大多公司的开放应该也是如此吧,虽然PaaS喊了这么多年,但真正成就的又有几个? 即使如阿里,在数据开放这个方向上的探索和实践,至今也有7个年头了,任何关于数据开放毕其功于一役的做法都将失败,任何一次数据开放的改进都是伴随着对于业务理解的深入而成长起来的。 阿里的数据开放经历四个阶段,DWSOA、OpenAPI、SmartDQ和OneService: DWSOA:是数据服务的第一个阶段,也就是将业务方对数据的需求通过SOA服务的方

优秀的个人博客,低调大师

阿里巴巴最新开源项目 - [HandyJSON] 在Swift中优雅地处理JSON

项目名称:HandyJSON 项目地址:https://github.com/alibaba/handyjson 背景 JSON是移动端开发常用的应用层数据交换协议。最常见的场景便是,客户端向服务端发起网络请求,服务端返回JSON文本,然后客户端解析这个JSON文本,再把对应数据展现到页面上。 但在编程的时候,处理JSON是一件麻烦事。在不引入任何轮子的情况下,我们通常需要先把JSON转为Dictionary,然后还要记住每个数据对应的Key,用这个Key在Dictionary中取出对应的Value来使用。这个过程我们会犯各种错误: Key拼写错了; 路径写错了; 类型搞错了; 没拿到值懵逼了; 某一天和服务端约定的某个字段变更了,没能更新所有用到它的地方; ... 为了解决这些问题,很多处理JSON的开源库应运而生。在Swift中,这些开源库主要朝着两个方向努力: 保持JSON语义,直接解析JSON,但通过封装使调用方式更优雅、更安全; 预定义Model类,将JSON反序列化为类实例,再使用这些实例; 对于1,使用最广、评价最好的库非 SwiftyJSON 莫属,它很能代表这个方向的核心。它本质上仍然是根据JSON结构去取值,使用起来顺手、清晰。但也正因如此,这种做法没能妥善解决上述的几个问题,因为Key、路径、类型仍然需要开发者去指定; 对于2,我个人觉得这是更合理的方式。由于Model类的存在,JSON的解析和使用都受到了定义的约束,只要客户端和服务端约定好了这个Model类,客户端定义后,在业务中使用数据时就可以享受到语法检查、属性预览、属性补全等好处,而且一旦数据定义变更,编译器会强制所有用到的地方都改过来才能编译通过,非常安全。这个方向上,开源库们做的工作,主要就是把JSON文本反序列化到Model类上了。这一类JSON库有 ObjectMapper、JSONNeverDie、HandyJSON 等。而 HandyJSON 是其中使用最舒服的一个库,本文将介绍用 HandyJSON 来进行Model和JSON间的互相转换。 为什么用HandyJSON 在Swift中把JSON反序列化到Model类,在HandyJSON出现以前,主要使用两种方式: 让Model类继承自NSObject,然后class_copyPropertyList()方法获取属性名作为Key,从JSON中取得Value,再通过Objective-C runtime支持的KVC机制为类属性赋值;如JSONNeverDie; 支持纯Swift类,但要求开发者实现Mapping函数,使用重载的运算符进行赋值,如ObjectMapper; 这两者都有显而易见的缺点。前者要求Model继承自NSObject,非常不优雅,且直接否定了用struct来定义Model的方式;后者的Mapping函数要求开发者自定义,在其中指明每个属性对应的JSON字段名,代码侵入大,且仍然容易发生拼写错误、维护困难等问题。 而HandyJSON独辟蹊径,采用Swift反射+内存赋值的方式来构造Model实例,规避了上述两个方案遇到的问题。 把JSON转换为Model 简单类型 某个Model类想支持通过HandyJSON来反序列化,只需要在定义时,实现HandyJSON协议,这个协议只要求实现一个空的init()函数。 比如我们和服务端约定了一个Animal数据,里面有name/id/num字段,那么我们这样定义Animal类: class Animal: HandyJSON { var name: String? var id: String? var num: Int? required init() {} // 如果定义是struct,连init()函数都不用声明; } 然后假设我们从服务端拿到这样一个JSON文本: let jsonString = "{\"name\":\"cat\",\"id\":\"12345\",\"num\":180}" 引入HandyJSON以后,我们就可以这样来做反序列化了: if let animal = JSONDeserializer<Animal>.deserializeFrom(json: jsonString) { print(animal.name) print(animal.id) print(animal.num) } 简单吧~ 比较复杂的类型 HandyJSON支持在类定义里使用各种形式的基本属性,包括可选(?),隐式解包可选(!),数组(Array),字典(Dictionary),Objective-C基本类型(NSString、NSNumber),各种类型的嵌套([Int]?、[String]?、[Int]!、...)等等。比如下面这个看起来比较复杂的类型: struct Cat: HandyJSON { var id: Int64! var name: String! var friend: [String]? var weight: Double? var alive: Bool = true var color: NSString? } 一样轻松转换: let jsonString = "{\"id\":1234567,\"name\":\"Kitty\",\"friend\":[\"Tom\",\"Jack\",\"Lily\",\"Black\"],\"weight\":15.34,\"alive\":false,\"color\":\"white\"}" if let cat = JSONDeserializer<Cat>.deserializeFrom(json: jsonString) { print(cat.xxx) } 嵌套的Model类 如果Model类中的某个属性是另一个自定义的Model类,那么只要那个Model类也实现了HandyJSON协议,就一样可以转换: struct Component: HandyJSON { var aInt: Int? var aString: String? } struct Composition: HandyJSON { var aInt: Int? var comp1: Component? var comp2: Component? } let jsonString = "{\"num\":12345,\"comp1\":{\"aInt\":1,\"aString\":\"aaaaa\"},\"comp2\":{\"aInt\":2,\"aString\":\"bbbbb\"}}" if let composition = JSONDeserializer<Composition>.deserializeFrom(json: jsonString) { print(composition) } 指定反序列化JSON中某个节点 有时候服务端返回给我们的JSON文本包含了大量的状态信息,和Model无关,比如statusCode,debugMessage等,或者有用的数据是在某个节点以下,那么我们可以指定反序列化哪个节点: struct Cat: HandyJSON { var id: Int64! var name: String! } // 服务端返回了这个JSON,我们想解析的只有data里的cat let jsonString = "{\"code\":200,\"msg\":\"success\",\"data\":{\"cat\":{\"id\":12345,\"name\":\"Kitty\"}}}" // 那么,我们指定解析 "data.cat",通过点来表达路径 if let cat = JSONDeserializer<Cat>.deserializeFrom(json: jsonString, designatedPath: "data.cat") { print(cat.name) } 有继承关系的Model类 如果某个Model类继承自另一个Model类,只需要这个父Model类实现HandyJSON协议就可以: class Animal: HandyJSON { var id: Int? var color: String? required init() {} } class Cat: Animal { var name: String? required init() {} } let jsonString = "{\"id\":12345,\"color\":\"black\",\"name\":\"cat\"}" if let cat = JSONDeserializer<Cat>.deserializeFrom(json: jsonString) { print(cat) } 自定义解析方式 HandyJSON还提供了一个扩展能力,就是允许自行定义Model类某个字段的解析Key、解析方式。我们经常会有这样的需求: 某个Model中,我们不想使用和服务端约定的key作为属性名,想自己定一个; 有些类型如enum、tuple是无法直接从JSON中解析出来的,但我们在Model类中有这样的属性; HandyJSON协议提供了一个可选的mapping()函数,我们可以在其中指定某个字段用什么Key、或者用什么方法从JSON中解析出它的值。如我们有一个Model类和一个服务端返回的JSON串: class Cat: HandyJSON { var id: Int64! var name: String! var parent: (String, String)? required init() {} } let jsonString = "{\"cat_id\":12345,\"name\":\"Kitty\",\"parent\":\"Tom/Lily\"}" 可以看到,Cat类的id属性和JSON文本中的Key是对应不上的;而对于parent这个属性来说,它是一个元组,做不到从JSON中的"Tom/Lily"解析出来。所以我们要定义一个Mapping函数来做这两个支持: class Cat: HandyJSON { var id: Int64! var name: String! var parent: (String, String)? required init() {} func mapping(mapper: HelpingMapper) { // 指定 id 字段用 "cat_id" 去解析 mapper.specify(property: &id, name: "cat_id") // 指定 parent 字段用这个方法去解析 mapper.specify(property: &parent) { (rawString) -> (String, String) in let parentNames = rawString.characters.split{$0 == "/"}.map(String.init) return (parentNames[0], parentNames[1]) } } } 就这样,HandyJSON完美地帮我们进行了JSON到Model类的转换。真是太Handy了。 把Model转换为JSON文本 HandyJSON还提供了把Model类序列化为JSON文本的能力,简直无情。 基本类型 如果只需要进行序列化,那么在定义Model类时,不需要做任何特殊的改动。任何一个类的实例,直接调用HandyJSON的序列化方法去序列化,就能得到JSON字符串了。 class Animal { var name: String? var height: Int? init(name: String, height: Int) { self.name = name self.height = height } } let cat = Animal(name: "cat", height: 30) print(JSONSerializer.serializeToJSON(object: cat)!) print(JSONSerializer.serializeToJSON(object: cat, prettify: true)!) 可以通过prettify参数来指定获得的是否是格式化后的JSON串。 复杂类型 即使Model类中有别的Model类啥的,都一样支持。 enum Gender: String { case Male = "male" case Female = "Female" } struct Subject { var id: Int64? var name: String? init(id: Int64, name: String) { self.id = id self.name = name } } class Student { var name: String? var gender: Gender? var subjects: [Subject]? } let student = Student() student.name = "Jack" student.gender = .Female student.subjects = [Subject(id: 1, name: "math"), Subject(id: 2, name: "English"), Subject(id: 3, name: "Philosophy")] print(JSONSerializer.serializeToJSON(object: student)!) print(JSONSerializer.serializeToJSON(object: student, prettify: true)!) 总结 有了HandyJSON的支持,现在我们可以开心地在Swift中使用JSON了。这个库还在更新中,已经支持了Swift 2.2+, Swift 3.0+。如果大家有什么需求或者建议,快去 https://github.com/alibaba/handyjson 给作者提issue吧~~

优秀的个人博客,低调大师

阿里巴巴 CEO 吴泳铭:AI 泡沫三年内不太存在

11月25日,阿里发布2026财年第二季度财报。财报数据显示,报告期内,阿里经营利润跌85%至53.65亿元,同比少赚近300亿;经调整净利润为104亿元,同比下降72%。AI投入方面,报告期内,在资本开支科目上,过去4个季度,阿里AI+云基础设施累计资本开支约1200亿元,单季资本开支315.01亿元,同比增80.1%,核心投向AI算力基建。 针对上述关注事项,在当日晚间举行的电话会上,阿里集团CEO吴泳铭和阿里中国电商事业群CEO蒋凡等高管,也分享了阿里在AI、云计算和电商业务上的最新进展。 吴泳铭表示,企业对AI应用的需求仍在快速增长,预计未来三年内AI资源仍将处于供不应求状态。吴泳铭同时指出,公司正积极扩充AI基础设施,"此前提到的3800亿元AI投资是三年规划,但目前服务器上架速度仍远远跟不上客户订单增长。"他提到,如果现有节奏仍不足以支撑增长,可能会进一步加大投资。 对于当下讨论较多的AI泡沫问题,吴泳铭认为,未来三年AI需求仍具确定性,驱动因素主要包括基座模型、视频生成模型及全模态模型能力持续提升,以及AI任务在各行业的渗透率不断扩大,"从今年下半年起,AI服务器普遍缺货,供应链扩产需两到三年才能缓解,未来三年AI资源仍将供不应求,我认为,所谓AI泡沫三年内不太存在。" 来源:https://baijiahao.baidu.com/s?id=1849781130134033820&wfr=spider&for=pc

优秀的个人博客,低调大师

阿里巴巴大规模应用Flink的踩坑经验:如何大幅降低 HDFS 压力?

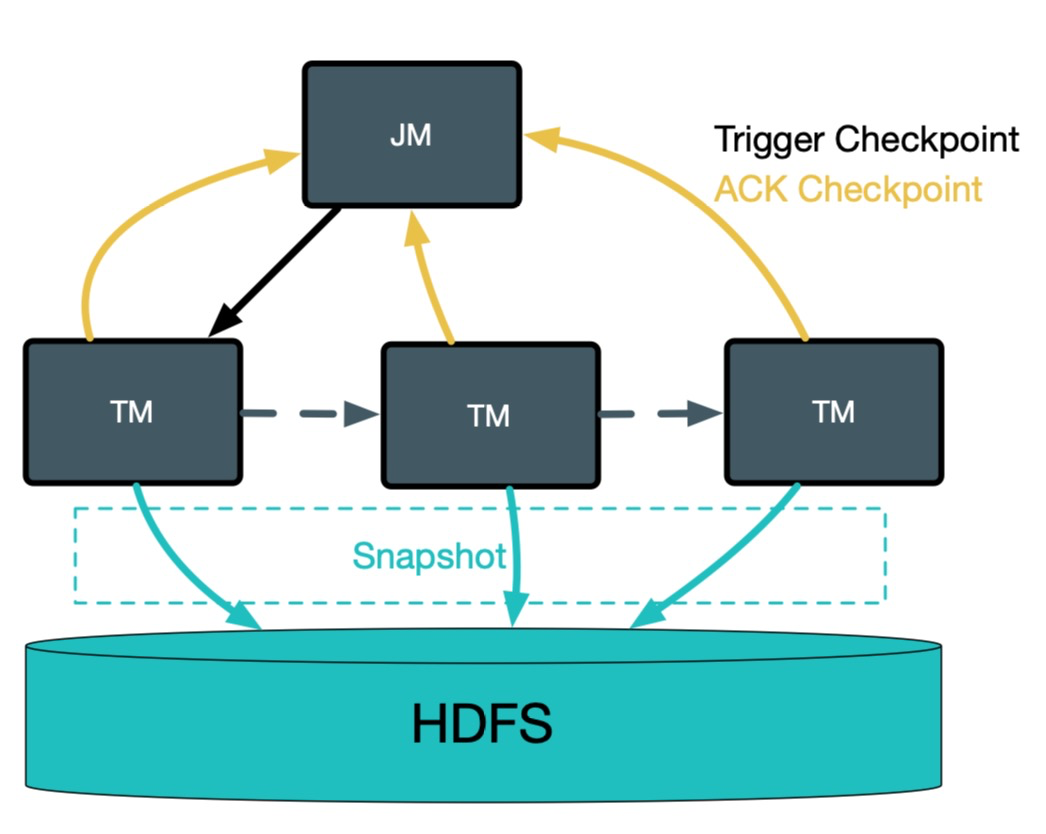
作者:邱从贤(山智) 众所周知 Flink 是当前广泛使用的计算引擎,Flink 使用 checkpoint 机制进行容错处理[1],Flink 的 checkpoint 会将状态快照备份到分布式存储系统,供后续恢复使用。在 Alibaba 内部我们使用的存储主要是 HDFS,当同一个集群的 Job 到达一定数量后,会对 HDFS 造成非常大的压力,本文将介绍一种大幅度降低 HDFS 压力的方法 -- 小文件合并。 背景 不管使用 FsStateBackend、RocksDBStateBackend 还是 NiagaraStateBackend,Flink 在进行 checkpoint 的时候,TM 会将状态快照写到分布式文件系统中,然后将文件句柄发给 JM,JM 完成全局 checkpoint 快照的存储,如下图所示。 对于全量 checkpoint 来说,TM 将每个 checkpoint 内部的数据都写到同一个文件,而对于 RocksDBStateBackend/NiagaraStateBackend 的增量 checkpoint [2]来说,则会将每个 sst 文件写到一个分布式系统的文件内。当作业量很大,且作业的并发很大时,则会对底层 HDFS 形成非常大的压力:1)大量的 RPC 请求会影响 RPC 的响应时间(如下图所示);2)大量文件对 NameNode 内存造成很大压力。 在 Flink 中曾经尝试使用 ByteStreamStateHandle 来解决小文件多的问题[3],将小于一定阈值的 state 直接发送到 JM,由 JM 统一写到分布式文件中,从而避免在 TM 端生成小文件。但是这个方案有一定的局限性,阈值设置太小,还会有很多小文件生成,阈值设置太大,则会导致 JM 内存消耗太多有 OOM 的风险。 1 小文件合并方案 针对上面的问题我们提出一种解决方案 -- 小文件合并。在原来的实现中,每个 sst 文件会打开一个 CheckpointOutputStream,每个 CheckpointOutputStream 对应一个 FSDataOutputStream,将本地文件写往一个分布式文件,然后关闭 FSDataOutputStream,生成一个 StateHandle。如下图所示: 小文件合并则会重用打开的 FSDataOutputStream,直至文件大小达到预设的阈值为止,换句话说多个 sst 文件会重用同一个 DFS 上的文件,每个 sst 文件占用 DFS 文件中的一部分,最终多个 StateHandle 共用一个物理文件,如下图所示。 在接下来的章节中我们会描述实现的细节,其中需要重点考虑的地方包括: 并发 checkpoint 的支持 Flink 天生支持并发 checkpoint,小文件合并方案则会将多个文件写往同一个分布式存储文件中,如果考虑不当,数据会写串或者损坏,因此我们需要有一种机制保证该方案的正确性,详细描述参考 2.1 节 防止误删文件 我们使用引用计数来记录文件的使用情况,仅通过文件引用计数是否降为 0 进行判断删除,则可能误删文件,如何保证文件不会被错误删除,我们将会在 2.2 节进行阐述 降低空间放大 使用小文件合并之后,只要文件中还有一个 statehandle 被使用,整个分布式文件就不能被删除,因此会占用更多的空间,我们在 2.3 节描述了解决该问题的详细方案 异常处理 我们将在 2.4 节阐述如何处理异常情况,包括 JM 异常和 TM 异常的情况 2.5 节中会详细描述在 Checkpoint 被取消或者失败后,如何取消 TM 端的 Snapshot,如果不取消 TM 端的 Snapshot,则会导致 TM 端实际运行的 Snapshot 比正常的多 在第 3 节中阐述了小文件合并方案与现有方案的兼容性;第 4 节则会描述小文件合并方案的优势和不足;最后在第 5 节我们展示在生产环境下取得的效果。 2 设计实现 本节中我们会详细描述整个小文件合并的细节,以及其中的设计要点。这里我们大致回忆一下 TM 端 Snapshot 的过程 TM 端 barrier 对齐 TM Snapshot 同步操作 TM Snapshot 异步操作 其中上传 sst 文件到分布式存储系统在上面的第三步,同一个 checkpoint 内的文件顺序上传,多个 checkpoint 的文件上传可能同时进行。 2.1 并发 checkpoint 支持 Flink 天生支持并发 checkpoint,因此小文件合并方案也需要能够支持并发 checkpoint,如果不同 checkpoint 的 sst 文件同时写往一个分布式文件,则会导致文件内容损坏,后续无法从该文件进行 restore。 在 FLINK-11937[4] 的提案中,我们会将每个 checkpoint 的 state 文件写到同一个 HDFS 文件,不同 checkpoint 的 state 写到不同的 HDFS 文件 -- 换句话说,HDFS 文件不跨 Checkpoint 共用,从而避免了多个客户端同时写入同一个文件的情况。 后续我们会继续推进跨 Checkpoint 共用文件的方案,当然在跨 Checkpoint 共用文件的方案中,并行的 Checkpoint 也会写往不同的 HDFS 文件。 2.2 防止误删文件 复用底层文件之后,我们使用引用计数追踪文件的使用情况,在文件引用数降为 0 的情况下删除文件。但是在某些情况下,文件引用数为 0 的时候,并不代表文件不会被继续使用,可能导致文件误删。下面我们会详>细描述开启并发 checkpoint 后可能导致文件误删的情况,以及解决方案。 我们以下图为例,maxConcurrentlyCheckpoint = 2 上图中共有 3 个 checkpoint,其中 chk-1 已经完成,chk-2 和 chk-3 都基于 chk-1 进行,chk-2 在 chk-3 前完成,chk-3 在注册 4.sst 的时候发现,发现 4.sst 在 chk-2 中已经注册过,会重用 chk-2 中 4.sst 对应的 stateHandle,然后取消 chk-3 中的 4.sst 的注册,并且删除 stateHandle,在处理完 chk-3 中 4.sst 之后,该 stateHandle 对应的分布式文件的引用计数为 0,如果我们这个时候删除分布式文件,则会同时删除 5.sst 对应的内容,导致后续无法从 chk-3 恢复。 这里的问题是如何在 stateHandle 对应的分布式文件引用计数降为 0 的时候正确判断是否还会继续引用该文件,因此在整个 checkpoint 完成处理之后再判断某个分布式文件能否删除,如果真个 checkpoint 完成发现文件没有被引用,则可以安全删除,否则不进行删除。 2.3 降低空间放大 使用小文件合并方案后,每个 sst 文件对应分布式文件中的一个 segment,如下图所示 文件仅能在所有 segment 都不再使用时进行删除,上图中有 4 个 segment,仅 segment-4 被使用,但是整个文件都不能删除,其中 segment[1-3] 的空间被浪费掉了,从实际生产环境中的数据可知,整体的空间放大率(实际占用的空间 / 真实有用的空间)在 1.3 - 1.6 之间。 为了解决空间放大的问题,在 TM 端起异步线程对放大率超过阈值的文件进行压缩。而且仅对已经关闭的文件进行压缩。 整个压缩的流程如下所示: 计算每个文件的放大率 如果放大率较小则直接跳到步骤 7 如果文件 A 的放大率超过阈值,则生成一个对应的新文件 A‘(如果这个过程中创建文件失败,则由 TM 负责清理工作) 记录 A 与 A’ 的映射关系 在下一次 checkpoint X 往 JM 发送落在文件 A 中的 StateHandle 时,则使用 A` 中的信息生成一个新的 StateHandle 发送给 JM checkpoint X 完成后,我们增加 A‘ 的引用计数,减少 A 的引用计数,在引用计数降为 0 后将文件 A 删除(如果 JM 增加了 A’ 的引用,然后出现异常,则会从上次成功的 checkpoint 重新构建整个引用计数器) 文件压缩完成 2.4 异常情况处理 在 checkpoint 的过程中,主要有两种异常:JM 异常和 TM 异常,我们将分情况阐述。 2.4.1 JM 异常 JM 端主要记录 StateHandle 以及文件的引用计数,引用计数相关数据不需要持久化到外存中,因此不需要特殊的处理,也不需要考虑 transaction 等相关操作,如果 JM 发送 failover,则可以直接从最近一次 complete checkpoint 恢复,并重建引用计数即可。 2.4.2 TM 异常 TM 异常可以分为两种:1)该文件在之前 checkpoint 中已经汇报过给 JM;2)文件尚未汇报过给 JM,我们会分情况阐述。 文件已经汇报过给 JM文件汇报过给 JM,因此在 JM 端有文件的引用计数,文件的删除由 JM 控制,当文件的引用计数变为 0 之后,JM 将删除该文件。 文件尚未汇报给 JM该文件暂时尚未汇报过给 JM,该文件不再被使用,也不会被 JM 感知,成为孤儿文件。这种情况暂时有外围工具统一进行清理。 2.5 取消 TM 端 snapshot 像前面章节所说,我们需要在 checkpoint 超时/失败时,取消 TM 端的 snapshot,而 Flink 则没有相应的通知机制,现在 FLINK-8871[5] 在追踪相应的优化,我们在内部增加了相关实现,当 checkpoint 失败时会发送 RPC 数据给 TM,TM 端接受到相应的 RPC 消息后,会取消相应的 snapshot。 3 兼容性 小文件合并功能支持从之前的版本无缝迁移过来。从之前的 checkpoint restore 的的步骤如下: 每个 TM 分到自己需要 restore 的 state handle TM 从远程下载 state handle 对应的数据 从本地进行恢复 小文件合并主要影响的是第 2 步,从远程下载对应数据的时候对不同的 StateHandle 进行适配,因此不影响整体的兼容性。 4 优势和不足 优势:大幅度降低 HDFS 的压力:包括 RPC 压力以及 NameNode 内存的压力 不足:不支持 State 多线程上传的功能(State 上传暂时不是 checkpoint 的瓶颈) 5 线上环境的结果 在该方案上线后,对 Namenode 的压力大幅降低,下面的截图来自线上生产集群,从数据来看,文件创建和关闭的 RPC 有明显下降,RPC 的响应时间也有大幅度降低,确保顺利度过双十一。 参考文献 [1] https://ci.apache.org/projects/flink/flink-docs-stable/ops/state/checkpoints.html [2] https://flink.apache.org/features/2018/01/30/incremental-checkpointing.html [3] https://www.slideshare.net/dataArtisans/stephan-ewen-experiences-running-flink-at-very-large-scale [4] https://issues.apache.org/jira/browse/FLINK-11937 [5] https://issues.apache.org/jira/browse/FLINK-8871

优秀的个人博客,低调大师

首次揭秘:阿里巴巴中间件在 Serverless 技术领域的探索

Serverless 话题涉及范围极广,几乎包含了代码管理、测试、发布、运维和扩容等与应用生命周期关联的所有环节。AWS Lambda 是Serverless 领域的标志性产品,但如果将其应用于核心业务,可能会遇到以下难题:(仅代表作者个人观点)首度揭秘: 要求用户以 Function 为单位进行开发,全新的开发框架,云厂商强绑定,社区主流技术栈迁移成本高; Function 启动速度要足够快,毫秒级或者秒级,这个限制对适用场景有很强的约束; Function 之间的调用通过 API Gateway,响应时间更长。 本文将介绍阿里云中间件团队在探索Serverless 过程中的思考以及正在做的事,目的是尽可能让开发者少改代码,甚至不改代码,就能具备 AWS Lambda 的技术优势。Cloud Service Engine 云服务引

优秀的个人博客,低调大师

阿里巴巴 Aliexpress 数据智能部 诚招 Java资深开发工程师/技术专家

职位名称:Aliexpress-Java资深开发工程师/技术专家 所属部门:阿里集团-AliExpress-数据智能部 期望层级:P6及以上 学历要求:第一学历必须是本科 其他具体细节 或想问的, 欢迎加 钉钉群 23399869 直接沟通,作者本人是群主。也可 扫码直接加入: 另,前端 、产品、数据开发、数据分析 等职位同样也有职位空缺。 团队介绍:数据智能部是于2018年8月新成立的部门,我们为业务提供端到端的解决方案,所以数据智能部几乎囊括了数据全部职能,包括的角色有数据增长(数据分析师),数据PD,数据研发前后端工程师,数据建模工程师,数据科学;我们的目标是数据智能化AliExpress;我们的工作围绕四个方向展开,一是构建AE全域的数据体系;二是把数据体系线上服务化,数据就像水电煤一样即拿即用;三是逐步从点

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册