首页 文章 精选 留言 我的

精选列表

搜索[小微模型],共10000篇文章
优秀的个人博客,低调大师

Docker命令小总结

attach Attach to a running container # 当前 shell 下 attach 连接指定运行镜像 build Build an image from a Dockerfile # 通过 Dockerfile 定制镜像 commit Create a new image from a container changes # 提交当前容器为新的镜像 cp Copy files/folders from the containers filesystem to the host path #从容器中拷贝指定文件或者目录到宿主机中 create Create a new container # 创建一个新的容器,同 run,但不启动容器 diff Inspect changes on a container's filesystem # 查看 docker 容器变化 events Get real time events from the server # 从 docker 服务获取容器实时事件 exec Run a command in an existing container # 在已存在的容器上运行命令 export Stream the contents of a container as a tar archive # 导出容器的内容流作为一个 tar 归档文件[对应 import ] history Show the history of an image # 展示一个镜像形成历史 images List images # 列出系统当前镜像 import Create a new filesystem image from the contents of a tarball # 从tar包中的内容创建一个新的文件系统映像[对应export] info Display system-wide information # 显示系统相关信息 inspect Return low-level information on a container # 查看容器详细信息 kill Kill a running container # kill 指定 docker 容器 load Load an image from a tar archive # 从一个 tar 包中加载一个镜像[对应 save] login Register or Login to the docker registry server # 注册或者登陆一个 docker 源服务器 logout Log out from a Docker registry server # 从当前 Docker registry 退出 logs Fetch the logs of a container # 输出当前容器日志信息 port Lookup the public-facing port which is NAT-ed to PRIVATE_PORT # 查看映射端口对应的容器内部源端口 pause Pause all processes within a container # 暂停容器 ps List containers # 列出容器列表 pull Pull an image or a repository from the docker registry server # 从docker镜像源服务器拉取指定镜像或者库镜像 push Push an image or a repository to the docker registry server # 推送指定镜像或者库镜像至docker源服务器 restart Restart a running container # 重启运行的容器 rm Remove one or more containers # 移除一个或者多个容器 rmi Remove one or more images # 移除一个或多个镜像[无容器使用该镜像才可删除,否则需删除相关容器才可继续或 -f 强制删除] run Run a command in a new container # 创建一个新的容器并运行一个命令 save Save an image to a tar archive # 保存一个镜像为一个 tar 包[对应 load] search Search for an image on the Docker Hub # 在 docker hub 中搜索镜像 start Start a stopped containers # 启动容器 stop Stop a running containers # 停止容器 tag Tag an image into a repository # 给源中镜像打标签 top Lookup the running processes of a container # 查看容器中运行的进程信息 unpause Unpause a paused container # 取消暂停容器 version Show the docker version information # 查看 docker 版本号 wait Block until a container stops, then print its exit code # 截取容器停止时的退出状态值

优秀的个人博客,低调大师

Go语言小技巧

1 反射 val := reflect.ValueOf(v) kind := val.Kind() if kind == reflect.String { pValue := val.String() } else if kind == reflect.Int || kind == reflect.Int8 || kind == reflect.Int16 || kind == reflect.Int32 || kind == reflect.Int64 { pValueInt := val.Int() pValue := strconv.FormatInt(pValueInt, 10) } else if kind == reflect.Float32 || kind == reflect.Float64 { pValueFloat := val.Float() pValue := strconv.FormatFloat(pValueFloat, 'f', -1, 64) } else if kind == reflect.Slice { vSlice, ok := v.([]interface{}) if ok { } } else if kind == reflect.Map { vMap, ok := v.(map[string]interface{}) if ok { } }

优秀的个人博客,低调大师

Kubernetes知识小普及

大部分概念Kubernetes官网都有详细介绍,Kubernetes中文官网 https://kubernetes.io/zh/docs/tutorials/kubernetes-basics/ 官网还提供一个比较好的功能是能在线互动,见互动教程,类似实操命令初步感受。 Kubernetes主要功能 基于容器的应用部署、维护和滚动升级 负载均衡和服务发现 跨机器和跨地区的集群调度 自动伸缩 无状态服务和有状态服务 广泛的 Volume 支持 插件机制保证扩展性 Kubernetes是谷歌开源的容器集群管理系统 Kubernetes 提供了很多的功能,它可以简化应用程序的工作流,加快开发速度。使用Kubernetes只需一个部署文件,使用一条命令就可以部署多层容器(前端,后台等)的完整集群。 核心概念 Kubernetes 主要由以下几个核心组件组成: etcd 保存了整个集群的状态; apiserver 提供了资源操作的唯一入口,并提供认证、授权、访问控制、API 注册和发现等机制; controller manager 负责维护集群的状态,比如故障检测、自动扩展、滚动更新等; scheduler 负责资源的调度,按照预定的调度策略将 Pod 调度到相应的机器上; kubelet 负责维护容器的生命周期,同时也负责 Volume(CVI)和网络(CNI)的管理; Container runtime 负责镜像管理以及 Pod 和容器的真正运行(CRI); kube-proxy 负责为 Service 提供 cluster 内部的服务发现和负载均衡 典型的Kubernetes架构图 上图可以看到如下组件,使用特别的图标表示Service和Label: Pod Container(容器) Label()(标签) Replication Controller(复制控制器) Service()(服务) Node(节点) Kubernetes Master(Kubernetes主节点) Pod Pod在节点上,包含一组容器和卷。同一个Pod里的容器共享同一个网络命名空间,可以使用localhost互相通信。Pod是短暂的,不是持续性实体。如果Pod是短暂的,那么我怎么才能持久化容器数据使其能够跨重启而存在呢? Kubernetes支持卷的概念,因此可以使用持久化的卷类型。如果Pod是短暂的,那么重启时IP地址可能会改变,那么怎么才能从前端容器正确可靠地指向后台容器呢?这时可以使用Service。 Lable 一些Pod有Label。一个Label是attach到Pod的一对键/值对,用来传递用户定义的属性。比如,你可能创建了一个"tier"和“app”标签,通过Label(tier=frontend, app=myapp)来标记前端Pod容器,使用Label(tier=backend, app=myapp)标记后台Pod。然后可以使用Selectors选择带有特定Label的Pod,并且将Service或者Replication Controller应用到上面。 Replication Controller Replication Controller确保任意时间都有指定数量的Pod“副本”在运行。如果为某个Pod创建了Replication Controller并且指定3个副本,它会创建3个Pod,并且持续监控它们。如果某个Pod不响应,那么Replication Controller会替换它,保持总数为3.如下面的动画所示: 如果之前不响应的Pod恢复了,现在就有4个Pod了,那么Replication Controller会将其中一个终止保持总数为3。如果在运行中将副本总数改为5,Replication Controller会立刻启动2个新Pod,保证总数为5。还可以按照这样的方式缩小Pod,这个特性在执行滚动升级时很有用。 当创建Replication Controller时,需要指定两个东西: Pod模板:用来创建Pod副本的模板 Label:Replication Controller需要监控的Pod的标签。 现在已经创建了Pod的一些副本,那么在这些副本上如何均衡负载呢?我们需要的是Service。 Service Service是定义一系列Pod以及访问这些Pod的策略的一层抽象。Service通过Label找到Pod组。因为Service是抽象的,所以在图表里通常看不到它们的存在,这也就让这一概念更难以理解。 假定有2个后台Pod,并且定义后台Service的名称为‘backend-service’,lable选择器为(tier=backend, app=myapp)。backend-service的Service会完成如下两件重要的事情: 会为Service创建一个本地集群的DNS入口,因此前端Pod只需要DNS查找主机名为 ‘backend-service’,就能够解析出前端应用程序可用的IP地址。 现在前端已经得到了后台服务的IP地址,但是它应该访问2个后台Pod的哪一个呢?Service在这2个后台Pod之间提供透明的负载均衡,会将请求分发给其中的任意一个(如下面的动画所示)。通过每个Node上运行的代理(kube-proxy)完成。这里有更多技术细节。 如果不进入网络配置,那么达到透明的负载均衡目标所涉及的底层网络和路由相对先进。 有一个特别类型的Kubernetes Service,称为'LoadBalancer',作为外部负载均衡器使用,在一定数量的Pod之间均衡流量。比如,对于负载均衡Web流量很有用。 Pod与Service 每个Pod都提供了一个独立的Endpoint(Pod IP+ContainerPort)以被客户端访问,多个Pod副本组成了一个集群来提供服务,一般的做法是部署一个负载均衡器来访问它们,为这组Pod开启一个对外的服务端口如8000,并且将这些Pod的Endpoint列表加入8000端口的转发列表中,客户端可以通过负载均衡器的对外IP地址+服务端口来访问此服务。运行在Node上的kube-proxy其实就是一个智能的软件负载均衡器,它负责把对Service的请求转发到后端的某个Pod实例上,并且在内部实现服务的负载均衡与会话保持机制。Service不是共用一个负载均衡器的IP地址,而是每个Servcie分配一个全局唯一的虚拟IP地址,这个虚拟IP被称为Cluster IP。 Node IP Node节点的IP地址,是Kubernetes集群中每个节点的物理网卡的IP地址,是真是存在的物理网络,所有属于这个网络的服务器之间都能通过这个网络直接通信; Pod IP Pod的IP地址,是Docker Engine根据docker0网桥的IP地址段进行分配的,通常是一个虚拟的二层网络,位于不同Node上的Pod能够彼此通信,需要通过Pod IP所在的虚拟二层网络进行通信,而真实的TCP流量则是通过Node IP所在的物理网卡流出的; Cluster IP Service的IP地址。特性如下: 仅仅作用于Kubernetes Servcie这个对象,并由Kubernetes管理和分配IP地址; 无法被Ping,因为没有一个“实体网络对象”来响应; 只能结合Service Port组成一个具体的通信端口; Node IP网、Pod IP网域Cluster IP网之间的通信,采用的是Kubernetes自己设计的一种编程方式的特殊的路由规则,与IP路由有很大的不同; Node 节点(上图橘色方框)是物理或者虚拟机器,作为Kubernetes worker,通常称为Minion。每个节点都运行如下Kubernetes关键组件: Kubelet:是主节点代理。 Kube-proxy:Service使用其将链接路由到Pod,如上文所述。 Docker或Rocket:Kubernetes使用的容器技术来创建容器。 Kubernetes Master 集群拥有一个Kubernetes Master。Kubernetes Master提供集群的独特视角,并且拥有一系列组件,比如Kubernetes API Server。API Server提供可以用来和集群交互的REST端点。master节点包括用来创建和复制Pod的Replication Controller。 应用 Kubernetes进行蓝绿部署 应用程序更新到一个新版本时,部署功能能够帮您对容器进行滚动更新,若有异常可自动回滚。 Kubernetes在腾讯游戏的应用 接入容器数超过两万,接入的业务也有两百多款,包括手游、端游、页游。 基于Kubernetes的Spark集群部署 相比于在物理机上部署,在Kubernetes集群上部署Spark集群,具有以下优势: 快速部署:安装1000台级别的Spark集群,在Kubernetes集群上只需设定worker副本数目replicas=1000,即可一键部署。 快速升级:升级Spark版本,只需替换Spark镜像,一键升级。 弹性伸缩:需要扩容、缩容时,自动修改worker副本数目replicas即可。 高一致性:各个Kubernetes节点上运行的Spark环境一致、版本一致 高可用性:如果Spark所在的某些node或pod死掉,Kubernetes会自动将计算任务,转移到其他node或创建新pod。 强隔离性:通过设定资源配额等方式,可与WebService应用部署在同一集群,提升机器资源使用效率,从而降低服务器成本。 Kubernetes、Docker Swarm、 Mesos 网易云容器如何解决Kubernetes在公有云上的问题 微服务持续集成 Spring Cloud + GitLab + Docker + K8S 微服务组成:Gateway api网关>消费端>服务端 和 一个注册中心,共4个Spring Boot项目 Kubernetes实际要用起来问题还有很多,需要躺很多坑,搭建起一套Kubernetes环境就可能会让你从入门到放弃,再接再励。 资料来源: http://www.dockone.io/article/932

优秀的个人博客,低调大师

Python 小入坑

python入坑学习的是python3 一些信息 官网 https://www.python.org/官方文档 https://docs.python.org/3/github https://github.com/python特点 简单,易学,开发快速分类 解释型语言,面向对象,动态数据类型的高级语言,其开源遵守GPL协议。支持多种编程范式, 面向对象,函数,过程,命令式。拥有动态类型系统和垃圾回收功能。创始人 Guido van Rossum 属于高阶动态类型编程语言注:不打算深入学习,基础语法过完,并了解几个框架,一个web框架完成。~ 其中c为低级语言,c++为中级语言,python为高级语言 GPL协议 属于GNU项目的一个分类,由FSF协会撰写。 维基百科 https://en.wikipedia.org/wiki/GNU_General_Public_License 使用的GCC都属于GNU项目里的 关于 Guido van Rossum 推特 https://twitter.com/gvanrossum github https://github.com/gvanrossum 其个人主页 https://gvanrossum.github.io/Resume.html目前在Dropbox, Inc. 安装 从官网上下载python,安装,打开powershell输入 PS C:\Users\mingm\Desktop> python -V Python 3.7.0 由于使用的是3.7版本,所以查看官方的3.7版本的文档 https://docs.python.org/3.7/ hello world 其文件后缀名为py编写py文件 print("hello world"); 编译 PS C:\Users\mingm\Desktop\py> python .\hello.py hello world PS C:\Users\mingm\Desktop\py> 完成输出hello world 基础语法 注释 注释以#开头 行与缩进 用行与缩进代表代码块 多行语句 通常用一行写完一条语句,如果语句很长使用反斜杠表示 同一行显示多条语句 使用分号表示同一行的多条语句 print输出 print输出默认是换行的 导入包 import 和 form ... import举例 import sys # 导入sys模块 for i in sys.argv: print (i) print("\n python 的路径为", sys.path) 关于sys模块https://docs.python.org/3.7/library/sys.html#module-sys 一个用于与解释权进行交互的模块 from sys import argv,path # 从sys模块导入两个函数 即argv函数,以及path函数 print("path:" + path); # 输出函数 命令行参数 使用-h参数,查看命令行的参数 PS C:\Users\mingm\Desktop\py> python -h 基本数据类型 和js一样,属于动态类型的,和Java,c的最大的区别在于属于动态类型的使用type()函数,查找当前的数据类型以及一个isinstance()函数,和type()函数的区别在于会认为子类是一种父类的类型 字符串 str = 'hello world'; print(str); print(str[0:-2]) PS C:\Users\mingm\Desktop\py> python .\hello.py hello world hello wor PS C:\Users\mingm\Desktop\py> 列表 类似于数组 list = ['abcd', 786, 2.23, 'hello world', 70.2]; tinyList = [123, 'hello world']; print(list); print(list[0]); print(list[1:3]); PS C:\Users\mingm\Desktop\py> python .\hello.py ['abcd', 786, 2.23, 'hello world', 70.2] abcd [786, 2.23] PS C:\Users\mingm\Desktop\py> 元组 类似于matlab的元组,不可改变 tuple = ('abcd', 786, 2.23, 'hello world', 70.2); tinytuple = (123, 'hello world'); print(tuple); print(tuple[0]); print(tuple + tinytuple); PS C:\Users\mingm\Desktop\py> python .\hello.py ('abcd', 786, 2.23, 'hello world', 70.2) abcd ('abcd', 786, 2.23, 'hello world', 70.2, 123, 'hello world') PS C:\Users\mingm\Desktop\py> set 集合 数学中的集合概念 student = {'tom', 'Jim', 'Mary', 'Tom'}; print(student); PS C:\Users\mingm\Desktop\py> python .\hello.py {'Jim', 'Tom', 'tom', 'Mary'} PS C:\Users\mingm\Desktop\py> 字典 即 键值对 dict = {}; dict['one'] = "1"; print(dict['one']); PS C:\Users\mingm\Desktop\py> python .\hello.py 1 PS C:\Users\mingm\Desktop\py> 选择 循环 选择 var1 = 100; if var1: print ("true"); var2 = 0; if var2: print ("true"); print("bey!"); PS C:\Users\mingm\Desktop\py> python .\hello.py true bey! PS C:\Users\mingm\Desktop\py> tips: elif 为else if 循环 n = 100; sum = 0; counter = 1; while counter <= n: sum += counter; counter += 1; print("和为%d " % sum); PS C:\Users\mingm\Desktop\py> python .\hello.py 和为5050 PS C:\Users\mingm\Desktop\py> while else 语句 count = 0; while count < 5: print(count, "小于 5"); count += 1; else: print (count, "值大于或等于 5"); PS C:\Users\mingm\Desktop\py> python .\hello.py 0 小于 5 1 小于 5 2 小于 5 3 小于 5 4 小于 5 5 值大于或等于 5 PS C:\Users\mingm\Desktop\py> for 语句 PS C:\Users\mingm\Desktop\py> python .\hello.py C C++ Perl PS C:\Users\mingm\Desktop\py> languages = ["C", "C++", "Perl"]; for x in languages: print (x) range()函数 for i in range(5): print(i) PS C:\Users\mingm\Desktop\py> python .\hello.py 0 1 2 3 4 PS C:\Users\mingm\Desktop\py> >>> list(range(5)); [0, 1, 2, 3, 4] >>> pass语句 pass语句为空语句, ps 用google提供的Puppeteer + koa + mongodb即可完成爬数据到数据库中,并且是无敌滴,管你加密与否,只要能给我显示出来,统统可以爬到手,一切的加密统统实效。! 算了自动化运维还需要py,╮(╯▽╰)╭

优秀的个人博客,低调大师

Python爬虫-小测验

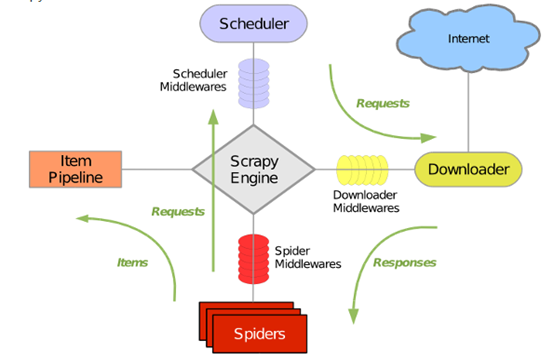
一、 使用scrapy.Selector或BeautifulSoup,实现以下需求(30分) (1)读取给定的dangdang.html页面内容,注:编码为gbk(5分) (2)获取页面中所有图书的名称,价格,作者,出版社及图书图片的url地址(20分) (3)将获取的信息保存至文件(excel、csv、json、txt格式均可)(5分) 网页文件dangdang.html文件下载链接: https://pan.baidu.com/s/1awbG5zqOMdnWzXee7TZm6A 密码: 3urs 1.1使用BeautifulSoup解决 from bs4 import BeautifulSoup as bs import pandas as pd def cssFind(book,cssSelector,nth=1): if len(book.select(cssSelector)) >= nth: return book.select(cssSelector)[nth-1].text.strip() else: return '' if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: html = file.read() soup = bs(html,'lxml') book_list = soup.select("div ul.bigimg li") result_list = [] for book in book_list: item = {} item['name'] = book.select("a.pic")[0]['title'] item['now_price'] = cssFind(book,"span.search_now_price") item['pre_price'] = cssFind(book,"span.search_pre_price") item['author'] = book.select("p.search_book_author a")[0]['title'] item['publisher'] = book.select("p.search_book_author span a")[-1].text item['detailUrl'] = book.select("p.name a")[0]['href'] item['imageUrl'] = book.select("a.pic img")[0]['src'] if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.select("a.pic img")[0]['data-original'] result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 1.2使用scrapy.selector解决 from scrapy.selector import Selector import pandas as pd if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: response = Selector(text=file.read()) book_list = response.xpath("//ul[@class='bigimg']/li") result_list = [] for book in book_list: item = {} item['name'] = book.xpath("a[@class='pic']/@title").extract_first() item['now_price'] = book.xpath(".//span[@class='search_now_price']/text()").extract_first() item['pre_price'] = book.xpath(".//span[@class='search_pre_price']/text()").extract_first() item['author'] = book.xpath("p[@class='search_book_author']//a/@title").extract_first() item['publisher'] = book.xpath("p[@class='search_book_author']//a/@title").extract()[-1] item['detailUrl'] = book.xpath(".//p[@class='name']/a/@href").extract_first() item['imageUrl'] = book.xpath("a[@class='pic']/img/@src").extract_first() if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.xpath("a[@class='pic']/img/@data-original").extract_first() result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 二、 需求:抓取天猫三只松鼠旗舰店超级满减商品信息(55分) 网站地址如下https://sanzhisongshu.tmall.com/p/rd523844.htm?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop 评分标准如下: 1、创建函数获取页面所有内容,代码无误(5分) 2、得到页面内容后解析信息,获取页面中图片链接,并将图片下载至本地photo文件夹。(10分) 3、获取页面中每个商品信息的商品名称、价格以及商品图片url信息(20分) 4、创建数据库product,及表格productinfo,包含(商品名称、价格及图片地址三个字段)(5分) 5、将第(3)步获取的结果写入数据库(10分) 6、代码规范,有注释(5分) import requests from bs4 import BeautifulSoup as bs import urllib import os import pymysql #获取实例化BeautifulSoup对象 def getSoup(url, encoding="gbk", **params): reponse = requests.get(url, **params) reponse.encoding = encoding soup = bs(reponse.text, 'lxml') return soup #下载单个图片函数 def downloadImage(imgUrl, imgName): imgDir = "photo" if not os.path.isdir(imgDir): os.mkdir(imgDir) imgPath = "%s/%s" %(imgDir,imgName) urllib.request.urlretrieve(imgUrl,imgPath) #下载所有图片函数 def downloadAllImages(soup): image_list = soup.select("img") count = 0 for image in image_list: try: srcStr = image['data-ks-lazyload'] imgFormat = srcStr[-3:] if imgFormat == 'gif': continue count += 1 imgName = "%d.%s" % (count, imgFormat) imgUrl = "http:" + srcStr downloadImage(imgUrl, imgName) except Exception as e: print(str(e)) #通过css选择器语法选择出标签 def cssFind(movie,cssSelector,nth=1): if len(movie.select(cssSelector)) >= nth: return movie.select(cssSelector)[nth-1].text.strip() else: return '' #获取数据库连接函数 def getConn(database ="product"): args = dict( host = 'localhost', user = 'root', passwd = '.... your password', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": soup = getSoup("https://sanzhisongshu.tmall.com/p/rd523844.htm" \ "?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop") #下载所有图片 downloadAllImages(soup) #获取数据库连接 conn = getConn() cursor = conn.cursor() #新建数据库中的表productinfo sql_list = [] sql_list.append("drop table if exists productinfo") sql_list.append("create table productinfo(name varchar(200)," \ "price varchar(20),imageUrl varchar(500))") for sql in sql_list: cursor.execute(sql) conn.commit() #获取商品信息并插入数据库 item_list = soup.select("div.item4line1 dl.item") for item in item_list: name = cssFind(item,"dd.detail a") price = cssFind(item,"dd.detail span.c-price") imageUrl = item.select("dt img")[0]['data-ks-lazyload'] insert_sql = 'insert into productinfo values("%s","%s","%s")' %(name,price,imageUrl) cursor.execute(insert_sql) conn.commit() 三、请以你的理解尽可能准确的描述出scrapy运行的原理图(15分) scrapy框架原理图.png 在实际编写代码的过程一种,一般按照下列顺序编写代码文件: 1.编写item.py文件;2.编写爬虫文件;3.编写pipelines.py文件;4.编写settings.py文件 在Scrapy框架理解上: 1.爬虫Spiders发送请求Requests给调度器Scheduler 2.调度器Scheduler发送下载网页的请求Requests给下载器Downloader 3.下载器Downloader获取网页相应response交给爬虫Spiders 4.爬虫Spiders对response进行解析形成Item 5.Item传送给管道,管道对数据进行相应处理,数据持久化。 6.Middelwares分为三种:调度中间件Scheduler middlewares、爬虫中间件spider Middlewares、下载中间件Download Middlewares。在编写scrapy-redis分布式爬虫时,redis就相当于调度中间件Scheduler middlewares;对爬虫进行伪装,设置用户代理User-agent和代理Ip,是在爬虫中间件spider Middlewares中进行设置,下载中间件Download Middlewares可以对下载进行相应设置。

优秀的个人博客,低调大师

C++小例子

#include <iostream> #include <conio.h> int main(){ std::cout<<"Enter two numbers:"<<std::endl; int v1,v2; std::cin>>v1>>v2; int lower,upper; if(v1<=v2){ lower = v1; upper = v2; }else{ lower = v2; upper = v1; } int sum = 0; for(int val = lower;val<=upper;++val){ sum +=val; } std::cout<<"Sum of "<<lower<<"to"<<upper <<" is " <<sum<<std::endl; getch(); return 0; } 输入两个数 计算出,他们之间的和 例如输入1、3 计算1+2+3 本文转自TBHacker博客园博客,原文链接:http://www.cnblogs.com/jiqing9006/p/3723660.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android系统小知识

1.添加振动 http://blog.csdn.net/caesardadi/article/details/8251933 2.excel操作 jxl.jar jxcell.jar Appache的poi库 3.保证屏幕黑屏之后CPU继续运作 http://blog.csdn.net/jhope/article/details/53737402 4.文件新建之后,在电脑上看不见。 http://blog.csdn.net/lmw21848/article/details/52297346 5.java文件加解密 http://zhangzhaoaaa.iteye.com/blog/2124700 6.AlarmManager定点提醒 http://blog.csdn.net/fxdaniel/article/details/41150129 几个设置参数的意义 http://blog.csdn.net/wangjia55/article/details/21518931 7. 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/2048586,如需转载请自行联系原作者

优秀的个人博客,低调大师

混淆小助手-Obfuscator

涉及的技术: 1.自定义Gradle plugin2.Jitpack发布开源库3.Proguard代码混淆4.Android Gradle编译 Github地址: Obfucator源码obfuscator-plugin源码 一.为什么要做混淆 Android是java开发的, 所以很容易被反编译.为了提升app的安全等级, 需要对app进行混淆. 常用有3种处理方式: proguard代码混淆 dexguard apk 加壳 现在市面上有很多加壳平台,可以防止app被反编译. 但是这不是万能的,因为脱壳技术也日益更新,如果app脱壳成功,代码就可以全被看到了,所以很有必要对代码进行proguard混淆. 这可以 1).可以减少apk的大小; 2)加大反编译后读取代码逻辑的难度. 二.不能混淆的几种case app中有些代码是不能混淆

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册