首页 文章 精选 留言 我的

精选列表

搜索[交错序列],共10000篇文章
优秀的个人博客,低调大师

时间序列数据的存储和计算 - 开源时序数据库解析(三)

InfluxDB InfluxDB在DB-Engines的时序数据库类别里排名第一,实至名归,从它的功能丰富性、易用性以及底层实现来看,都有很多的亮点,值得大篇幅来分析。 首先简单归纳下它的几个比较重要的特性: 极简架构:单机版的InfluxDB只需要安装一个binary,即可运行使用,完全没有任何的外部依赖。相比来看几个反面例子,OpenTSDB底层是HBase,拖家带口就得带上ZooKeeper、HDFS等,如果你不熟悉Hadoop技术栈,一般运维起来是有一定的难度,这也是其被人抱怨最多的一个点。KairosDB稍微好点,它依赖Cassandra和ZooKeeper,单机测试可以使用H2。总的来说,依赖一个外部的分布式数据库的TSDB,在架构上会比完全自包含的TSDB复杂一点,毕竟一个成熟的分布式数据库本身就很复杂,当然这一

优秀的个人博客,低调大师

简单入门循环神经网络RNN:时间序列数据的首选神经网络

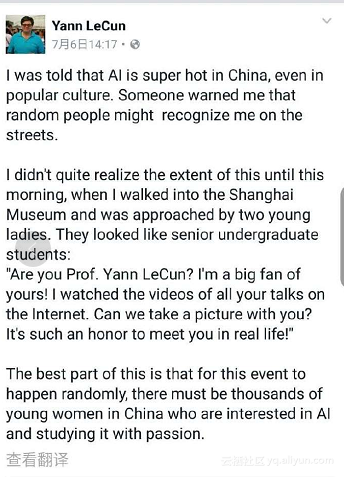
更多深度文章,请关注:https://yq.aliyun.com/cloud 随着科学技术的发展以及硬件计算能力的大幅提升,人工智能已经从几十年的幕后工作一下子跃入人们眼帘。人工智能的背后源自于大数据、高性能的硬件与优秀的算法的支持。2016年,深度学习已成为Google搜索的热词,随着最近一两年的围棋人机大战中,阿法狗完胜世界冠军后,人们感觉到再也无法抵挡住AI的车轮的快速驶来。在2017年这一年中,AI已经突破天际,相关产品也出现在人们的生活中,比如智能机器人、无人驾驶以及语音搜索等。最近,世界智能大会在天津举办成功,大会上许多业内行家及企业家发表自己对未来的看法,可以了解到,大多数的科技公司及研究机构都非常看好人工智能的前景,比如百度公司将自己的全部身家压在人工智能上,不管破釜沉舟后是一举成名还是一败涂地,只要不是一无所获就行。为什么突然之间深度学习会有这么大的效应与热潮呢?这是因为科技改变生活,很多的职业可能在今后的时间里慢慢被人工智能所取代。全民都在热议人工智能与深度学习,就连Yann LeCun大牛都感受到了人工智能在中国的火热! 言归正传,人工智能的背后是大数据、优秀的算法以及强大运算能力的硬件支持。比如,英伟达公司凭借自己的强大的硬件研发能力以及对深度学习框架的支持夺得世全球最聪明的五十家公司榜首。另外优秀的深度学习算法有很多,时不时就会出现一个新的算法,真是令人眼花缭乱。但大多都是基于经典的算法改进而来,比如卷积神经网络(CNN)、深度信念网络(DBN)、循环神经网络(RNN)等等。 本文将介绍经典的网络之循环神经网络(RNN),这一网络也是时序数据的首选网络。当涉及某些顺序机器学习任务时,RNN可以达到很高的精度,没有其他算法可以与之一较高下。这是由于传统的神经网络只是具有一种短期记忆,而RNN具有有限的短期记忆的优势。然而,第一代RNNs网络并没有引起人们着重的注意,这是由于研究人员在利用反向传播和梯度下降算法过程中遭受到了严重的梯度消失问题,阻碍了RNN几十年的发展。最后,于90年代后期出现了重大突破,导致更加准确的新一代RNN的问世。基于这一突破的近二十年,直到Google Voice Search和Apple Siri等应用程序开始抢夺其关键流程,开发人员完善和优化了新一代的RNN。现在,RNN网络遍布各个研究领域,并且正在帮助点燃人工智能的复兴之火。 与过去有关的神经网络(RNN) 大多数人造神经网络,如前馈神经网络,都没有记忆它们刚刚收到的输入。例如,如果提供前馈神经网络的字符“WISDOM”,当它到达字符“D”时,它已经忘记了它刚刚读过字符“S”,这是一个大问题。无论训练该网络是多么的辛苦,总是很难猜出下一个最有可能的字符“O”。这使得它成为某些任务的一个相当无用的候选人,例如在语音识别中,识别的好坏在很大程度上受益于预测下一个字符的能力。另一方面,RNN网络确实记住了之前的输入,但是处于一个非常复杂的水平。 我们再次输入“WISDOM”,并将其应用到一个复发性网络中。RNN网络中的单元或人造神经元在接收到“D”时也将其之前接收到的字符“S”作为其输入。换句话说,就是把刚刚过去的事情联合现在的事情作为输入,来预测接下来会发生的事情,这给了它有限的短期记忆的优势。当训练时,提供足够的背景下,可以猜测下一个字符最有可能是“O”。调整和重新调整像所有人工神经网络一样,RNN的单元为其多个输入分配一个权重矩阵,这些权重代表各个输入在网络层中所占的比重;然后对这些权重应用一个函数来确定单个输出,这个函数一般被称为损失函数(代价函数),限定实际输出与目标输出之间的误差。然而,循环神经网络不仅对当前输入分配权重,而且还从对过去时刻输入分配权重。然后,通过使得损失函数最下来动态的调整分配给当前输入和过去输入的权重,这个过程涉及到两个关键概念:梯度下降和反向传播(BPTT)。梯度下降机器学习中最著名的算法之一就是梯度下降算法。它的主要优点在于它显着的回避了“维数灾难”。什么是“维数灾难”呢,就是说在涉及到向量的计算问题中,随着维数的增加,计算量会呈指数倍增长。这个问题困扰着诸多神经网络系统,因为太多的变量需要计算来达到最小的损失函数。然而,梯度下降算法通过放大多维误差或代价函数的局部最小值来打破维数灾难。这有助于系统调整分配给各个单元的权重值,以使网络变得更加精确。通过时间的反向传播RNN通过反向推理微调其权重来训练其单元。简单的说,就是根据单元计算出的总输出与目标输出之间的误差,从网络的最终输出端反向逐层回归,利用损失函数的偏导调整每个单元的权重。这就是著名的BP算法,关于BP算法可以看本博主之前的相关博客。而RNN网络使用的是类似的一个版本,称为通过时间的反向传播(BPTT)。该版本扩展了调整过程,包括负责前一时刻(T-1)输入值对应的每个单元的记忆的权重。Yikes:梯度消失问题 尽管在梯度下降算法和BPTT的帮助下享有一些初步的成功,但是许多人造神经网络(包括第一代RNNs网络),最终都遭受了严重的挫折——梯度消失问题。什么是梯度消失问题呢,其基本思想其实很简单。首先,来看一个梯度的概念,将梯度视为斜率。在训练深层神经网络的背景中,梯度值越大代表坡度越陡峭,系统能够越快地下滑到终点线并完成训练。但这也是研究者陷入困境的地方——当斜坡太平坦时,无法进行快速的训练。这对于深层网络中的第一层而言特别关键,因为若第一层的梯度值为零,说明没有了调整方向,无法调整相关的权重值来最下化损失函数,这一现象就是“消梯度失”。随着梯度越来越小,训练时间也会越来越长,类似于物理学中的沿直线运动,光滑表面,小球会一直运动下去。 大的突破:长短期记忆(LSTM)在九十年代后期,一个重大的突破解决了上述梯度消失问题,给RNN网络发展带来了第二次研究热潮。这种大突破的中心思想是引入了单元长短期记忆(LSTM)。 LSTM的引入给AI领域创造了一个不同的世界。这是由于这些新单元或人造神经元(如RNN的标准短期记忆单元)从一开始就记住了它们的输入。然而,与标准的RNN单元不同,LSTM可以挂载在它们的存储器上,这些存储器具有类似于常规计算机中的存储器寄存器的读/写属性。另外LSTM是模拟的,而不是数字,使得它们的特征可以区分。换句话说,它们的曲线是连续的,可以找到它们的斜坡的陡度。因此,LSTM特别适合于反向传播和梯度下降中所涉及的偏微积分。 总而言之,LSTM不仅可以调整其权重,还可以根据训练的梯度来保留、删除、转换和控制其存储数据的流入和流出。最重要的是,LSTM可以长时间保存重要的错误信息,以使梯度相对陡峭,从而网络的训练时间相对较短。这解决了梯度消失的问题,并大大提高了当今基于LSTM的RNN网络的准确性。由于RNN架构的显著改进,谷歌、苹果及许多其他先进的公司现在正在使用RNN为其业务中心的应用提供推动力。总结 循环神经网络(RNN)可以记住其以前的输入,当涉及到连续的、与上下文相关的任务(如语音识别)时,它比其他人造神经网络具有更大的优势。 关于RNN网络的发展历程:第一代RNNs通过反向传播和梯度下降算法达到了纠正错误的能力。但梯度消失问题阻止了RNN的发展;直到1997年,引入了一个基于LSTM的架构后,取得了大的突破。 新的方法有效地将RNN网络中的每个单元转变成一个模拟计算机,大大提高了网络精度。 作者信息 Jason Roell:软件工程师,热爱深度学习及其可改变技术的应用。 Linkedin:http://www.linkedin.com/in/jason-roell-47830817/ 本文由北邮@爱可可-爱生活老师推荐,阿里云云栖社区组织翻译。 文章原标题《Understanding Recurrent Neural Networks: The Preferred Neural Network for Time-Series Data》,作者:Jason Roel,译者:海棠,审阅:袁虎 附件为原文的pdf 文章为简译,更为详细的内容,请查看原文

优秀的个人博客,低调大师

时间序列数据的存储和计算 - 开源时序数据库解析(二)

KairosDB KairosDB最初是从OpenTSDB 1.x版本fork出来的一个分支,目的是在OpenTSDB的代码基础上进行二次开发来满足新的功能需求。其改造之一就是支持可插拔式的存储引擎,例如支持H2可以方便本地开发和测试,而不是像OpenTSDB一样与HBase强耦合。在其最初的几个版本中,HBase也是作为其主要的存储引擎。但是在之后的存储优化中,慢慢使用Cassandra替换了HBase,它也是第一个基于Cassandra开发的时序数据库。在最新的几个版本中,已不再支持HBase,因为其存储优化使用了Cassandra所特有而HBase没有的一些特性。 在整体架构上,和OpenTSDB比较类似,都是采用了一个比较成熟的数据库来作为底层存储引擎。自己的主要逻辑仅仅是在存储引擎层之上很薄的一个逻辑层,这层逻辑层的

优秀的个人博客,低调大师

时间序列数据的存储和计算 - 开源时序数据库解析(一)

开源时序数据库 如图是17年6月在db-engines上时序数据库的排名,我会挑选开源的、分布式的时序数据库做详细的解析。前十的排名中,RRD是一个老牌的单机存储引擎,Graphite底层是Whisper,可以认为是一个优化的更强大的RRD数据库。kdb+、eXtremeDB和Axibase都未开源,不做解析。InfluxDB开源版和Prometheus的底层都是基于levelDB自研的单机的存储引擎,InfluxDB的商业版支持分布式,Prometheus的roadmap上也规划了分布式存储引擎的支持计划。 综合看下来,我会选择OpenTSDB、KairosDB和InfluxDB做一个详细的解析。我对OpenTSDB比较熟悉,研究过它的源码,所以对OpenTSDB会描述的格外详细,而对其他时序数据库了解的没那么深入,如果有描

优秀的个人博客,低调大师

图片、视频、DNA序列……非结构化数据井喷,新技术风向标在哪?

万物互联的今天,数据井喷,数据类型也不断增长,其中包括图片、视频、分子结构等在内的非结构化数据暴涨。根据 IDC 预测,到 2025 年,中国数据总量预计增加至 48.6ZB,独占全球份额的 27.8%,成为世界上数据容量最大的区域。在全球数据增量和总量都不断增长的同时,其中 80% 都数据都将是非结构化数据。这不仅为非结构化数据研究提供了沃土,也为技术创业者创造了机会。 另一方面,回归到数据技术本身,如何在新型数据、计算机、上层业务之间构筑有效的桥梁,正是当下技术公司亟需解决的问题。 首先要实现计算机对于非结构化数据的理解,业界目前普遍认可的做法便是通过深度学习模型,将数据生成向量 embedding,然后做近邻的匹配,实现相似数据检索。这一过程涉及多个技术领域,比如除了传统的大规模数据存储、传输外,还要关注 AI 技术中深度学习模型对向量数据转换的精确度的影响等等。再加之数据库上云所涉及到的分布式技术、在线服务能力等等,对向量数据库的开发者提出了非常高的技术要求。 对于这些问题,向量数据库公司 Ziliiz 提出了自己的解决办法,并开源非结构化数据处理系列工具链,包括非结构化数据 ETL 平台 Towhee、向量数据库 Milvus、Milvus 图形化管理工具Attu、可视化工具 Feder。Zilliz 已帮助全球超过 1000 家企业级用户实现非结构化数据处理,释放数据价值,赋能客户业务发展。现在,Zilliz 发布 Zilliz Cloud 服务,开始主攻北美市场,希望在全球化的舞台上,做向量数据库领域的“引领者”。 为了加速非结构化数据技术的研究,9 月 24 - 25 日,Zilliz 特举办 2022 首届非结构化数据大会,向全球用户展示 Zilliz 在向量数据库领域的研究成果,同时邀请众多行业伙伴,分享向量数据库在不同领域的落地经验。 新品首发:Zilliz Cloud “数据其实是我们对世界的一种数字表示。”在 Zilliz 创始人兼首席执行官星爵看来,结构化数据更多的是用计算机的视角,把数据进行组织和存储,而现在的非结构化数据超出了机器处理的范畴,属于自然界的视角,比如图片、视频、用户行为画像、分子和材料的三维结构、人类 DNA 测序结构等等。 在非结构化数据激增的趋势之下,星爵认为,我们需要做是让计算机可以去存储、理解、分析更多数据,从而摆脱人类的脑力、时间的限制,实现一种可复制、可扩展、低成本的方法,去自动地、端到端地处理与分析数据,最终实现从非结构化数据中获取商业洞见。 现在,Zilliz 将自身非结构化数据处理能力搬到了云上,意在进一步降低用户成本。本次峰会上,Zilliz 合伙人和技术总监栾小凡带来了重磅发布:云端全托管向量数据库服务 Zilliz Cloud。 Zilliz Cloud 有 6 个核心特点:一是高可用;二是对成本有很大的优化,包括 runtime 成本、开发运维等成本;三是有很好的扩展性,可以按需调用资源、按需付费;四是有很好的安全支持保障;五是优化使用体验,简化 ETL、数据管理、数据可视化等操作;六是 Zilliz Cloud 由 Milvus 原班人马打造,对非结构化数据处理有着丰富的经验,可以为用户提供更好的服务。 现阶段,Zilliz Cloud 在北美首发,基于 AWS 搭建第一个版本服务。接下来,Zilliz 计划在美西、美东地区扩展,国内和东南亚地区也将并行发展,并实现多云服务。 Zilliz Cloud 架构图 Zilliz 非结构化数据处理工具链及研究成果 目前,向量数据库 Milvus 已迭代至 2.1 版本,2.2 版本也即将与大家见面。Zilliz 首席工程师焦恩伟介绍了新一代 Milvus 的新特性及未来规划。 最新的 Milvus 2.1 版本中,提供了内存多副本,查询⾼可⽤的能力;支持 String 类型,包括⽀持在 Collection 中使⽤ String 数据类型,对 String 类型建⽴ Inverted Index 等等;持续的性能提升,包括⽀持 ANN 索引,3.2x 性能提升等;还有其他新功能,如将 Kafka 作为 log broker ,SDK 身份认证等。 2.2 版本将增加磁盘索引、数据批量导入、RBAC 权限控制等功能。下一代的 Milvus 将主要围绕 AI 中台/AI 业务两大用户群、高性能向量库/海量向量分析两大用户群和场景进行迭代升级。 Milvus 架构图 除 Milvus 之外,Towhee 也是本次峰会的亮点之一。这是 Zilliz 团队重点打造的第二个开源项目。Towhee 是一个开源的 embedding 框架,包含丰富的数据处理算法与神经网络模型。通过 Towhee,能够轻松地处理非结构化数据(如图片、视频、音频、长文本等),完成原始数据到向量的转换。 Zilliz 合伙人和产品总监郭人通介绍,相较于传统的结构化数据的 ETL 工具,非结构化数据 ETL 工具有 4 个较大的特点:首先在业务侧的原始数据上囊括了各式非结构化数据;其二,在 transform 过程中,会深入到数据底层语义去匹配高度相关的标签;其三,transform 过程中也会引入大量的 AI 能力,实现非结构化数据的精准分析;其四,在 load 环节,处理后的数据会流向以向量数据库为中心的数据平台或数据中台。在实际生产环境中,非结构化数据 ETL 流水线往往非常复杂,原因有 6 个:数据复杂,工具未实现标准化,涉及多个神经网络模型,解决方案难以高度模版化,需要较多人力,项目资源消耗大。 结合实际发展情况,非结构化数据 ETL 的问题应该由一个好的开源基础软件或者是开源的解决方案去解决。Towhee 便是基于此定位发起的。Towhee 设计了大量轻巧友善的接口,针对典型的 embedding 场景需要,Towhee 从中抽象出一系列 embedding 流水线。为了能够更好地融合进不同业务中,在生态对接和集成方面,Towhee 对接了大量的模型库,集成了一些较为成熟的数据处理技术生态,同时优化底层 Pipeline 能力。此外,Towhee 现在也在继承一系列高性能的第三方组件,满足更多用户需求。 郭人通博士还介绍了当下非结构化数据搜索的工具链与技术生态。 目前,非结构化数据搜索市场还存在很多挑战,比如缺乏构建模块和工具,很难把所有碎片拼凑在一起,重复发明轮子消耗资源,同时 AL/ML 基础设施也不够完善。面对诸多挑战,Zilliz 给出的答案是内外功兼修。内功方面,不断提升各个产品的性能、可靠性、可用性、可伸缩性。外功方面,通过 Zilliz Cloud 实现全托管向量数据库服务,将复杂的操作藏在 ETL 流水线之中,并且尽可能地优化与模型、数据处理工具、云服务的生态集成。 实际上,向量数据库相关技术当下也面临着许多挑战。Zilliz 研究团队负责人和高级研究员易小萌介绍,向量检索有三大关键技术挑战:向量数据处理维度灾难、多路折中以及复杂查询语义。近期,学术界探索向量检索时主要关注三方向:新的存储和硬件加速器支持、基于机器学习的调优策略,以及分布式方案。 向量数据库的产业落地实践 向量数据库技术现在已经在多个行业有了落地应用实践,许多企业使用 Milvus 处理海量非结构化数据,赋能业务发展。 在中国电信,其产品翼支付的 RiskX 风控模型引擎的算法体系主要分为视觉风控、风险信任体系、风险画像、风险时序模型、风控知识图谱五个版块。中国电信翼支付风控总监汤敏伟介绍,这五大版块都深度结合了 Milvus 的多种能力。比如针对开户/认证场景材料的背景特征提取,进行实时多模态高阶聚类,识别群体性风险时,就需要依靠 Milvus 的存储、检索能力来实现。 在深度学习领域,Milvus 被引入至飞桨 PaddleNLP 中。百度资深研发工程师方泽阳表示,Milvus 作为新一代向量数据库,具有部署简单、功能全面、性能极致、硬件支持广泛等特点。因此才会选择将 Milvus 作为向量搜索节点引入到能够快速搭建 NLP 产品级系统的工具——Pipeline 中。而且得益于 PaddlleNLP 组件式设计,将 Milvus 部署到向量召回场景,很是轻松,只需几行代码就能搞定。一个典型的例子是,某医疗信息服务提供商搭建医疗信息检索系统时,通过 ERNIE 3.0 模型和基于 Mivus 的向量召回系统,快速将传统基于 TF-IDF 的语义召回系统切换到基于预训练模型的召回系统,召回效果大幅提升,同时统稳定性也有很大提升。 基于 Milvus,虎牙天眼智能内容安全系统落地应用了整套弱监督敏感区域特征检索方案。虎牙安全算法高级研究员黎官钊表示,长远来看,基于 Milvus 检索有几大优势:首先,Milvus 不只是普通检索工具,更是完备的 AI 向量数据库,同时支持 Python、Go 等多种语言;二是便捷易用,提供了很多可视化的操作工具,迁移到 Milvus 很便利;三是在使用过程中遇到问题时,背后的公司和团队具备会积极地与其沟通,并且不断完善使之成为一款优秀的向量检索数据库。未来,除了进一步提升特征提取能力外,虎牙还将针对更多违规场景构建大规模检索库,结合利用和参与构建 Milvus 社区的相关能力,不断提升性能,并落地到更多业务场景。 在陌陌,其最初自建向量检索引擎 VRE,但随着业务变化,面临的挑战越来越多,比如 QPS 增大,latency 降低;无法支持更多索引类型;组件依赖多,故障定位链路长等。陌陌数据平台资深专家孔云龙介绍,几番调研对比了现有的开源向量检索产品之后,陌陌最终选择了将 Milvus 引入到实际业务中。 未来,陌陌将进一步完善基于 Milvus 的向量检索平台,比如权限管理、监控报警等;并投入更多人力优化 Milvus 的稳定性,将一些好的模块同步贡献到社区;同时会在陌陌探索更多应用场景,比如生态治理、动态搜索、推荐等等;此外,借助于公司内部的大数据平台,还将探索 Milvus 在离线集群混合部署、资源隔离等场景的应用。 开源开放,共筑未来 Zilliz 始终坚持开源开放的原则,在深耕开源社区的同时,也在积极加强和学术界的合作,分享最新研究成果。过去两年,Zilliz 分别在 SIGMOD 和 VLDB 两大数据库顶会上发表了 Milvus 研究论文。开源社区方面,Milvus 在过去一年的时间里,GitHub Star 数量增⻓⼀倍,已超 13000,贡献者数量翻番。 未来, Zilliz 也将持续发力开源社区的建设。 LF AI & Data 基金会的执行董事 Ibrahim Haddad 也为我们介绍了 Milvus 开源社区的成绩。他提到,Milvus 于 2020 年 1 月 进入 LF AI & Data 基金会孵化,仅用了一年半的时间就从基金会毕业。现在,已经有 1600 多名贡献者参与了 Milvus 项目,其中有 800 多名持续活跃的贡献者。他说:“这是一个了不起的数字,几乎是 2020 年 1 月之初刚加入我们时的九倍。” Ibrahim Haddad 认为, 真正令人惊叹的是 Milvus 的项目增长和提交增长情况。“在短短的几个月时间,越来越多的人为该项目做出贡献,不断有新的东西提交上来。在过去的两年里,提交增长了约 270%。新贡献者的数量也在增长,每个月我们都能够吸引新的贡献者加入项目。Zilliz 团队在平衡项目方面做得非常出色,并且推动和吸引新的贡献者加入其中。" 实际上,当前国际市场上也有类似的向量数据库产品,但并非走的是开源开放的产品模式。此外,一些传统的数据库公司和公有云服务商也开始尝试探索向量检索领域。但相较而言,Zilliz 可以说是较早迈入向量数据库领域的公司,同时也早早地坚定了开源的路线,深入用户社区,了解用户需求,并且围绕核心产品 Milvus,逐渐搭建起上下游工具生态,优势显著。 放眼全球市场,在非结构化数据处理的技术探索之路上,谁能成为领跑者的答案现在还未揭晓。 但是通过这一次 Zilliz 2022 首届非结构化数据峰会,我们看到了一套正在趋于成熟的非结构化数据处理技术,也看到了其开源开放的优势所在,相信未来可期。

优秀的个人博客,低调大师

MessagePack Java Jackson Dataformat 不使用 str8 数据类型的序列化

老的 msgpack-java(例如 0.6.7)并不支持MessagePack str8 数据类型。 当你的希望的你的应用程序需要支持老的版本的话,你需要禁用这个数据类型,例如使用下面的语句: MessagePack.PackerConfig config = new MessagePack.PackerConfig().withStr8FormatSupport(false); ObjectMapper mapperWithConfig = new ObjectMapper(new MessagePackFactory(config)); // This string is serialized as bin8 type byte[] resultWithoutStr8Format = mapperWithConfig.writeValueAsBytes(str8LengthString); https://www.cwiki.us/display/Serialization/MessagePack+Jackson+Dataformat

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册