首页 文章 精选 留言 我的

精选列表

搜索[python],共10000篇文章
优秀的个人博客,低调大师

Python 调度算法 死锁 静动态链接 分页分段(七)

1 select poll epoll的区别 基本上select有3个缺点: 连接数受限 查找配对速度慢 数据由内核拷贝到用户态 poll改善了第一个缺点 epoll改了三个缺点. (1)select,poll实现需要自己不断轮询所有fd集合,直到设备就绪,期间可能要睡眠和唤醒多次交替。而epoll其实也需要调用epoll_wait不断轮询就绪链表,期间也可能多次睡眠和唤醒交替,但是它是设备就绪时,调用回调函数,把就绪fd放入就绪链表中,并唤醒在epoll_wait中进入睡眠的进程。虽然都要睡眠和交替,但是select和poll在“醒着”的时候要遍历整个fd集合,而epoll在“醒着”的时候只要判断一下就绪链表是否为空就行了,这节省了大量的CPU时间。这就是回调机制带来的性能提升。 (2)select,poll每次调用都要把fd集合从用户态往内核态拷贝一次,并且要把current往设备等待队列中挂一次,而epoll只要一次拷贝,而且把current往等待队列上挂也只挂一次(在epoll_wait的开始,注意这里的等待队列并不是设备等待队列,只是一个epoll内部定义的等待队列)。这也能节省不少的开销。 2 调度算法 调度算法是指:根据系统的资源分配策略所规定的资源分配算法。 先来先服务(FCFS, First Come First Serve) 短作业优先(SJF, Shortest Job First) 最高优先权调度(Priority Scheduling) 时间片轮转(RR, Round Robin) 多级反馈队列调度(multilevel feedback queue scheduling) 实时调度算法: 最早截至时间优先 EDF 最低松弛度优先 LLF 一、FCFS——先来先服务和短作业(进程)优先调度算法 先来先服务调度算法。 先来先服务(FCFS)调度算法是一种最简单的调度算法,该算法既可用于作业调度, 也可用于进程调度。FCFS算法比较有利于长作业(进程),而不利于短作业(进程)。由此可知,本算法适合于CPU繁忙型作业, 而不利于I/O繁忙型的作业(进程)。 短作业(进程)优先调度算法。 短作业(进程)优先调度算法(SJ/PF)是指对短作业或短进程优先调度的算法,该算法既可用于作业调度, 也可用于进程调度。但其对长作业不利;不能保证紧迫性作业(进程)被及时处理;作业的长短只是被估算出来的。 二、FPF高优先权优先调度算法 优先权调度算法的类型。 为了照顾紧迫性作业,使之进入系统后便获得优先处理,引入了最高优先权优先(FPF)调度算法。 此算法常被用在批处理系统中,作为作业调度算法,也作为多种操作系统中的进程调度,还可以用于实时系统中。当其用于作业调度, 将后备队列中若干个优先权最高的作业装入内存。当其用于进程调度时,把处理机分配给就绪队列中优先权最高的进程,此时, 又可以进一步把该算法分成以下两种: 1)非抢占式优先权算法 2)抢占式优先权调度算法(高性能计算机操作系统) ​ 2.优先权 对于最高优先权优先调度算法,其核心在于:它是使用静态优先权还是动态优先权, 以及如何确定进程的优先权。 ​ 3.动态优先权 高响应比优先调度算法为了弥补短作业优先算法的不足,我们引入动态优先权,使作业的优先等级随着等待时间的增加而以速率a提高。 该优先权变化规律可描述为:优先权=(等待时间+要求服务时间)/要求服务时间;即 =(响应时间)/要求服务时间 三、基于时间片的轮转调度算法 1.时间片轮转法。 时间片轮转法一般用于进程调度,每次调度,把CPU分配队首进程,并令其执行一个时间片。 当执行的时间片用完时,由一个记时器发出一个时钟中断请求,该进程被停止,并被送往就绪队列末尾;依次循环。 多级反馈队列调度算法 多级反馈队列调度算法多级反馈队列调度算法,不必事先知道各种进程所需要执行的时间,它是目前被公认的一种较好的进程调度算法。 其实施过程如下: 1) 设置多个就绪队列,并为各个队列赋予不同的优先级。在优先权越高的队列中, 为每个进程所规定的执行时间片就越小。 2) 当一个新进程进入内存后,首先放入第一队列的末尾,按FCFS原则排队等候调度。 如果他能在一个时间片中完成,便可撤离;如果未完成,就转入第二队列的末尾,在同样等待调度…… 如此下去,当一个长作业(进程)从第一队列依次将到第n队列(最后队列)后,便按第n队列时间片轮转运行。 3) 仅当第一队列空闲时,调度程序才调度第二队列中的进程运行; 仅当第1到第( i-1 )队列空时, 才会调度第i队列中的进程运行,并执行相应的时间片轮转。 4) 如果处理机正在处理第i队列中某进程,又有新进程进入优先权较高的队列, 则此新队列抢占正在运行的处理机,并把正在运行的进程放在第i队列的队尾。 3 死锁 在多道程序系统中,由于多个进程的并发执行,改善了系统资源的利用率并提高了系统的处理能力。然而,多个进程的并发执行也带来了新的问题——死锁。所谓死锁是指多个进程因竞争资源而造成的一种僵局,若无外力作用,这些进程都将无法向前推进。 死锁产生的原因: 1)系统资源的竞争 2)进程推进顺序非法(程序推进顺序不当) 死锁产生的条件: 互斥条件 不剥夺条件 请求和保持条件 循环等待条件 处理死锁的基本方法: 预防死锁(摒弃除1以外的条件) 避免死锁(银行家算法) 检测死锁(资源分配图) 解除死锁 : 死锁的接触方法 : 剥夺资源 撤销进程 进程回退 4 程序的编译与链接 Bulid过程可以分解为4个步骤:预处理(Prepressing), 编译(Compilation)、汇编(Assembly)、链接(Linking) 以c语言为例: 1 预处理 预编译过程主要处理那些源文件中的以“#”开始的预编译指令,主要处理规则有: 将所有的“#define”删除,并展开所用的宏定义 处理所有条件预编译指令,比如“#if”、“#ifdef”、 “#elif”、“#endif” 处理“#include”预编译指令,将被包含的文件插入到该编译指令的位置,注:此过程是递归进行的 删除所有注释 添加行号和文件名标识,以便于编译时编译器产生调试用的行号信息及用于编译时产生编译错误或警告时可显示行号 保留所有的#pragma编译器指令。 2 编译 编译过程就是把预处理完的文件进行一系列的词法分析、语法分析、语义分析及优化后生成相应的汇编代码文件。这个过程是整个程序构建的核心部分。 3 汇编 汇编器是将汇编代码转化成机器可以执行的指令,每一条汇编语句几乎都是一条机器指令。经过编译、链接、汇编输出的文件成为目标文件(Object File). 4 链接 链接的主要内容就是把各个模块之间相互引用的部分处理好,使各个模块可以正确的拼接。 链接的主要过程包块 地址和空间的分配(Address and Storage Allocation)、符号决议(Symbol Resolution)和重定位(Relocation)等步骤。 5 静态链接与动态链接 静态链接方法:静态链接的时候,载入代码就会把程序会用到的动态代码或动态代码的地址确定下来 静态库的链接可以使用静态链接,动态链接库也可以使用这种方法链接导入库 动态链接方法:使用这种方式的程序并不在一开始就完成动态链接,而是直到真正调用动态库代码时,载入程序才计算(被调用的那部分)动态代码的逻辑地址,等到某个时候,程序又需要调用另外某块动态代码时,载入程序又去计算这部分代码的逻辑地址,所以这种方式使程序初始化时间较短,但运行期间的性能比不上静态链接的程序 6 虚拟内存技术与分页分段 虚拟存储器是指具有请求调入功能和置换功能,能从逻辑上对内存容量加以扩充的一种存储系统. 分页: 用户程序的地址空间被划分成若干固定大小的区域,称为“页”,相应地,内存空间分成若干个物理块,页和块的大小相等。可将用户程序的任一页放在内存的任一块中,实现了离散分配。 分段: 将用户程序地址空间分成若干个大小不等的段,每段可以定义一组相对完整的逻辑信息。存储分配时,以段为单位,段与段在内存中可以不相邻接,也实现了离散分配。 分页与分段的主要区别 页是信息的物理单位,分页是为了实现非连续分配,以便解决内存碎片问题,或者说分页是由于系统管理的需要.段是信息的逻辑单位,它含有一组意义相对完整的信息,分段的目的是为了更好地实现共享,满足用户的需要. 页的大小固定,由系统确定,将逻辑地址划分为页号和页内地址是由机器硬件实现的.而段的长度却不固定,决定于用户所编写的程序,通常由编译程序在对源程序进行编译时根据信息的性质来划分. 分页的作业地址空间是一维的.分段的地址空间是二维的. 页面置换算法 最佳置换算法OPT:不可能实现 先进先出FIFO clock算法 边沿触发和水平触发 边缘触发是指每当状态变化时发生一个 io 事件,条件触发是只要满足条件就发生一个 io 事件

优秀的个人博客,低调大师

Python Pip安装:whl is not a supported wheel on this platform问题的解决

在安装locust压测工具时遇到大量这样的东东。因为windows下,有的用到了c扩展。要么就是前面介绍的方法,自己编译。要么下载编译好c的whl文件。 参考URL: https://blog.csdn.net/qing101hua/article/details/52504403 方法:在shell中输入import pip; print(pip.pep425tags.get_supported())可以获取到pip支持的文件名还有版本。 比如,按如下载图的结果,numpy-1.10.4+mkl-cp27-cp27m-win32.whl就需要更改成numpy-1.10.4+mkl-cp27-none-win32.whl。

优秀的个人博客,低调大师

Python 使用 pygame 实现一个简单的动画

首先安装pygame库: $ sudo pip install pygame 测试安装效果: #导入pygame模块 import pygame #初始化pygame pygame.init() #创建舞台,利用Pygame中的display模块,来创建窗口 screen = pygame.display.set_mode((640,480),0,32) #设置窗口标题 pygame.display.set_caption("Hello PyGame") 这个时候大家运行就能得到一个窗口但是窗口一闪而过。 #导入pygame模块 import pygame #初始化pygame pygame.init() #创建舞台,利用Pygame中的display模块,来创建窗口 screen = pygame.display.set_mode((640,480),0,32) #设置窗口标题 pygame.display.set_caption("Hello PyGame") while 1: for event in pygame.event.get(): #这段程序大家可能比较费解,实际上是检测quit事件 if event.type == pygame.QUIT: pygame.quit() 实现一个左右滚动的小猫: image.png 直接上代码: # 导入pygame模块 import pygame # 初始化pygame pygame.init() width = 844 height = 689 speed = 10 # 创建舞台,利用Pygame中的display模块,来创建窗口 screen = pygame.display.set_mode((width, height), 0, 32) # 设置窗口标题 pygame.display.set_caption("Hello PyGame") # 我的cat.png和cat.py文件在同一个文件夹下面 # 所以可以直接这样加载图片的 # laod函数加载图片 cat = pygame.image.load("cat.jpg") print(cat) cat_x, cat_y = 0, 0 # 猫的坐标 h_direction = 1 # 水平方向 while 1: for event in pygame.event.get(): # 这段程序大家可能比较费解,实际上是检测quit事件,实际讲课中让学生直接模仿即可,时间足够也可以讲明白 if event.type == pygame.QUIT: pygame.quit() # blit函数的作用是把加载的图片放到舞台的(cat_x, cat_y)坐标的位置 screen.blit(cat, (cat_x, cat_y)) # 这样就实现了会移动的猫 cat_x += speed * h_direction # 如果猫的坐标超出了640,就让小猫反向 # 如果猫的坐标小于了0,也让小猫反向,这样就实现了碰到墙壁反弹的效果 if cat_x > width: h_direction = -h_direction elif cat_x < 0: h_direction = -h_direction pygame.display.update()

优秀的个人博客,低调大师

Python程序设计思维练习---体育竞技分析

体育竞技分析:模拟N场比赛 计算思维:抽象 + 自动化 模拟:抽象比赛过程,自动模拟N场比赛,当N越大时,比赛结果分析越科学。 本次比赛规则:回合制,15分一局,先由一方发球,如胜利,则得1分并继续发球,如失败,则双方分数不改变并交换球权。球员AB的能力为0-1之间的一个数值 思维方式:自顶向下即将一个复杂问题分解成几个问题,再细分成一个个具体的小问题,从而来解决复杂问题。自底向上为自顶向下的逆过程,即解决复杂问题的方法,逐步解决一个个小问题,来达成目的。 1.将体育竞技分析分解为以下几个小步骤 1.1打印程序的介绍性信息式 1.2获得程序运行参数:probA(A的能力值),probB(B的能力值),n(比赛场次) 1.3利用球员AB的能力值,模拟n场比赛 1.4输出球员AB获胜的场次及概率 2.将各个步骤定义成函数来实现 分解 定义函数 3.完整代码 from random import random def printInfo(): # 打印程序介绍信息 print('这个程序模拟两个选手A和B的某种竞技比赛') print('程序运行需要A和B的能力值(以0到1之间的小数表示)') def getInputs(): # 获得程序运行参数 a = eval(input('请输入选手A的能力值(0-1):')) b = eval(input('请输入选手B的能力值(0-1):')) n = eval(input('模拟比赛场次:')) return a, b, n def simOneGame(probA, probB): # 进行一场比赛 scoreA, scoreB = 0, 0 # 初始化AB的得分 serving = 'A' # 首先由A发球 while not gameOver(scoreA, scoreB): #用while循环来执行比赛 if serving == 'A': if random() < probA: # random() 方法返回随机生成的一个实数,它在[0,1)范围内。 scoreA += 1 # 用随机数来和能力值比较从而分出胜负 else: serving = 'B' else: if random() < probB: scoreB += 1 else: serving = 'A' return scoreA, scoreB def simNGames(n, probA, probB): #进行N场比赛 winsA, winsB = 0, 0 # 初始化AB的胜场数 for i in range(n): scoreA, scoreB = simOneGame(probA, probB) if scoreA > scoreB: winsA += 1 else: winsB += 1 return winsA, winsB def gameOver(c, d): #比赛结束 return c==15 or d==15 def printSummary(n ,winA, winB): #打印比赛结果 print('竞技分析开始,共模拟{}场比赛'.format(n)) print('选手A获胜{}场比赛,占比{:.2f}%'.format(winA, winA/n*100)) print('选手B获胜{}场比赛,占比{:.2f}%'.format(winB, winB / n * 100)) def main(): printInfo() probA, probB, n =getInputs() winsA, winsB = simNGames(n, probA, probB) printSummary(n, winsA, winsB) main() 4.运行结果分析 菜鸟互啄 中阶对抗 皇城PK 分析以上数据得知:对于两位能力相差相同的选手(都为0.05),能力越大的选手竞技时,胜负概率越接近。 本练习来自中国大学MOOC

优秀的个人博客,低调大师

深度学习中的正则化技术(附Python代码)

数据科学家面临的常见问题之一是如何避免过拟合。你是否碰到过这样一种情况:你的模型在训练集上表现异常好,却无法预测测试数据。或者在一个竞赛中你排在public leaderboard的顶端,但是在最终排名中却落后了几百名?那么这篇文章就是为你而准备的! (译者注: 在kaggle这样的数据竞赛中, public leaderboard排名是根据一部分测试集来计算的,用于给选手提供及时的反馈和动态展示比赛的进行情况;而private leaderboard是根据测试集的剩余部分计算而来,用于计算选手的最终得分和排名。 通常我们可以把public LB理解为在验证集上的得分,private LB为真正未知数据集上的得分,这样做的目的是提醒参赛者,我们建模的目标是获取一个泛化能力好的模型) 避免过拟合可以提高我们模型的性能。 目录 1. 什么是正

优秀的个人博客,低调大师

爱她就用python给她画个小心心 ♥(ˆ◡ˆԅ)

from turtle import * a = Turtle() screensize(400, 300, "blue") setup(width=1300, height=650, startx=20, starty=20) a.speed(10) a.hideturtle() a.pensize(2) a.color('red', 'pink') a.up() a.goto(200, 0) a.down() a.left(150) a.begin_fill() a.speed(1) a.forward(51) a.speed(50) for i in range(150): a.forward(1) a.right(0.3) a.speed(50) for i in range(210): a.forward(1) a.right(0.786) a.left(120) a.speed(50) for i in range(210): a.forward(1) a.right(0.786) a.speed(50) for i in range(150): a.forward(1) a.right(0.3) a.speed(1) a.forward(51) a.end_fill() # 画笔朝向x轴正方向 a.setheading(0) a.up() a.goto(-80, -100) a.down() a.left(150) a.begin_fill() a.speed(1) a.forward(51 * 1.5) a.speed(50) for i in range(150): a.forward(1.5) a.right(0.3) a.speed(50) for i in range(210): a.forward(1.5) a.right(0.786) a.left(120) a.speed(50) for i in range(210): a.forward(1.5) a.right(0.786) a.speed(50) for i in range(150): a.forward(1.5) a.right(0.3) a.speed(1) a.forward(51 * 1.5) a.end_fill() # 画穿心直线 a.pensize(7) a.setheading(0) a.up() a.goto(-400, 0) a.down() a.left(15) a.forward(150) a.up() a.goto(339, 175) a.down() # 画箭头 a.forward(150) a.pensize(1) a.speed(5) a.color('red', 'red') a.begin_fill() a.left(120) a.forward(20) a.right(150) a.forward(35) a.right(120) a.forward(35) a.right(150) a.forward(20) a.end_fill() a.up() a.goto(400, -300) a.down() a.write('作者:爱苗苗的凡哥', move = True, align = 'left', font = ('楷体', 20, 'normal')) done() -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

通过KNN算法预测数据所属NBA球员——Python实现

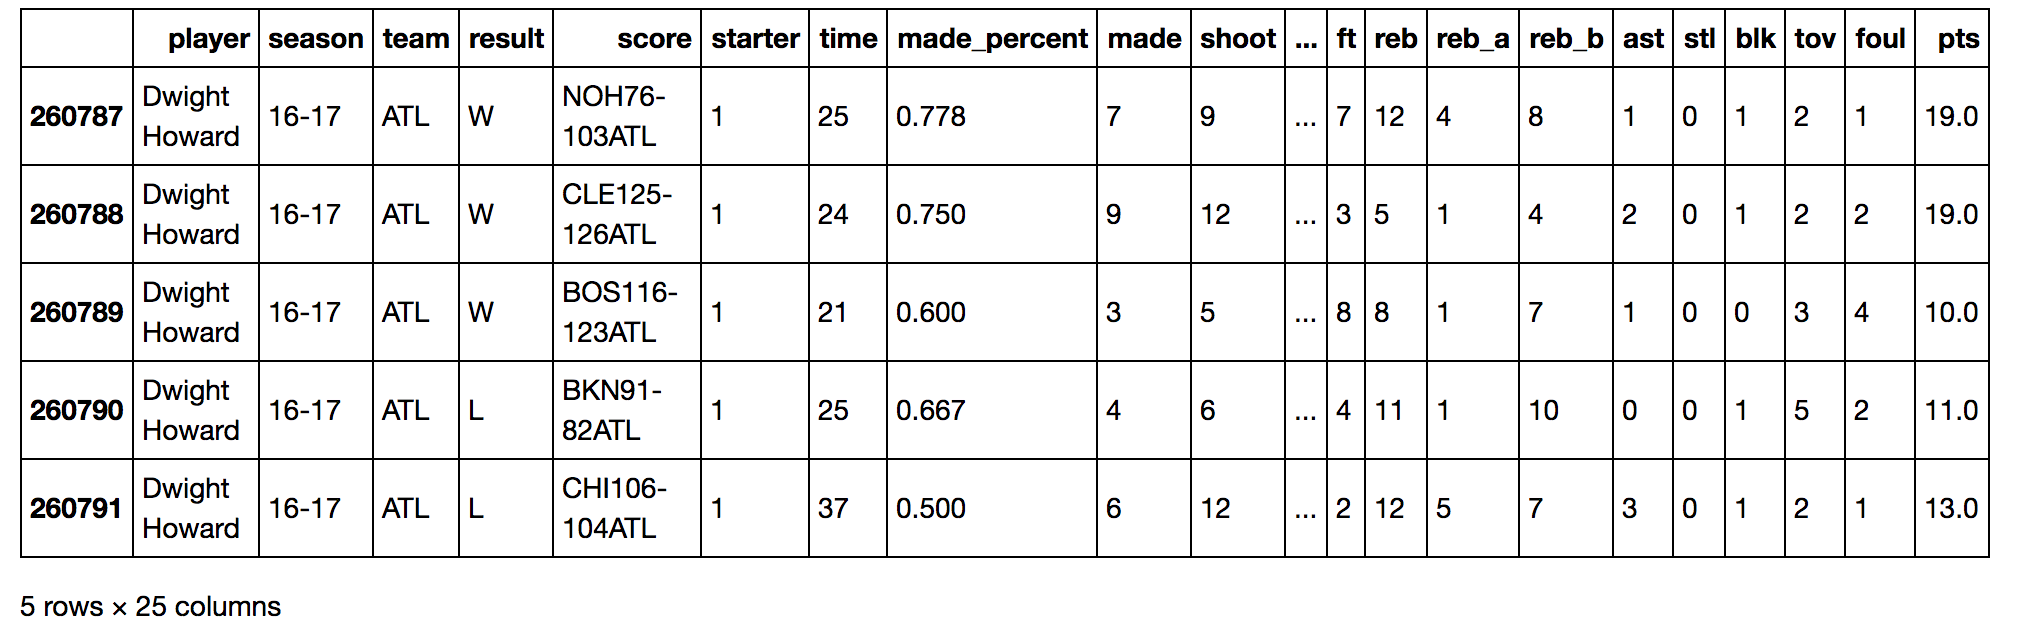
项目介绍 通过得分,篮板,助攻,出场时间四个数据来预测属于哪位球员。 选取了'LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'五位球员单场数据。 数据来源 本文使用数据全部来自于科赛网 ,字段解释如下: 字段 内容 player 球员 pts 得分 reb 篮板 ast 助攻 time 出场时间 season 赛季 项目内容 导入所需包 import pandas as pd import seaborn as sns import matplotlib.pyplot as plt import numpy as np from sklearn.neighbors import KNeighborsClassifier as KNN 导入数据 由于seaborn包作图对中文并不是很友好,我们将原有的字段名都设置为英文。选取我们所需要的五位球员数据命名为data。 #设置主题 sns.set(style="ticks") #导入数据 data = pd.read_csv('/Users/***/Downloads/NBA.zip/player_season.csv',encoding = 'utf-8') #避免seaborn包中文显示为方框问题,改为英文 data.columns = ['player', 'season', 'team', 'result', 'score', 'starter', 'time', 'made_percent', 'made', 'shoot', '3_made_percent', '3_made', '3_shoot', 'ft_percent', 'fta', 'ft', 'reb', u'reb_a', 'reb_b', 'ast', 'stl', 'blk', 'tov', 'foul', 'pts'] data = data.loc[data['player'].isin(['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'])] data.head() image.png 可视化 其实这一步本身是不需要的,但我们还是想先在训练之前看下不同球员的数据特点。 首先我们通过散点图看5位球员的得分情况 霍华德,哈登,勒夫在进入联盟初期都有一段适应期,都经历了两三个赛季后有较大提升,哈登上升最为明显,从当年的雷霆三少到开始独自带队之后,开启砍分模式,霍华德/勒夫最近几个赛季由于战术地位的下降,数据也开始下滑; 詹姆斯/保罗数据比较稳定,‘出道即巅峰,一巅十五年’说詹姆斯真是没错; 单从得分来看,能看出些差别,但不是很明显,尤其是都步入稳定期之后,差别很小; …… plt.figure(figsize = (15,8)) #设置绘图尺寸 sns.stripplot(x='season', y='pts',data = data ,hue = 'player',jitter=True,size = 5) image.png 接下来我们通过密度图看下5位球员在篮板助攻上的表现: 首先是詹姆斯,在篮板助攻上都有不错的表现,非常全面; 保罗助攻上表现很抢眼,组织能力出色,篮板也不错,4,5个居多 哈登篮板助攻都比较低,还是以得分见长; 勒夫/霍华德两位内线球员都是篮板数据更多,相比于霍华德,勒夫分球能力更强; 霍华德在助攻上有明显的三个区间,最高的那段肯定是在魔术没错了,当年可是能单换詹姆斯的人; …… f, axes = plt.subplots(3, 2, figsize=(8, 12)) player_list = ['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'] for ax,name,s in zip(axes.flat,player_list,np.linspace(0, 3, 5)): cmap = sns.cubehelix_palette(start=s, light=1, as_cmap=True) x = data[data['player']==name].reb y = data[data['player']==name].ast sns.kdeplot(x, y, cmap=cmap, shade=True, cut=5, ax=ax) ax.set(xlim=(0, 20), ylim=(0, 20)) f.tight_layout() image.png 各项数据看完心里算是有了一个大概,每个球员都有自己的技术特点: 保罗善于传球,所以助攻多; 哈登得分能力强,但篮板助攻都偏低; 霍华德篮板能力强,助攻偏弱; 相比于霍华德,勒夫助攻要更多; 詹姆斯全面,从数据上就可以展现; …… 最后我们16-17赛季的数据作为测试集,其他赛季的数据作为训练集,看看预测准确率能够达到多少~ #取16-17赛季数据作为测试集 data_train = data[data['season']!=u'16-17'] data_test = data[data['season']==u'16-17'] #得分,篮板,助攻,出场时间为特征,球员为标签 train_x = np.array(data_train[['pts','reb','ast','time']]).tolist() train_y = np.array(data_train[['player']]).tolist() test_x = np.array(data_test[['pts','reb','ast','time']]).tolist() test_y = np.array(data_test[['player']]).tolist() #训练模型 neigh = KNN(n_neighbors=10) neigh.fit(train_x, train_y) #使用模型预测,最后与实际结果对计算准确率 m = 0.0 n = 0.0 for x,y in zip(test_x,test_y): if neigh.predict([x])[0] == y[0]: n = n+1 m = m+1 print '预测准确率为:%.2f%%' % (n/m*100) 预测准确率为:49.143% 最后准确率50%不到,马马虎虎~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册