首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6164篇文章
优秀的个人博客,低调大师

elasticsearch function_score Query——文档排序结果的最后一道墙

function_score Query Thefunction_scorequeryis the ultimate tool for taking control of the scoring process.It allows you to apply a function to each document that matches the main query in order to alter or completely replace the original query_score. In fact, you can apply different functions tosubsetsof the main result set by using filters, which gives you the best of both worlds: efficient scoring with cacheable filters. It supports several predefined functions out of the box: weight Apply a simple boost to each document without the boost being normalized: a weightof 2results in 2 * _score. field_value_factor Use the value of a field in the document to alter the _score, such as factoring in a popularitycount or number of votes. random_score Use consistently random scoring to sort results differently for every user, while maintaining the same sort order for a single user. Decay functions—linear,exp,gauss Incorporate sliding-scale values like publish_date, geo_location, or priceinto the _scoreto prefer recently published documents, documents near a latitude/longitude (lat/lon) point, or documents near a specified price point. script_score Use a custom script to take complete control of the scoring logic. If your needs extend beyond those of the functions in this list, write a custom script to implement the logic that you need. Without thefunction_scorequery, we would not be able to combine the score from a full-text query with a factor like recency. We would have to sort either by_scoreor bydate; the effect of one would obliterate the effect of the other. This query allows you to blend the two together: to still sort by full-text relevance, but giving extra weight to recently published documents, or popular documents, or products that are near the user’s price point. As you can imagine, a query that supports all of this can look fairly complex. We’ll start with a simple use case and work our way up the complexity ladder. 转自:https://www.elastic.co/guide/en/elasticsearch/guide/current/function-score-query.html 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6480761.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

程序员必须要会的线程池,附10道面试题

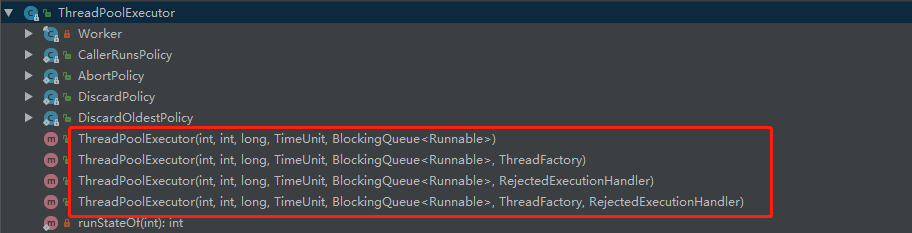
为什么要用线程池呢? 下面是一段创建线程并运行的代码: for (int i = 0; i < 100; i++) { new Thread(() -> { System.out.println("run thread->" + Thread.currentThread().getName()); userService.updateUser(....); }).start(); } 我们想使用这种方式去做异步,或者提高性能,然后将某些耗时操作放入一个新线程去运行。 这种思路是没问题的,但是这段代码是存在问题的,有哪些问题呢?下面我们就来看看有哪些问题; 创建销毁线程资源消耗;我们使用线程的目的本是出于效率考虑,可以为了创建这些线程却消耗了额外的时间,资源,对于线程的销毁同样需要系统资源。 cpu资源有限,上述代码创建线程过多,造成有的任务不能即时完成,响应时间过长。 线程无法管理,无节制地创建线程对于有限的资源来说似乎成了“得不偿失”的一种作用。 既然我们上面使用手动创建线程会存在问题,那有解决方法吗? 答案:有的,使用线程池。 线程池介绍 线程池(Thread Pool):把一个或多个线程通过统一的方式进行调度和重复使用的技术,避免了因为线程过多而带来使用上的开销。 线程池有什么优点? 降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。 提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。 提高线程的可管理性。 线程池使用 在JDK中rt.jar包下JUC(java.util.concurrent)创建线程池有两种方式:ThreadPoolExecutor 和 Executors,其中 Executors又可以创建 6 种不同的线程池类型。 ThreadPoolExecutor 的使用 线程池使用代码如下: import java.util.concurrent.LinkedBlockingQueue; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; ​ public class ThreadPoolDemo { private static ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(2, 10, 10L, TimeUnit.SECONDS, new LinkedBlockingQueue(100)); ​ public static void main(String[] args) { threadPoolExecutor.execute(new Runnable() { @Override public void run() { System.out.println("田先生您好"); } }); } } 以上程序执行结果如下: 田先生您好 核心参数说明 ThreadPoolExecutor的构造方法有以下四个: 可以看到最后那个构造方法有 7 个构造参数,其实前面的三个构造方法只是对最后那个方法进行包装,并且前面三个构造方法最终都是调用最后那个构造方法,所以我们这里就来聊聊最后那个构造方法。 参数解释 corePoolSize 线程池中的核心线程数,默认情况下核心线程一直存活在线程池中,如果将 ThreadPoolExecutor 的 allowCoreThreadTimeOut 属性设为 true,如果线程池一直闲置并超过了 keepAliveTime 所指定的时间,核心线程就会被终止。 maximumPoolSize 最大线程数,当线程不够时能够创建的最大线程数。 keepAliveTime 线程池的闲置超时时间,默认情况下对非核心线程生效,如果闲置时间超过这个时间,非核心线程就会被回收。如果 ThreadPoolExecutor 的 allowCoreThreadTimeOut 设为 true 的时候,核心线程如果超过闲置时长也会被回收。 unit 配合 keepAliveTime 使用,用来标识 keepAliveTime 的时间单位。 workQueue 线程池中的任务队列,使用 execute() 或 submit() 方法提交的任务都会存储在此队列中。 threadFactory 为线程池提供创建新线程的线程工厂。 rejectedExecutionHandler 线程池任务队列超过最大值之后的拒绝策略,RejectedExecutionHandler 是一个接口,里面只有一个 rejectedExecution 方法,可在此方法内添加任务超出最大值的事件处理。ThreadPoolExecutor 也提供了 4 种默认的拒绝策略: DiscardPolicy():丢弃掉该任务,不进行处理。 DiscardOldestPolicy():丢弃队列里最近的一个任务,并执行当前任务。 AbortPolicy():直接抛出 RejectedExecutionException 异常(默认)。 CallerRunsPolicy():既不抛弃任务也不抛出异常,直接使用主线程来执行此任务。 包含所有参数的使用案例: public class ThreadPoolExecutorTest { public static void main(String[] args) throws InterruptedException, ExecutionException { ThreadPoolExecutor threadPool = new ThreadPoolExecutor(1, 1, 10L, TimeUnit.SECONDS, new LinkedBlockingQueue<Runnable>(2), new MyThreadFactory(), new ThreadPoolExecutor.CallerRunsPolicy()); threadPool.allowCoreThreadTimeOut(true); for (int i = 0; i < 10; i++) { threadPool.execute(new Runnable() { @Override public void run() { System.out.println(Thread.currentThread().getName()); try { Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } } }); } } } class MyThreadFactory implements ThreadFactory { private AtomicInteger count = new AtomicInteger(0); @Override public Thread newThread(Runnable r) { Thread t = new Thread(r); String threadName = "MyThread" + count.addAndGet(1); t.setName(threadName); return t; } } 运行输出: main MyThread1 main MyThread1 MyThread1 .... 这里仅仅是为了演示所有参数自定义,并没有其他用途。 execute() 和 submit()的使用 execute() 和 submit() 都是用来执行线程池的,区别在于 submit() 方法可以接收线程池执行的返回值。 下面分别来看两个方法的具体使用和区别: // 创建线程池 ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(2, 10, 10L, TimeUnit.SECONDS, new LinkedBlockingQueue(100)); // execute 使用 threadPoolExecutor.execute(new Runnable() { @Override public void run() { System.out.println("老田您好"); } }); // submit 使用 Future<String> future = threadPoolExecutor.submit(new Callable<String>() { @Override public String call() throws Exception { System.out.println("田先生您好"); return "返回值"; } }); System.out.println(future.get()); 以上程序执行结果如下: 老田您好 田先生您好 返回值 Executors Executors 执行器创建线程池很多基本上都是在 ThreadPoolExecutor 构造方法上进行简单的封装,特殊场景根据需要自行创建。可以把Executors理解成一个工厂类 。Executors可以创建 6 种不同的线程池类型。 下面对这六个方法进行简要的说明: newFixedThreadPool 创建一个数量固定的线程池,超出的任务会在队列中等待空闲的线程,可用于控制程序的最大并发数。 newCacheThreadPool 短时间内处理大量工作的线程池,会根据任务数量产生对应的线程,并试图缓存线程以便重复使用,如果限制 60 秒没被使用,则会被移除缓存。如果现有线程没有可用的,则创建一个新线程并添加到池中,如果有被使用完但是还没销毁的线程,就复用该线程。终止并从缓存中移除那些已有 60 秒钟未被使用的线程。因此,长时间保持空闲的线程池不会使用任何资源。 newScheduledThreadPool 创建一个数量固定的线程池,支持执行定时性或周期性任务。 newWorkStealingPool Java 8 新增创建线程池的方法,创建时如果不设置任何参数,则以当前机器CPU 处理器数作为线程个数,此线程池会并行处理任务,不能保证执行顺序。 newSingleThreadExecutor 创建一个单线程的线程池。这个线程池只有一个线程在工作,也就是相当于单线程串行执行所有任务。如果这个唯一的线程因为异常结束,那么会有一个新的线程来替代它。此线程池保证所有任务的执行顺序按照任务的提交顺序执行。 newSingleThreadScheduledExecutor 此线程池就是单线程的 newScheduledThreadPool。 线程池如何关闭? 线程池关闭,可以使用 shutdown() 或 shutdownNow() 方法,它们的区别是: shutdown():不会立即终止线程池,而是要等所有任务队列中的任务都执行完后才会终止。执行完 shutdown 方法之后,线程池就不会再接受新任务了。 shutdownNow():执行该方法,线程池的状态立刻变成 STOP 状态,并试图停止所有正在执行的线程,不再处理还在池队列中等待的任务,执行此方法会返回未执行的任务。 下面用代码来模拟 shutdown() 之后,给线程池添加任务,代码如下: import java.util.concurrent.*; import java.util.concurrent.atomic.AtomicInteger; ​ public class ThreadPoolExecutorAllArgsTest { public static void main(String[] args) throws InterruptedException, ExecutionException { //创建线程池 ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(1, 1, 10L, TimeUnit.SECONDS, new LinkedBlockingQueue<Runnable>(2), new MyThreadFactory(), new ThreadPoolExecutor.CallerRunsPolicy()); threadPoolExecutor.allowCoreThreadTimeOut(true); //提交任务 threadPoolExecutor.execute(() -> { for (int i = 0; i < 3; i++) { System.out.println("提交任务" + i); try { Thread.sleep(3000); } catch (InterruptedException e) { System.out.println(e.getMessage()); } } }); threadPoolExecutor.shutdown(); //再次提及任务 threadPoolExecutor.execute(() -> { System.out.println("我想再次提及任务"); }); } } 以上程序执行结果如下: 提交任务0 提交任务1 提交任务2 可以看出,shutdown() 之后就不会再接受新的任务了,不过之前的任务会被执行完成。 面试题 面试题1:ThreadPoolExecutor 有哪些常用的方法? ThreadPoolExecutor有如下常用方法: submit()/execute():执行线程池 shutdown()/shutdownNow():终止线程池 isShutdown():判断线程是否终止 getActiveCount():正在运行的线程数 getCorePoolSize():获取核心线程数 getMaximumPoolSize():获取最大线程数 getQueue():获取线程池中的任务队列 allowCoreThreadTimeOut(boolean):设置空闲时是否回收核心线程 这些方法可以用来终止线程池、线程池监控等。 面试题2:说说submit(和 execute两个方法有什么区别? submit() 和 execute() 都是用来执行线程池的,只不过使用 execute() 执行线程池不能有返回方法,而使用 submit() 可以使用 Future 接收线程池执行的返回值。 说说线程池创建需要的那几个核心参数的含义 ThreadPoolExecutor 最多包含以下七个参数: corePoolSize:线程池中的核心线程数 maximumPoolSize:线程池中最大线程数 keepAliveTime:闲置超时时间 unit:keepAliveTime 超时时间的单位(时/分/秒等) workQueue:线程池中的任务队列 threadFactory:为线程池提供创建新线程的线程工厂 rejectedExecutionHandler:线程池任务队列超过最大值之后的拒绝策略 面试题3:shutdownNow() 和 shutdown() 两个方法有什么区别? shutdownNow() 和 shutdown() 都是用来终止线程池的,它们的区别是,使用 shutdown() 程序不会报错,也不会立即终止线程,它会等待线程池中的缓存任务执行完之后再退出,执行了 shutdown() 之后就不能给线程池添加新任务了;shutdownNow() 会试图立马停止任务,如果线程池中还有缓存任务正在执行,则会抛出 java.lang.InterruptedException: sleep interrupted 异常。 面试题6:了解过线程池的工作原理吗? 当线程池中有任务需要执行时,线程池会判断如果线程数量没有超过核心数量就会新建线程池进行任务执行,如果线程池中的线程数量已经超过核心线程数,这时候任务就会被放入任务队列中排队等待执行;如果任务队列超过最大队列数,并且线程池没有达到最大线程数,就会新建线程来执行任务;如果超过了最大线程数,就会执行拒绝执行策略。 面试题5:线程池中核心线程数量大小怎么设置? 「CPU密集型任务」:比如像加解密,压缩、计算等一系列需要大量耗费 CPU 资源的任务,大部分场景下都是纯 CPU 计算。尽量使用较小的线程池,一般为CPU核心数+1。因为CPU密集型任务使得CPU使用率很高,若开过多的线程数,会造成CPU过度切换。 「IO密集型任务」:比如像 MySQL 数据库、文件的读写、网络通信等任务,这类任务不会特别消耗 CPU 资源,但是 IO 操作比较耗时,会占用比较多时间。可以使用稍大的线程池,一般为2*CPU核心数。IO密集型任务CPU使用率并不高,因此可以让CPU在等待IO的时候有其他线程去处理别的任务,充分利用CPU时间。 另外:线程的平均工作时间所占比例越高,就需要越少的线程;线程的平均等待时间所占比例越高,就需要越多的线程; 以上只是理论值,实际项目中建议在本地或者测试环境进行多次调优,找到相对理想的值大小。 面试题7:线程池为什么需要使用(阻塞)队列? 主要有三点: 因为线程若是无限制的创建,可能会导致内存占用过多而产生OOM,并且会造成cpu过度切换。 创建线程池的消耗较高。 面试题8:线程池为什么要使用阻塞队列而不使用非阻塞队列? 阻塞队列可以保证任务队列中没有任务时阻塞获取任务的线程,使得线程进入wait状态,释放cpu资源。 当队列中有任务时才唤醒对应线程从队列中取出消息进行执行。 使得在线程不至于一直占用cpu资源。 (线程执行完任务后通过循环再次从任务队列中取出任务进行执行,代码片段如下 while (task != null || (task = getTask()) != null) {})。 不用阻塞队列也是可以的,不过实现起来比较麻烦而已,有好用的为啥不用呢? 面试题9:了解线程池状态吗? 通过获取线程池状态,可以判断线程池是否是运行状态、可否添加新的任务以及优雅地关闭线程池等。 RUNNING:线程池的初始化状态,可以添加待执行的任务。 SHUTDOWN:线程池处于待关闭状态,不接收新任务仅处理已经接收的任务。 STOP:线程池立即关闭,不接收新的任务,放弃缓存队列中的任务并且中断正在处理的任务。 TIDYING:线程池自主整理状态,调用 terminated() 方法进行线程池整理。 TERMINATED:线程池终止状态。 面试题10:知道线程池中线程复用原理吗? 线程池将线程和任务进行解耦,线程是线程,任务是任务,摆脱了之前通过 Thread 创建线程时的一个线程必须对应一个任务的限制。 在线程池中,同一个线程可以从阻塞队列中不断获取新任务来执行,其核心原理在于线程池对 Thread 进行了封装,并不是每次执行任务都会调用 Thread.start() 来创建新线程,而是让每个线程去执行一个“循环任务”,在这个“循环任务”中不停的检查是否有任务需要被执行,如果有则直接执行,也就是调用任务中的 run 方法,将 run 方法当成一个普通的方法执行,通过这种方式将只使用固定的线程就将所有任务的 run 方法串联起来。 总结 本文通过没有使用线程池带来的弊端,Executors介绍,Executors的六种方法介绍、如何使用线程池,了解线程池原理,核心参数,以及10到线程池面试题。 「成功不是将来才有的,而是从决定去做的那一刻起,持续累积而成。」

优秀的个人博客,低调大师

这8道接口测试面试题!你如果都答好,I want you!

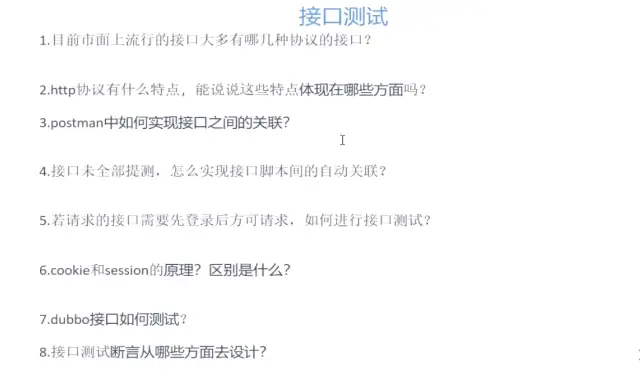
接口测试常见的问题了。 大家乍一看! 接口测试面试题 这几个问题,能答出来几个?有没有8个都能够完美的答出来的?在留言区打出你的数字。(0~8) 这些问题你回答起来,不要吞吞吐吐只说几个关键字。你要从多方面去给面试官总结分析那些场景,如何去做的,遇到的问题…… 接口测试的重要性,相信不用我多说了。接口测试是现在软件测试工程师一个加分项。因为很多朋友一开始做了几年的软件测试都是在做功能测试,做界面UI的测试,然而没有做过接口测试。(很正常很普遍) 那么接口测试它在企业中,能达到非常好的收益。后端、服务端的测试,特别是现在!像是前面几年,物联网公司没有做一个前后端分离,现在基本上都是微服务架构,前后端分离。接口非常重要,现在2020年了,未来几年你去做测试,很多都是接口。 一个接口它可以支持安卓、IOS、H5、Web端。而且接口测试可以测很多你在界面上无法去测试的一些范围和类型。 我们来看一看这几个问题,从简单的来。 第一题,大家绝大部分都能够答得出来 1.目前市面上流行的接口大多有哪几种协议的接口? 大家可能就非常了解,Http、Https、RPC、Websocket、还有一个Dubbo接口,这些类型百度一下也都能够比较全面的得到答案。 所以我一直传输给大家一个观念就是说,假如面试官问你这个问题,你不仅要说有Http、Https……说完这几种类型,你还可以多说几句,比如说我之前在项目中测试过Http的,怎么测试的,用什么测试工具测试的,这是我一直传输给大家的一个面试小技巧。因为我之前在企业中做为面试官的时候,当听到这种面试题回答的时候,会更加分。 因为如果我问你一个问题,你答Http、Https就没了,那么说明你这个人的积极性和你的一个综合能力、见识都不是非常的亮眼突出。理解我的意思吗?不管面试官问你什么问题,你都要非常全面的去解答。 比如说第二个问题 2.http协议有什么特点,能说说这些特点体现在哪些方面吗? 可能会有朋友就说,安全。 Http就安全了吗?(Https才相对安全) a.无状态 b.灵活 c.无连接 d.简单快速 那么我又来问大家,这些状态这些特点,具体体现在哪些方面? 可能问到这个问题的后面部分,有些朋友就要头皮发麻了。 它为什么叫做无状态,为什么灵活?可能像这种问题就又刷下去了一大批人。有很多朋友特点可能说了一个,但是这些特点具体体现在哪些方面。你如果没有答出来,那面试官就觉得你没有做过很多的接口测试,你对接口根本不是很了解,那你对接口既然不了解,做过的测试也不多,那你还说你做过接口测试,那都只是片面的。 那首先它无状态,灵活,说一个最简单的。灵活,大家都知道,像Http类型的接口我们用Postman来做测试,它为什么比较灵活?它支持的参数类型是任意类型 这个就是我之前搭建的接口项目 它来做测试的时候,这个参数类型,表单,文件上传类型,还有JSON类型,Text文本,JS,XML,HTML 你的参数可以支持任意类型 你的参数可以支持任意类型,所以说它比较灵活。 那为什么说它简单快速?你只需要传一些接口的请求方法和请求路径,通信速度非常快,它就能给到你响应的数据。 比如说很简单,我之前写的一个demo接口 你只需要告诉我,这个地址和这个接口的路径,或者说接口的名称,我就能请求这个接口了,就能快速的拿到下面的值。那是不是说它非常的简单快速呢,不像Dubbo接口不像Websocket,不像其他的接口,稍微你要去测试,去请求可能难一点。这就说明它简单快速。 无状态。比如说你现在要去支付一笔订单,你要点一个外卖,那么你支付订单的时候,那么我怎么知道你的购物车里面加了哪些东西呢?其实你加购物车、下订单、登录其实都是相应的接口,他们之间其实是没有一个实物处理记忆能力的,Http协议它请求成功之后没有记忆了。所以说你每次去请求新的接口,它都有一个新的请求,那么为什么现在这种下单、登录加购物车能够非常灵活的应用起来呢?这就还有它中间的一些机制,会用到一些Session、Cookie、和一些Token,所以这就是它的一个原理。 那么无连接。怎么理解? 那我自己的一个项目来说吧!这是之前搭建的一个测试项目管理平台 那么每次我们去请求的时候,Network刷新一下,它可能去请求了很多个接口,所以说每次连接它只处理一个请求。服务端当处理其中一个接口的时候,它只请求这一个,请求完之后,它就马上断开连接,节省这个传输的时间,所以这是一个无连接。 所以这些特点体现在哪些方面,你能说一说的话,说明你对这个接口你比较有心得了。有收获记得点赞支持一下! 3.postman中如何实现接口之间的关联? 我想这个可能还不是最难的问题,可能大家用过,像第二个问题比较综合性的往往是大家比较薄弱的东西。 比如说这是一个正规的接口文档,有哪些接口就用Postman全部写一遍,然后如何接口之间的关联,这里会用到这些东西。 怎么设置关联,将数据解析成Json格式,获取topic_id的值,设置成环境变量,等等。这就能实现接口之间的关联。 然后你在这里会发现,这里有很多环境变量或者全局变量,这就是接口之间的关联。 5.若请求的接口需要先登录后方可请求,如何进行接口测试? 比如说有些接口需要先登录才请求,那如何来进行接口测试?先登录,比如我问你这个问题你怎么来回答? 因为很多需要请求的接口它需要先认证才能去请求。 Token? 这个回答不对,Token从哪里来?你需要去请求什么样的接口,你的登录接口或者去哪里去拿到,这个问题还是比较简单的,大家可以做为作业区用心学习一下。 7.dubbo接口如何测试? 那我们来看看像这种Dubbo如何去进行测试?这个有了解过吗?因为现在越来越多的公司可能不仅用Http他还会用到Dubbo接口。dubbo接口是我们(用的阿里云服务器)阿里巴巴开源的一个高性能的服务框架,Dubbo是经历过双十一的一个摧残优秀的RPC框架,很多公司都在用了,但是你又没有听说过,额,怎么还会有这个接口啊?你听都没有听说过,那么你在面试官那里……因为面试的公司很有可能就是做的Dubbo接口,那你来做接口测试,你连Dubbo都不知道,那我是不是又要培养你一个月?告诉你什么是Dubbo,怎么测试Dubbo,还说让你来做Dubbo接口自动化,那更加。就算招你进去了,你也是一个新手,菜鸟的身份进去的,你的工资是很难提上去的。 比如他工资本来开的是15K-20K,那么就算你能面试进去了,你最多最多拿到15K。那还要看你的运气,看你其他方面的一个加分项,来抵消这个暂时的短板。 面试官:什么是Dubbo? 我:我、我、我抓一抓后脑勺,摸摸手臂,扣一扣指甲。 然后就是说……吞吞吐吐答不出来(内心独白:到底什么时候结束这个面试,你赶快把简历还给我吧,QAQ) 我还准备去下一家公司去“吹牛皮”也许下一家公司面试官不会问到我不会的问题。 大家不要抱着这样的心态,我发现做测试真的这样一个现状,很多朋友就觉得能混,我现在做功能测试不用任何的技术,能拿个7.8K,一万的工资,也可以。至少要比其他的行业的底薪是要高一些。 所以就存在这个现象,他不会很多的技术,没有很多的技能他也能混,或者运气好,在一线城市需求多。为什么很多测试在一线城市能够拿到10-15K,他不会任何的技术,因为一线城市的需求多很多。 但是你想要突破,想突破15K,突破18K那就难上加难了,而且如果你从大城市工作三到五年,你再回去到二线城市去做测试,那么你还想来混,那么你的工资就可能只有5-6K了,而且你没有任何的技术,你说你从大城市回来的,都觉得有点不好意思说。 你从大城市回来的,你带回来了什么先进的概念,带来了什么先进的技术,是不是? 说远了,回归正题。 文章首发于公众号:程序员一凡 转载请注明出处! . Dubbo的一个测试关键,搭建消费者,你需要去理解的Dubbo接口的基础架构基础服务到底是一个什么样的原理。(有一个接口测试训练营有讲到这个原理以及如何去测试,需要视频教程可以免费领取) 我在这个服务器上搭建了一个Dubbo服务 最简单的方式用,Telnet,我的IP地址,然后加一个端口,其实测试起来和Http原理都一样。 开启服务之后,进去之后就是一个Dubbo 我们还可以用代码来写 这里封装了一个Dubbo的方法,类。需要完整视频版教学可以公众号主页点击领取资料即可。 8.接口测试断言从哪些方面去设计? 如果我把这个接口测试改成功能测试,功能测试断言从哪些方面去设计? 你要怎么去校验一个测试用例,我觉得这个是很多做测试的朋友最擅长的东西,那么我问接口测试呢? 其实接口测试也属于功能测试,也是黑盒测试。 比如说这个接口,我去发送一个请求,你怎么去校验这个接口,我怎么去判断我这个用例到底是不是对的,我这个用例到底是验证了什么东西 到底什么是401,什么情况下会401,或者是403 Forbidden到底是什么情况。 1.状态码 它会不会返回200,会不会返回401,403,返回500等等 2.返回值 返回值比如我拿一个正确的吧,状态码200,返回了一大堆的值,那么这个返回值里面就有很多东西需要去校验了,怎么去校验这个返回值? 3.而且返回值里面很多数据是动态的,这个时候要怎么去设置?要考虑数据库校验吧,很多字段的值来源于数据库 非关系型数据库(Mongo) 4.空校验,异常校验, 5.幂等性 幂等性的校验在接口测试是一个常见的校验,比如说你一个接口我调用一次正常了,你能保证它之后调用都是正常的吗?这些数据、参数几百个不同类型的参数,我调用一百次,会是一个什么样的情况? 幂等性,我重复执行一百次,它会返回什么。 或者我去买一个外卖,下单,但是我不支付,是不是我点击下单一百次,它会不会产生很多垃圾数据在我们数据库里面。 其实还有很多需要你去测试的,为什么接口测试这么重要,要测试的东西和功能测试一样方方面面都是需要考虑到的。 6.流程节点限制 举一个异常例子吧,比如说你在支付的时候,我只下单没有付钱,那么像这个接口的返回值。我先调用下单的接口,我拿到一些数据再去调用别人正常支付后的接口。会是一个什么样的场景,有没有做一些限制。 接口测试很容易做一个数据驱动,做一些自动化,我们都要去尽可能的全面的覆盖做一个接口自动化,那么你的效益是非常高的。而且你把这一套全部做成自动化,不管是后端开发人员还是前端开发人员还是测试,你在企业中本人价值也是非常高的。 如果面试官觉得你答对了,再深入一点,什么是异常校验?就是来评判你能不能达到一个高级测试工程师。 异常校验 数据异常,环境异常,前置条件异常,大家都知道做过接口测试的朋友都知道接口有很多的前置条件,前置条件连接数据库或者数据的预制,那么这些前置条件有没有异常导致我们接口异常。 所以像这种问题,你如果没有真实的项目经验,你绝对总结不出来也回答不出来。 文章首发于公众号:程序员一凡 转载请注明出处! 愿你我相遇,皆有所获! 欢迎关注微信公众号:程序员一凡 1.免费领取一份216页软件测试工程师面试宝典文档资料。 2.软件测试学习路线以及相对应的视频学习教程免费分享!

优秀的个人博客,低调大师

2019年面试官最喜欢问的28道ZooKeeper面试题

前言 ZooKeeper 是一个分布式的,开放源码的分布式应用程序协调服务。它是一个为分布式应用提供一致性服务的软件,提供的功能包括:配置维护、域名服务、分布式同步、组服务等。ZooKeeper 的目标就是封装好复杂易出错的关键服务,将简单易用的接口和性能高效、功能稳定的系统提供给用户。 ZooKeeper 面试题 ZooKeeper 是什么? ZooKeeper 提供了什么? Zookeeper 文件系统 ZAB 协议? 四种类型的数据节点 Znode Zookeeper Watcher 机制 -- 数据变更通知 客户端注册 Watcher 实现 服务端处理 Watcher 实现 客户端回调 Watcher ACL 权限控制机制 Chroot 特性 会话管理 服务器角色 Zookeeper 下 Server 工作状态 数据同步 zookeeper 是如何保证事务的顺序一致性的? 分布式集群中为什么会有 Master? zk 节点宕机如何处理? zookeeper 负载均衡和 nginx 负载均衡区别 Zookeeper 有哪几种几种部署模式? 集群最少要几台机器,集群规则是怎样的? 集群支持动态添加机器吗? Zookeeper 对节点的 watch 监听通知是永久的吗?为什么不是永久的? Zookeeper 的 java 客户端都有哪些? chubby 是什么,和 zookeeper 比你怎么看? 说几个 zookeeper 常用的命令。 ZAB 和 Paxos 算法的联系与区别? Zookeeper 的典型应用场景 ZooKeeper面试题答案解析 1. ZooKeeper 是什么? ZooKeeper 是一个开放源码的分布式协调服务,它是集群的管理者,监视着集群中各个节点的状态根据节点提交的反馈进行下一步合理操作。最终,将简单易用的接口和性能高效、功能稳定的系统提供给用户。分布式应用程序可以基于 Zookeeper 实现诸如数据发布/订阅、负载均衡、命名服务、分布式协调/通知、集群管理、Master 选举、分布式锁和分布式队列等功能。Zookeeper 保证了如下分布式一致性特性:(1)顺序一致性(2)原子性(3)单一视图(4)可靠性(5)实时性(最终一致性)客户端的读请求可以被集群中的任意一台机器处理,如果读请求在节点上注册了监听器,这个监听器也是由所连接的 zookeeper 机器来处理。对于写请求,这些请求会同时发给其他 zookeeper 机器并且达成一致后,请求才会返回成功。因此,随着 zookeeper 的集群机器增多,读请求的吞吐会提高但是写请求的吞吐会下降。有序性是 zookeeper 中非常重要的一个特性,所有的更新都是全局有序的,每个更新都有一个唯一的时间戳,这个时间戳称为 zxid(Zookeeper Transaction Id)。而读请求只会相对于更新有序,也就是读请求的返回结果中会带有这个zookeeper 最新的 zxid。 2. ZooKeeper 提供了什么? (1)文件系统(2)通知机制 3.Zookeeper 文件系统 Zookeeper 提供一个多层级的节点命名空间(节点称为 znode)。与文件系统不同的是,这些节点都可以设置关联的数据,而文件系统中只有文件节点可以存放数据而目录节点不行。Zookeeper 为了保证高吞吐和低延迟,在内存中维护了这个树状的目录结构,这种特性使得 Zookeeper 不能用于存放大量的数据,每个节点的存放数据上限为1M。 4. ZAB 协议? ZAB 协议是为分布式协调服务 Zookeeper 专门设计的一种支持崩溃恢复的原子广播协议。ZAB 协议包括两种基本的模式:崩溃恢复和消息广播。当整个 zookeeper 集群刚刚启动或者 Leader 服务器宕机、重启或者网络故障导致不存在过半的服务器与 Leader 服务器保持正常通信时,所有进程(服务器)进入崩溃恢复模式,首先选举产生新的 Leader 服务器,然后集群中 Follower 服务器开始与新的 Leader 服务器进行数据同步,当集群中超过半数机器与该 Leader服务器完成数据同步之后,退出恢复模式进入消息广播模式,Leader 服务器开始接收客户端的事务请求生成事物提案来进行事务请求处理。 5. 四种类型的数据节点 Znode (1)PERSISTENT-持久节点除非手动删除,否则节点一直存在于 Zookeeper 上(2)EPHEMERAL-临时节点临时节点的生命周期与客户端会话绑定,一旦客户端会话失效(客户端与zookeeper 连接断开不一定会话失效),那么这个客户端创建的所有临时节点都会被移除。(3)PERSISTENT_SEQUENTIAL-持久顺序节点基本特性同持久节点,只是增加了顺序属性,节点名后边会追加一个由父节点维护的自增整型数字。(4)EPHEMERAL_SEQUENTIAL-临时顺序节点基本特性同临时节点,增加了顺序属性,节点名后边会追加一个由父节点维护的自增整型数字。 6. Zookeeper Watcher 机制 -- 数据变更通知 Zookeeper 允许客户端向服务端的某个 Znode 注册一个 Watcher 监听,当服务端的一些指定事件触发了这个 Watcher,服务端会向指定客户端发送一个事件通知来实现分布式的通知功能,然后客户端根据 Watcher 通知状态和事件类型做出业务上的改变。工作机制:(1)客户端注册 watcher(2)服务端处理 watcher(3)客户端回调 watcherWatcher 特性总结:(1)一次性无论是服务端还是客户端,一旦一个 Watcher 被 触 发 ,Zookeeper 都会将其从相应的存储中移除。这样的设计有效的减轻了服务端的压力,不然对于更新非常频繁的节点,服务端会不断的向客户端发送事件通知,无论对于网络还是服务端的压力都非常大。(2)客户端串行执行客户端 Watcher 回调的过程是一个串行同步的过程。(3)轻量3.1、Watcher 通知非常简单,只会告诉客户端发生了事件,而不会说明事件的具体内容。3.2、客户端向服务端注册 Watcher 的时候,并不会把客户端真实的 Watcher 对象实体传递到服务端,仅仅是在客户端请求中使用 boolean 类型属性进行了标记。(4)watcher event 异步发送 watcher 的通知事件从 server 发送到 client 是异步的,这就存在一个问题,不同的客户端和服务器之间通过 socket 进行通信,由于网络延迟或其他因素导致客户端在不通的时刻监听到事件,由于 Zookeeper 本身提供了 ordering guarantee,即客户端监听事件后,才会感知它所监视 znode发生了变化。所以我们使用 Zookeeper 不能期望能够监控到节点每次的变化。Zookeeper 只能保证最终的一致性,而无法保证强一致性。(5)注册 watcher getData、exists、getChildren(6)触发 watcher create、delete、setData(7)当一个客户端连接到一个新的服务器上时,watch 将会被以任意会话事件触发。当与一个服务器失去连接的时候,是无法接收到 watch 的。而当 client 重新连接时,如果需要的话,所有先前注册过的 watch,都会被重新注册。通常这是完全透明的。只有在一个特殊情况下,watch 可能会丢失:对于一个未创建的 znode的 exist watch,如果在客户端断开连接期间被创建了,并且随后在客户端连接上之前又删除了,这种情况下,这个 watch 事件可能会被丢失。 7. 客户端注册 Watcher 实现 (1)调用 getData()/getChildren()/exist()三个 API,传入 Watcher 对象(2)标记请求 request,封装 Watcher 到 WatchRegistration(3)封装成 Packet 对象,发服务端发送 request(4)收到服务端响应后,将 Watcher 注册到 ZKWatcherManager 中进行管理(5)请求返回,完成注册。 8. 服务端处理 Watcher 实现 (1)服务端接收 Watcher 并存储接收到客户端请求,处理请求判断是否需要注册 Watcher,需要的话将数据节点的节点路径和 ServerCnxn(ServerCnxn 代表一个客户端和服务端的连接,实现了 Watcher 的 process 接口,此时可以看成一个 Watcher 对象)存储在WatcherManager 的 WatchTable 和 watch2Paths 中去。(2)Watcher 触发以服务端接收到 setData() 事务请求触发 NodeDataChanged 事件为例:2.1 封装 WatchedEvent将通知状态(SyncConnected)、事件类型(NodeDataChanged)以及节点路径封装成一个 WatchedEvent 对象2.2 查询 Watcher从 WatchTable 中根据节点路径查找 Watcher2.3 没找到;说明没有客户端在该数据节点上注册过 Watcher2.4 找到;提取并从 WatchTable 和 Watch2Paths 中删除对应 Watcher(从这里可以看出 Watcher 在服务端是一次性的,触发一次就失效了)(3)调用 process 方法来触发 Watcher这里 process 主要就是通过 ServerCnxn 对应的 TCP 连接发送 Watcher 事件通知。 9. 客户端回调 Watcher 客户端 SendThread 线程接收事件通知,交由 EventThread 线程回调 Watcher。客户端的 Watcher 机制同样是一次性的,一旦被触发后,该 Watcher 就失效了。 10. ACL 权限控制机制 UGO(User/Group/Others)目前在 Linux/Unix 文件系统中使用,也是使用最广泛的权限控制方式。是一种粗粒度的文件系统权限控制模式。ACL(Access Control List)访问控制列表包括三个方面:权限模式(Scheme)(1)IP:从 IP 地址粒度进行权限控制(2)Digest:最常用,用类似于 username:password 的权限标识来进行权限配置,便于区分不同应用来进行权限控制(3)World:最开放的权限控制方式,是一种特殊的 digest 模式,只有一个权限标识“world:anyone”(4)Super:超级用户授权对象授权对象指的是权限赋予的用户或一个指定实体,例如 IP 地址或是机器灯。权限 Permission(1)CREATE:数据节点创建权限,允许授权对象在该 Znode 下创建子节点(2)DELETE:子节点删除权限,允许授权对象删除该数据节点的子节点(3)READ:数据节点的读取权限,允许授权对象访问该数据节点并读取其数据内容或子节点列表等(4)WRITE:数据节点更新权限,允许授权对象对该数据节点进行更新操作(5)ADMIN:数据节点管理权限,允许授权对象对该数据节点进行 ACL 相关设置操作 11. Chroot 特性 3.2.0 版本后,添加了 Chroot 特性,该特性允许每个客户端为自己设置一个命名空间。如果一个客户端设置了 Chroot,那么该客户端对服务器的任何操作,都将会被限制在其自己的命名空间下。通过设置 Chroot,能够将一个客户端应用于 Zookeeper 服务端的一颗子树相对应,在那些多个应用公用一个 Zookeeper 进群的场景下,对实现不同应用间的相互隔离非常有帮助。欢迎大家关注我的公种浩【程序员追风】,2019年多家公司java面试题整理了1000多道400多页pdf文档,文章都会在里面更新,整理的资料也会放在里面。 12. 会话管理 分桶策略:将类似的会话放在同一区块中进行管理,以便于 Zookeeper 对会话进行不同区块的隔离处理以及同一区块的统一处理。分配原则:每个会话的“下次超时时间点”(ExpirationTime)计算公式:ExpirationTime_ = currentTime + sessionTimeoutExpirationTime = (ExpirationTime_ / ExpirationInrerval + 1) *ExpirationInterval , ExpirationInterval 是指 Zookeeper 会话超时检查时间间隔,默认 tickTime 13. 服务器角色 Leader(1)事务请求的唯一调度和处理者,保证集群事务处理的顺序性(2)集群内部各服务的调度者Follower(1)处理客户端的非事务请求,转发事务请求给 Leader 服务器(2)参与事务请求 Proposal 的投票(3)参与 Leader 选举投票Observer(1)3.0 版本以后引入的一个服务器角色,在不影响集群事务处理能力的基础上提升集群的非事务处理能力(2)处理客户端的非事务请求,转发事务请求给 Leader 服务器(3)不参与任何形式的投票 14. Zookeeper 下 Server 工作状态 服务器具有四种状态,分别是 LOOKING、FOLLOWING、LEADING、OBSERVING。(1)LOOKING:寻 找 Leader 状态。当服务器处于该状态时,它会认为当前集群中没有 Leader,因此需要进入 Leader 选举状态。(2)FOLLOWING:跟随者状态。表明当前服务器角色是 Follower。(3)LEADING:领导者状态。表明当前服务器角色是 Leader。(4)OBSERVING:观察者状态。表明当前服务器角色是 Observer。 15. 数据同步 整个集群完成 Leader 选举之后,Learner(Follower 和 Observer 的统称)回向Leader 服务器进行注册。当 Learner 服务器想 Leader 服务器完成注册后,进入数据同步环节。数据同步流程:(均以消息传递的方式进行)Learner 向 Learder 注册数据同步同步确认Zookeeper 的数据同步通常分为四类:(1)直接差异化同步(DIFF 同步)(2)先回滚再差异化同步(TRUNC+DIFF 同步)(3)仅回滚同步(TRUNC 同步)(4)全量同步(SNAP 同步)在进行数据同步前,Leader 服务器会完成数据同步初始化:peerLastZxid:· 从 learner 服务器注册时发送的 ACKEPOCH 消息中提取 lastZxid(该Learner 服务器最后处理的 ZXID)minCommittedLog:· Leader 服务器 Proposal 缓存队列 committedLog 中最小 ZXIDmaxCommittedLog:· Leader 服务器 Proposal 缓存队列 committedLog 中最大 ZXID直接差异化同步(DIFF 同步)· 场景:peerLastZxid 介于 minCommittedLog 和 maxCommittedLog之间先回滚再差异化同步(TRUNC+DIFF 同步)· 场景:当新的 Leader 服务器发现某个 Learner 服务器包含了一条自己没有的事务记录,那么就需要让该 Learner 服务器进行事务回滚--回滚到 Leader服务器上存在的,同时也是最接近于 peerLastZxid 的 ZXID仅回滚同步(TRUNC 同步)· 场景:peerLastZxid 大于 maxCommittedLog全量同步(SNAP 同步)· 场景一:peerLastZxid 小于 minCommittedLog· 场景二:Leader 服务器上没有 Proposal 缓存队列且 peerLastZxid 不等于 lastProcessZxid 16. zookeeper 是如何保证事务的顺序一致性的? zookeeper 采用了全局递增的事务 Id 来标识,所有的 proposal(提议)都在被提出的时候加上了 zxid,zxid 实际上是一个 64 位的数字,高 32 位是 epoch( 时期; 纪元; 世; 新时代)用来标识 leader 周期,如果有新的 leader 产生出来,epoch会自增,低 32 位用来递增计数。当新产生 proposal 的时候,会依据数据库的两阶段过程,首先会向其他的 server 发出事务执行请求,如果超过半数的机器都能执行并且能够成功,那么就会开始执行。 17. 分布式集群中为什么会有 Master? 在分布式环境中,有些业务逻辑只需要集群中的某一台机器进行执行,其他的机器可以共享这个结果,这样可以大大减少重复计算,提高性能,于是就需要进行leader 选举。 18. zk 节点宕机如何处理? Zookeeper 本身也是集群,推荐配置不少于 3 个服务器。Zookeeper 自身也要保证当一个节点宕机时,其他节点会继续提供服务。如果是一个 Follower 宕机,还有 2 台服务器提供访问,因为 Zookeeper 上的数据是有多个副本的,数据并不会丢失;如果是一个 Leader 宕机,Zookeeper 会选举出新的 Leader。ZK 集群的机制是只要超过半数的节点正常,集群就能正常提供服务。只有在 ZK节点挂得太多,只剩一半或不到一半节点能工作,集群才失效。所以3 个节点的 cluster 可以挂掉 1 个节点(leader 可以得到 2 票>1.5)2 个节点的 cluster 就不能挂掉任何 1 个节点了(leader 可以得到 1 票<=1) 19. zookeeper 负载均衡和 nginx 负载均衡区别 zk 的负载均衡是可以调控,nginx 只是能调权重,其他需要可控的都需要自己写插件;但是 nginx 的吞吐量比 zk 大很多,应该说按业务选择用哪种方式。 20. Zookeeper 有哪几种几种部署模式? 部署模式:单机模式、伪集群模式、集群模式。 21. 集群最少要几台机器,集群规则是怎样的? 集群规则为 2N+1 台,N>0,即 3 台。 22. 集群支持动态添加机器吗? 其实就是水平扩容了,Zookeeper 在这方面不太好。两种方式:全部重启:关闭所有 Zookeeper 服务,修改配置之后启动。不影响之前客户端的会话。逐个重启:在过半存活即可用的原则下,一台机器重启不影响整个集群对外提供服务。这是比较常用的方式。3.5 版本开始支持动态扩容。 23. Zookeeper 对节点的 watch 监听通知是永久的吗?为什么不是永久的? 不是。官方声明:一个 Watch 事件是一个一次性的触发器,当被设置了 Watch的数据发生了改变的时候,则服务器将这个改变发送给设置了 Watch 的客户端,以便通知它们。为什么不是永久的,举个例子,如果服务端变动频繁,而监听的客户端很多情况下,每次变动都要通知到所有的客户端,给网络和服务器造成很大压力。一般是客户端执行 getData(“/节点 A”,true),如果节点 A 发生了变更或删除,客户端会得到它的 watch 事件,但是在之后节点 A 又发生了变更,而客户端又没有设置 watch 事件,就不再给客户端发送。在实际应用中,很多情况下,我们的客户端不需要知道服务端的每一次变动,我只要最新的数据即可。 24. Zookeeper 的 java 客户端都有哪些? java 客户端:zk 自带的 zkclient 及 Apache 开源的 Curator。 25. chubby 是什么,和 zookeeper 比你怎么看? chubby 是 google 的,完全实现 paxos 算法,不开源。zookeeper 是 chubby的开源实现,使用 zab 协议,paxos 算法的变种。 26. 说几个 zookeeper 常用的命令。 常用命令:ls get set create delete 等。 27. ZAB 和 Paxos 算法的联系与区别? 相同点:(1)两者都存在一个类似于 Leader 进程的角色,由其负责协调多个 Follower 进程的运行(2)Leader 进程都会等待超过半数的 Follower 做出正确的反馈后,才会将一个提案进行提交(3)ZAB 协议中,每个 Proposal 中都包含一个 epoch 值来代表当前的 Leader周期,Paxos 中名字为 Ballot不同点:ZAB 用来构建高可用的分布式数据主备系统(Zookeeper),Paxos 是用来构建分布式一致性状态机系统。 28. Zookeeper 的典型应用场景 Zookeeper 是一个典型的发布/订阅模式的分布式数据管理与协调框架,开发人员可以使用它来进行分布式数据的发布和订阅。通过对 Zookeeper 中丰富的数据节点进行交叉使用,配合 Watcher 事件通知机制,可以非常方便的构建一系列分布式应用中年都会涉及的核心功能,如:(1)数据发布/订阅(2)负载均衡(3)命名服务(4)分布式协调/通知(5)集群管理(6)Master 选举(7)分布式锁(8)分布式队列数据发布/订阅介绍数据发布/订阅系统,即所谓的配置中心,顾名思义就是发布者发布数据供订阅者进行数据订阅。目的动态获取数据(配置信息)实现数据(配置信息)的集中式管理和数据的动态更新设计模式Push 模式Pull 模式数据(配置信息)特性(1)数据量通常比较小(2)数据内容在运行时会发生动态更新(3)集群中各机器共享,配置一致如:机器列表信息、运行时开关配置、数据库配置信息等基于 Zookeeper 的实现方式· 数据存储:将数据(配置信息)存储到 Zookeeper 上的一个数据节点· 数据获取:应用在启动初始化节点从 Zookeeper 数据节点读取数据,并在该节点上注册一个数据变更 Watcher· 数据变更:当变更数据时,更新 Zookeeper 对应节点数据,Zookeeper会将数据变更通知发到各客户端,客户端接到通知后重新读取变更后的数据即可。负载均衡zk 的命名服务命名服务是指通过指定的名字来获取资源或者服务的地址,利用 zk 创建一个全局的路径,这个路径就可以作为一个名字,指向集群中的集群,提供的服务的地址,或者一个远程的对象等等。分布式通知和协调对于系统调度来说:操作人员发送通知实际是通过控制台改变某个节点的状态,然后 zk 将这些变化发送给注册了这个节点的 watcher 的所有客户端。对于执行情况汇报:每个工作进程都在某个目录下创建一个临时节点。并携带工作的进度数据,这样汇总的进程可以监控目录子节点的变化获得工作进度的实时的全局情况。zk 的命名服务(文件系统)命名服务是指通过指定的名字来获取资源或者服务的地址,利用 zk 创建一个全局的路径,即是唯一的路径,这个路径就可以作为一个名字,指向集群中的集群,提供的服务的地址,或者一个远程的对象等等。zk 的配置管理(文件系统、通知机制)程序分布式的部署在不同的机器上,将程序的配置信息放在 zk 的 znode 下,当有配置发生改变时,也就是 znode 发生变化时,可以通过改变 zk 中某个目录节点的内容,利用 watcher 通知给各个客户端,从而更改配置。Zookeeper 集群管理(文件系统、通知机制)所谓集群管理无在乎两点:是否有机器退出和加入、选举 master。对于第一点,所有机器约定在父目录下创建临时目录节点,然后监听父目录节点的子节点变化消息。一旦有机器挂掉,该机器与 zookeeper 的连接断开,其所创建的临时目录节点被删除,所有其他机器都收到通知:某个兄弟目录被删除,于是,所有人都知道:它上船了。新机器加入也是类似,所有机器收到通知:新兄弟目录加入,highcount 又有了,对于第二点,我们稍微改变一下,所有机器创建临时顺序编号目录节点,每次选取编号最小的机器作为 master 就好。Zookeeper 分布式锁(文件系统、通知机制)有了 zookeeper 的一致性文件系统,锁的问题变得容易。锁服务可以分为两类,一个是保持独占,另一个是控制时序。对于第一类,我们将 zookeeper 上的一个 znode 看作是一把锁,通过 createznode的方式来实现。所有客户端都去创建 /distribute_lock 节点,最终成功创建的那个客户端也即拥有了这把锁。用完删除掉自己创建的 distribute_lock 节点就释放出锁。对于第二类, /distribute_lock 已经预先存在,所有客户端在它下面创建临时顺序编号目录节点,和选 master 一样,编号最小的获得锁,用完删除,依次方便。Zookeeper 队列管理(文件系统、通知机制)两种类型的队列:(1)同步队列,当一个队列的成员都聚齐时,这个队列才可用,否则一直等待所有成员到达。(2)队列按照 FIFO 方式进行入队和出队操作。第一类,在约定目录下创建临时目录节点,监听节点数目是否是我们要求的数目。第二类,和分布式锁服务中的控制时序场景基本原理一致,入列有编号,出列按编号。在特定的目录下创建 PERSISTENT_SEQUENTIAL 节点,创建成功时Watcher 通知等待的队列,队列删除序列号最小的节点用以消费。此场景下Zookeeper 的 znode 用于消息存储,znode 存储的数据就是消息队列中的消息内容,SEQUENTIAL 序列号就是消息的编号,按序取出即可。由于创建的节点是持久化的,所以不必担心队列消息的丢失问题。 最后欢迎大家一起交流,喜欢文章记得关注我点个赞哟,感谢支持!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册