首页 文章 精选 留言 我的

精选列表

搜索[爬虫系统],共10000篇文章
优秀的个人博客,低调大师

DC学院爬虫学习笔记(四):使用Xpath解析豆瓣短评

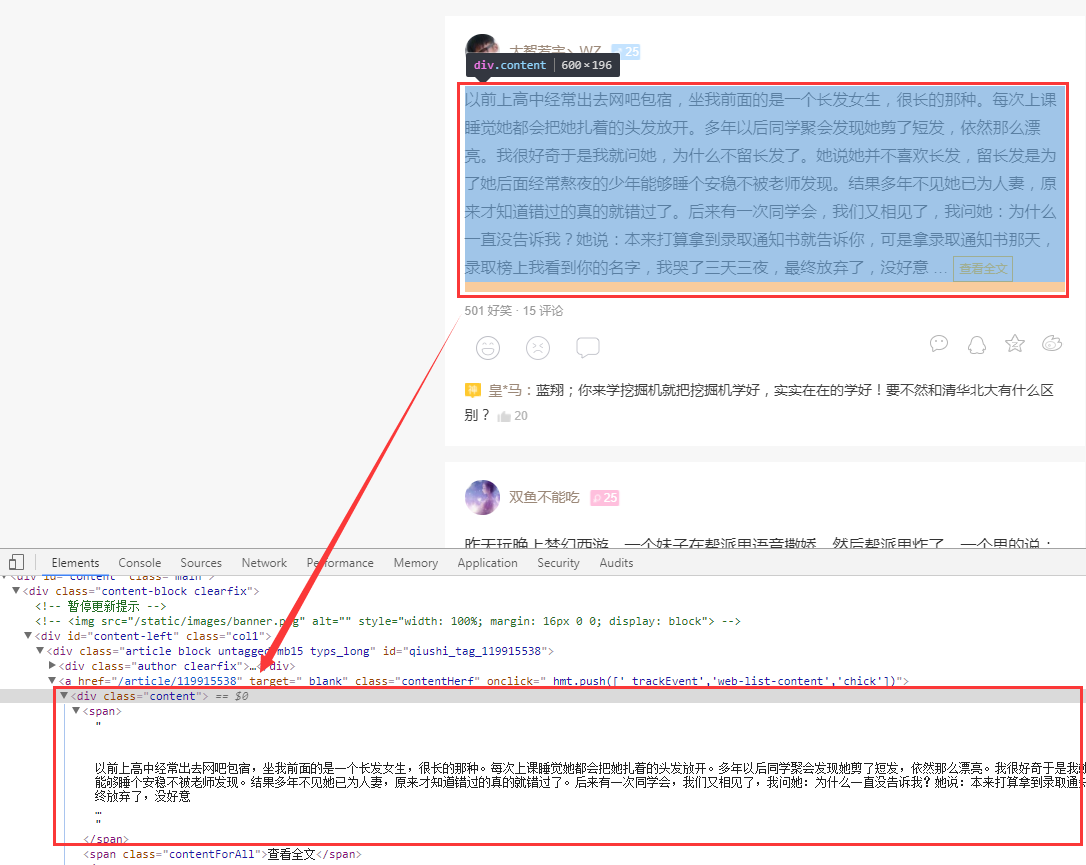
解析神器Xpath: 1. 什么是Xpath XPath即为XML路径语言(XML Path Language),它是一种用来确定XML文档中某部分位置的语言。 XPath基于XML的树状结构,提供在数据结构树中找寻节点的能力。起初XPath的提出的初衷是将其作为一个通用的、介于XPointer与XSL间的语法模型。但是XPath很快的被开发者采用来当作小型查询语言。 2. Xpath解析网页的流程 首先通过Requests库获取网页数据 通过网页解析,得到想要的数据或者新的链接 网页解析可以通过Xpath或者其它解析工具进行,Xpath在是一个非常好用的网页解析工具 3. 常用的网页解析 正则表达式使用比较困难,学习成本较高 BeautifulSoup性能较慢,相对于Xpath较难,在某些特定场景下有用 Xpath使用简单,速度快(Xpath是lxml里面的一种),是抓取数据最好的选择 Xpath的使用: 1. 使用Xpath解析网页数据的步骤 从lxml导入etree 解析数据,返回xml结构 使用.xpath()寻找和定位数据 import requests from lxml import etree url="https://book.douban.com/subject/27147922/comments/" r=requests.get(url).text ##html数据,使用requests获取 ##print (r)| s = etree.HTML(r) #解析html数据 print(s.xpath('//*[@id="comments"]/ul[1]/li[1]/div[2]/p'))#使用.xpath() [<Element p at 0x1d992e8b808>] print(s.xpath('//*[@id="comments"]/ul[1]/li[1]/div[2]/p/text()'))## 获取文本,加上 /text() ['最喜欢《姐妹》这一篇:女性之间有一种镜像的关系,通过对方可以看到自己,看到自己深处的处境。'] 2. 获取Xpath的方法 第一种方法:从浏览器直接复制 首先在浏览器上定位到需要爬取的数据 右键,点击“检查”,在“Elements”下找到定位到所需数据 右键——Copy——Copy Xpath,即可完成Xpath的复制 第二种方法:手写Xpath 获取文本内容用 text() 获取注释用 comment() 获取其它任何属性用@xx,如: src value 想要获取某个标签下所有的文本(包括子标签下的文本),使用string 如”< p>123< a>来获取我啊< /a>< /p>”,这边如果想要得到的文本为”123来获取我啊”,则需要使用string starts-with 匹配字符串前面相等 contains 匹配任何位置相等 #手写Xpath import requests from lxml import etree url = 'https://book.douban.com/subject/1084336/comments/' r = requests.get(url).text s = etree.HTML(r) print(s.xpath('//div[@class="comment"]/p/text()')[0]) 十几岁的时候渴慕着小王子,一天之间可以看四十四次日落。是在多久之后才明白,看四十四次日落的小王子,他有多么难过。 实战环节 使用Xpath爬取豆瓣图书《小王子》短评网页 import requests from lxml import etree url = 'https://book.douban.com/subject/1084336/comments/' r = requests.get(url).text s = etree.HTML(r) #从浏览器复制第一条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[1]/div[2]/p/text()')) #从浏览器复制第二条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[2]/div[2]/p/text()')) #从浏览器复制第三条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[3]/div[2]/p/text()')) #掌握规律,删除li[]的括号,获取全部短评 #print(s.xpath('//*[@id="comments"]/ul/li/div[2]/p/text()')) #手写Xpath获取全部短评 #print(s.xpath('//div[@class="comment"]/p/text()')) ['十几岁的时候渴慕着小王子,一天之间可以看四十四次日落。是在多久之后才明白,看四十四次日落的小王子,他有多么难过。'] ['读了好多年,终于读完了,但是实在共鸣不起来,虽然知道那些道理,但真的觉得没什么了不起啊,是我还太幼稚吗?'] ['我早该猜到,在她那可笑的伎俩后面是缱绻柔情啊。花朵是如此的天真无邪,可是,我毕竟太年轻了,不知该如何去爱她。'] 通过对比可以发现从浏览器复制的Xpath中,“li[]”括号中的数字代表对应的第几条评论,直接删除括号,即可获取全部短评 对于结构清晰的html网页,可以直接手写Xpath,更加简洁且高效 对于结构复杂的html网页,可以通过浏览器复制的方式获取Xpath

优秀的个人博客,低调大师

Python 爬虫的会话管理:从 Cookie 维持到登录态复用

HTTP 本身是无状态的。服务器识别“同一个人”靠的是客户端每次请求携带的 Cookie,而服务器在响应中通过 Set-Cookie 下发新的 Cookie。登录过程的本质是:客户端提交凭证 → 服务器验证通过 → 下发一个标识会话的 Cookie(通常是 sessionid 或类似名称)→ 客户端后续请求自动携带该 Cookie → 服务器据此返回受保护内容。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。


用户登录
用户注册