首页 文章 精选 留言 我的

精选列表

搜索[多模块结构],共10000篇文章
优秀的个人博客,低调大师

数据结构---树(待补充)

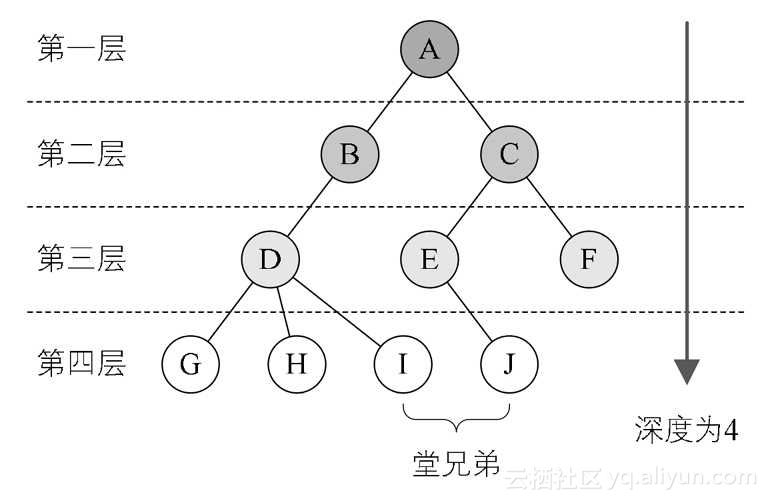
基本概念 1. 相关定义 树是由n(n>0)个有限节点组成一个具有层次关系的集合。 每个节点有零个或多个子节点。 没有父节点的节点称为根节点。 每一个非根节点有且只有一个父节点。 除了根节点外,每个子节点可以分为多个不相交的子树。 节点的度:一个节点含有的子树的个数称为该节点的度。 树的度:一棵树中,最大的节点的度称为树的度。 叶节点或终端节点:度为零的节点。 节点的层次:从根开始定义起,根为第1层,根的子节点为第2层,以此类推。 深度:对于任意节点n,n的深度为从根到n的唯一路径长,根的深度为0。 高度:对于任意节点n,n的高度为从n到一片树叶的最长路径长,所有树叶的高度为0。 森林:由m(m>=0)棵互不相交的树的集合称为森林。 2. 树的分类 无序树 树中任意节点的子节点之间没有顺序关系。它就是一个无回路的连通图,没有确定根,在自由树中选定一顶点做根,则成为一棵通常的树。 有序树 树中任意节点的子节点之间有顺序关系。常见的有序树有:二叉树、完全二叉树、满二叉树、平衡二叉树(AVL树)、二叉查找树、霍夫曼树、B树、字典树。 3. 相关规律 二叉树 每个结点最多有两棵子树,所以二叉树中不存在度大于2的结点。左子树和右子树是有顺序的,次序不能任意颠倒。即使树中某结点只有一棵子树,也要区分它是左子树还是右子树。 在二叉树的第 i 层上至多有$2^{i-1}$个结点(i≥1)。 深度为k的二叉树至多有$2^k-1$个结点(k≥1)。 对任何一棵二叉树,如果其叶子节点数为$n_0$,度为2的结点数为$n_2$,则$n_0=n_2 + 1$。(要会推导) 完全二叉树&&满二叉树 完全二叉树:对于一颗二叉树,假设其深度为d(d>1)。除了第d层外,其它各层的节点数目均已达最大值,且第d层所有节点从左向右连续地紧密排列。 满二叉树:每一个层的结点数都达到最大值。 满二叉树一定是完全二叉树,完全二叉树不一定是满二叉树。 具有n个结点的完全二叉树的深度为$log_2n + 1$ 平衡二叉树 它是一棵空树或它的左右两个子树的高度差的绝对值不超过1,并且左右两个子树都是一棵平衡二叉树。 最小二叉平衡树的节点的公式:$F(n)=F(n-1)+F(n-2)+1$ 二叉查找树 二叉查找树又叫二叉排序树或二叉搜索树。是一棵空树,或者是具有下列性质的二叉树: 1. 若左子树不空,则左子树上所有结点的值均小于它的根结点的值; 2. 若右子树不空,则右子树上所有结点的值均大于或等于它的根结点的值; 3. 左、右子树也分别为二叉排序树; 4. 没有键值相等的节点。 二叉查找树的性质:对二叉查找树进行中序遍历,即可得到有序的数列。 霍夫曼树 带权路径最短的二叉树。是一个一般化的二叉查找树,可以拥有多于2个子节点。 B树 不是二叉树,是一个一般化的二叉查找树,可以拥有多于2个子节点。 ![image](https://yqfile.alicdn.com/da7677793d755574cf60be202909743405eb894b.png) 字典树 Tire树称为字典树,又称单词查找树,Trie树用于统计,排序和保存大量的字符串(但不仅限于字符串),所以经常被搜索引擎系统用于文本词频统计。它的优点是:利用字符串的公共前缀来减少查询时间,最大限度地减少无谓的字符串比较,查询效率比哈希树高。 Tire树的三个基本性质: 1. 根节点不包含字符,除根节点外每一个节点都只包含一个字符; 2. 从根节点到某一节点,路径上经过的字符连接起来,为该节点对应的字符串; 3. 每个节点的所有子节点包含的字符都不相同。 相关实现(C++)

优秀的个人博客,低调大师

Hadoop体系结构之 Mapreduce

MR框架是由一个单独运行在主节点上的JobTracker和运行在每个集群从节点上的TaskTracker共同组成。主节点负责调度构成一个作业的所有任务,这些任务分布在不同的不同的从节点上。主节点监视它们的执行情况,并重新执行之前失败的任务。从节点仅负责由主节点指派的任务。当一个Job被提交时,JobTracker接受到提交作业和配置信息之后,就会将配置信息等分发给从节点,同时调度任务并监控TaskTracker的执行。JobTracker可以运行于集群中的任意一台计算机上。TaskTracker负责执行任务,它必须运行在DataNode上,DataNode既是数据存储节点,也是计算节点。JobTracker将map任务和reduce任务分发给空闲的TaskTracker,这些任务并行运行,并监控任务运行的情况。如果JobTracker出了故障,JobTracker会把任务转交给另一个空闲的TaskTracker重新运行。 Hadoop上的并行应用程序开发是基于MR编程框架。MR编程模型原理:利用一个输入的key-value对集合来产生一个输出的key-value对集合。MR库通过Map和Reduce两个函数来实现这个框架。用户自定义的map函数接受一个输入的key-value对,然后产生一个中间的key-value对的集合。MR把所有具有相同的key值的value结合在一起,然后传递个reduce函数。Reduce函数接受key和相关的value结合,reduce函数合并这些value值,形成一个较小的value集合。通常我们通过一个迭代器把中间的value值提供给reduce函数(迭代器的作用就是收集这些value值),这样就可以处理无法全部放在内存中的大量的value值集合了。 流程简而言之,大数据集被分成众多小的数据集块,若干个数据集被分在集群中的一个节点进行处理并产生中间结果。单节点上的任务,map函数一行行读取数据获得数据的(k1,v1),数据进入缓存,通过map函数执行map(基于key-value)排序(框架会对map的输出进行排序)执行后输入(k2,v2)。每一台机器都执行同样的操作。不同机器上的(k2,v2)通过merge排序的过程(shuffle的过程可以理解成reduce前的一个过程),最后reduce合并得到,(k3,v3),输出到HDFS文件中。 谈到reduce,在reduce之前,可以先对中间数据进行数据合并(Combine),即将中间有相同的key的<key,value>对合并。Combine的过程与reduce的过程类似,但Combine是作为map任务的一部分,在执行完map函数后仅接着执行。Combine能减少中间结果key-value对的数目,从而降低网络流量。 Map任务的中间结果在做完Combine和Partition后,以文件的形式存于本地磁盘上。中间结果文件的位置会通知主控JobTracker,JobTracker再通知reduce任务到哪一个DataNode上去取中间结果。所有的map任务产生的中间结果均按其key值按hash函数划分成R份,R个reduce任务各自负责一段key区间。每个reduce需要向许多个map任务节点取的落在其负责的key区间内的中间结果,然后执行reduce函数,最后形成一个最终结果。有R个reduce任务,就会有R个最终结果,很多情况下这R个最终结果并不需要合并成一个最终结果,因为这R个最终结果可以作为另一个计算任务的输入,开始另一个并行计算任务。这就形成了上面图中多个输出数据片段(HDFS副本)。 source: 总结于网络。 本文转自 张冲andy 博客园博客,原文链接:http://www.cnblogs.com/andy6/p/7351156.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS应用目录结构和操作

Paste_Image.png home /var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC Phone会为每一个应用程序生成一个私有目录,iOS7这个目录位于:/var/mobile/Applications,随机生成一个数字字母串作为目录名,每一次应用程序启动时,这个字母数字串都是不同的。 NSString *destPath = NSHomeDirectory(); NSLog(@"NSHomeDirectory: %@",destPath); Documents Documents:保存应用运行时生成的需要持久化的数据,iTunes会自动备份该目录 (1) expandTilde:YES "/var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC/Documents" NSArray *documentPaths = NSSearchPathForDirectoriesInDomains(NSDocumentDirectory, NSUserDomainMask, YES); NSLog(@"NSDocumentDirectory: %@",documentPaths); (2) expandTilde:NO ~/Documents NSArray *documentPathsNO = NSSearchPathForDirectoriesInDomains(NSDocumentDirectory, NSUserDomainMask, NO); NSLog(@"NSDocumentDirectory: %@",documentPathsNO); Cache Libaray/Caches:存放缓存文件,iTunes不会备份此目录,此目录下文件不会在应用退出删除,一般存放体积比较大,不是很重要的资源 (1)expandTilde:YES 打印: /var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC/Library/Caches NSArray *cachePaths = NSSearchPathForDirectoriesInDomains(NSCachesDirectory, NSUserDomainMask, YES); NSLog(@"NSCachesDirectory: %@", cachePaths); (2)expandTilde:NO 打印: ~/Library/Caches NSArray *cachePathsNO = NSSearchPathForDirectoriesInDomains(NSCachesDirectory, NSUserDomainMask, NO); NSLog(@"cachePathsNO %@", cachePathsNO); Library Libaray:存储程序的默认设置和其他状态信息,iTunes会自动备份该目录 (1) expandTilde:YES 打印:"/var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC/Library" NSArray *libraryPaths = NSSearchPathForDirectoriesInDomains(NSLibraryDirectory, NSUserDomainMask, YES); NSLog(@"NSLibraryDirectory: %@", libraryPaths); (2) expandTilde:NO 打印:~/Library NSArray *libraryPathsNO = NSSearchPathForDirectoriesInDomains(NSLibraryDirectory, NSUserDomainMask, NO); NSLog(@"libraryPathsNO: %@", libraryPathsNO); (3) 获取应用的Preferences 目录,不能直接获取只能自行拼接 : Libaray/Preferences:保存应用的所有偏好设置,ios的Settings(设置)应用会在该目录中查找应用的设置信息,iTunes会自动备份该目录。 /var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC/Library/Preferences NSString *preferencePath =[[libraryPaths lastObject] stringByAppendingPathComponent:@"Preferences"]; NSLog(@"%@", preferencePath); Tmp tmp:保存应用运行时所需的临时数据,使用完毕后再将相应的文件从该目录删除,应用没有运行时,系统也可能会自动清理该目录下的文件,iTunes不会同步该目录,iPhone重启时该目录下的文件会丢失 (1) expandTilde:YES /private/var/mobile/Applications/4DCF7000-BD28-4494-80DF-4F081C975EDC/tmp/ NSString *tmpDir = NSTemporaryDirectory(); NSLog(@"NSTemporaryDirectory: %@", tmpDir); 文件目录的创建,读取,移动,拷贝以及删除 NSFileManager 是处理文件系统的 Foundation 框架的高级API。它抽象了 Unix 和 Finder 的内部构成,和 iCloud ubiquitous containers 一样, 提供了创建,读取,移动,拷贝以及删除本地或者网络驱动器上的文件或者目录的方法。 https://developer.apple.com/library/ios/documentation/FileManagement/Conceptual/FileSystemProgrammingGuide/FileSystemOverview/FileSystemOverview.html#//apple_ref/doc/uid/TP40010672-CH2-SW2 NSFileManager http://nshipster.cn/nsfilemanager/官方文档

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册