首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

技术| Python的从零开始系列连载(三十一)

大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子。与上一篇不同的是,这次我们需要用到文件的相关操作。 本篇目标 1.对百度贴吧的任意帖子进行抓取 2.指定是否只抓取楼主发帖内容 3.将抓取到的内容分析并保存到文件 1.URL格式的确定 首先,我们先观察一下百度贴吧的任意一个帖子。 比如:http://tieba.baidu.com/p/3138733512?see_lz=1&pn=1,这是一个关于NBA50大的盘点,分析一下这个地址。 http:// 代表资源传输使用http协议 tieba.baidu.com 是百度的二级域名,指向百度贴吧的服务器。 /p/3138733512 是服务器某个资源,即这个帖子的地址定位符 see_lz和pn是该URL的两个参数,分别代表了只看楼主和帖子页码,等于1表示该条件为真 所以我们可以把URL分为两部分,一部分为基础部分,一部分为参数部分。 例如,上面的URL我们划分基础部分是 http://tieba.baidu.com/p/3138733512,参数部分是 ?see_lz=1&pn=1 2.页面的抓取 熟悉了URL的格式,那就让我们用urllib2库来试着抓取页面内容吧。上一篇糗事百科我们最后改成了面向对象的编码方式,这次我们直接尝试一下,定义一个类名叫BDTB(百度贴吧),一个初始化方法,一个获取页面的方法。 其中,有些帖子我们想指定给程序是否要只看楼主,所以我们把只看楼主的参数初始化放在类的初始化上,即init方法。另外,获取页面的方法我们需要知道一个参数就是帖子页码,所以这个参数的指定我们放在该方法中。 综上,我们初步构建出基础代码如下: __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ): self.baseURL = baseUrl self.seeLZ = '?see_lz='+str(seeLZ) #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) print response.read() return response except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None baseURL = 'http://tieba.baidu.com/p/3138733512' bdtb = BDTB(baseURL,1) bdtb.getPage(1) 运行代码,我们可以看到屏幕上打印出了这个帖子第一页楼主发言的所有内容,形式为HTML代码。 3.提取相关信息 1)提取帖子标题 首先,让我们提取帖子的标题。 在浏览器中审查元素,或者按F12,查看页面源代码,我们找到标题所在的代码段,可以发现这个标题的HTML代码是 <h1 class="core_title_txt " title="纯原创我心中的NBA2014-2015赛季现役50大" style="width: 396px">纯原创我心中的NBA2014-2015赛季现役50大</h1> 所以我们想提取<h1>标签中的内容,同时还要指定这个class确定唯一,因为h1标签实在太多啦。 正则表达式如下 <h1 class="core_title_txt.*?>(.*?)</h1>所以,我们增加一个获取页面标题的方法 #获取帖子标题 def getTitle(self): page = self.getPage(1) pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None 2)提取帖子页数 同样地,帖子总页数我们也可以通过分析页面中的共?页来获取。所以我们的获取总页数的方法如下 #获取帖子一共有多少页 def getPageNum(self): page = self.getPage(1) pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None 3)提取正文内容 审查元素,我们可以看到百度贴吧每一层楼的主要内容都在<div id=”post_content_xxxx”></div>标签里面,所以我们可以写如下的正则表达式 <div id="post_content_.*?>(.*?)</div>相应地,获取页面所有楼层数据的方法可以写成如下方法 #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) for item in items: print item好,我们运行一下结果看一下 真是醉了,还有一大片换行符和图片符,好口怕!既然这样,我们就要对这些文本进行处理,把各种各样复杂的标签给它剔除掉,还原精华内容,把文本处理写成一个方法也可以,不过为了实现更好的代码架构和代码重用,我们可以考虑把标签等的处理写作一个类。 那我们就叫它Tool(工具类吧),里面定义了一个方法,叫replace,是替换各种标签的。在类中定义了几个正则表达式,主要利用了re.sub方法对文本进行匹配后然后替换。具体的思路已经写到注释中,大家可以看一下这个类 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() 在使用时,我们只需要初始化一下这个类,然后调用replace方法即可。 现在整体代码是如下这样子的,现在我的代码是写到这样子的 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ): self.baseURL = baseUrl self.seeLZ = '?see_lz='+str(seeLZ) self.tool = Tool() #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) return response.read().decode('utf-8') except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None #获取帖子标题 def getTitle(self): page = self.getPage(1) pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None #获取帖子一共有多少页 def getPageNum(self): page = self.getPage(1) pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: #print result.group(1) #测试输出 return result.group(1).strip() else: return None #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) #for item in items: # print item print self.tool.replace(items[1]) baseURL = 'http://tieba.baidu.com/p/3138733512' bdtb = BDTB(baseURL,1) bdtb.getContent(bdtb.getPage(1))我们尝试一下,重新再看一下效果,这下经过处理之后应该就没问题了,是不是感觉好酸爽! 4)替换楼层 至于这个问题,我感觉直接提取楼层没什么必要呀,因为只看楼主的话,有些楼层的编号是间隔的,所以我们得到的楼层序号是不连续的,这样我们保存下来也没什么用。 所以可以尝试下面的方法: 1.每打印输出一段楼层,写入一行横线来间隔,或者换行符也好。 2.试着重新编一个楼层,按照顺序,设置一个变量,每打印出一个结果变量加一,打印出这个变量当做楼层。 这里我们尝试一下吧,看看效果怎样 把getContent方法修改如下 #获取每一层楼的内容,传入页面内容 def getContent(self,page): pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) floor = 1 for item in items: print floor,u"楼------------------------------------------------------------------------------------------------------------------------------------\n" print self.tool.replace(item) floor += 1运行一下看看效果 嘿嘿,效果还不错吧,感觉真酸爽!接下来我们完善一下,然后写入文件 4.写入文件 最后便是写入文件的过程,过程很简单,就几句话的代码而已,主要是利用了以下两句 file = open(“tb.txt”,”w”) file.writelines(obj) 这里不再赘述,稍后直接贴上完善之后的代码。 5.完善代码 现在我们对代码进行优化,重构,在一些地方添加必要的打印信息,整理如下 __author__ = 'CQC' # -*- coding:utf-8 -*- import urllib import urllib2 import re #处理页面标签类 class Tool: #去除img标签,7位长空格 removeImg = re.compile('<img.*?>| {7}|') #删除超链接标签 removeAddr = re.compile('<a.*?>|</a>') #把换行的标签换为\n replaceLine = re.compile('<tr>|<div>|</div>|</p>') #将表格制表<td>替换为\t replaceTD= re.compile('<td>') #把段落开头换为\n加空两格 replacePara = re.compile('<p.*?>') #将换行符或双换行符替换为\n replaceBR = re.compile('<br><br>|<br>') #将其余标签剔除 removeExtraTag = re.compile('<.*?>') def replace(self,x): x = re.sub(self.removeImg,"",x) x = re.sub(self.removeAddr,"",x) x = re.sub(self.replaceLine,"\n",x) x = re.sub(self.replaceTD,"\t",x) x = re.sub(self.replacePara,"\n ",x) x = re.sub(self.replaceBR,"\n",x) x = re.sub(self.removeExtraTag,"",x) #strip()将前后多余内容删除 return x.strip() #百度贴吧爬虫类 class BDTB: #初始化,传入基地址,是否只看楼主的参数 def __init__(self,baseUrl,seeLZ,floorTag): #base链接地址 self.baseURL = baseUrl #是否只看楼主 self.seeLZ = '?see_lz='+str(seeLZ) #HTML标签剔除工具类对象 self.tool = Tool() #全局file变量,文件写入操作对象 self.file = None #楼层标号,初始为1 self.floor = 1 #默认的标题,如果没有成功获取到标题的话则会用这个标题 self.defaultTitle = u"百度贴吧" #是否写入楼分隔符的标记 self.floorTag = floorTag #传入页码,获取该页帖子的代码 def getPage(self,pageNum): try: #构建URL url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum) request = urllib2.Request(url) response = urllib2.urlopen(request) #返回UTF-8格式编码内容 return response.read().decode('utf-8') #无法连接,报错 except urllib2.URLError, e: if hasattr(e,"reason"): print u"连接百度贴吧失败,错误原因",e.reason return None #获取帖子标题 def getTitle(self,page): #得到标题的正则表达式 pattern = re.compile('<h1 class="core_title_txt.*?>(.*?)</h1>',re.S) result = re.search(pattern,page) if result: #如果存在,则返回标题 return result.group(1).strip() else: return None #获取帖子一共有多少页 def getPageNum(self,page): #获取帖子页数的正则表达式 pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S) result = re.search(pattern,page) if result: return result.group(1).strip() else: return None #获取每一层楼的内容,传入页面内容 def getContent(self,page): #匹配所有楼层的内容 pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S) items = re.findall(pattern,page) contents = [] for item in items: #将文本进行去除标签处理,同时在前后加入换行符 content = "\n"+self.tool.replace(item)+"\n" contents.append(content.encode('utf-8')) return contents def setFileTitle(self,title): #如果标题不是为None,即成功获取到标题 if title is not None: self.file = open(title + ".txt","w+") else: self.file = open(self.defaultTitle + ".txt","w+") def writeData(self,contents): #向文件写入每一楼的信息 for item in contents: if self.floorTag == '1': #楼之间的分隔符 floorLine = "\n" + str(self.floor) + u"-----------------------------------------------------------------------------------------\n" self.file.write(floorLine) self.file.write(item) self.floor += 1 def start(self): indexPage = self.getPage(1) pageNum = self.getPageNum(indexPage) title = self.getTitle(indexPage) self.setFileTitle(title) if pageNum == None: print "URL已失效,请重试" return try: print "该帖子共有" + str(pageNum) + "页" for i in range(1,int(pageNum)+1): print "正在写入第" + str(i) + "页数据" page = self.getPage(i) contents = self.getContent(page) self.writeData(contents) #出现写入异常 except IOError,e: print "写入异常,原因" + e.message finally: print "写入任务完成" print u"请输入帖子代号" baseURL = 'http://tieba.baidu.com/p/' + str(raw_input(u'http://tieba.baidu.com/p/')) seeLZ = raw_input("是否只获取楼主发言,是输入1,否输入0\n") floorTag = raw_input("是否写入楼层信息,是输入1,否输入0\n") bdtb = BDTB(baseURL,seeLZ,floorTag) bdtb.start()现在程序演示如下 完成之后,可以查看一下当前目录下多了一个以该帖子命名的txt文件,内容便是帖子的所有数据。 抓贴吧,就是这么简单和任性! 原文发布时间为:2018-11-30 本文作者:灯塔大数据 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“DTbigdata”微信公众号


优秀的个人博客,低调大师

技术 | Python从零开始系列连载(二十九)

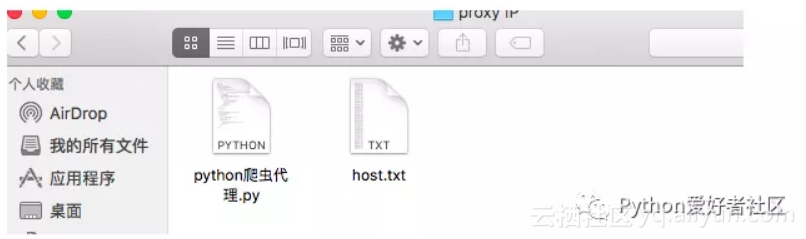
写爬虫防止被封的关键有以下几点: ●伪装请求报头(request header) ●减轻访问频率,速度 ●使用代理IP 一般第一点都能做到,第二点减轻访问频率就会大大增加任务时间,而使用代理就能在不增加任务时长避免被封的关键(实际情况却是任务时间因为代理的使用而增加的,但这里不细说,知道就好)。 下面我们从国内高匿代理IP获得代理IP数据。 import osimport timeimport requestsfrom bs4 import BeautifulSoup#num获取num页 国内高匿ip的网页中代理数据def fetch_proxy(num): #修改当前工作文件夹 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') api = 'http://www.xicidaili.com/nn/{}' header = { 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_3) AppleWebKit/' '537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'} fp = open('host.txt', 'a+', encoding=('utf-8')) for i in range(num+1): api = api.format(1) respones = requests.get(url=api, headers=header) soup = BeautifulSoup(respones.text, 'lxml') container = soup.find_all(name='tr',attrs={'class':'odd'}) for tag in container: try: con_soup = BeautifulSoup(str(tag),'lxml') td_list = con_soup.find_all('td') ip = str(td_list[1])[4:-5] port = str(td_list[2])[4:-5] IPport = ip + '\t' + port + '\n' fp.write(IPport) except Exception as e: print('No IP!') time.sleep(1) fp.close() 我们准备抓国内高匿代理IP网的十个页面的代理 fetch_proxy(10) 当前工作目录下的文件,你看!!有host.txt 打开host.txt,收集到了很多代理IP 但是有代理IP还不行,因为我们不知道这代理能不能用,是否有效。 下面我们用百度网进行检验(大公司不怕咱们短时间内高频率访问),上代码: import osimport timeimport requestsfrom bs4 import BeautifulSoupdef test_proxy(): N = 1 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') url = 'https://www.baidu.com' fp = open('host.txt', 'r') ips = fp.readlines() proxys = list() for p in ips: ip = p.strip('\n').split('\t') proxy = 'http:\\' + ip[0] + ':' + ip[1] proxies = {'proxy': proxy} proxys.append(proxies) for pro in proxys: try: s = requests.get(url, proxies=pro) print('第{}个ip:{} 状态{}'.format(N,pro,s.status_code)) except Exception as e: print(e) N+=1 运行该代码,效果如下 代理Ip池生成函数 #生成代理池子,num为代理池容量def proxypool(num): n = 1 os.chdir(r'/Users/apple888/PycharmProjects/proxy IP') fp = open('host.txt', 'r') proxys = list() ips = fp.readlines() while n<num: for p in ips: ip = p.strip('\n').split('\t') proxy = 'http:\\' + ip[0] + ':' + ip[1] proxies = {'proxy': proxy} proxys.append(proxies) n+=1 return proxys 下面开始爬豆瓣电影的电影数据,我们要获取 电影名、演员、评分。 电影标签页https://movie.douban.com/tag/ 烂片详情页https://movie.douban.com/tag/烂片 烂片详情页 我们就只爬烂片标签页的部分数据吧,网页链接规律如下 第一页https://movie.douban.com/tag/烂片?start=0 第二页https://movie.douban.com/tag/烂片?start=20 第三页https://movie.douban.com/tag/烂片?start=40 开始上代码 def fetch_movies(tag, pages, proxys): os.chdir(r'/Users/apple888/PycharmProjects/proxy IP/豆瓣电影') url = 'https://movie.douban.com/tag/爱情?start={}' headers = { 'User-Agent': 'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/' '537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Mobile Safari/537.36'} #用csv文件保存数据 csvFile = open("{}.csv".format(tag), 'a+', newline='', encoding='utf-8') writer = csv.writer(csvFile) writer.writerow(('name', 'score', 'peoples', 'date', 'nation', 'actor')) for page in range(0, pages*(20+1), 20): url = url.format(tag, page) try: respones = requests.get(url, headers=headers, proxies=random.choice(proxys)) while respones.status_code!=200: respones = requests.get(url, headers=headers, proxies=random.choice(proxys)) soup = BeautifulSoup(respones.text, 'lxml') movies = soup.find_all(name='div', attrs={'class': 'pl2'}) for movie in movies: movie = BeautifulSoup(str(movie), 'lxml') movname = movie.find(name='a') # 影片名 movname = movname.contents[0].replace(' ', '').strip('\n').strip('/').strip('\n') movInfo = movie.find(name='p').contents[0].split('/') # 上映日期 date = movInfo[0][0:10] # 国家 nation = movInfo[0][11:-2] actor_list = [act.strip(' ').replace('...', '') for act in movInfo[1:-1]] # 演员 actors = '\t'.join(actor_list) # 评分 score = movie.find('span', {'class': 'rating_nums'}).string # 评论人数 peopleNum = movie.find('span', {'class': 'pl'}).string[1:-4] writer.writerow((movname, score, peopleNum, date, nation, actors)) except: continue print('共有{}页,已爬{}页'.format(pages, int((page/20)))) 执行上述写好的代码 import timestart = time.time() proxyPool= proxypool(50) fetch_movies('烂片', 111, proxyPool)end = time.time() lastT = int(end-start) print('耗时{}s'.format(lastT)) Perfect 原文发布时间为:2018-11-16 本文来自云栖社区合作伙伴“灯塔大数据”,了解相关信息可以关注“灯塔大数据”。

优秀的个人博客,低调大师

Python网络爬虫(requests, 代理,Web认证, SSL证书认证)

requests模块 代理(proxies) 西刺代理 快代理 全网代理 高匿ip:看不到真实ip 透明ip:可以看到代理 和 真实ip 普通代理 proxies = {"协议":"协议://IP地址:端口号"} '''01_普通代理示例.py''' import requests url = "http://www.baidu.com/" proxies = {"http":"http://183.129.207.82:11597"} headers = {"User-Agent":"Mozilla/5.0"} res = requests.get(url,proxies=proxies,headers=headers) print(res.status_code) 私密代理 proxies = {"协议": "协议://用户名:密码@ip地址:端口号"} '''02_私密代理示例.py''' import requests url = "http://httpbin.org/get" headers = {"User-Agent":"Mozilla/5.0"} proxies = {"http":"http://309435365:szayclhp@123.206.119.108:16817"} res = requests.get(url,proxies=proxies,headers=headers) res.encoding = "utf-8" print(res.text) 爬取链家二手房信息 --> 存到MySQL数据库中 '''05_链家数据ToMongo.py''' import requests import re import pymysql import warnings class LianjiaSpider: def __init__(self): self.baseurl = "https://bj.lianjia.com/ershoufang/pg" self.page = 1 self.headers = {"User-Agent": "Mozilla/5.0"} self.proxies = {"http": "http://127.0.0.1:8888"} self.db = pymysql.connect("localhost", "root","ParisPython",charset="utf8") self.cursor = self.db.cursor() def getPage(self,url): res = requests.get(url,proxies=self.proxies,headers=self.headers,timeout=5) res.encoding = "utf-8" html = res.text print("页面爬取成功,正在解析...") self.parsePage(html) def parsePage(self,html): p = re.compile('<div class="houseInfo".*?data-el="region">(.*?)</a>.*?<div class="totalPrice">.*?<span>(.*?)</span>(.*?)</div>',re.S) r_list = p.findall(html) # [("天通苑","480","万"),()..] print("页面解析完成,正在存入数据库...") self.writeTomysql(r_list) def writeTomysql(self,r_list): c_db = "create database if not exists Lianjiadb \ character set utf8" u_db = "use Lianjiadb" c_tab = "create table if not exists housePrice( \ id int primary key auto_increment,\ housename varchar(50), \ totalprice int)charset=utf8" warnings.filterwarnings("ignore") try: self.cursor.execute(c_db) self.cursor.execute(u_db) self.cursor.execute(c_tab) except Warning: pass ins = "insert into housePrice(housename,totalprice) \ values(%s,%s)" for r_tuple in r_list: name = r_tuple[0].strip() price = float(r_tuple[1].strip())*10000 L = [name,price] self.cursor.execute(ins,L) self.db.commit() print("存入数据库成功") def workOn(self): while True: c = input("爬取按y(q退出):") if c.strip().lower() == "y": url = self.baseurl + str(self.page) + "/" self.getPage(url) self.page += 1 else: self.cursor.close() self.db.close() print("爬取结束,谢谢使用!") break if __name__ == "__main__": spider = LianjiaSpider() spider.workOn() 找URL https://bj.lianjia.com/ershoufang/pg1/ 正则 <div class="houseInfo".*?data-el="region">(.*?)</a>.*?<div="totalPrice">.*?<span>(.*?)</span>(.*?)</div> Web客户端验证(参数名:auth) auth=("用户名","密码") 案例 :09_Web客户端验证.py '''09_Web客户端验证.py''' import requests import re class NoteSpider: def __init__(self): self.headers = {"User-Agent":"Mozilla/5.0"} self.url = "网址" self.proxies = {"http":"http://309435365:szayclhp@123.206.119.108:16817"} # auth参数存储用户名和密码(必须为元组) self.auth = ("账号","密码") def getParsePage(self): res = requests.get(self.url, proxies=self.proxies, headers=self.headers, auth=self.auth, timeout=3) res.encoding = "utf-8" html = res.text print(html) p = re.compile('<a href=".*?>(.*?)</a>',re.S) r_list = p.findall(html) print(r_list) self.writePage(r_list) def writePage(self,r_list): print("开始写入文件...") with open("达内科技.txt","a") as f: for r_str in r_list: f.write(r_str + "\n\n") print("写入成功") if __name__ == "__main__": spider = NoteSpider() spider.getParsePage() SSL证书认证(参数名:verify) verify = True : 默认,进行SSL证书认证 verify = False: 不做认证 '''10_SSL证书认证示例.py''' import requests url = "https://www.12306.cn/mormhweb/" headers = {"User-Agent":"Mozilla/5.0"} res = requests.get(url,headers=headers,verify=False) res.encoding = "utf-8" print(res.text) urllib.request中Handler处理器 定义 自定义的urlopen()方法,urlopen()方法是一个特殊的opener(模块已定义好), 不支持代理等功能,通过Handler处理器对象来自定义opener对象 常用方法 build_opener(Handler处理器对象) :创建opener对象 opener.open(url,参数) # 创建Handler处理器对象 http_handler = urllib.request.HTTPHandler() #proxy_handler = urllib.request.ProxyHandler() # 创建自定义的opener对象 opener = urllib.request.build_opener(http_handler) # 利用opener对象的open()方法发请求 req = urllib.request.Request(url) res = opener.open(req) print(res.read().decode("utf-8")) Handler处理器分类 HTTPHandler() :没有任何特殊功能 ProxyHandler(普通代理) 代理: {"协议":"IP地址:端口号"} ProxyBasicAuthHandler(密码管理器对象) :私密代理 HTTPBasicAuthHandler(密码管理器对象) : web客户端认证 密码管理器对象作用 私密代理 Web客户端认证 程序实现流程 创建密码管理器对象 pwdmg = urllib.request.HTTPPasswordMgrWithDefaultRealm() 把认证信息添加到密码管理器对象 pwdmg.add_password(None,webserver,user,passwd) 创建Handler处理器对象 私密代理 proxy = urllib.request.ProxyAuthBasicHandler(pwdmg) Web客户端 webbasic = urllib.request.HTTPBasicAuthHandler(pwdmg) # 创建Handler处理器对象 pro_hand = urllib.request.ProxyHandler(proxy) # 创建自定义opener对象 opener = urllib.request.build_opener(pro_hand) # opener对象open方法发请求 req = urllib.request.Request(url) res = opener.open(req) print(res.read().decode("utf-8")) 爬取猫眼电影排行榜存入MongoDB数据库 '''06_猫眼电影top100抓取.py''' import requests import re import pymongo class MaoyanSpider: def __init__(self): self.baseurl = "http://maoyan.com/board/4?offset=" self.headers = {"User-Agent":"Mozilla/5.0"} self.page = 1 self.offset = 0 self.proxies = {"http":"http://309435365:szayclhp@123.206.119.108:16817"} self.conn = pymongo.MongoClient("localhost",27017) self.db = self.conn.Film self.myset = self.db.top100 # 下载页面 def loadPage(self,url): res = requests.get(url,headers=self.headers) res.encoding = "utf-8" html = res.text self.parsePage(html) # 解析页面 def parsePage(self,html): p = re.compile('<div class="movie-item-info">.*?title="(.*?)".*?<p class="star">(.*?)</p>.*?releasetime">(.*?)</p>',re.S) r_list = p.findall(html) # print(r_list) # [("霸王别姬","张国荣","1994-01-01"),(),()...] self.writeTomysql(r_list) def writeTomysql(self,r_list): for r_tuple in r_list: name = r_tuple[0].strip() star = r_tuple[1].strip() releasetime = r_tuple[2].strip() D = {"name":name, "star":star, "releasetime":releasetime} self.myset.insert(D) print("存入数据库成功") def workOn(self): while True: c = input("爬取请按y(y/n):") if c.strip().lower() == "y": self.offset = (self.page-1)*10 url = self.baseurl + str(self.offset) self.loadPage(url) self.page += 1 else: print("爬取结束,谢谢使用!") break if __name__ == "__main__": spider = MaoyanSpider() spider.workOn()

优秀的个人博客,低调大师

Python全栈 Web(Django框架、forms对象、cookie、session)

forms模块的高级处理 将models和forms结合到一起使用 1.在forms.py中创建class 继承自forms.ModelForm 2.创建一个内部类Meta来关联Model model 指定要关联的实体类是谁 fields 指定从model中取出那些字段生成控件 取值 "__all__"表示全部属性都要生控件 列表 声明允许生成控件的属性名 labels 指定每个属性所关联的label 取值为字典 label = { '属性名':'label文本', '属性名':'label文本', } class RegisterForm(forms.ModelForm): #通过内部类Meta表示关联的信息 class Meta: #1.指定关联的Model model = User #2.指定要生成控件的字段们 fields = "__all__" #3.指定每个控件对应的label labels = { 'uphone':'电话号码', 'upwd':'登录密码', 'uname':'用户名称', 'uemail':'电子邮件', } if request.method == 'GET': form = RegisterForm() return render(request,'05-register.html',locals()) 小部件: 什么是小部件? widget表示生成到页面上的控件类型以及其他的HTML属性 常用小部件类型 TextInput: type="text" PasswordInput: type="password" NumberInput: type="number" EmailInput: type="email" URLInput: type="url" HiddenInput: type="hidden" CheckboxInput: type="checkbox" Textarea: <textarea></textarea> Select: <select></select> 小部件的使用 继承自forms.Form 基本 只需要指定控件的类型 class RemarkForm(forms.Form): 属性 = forms.CharField( label:'文本', widget=forms.小部件类型 ) 高级 指定控件类型的基础上 还允许设置HTML的一些相关属性 属性 = forms.CharField( label="文本" widget=forms.小部件类型( attrs = { "html属性名":"html属性值", "html属性名":"HTML属性值" } ) ) 继承自forms.ModelForm class xxxForm(forms.ModelForm): class Meta: model = User fields = "__all__" labels = { "属性":"label" } widgets = { "属性1": forms.小部件类型(attrs={ }), } class LoginForm(forms.ModelForm): class Meta: model = User fields = ['uphone','upwd'] labels = { 'uphone':'注册电话', 'upwd':'登录密码', } #指定小部件 widgets = { 'upwd':forms.PasswordInput(attrs={ 'placeholder':'请输入您的密码' }) } class WidgetLoginForm(forms.Form): uphone = forms.CharField(label='电话号码') #为pwd指定小部件,显示为 密码框 # upwd = forms.CharField(label='登录密码',widget=forms.PasswordInput) upwd = forms.CharField( label='登录密码', widget=forms.PasswordInput( attrs = { 'placeholder':'请输入密码', 'class':'form-control', } ) ) cookies在Django中的实现 django中使用cookies 设置cookies: 响应对象.set_cookie(key, value, expires) key:cookie的名字 value:cookie的值 expires:保存时间 以s为单位 响应对象: HttpResponse() resp = HttpResponse("hello") resp.set_cookie(response, "xxx.html", locals()) return resp render() 获取cookies的值: 通过request.COOKIES 获取当前站点下对的所有的cookie的信息 def login_views(request): if request.method == 'GET': #判断uname是否存在于cookies中,如果有的话,直接提示登录成功,否则,去往09-login模板 if 'uname' in request.COOKIES: return HttpResponse('您已成功登录过') return render(request,'09-login.html') else: # 获取用户名称和密码 uname=request.POST['uname'] upwd = request.POST['upwd'] # 判断用户名称和密码的 if uname=='wangwc' and upwd=='123456': # 如果用户名和密码正确的话,判断有没有勾住记住密码 resp = HttpResponse("登录成功") if 'isSaved' in request.POST: # 如果有勾住记住密码,则将用户名称保存进cookies resp.set_cookie('uname',uname,60*60*24*90) return resp else: return HttpResponse('登录失败') session在django中的实现: 设置session的值: request.session["key"] = value 获取session的值: value = request.session["key"] 删除session的值 del request.session["key"] 在settings.py中设置session的相关设置 SESSION_COOKIE_AGE 设置 sessionID在cookies中的保存时间 SESSION_COOKIE_AGE = 60 * 60 * 24 # 最多保存24小时 SESSION_EXPIRE_AT_BROWSER_CLOSE 设置关闭浏览器是则清空服务器上对应的session空间 bool值 # 设置session def setSession_views(request): request.session['uname']='wangwc' return HttpResponse('Set Session Succefull') # 获取session def getSession_views(request): uname = request.session['uname'] return HttpResponse('uname:'+uname)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册