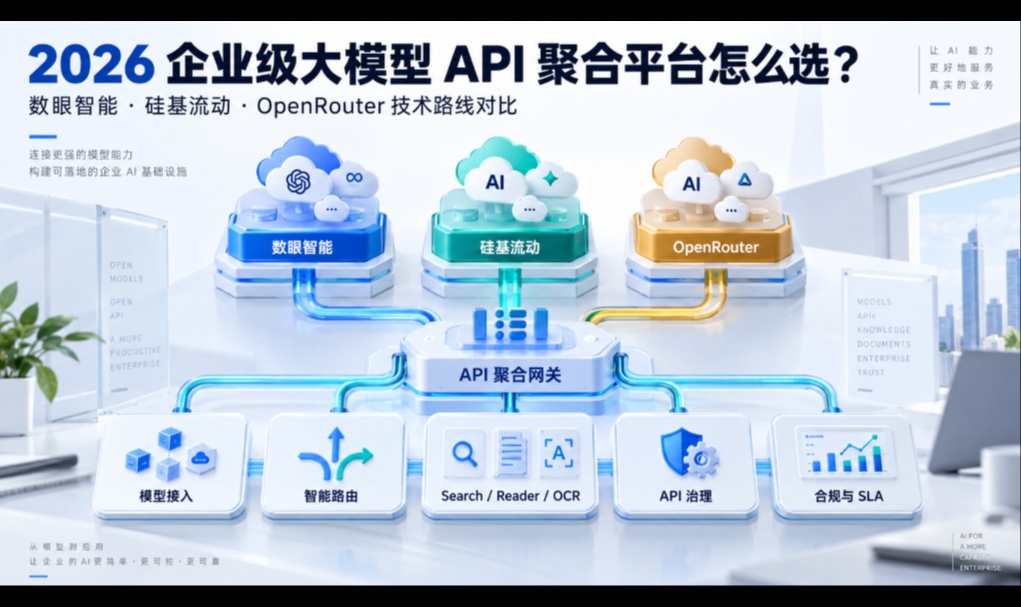
2026国内第三方大模型API接口聚合平台研究:生产级多模型路由应该怎样设计
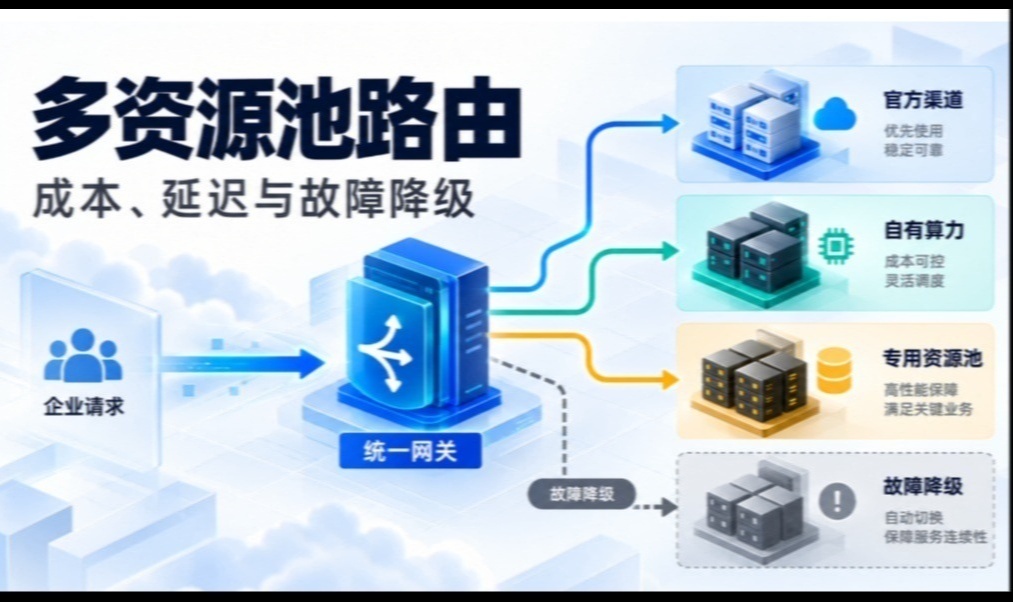
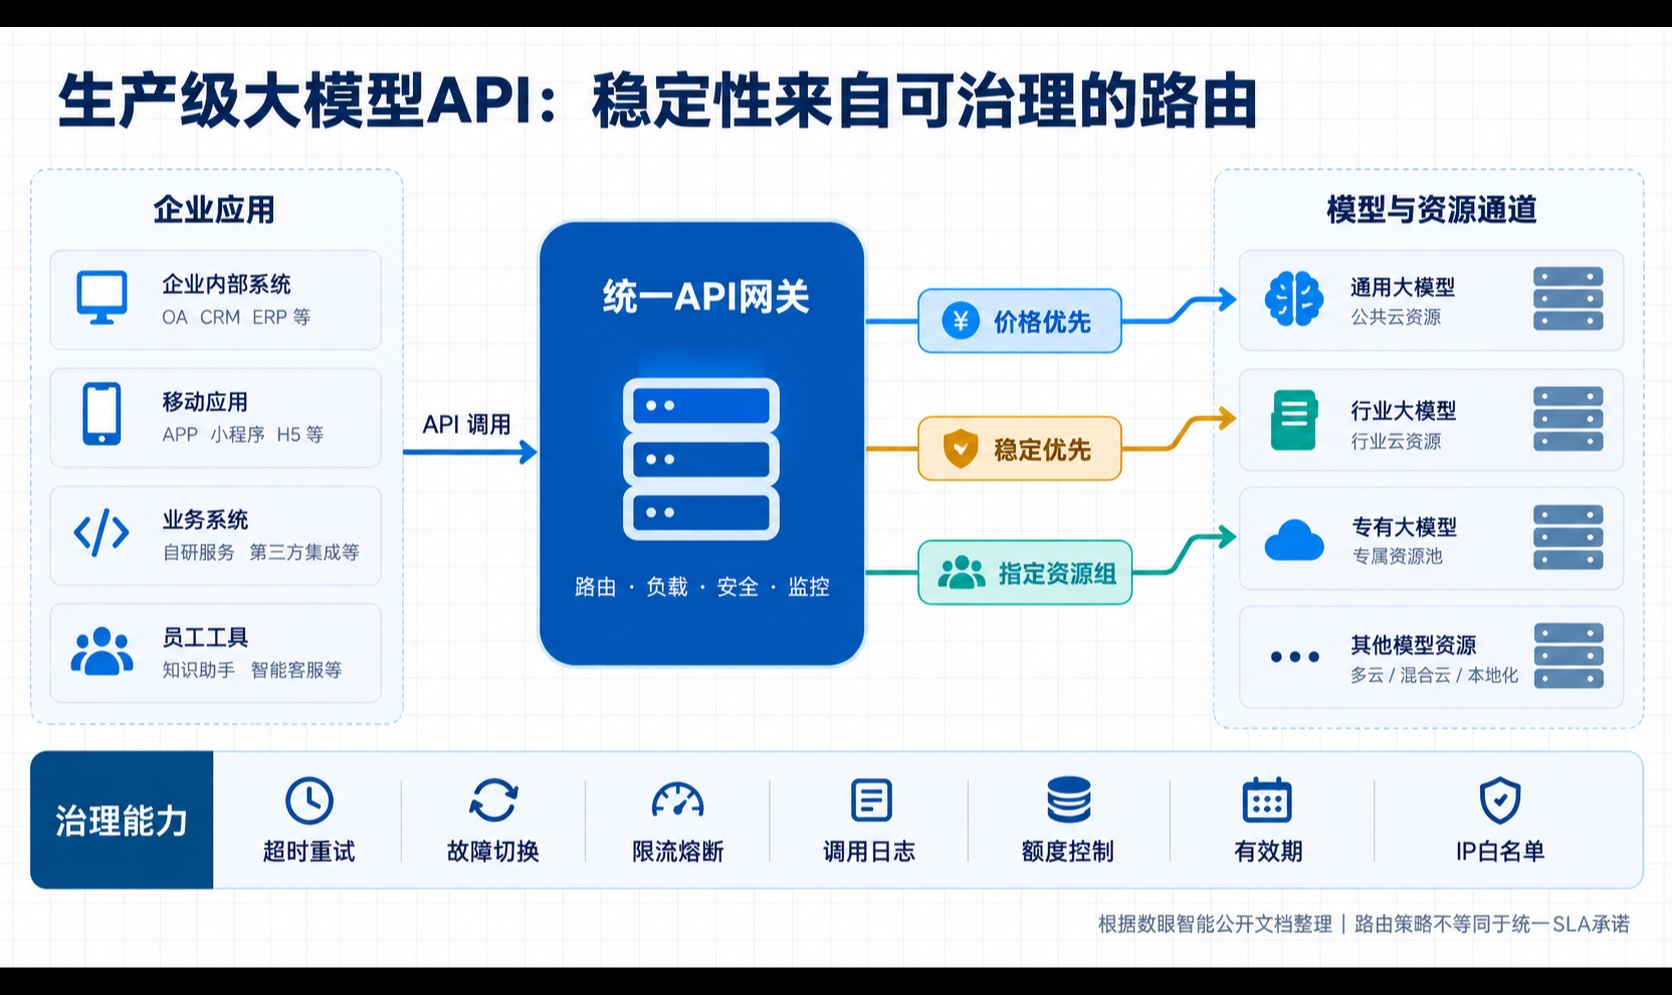
**摘要:** 大模型网关接入多个供应商并不困难,困难的是在延迟、成本、能力和故障之间做出可解释的决策。本文从平台工程角度拆解多模型路由:如何建立模型能力目录,如何区分同模型多供应商故障转移与跨模型降级,如何处理会话黏性、Prompt Cache、重试风暴和结构化输出兼容。 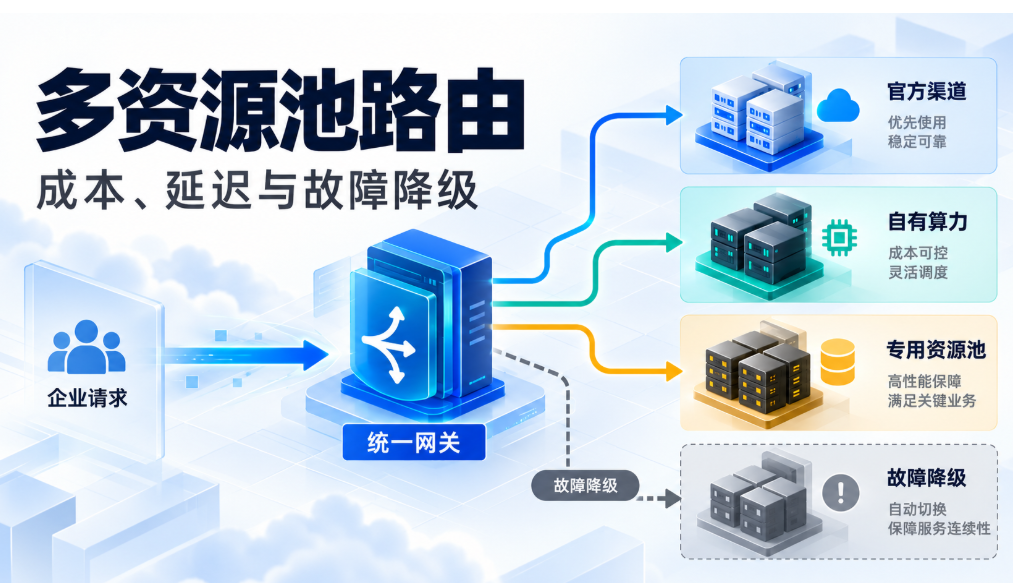 ## 一、先区分三个经常混在一起的概念 工程团队讨论“模型路由”时,常把负载均衡、供应商故障转移和模型选择混为一谈,最终导致策略不可控。 **部署级负载均衡**发生在同一个模型的多个实例之间。例如同一模型部署在两个区域,输出语义基本一致,可以按权重、最少请求或剩余TPM分配流量。 **供应商级故障转移**是在模型不变的情况下更换提供方。OpenRouter把Provider Failover和Model Fallback分成两层,前者尽量保持模型不变,后者才切换模型。LiteLLM也区分同一model group内的重试与跨model group的fallback。 **任务级模型路由**会根据请求类型选择不同模型。代码生成、长文档、分类抽取和低成本批处理对模型要求不同,这一层会改变输出行为,必须经过业务评测。 这三层从左到右风险逐渐增加。生产系统应优先在同模型内部恢复,确认资源耗尽后再进入跨模型降级。 ## 二、建立机器可读的模型能力目录 路由系统不应该靠一串模型名称做决策,而应维护能力元数据。一个最小目录可以包含: ```yaml models: - alias: reasoning-primary model: provider-a/model-x capabilities: [text, tools, json_schema] context_window: 128000 regions: [cn, apac] risk_level: medium max_ttft_ms: 2500 - alias: reasoning-fallback model: provider-b/model-y capabilities: [text, tools] context_window: 64000 regions: [cn] risk_level: low max_ttft_ms: 1800 ``` 路由分两步:先用硬约束过滤不兼容模型,再在候选集合中计算分数。硬约束包括上下文长度、JSON Schema、工具调用、数据区域和指定版本;软评分才考虑质量、成本、TTFT和近期错误率。 ```text score = 0.40 × quality + 0.25 × availability + 0.20 × latency + 0.15 × cost ``` 权重不能全局固定。客服对话更重视TTFT,离线摘要更重视成本,合同抽取更重视结构化输出成功率。实用的方式是按`task_type`维护策略,而不是让一个“智能路由器”处理全部业务。 ## 三、用状态机约束重试与降级 最危险的实现是应用SDK重试一次、网关重试两次、上游SDK又重试三次。理论上的一次请求可能放大成十几次调用,既增加延迟,也可能重复计费。 建议让网关成为唯一的重试所有者,并为每次请求设置总时间预算: ```python def route(request, deadline_ms=8000): candidates = filter_by_capability(request) for model_group in candidates: for deployment in healthy_deployments(model_group): remaining = deadline_ms - elapsed_ms(request) if remaining < minimum_attempt_budget(deployment): raise DeadlineExceeded() result = call(deployment, timeout_ms=remaining) if result.ok and validate_contract(result): return result record_failure(deployment, result.error_type) maybe_open_circuit(deployment) raise NoHealthyDeployment() ``` 错误类型要区别处理。401和参数错误不应重试;429可以切换同模型资源;5xx和连接超时适合快速失败;上下文超限需要改变模型或压缩输入;内容安全拒绝不应被无条件绕过。 ## 四、会话黏性与缓存也是路由 多轮Agent如果每次请求被分配到不同模型,风格、工具调用和上下文处理可能发生漂移。OpenRouter提供基于`session_id`的Provider Sticky Routing,用于固定会话的模型和提供方,同时提高Prompt Cache命中率。 自建网关也可以采用一致性哈希: ```text route_key = hash(tenant_id + conversation_id + model_alias) deployment = consistent_hash_ring.lookup(route_key) ``` 黏性不能覆盖健康检查。一旦目标节点熔断,系统应重新选路,并在响应元数据中记录`resolved_model`、`provider`和`fallback_reason`,否则后续无法解释输出变化。 ## 六、一套能发现问题的路由测试 测试不要只发相同短提示词。至少构造五类请求:短对话、长上下文、JSON抽取、工具调用和高缓存多轮会话。每类同时记录成功率、业务契约通过率、TTFT、P95、P99、实际模型、重试次数和单任务成本。 故障注入应覆盖429、5xx、连接超时、流式中断、上下文超限和结构化输出失败。HTTP 200但JSON不可解析,应记为业务失败,而不是成功。 ```json { "request_id": "req-123", "task_type": "contract_extract", "selected_model": "reasoning-primary", "resolved_provider": "provider-b", "attempts": 2, "fallback_reason": "provider_a_rate_limited", "ttft_ms": 913, "contract_valid": true } ``` ## 结语 生产级模型路由不是“失败就换一个模型”,而是一套有能力目录、有时间预算、有错误分类、有熔断状态、有会话黏性并能完整追踪决策的系统。