首页 文章 精选 留言 我的

精选列表

搜索[es],共3900篇文章
优秀的个人博客,低调大师

爬取歌词信息,写入ES

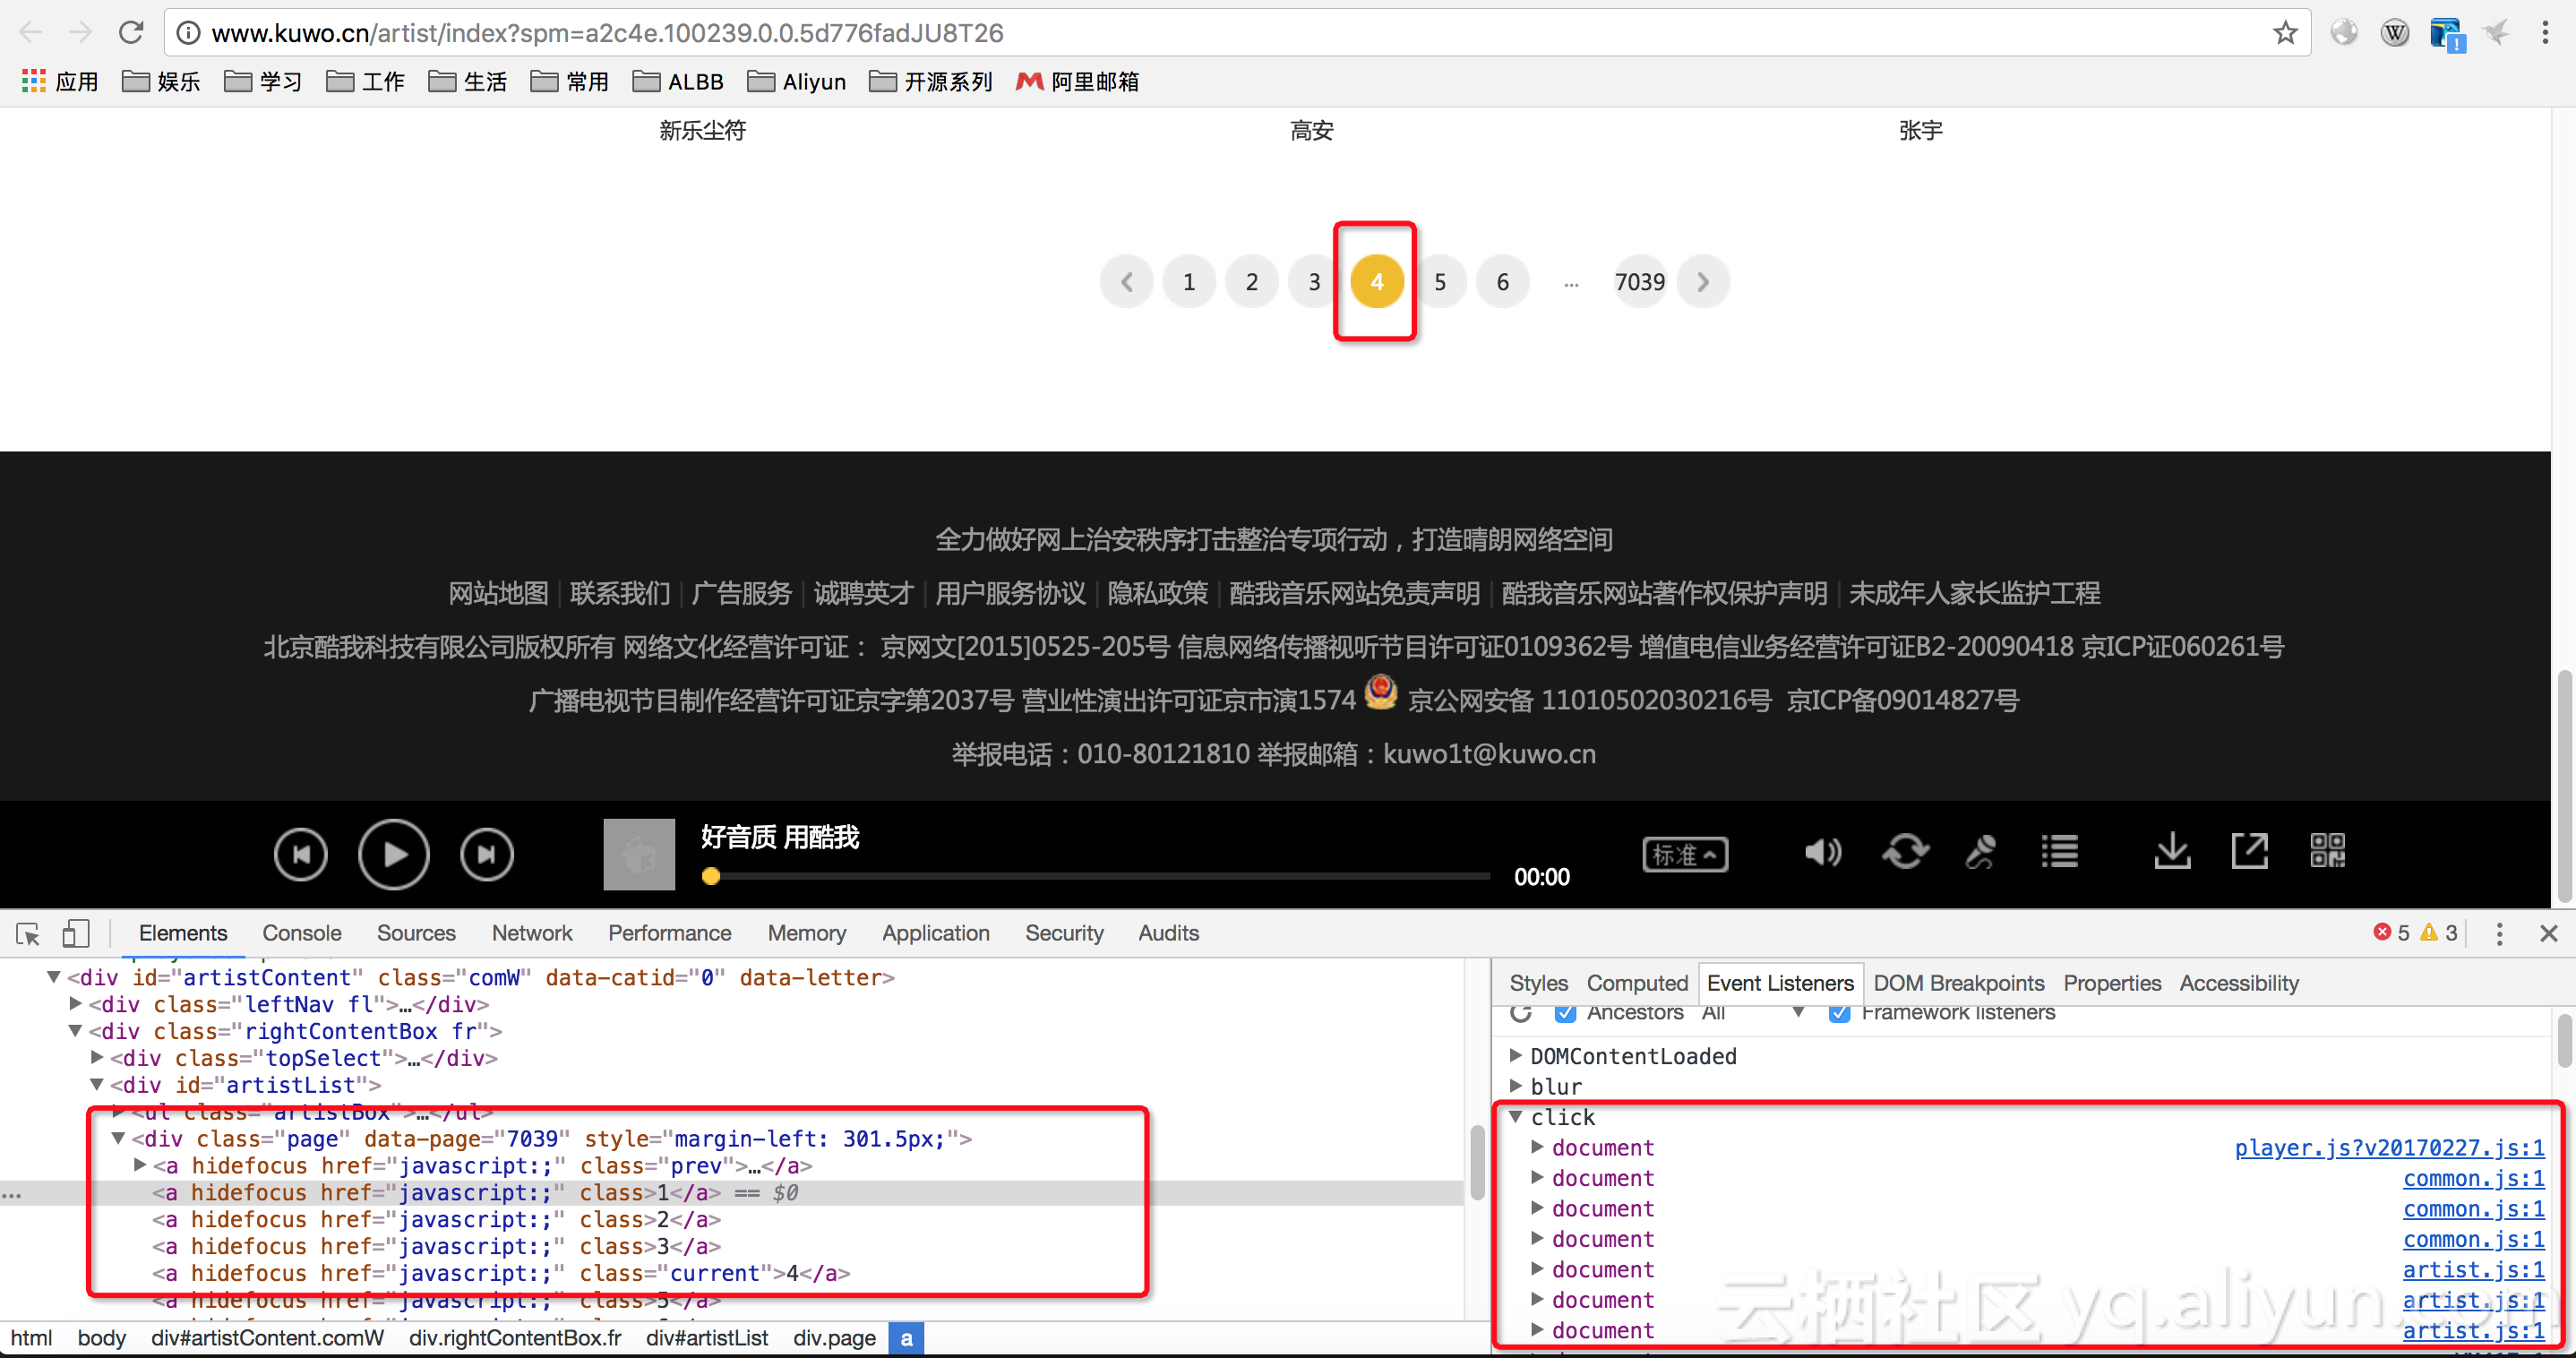
1.说明 爬虫采用Java的Jsoup ElasticSearch请在阿里云官网购买,采用客户端x-pack-transport 歌词网站来源:http://www.kuwo.cn/artist/index 2. 歌词网站分析 此处采用了比较笨的一种方式,即逐个分析每个请求的url,这样可以方便代码编写,就不用模拟器了(如需使用模拟器可参考使用cdp4j模拟点击事件等,但简单试了下不是很好用,且效率低) a) 歌手获取分析 在http://www.kuwo.cn/artist/index 查看分页按钮的click事件,从js中找到分页请求的url从click事件的artist.js中找到相关url如下图所示其中pn参数即为页码参数 var b = host + "/artist/indexAjax?category=" + index + "&a

优秀的个人博客,低调大师

基于OpenGL ES 的图片翻转例子,包含双面贴图3D变换

代码不太规范,凑合着看看吧,sdk版本15,可以自己降低版本编译,反正没用什么新特性。OpenGL现在的例子很少啊,有兴趣的可以下载看看,花了我一天呐。 纹理已经处理过,一律缩放到512x512,android限制纹理高宽必须是2的N次幂,但是比例无所谓。 PS:好吧……那就把图补上 源码下载:http://www.apkbus.com/android-20283-1-1.html 代码不太规范,凑合着看看吧,sdk版本15,可以自己降低版本编译,反正没用什么新特性。OpenGL现在的例子很少啊,有兴趣的可以下载看看,花了我一天呐。 纹理已经处理过,一律缩放到512x512,android限制纹理高宽必须是2的N次幂,但是比例无所谓。 PS:好吧……那就把图补上 源码下载:http://www.apkbus.com/android-20283-1-1.html 本文转自qianqianlianmeng博客园博客,原文链接:http://www.cnblogs.com/aimeng/archive/2012/01/29/2331516.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

时间序列数据库——索引用ES、聚合分析时加载数据用什么?docvalues的列存储貌似更优优势一些。那分布式计算呢?ES做

分布式计算 分布式聚合如何做得快 Elasticsearch/Lucene从最底层就支持数据分片,查询的时候可以自动把不同分片的查询结果合并起来。Elasticsearch的document都有一个uid,默认策略是按照uid 的 hash把文档进行分片。 一个Elasticsearch Index相当于一个MySQL里的表,不同Index的数据是物理上隔离开来的。Elasticsearch的Index会分成多个Shard存储,一 部分Shard是Replica备份。一个Shard是一份本地的存储(一个本地磁盘上的目录),也就是一个Lucene的Index。不同的Shard 可能会被分配到不同的主机节点上。一个Lucene Index会存储很多的doc,为了好管理,Lucene把Index再拆成了Segment存储(子目录)。Segment内的doc数量上限是1的 31次方,这样doc id就只需要一个int就可以存储。Segment对应了一些列文件存储索引(倒排表等)和主存储(DocValues等),这些文件内部又分为小的 Block进行压缩。 时间序列数据一般按照日期分成多个Elasticsearch Index来存储,比如logstash-2014.08.02。查询的时候可以指定多个Elasticsearch Index作为查找的范围,也可以用logstash-*做模糊匹配。 美妙之处在于,虽然数据被拆得七零八落的,在查询聚合的时候甚至需要分为两个阶段完成。但是对于最终用户来说,使用起来就好像是一个数据库表一样。所有的合并查询的细节都是隐藏起来的。 对于聚合查询,其处理是分两阶段完成的: Shard本地的Lucene Index并行计算出局部的聚合结果; 收到所有的Shard的局部聚合结果,聚合出最终的聚合结果。 这种两阶段聚合的架构使得每个shard不用把原数据返回,而只用返回数据量小得多的聚合结果。相比Opentsdb这样的数据库设计更合理。Opentsdb其聚合只在最终节点处完成,所有的分片数据要汇聚到一个地方进行计算,这样带来大量的网络带宽消耗。所以Influxdb等更新的时间序列数据库选择把分布式计算模块和存储引擎进行同机部署,以减少网络带宽的影响。 除此之外Elasticsearch还有另外一个减少聚合过程中网络传输量的优化,那就是Hyperloglog算 法。在计算unique visitor(uv)这样的场景下,经常需要按用户id去重之后统计人数。最简单的实现是用一个hashset保存这些用户id。但是用set保存所有 的用户id做去重需要消耗大量的内存,同时分布式聚合的时候也要消耗大量的网络带宽。Hyperloglog算法以一定的误差做为代价,可以用很小的数据 量保存这个set,从而减少网络传输消耗。 为什么时间序列需要更复杂的聚合? 关系型数据库支持一些很复杂的聚合查询逻辑,比如: Join两张表; Group by之后用Having再对聚合结果进行过滤; 用子查询对聚合结果进行二次聚合。 在使用时间序列数据库的时候,我们经常会怀念这些SQL的查询能力。在时间序列里有一个特别常见的需求就是降频和降维。举例如下: 12:05:05 湖南 81 12:05:07 江西 30 12:05:11 湖南 80 12:05:12 江西 32 12:05:16 湖南 80 12:05:16 江西 30 按1分钟频率进行max的降频操作得出的结果是: 12:05 湖南 81 12:05 江西 32 这种按max进行降频的最常见的场景是采样点的归一化。不同的采集器采样的时间点是不同的,为了避免漏点也会加大采样率。这样就可能导致一分钟内采样多次,而且采样点的时间都不对齐。在查询的时候按max进行降频可以得出一个统一时间点的数据。 按sum进行降维的结果是: 12:05 113 经常我们需要舍弃掉某些维度进行一个加和的统计。这个统计需要在时间点对齐之后再进行计算。这就导致一个查询需要做两次,上面的例子里: 先按1分钟,用max做降频; 再去掉省份维度,用sum做降维。 如果仅仅能做一次聚合,要么用sum做聚合,要么用max做聚合。无法满足业务逻辑的需求。为了避免在一个查询里做两次聚合,大部分的时间序列数据库都要求数据在入库的时候已经是整点整分的。这就要求数据不能直接从采集点直接入库,而要经过一个实时计算管道进行处理。如果能够在查询的时候同时完成降频和降维,那就可以带来一些使用上的便利。 这个功能看似简单,其实非常难以实现。很多所谓的支持大数据的数据库都只支持简单的一次聚合操作。Elasticsearch 将要发布的 2.0 版本的最重量级的新特性是Pipeline Aggregation,它支持数据在聚合之后再做聚合。类似SQL的子查询和Having等功能都将被支持。 总结 时间序列随着Internet of Things等潮流的兴起正变得越来越常见。希望本文可以帮助你了解到那些号称自己非常海量,查询非常快的时间序列数据库背后的秘密。没有完美的数据 库,Elasticsearch也不例外。如果你的用例根本不包括聚合的需求,也许Opentsdb甚至MySQL就是你最好的选择。但是如果你需要聚合海量的时间序列数据,一定要尝试一下Elasticsearch! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6432769.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册