首页 文章 精选 留言 我的

精选列表

搜索[笔记软件],共10000篇文章
优秀的个人博客,低调大师

Scala学习笔记(2)-基础语法

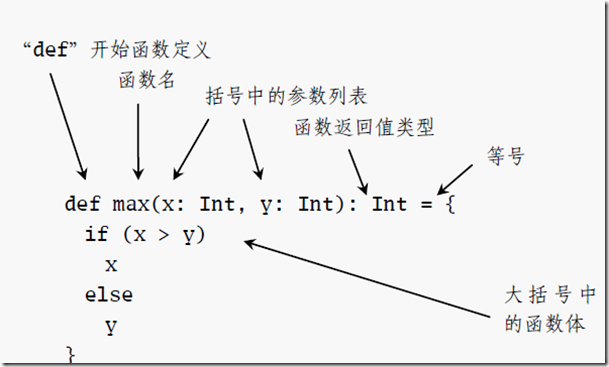
秉着简洁而不失完整的的原则,这章只把Scala主要语法和与Java不同的内容列出来,以后章节也如此,内容以简洁为主,太长了自己都被吓着了,也没耐心看下去。 1.Scala解释器使用,这里不做介绍,有IDE这玩意一般用不着。 2.基本数据类型 Java原始类型在scala包里都有对应的类。例如,scala.Boolean对应着Java的boolean。scala.Float对应着Java的float。当你把你的Scala代码编译成Java字节码,Scala编译器将使用Java的原始类型以便获得其带来的性能益处。 3.定义变量 Scala有两种变量,val和var。val类似于Java里的final变量。一旦初始化了,val就不能再赋值了。与之对应的,var如同Java里面的非final变量。var可以在它生命周期中被多次赋值。 val msg1=”hello scala” var msg2=”hello world” 仔细看上面定义的2个变量好像都没有类型声明,这是怎么回事呢?这就要说到Scala的类型推断(type inference),因为你用了一个字符串来初始化msg变量,Scala推断msg的类型是String。你也可以显式地定义类型,有些时候也应该这么做。显式的类型标注不但可以确保Scala编译器推断你倾向的类型,还有助于以后代码的阅读。 val msg : String=”hello scala” 与Java不同的是类型声明在变量后面,用一个”:”分隔。 4.定义函数 上面已经定义了变量,现在开始学习怎么定义一个函数 def max(x: Int, y: Int): Int = { //定义函数 if (x > y) x else y } max(3,7) //调用函数 自己对照看与 java函数有什么不同,函数体只有一句的大括号可以省略写成 : def max(x: Int, y: Int) = if (x > y) x else y 结果类型也去掉了,编译器类型推断可得出,尽管如此带上结果类型也是一个好习惯,便于其他人阅读代码。 Scala的Unit结果类型指的是函数没有返回有用的值。Scala的Unit类型比较接近Java的void类型,而且实际上Java里每一个返回void的方法都被映射为Scala里返回Unit的方法。因此结果类型为Unit的方法,仅仅是为了它们的副作用而运行 注:java里的i++和++i在scala里是行不通的。 本文来自云栖社区合作伙伴“开源中国” 本文作者:山海经 原文链接

优秀的个人博客,低调大师

kettle学习笔记及最佳实践

最近在用kettle迁移数据,从对kettle一点不会到比较熟悉,对于期间的一些问题和坑做了记录和总结,内容涵盖了使用的经验和技巧,踩到的坑、最佳实践和优化前后结果对比。 常用转换组件 计算形成新字段:只限算术运算,并且选择固定 过滤记录:元表某字段按照某个条件分流,满足条件的到一个表,不满足的到另一个表,这两个目标表都必须有。 Switch/Case:和过滤记录类似,可以多个条件判断,并且有默认转向条件,可以完美替换过滤记录组建 记录分组:group by 组建未能正常按照预期理解运行 设置为NULL:将某个特定值设置为NULL 行扁平化:行扁平化,使用与某条件下某名称对应的行数相同的情况 行列转换:行转成列,使用Row Normalizer组件,事先一定要是根据分组字段排好序,关键字段就是name列字段,分组字段就是按照什么分组,目标字段就是行转列之后形成的字段列表。 8.字段选择:选择需要的目的列到目标表,并且量表的对应字段不一样时可以用来做字段映射 排序:分组前先排序可以提高效率 条件分发:根据条件分发,相当与informatica的router组件 值映射:相当与oracle的decode函数,源和目标字段同名的话,只要写源字段就可以了 #常用输入组件 表输入:源表输入 文本文件输入:文本文件输入 xml文件输入:使用Get Data From XML组件,可以在其中使用xpath来选择数据 JsonInput:貌似在中文环境下组件面板里看不到,切换到英文模式就看到了 #常用输出组件 表输出:表输出 文本文件输出:文本文件输出 XML文件输出:输出的XML文件是按照记录行存储的,字段名为元素名 Excel文件输出:输出的excel文件是按照记录行存储的,字段名为元素名 删除:符合比较条件的记录将删除 更新:注意两个表都要有主键才可以 插入/更新:速度太慢,不建议使用 检查字段是否存在:若在则家一个标志位,值可以是Y/N 等值连接:有关联关系字段可以关联,其它的不关联。 笛卡尔连接:所有两边的记录交叉连接 write to log:把数据输出到控制台日志里,一般调试时很常用 空操作:很常用,比如过滤数据,未过滤走正常流程,滤除的数据就转向空操作。我喜欢在转换里用它做开始和结束之类需要分发或汇聚数据流的场景 #内置变量 Internal.Transformation.Name 当前转换的名字 Internal.Job.Name 当前job名字 Internal.Job.Filename.Name job的文件名 #需要修改的配置 在java8里-XX:MaxPermSize,-XX:PermSize已经去掉了,需要修改成-XX:MetaspaceSize 和 -XX:MaxMetaspaceSize 生产环境和开发环境使用不同的数据库连接 ~/.kettle/kettle.properties里设置key=value 在kettle.properties中添加变量,然后在类似数据库连接的地方可以用${key}来使用,这样可以实现开发环境和生产环境配置的差异,就算往资源库里提交也可以互不影响了 kettle分页问题 kettle循环分页 首先弄一个转换A,根据源表获取记录数,页数,每页记录数,然后写入系统变量,然后在job里调用转换A,再加一个转换B来迁移数据(其中查询sql要使用转换A生成的系统变量),最后在job里用一个javascript脚本来判断查询记录数是否是0,如果是0就走执行成功,否则就继续执行转换B。 最关键的是判断的js脚本,可以参考 var prevRow=previous_result.getRows();//获取上一个传递的结果,这种方案需要在转换B中将记录集复制为结果,如果记录集较多会造成内存溢出。就算在job里执行也是如此 完整代码: if (prevRow==null && prevRow.size()==0){ false; }else{ var startRow=parseInt(parent_job.getVariable("START_ROW", 0)); var pageSize=parseInt(parent_job.getVariable("PAGE_SIZE",1000)); startRow=startRow+pageSize; parent_job.setVariable("START_ROW", startRow); true; } kettle分页循环的更高效的改进方案 在转换里,每执行一次有个SUCC_COUNT环境变量就+1,在job中用js脚本判断成功数是否>=总记录数,是就终止循环,否就起始行+每页记录数,下面是代码 var startRow=parseInt(parent_job.getVariable("startrow")); var totalItemCount=parseInt(parent_job.getVariable("totalitemcount")); if (startRow >= totalItemCount){ false; }else{ true; } 对比前一种方案,改进方案一次迁移一万条数据没有压力,而且cpu稳定在20%以下。 参数和变量 全局变量参数 在kettle.properties中配置,通过获取环境变量组件来读取,一般用来做数据库连接配置等 位置参数(arguments参数) 最多支持10个,通过命令行参数的位置来区别,不是太好用 命名参数(named params) 通过 -param:name=value的方式设置参数,如果传多个参数需要 -param:name1:value1 -param:name2:value2 配置方法 在转换中双击空白处添加命名参数arg3,arg4,用的时候可以 ${arg3},${arg4}来使用,注意:如果不直接执行转换就不要配置转换命名参数(转换的命名参数和全局参数在调试时有时候会出现莫名其妙的冲突),建议使用全局参数来替代 在job中双击转换,切换到命名参数页,点击获取参数(arg3和arg4会出现到列表里)注意:在使用全局参数的时候这步可以省略 在job中双击空白处添加命名参数arg3,arg4,然后在调用kitchen.sh时通过 -param:arg3=abc -param:arg4=def来使用,注意:-param传递的命名参数一定要在job中事先定义才可以。 命名参数可以做变量使用,即${var}的方式来调用,如果是日期这样必须包含'的场景,可以用-param:date="2018-1-1 0:0:0"来表示,在sql里用'${var}'来表示 kitchen常用命令 命令行执行job(repository模式) ./kitchen.sh -listrep kitchen.sh -rep=<respository名字> -user=<respository登录用户名> -pass=<respository密码> -level=<日志级别> -job=<job名字> -logfile=<日志文件路径> kitchen.sh -rep=olpbdb01 -user=admin -pass=admin -level=Basic -dir=/demo1 -job=demo1 //会执行repository上 /demo1/demo1.kjb 命令行执行job(文件模式) kitchen.sh -file=/home/job/demo.kjb >> /home/job/log/demo.log 命令行执行转换(respository模式) pan.sh -rep=mysql -user=admin -pass=admin -dir=/fixbug -trans=f_loan_update -level=Basic -logfile=/data/kettle.log 命令行执行转换(文件模式) pan.sh -file /data/kettle/demo1/t_test_rep_mysql.ktr 三种增量同步的模式 时间戳增量同步:表中增加一个时间戳字段,每次更新值查询update_time>上次更新时间的记录。优点速度快,实现简单,缺点是对数据库有侵入性,对于业务系统也需要更新时间戳,增加了复杂性。 触发器增量同步:使用触发器来监控数据变化,对数据库有侵入性并且实现难度较大 全表增量同步:主要是用合并记录来比对,优点是数据库侵入较小,实现简单,缺点是性能较差。 个人观点是全表比对要好一点,如果按照分页的方式的化,二十几万条数据20分钟可以全同步完成。但全表增量同步只适合对实时性要求不高的场景。 几个常用组件的用途 1.字段选择:比如上一步骤有10个字段,下一步骤需要对其中某个字段做处理,就用字段选择来选择那个字段。还有,如果要合并记录,也会在数据流中使用字段选择选择一下字段。还有就是字段选择自带删除字段和修改字段类型和格式的功能 2.写日志:在处理数据时用写日志组建来记录logger是个不错的方法。 3.Switch/Case:和合并记录配合使用可以实现增量的数据插入/更新和删除。用过滤记录也可以实现同样功能 4.表输出:实际就是向表里insert数据,里面有个[返回自动产生的关键字]功能很好用,相当与insert后立刻查询的到刚刚自增的ID,省去了一部查询操作。 5.更新,删除:和名字一个意思 6.空操作:这个也很有用。 7.记录集连接:类似sql中的join操作,把两个数据流的字段(类型相同,列数相同,位置相同且已经排序过)拼合到一起。 8.分组:类似sql里的group by,构成分组的字段是分组条件(如果没有组可分但又要把每一行的数据都拼成一个串,可以不设置分组条件),聚合部分的字段是类似在select部分需要用聚合函数处理的字段。在拼合in 条件时很有用。 9.javascript脚本:这个不好用,能不用就不要用了。javascript组件支持将js变量转成输出字段。注意在转换里js脚本是每行执行一次。 10.获取变量:如果有外部传入的命名参数或者有环境变量,最好获取变量是做为流程的起点来使用。 11.设置变量:把某个字段转成变量时可以用。 12.表输入 12.1.一般提供一个复杂的sql查询,而且如果表输入需要参数,那么前一步骤一定是个获取变量。 12.2.如果需要实现动态sql(即拼一个sql存入变量A,然后在表输入里执行${A}),必须用两个转换实现。 12.3.如果需要实现每行查询一次(尽量避免这样做,太慢),可以在表输入中选中从步骤插入数据,并勾选执行每一行,在表输入的前一个步骤使用选择选择表输入的参数,在表输入中用占位符?来表示字段选择中选择的字段。 12.4.如果有可能,尽量一次性的用表输入完成所有的各类计算,转换,排序,而尽量避免使用kettle自带组件,因为这样速度快。 13.映射 13.1.可以在转换里调用另一个转换,转换中通过映射输入规范来接收入参数(实际就是个表记录集,在输入规范里定义的都是字段),用映射输出规范来定义输出数据集。这样整个映射就可以作为一个步骤整合到一个转换里(有输入和输出)。映射可以实现转换流程逻辑的复用。 13.2..关于在同一个转换的不同步骤中先修改变量然后再获取变量(取得的是转换刚开始执行时的值)不正确的问题,官方是这样解释的,在转换开始时会有一些变量初始化,初始化之后一些转换中的步骤并不是顺次执行的,所以无法做到同一个转换中在一个步骤。对于这种情况需要拆成两个抓换,先定义和初始化变量,然后再另一个转换中获取变量,需要注意的是,如果是转换中定义变量在子映射的获取的话也是不行的。 14.执行结果里面的Preview data非常好用,可以跑起来查看每个步骤的处理结果,如果发现一个步骤有数据,下一个步骤没数据了,那么可能是有问题了。 15.对于执行时有错误的情况,最好采用一张表来存储执行除错的数据,这对于无人职守迁移数据很重要。可以做成一个子转换来实现功能的复用。 16.对于javascript的调试,最好使用第三方的js开发工具来做,kettle自带的js编辑器太垃圾了。 17.合并记录时总是报NullPointerException,原因是合并记录的两个来源可能有不存在的情况,也可能是两个数据来源的排序不一致 18.转换的配置里的日志可以在线上部署的时候先禁用掉,有问题的时候可以再打开(通过点击连接线) kettle的最佳实践 启动时 kettle不能加入到PATH里去,加了执行 kitchen.sh -listrep找不到资源库 在~/.kettle里有重要的kettle.properties和repositories.xml文件,服务器部署的时候需要拷贝上去 spoon图形界面一般用来调试,跑多条数据会很慢 个人认为文件模式比repository模式好用点,repository模式总是莫名其妙的出问题,并且repository无法保留变更历史,但文件模式+git就可以做到 Unable to get module class path. (java.lang.RuntimeException: Unable to open JAR file, probably deleted: error in opening zip file) 需要删掉 <kettle_home>/system/karaf/caches/下的所有文件 启动时闪退时需要删掉~/.kettle/db.cache打头的文件就可以了。 防内存溢出和提高性能的处理办法 数据量较大时一定要使用分页机制,控制每个批次导入5000~10000 需要在分页循环中首先用一个独立的转换来计算出当前批次的用户ID数组,页码数量,总记录数以及维度表的数据,比如有日期维度表,那么就需要算出当前批次要处理的日期时间数组,最后把这些数据存入到全局变量里面去。这样在后续步骤就可以取出这些全局变量内容按照分页批次进行迁移了。 2.分页要通过一个表输入根据传入的每页记录数动态计算出总页数,并把总页数,总记录数存入全局变量,然后每处理一行计数器加1,截止条件就是总记录数<=处理过的记录数,从而实现的分页循环。 分页变量务必要通过命名参数-param来传递,这样在生产环境万一碰到了数据过大造成内存泄漏,可以通过参数快速调整 分页需要动态在模型中计算出页码数和总记录数,可以用个sql来搞定 select count(1) totalitemcount, round(CEIL(count(1)/${pagesize})) pagecount from table_name where create_time between unix_timestamp('${startdate}') and unix_timestamp('${enddate}') 之后的结果(totalitemcount,pagecount)用设置变量组件存入变量里就ok了 5. 注意数据量较大时不要使用记录复制到结果组件,不然一定会内存溢出 6. kettle的很多功能都有对应的纯sql实现方法,比如加字段,比如排序和空值的处理,纯sql的实现方式要比kettle的方式快很多,而且对内存的消耗也会小很多。 7. 可以设置几个变量来优化性能 KETTLE_MAX_LOG_SIZE_IN_LINES=5000 #内存里最多记录多少行日志 KETTLE_MAX_LOG_TIMEOUT_IN_MINUTES=1440 #kettle日志的保留时间,单位是分钟 KETTLE_MAX_JOB_ENTRIES_LOGGED=1000 #内存中保留多少实体返回结果日志 KETTLE_MAX_JOB_TRACKER_SIZE=1000 #内存里最多保留多少job跟踪记录 KETTLE_MAX_LOGGING_REGISTRY_SIZE=1000 #内存里记录多少实体 来优化内使用情况(在~/.kettle/kettle.properties里设置) 迁移模型的设计原则 整个模型必须是job+多个转换(除非是一次性工作可以没有job) job可以认为是表级处理(即一次处理多行,所有组件都是对于多行的处理组件),转换可以认为是行级处理(即一次处理一行,所有组件都是一次一行) 转换分两组,初始化变量用的转换(至少有一个,也可能有多个,主看是否有新变量,因为新变量无法在同一个转换里使用),和迁移数据用的转换(看情况,一般一个就够了) 命名参数的选择,即通过-param:varname=value的参数,一般需要有startdate,enddate,startrow,pagesize几个就够了 迁移的模式一般来说需要一个独立的转换根据日期区间计算出本次需要处理的业务ID数组(即先锁定该批次要处理交易),然后第二个转换根据事先锁定的交易ID数组提取出日期时间数组,用户ID数组,地区数组等。第三个转换再使用前面两步转换里提取的变量查询数据进行迁移 在迁移i数据时,数据流分成了新数据流(针对业务表)和旧数据流(针对事实/维度表),新数据流通过排序、分组、字段选择和连接数据集join起来,然后通过合并记录组件计算出每行记录的flagfield(new/changed/deleted/identical的评判结论),然后通过Switch/Case或过滤记录分别针对每种情况进行处理(调用表输出/更新/删除) 如果转换时涉及多个类别的数据要迁移到一张事实/维度表,不要拆成两组job,可以在一个job里依次调用一组转换,执行完一组再执行下一组,千万不要并行,因为设置的全局变量名字都一样,会出现冲突问题 变量的的使用 ${Internal.Entry.Current.Directory}/test.ktr可以表示当前目录下的test.ktr,同时适配repository模式和local文件模式 关于变量的使和编程语言中的变量不太一样,无法使用在同一个转换中定义和获取当前转换内修改过的变量,变通方法是拆成两个转换来使用,这问题卡了好几天才找到原因。 在job/转换通过-param:varname=value的方式传参时,如果发现变量无法解析,那么一定是job和转换的命名参数里没有配置(双击空白处,有个命名参数页签....) 在job/转换开始执行的时候通过日志输出一下用到的变量是个很好的习惯 作业和转换都要有命名参数startrow,pagesize,startdate,enddate几个,这样可以在调用的时候灵活控制分页以及起止时间,灵活实现全量和增量迁移 对变量冲突的问题要小心,特别是同一个job并行处理多个转换时更是如此,因此在job里并行执行转换时要格外小心。 写变量时有对变量作用域的设置,推荐设置成Valid in the root job,不推荐Valid in the Java Virtual Matchine。 表输入的处理 表输入有个功能,可以每行都执行一次查询,这个功能不要用,太慢对内存占用很高。 推荐使用记录集连接的方法,比如A,B,C三个表要通过外键拼接在一起插入到D表中,那么可以A,B,C三个表分别通过表输入查询出来,然后通过连接记录集拼接到一起做为新数据(排序、字段对齐、类型要一致),然后查询出D表做为老数据(排序、字段对齐、类型要一致),然后通过合并记录的方式对比新老数据,并根据flagfield的四个状态值(new/update/delete/identical)来通过Switch/Case组件分别处理插入/更新/删除和无变化四种情况。处理完成后,记得startrow要加一,这样做会显著提升迁移性能。 表输入最好选中忽略插入错误选项并且设置自动产生的关键字字段名称,并且在下一步骤用Switch/Case判断下这个自动产生的关键字字段的内容是否是null,不这样做,当插入出错时(不会在表输出步骤报错),错误会在表输出的下一步骤报错。 全量和增量迁移 全量迁移和增量迁移做到一起可以通过合并记录+Switch/Case来判断flagfied的值分别实现对应的插入/更新/删除/无变化四种类型的数据处理。千万不要将全量迁移和增量迁移分开,维护工作量太大了 映射功能 映射功能可以提升整个模型的复用度,映射中的输入就是外部查询的业务数据(不同的业务数据sql不同,但对于初始化的维度数据必须一致),这样可以实现业务转换和通用转换的分离,极大的降低整个模型的复杂度和维护难度。 每个维度表要使用一个独立的转换(内部实现新增/修改/删除等功能),在事实表中调用维度表转换(每个维度字段都要对应一个转换)在业务模型查询出本页里面需要处理的维度数据集,然后传入映射(子转换)并交由子转换(输入规范组件)做处理,每个子转换处理一个维度表,处理完的结果在子转换中通过映射输出规范组件输出到父模型里,然后父模型可以继续往下处理。 映射调试:首先输入数据用文本输出组件输出成A.txt,然后在映射中同时添加映射输入规范和文件输入(使用A.txt)通过点击连接禁用和启用输入规范和文件输入实现调试映射和在父转换中调试映射。 映射可以提升模型的复用度,比如类似日期处理,地区处理,用户处理这些一般都要抽取成可复用的模型,通过映射嵌入到别的模型里去,这样模型的层次比较清晰和简洁,而且不显得那么乱 映射时的变量我推荐勾选默认的“从父转换集成所有变量”,而不要每个转换里都定义,当子转换和父转换中的变量同名时很容易出现稀奇古怪的问题 映射偶尔会出现不返回数据的情况(重复执行可能又正常了,估计是kettle的bug),经过测试,在传参的上一步加一个文件输出会有改善(连接使用复制就可以) 模型调试 完整模型是由一个job,多个转换组成(转换也分成了业务转换和共用转换),执行迁移的时候通过job来执行(不要直接执行转换),从逻辑上只要关注全局变量的内容和转换的结果就可以了。这样对于调试来说效率较高。 整个完整的转换中,全局变量是统一的,主要包含startdate,enddate,pagesize,所有转换和job都使用这三个命名参数,在通过kitchen.sh执行时要通过-param传入这三个变量 某个共用转换需要另一个转换中的数据的时候,可以使用文件保存输出数据,然后在共用转换中用文件输入替代映射输入规范的输入参数 合并记录时的几个注意事项。 貌似kettle是用数据字段匹配的,关键字段必须可以唯一确定一条数据(类似联合唯一索引的作用,但不要选事实表主键),如果关键字段是空,那么合并的结果可能多条会合并成一条。数据字段是标识新旧数据需要比对哪些字段(也就是通过哪些字段来的到new/update/delete/identical的评判结论)。 合并记录时数据字段的多少并不影响合并后的结果。 合并记录最大的作用是对比两个数据流的数据变化,自动识别出需要插入/更新/删除和无变化的数据行,再配合Switch/Case组件分别实现insert、update和delete。 注意在合并记录中不能有更新时间,否则会出现很奇怪的结果 合并记录时需要注意一个是新旧数据源的排序必须相同,第二就是关键字和数据字段的选择,这两点做到了结果就是对的。 合并记录后某些记录的flagfield总是不正确(已经存在的数据flagfield是new,造成插入时唯一索引冲突),这说明前面步骤的排序方式不对 合并记录如果出现相同的两条数据flagfield一个是new另一个是deleted,那说明关键字定义的几个字段有差异 合并记录后处理更新和删除时条件部分选择合并记录的关键字保持一致 表输出的处理 表输出有个[返回一个自动产生的关键字]在insert后,可以将主键值自动获取到并填入到一个新字段,在后续的步骤可以通过给字段赋值来回写到主键字段,再通过字段选择移除这个临时生成的新字段,可以减少一次查询表的过程。 表输出时有个选项是忽略插入错误,这个一定要打开,但要有区分,一般唯一索引异常是要忽略掉的,但其余不能忽略,这个问题可以通过添加自定义错误来解决。 合并之前一定要用选择字段对新旧数据流里面的字段做一致化处理(元数据名字,类型,长度,精度,Binary to Normal)甚至字段的数量和顺序都要严格匹配 合并之前字段一定要排序,并且排序规则完全一致 合并记录后,flagfield=identical的记录主键会是0,这时候需要把老数据重新连接到合并之后的数据流就可以了(注意排序和字段名字) 异常处理 表输出异常,表输出是支持异常的,组件上右键菜单里选“定义错误处理”,可以设置错误列名,字段名,描述等信息,在后续步骤中可以使用过滤记录来做甄别,比如主键冲突错误要Contains Duplicate entry就忽略掉异常,其余的错误就停止,这样可以提高容错性。 排序 很多组件都要实现对数据排序,比如分组、合并记录、连接数据集等,如果不排序会出现一些稀奇古怪的问题 有条件一定用sql排序,只有中间步骤没法使用sql排序的情况下才使用kettle自带的排序。 异常和报错 you're mixing rows with different storage types. Field [VISIT_NO String(13)<binary-string>] does not have the same storage type as field [VISIT_NO String(13)] 有两种办法,一种是两处数据流在查询的时候,字段类型不一致,可以在sql里做下cast转换解决。 另外一种是通过字段选择,在元数据页添加一致的类型(长度,格式,最重要的是Binary to Normal改成true) java.lang.NullPointerException: 这种一般是有合并记录步骤,需要两个输入步骤,但其中有的输入步骤不存在,就会报这个错 字段选择提示字段不存在,但字段明明存在: 因为在选择和修改页把字段修改了名字,在元数据页填修改后的新名字就不报错了 优化前后效果对比 优化前 里面有大量的每行查询一次的功能,一次迁移最多2000条,多了就内存溢出 全量迁移一次要2天 全量和增量迁移是分开的,修改起来很罗嗦 没有使用变量,limit限制条件都是写死的,每次执行都要先调整模型的limit参数 没有使用子转换,模型间没有复用,模型都是复制来复制去,很容易出错 缺少异常处理 优化后 增加命名参数,迁移的时候非常灵活 改用分页机制,每页数据量可以通过参数传递 将全量模型和增量模型整合在一起,通过时间参数来控制 将用户,时间,地区等复用度高的模型写成了子转换,通过映射的方式提高模型复用度,极大的简化了模型。 有异常处理,同时对插入数据做了容错(索引冲突不报错,认为是成功) 增加了完善的数据调试机制 优化后每次迁移可以5000~10000条(通过参数设置,如果中间出错还可以从上次断开的地方继续迁移),自动全量迁移,相同的数据量迁移一次只要1小时就搞定。

优秀的个人博客,低调大师

机器学习笔记——哑变量处理

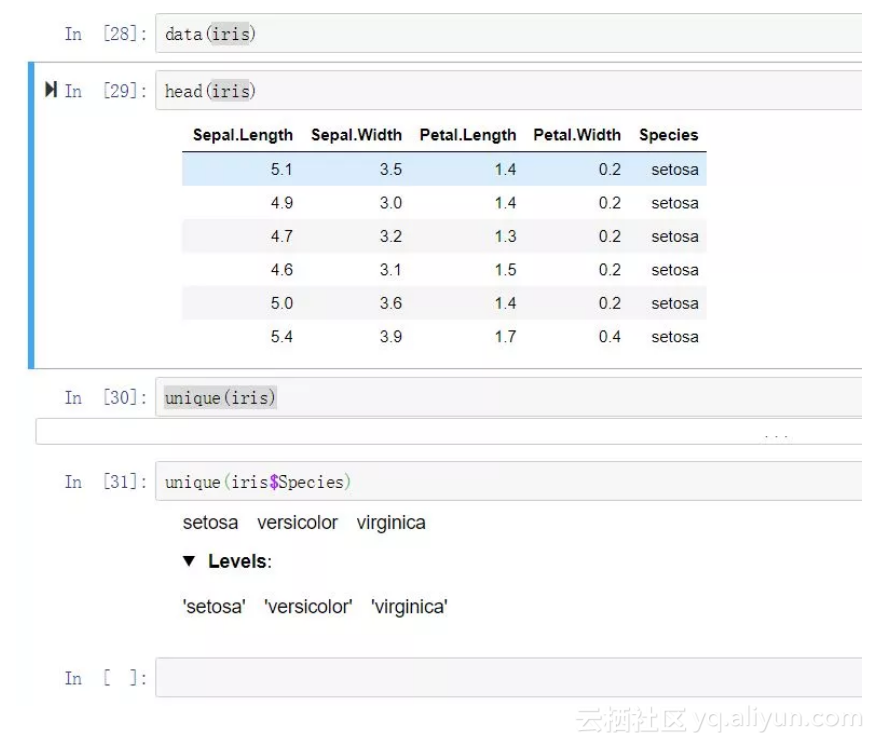
在机器学习的特征处理环节,免不了需要用到类别型特征,这类特征进入模型的方式与一般数值型变量有所不同。 通常根据模型的需要,类别型特征需要进行哑变量处理,即按照特征类别进行编码,一般一个类别为k的特征需要编码为一组k-1【避免引起多重共线性】个衍生哑变量,这样就可以表示特征内部所有的类别(将其中基准比较类设为0,当k-1个哑变量都为0时,即为基准类)。 这种哑变量的编码过程在R和Python中的有成熟的方案,而无需我们手动进行编码,使用成熟的编码方案可以提升特征处理的过程。 R语言哑变量处理: data(iris) 这里仍以iris数据集为例,假设这里的Species变量是要进入模型的其中一个自变量,在建模前需要对齐进行哑变量处理。 方法一——dummy包: library("dummy") dumy <- dummy(x=iris) dummy函数会自动检查你输入数据集对象中的字符型/因子型变量,并全量输出字符型/因子型变量的哑变量编码结果。注意这里编码结果是全量输出,即类别型特征的每一个类别都有一个编码后的特征。为了编码引起多重共线性,我们需要舍弃一个(代表比较基准类的特征),这里Species类别变量一共有三个类别:setosa、versicolor 、virginica,各自都有一个对应编码变量,当原始类别变量取对应类别时,则对应类别哑变量位置取值为1,否则为0. 假设这里我们想要对比的基准类是setosa,只需要保留versicolor、virginica对应的编码后变量。那么当versicolor、virginica都取值为0时,则代表取值为setosa。 最终我们要将保留的哑变量与原始数据集合并,以备之后其他特征处理环节需要。 iris_data <- cbind(iris,dumy[,-1]) 此时就可以完美的用Species_versicolor、Species_virginica这两个新生成的哑变量来代表原始分类变量Species了。 方法二——model.matrix函数: R语言内置包stat中有一个model.matrix函数(无需单独加载既可用),它可以处理分类变量的哑变量处理过程,语法非常简单。 dumy <- model.matrix( ~ Species -1, data = iris) iris_data <- cbind(iris,dumy[,-1]) 这里需要在表达式中设定消除截距【公式中减一,否则输出的哑变量带有截距项】,选择的时候同上,只取比较基准类之外的所有哑变量。 方法三——caret包中的dummyVars函数: library("caret") dumy <- dummyVars(~gender,data=customers) trfs <- predict(dumy,newdata=customers) iris_data <- iris %>% dummyVars(~Species,.) %>% predict(iris) %>% .[,-1] %>% cbind(iris,.) 选择规则同上。 Python中的哑变量处理工具: from sklearn.preprocessing import Imputer,LabelEncoder,OneHotEncoder from sklearn import preprocessing from sklearn.model_selection import train_test_split from sklearn.datasets import load_iris import pandas as pd import numpy as np 方案一——:sk-learn中的OneHotEncoder方法: iris = load_iris() data = iris['data'] iris_data = pd.DataFrame( data = data, columns = ['sepal_length','sepal_width','petal_length','petal_width'] ) iris_data["Species"] = iris[ 'target'] iris_data["Species"] = iris_data["Species"].map({0:"setosa",1:"versicolor",2:"virginica"}) labelencoder_X = LabelEncoder() iris_data["Species_code"] = labelencoder_X.fit_transform(iris_data.iloc[:,4]) onehotencoder = OneHotEncoder(categorical_features = [0]) X = onehotencoder.fit_transform(iris_data[["Species_code"]]).toarray() iris_data = pd.DataFrame( data = np.hstack((iris_data.values,X[:,0:2])), columns = iris_data.columns.tolist() + ['Species_versicolor','Species_virginica'] ) 方案二——pandas中的get_dummies方法: 可以看到sk-learn中的OneHotEncoder方法必须保证处理的输入值是array,而且只能处理数值型(也就是数字编码之后的类别变量),无法直接处理仔字符型变量。 其实如果能够直接在数据框中处理完这一切就方便很多。 dummy = pd.get_dummies(iris_data.iloc[:,4],prefix = "Species") iris_data = pd.concat([iris_data,dummy.iloc[:,0:2]], axis= 1) pandas中的get_dummies方法提供了非常简单高效的哑变量处理方案,只有短短的一句代码即可。 回顾一下今天分享的哑变量处理知识点: R语言: ●方案一——:dummy包的dummy函数 ●方法二——:model.matrix函数 ●方法三——:caret包中的dummyVars函数 Python: ●方法一——:caret包中的dummyVars函数 ●方案二——:pandas中的get_dummies方法 原文发布时间为:2018-10-1 本文作者:杜雨 本文来自云栖社区合作伙伴“ 数据小魔方”,了解相关信息可以关注“ 数据小魔方”。

优秀的个人博客,低调大师

js的基础知识笔记

目录 一、基本数据类型 二、函数 三、面向对象 一、基本数据类型 1、使用var声明变量、使用;结尾、使用{}表示代码块、使用驼峰式命名 2、变量是弱类型的,即并不严格要求声明变量的类型,一个变量可以在运行期间动态的指向不同类型的数据 3、变量声明后可以不定义(或叫赋值、初始化),此时它的值是undefined 4、符号$可以作为命名开头的特殊字母,jQuery使用它作为jquery函数的别名 5、数据分为两大类:原始数据和引用数据,所以一个变量中保存的值自然也有两类 原始数据:直接存放在栈中, 变量中保存着此数据的直接值 引用数据:存放在堆中,并把内存地址存放在栈中,即变量中存放着此对象的指针 6、原始类型:undefined、boolean、number、string、null 7、引用类型:即对象object,其他array、function等对象都是在object基础上进一步封装的对象 二、函数 1、函数也是一个对象,构造函数在功能上还类似于一个类 2、函数如果没有显式说明返回值,则默认return undefined 3、函数对输入参数的要求并不严格(数量、类型),可以使用arguments来获得一个函数的输入参数数组 4、函数也是一个对象意味着,函数可以被当做输入参数、也可以被return,这就意味着可以实现闭包 5、函数的toString()方法可以得到函数的源代码 6、闭包,保存了函数定义时上下文的执行环境,当函数执行时,可以获取到这些数据 闭包的支持意味着可以完成装饰器模式 7、函数声明和函数表达式在某些环境下有非常大的区别 函数声明: function show(){} 函数表达式: var show = function(){} 函数声明有很高的优先级,会被解释器提前解析并释放到执行环境中() console.log(show) // 可以正常的打印出show函数对象 function show(){} 以上两句语句可以正常执行而不报错,全局代码被扫描的时候通过词法分析会在当前函数的AO对象中设定show变量的值为对应函数 而函数表达式等价于一个赋值语句,只有在运行此句代码时才执行,一下语句会报错 console.log(show) var show = function(){} 8、词法分析,一个函数在被真正执行内部代码前,解释器会先扫描函数源代码并执行词法分析,目的是提前完成函数作用域的生成, 函数作用域通过一个AO对象来保存,后续在逐行执行函数代码时,所有的变量查询都通过AO对象,词法分析步骤: a、分析函数输入参数,若函数源代码出现输入参数,则发生此步骤。解释器在AO对象中添加此属性,值为undefined,若有接收实参,则覆盖原有的值 b、分析变量,若函数源代码中出现变量定义,则发生此步骤。解释器寻找AO对象中是否有此属性,若无则增加,值为undefined,若有,什么也不做 c、分析函数声明,若函数源代码中出现函数声明(函数表达式会被定义为步骤b),则发生此步骤。解释器寻找AO对象是否有此属性,若无则增加,若有,则覆盖 换句话说,如果在一个函数func1内部有另一个函数声明func2,此func1函数在真正被执行内部代码前就已经生成了AO对象并且func2函数已经在func1函数的作用域中 三、面向对象 1、js对象类似于Python中的字典,里面存放着无序的键值对 2、对象中的属性(数据属性、函数属性)权限均为公开的(和Python一样),使用_xxx_的方式约定俗成的表示成私有数据(Python中使用__xxx) 3、this指代当前对象,尤其在构造函数中使用时,指代当前被初始化的对象(类似Python的__init__中的self) 4、如何定义一个类(实际是构造函数) a、构造函数定义数据+原型定义函数(我个人比较常用此种方式,代码清晰) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; } Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } b、构造函数定义数据+函数(这种模型也可以用于处理单例模式) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; if(!Stu.__definedFlag){ //实际上此函数被当做单例模式 Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } var Stu.__definedFlag = true; } }

优秀的个人博客,低调大师

AndroidStudio笔记(1)快捷键

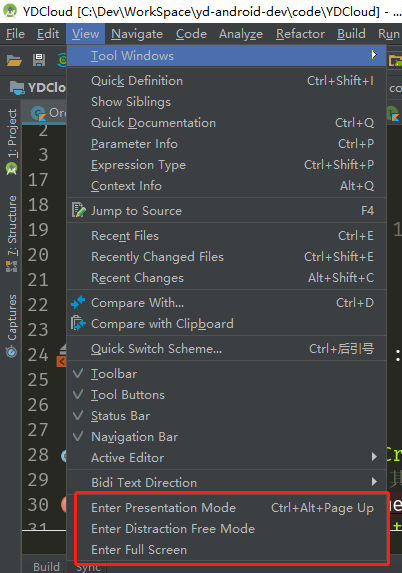
前言 记录一些常用的快捷键键位和小技巧,能够极大的提高开发效率和逼格,最终目的是成为一个 Full Screen Developer,远离鼠标。 正式内容 本套快捷键基于 ==Android Studio 3.1.3==,非常常用和比较有意思的快捷键会单独独立出来讲解,其它的就列一个表格。 全屏模式/勿扰模式 三种模式 Presentation mode 演示模式(全屏专注模式),在这个模式下,只有代码编辑区,什么菜单栏等乱七八糟的东西都没有。来看看效果: Toggle Presentation mode 如何进入该模式? 点击 View - > Toggle Presentation mode 就能进入勿扰模式,在点击一次就能退出。 当然,既然要远离鼠标,我们就可以设置快捷键了,好像在3.1.3之前的版本默认就有个快捷键 ==Ctrl + Alt + PageUp==,那么久直接设置这个快捷键吧。 快捷键1 另外两种模式就不详细讲了,看看截图吧 Distraction Free mode Distraction Free mode Full Screen Full Screen 缺省键 更改==缺省(提示)==键,避免与win10的 ==输入法切换== 冲突 缺省键 定位当前文件 定位当前文件在项目文件夹中的位置。 快捷键 ==Alt + F1==,选择第一个菜单选项 Select In 快速导航到错误代码行 这个快捷键看上去没什么作用,但事实上作用可大了,就好比一个几百行的代码报错了,有可能是因为没写分号,而你又死活找不到错误的位置,那么就可以直接用这个快捷键,它能够让你快速定位到 错误位置 和切换 错误位置。 AS 3.1以下 Alt + E AS 3.1以上 F2 其它常用 键位含义 对应键位 编译并启动 Shift + F10 查看引用 Ctrl +B 编译并调试 Shift + F9 打开菜单栏 Alt + 菜单栏首字母 打开侧边栏 - Project Alt +1 查看注释 Ctrl + Q 查看方法参数提示 Ctrl + P 抽取方法 Ctrl + Alt + M 局部变量变为成员变量 Ctrl + Alt + F 提交仓库 Ctrl + K 打开logcat Alt + 6 打开文件 Ctrl + Shift + N 搜索文件 双击 Shift 当前文件内搜索 Ctrl + F 全局搜索 Ctrl + Shift + F 重命名-文件名、变量名等 Shift +F6 Show Action Ctrl + Shift + A 是 Android Studio中最强大的快捷键,它提供了所有的快捷键搜索方式,可以不用记住键位,只需要要模糊的记得几个单词,比如下面的例子; 抽取样式 抽取样式 创建新的layout 创建新的layout 等等.....很多很多,只要你能熟用 Show Action ,那么平常的开发效率将会大大提升。 最后 未完待续、敬请期待!我的博客地址 FullScreenDeveloper

优秀的个人博客,低调大师

2018-09-02学习笔记

Content Provider 总结: 跨程序共享数据——Content Provider 之 运行时权限解析以及申请的实现(可完美解决java.lang.SecurityException:Permission Denial 问题) 跨程序共享数据——Content Provider 之 ContentResolver基本用法 & 一个读取系统联系人的Demo 跨程序共享数据——Content Provider 之 创建自己的内容提供器 Content Provider 之 最终弹 实战体验跨程序数据共享(结合SQLiteDemo)(即本文) Java回顾: Java基础知识的全面巩固_note1(附各种demo code) Java知识详细巩固_note2(数组 _ 附demo code) 受腾讯云+社区的运营小编陈子龙前辈邀请, 我的博客即将搬运同步至腾讯云+社区,邀请大家一同入驻:https://cloud.tencent.com/developer/support-plan?invite_code=2iitqqr04f408 ——2018.9.3

优秀的个人博客,低调大师

MyBatis学习笔记(二) 关联关系

一、一对一关系 还是通过例子来解释说明。(一个妻子对应一个丈夫)。 1)数据库信息 create table t_wife( id int primary key auto_increment, wife_name varchar(20), fk_husband_id int ); create table t_husband( id int primary key auto_increment, husband_name varchar(20) ); insert into t_husband values (null,'hello'); insert into t_wife values(null,'kitty',1) 2)对应的JavaBean代码 虽然在数据库里只有一方配置的外键,但是这个一对一是双向的关系。 HusbandBean.java package com.cy.mybatis.beans; import java.io.Serializable; /** * one to one * @author acer * */ public class HusbandBean implements Serializable{ private static final long serialVersionUID = 1L; private Integer id; private String name; private WifeBean wife; public HusbandBean() { super(); } public HusbandBean(Integer id, String name, WifeBean wife) { super(); this.id = id; this.name = name; this.wife = wife; } public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } public WifeBean getWife() { return wife; } public void setWife(WifeBean wife) { this.wife = wife; } @Override public String toString() { return "Husband [id=" + id + ", name=" + name + ", wife=" + wife + "]"; } } WifeBean.java package com.cy.mybatis.beans; import java.io.Serializable; /** * one to one * @author acer * */ public class WifeBean implements Serializable{ private static final long serialVersionUID = 1L; private Integer id; private String name; private HusbandBean husband; public WifeBean() { super(); } public WifeBean(Integer id, String name, HusbandBean husband) { super(); this.id = id; this.name = name; this.husband = husband; } public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } public HusbandBean getHusband() { return husband; } public void setHusband(HusbandBean husband) { this.husband = husband; } @Override public String toString() { return "Wife [id=" + id + ", name=" + name + ", husband=" + husband + "]"; } } 3)接下来建立两个接口,HusbandMapper,WifeMapper. HusbandMapper package com.cy.mybatis.mapper; import com.cy.mybatis.beans.HusbandBean; public interface HusbandMapper { /** * 根据id查询丈夫信息 * @param id * @return * @throws Exception */ public HusbandBean selectHusbandById (int id) throws Exception; /** * 根据id查询丈夫与妻子信息 * @param id * @return * @throws Exception */ public HusbandBean selectHusbandAndWife(int id) throws Exception; } 4)定义HusbandMapper.xml文件 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.cy.mybatis.mapper.HusbandMapper"> <resultMap type="HusbandBean" id="husbandAndWife"> <id property="id" column="id" javaType="java.lang.Integer"/> <result property="name" column="name" javaType="java.lang.String"/> <!-- association – 一个复杂的类型关联;许多结果将包成这种类型 嵌入结果映射 – 结果映射自身的关联,或者参考一个 column="id" 这里的id指的是在t_wife表来的主键id 这个查询妻子,所以在妻子mapper里有个方法 --> <association property="wife" column="id" javaType="WifeBean" select="com.cy.mybatis.mapper.WifeMapper.selectWifeByHusbandId" ></association> </resultMap> <!-- resultType 返回类型 从这条语句中返回的期望类型的类的完全限定名或别名 。--> <select id="selectHusbandById" resultType="HusbandBean"> select * from t_husband where id=#{id} </select> <!-- resultMap 命名引用外部的 resultMap。返回的是一个集合。--> <select id="selectHusbandAndWife" resultMap="husbandAndWife"> select * from t_husband where id=#{id} </select> </mapper> 在WifeMapper.xml里有个方法 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.cy.mybatis.mapper.WifeMapper"> <select id="selectWifeByHusbandId" resultType="WifeBean"> select * from t_wife where fk_husband_id = #{id} </select> </mapper> 5)写个实现 package com.cy.mybatis.service; import org.apache.ibatis.session.SqlSession; import com.cy.mybatis.beans.HusbandBean; import com.cy.mybatis.mapper.HusbandMapper; import com.cy.mybatis.tools.DBTools; public class OneToOneService { public static void main(String[] args) { selectHusbandAndWife(); } private static void selectHusbandAndWife() { SqlSession session = DBTools.getSession(); HusbandMapper hm = session.getMapper(HusbandMapper.class); try { HusbandBean husband = hm.selectHusbandAndWife(1); System.out.println(husband); session.commit(); } catch (Exception e) { e.printStackTrace(); } } } 注意:那个工具类还是前一章那样写的,就相当与在昨天的基础上建立的。 注意: mybatis实际是对XML进行操作,我们所有的方法都直接定义在XML中,写个接口只是为了更好的符合我们3层的思想,如果不写接口,直接通过session也可以直接操作xml中的方法 , XML中只要有方法,就可以使用,而调用的方式就是:namespace+方法名; 例外使用resultType时,一定要保证,你属性名与字段名相同; 如果不相同,就使用resultMap 。 二、一对多关系 还是通过例子来解释说明。(一把锁对应多把钥匙)。 2.1)数据库信息 这里没有添加数据了,我们用批量添加数据 create table t_key( id int primary key auto_increment, key_name varchar(20), fk_lock_id int ); create table t_lock( id int primary key auto_increment, lock_name varchar(20) ); 2.2) 实体类 KeyBean.java package com.cy.mybatis.beans; import java.io.Serializable; /** * manyTOone * * */ public class KeyBean implements Serializable { private static final long serialVersionUID = 3712545874604618746L; private Integer id; private String key; private LockBean lock; public KeyBean() { super(); } public KeyBean(Integer id, String key, LockBean lock) { super(); this.id = id; this.key = key; this.lock = lock; } public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getKey() { return key; } public void setKey(String key) { this.key = key; } public LockBean getLock() { return lock; } public void setLock(LockBean lock) { this.lock = lock; } @Override public String toString() { return "KeyBean [id=" + id + ", key=" + key + ", lock=" + lock + "]"; } } LockBean.java package com.cy.mybatis.beans; import java.io.Serializable; import java.util.List; /** * oneTOmany * * */ public class LockBean implements Serializable{ private static final long serialVersionUID = 7092410462131162665L; private Integer id; private String lock; private List<KeyBean> keys; public LockBean() { super(); } public LockBean(Integer id, String lock, List<KeyBean> keys) { super(); this.id = id; this.lock = lock; this.keys = keys; } public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getLock() { return lock; } public void setLock(String lock) { this.lock = lock; } public List<KeyBean> getKeys() { return keys; } public void setKeys(List<KeyBean> keys) { this.keys = keys; } @Override public String toString() { return "LockBean [id=" + id + ", keys=" + keys + ", lock=" + lock + "]"; } } 2.3) 建立接口 KeyMapper.java package com.cy.mybatis.mapper; import java.util.List; import org.apache.ibatis.annotations.Param; import com.cy.mybatis.beans.KeyBean; public interface KeyMapper { /** * 批量添加钥匙 * @return * 提倡 这样使用 @Param("keys") */ public int batchSaveKeys(@Param("keys")List<KeyBean> keys); } LockMapper.java package com.cy.mybatis.mapper; import org.apache.ibatis.annotations.Param; import com.cy.mybatis.beans.LockBean; public interface LockMapper { /** * 添加锁 * @param lock * @return */ public int saveLock(@Param("lock")LockBean lock); /** * 根据ID查询锁的资料 * @param id * @return */ public LockBean findLockById(int id); /** * 根据ID查询锁与钥匙的资料 * one2many * @param id * @return */ public LockBean findLockAndKeys(int id); } 2.4) 建立xml文件 KeyMapper.xml <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.cy.mybatis.mapper.KeyMapper"> <resultMap id="keyMap" type="KeyBean"> <id property="id" column="id" javaType="java.lang.Integer"/> <result property="key" column="key_name" javaType="java.lang.String"/> </resultMap> <!--collection 为用于遍历的元素(必选),支持数组、List、Set --> <!-- item 表示集合中每一个元素进行迭代时的别名. --> <!--separator表示在每次进行迭代之间以什么符号作为分隔 符. --> <insert id="batchSaveKeys"> insert into t_key values <foreach collection="keys" item="key" separator=","> (null,#{key.key},#{key.lock.id}) </foreach> </insert> <select id="findKeysByLockId" resultMap="keyMap"> select * from t_key where fk_lock_id = #{id} </select> </mapper> LockMapper.xml <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org/DTD Mapper 3.0" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.cy.mybatis.mapper.LockMapper"> <!--自定义返回类型 --> <resultMap id="lockMap" type="LockBean"> <id property="id" column="id" javaType="java.lang.Integer"/> <result property="lock" column="lock_name" javaType="java.lang.String"/> </resultMap> <!--自定义返回类型 --> <resultMap id="lockAndKeysMap" type="LockBean"> <id property="id" column="id" javaType="java.lang.Integer"/> <result property="lock" column="lock_name" javaType="java.lang.String"/> <collection property="keys" column="id" select="com.cy.mybatis.mapper.KeyMapper.findKeysByLockId"></collection> </resultMap> <insert id="saveLock"> insert into t_lock values (null,#{lock.lock}) </insert> <select id="findLockById" resultMap="lockMap"> select * from t_lock where id= #{id} </select> <select id="findLockAndKeys" resultMap="lockAndKeysMap"> select * from t_lock where id= #{id} </select> </mapper> 2.5 ) 实现 package com.cy.mybatis.service; import java.util.ArrayList; import java.util.List; import org.apache.ibatis.session.SqlSession; import com.cy.mybatis.beans.KeyBean; import com.cy.mybatis.beans.LockBean; import com.cy.mybatis.mapper.KeyMapper; import com.cy.mybatis.mapper.LockMapper; import com.cy.mybatis.tools.DBTools; public class OneToManyService { public static void main(String[] args) { // saveLock(); // batchSaveKeys(); findLockAndKeys(); } private static void findLockAndKeys() { SqlSession session = DBTools.getSession(); LockMapper lm = session.getMapper(LockMapper.class); LockBean lock = lm.findLockAndKeys(1); System.out.println(lock); } private static void batchSaveKeys() { SqlSession session = DBTools.getSession(); LockMapper lm = session.getMapper(LockMapper.class); KeyMapper km = session.getMapper(KeyMapper.class); LockBean lock = lm.findLockById(1); List<KeyBean> keys = new ArrayList<KeyBean>(); for(int i = 0; i < 5; i++){ KeyBean key = new KeyBean(null, "钥匙"+i, lock); keys.add(key); } km.batchSaveKeys(keys); session.commit(); } private static void saveLock() { SqlSession session = DBTools.getSession(); LockMapper lm = session.getMapper(LockMapper.class); LockBean lock = new LockBean(null, "锁1", null); lm.saveLock(lock); session.commit(); } } 结果显示: 原文发布时间为:2018-08-30本文来自云栖社区合作伙伴“ 全栈开发者社区”,了解相关信息可以关注“ 全栈开发者社区”。

优秀的个人博客,低调大师

ElasticSearch学习笔记之原理介绍

ElasticSearch是一个基于Lucene的搜索服务器。它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口。Elasticsearch是用Java开发的,并作为Apache许可条款下的开放源码发布,是当前流行的企业级搜索引擎。设计用于云计算中,能够达到实时搜索,稳定,可靠,快速,安装使用方便。 揭面: 架构图: 架构各模块介绍: Lucence Directory:是lucene的框架服务发现以及选主 ZenDiscovery: 用来实现节点自动发现,还有Master节点选取,假如Master出现故障,其它的这个节点会自动选举,产生一个新的Master; Plugins:插件可以通过自定的方式扩展加强Elasticsearch的基本功能,比如可以自定义类型映射,分词器,本地脚本,自动发现等; Scripting:使用脚本语言可以计算自定义表达式的值,比如计算自定义查询相关度评分。支持的脚本语言有groovy,js,mvel(1.3.0废弃),python等; Disovery:该模块主要负责集群中节点的自动发现和Master节点的选举。节点之间使用p2p的方式进行直接通信,不存在单点故障的问题。Elasticsearch中,Master节点维护集群的全局状态,比如节点加入和离开时进行shard的重新分配; River:代表es的一个数据源,也是其它存储方式(如:数据库)同步数据到es的一个方法。它是以插件方式存在的一个es服务,通过读取river中的数据并把它索引到es中; Gateway:模块用于存储es集群的元数据信息; Zen Discovery:zen发现机制是elasticsearch默认的内建模块。它提供了多播和单播两种发现方式,能够很容易的扩展至云环境。zen发现机制是和其他模块集成的,例如所有节点间通讯必须用trasport模块来完成。 核心概念: 集群(Cluster):ES集群是一个或多个节点的集合,它们共同存储了整个数据集,并提供了联合索引以及可跨所有节点的搜索能力。多节点组成的集群拥有冗余能力,它可以在一个或几个节点出现故障时保证服务的整体可用性。 集群靠其独有的名称进行标识,默认名称为“elasticsearch”。节点靠其集群名称来决定加入哪个ES集群,一个节点只能属一个集群; 节点(node):一个节点是一个逻辑上独立的服务,可以存储数据,并参与集群的索引和搜索功能, 一个节点也有唯一的名字,群集通过节点名称进行管理和通信; 主节点:主节点的主要职责是和集群操作相关的内容,如创建或删除索引,跟踪哪些节点是群集的一部分,并决定哪些分片分配给相关的节点。稳定的主节点对集群的健康是非常重要的。虽然主节点也可以协调节点,路由搜索和从客户端新增数据到数据节点,但最好不要使用这些专用的主节点。一个重要的原则是,尽可能做尽量少的工作。 对于大型的生产集群来说,推荐使用一个专门的主节点来控制集群,该节点将不处理任何用户请求。 数据节点:持有数据和倒排索引。 客户端节点:它既不能保持数据也不能成为主节点,该节点可以响应用户的情况,把相关操作发送到其他节点;客户端节点会将客户端请求路由到集群中合适的分片上。对于读请求来说,协调节点每次会选择不同的分片处理请求,以实现负载均衡。 部落节点:部落节点可以跨越多个集群,它可以接收每个集群的状态,然后合并成一个全局集群的状态,它可以读写所有节点上的数据。 索引(Index): ES将数据存储于一个或多个索引中,索引是具有类似特性的文档的集合。类比传统的关系型数据库领域来说,索引相当于SQL中的一个数据库,或者一个数据存储方案(schema)。索引由其名称(必须为全小写字符)进行标识,并通过引用此名称完成文档的创建、搜索、更新及删除操作。一个ES集群中可以按需创建任意数目的索引。 文档类型(Type):类型是索引内部的逻辑分区(category/partition),然而其意义完全取决于用户需求。因此,一个索引内部可定义一个或多个类型(type)。一般来说,类型就是为那些拥有相同的域的文档做的预定义。例如,在索引中,可以定义一个用于存储用户数据的类型,一个存储日志数据的类型,以及一个存储评论数据的类型。类比传统的关系型数据库领域来说,类型相当于“表”。 文档(Document) :文档是Lucene索引和搜索的原子单位,它是包含了一个或多个域的容器,基于JSON格式进行表示。文档由一个或多个域组成,每个域拥有一个名字及一个或多个值,有多个值的域通常称为“多值域”。每个文档可以存储不同的域集,但同一类型下的文档至应该有某种程度上的相似之处。相当于数据库的“记录” Mapping: 相当于数据库中的schema,用来约束字段的类型,不过 Elasticsearch 的 mapping 可以自动根据数据创建。 ES中,所有的文档在存储之前都要首先进行分析。用户可根据需要定义如何将文本分割成token、哪些token应该被过滤掉,以及哪些文本需要进行额外处理等等。 分片(shard) :ES的“分片(shard)”机制可将一个索引内部的数据分布地存储于多个节点,它通过将一个索引切分为多个底层物理的Lucene索引完成索引数据的分割存储功能,这每一个物理的Lucene索引称为一个分片(shard)。 每个分片其内部都是一个全功能且独立的索引,因此可由集群中的任何主机存储。创建索引时,用户可指定其分片的数量,默认数量为5个。 Shard有两种类型:primary和replica,即主shard及副本shard。 Primary shard用于文档存储,每个新的索引会自动创建5个Primary shard,当然此数量可在索引创建之前通过配置自行定义,不过,一旦创建完成,其Primary shard的数量将不可更改。 Replica shard是Primary Shard的副本,用于冗余数据及提高搜索性能。 每个Primary shard默认配置了一个Replica shard,但也可以配置多个,且其数量可动态更改。ES会根据需要自动增加或减少这些Replica shard的数量。 ES集群可由多个节点组成,各Shard分布式地存储于这些节点上。 ES可自动在节点间按需要移动shard,例如增加节点或节点故障时。简而言之,分片实现了集群的分布式存储,而副本实现了其分布式处理及冗余功能。 创建索引: 过程:当分片所在的节点接收到来自协调节点的请求后,会将该请求写入translog,并将文档加入内存缓存。如果请求在主分片上成功处理,该请求会并行发送到该分片的副本上。当translog被同步到全部的主分片及其副本上后,客户端才会收到确认通知。 内存缓冲会被周期性刷新(默认是1秒),内容将被写到文件系统缓存的一个新段(segment)上。虽然这个段并没有被同步(fsync),但它是开放的,内容可以被搜索到。 每30分钟,或者当translog很大的时候,translog会被清空,文件系统缓存会被同步。这个过程在Elasticsearch中称为冲洗(flush)。在冲洗过程中,内存中的缓冲将被清除,内容被写入一个新段。段的fsync将创建一个新的提交点,并将内容刷新到磁盘。旧的translog将被删除并开始一个新的translog。 ES如何做到实时检索? 由于在buffer中的索引片先同步到文件系统缓存,再刷写到磁盘,因此在检索时可以直接检索文件系统缓存,保证了实时性。 这一步刷到文件系统缓存的步骤,在 Elasticsearch 中,是默认设置为 1 秒间隔的,对于大多数应用来说,几乎就相当于是实时可搜索了。 不过对于 ELK 的日志场景来说,并不需要如此高的实时性,而是需要更快的写入性能。我们可以通过 /_settings接口或者定制 template 的方式,加大 refresh_interval 参数。 当segment从文件系统缓存同步到磁盘时发生了错误怎么办? 数据会不会丢失? 由于Elasticsearch 在把数据写入到内存 buffer 的同时,其实还另外记录了一个 translog日志,如果在这期间故障发生时,Elasticsearch会从commit位置开始,恢复整个translog文件中的记录,保证数据的一致性。 等到真正把 segment 刷到磁盘,且 commit 文件进行更新的时候, translog 文件才清空。这一步,叫做flush。同样,Elasticsearch 也提供了 /_flush 接口。 索引数据的一致性通过 translog 保证,那么 translog 文件自己呢? Elasticsearch 2.0 以后为了保证不丢失数据,每次 index、bulk、delete、update 完成的时候,一定触发刷新translog 到磁盘上,才给请求返回 200 OK。这个改变在提高数据安全性的同时当然也降低了一点性能 检索文档: 搜索相关性 相关性是由搜索结果中Elasticsearch打给每个文档的得分决定的。默认使用的排序算法是tf/idf(词频/逆文档频率)。词频衡量了一个词项在文档中出现的次数 (频率越高 == 相关性越高),逆文档频率衡量了词项在全部索引中出现的频率,是一个索引中文档总数的百分比(频率越高 == 相关性越低)。最后的得分是tf-idf得分与其他因子比如(短语查询中的)词项接近度、(模糊查询中的)词项相似度等的组合 更新删除索引: 删除和更新也都是写操作。但是Elasticsearch中的文档是不可变的,因此不能被删除或者改动以展示其变更。那么,该如何删除和更新文档呢? 磁盘上的每个段都有一个相应的.del文件。当删除请求发送后,文档并没有真的被删除,而是在.del文件中被标记为删除。该文档依然能匹配查询,但是会在结果中被过滤掉。当段合并(我们将在本系列接下来的文章中讲到)时,在.del文件中被标记为删除的文档将不会被写入新段。 接下来我们看更新是如何工作的。在新的文档被创建时,Elasticsearch会为该文档指定一个版本号。当执行更新时,旧版本的文档在.del文件中被标记为删除,新版本的文档被索引到一个新段。旧版本的文档依然能匹配查询,但是会在结果中被过滤掉。 物理删除索引:当索引数据不断增长时,对应的segment也会不断的增多,查询性能可能就会下降。因此,Elasticsearch会触发segment合并的线程,把很多小的segment合并成更大的segment,然后删除小的segment,当这些标记为删除的segment不会被复制到新的索引段中。 Elasticseach查询: Elasticseach查询分为两种,结构化查询和全文查询; 尽管统一称之为query DSL,事实上Elasticsearch中存在两种DSL:查询DSL(query DSL)和过滤DSL(filter DSL)。 查询子句和过滤子句的自然属性非常相近,但在使用目的上略有区别。 简单来讲,当执行full-text查询或查询结果依赖于相关度分值时应该使用查询DSL,当执行精确值(extac-value)查询或查询结果仅有“yes”或“no”两种结果时应该使用过滤DSL。 Filter DSL计算及过滤速度较快,且适于缓存,因此可有效提升后续查询请求的执行速度。而query DSL不仅要查找匹配的文档,还需要计算每个文件的相关度分值,因此为更重量级的查询,其查询结果不会被缓存。 不过,得益于倒排索引,一个仅返回少量文档的简单query或许比一个跨数百万文档的filter执行起来并得显得更慢。 Elasticsearch支持许多的query和filter,但最常用的也不过几种。 Filter DSL中常见的有term Filter、terms Filter、range Filter、exists and missing Filters和bool Filter。 而Query DSL中常见的有match_all、match 、multi_match及bool Query。鉴于时间关系,这里不再细述,朋友们可参考官方文档学习。 Queries用于查询上下文,而filters用于过滤上下文,不过,Elasticsearch的API也支持此二者合并运行。 组合查询可用于合并查询子句,组合过滤用于合并过滤子句,然而,Elasticsearch的使用习惯中,也常会把filter用于query上进行过滤。不过,很少有机会需要把query用于filter上的。 结构化搜索:是指查询包含内部结构的数据。日期,时间,和数字都是结构化的:它们有明确的格式给你执行逻辑操作。一般包括比较数字或日期的范围,或确定两个值哪个大。 文本也可以被结构化。一包蜡笔有不同的颜色:红色,绿色,蓝色。一篇博客可能被打上 分布式 和 搜索的标签。电子商务产品有商品统一代码(UPCs) 或其他有着严格格式的标识。 通过结构化搜索,你的查询结果始终是 是或非;是否应该属于集合。结构化搜索不关心文档的相关性或分数,它只是简单的包含或排除文档。 这必须是有意义的逻辑,一个数字不能比同一个范围中的其他数字更多。它只能包含在一个范围中,或不在其中。类似的,对于结构化文本,一个值必须相等或不等。这里没有 更匹配 的概念。 所谓的全文搜索查询通常是指在给定的文本域内部搜索指定的关键字,但搜索操作该需要真正理解查询者的目的,例如: (1) 搜索“UK”应该返回包含“United Kingdom”的相关文档; (2) 搜索“jump”应该返回包含“JUMP”、“jumped”、“jumps”、“jumping”甚至是“leap”的文档; 为了完成此类全文搜域的搜索,ES必须首先分析文本并将其构建成为倒排索引(inverted index),倒排索引由各文档中出现的单词列表组成,列表中的各单词不能重复且需要指向其所在的各文档。 因此,为了创建倒排索引,需要先将各文档中域的值切分为独立的单词(也称为term或token),而后将之创建为一个无重复的有序单词列表。这个过程称之为“分词(tokenization)”。 其次,为了完成此类full-text域的搜索,倒排索引中的数据还需进行“正规化(normalization)”为标准格式,才能评估其与用户搜索请求字符串的相似度。 这里的“分词”及“正规化”操作也称为“分析(analysis)”。 Analysis过程由两个步骤的操作组成:首先将文本切分为terms(词项)以适合构建倒排索引,其次将各terms正规化为标准形式以提升其“可搜索度”。这两个步骤由分析器(analyzers)完成。 一个分析器通常需要由三个组件构成:字符过滤器(Character filters)、分词器(Tokenizer)和分词过滤器(Token filters)组成。 字符过滤器:在文本被切割之前进行清理操作,例如移除HTML标签,将&替换为字符等; 分词器:将文本切分为独立的词项;简单的分词器通常是根据空白及标点符号进行切分; 分词过滤器:转换字符(如将大写转为小写)、移除词项(如移除a、an、of及the等)或者添加词项(例如,添加同义词); Elasticsearch内置了许多字符过滤器、分词器和分词过滤器,用户可按需将它们组合成“自定义”的分析器。 与SOLR比对: 三种使用方式: 使用案例: 1)维基百科,类似百度百科,牙膏,牙膏的维基百科,全文检索,高亮,搜索推荐; 2)The Guardian(国外新闻网站),类似搜狐新闻,用户行为日志(点击,浏览,收藏,评论)+社交网络数据(对某某新闻的相关看法),数据分析,给到每篇新闻文章的作者,让他知道他的文章的公众反馈(好,坏,热门,垃圾,鄙视,崇拜); 3)Stack Overflow(国外的程序异常讨论论坛),IT问题,程序的报错,提交上去,有人会跟你讨论和回答,全文检索,搜索相关问题和答案,程序报错了,就会将报错信息粘贴到里面去,搜索有没有对应的答案; 4)GitHub(开源代码管理),搜索上千亿行代码; 5)电商网站,检索商品; 6)日志数据分析,logstash采集日志,ES进行复杂的数据分析(ELK技术,elasticsearch+logstash+kibana); 7)商品价格监控网站,用户设定某商品的价格阈值,当低于该阈值的时候,发送通知消息给用户,比如说订阅牙膏的监控,如果高露洁牙膏的家庭套装低于50块钱,就通知我,我就去买; 8)BI系统,商业智能,Business Intelligence。比如说有个大型商场集团,BI,分析一下某某区域最近3年的用户消费金额的趋势以及用户群体的组成构成,产出相关的数张报表,最近3年,每年消费金额呈现100%的增长,而且用户群体85%是高级白领,开一个新商场。ES执行数据分析和挖掘,Kibana进行数据可视化; 9)国内:站内搜索(电商,招聘,门户,等等),IT系统搜索(OA,CRM,ERP,等等),数据分析(ES热门的一个使用场景) 原文发布时间为:2018-08-22 本文作者:等待九月 本文来自云栖社区合作伙伴“我的小碗汤”,了解相关信息可以关注“我的小碗汤”。

优秀的个人博客,低调大师

Python多线程threading进阶笔记

1.创建threading.Thread对象实现多线程: 创建一个threading.Thread对象,在它的初始化函数(__init__)中将可调用对象作为参数传入 引入threadring来同时播放音乐和视频: #coding=utf-8 import threading from time import ctime,sleep def music(func): for i in range(2): print ("I was listening to %s. %s\n" %(func,ctime())) sleep(1) def move(func): for i in range(2): print ("I was at the %s! %s\n" %(func,ctime())) sleep(5) threads = [] t1 = threading.Thread(target=music,args=(u'爱情买卖',)) threads.append(t1) t2 = threading.Thread(target=move,args=(u'阿凡达',)) threads.append(t2) if __name__ == '__main__': for t in threads: t.setDaemon(True) t.start() print ("all over %s" %ctime()) import threading 首先导入threading 模块,这是使用多线程的前提。 threads = [] t1 = threading.Thread(target=music,args=(u'爱情买卖',)) threads.append(t1) 创建了threads数组,创建线程t1,使用threading.Thread()方法,在这个方法中调用music方法target=music,args方法对music进行传参。 把创建好的线程t1装到threads数组中。 接着以同样的方式创建线程t2,并把t2也装到threads数组。 for t in threads: t.setDaemon(True) t.start() 最后通过for循环遍历数组。(数组被装载了t1和t2两个线程) setDaemon() setDaemon(True)将线程声明为守护线程,必须在start() 方法调用之前设置,如果不设置为守护线程程序会被无限挂起。子线程启动后,父线程也继续执行下去,当父线程执行完最后一条语句print "all over %s" %ctime()后,没有等待子线程,直接就退出了,同时子线程也一同结束。 start() 开始线程活动。 运行结果: >>> ========================= RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 12:51:45 2014 I was at the 阿凡达! Thu Apr 17 12:51:45 2014 all over Thu Apr 17 12:51:45 2014 从执行结果来看,子线程(muisc、move)和主线程(print"allover%s"%ctime())都是同一时间启动,但由于主线程执行完结束,所以导致子线程也终止。 继续调整程序: ... if __name__ == '__main__': for t in threads: t.setDaemon(True) t.start() t.join() print "all over %s" %ctime() 我们只对上面的程序加了个join()方法,用于等待线程终止。join()的作用是,在子线程完成运行之前,这个子线程的父线程将一直被阻塞。 注意: join()方法的位置是在for循环外的,也就是说必须等待for循环里的两个进程都结束后,才去执行主进程。 运行结果: >>> ========================= RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 13:04:11 2014 I was at the 阿凡达! Thu Apr 17 13:04:11 2014 I was listening to 爱情买卖. Thu Apr 17 13:04:12 2014 I was at the 阿凡达! Thu Apr 17 13:04:16 2014 all over Thu Apr 17 13:04:21 2014 从执行结果可看到,music和move是同时启动的。 开始时间4分11秒,直到调用主进程为4分22秒,总耗时为10秒。从单线程时减少了2秒,我们可以把music的sleep()的时间调整为4秒。 ... def music(func): for i in range(2): print "I was listening to %s. %s" %(func,ctime()) sleep(4) ... 执行结果: >>> ====================== RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 13:11:27 2014 I was at the 阿凡达! Thu Apr 17 13:11:27 2014 I was listening to 爱情买卖. Thu Apr 17 13:11:31 2014 I was at the 阿凡达! Thu Apr 17 13:11:32 2014 all over Thu Apr 17 13:11:37 2014 子线程启动11分27秒,主线程运行11分37秒。 虽然music每首歌曲从1秒延长到了4,但通多程线的方式运行脚本,总的时间没变化。 2.继承Thread类实现多线程 下面分别举例说明。先来看看通过继承threading.Thread类来创建线程的例子: #coding=utf-8 import threading, time count = 0 class Counter(threading.Thread): def __init__(self, lock, threadName): ''' @summary: 初始化对象。 @param lock: 琐对象。 @param threadName: 线程名称。 ''' super(Counter, self).__init__(name = threadName) #注意:一定要显式的调用父类的初始化函数。 self.lock = lock def run(self): ''' @summary: 重写父类run方法,在线程启动后执行该方法内的代码。 ''' global count self.lock.acquire() for i in range(10000): count = count + 1 self.lock.release() lock = threading.Lock() for i in range(5): Counter(lock, "thread-" + str(i)).start() time.sleep(2) #确保线程都执行完毕 print (count) 在代码中,我们创建了一个Counter类,它继承了threading.Thread。初始化函数接收两个参数,一个是琐对象,另一个是线程的名称。在Counter中,重写了从父类继承的run方法,run方法将一个全局变量逐一的增加10000。在接下来的代码中,创建了五个Counter对象,分别调用其start方法。最后打印结果。这里要说明一下run方法 和start方法: 它们都是从Thread继承而来的,run()方法将在线程开启后执行,可以把相关的逻辑写到run方法中;start()方法用于启动线程。 3.Thread类 Thread类还定义了以下常用方法与属性: Thread.getName() Thread.setName() Thread.name 用于获取和设置线程的名称。 Thread.ident 获取线程的标识符。线程标识符是一个非零整数,只有在调用了start()方法之后该属性才有效,否则它只返回None。 Thread.is_alive() Thread.isAlive() 判断线程是否是激活的(alive)。从调用start()方法启动线程,到run()方法执行完毕或遇到未处理异常而中断 这段时间内,线程是激活的。 Thread.join([timeout]) 调用Thread.join将会使主调线程堵塞,直到被调用线程运行结束或超时。参数timeout是一个数值类型,表示超时时间,如果未提供该参数,那么主调线程将一直堵塞到被调线程结束。下面举个例子说明join()的使用: import threading, time def doWaiting(): print ('start waiting:', time.strftime('%H:%M:%S')) time.sleep(3) print ('stop waiting', time.strftime('%H:%M:%S')) thread1 = threading.Thread(target = doWaiting) thread1.start() time.sleep(1) #确保线程thread1已经启动 print ('start join') thread1.join() #将一直堵塞,直到thread1运行结束。 print ('end join') threading.RLock和threading.Lock 在threading模块中,定义两种类型的琐:threading.Lock和threading.RLock。它们之间有一点细微的区别,通过比较下面两段代码来说明: import threading lock = threading.Lock() #Lock对象 lock.acquire() lock.acquire() #产生了死琐。 lock.release() lock.release() import threading rLock = threading.RLock() #RLock对象 rLock.acquire() rLock.acquire() #在同一线程内,程序不会堵塞。 rLock.release() rLock.release() 这两种琐的主要区别是:RLock允许在同一线程中被多次acquire。而Lock却不允许这种情况。注意:如果使用RLock,那么acquire和release必须成对出现,即调用了n次acquire,必须调用n次的release才能真正释放所占用的琐。 threading.Condition 可以把Condiftion理解为一把高级的琐,它提供了比Lock, RLock更高级的功能,允许我们能够控制复杂的线程同步问题。threadiong.Condition在内部维护一个琐对象(默认是RLock),可以在创建Condigtion对象的时候把琐对象作为参数传入。Condition也提供了acquire, release方法,其含义与琐的acquire, release方法一致,其实它只是简单的调用内部琐对象的对应的方法而已。Condition还提供了如下方法(特别要注意:这些方法只有在占用琐(acquire)之后才能调用,否则将会报RuntimeError异常。): Condition.wait([timeout]): wait方法释放内部所占用的琐,同时线程被挂起,直至接收到通知被唤醒或超时(如果提供了timeout参数的话)。当线程被唤醒并重新占有琐的时候,程序才会继续执行下去。 Condition.notify(): 唤醒一个挂起的线程(如果存在挂起的线程)。注意:notify()方法不会释放所占用的琐。 Condition.notify_all() Condition.notifyAll() 唤醒所有挂起的线程(如果存在挂起的线程)。注意:这些方法不会释放所占用的琐。 现在写个捉迷藏的游戏来具体介绍threading.Condition的基本使用。假设这个游戏由两个人来玩,一个藏(Hider),一个找(Seeker)。游戏的规则如下:1. 游戏开始之后,Seeker先把自己眼睛蒙上,蒙上眼睛后,就通知Hider;2. Hider接收通知后开始找地方将自己藏起来,藏好之后,再通知Seeker可以找了; 3. Seeker接收到通知之后,就开始找Hider。Hider和Seeker都是独立的个体,在程序中用两个独立的线程来表示,在游戏过程中,两者之间的行为有一定的时序关系,我们通过Condition来控制这种时序关系。 #---- Condition #---- 捉迷藏的游戏 import threading, time class Hider(threading.Thread): def __init__(self, cond, name): super(Hider, self).__init__() self.cond = cond self.name = name def run(self): time.sleep(1) #确保先运行Seeker中的方法 self.cond.acquire() #b print (self.name + ': 我已经把眼睛蒙上了') self.cond.notify() self.cond.wait() #c #f print (self.name + ': 我找到你了 ~_~') self.cond.notify() self.cond.release() #g print (self.name + ': 我赢了') #h class Seeker(threading.Thread): def __init__(self, cond, name): super(Seeker, self).__init__() self.cond = cond self.name = name def run(self): self.cond.acquire() self.cond.wait() #a #释放对琐的占用,同时线程挂起在这里,直到被notify并重新占有琐。 #d print (self.name + ': 我已经藏好了,你快来找我吧') self.cond.notify() self.cond.wait() #e #h self.cond.release() print (self.name + ': 被你找到了,哎~~~') cond = threading.Condition() seeker = Seeker(cond, 'seeker') hider = Hider(cond, 'hider') seeker.start() hider.start() threading.Event Event实现与Condition类似的功能,不过比Condition简单一点。它通过维护内部的标识符来实现线程间的同步问题。(threading.Event和.NET中的System.Threading.ManualResetEvent类实现同样的功能。) Event.wait([timeout]) 堵塞线程,直到Event对象内部标识位被设为True或超时(如果提供了参数timeout)。 Event.set() 将标识位设为Ture Event.clear() 将标识伴设为False。 Event.isSet() 判断标识位是否为Ture。 下面使用Event来实现捉迷藏的游戏(可能用Event来实现不是很形象) #---- Event #---- 捉迷藏的游戏 import threading, time class Hider(threading.Thread): def __init__(self, cond, name): super(Hider, self).__init__() self.cond = cond self.name = name def run(self): time.sleep(1) #确保先运行Seeker中的方法 print (self.name + ': 我已经把眼睛蒙上了') self.cond.set() time.sleep(1) self.cond.wait() print (self.name + ': 我找到你了 ~_~') self.cond.set() print (self.name + ': 我赢了') class Seeker(threading.Thread): def __init__(self, cond, name): super(Seeker, self).__init__() self.cond = cond self.name = name def run(self): self.cond.wait() print (self.name + ': 我已经藏好了,你快来找我吧') self.cond.set() time.sleep(1) self.cond.wait() print (self.name + ': 被你找到了,哎~~~') cond = threading.Event() seeker = Seeker(cond, 'seeker') hider = Hider(cond, 'hider') seeker.start() hider.start() threading.Timer threading.Timer是threading.Thread的子类,可以在指定时间间隔后执行某个操作。下面是Python手册上提供的一个例子: def hello(): print ("hello, world") t = Timer(3, hello) t.start() # 3秒钟之后执行hello函数。 threading常用的方法: threading.active_count() threading.activeCount() 获取当前活动的(alive)线程的个数。 threading.current_thread() threading.currentThread() 获取当前的线程对象(Thread object)。 threading.enumerate() 获取当前所有活动线程的列表。 threading.settrace(func) 设置一个跟踪函数,用于在run()执行之前被调用。 threading.setprofile(func) 设置一个跟踪函数,用于在run()执行完毕之后调用。 threading模块的内容很多,更多内容可以参考官方,猛戳这里!
优秀的个人博客,低调大师

ES6学习笔记(一)

一、let 命令 1、let命令 1.1基本用法 1.1.1 let用于声明变量 类似var,但是let声明的变量只在当前代码块内有效 { let a = 10; var b = 1; } a // ReferenceError: a is not defined. b // 1 let命令在for 循环的计数器中很实用。 1.1.2 let不存在变量提升 var命令会发送“变量提升”,即变量可以在声明之前使用,值为undefined 正常来说变量使用一定要在声明之后。 1.1.3 暂时性死区 只要块级作用域内存在let命令,它所生命的变量就绑定(binding)这个区域,不受外部影响。 ES6明确规定,在区块中存在let 和 const命令,这个区块对这些命令声明的变量都是 不能提前使用的,会报错。 总之在代码块之内,Let声明的变量不可提前使用。 1.1.4不允许重复声明 let不允许在相同作用域内重复声明同一个变量。所以不能在函数内部重新声明参数。 function func(arg) { let arg; // 报错 } function func(arg) { { let arg; // 不报错 } } 1.1.5 ES6的块级作用域 let为JavaScript新增了块级作用域,允许块级作用域的任意嵌套。 {{{{{let insane = 'Hello World'}}}}}; 外层作用域无法读取内层作用域内的变量。 {{{{ {let insane = 'Hello World'} console.log(insane); // 报错 }}}}; 内层作用域可以定义外层作用域的同名变量。 {{{{ let insane = 'Hello World'; {let insane = 'Hello World'} }}}}; 1.1.6 允许块级作用域中声明函数 // 浏览器的 ES6 环境 function f() { console.log('I am outside!'); } (function () { if (false) { // 重复声明一次函数f function f() { console.log('I am inside!'); } } f(); }()); // Uncaught TypeError: f is not a function ES6的块级作用域允许声明函数的规则只在使用大括号的前提下成立,否则就会报错。 1.1.7 do表达式 块级作用域是一个语句,将多个操作封装在一起,没有返回值。 使得块级作用域可以变为表达式,也就是说可以返回值,办法就是在块级作用域之前加上do,使它变为do表达式。 let x = do { let t = f(); t * t + 1; }; 上面代码中,变量x会得到整个块级作用域的返回值。

优秀的个人博客,低调大师

深度学习入门笔记系列 ( 三 )

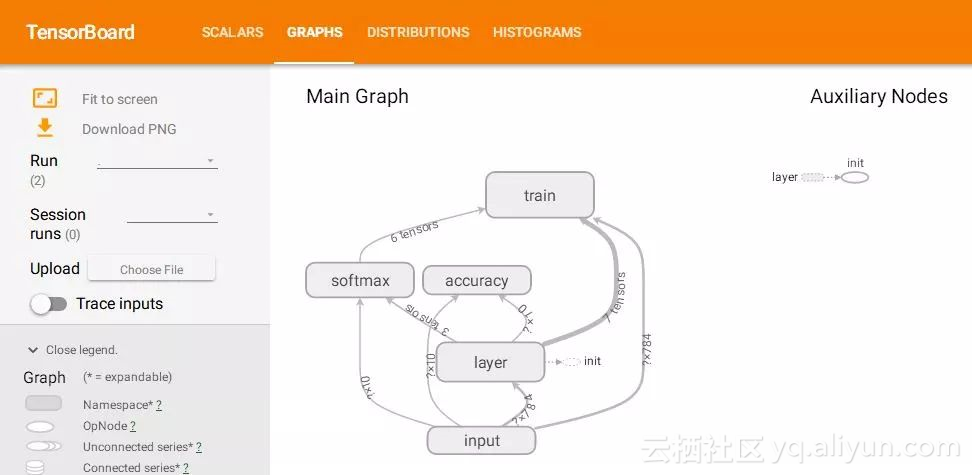
本系列将分为 8 篇 。今天是第三篇 。主要讲讲感知器模型和 tensorboard 的基本使用方法 。 1. 感知器模型 因为小詹之前写过一篇感知器模型的介绍 ,这里就不赘述了 。 2. tensorboard TensorBoard 是 TensorFlow 自带的可视化结构管理和调试优化网络的工具 。在我们学习深度学习网络框架时 ,我们需要更直观的看到各层网络结构和参数 ,也可以更好的进行调试优化网络 。TensorBoard 可以实现网络结构的显示 ,也可以进行显示训练及测试过程中各层参数的变化情况 。 TensorBoard 界面如下 : 我们可以看到顶部有几个功能分类 :SCALARS 、GRAPHS 、HISTOGRAM 等 。 SCALARS 是训练参数统计显示 ,可以看到整个训练过程中 ,各个参数的变换情况 。 HISTOGRAM 是训练过程参数分布情况显示 。 GRAPHS 是网络结构显示 。 TensorBoard 基本操作介绍如下 : 下面用一个最简单的例子来实现基础启动 。定义了两个常量相加的操作 ,运行后会在 log_test 文件夹中出现目标文件 。 之后我们需要在命令窗口启动 tensorboard 。方法在上边基础语法介绍中提及 。这里就小詹自己代码存放位置 ,可在命令窗口执行如下命令 ,得到一个网址(下图标出的部分),并在浏览器中打卡即可 。 在浏览器中打开该网址即可得到上述实例程序的 graph 信息 。 举例比较简单 ,但是并不说明 TensorBoard 不重要 。事实上 ,基于 TensorBoard ,我们可以直观的看到各层网络结构和参数,也可以更好的进行调试优化网络。 原文发布时间为:2018-07-30本文作者:小詹同学本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”

优秀的个人博客,低调大师

深度学习入门笔记系列 ( 一 )

本系列将分为 8 篇 。今天是第一篇 ,工欲善其事必先利其器 ,先简单讲讲当前的主流深度学习框架 TensorFlow 及其安装方法 。 我们知道 ,深度学习研究的热潮持续高涨 ,许多的开源深度学习框架也层出不穷 ,比如 TensorFlow、Caffe、Keras、Theano、Torch7……其中 ,TensorFlow 由强大的谷歌研发 ,应用也十分广泛 ,从 GitHub 上的数据统计可以看出来其有着大一统之势头 。 关于 TensorFlow 的安装 ,我们首先得知道 : Window 、MacOS 、Linux 都已支持 TensorFlow Window用户只能使用python3.5+ ,MacOS,Linux支持python2.7和python3.3+ 有GPU可以安装带GPU版本的,没有GPU就安装CPU版本的。 关于 TensorFlow 的安装 ,这里推荐使用 pip 方式安装 ,简单粗暴 !这里小詹安利一款神器 ,谁用谁说好哈哈 !Anaconda ,你可以试试 ,自带python3.5 ,也包含了很多模块 ,配置其他模块的时候也很好用 。 首先是 windows 下的 pip 安装 :(命令窗口执行) CPU 版本 :pip install tensorflow GPU 版本 :pip install tensorflow-gpu 如果要更新 ,可以选择先pip uninstall tensorflow 再执行pip install tensorflow 至于 Linux 和 MacOS 安装 Tensorflow : CPU版本:Python 2.7 用户:pip install tensorflow Python 3.3+ 用户:pip3 install tensorflow GPU版本:Python 2.7用户:pip install tensorflow-gpu Python3.3+用户:pip3 install tensorflow-gpu 磨刀不误砍柴工 ,花较少的篇幅汇总下如何安装 TensorFlow 在我看来还是很有必要的 ! 原文发布时间为:2018-07-25本文作者: 小詹学Python本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册