首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10000篇文章
优秀的个人博客,低调大师

Android音频开发(1):基础知识

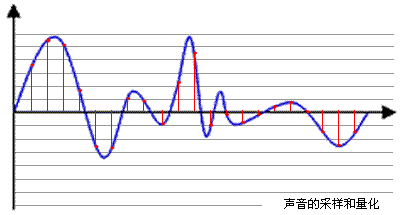
先来点闲言碎语,前段时间我有一段感悟:Android开发,本身并不是一个可以走得多远的方向,它只是一个平台,提供了许多封装好的API,让大家能够快速开发出针对特定业务的应用。 真正有价值的地方就在于Android与具体的业务方向结合,比如:Android与音视频技术,Android与智能硬件交互,Android与前端技术的融合与探索,Android信息安全,Android源码深度定制等等。 我一直比较看好音视频/多媒体方向,希望在此能够深入积累和探索,前段时间我发布了一款Android VoIP网络电话应用“飞鸽电话”,并写了一篇分析其整体架构的文章《PigeonCall:一款Android VoIP网络电话App架构分析》,欢迎有兴趣的小伙伴们先看一看。 在这个应用的开发过程中学到的东西还蛮多的,因此想写一些文章分享分享,本文作为开篇,主要以问答的形式,介绍一些音频开发的基础常识,非常重要,因为不了解这些常识,很多Android API或者第三方库的参数,你都不知道该怎么配置。 1. 音频开发的主要应用有哪些? 音频播放器,录音机,语音电话,音视频监控应用,音视频直播应用,音频编辑/处理软件,蓝牙耳机/音箱,等等。 2. 音频开发的具体内容有哪些? (1)音频采集/播放 (2)音频算法处理(去噪、静音检测、回声消除、音效处理、功放/增强、混音/分离,等等) (3)音频的编解码和格式转换 (4)音频传输协议的开发(SIP,A2DP、AVRCP,等等) 3. 音频应用的难点在哪? 延时敏感、卡顿敏感、噪声抑制(Denoise)、回声消除(AEC)、静音检测(VAD)、混音算法,等等。 4. 音频开发基础概念有哪些? 在音频开发中,下面的这几个概念经常会遇到。 (1) 采样率(samplerate) 采样就是把模拟信号数字化的过程,不仅仅是音频需要采样,所有的模拟信号都需要通过采样转换为可以用0101来表示的数字信号,示意图如下所示: 蓝色代表模拟音频信号,红色的点代表采样得到的量化数值。 采样频率越高,红色的间隔就越密集,记录这一段音频信号所用的数据量就越大,同时音频质量也就越高。 根据奈奎斯特理论,采样频率只要不低于音频信号最高频率的两倍,就可以无损失地还原原始的声音。 通常人耳能听到频率范围大约在20Hz~20kHz之间的声音,为了保证声音不失真,采样频率应在40kHz以上。常用的音频采样频率有:8kHz、11.025kHz、22.05kHz、16kHz、37.8kHz、44.1kHz、48kHz、96kHz、192kHz等。 (2) 量化精度(位宽) 上图中,每一个红色的采样点,都需要用一个数值来表示大小,这个数值的数据类型大小可以是:4bit、8bit、16bit、32bit等等,位数越多,表示得就越精细,声音质量自然就越好,当然,数据量也会成倍增大。 常见的位宽是:8bit 或者 16bit (3) 声道数(channels) 由于音频的采集和播放是可以叠加的,因此,可以同时从多个音频源采集声音,并分别输出到不同的扬声器,故声道数一般表示声音录制时的音源数量或回放时相应的扬声器数量。 单声道(Mono)和双声道(Stereo)比较常见,顾名思义,前者的声道数为1,后者为2 (4) 音频帧(frame) 这个概念在应用开发中非常重要,网上很多文章都没有专门介绍这个概念。 音频跟视频很不一样,视频每一帧就是一张图像,而从上面的正玄波可以看出,音频数据是流式的,本身没有明确的一帧帧的概念,在实际的应用中,为了音频算法处理/传输的方便,一般约定俗成取2.5ms~60ms为单位的数据量为一帧音频。 这个时间被称之为“采样时间”,其长度没有特别的标准,它是根据编解码器和具体应用的需求来决定的,我们可以计算一下一帧音频帧的大小: 假设某通道的音频信号是采样率为8kHz,位宽为16bit,20ms一帧,双通道,则一帧音频数据的大小为: int size = 8000 x 16bit x 0.02s x 2= 5120 bit = 640 byte 5. 常见的音频编码方式有哪些? 上面提到过,模拟的音频信号转换为数字信号需要经过采样和量化,量化的过程被称之为编码,根据不同的量化策略,产生了许多不同的编码方式,常见的编码方式有:PCM 和 ADPCM,这些数据代表着无损的原始数字音频信号,添加一些文件头信息,就可以存储为WAV文件了,它是一种由微软和IBM联合开发的用于音频数字存储的标准,可以很容易地被解析和播放。 我们在音频开发过程中,会经常涉及到WAV文件的读写,以验证采集、传输、接收的音频数据的正确性。 6. 常见的音频压缩格式有哪些? 首先简单介绍一下音频数据压缩的最基本的原理:因为有冗余信息,所以可以压缩。 (1) 频谱掩蔽效应: 人耳所能察觉的声音信号的频率范围为20Hz~20KHz,在这个频率范围以外的音频信号属于冗余信号。 (2) 时域掩蔽效应: 当强音信号和弱音信号同时出现时,弱信号会听不到,因此,弱音信号也属于冗余信号。 下面简单列出常见的音频压缩格式: MP3,AAC,OGG,WMA,Opus,FLAC,APE,m4a,AMR,等等 7. Adndroid VoIP相关的开源应用有哪些 ? imsdroid,sipdroid,csipsimple,linphone,WebRTC 等等 8. 音频算法处理的开源库有哪些 ? speex、ffmpeg,webrtc audio module(NS、VAD、AECM、AGC),等等 10. Android提供了哪些音频开发相关的API? 音频采集: MediaRecoder,AudioRecord 音频播放: SoundPool,MediaPlayer,AudioTrack (它们之间的区别可以参考这篇文章) 音频编解码: MediaCodec NDK API: OpenSL ES 11. 音频开发的延时标准是什么? ITU-TG.114规定,对于高质量语音可接受的时延是300ms。一般来说,如果时延在300~400ms,通话的交互性比较差,但还可以接受。时延大于400ms时,则交互通信非常困难。 本文转自 Jhuster 51CTO博客,原文链接:http://blog.51cto.com/ticktick/1748506,如需转载请自行联系原作者

优秀的个人博客,低调大师

学习OpenStack之 (0):基础知识

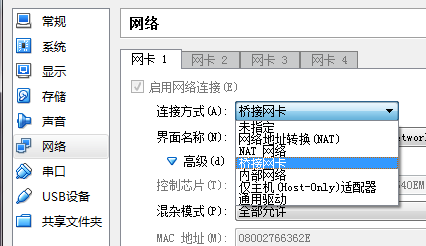
vi 方向键出现字母问题解决方法 执行命令 sudo apt-get remove vim-common 执行命令 sudo apt-get install vim 鼠标被virtualbox捕获无法释放 按右Control键可以释放鼠标 使服务在机器重启后自启动 sudo update-rc.d ssh defaults IP段表示方法 原来“/”后面的数字其实代表了掩码。正常情况下,掩码中的“1”是不可间断的,这样只要知道掩码中“1”的个数,就可以唯一地确定一个掩码。比如“/24”就表示掩码中有24个“1”,即“11111111 11111111 11111111 00000000”,用十进点分法表示就是“255.255.255.0”。 192.168.2.12与192.168.2.20 换成2进制 192.168.2.12二进制11000000.10101000.00000010.00001100 192.168.2.20二进制11000000.10101000.00000010.00010100 相与,有27位地址相同,所以可以写成192.168.2.12/27 主机位就是2的5次方,192168.2.12/27 有32个主机位 tar命令 tar -c: 建立压缩档案 -x:解压 -t:查看内容 -r:向压缩归档文件末尾追加文件 -u:更新原压缩包中的文件 这五个是独立的命令,压缩解压都要用到其中一个,可以和别的命令连用但只能用其中一个。下面的参数是根据需要在压缩或解压档案时可选的。 -z:有gzip属性的 -j:有bz2属性的 -Z:有compress属性的 -v:显示所有过程 -O:将文件解开到标准输出 下面的参数-f是必须的 -f: 使用档案名字,切记,这个参数是最后一个参数,后面只能接档案名。 # tar -cf all.tar *.jpg 这条命令是将所有.jpg的文件打成一个名为all.tar的包。-c是表示产生新的包,-f指定包的文件名。 # tar -rf all.tar *.gif 这条命令是将所有.gif的文件增加到all.tar的包里面去。-r是表示增加文件的意思。 # tar -uf all.tar logo.gif 这条命令是更新原来tar包all.tar中logo.gif文件,-u是表示更新文件的意思。 # tar -tf all.tar 这条命令是列出all.tar包中所有文件,-t是列出文件的意思 # tar -xf all.tar 这条命令是解出all.tar包中所有文件,-x是解开的意思 压缩 tar –cvf jpg.tar *.jpg //将目录里所有jpg文件打包成tar.jpg tar –czf jpg.tar.gz *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用gzip压缩,生成一个gzip压缩过的包,命名为jpg.tar.gz tar –cjf jpg.tar.bz2 *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用bzip2压缩,生成一个bzip2压缩过的包,命名为jpg.tar.bz2 tar –cZf jpg.tar.Z *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用compress压缩,生成一个umcompress压缩过的包,命名为jpg.tar.Z rar a jpg.rar *.jpg //rar格式的压缩,需要先下载rar for linux zip jpg.zip *.jpg //zip格式的压缩,需要先下载zip for linux 解压 tar –xvf file.tar //解压 tar包 tar -xzvf file.tar.gz //解压tar.gz tar -xjvf file.tar.bz2 //解压 tar.bz2 tar –xZvf file.tar.Z //解压tar.Z unrar e file.rar //解压rar unzip file.zip //解压zip 总结 1、*.tar 用 tar –xvf 解压 2、*.gz 用 gzip -d或者gunzip 解压 3、*.tar.gz和*.tgz 用 tar –xzf 解压 4、*.bz2 用 bzip2 -d或者用bunzip2 解压 5、*.tar.bz2用tar –xjf 解压 6、*.Z 用 uncompress 解压 7、*.tar.Z 用tar –xZf 解压 8、*.rar 用 unrar e解压 9、*.zip 用 unzip 解压 指定ubuntu的源,参考http://chenrongya.blog.163.com/blog/static/8747419620143185103297/ 配置静态ip地址 $sudo vi /etc/network/interfaces 原有内容只有如下两行: auto lo iface lo inet loopback 向末尾追加以下内容: auto eth0 iface eth0 inet static address 192.168.0.33 gateway 192.168.0.1 netmask 255.255.255.0 network 192.168.0.0 broadcast 192.168.0.255 然后保存退出; 修改机器名: 修改/etc/hostname 和 /etc/hosts,再重启机器 W: GPG error: http://ppa.launchpad.net lucid Release: The following signatures couldn't be verified because the public key is not available: NO_PUBKEY A1715D88E1DF1F24 Google 之,在这篇文档里有提到解决方案: http://muzso.hu/2007/05/25/how-to-fix-no_pubkey-errors-in-apt-get-update-operations 具体的解决方法步骤是(注意下面的KEY 是根据每次报错而不同的,可能需要用实际报错的KEY替换命令中的KEY值): $ sudo gpg --keyserver keyserver.ubuntu.com --recv A1715D88E1DF1F24 $sudo gpg --export --armor A1715D88E1DF1F24 | sudo apt-key add - 注:上面第二个命令中的第二个sudo,因为sudo不能跨越Pipe,所以第二个命令也需要使用sudo 在ubuntu上安装ssh server 现象: ssh client无法连到ubuntu sammydeair:~ Sammy$ ssh -l s1 10.211.55.4 ssh: connect to host 10.211.55.4 port 22: Connection refused 查看: ubuntu上ssh local,同样错误,发现是openssh-server没安装 解决: $ sudo apt-getupdate //视网络情况会花比较长的时间 $ sudo apt-getupgrade $ sudo apt-get install openssh-server $sudo /etc/init.d/ssh start 在Mac上使用过要license的Parallels Desktop和免费的VirtualBox,比较结果如下: 1. VirtualBox对鼠标的捕获和控制更加友好,Parallels需要按键来释放鼠标,但是VirtualBox里面完全自动。 2. VirtualBox里面虚拟机的运行速度似乎更快,至少关机比Parallels快。 3.VirutalBox里面可以很方便地复制虚拟机,但是在Parallels Desktop里面不知道什么原因“克隆”菜单为灰色不可用。 4. VirtualBox里面多网卡配置更方便。 5. google查到的VirtualBox的文章比Parallels Desktop多得多 至少在我看来,免费的VirtualBox要比收费的Parallels要好些。接下里继续体会VirtualBox。 在Ubuntu里面配置静态IP使得可以连接外网 1. 关闭虚机,在VirtualBox里面,设置虚机的一个网卡为桥接模式 2. 查看主机的DNS server 3. 开虚机,运行ifconfig和route命令,查看该网卡自动获得的IP,netmask,gateway s1@compute1:~$ route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 192.168.1.1 0.0.0.0 UG 0 0 0 eth0 10.0.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth1 192.168.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth0 4. 运行命令vi /etc/network/interfaces,设置静态IP,gateway,broadcast,netmask auto eth0 iface eth0 inet static address 192.168.1.15 netmask 255.255.255.0 gateway 192.168.1.1 5.配置DNS, 运行vi /etc/resolvconf/resolv.conf.d/tail, 从而在/etc/resolvconf/resolv.conf.d/目录下创建tail文件,写入 nameserver 192.168.1.1 然后重启,DNS生效 6.测试。ping www.sohu.com s1@compute1:~$ ping www.sohu.com PING fsh.a.sohu.com (114.80.130.88) 56(84) bytes of data. 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=1 ttl=56 time=4.65 ms 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=2 ttl=56 time=6.91 ms 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=3 ttl=56 time=5.39 ms VirtualBox 虚拟机的几种网络连接方式 (1)NAT(网络地址转换模式):能从虚拟机访问外网,主机不能访问虚拟机。 网络地址转换( NAT )是最简单的方法从一个虚拟机访问外部网。通常,它并不要求在主机网络和客户机上做任何配置。基于这个原因,它是默认的网络模式 。 原理:客户机(即虚拟机)送出的网络帧被 VirtualBox 的 NAT 引擎收到,抽取 TCP/IP 数据,再通过主机的操作系统(即安装 VirtualBox 的操作系统)重新发送出去。送到在主机上的一个应用程序,或者到位于主机同一网络的另一台计算机上,它看起来好象是安装在主机上的程序 VirtualBox,通过一个属于主机的 IP 地址,把数据发送出去。VirtualBox 倾听到数据包裹的回复,通过客户机的私人网络重新包装和发送往客户机上。 效果:使用NAT模式,就是让虚拟系统借助NAT(网络地址转换)功能,通过宿主机器所在的网络来访问公网。但纯NAT模式下,宿主机不能访问虚拟机。 使用场景:如果你想利用安装一个新的虚拟系统,在虚拟系统中不用进行任何手工配置就能直接访问互联网,建议你采用NAT模式. (2)Bridged方式:虚拟机和主机拥有同样的网络功能,能互相访问。 用这种方式,虚拟系统的IP可设置成和本机系统在同一网段,虚拟系统相当于网络内的一台独立的机器,和本机一起插在一个Hub上,网络内其他机器可访问虚拟系统,虚拟系统也可访问网络内其他机器,当然和本机系统的双向访问也不成问题。 (3)内部网络:虚拟机之间可以互相访问,虚拟机不能访问外网,主机和虚机之间不能访问。 内网模式,顾名思义就是内部网络模式: 虚拟机与外网完全断开,只实现虚拟机于虚拟机之间的内部网络模式。 (1)虚拟机与主机的关系:不能相互访问,彼此不属于同一个网络,无法相互访问。 (2)虚拟机与网络中其他主机的关系:不能相互访问,理由同上。 (3)虚拟机与虚拟机的关系:可以相互访问,前提是在设置网络时,两台虚拟机设置同一网络名称。 (4)host-only方式 (主机模式):虚拟机不能访问外网,主机可以访问虚拟机。 Virtualbox在宿主机中模拟出一张专供虚拟机使用的网卡,所有虚拟机都是连接到该网卡上的,虚拟机可以通过该网卡IP访问宿主机,同时Virtualbox提供一个DHCP服务,虚拟机可以获得一个内部网IP,宿主机可以通过该IP访问虚拟机。如果单纯使用Host-only模式,则虚拟机不能连接外部公共网络。 (5)通用驱动 作用和效果:运行用于选择网卡驱动。该驱动是virtualbox内部自带的,或者是通过extensionpack添加进来的。此模式实际上很少用到 一般来说,Bridged方式最方便好用。但如果本机系统是win2000而网线没插(或根本没有网卡),网络非常可能不可用(大部分用PCI网卡的机器都如此),此时就只能用NAT方式或host-only,之前所说的那两块虚拟网卡就是适应这两种网络准备的。 使用NAT和host-only混合模式,使得虚拟机既能访问外网,主机也能访问虚机 在虚机关机状态下配置网络,网卡1使用NAT模式,网卡2使用host-only模式。 1. 检查宿主机上host-only adapter的网络设置 当添加多个网卡时,比如 eth0 是 NAT 模式用于虚机访问外网,eth1 是 host-only 模式用于宿主机访问虚机,eth2 是internal 模式用于虚机之间互访,需要注意 default gateway。设置不对的话,虚机是不能访问外网的。当专有 eth0 时候,default gw 是它自己,当增加 eth1 和 eth2 后,default gw 就跑到了 eth2上,而 eth2 是不能用于外网访问的。因此,此时需要手工修改 default gw,修改为: route del default gw 192.168.1.1 route add default gw 10.0.2.2 eth0 root@ceph1:~# route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 10.0.2.2 0.0.0.0 UG 0 0 0 eth0 10.0.2.0 0.0.0.0 255.255.255.0 U 0 0 0 eth0 192.168.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth2 192.168.56.0 0.0.0.0 255.255.255.0 U 0 0 0 eth1 root@ceph1:~# ping www.sohu.com PING fhk.a.sohu.com (175.100.207.201) 56(84) bytes of data. 64 bytes from 175.100.207.201: icmp_seq=1 ttl=41 time=133 ms 64 bytes from 175.100.207.201: icmp_seq=2 ttl=41 time=69.9 ms 64 bytes from 175.100.207.201: icmp_seq=3 ttl=41 time=69.4 ms 64 bytes from 175.100.207.201: icmp_seq=4 ttl=41 time=68.5 ms 64 bytes from 175.100.207.201: icmp_seq=5 ttl=41 time=71.9 ms 注意 eth0 的 default gw 是 10.0.2.2 而不是 10.0.2.1. 2. 开启虚拟机配置网络 sudo vi /etc/network/interfaces sudo /etc/init.d/networking restart 可运行ifconfig查看ip 3. 可以从主机ping和ssh虚拟机了 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4139246.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

SQL知识整理二:锁、游标、索引

锁的模式 锁模式 描述 共享(S) 用于不更改或不更新数据(只读操作),如SELECT语句 更新(U) 用于可更新的资源中。防止当多个会话在读取、锁定以及随后可能进行的资源更新时发生常见形式的死锁。 排它(X) 用于数据修改操作,例如INSERT、UPDATE或DELETE。确保不会同时对同一资源进行多重更新 意向 SQL Server有在资源的低层获得共享锁或排它锁的意向意向锁的类型为:意向共享(IS)、意向排它(IX)以及意向排它共享(SIX) 架构 在执行依赖于表架构的操作时使用。架构锁的类型为:架构修改(Sch-M)和架构稳定(Sch-S) 大容量更新(BU) 向表中大容量复制数据并指定了TABLOCK提示时使用 死锁 死锁是指在一组进程中的各个进程均占有不会释放的资源,但因互相申请被其他进程所站用不会释放的资源而处于的一种永久等待状态。 死锁的四个必要条件 互斥条件(Mutual exclusion):资源不能被共享,只能由一个进程使用。 请求与保持条件(Hold and wait):已经得到资源的进程可以再次申请新的资源。 非剥夺条件(No pre-emption):已经分配的资源不能从相应的进程中被强制地剥夺。 循环等待条件(Circular wait):系统中若干进程组成环路,该环路中每个进程都在等待相邻进程正占用的资源 死锁的处理方法 查看那个spid处于wait状态,然后用kill spid来干掉(即破坏死锁的第四个必要条件:循环等待)。 使用SET LOCK_TIMEOUT timeout_period(单位为毫秒)来设定锁请求超时。默认情况下,数据库没有超时期限(timeout_period值为-1,可以用SELECT @@LOCK_TIMEOUT来查看该值,即无限期等待)。 SQL Server内部有一个锁监视器线程执行死锁检查,锁监视器对特定线程启动死锁搜索,检测到死锁后,数据库引擎选择运行回滚开销最小的事务的会话作为死锁牺牲品回滚死锁牺牲品的事务并释放该事务持有的所有锁,使其他线程的事务可以请求资源并继续运行。 游标 游标定义: 可以对一个select的结果集进行处理,或是不需要全部处理,就会返回一个对记录集进行处理之后的结果。 游标实际上是一种能从多条数据记录的结果集中每次提取一条记录的机制。游标可以完成: # 允许定位到结果集中的特定行 # 从结果集的当前位置检索一行或多行数据 # 支持对结果集中当前位置的进行修改 由于游标是将记录集进行一条条的操作,所以这样给服务器增加负担,一般在操作复杂的结果集的情况下,才使用游标。SQL Server 2005有三种游标:T-SQL游标、API游标、客户端游标。 游标的基本操作 游标的基本操作有定义游标、打开游标、循环读取游标、关闭游标、删除游标。 A、 定义游标 declare cursor_name --游标名称 cursor [local | global] --全局、局部 [forward only | scroll] --游标滚动方式 [read_only | scroll_locks | optimistic] --读取方式 for select_statements --查询语句 [for update | of column_name ...] --修改字段 参数: forward only | scroll:前一个参数,游标只能向后移动;后一个参数,游标可以随意移动 read_only:只读游标 scroll_locks:游标锁定,游标在读取时,数据库会将该记录锁定,以便游标完成对记录的操作 optimistic:该参数不会锁定游标;此时,如果记录被读入游标后,对游标进行更新或删除不会超过 B、 打开游标 open cursor_name; 游标打开后,可以使用全局变量@@cursor_rows显示读取记录条数 C、 检索游标 fetch cursor_name; 检索方式如下: fetch first; 读取第一行 fetch next; 读取下一行 fetch prior; 读取上一行 fetch last; 读取最后一行 fetch absolute n; 读取某一行 如果n为正整数,则读取第n条记录 如果n为负数,则倒数提取第n条记录 如果n为,则不读取任何记录 fetch pelative n 如果n为正整数,则读取上次读取记录之后第n条记录 如果n为负数,则读取上次读取记录之前第n条记录 如果n为,则读取上次读取的记录 D、 关闭游标 close cursor_name; E、 删除游标 deallocate cursor_name; 游标操作示例 --创建一个游标 declare cursor_stu cursor scroll for select id, name, age from student; --打开游标 open cursor_stu; --存储读取的值 declare @id int, @name nvarchar(20), @age varchar(20); --读取第一条记录 fetch first from cursor_stu into @id, @name, @age; --循环读取游标记录 print '读取的数据如下:'; --全局变量 while (@@fetch_status = 0) begin print '编号:' + convert(char(5), @id) + ', 名称:' + @name + ', 类型:' + @age; --继续读取下一条记录 fetch next from cursor_stu into @id, @name, @age; end --关闭游标 close area_cursor; --删除游标 --deallocate area_cursor; 索引 聚集索引定义: 聚簇索引即建立在聚簇上的索引,创建聚簇索引时,需要对已有表数据重新进行排序(若表中已有数据),即删除原始的表数据后再将排序结果按物理顺序插回,故聚簇索引建立完毕后,建立聚簇索引的列中的数据已经全部按序排列。 一个表中只能包含一个聚簇索引,但该索引可以包含多个列。 B-树索引中,聚簇索引的叶层就是数据页。 聚集索引最佳实践: 首先创建聚集索引 聚集索引键最好是唯一值 聚集索引上的列需要足够短,检索一定范围和预先排序数据时使用,因为聚集索引的叶子与数据页面相同,索引顺序也是数据物理顺序,读取数据时,磁头是按照顺序读取,而不是随机定位读取数据 在频繁更新的列上不要设计聚集索引,他将导致所有的非聚集所有的更新,阻塞非聚集索引的查询 不要使用太长的关键字,因为非聚集索引实际包含了聚集索引值 不要在太多并发度高的顺序插入,这将导致页面分割,设置合理的填充因子是个不错的选择 聚集索引示例: CREATE CLUSTERED INDEX IX_tb_heap_test_id ON dbo.tb_heap_test (id) WITH (ONLINE=ON) 非聚集索引定义: 非聚簇索引类似书本索引,索引与数据存放在不同的物理区域,建立非聚簇索引时数据本身不进行排序。一个表中科含多个非聚簇索引。 B-树索引中,非聚簇索引的叶层仍是索引页,其以指针指向数据页实际存储位置。 非聚集索引最佳实践 频繁更新的列,不适合做聚集索引,但可以做非聚集索引 宽关键字,例如很宽的一列或者一组列,不适合做聚集索引的列可作非聚集索引列 检索大量的行不宜做非聚集索引,但是可以使用覆盖索引来消除这种影响 非聚集索引示例: CREATE INDEX IX_tb_clustered_update_ID ON dbo.tb_clustered_update (ID) WITH (ONLINE=ON) 非聚集与聚集用法之比较 检索的数据行 一般地,检索数据量大的一般使用聚集索引,因为聚集索引的叶子页面与数据页面在相同。相反,检索少量的数据可能非聚集索引更有利,但注意书签查找消耗资源的力度,不过可考虑覆盖索引解决这个问题。 数据是否排序 如果数据需要预先排序,需要使用聚集索引,若不需要预先排序就那就选择聚集索引。 索引键的宽度 索引键如果太宽,不仅会影响数据查询性能,还影响非聚集索引,因此,若索引键比较小,可以作为聚集索引,如果索引键够大,考虑非聚集索引,如果很大的话,可以用INCLUDE创建覆盖索引 列更新的频度 列更新频率高的话,应该避免考虑所用非聚集索引,否则可考虑聚集索引。 书签查找开销 如果书签查找开销较大,应该考虑聚集索引,否则可使用非聚集索引,更佳是使用覆盖索引,不过得根据具体的查询语句而看 覆盖索引 覆盖索引可显著减少查询的逻辑读次数,使用INCLUDE语句添加列的方式更容易实现,他不仅减小索引中索引列的数据,还可以减少索引键的大小,原因是包含列只保存在索引的叶子级别上,而不是索引的叶子页面。覆盖索引充当一个伪的聚集索引。覆盖索引还能够有效的减少阻塞和死锁的发生,与聚集索引类似,因为聚集索引值发生一次锁,非覆盖索引可能发生两次,一次锁数据,一次锁索引,以确保数据的一致性。覆盖索引相当于数据的一个拷贝,与数据页面隔离,因此也只发生一次锁。 覆盖索引示例: CREATE INDEX IX_IX_tb_booklookup_name_type_other ON dbo.tb_booklookup (name) INCLUDE ([type],other) WITH ( ONLINE=ON ) 本文转自程兴亮博客园博客,原文链接: http://www.cnblogs.com/chengxingliang/p/3307473.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux 小知识翻译 - 「架构 续」(arch)

上次,从「计算机的内部构造」的角度解释了架构这个术语。这次,介绍下架构中经常提到的「i386架构」及之后的「i486」,「i586」。 安装Linux的时候,很多人即使不了解但也会经常听到i386架构这个词。因此,会误认为「自己的PC的架构是i386架构的」。现在用i386的人是非常少的。 i386的 i 就是「Intel」的首字母。i386是1985年发布的架构,那么如今还在用i386电脑的人... ...将近20年没有换过电脑了。(这篇文章应该是作者2005年左右写的) 实际上i386的CPU正式名称是「80386」。80386之前是8086和80286,之后还有80486。80386其实就是「80x86」系列CPU中的一种。 这个「80x86」系列,作为「个人电脑」被世界上很多PC所采用。 注:8086之后也有 80186,只不过在PC上用的不多,所以不是那么普遍。 i386是「80x86系列」中第一个32位的CPU。而且,Linux也是在i386上诞生的。 之后,x86系列再次升级,出现了 80486,再之后... ... 实际上官方是不存在 80586 这种型号的CPU的。由于商标的问题,80486之后是「Pentium」(也就是曾经流行的奔腾机),再之后是「Pentium Pro/Pentium II/Pentium III」。 但是,当时比较流行称呼 80x86,所以Pentium被称为「i586」,「Pentium Pro/Pentium II/Pentium III」被称为「i686」。 后来基于Pentium III的Xeon也被包含在i686里面了。之后再发布的各种架构,关于谁是「i786」?有很多争论。(大部分情况下认为Pentium 4是「i786」) 其实,i786和i886这种名称之后几乎没有人使用了。 这里提到的架构都是继承于i386的,「面向i386的OS和应用程序」都能在这些架构上运行。 IA-64之类64位的架构上,面向i386的应用程序有很多是无法运行的,所以把架构「暂且都当成i386」来看的话有点危险, 不过,在面向普通用户的PC上,可以认为面向「i386」的应用程序都能运行。 本文转自wang_yb博客园博客,原文链接:http://www.cnblogs.com/wang_yb/p/3798162.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark MLlib知识点学习整理

MLlib的设计原理:把数据以RDD的形式表示,然后在分布式数据集上调用各种算法。MLlib就是RDD上一系列可供调用的函数的集合。 操作步骤: 1、用字符串RDD来表示信息。 2、运行MLlib中的一个特征提取算法来吧文本数据转换为数值的特征。给操作会返回一个向量RDD。 3、对向量RDD调用分类算法,返回一个模型对象,可以使用该对象对新的数据点进行分类。 4、使用MLlib的评估函数在测试数据集上评估模型。 机器学习基础: 机器学习算法尝试根据 训练数据 使得表示算法行为的数学目标最大化,并以此来进行预测或作出决定。包括分类、回归、聚类,每种都有不一样的目标。 所有的学习算法都需要定义每个数据点的特征集,也就是传给学习函数的值。 更重要的在于如何去正确的定义特征。 例如: 在产品推荐的任务中,仅仅机上一个额外的特征(推荐给用户的书籍也可能取决于用户看过的电影),就有可能极大地改进结果。 当数据已成为特征向量的形式后,大多数机器学习算法会根据这些向量优化一个定义好的数学模型。 然后算法会再运行结束时返回一个代表学习决定的模型。 MLlib数据类型 1、Vector 一个数学向量。MLlib既支持稠密向量也支持稀疏向量。前者表示向量的每一位都存储下来,后者则存储非零位以节省空间。 稠密向量:把所有唯独的值存放在一个浮点整数组中。 稀疏向量只把各维度中的非零值存储下来。当最多只有10%的元素为非零元素时,通常更倾向于使用稀疏向量。 spark中创建向量的方式有 import org.apache.spark.mllib.linalg.Vectors //创建稠密向量<1.0,2.0,3.0>;Vectors.dense接收一串值或一个数组 val denseVec1 = Vectors.dense(1.0,2.0,3.0)) val denseVec2 = Vectors.dense(Array(1.0,2.0,3.0)) //创建稀疏向量<1.0,0.0,2.0,0.0> 向量的维度(4) 以及非零位的位置和对应的值 val sparseVec1 = Vectors.sparse(4,Array(0,2),Array(1.0,2.0)) 2、LabeledPoint 诸如分类和回归的算法这样的监督学习算法中,LabeledPoint用来表示带标签的数据点。它包含一个特征向量与一个标签(由一个浮点数表示),位置在mllib.regression包中。 3、Rating 用户对一个产品的评分,在mllib.recomendation包中,用于产品推荐。 4、各种Model类 每个Model都是训练算法的结果,一般有一个predict()方法可以用来对新的数据点或数据点组成的RDD应用该模型进行预测。 特征转化: TF-IDF:词频,逆文档频率是一种用来从文本文档中生成特征向量的简单方法。它为文档中的每个词计算两个统计值:一个是词频(TF),也就是每个词在文档中出现的次数,另一个是逆文档频率(IDF),用来衡量一个词语特定文档的相关度。 MLlib有两个算法可以用来计算TF-IDF:HashTF和TF HashTF从一个文档中计算出给定大小的词频向量。为了将词和向量顺序对应起来,所以使用了哈希。HashingTF使用每个单词对所需向量的长度S取模得出的哈希值,把所有单词映射到一个0到S-1之间的数字上。由此可以保证生成一个S维的向量。随后当构建好词频向量后,使用IDF来计算逆文档频率,然后将它们与词频相乘计算TF-IDF。 MLlib统计 1、Statistics.colStats(rdd) 计算由向量组成的RDD的统计性综述,保存着向量集合中每列的最大值、最小值、平均值和方差。 2、statistics.corr(rdd,method_ 计算由向量组成的RDD中的列间的相关矩阵,使用皮卡森相关或斯皮尔曼相关中的一种。 3、statistics.corr(rdd1,rdd2,method) 计算两个由浮点值组成的RDD的相关矩阵。 4、Statistics.chiSqTest(rdd) 计算由LabeledPoint对象组成的RDD中每个特征与标签的皮卡森独立性测试结果。返回一个ChiSqTestResult对象,其中有p值、测试统计及每个特征的自由度。 分类与回归 监督试学习指算法尝试使用有标签的训练数据(已知结果的数据点)根据对象的特征预测的结果。在分类中,预测出的变量是离散的(就是一个在有限集中的值,叫做类别) 。比如,分类可能是将邮件文卫垃圾邮件和非垃圾邮件,也有可能是文本所使用的语言。在回归中,预测出的是变量是连续的(根据年龄和体重预测一个人的身高) 线性回归: 1、numIteratrions 要运行的迭代次数(默认值:100) 2、stepSize 梯度下降的步长(默认值:1.0) 3、intercept 是否给数据加上一个干扰特征或者偏差特征--也就是一个值始终未1的特征(默认值:false) 4、regParam Lasso和ridge的正规化参数(默认值:1.0) import org.apache.spark.mllib.regression.LabeledPoint import org.apache.spark.mllib.regression.LinearRegressionWithSGD val points: RDD[LabeledPoint] = //.. val lr = new LinearRegressiionWithSGD().setNumIterations(200).setIntercept(true) val model = lr.run(points) println("weight: %s, intercept: %s".format(model.weights, model.intercept)) 逻辑回归 用来寻找一个分割阴性和阳性示例的线性分割平面。在MLlib中,接收一组标签为0或1的LabeledPoint,返回可以预测新点的分类的LogisticRegressionModel对象。 决策树与随机深林 决策树是一个灵活的模型,可以用来进行分类,也可以用来进行回归。决策树以节点树的形式表示,每个节点基于数据的特征作出一个二元决定(比如这个人的年龄是否大于20?),而树的每个叶节点则包含一种预测结果(例如,这个人是不是会买一个产品?)决策树的吸引力在于模型本身容易检查,而且决策树既支持分类的特征,也支持连续的特征。 参考于:《Spark快速大数据分析》

优秀的个人博客,低调大师

oracle点知识8——索引组织表

关于索引的入门参照博客:http://blog.csdn.net/changyanmanman/article/details/7097318 索引组织表(index organizedtable, IOT)就是存储在一个索引结构中的表。存储在堆中的表是无组织的(也就是说,只要有可用的空间,数据可以放在任何地方),IOT中的数据则按主键存储和排序。对你的应用来说,IOT表和一个“常规”表并无二致。 IOT有什么意义呢?使用堆组织表时,我们必须为表和表主键上的索引分别留出空间。而IOT不存在主键的空间开销,因为索引就是数据,数据就是索引,二者已经合二为一。 但是,IOT带来的好处并不止于节约了磁盘空间的占用,更重要的是大幅度降低了I/O,减少了访问缓冲区缓存(尽管从缓冲区缓存获取数据比从硬盘读要快得多,但缓冲区缓存并不免费,而且也绝对不是廉价的。每个缓冲区缓存获取都需要缓冲区缓存的多个闩,而闩是串行化设备,会限制应用的扩展能力)IOT适用的场合有: 1、完全由主键组成的表。这样的表如果采用堆组织表,则表本身完全是多余的开销,因为所有的数据全部同样也保存在索引里,此时,堆表是没用的。 2、代码查找表。如果你只会通过一个主键来访问一个表,这个表就非常适合实现为IOT. 3、如果你想保证数据存储在某个位置上,或者希望数据以某种特定的顺序物理存储,IOT就是一种合适的结构。 IOT提供如下的好处: ·提高缓冲区缓存效率,因为给定查询在缓存中需要的块更少。 ·减少缓冲区缓存访问,这会改善可扩缩性。 ·获取数据的工作总量更少,因为获取数据更快。 ·每个查询完成的物理I/O更少。 如果经常在一个主键或唯一键上使用between查询,也是如此。如果数据有序地物理存储,就能提升这些查询的性能。 索引组织表的创建格式如下: createtableindexTable( IDvarchar2(10), NAMEvarchar2(20), constraintpk_idprimarykey(ID) ) organizationindex; 注意两点: ● 创建IOT时,必须要设定主键,否则报错。 ● 索引组织表实际上将所有数据都放入了索引中。 索引组织表属性 1、OVERFLOW子句(行溢出) 因为所有数据都放入索引,所以当表的数据量很大时,会降低索引组织表的查询性能。此时设置溢出段将主键和溢出数据分开来存储以提高效率。溢出段的设置有两种格式: PCTTHRESHOLD n:制定一个数据块的百分比,当行数据占用大小超出时,该行的其他列数据放入溢出段 INCLUDING column_name:指定列之前的列都放入索引块,之后的列都放到溢出段 ● 当行中某字段的数据量无法确定时使用PCTTHRESHOLD。 ● 若所有行均超出PCTTHRESHOLD规定大小,则考虑使用INCLUDING。 createtablet88( IDvarchar2(10), NAMEvarchar2(20), constraintpk_idprimarykey(ID) ) organizationindex PCTTHRESHOLD20 overflowtablespaceusers INCLUDINGname; ● 如上例所示,name及之后的列必然被放入溢出列,而其他列根据PCTTHRESHOLD规则。 2、COMPRESS子句(键压缩) 与普通的索引一样,索引组织表也可以使用COMPRESS子句进行键压缩以消除重复值。 具体的操作是,在organization index之后加上COMPRESSn子句 ● n的意义在于:指定压缩的列数。默认为无穷大。 例如对于数据(1,2,3)、(1,2,4)、(1,2,5)、(1,3,4)、(1,3,5)时 若使用COMPRESS则会将重复出现的(1,2)、(1,3)进行压缩 若使用COMPRESS 1时,只对数据(1)进行压缩 索引组织表的维护 索引组织表可以和普通堆表一样进行INSERT、UPDATE、DELETE、SELECT操作。 可使用ALTER TABLE ... OVERFLOW语句来更改溢出段的属性。 alter tablet88add overflow;--新增一个overflow ● 要ALTER任何OVERVIEW的属性,都必须先定义overflow,若建表时没有可以新增 alter tablet88pctthreshold 15 including name;--调整overflow的参数 alter tablet88initrans 2 overflow initrans 4;--修改数据块和溢出段的initrans特性 ● 关于initrans的概念参考http://space.itpub.net/265709/viewspace-166534 索引组织表的应用 Heap Table 就是一般的表,获取表中的数据是按命中率来得到的。没有明确的先后之分,在进行全表扫描的时候,并不是先插入的数据就先获取。数据的存放也是随机的,当然根据可用空闲的空间来决定。 IOT就是类似一个全是索引的表,表中的所有字段都放在索引上,所以就等于是约定了数据存放的时候是按照严格规定的,在数据插入以前其实就已经确定了其位置,所以不管插入的先后顺序,它在那个物理上的那个位置与插入的先后顺序无关。这样在进行查询的时候就可以少访问很多blocks,但是插入的时候,速度就比普通的表要慢一些。 适用于信息检索、空间和OLAP程序。 索引组织表的适用情况:1、 代码查找表。 2、 经常通过主码访问的表。 3、 构建自己的索引结构。 4、 加强数据的共同定位,要数据按特定顺序物理存储。 5、 经常用between…and…对主码或唯一码进行查询。数据物理上分类查询。如一张订单表,按日期装载数据,想查单个客户不同时期的订货和统计情况。 经常更新的表当然不适合IOT,因为oracle需要不断维护索引,而且由于字段多索引成本就大。 如果不是经常使用主键访问表,就不要使用IOT 索引组织表中的二次索引: 在索引表上建立二次索引(secondary index)访问索引组织表的非主键列或者非主键前缀列的性能将得到提高。 oracle为索引组织表建立的二次索引是建立在逻辑ROWID上面的,什么是逻辑rowid呢?其实就是根据索引组织表的主键生成的rowid,它不是存储位置的实际rowid,oracle能够根据这个逻辑rowid进行 物理推测 找到索引项在索引块中的实际(物理)位置。(捋一下思路:二次索引建立在逻辑rowid上,rowid能推测出数据在索引块的实际位置)这样就能访问索引块了。可以省略通过索引主键来访问的步骤,减少I/O. 但是有一个很明显的问题,就是因为索引组织表的数据行没有固定的物理地址,当索引项被移动到新的物理块时,就还需要再执行主键搜索。 对一个常规表来说,通过间接索引(secondary index)访问表数据意味着先扫描间接索引再获取包含所需数据行的数据块(data block)。而对于索引表(index-organized table)来说,通过间接索引访问表数据的步骤依据是否使用物理推测(physical guess),及物理推测的准确度而有所不同: 如不使用物理推测,数据访问需要两次索引扫描:首先扫描间接索引,再依据其结果扫描主键索引(primary key index)。 如使用物理推测且推测结果准确,数据访问需要首先扫描间接索引,再进行 I/O 操作获取包含所需数据行的数据块。 如使用物理推测且推测结果不准确,数据访问需要首先扫描间接索引,并根据物理推测执行 I/O 操作获取了错误的数据块,之后再进行主键索引扫描。 索引组织表的位图索引: Oracle 支持在分区的(partitioned)或非分区的(nonpartitioned)索引表(index-organized table)上创建位图索引(bitmap index)。为索引表创建位图索引时需要使用一个映射表(mapping table)。 映射表:这个表的存储结构式按照堆组织表存储的,它用来存储索引组织表的逻辑ROWID,具体说来,就是映射表在每一行中存储一个索引组织表的逻辑rowid,这一映射表自己的每一行的物理rowid与索引组织表的逻辑rowid就建立了一一对应的关系。 建立在索引组织表上的位图索引与建立在堆表上的位图索引十分相似,只不过这里索引组织表使用了映射表中的物理rowid,而堆表直接直接使物理rowid与实际数据对应,IOT中间多了一层映射表,每个iot只需一个映射表就把所有的逻辑rowid存储到物理的映射表中。建立在IOT中的上的多个位图可以共用一个映射表。(这里我在想,不管是IOT还是堆组织表,都是根据索引键的值做的位图索引,比如用性别列做索引,有男,女两个位图,搜索的时候不管是IOT还是堆表,都是一样的根据搜索条件去位图置位表里选择,然后堆表直接找到置位对应的物理rowid,IOT通过映射找到逻辑rowid进行访问) 无论是堆表(heap-organized)还是索引表(index-organized),都会使用搜索键(search key)来检索位图索引(bitmap index)。如果在位图索引中找到了符合条件的记录,这个位图索引项(bitmap index entry)将被转换为物理 rowid(physical rowid)。对于堆表,Oracle 将使用此物理 rowid 访问基表(base table)。而对于索引表,Oracle 将使用此物理 rowid 访问映射表(mapping table)得到逻辑 rowid(logical rowid),再通过逻辑 rowid 访问索引表。 索引表(index-organized table)的数据行发生了移动后,不会导致建立在其上的位图索引(bitmap index)失效。数据行移动后会导致使用映射表(mapping table)中某些逻辑 rowid(logical rowid)进行物理推测(physical guess)时不准确。但是索引表仍旧可以通过主键(primary key)访问。 数据段和索引段:http://blog.csdn.net/changyanmanman/article/details/7270361 索引总结:http://blog.csdn.net/changyanmanman/article/details/7337020

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册