首页 文章 精选 留言 我的

精选列表

搜索[记忆机制],共10000篇文章
优秀的个人博客,低调大师

这份备忘录拯救你的记忆

今天要介绍的 Python 3 Cheat Sheet 由法国国家科学研究中心(CNRS)的法国机械工程与信息技术实验室(LIMSI)的工程师 Laurent Pointal 总结。这个简单的 Cheat Sheet 专注于从算法/编程开始所必需的语言部分,提供了学生入门所需的一般信息。注意:它不涉及面向对象的编程。 Python 3 Cheat Sheet 一共包含两页,分成了多个框图,涉及基本的 Python 数据结构、数学运算、条件和循环语句、文件读写,以及异常值处理等。在每个框图中,右上角是类型名称,蓝色和红色字体是该类型包含的关键字,绿色字体是示例,黑色斜体字提供更详细的信息。 Python3 的基本数据类型和数据结构类型: 数据类型:整型(int)、浮点型(float)、布尔型(bool)、字符串(str)、二进制字节序列数(含二进制数、八进制数、十六进制数,bytes)等。 数据结构类型包含有序序列和键值容器。有序序列包含列表、元组和字符串等,其中列表和元组的重要区别是前者可变,后者不可变,列表主要用于存储同构数据,元组主要用于存储异构数据;键值容器没有预先设置顺序,可以通过访问键快速查找值,包含字典、集合等。 标识符:用于代表变量、函数、模块、类等的名称。注意尽量避免使用读音符号,不要使用 Python3 中的关键字,Python3 的标识符是区分大小写的,框图中分别列出了允许和不允许的标识符示例。 变量赋值:赋值也就是为变量赋予具体的值,等号左侧是变量名,右侧是值。如果右侧存在变量,可以看成是函数;可以将同一个值赋予多个变量;可以将多个值分别赋予多个变量;可以交换两个变量的值;可以用于表示循环语句,等。 类型转换:将数据从某一个数据类型转换为另一个数据类型,或将某一个数据结构转换为另一个数据结构。可以将表达式总结为 type(expression),其中 type 是目标转换类型,expression 是要转换的数据或数据结构。此外,也可以用更具体的句式转换列表的格式,或者对列表中的每个数据同时转换数据类型。 序列容器索引:用于列表、元组、字符串、bytes 的数据排序。可以使用正索引,也可以使用负索引。定义了索引之后,可以方便地对容器的数据进行访问、赋值(可变量)等操作,数据访问/赋值可以用于单个数据,也可以用于多个数据,并能指定间隔、顺序/倒序等。 第一页剩余部分还包括:布尔逻辑、声明的模块结构、模块导入操作、数学运算、条件声明语句结构以及异常案例处理语句。 循环语句是编程语言中最核心的语句之一,如下在第二页所示在 Python 中主要有 while 循环与 for 循环。其中 While 循环需要一个「循环条件」,如果它为真,则继续迭代。而对于 For 循,我们可以把变量「var」应用需要循环的代码块中,「for」语句会迭代地从 seqence 中抽取它。注意这两个循环还会有控制语句,即立即从循环体跳出的 break 命令和跳过当前循环剩余语句并进入下一个循环的 continue 语句。 注意 for 循环需要可迭代目标,即列表、元组和字符串等,只有这样才能从它们中抽取元素。此外,for ... in range() 语句可以通过数值进行迭代,例如从 0 增加到 9 等。在上图还展示了 print() 函数和 input() 函数,其中 print() 函数可以打印字符串、变量和表达式。 Python 提供了非常多的内嵌运算函数,包括对数值变量的运算和各种数据结构的操作。如下展示了对列表、字典、集合和一般数据结构的操作方法,后面还继续展示了字符串或元组的操作。例如在一般数据结构的操作中,len() 函数可能是最常见的方法,它可以用来统计不同数据结构中元素的数量。例如如果一个列表中储存了所有神经元的输出值,那么我们可以使用 len() 统计神经元的数量,并用 for 循环依次访问不同的神经元。 后面的列表、字典和集合操作都非常重要,它们在机器学习及一般编程中都十分常见。例如在列表运算中,append() 方法会在列表的尾部添加新的元素,extend() 方法会将另外一个序列添加到列表的末尾,而 pop() 方法会移除列表中的一个元素(默认最后一个元素),并且返回该元素的值。列表数据结构还有其它很多方法,包括移除 remove()、排序 sort() 和统计 count() 等。 除了列表外,字典是另外一种很重要的数据结构,如果我们需要迭代地给神经网络不同层级的参数命名,那么很可能就需要借助字典数据结构。通过字典,我们可以使用数值型、字符型或其它类型的索引。字典的每个键值 (key=>value) 对用冒号 (:) 分割,每个对之间用逗号 (,) 分割,整个字典包括在花括号 ({}) 中。 字典同样也有非常多的方法,如上所示删除字典内所有元素的 clear() 方法、以列表返回可遍历的(键,值)元组的 items() 方法,以及把字典 d2 的键/值对更新到 d 里面的 update(d2) 方法。 下面备忘录中最重要的就是函数的定义和调用了,这在大多数编程语言中都是很核心的模块。函数的定义与调用都非常简单,这张表也只是展示了基本概念。此外,在这一张备忘录中,它并没有介绍类与实例等面向对象的编程方法。 最后是文件读写、字符串操作与字符串的格式化操作。其中文件读写在读写数据中是很常用的,当然我们也可以用 Pandas 等库实现更高效的读写方法。在对文件进行处理过程中,open() 方法用于打开一个文件,并返回文件对象,如果该文件无法被打开,会抛出 OSError。打开文件并执行某些操作后,一般我们都需要使用 write() 方法将字符串写入文件。每次打开一个文件,并完成读写后,我们必须使用 close() 关闭文件。 原文发布时间为:2018-10-17 本文作者:思源 本文来自云栖社区合作伙伴“深度学习自然语言处理”,了解相关信息可以关注“深度学习自然语言处理”。

优秀的个人博客,低调大师

Elasticsearch结构化搜索_filter执行原理深度剖析(bitset机制与caching机制)

1)在倒排索引中查找搜索串,获取document list date来举例 word doc1 doc2 doc3 2017-01-01 * * 2017-02-02 * * 2017-03-03 * * * filter:2017-02-02 到倒排索引中一找,发现2017-02-02对应的document list是doc2,doc3 (2)为每个在倒排索引中搜索到的结果,构建一个bitset,[0, 0, 0, 1, 0, 1] 非常重要 使用找到的doc list,构建一个bitset,就是一个二进制的数组,数组每个元素都是0或1,用来标识一个doc对一个filter条件是否匹配,如果匹配就是1,不匹配就是0 [0, 1, 1] doc1:不匹配这个filter的doc2和do3:是匹配这个filter的 尽可能用简单的数据结构去实现复杂的功能,可以节省内存空间,提升性能 (3)遍历每个过滤条件对应的bitset,优先从最稀疏的开始搜索,查找满足所有条件的document 后面会讲解,一次性其实可以在一个search请求中,发出多个filter条件,每个filter条件都会对应一个bitset遍历每个filter条件对应的bitset,先从最稀疏的开始遍历 [0, 0, 0, 1, 0, 0]:比较稀疏[0, 1, 0, 1, 0, 1] 先遍历比较稀疏的bitset,就可以先过滤掉尽可能多的数据 遍历所有的bitset,找到匹配所有filter条件的doc 请求:filter,postDate=2017-01-01,userID=1 postDate: [0, 0, 1, 1, 0, 0] userID: [0, 1, 0, 1, 0, 1] 遍历完两个bitset之后,找到的匹配所有条件的doc,就是doc4 就可以将document作为结果返回给client了 (4)caching bitset,跟踪query,在最近256个query中超过一定次数的过滤条件,缓存其bitset。对于小segment(<1000,或<3%),不缓存bitset。 比如postDate=2017-01-01,[0, 0, 1, 1, 0, 0],可以缓存在内存中,这样下次如果再有这个条件过来的时候,就不用重新扫描倒排索引,反复生成bitset,可以大幅度提升性能。 在最近的256个filter中,有某个filter超过了一定的次数,次数不固定,就会自动缓存这个filter对应的bitset segment(上半季),filter针对小segment获取到的结果,可以不缓存,segment记录数<1000,或者segment大小 segment数据量很小,此时哪怕是扫描也很快;segment会在后台自动合并,小segment很快就会跟其他小segment合并成大segment,此时就缓存也没有什么意义,segment很快就消失了 针对一个小segment的bitset,[0, 0, 1, 0] filter比query的好处就在于会caching,但是之前不知道caching的是什么东西,实际上并不是一个filter返回的完整的doc list数据结果。而是filter bitset缓存起来。下次不用扫描倒排索引了。 (5)filter大部分情况下来说,在query之前执行,先尽量过滤掉尽可能多的数据 query:是会计算doc对搜索条件的relevance score,还会根据这个score去排序filter:只是简单过滤出想要的数据,不计算relevance score,也不排序 (6)如果document有新增或修改,那么cached bitset会被自动更新 postDate=2017-01-01,[0, 0, 1, 0]document,id=5,postDate=2017-01-01,会自动更新到postDate=2017-01-01这个filter的bitset中,全自动,缓存会自动更新。postDate=2017-01-01的bitset,[0, 0, 1, 0, 1]document,id=1,postDate=2016-12-30,修改为postDate-2017-01-01,此时也会自动更新bitset,[1, 0, 1, 0, 1] (7)以后只要是有相同的filter条件的,会直接来使用这个过滤条件对应的cached bitset 参考内容:《Elasticsearch顶尖高手系列-高手进阶篇》
优秀的个人博客,低调大师

tcp拥塞机制完整过程

- **完整过程** ![](https://developer.qcloudimg.com/http-save/audit-9879380/f3a43b807b0736d60c8d08de85bbbdb0.png) - **关键词** - cwnd: 拥塞窗口 - rwnd: 接收窗口 - swnd: 发送窗口 = min(cwnd, rwnd) - ssthresh:初始无穷大 - RTT: 只是从数据包发出到接收到对方的包中间经过的时间, 五层协议中RTT定义的概率是不一样的, - 应用层:是指进程发出消息到收到回复消息的整个过程 - 链路层: - RTO: 超时重传,主要依赖RTT动态计算 - **关键过程** - **慢启动** - 概念: 刚开始建立连接执行慢启动 - 数值 - 老版本教材 cwnd=1, ssthresh=无穷大,rwnd>cwnd, swnd=min(1,rwnd) = 1 - 新版本 cwnd=10, ssthresh=无穷大, rwnd>cwnd, swnd=min(10,rwnd) = 10 (**原因是带宽和网页都越来越大,而RTT就变成了影响消息速度的卡点,所以将cwnd初始值调大,跳大之后一个 RTT 内回来的 ACK 数量变多了,连接建立之后的消息响应会加快很多**) - **从链路层来说,所有的报文从介质中传播都是串行的,只是说一个rtt内传播的报文可能有多个** - **超时** - 概念:发出报文后等待RTO还没收到ack,就认为是超时了 - 新阶段: 进入慢启动 - **收到三次重复的ack** - 概念: 收到三次重复的ack,就意味着大概率丢包了,需要重发 - 新动作:立刻重传报文 - 新阶段:进入快速恢复阶段 - **快速恢复** - 概念: 快速恢复降低cwnd不会降到1,所以恢复起来较快 - 进入信号: 收到三次重复的ack - 退出信号: 收到新的报文的ack就结束快速恢复阶段 - 新阶段: 进入拥塞避免阶段 - 数值 - (假设超时是cwnd=16) - ssthresh = max(cwnd / 2, 2) = max(8, 2) = 8 - cwnd = ssthresh + 3 = 8+3 = 11 (这里的3对应收到的三次重复的ack) - **拥塞避免** - 概念:在通过慢启动探测到网络上限时开始缓慢增加 - 进入信号:cwnd >= sstresh - 退出信号:超时或者收到三次重复的ack - **其他概念** - **延迟ack** - 影响: 由于ack变少, - 慢启动 cwnd的增长会变慢 - 拥塞避免阶段 cwnd的增长会变慢 - 减少了纯ack包,可以让ack携带数据返回 - 使用场景 - 数据包较大,会被切分成多个报文,每个报文都回复无太大意义 - 返回的ack无实际意义的情况 - 不使用场景 - 需要实时交互的场景,比如游戏,需要及时响应,延迟ack会降低玩家体验感 - 一些小数据包请求,本身切割后的报文数量较小,不太需要延迟ack - 请求数据包较小,但响应数据包较大,,相应数据包本身就要被切分成多个报文,再延迟,基本就是灾难了

优秀的个人博客,低调大师

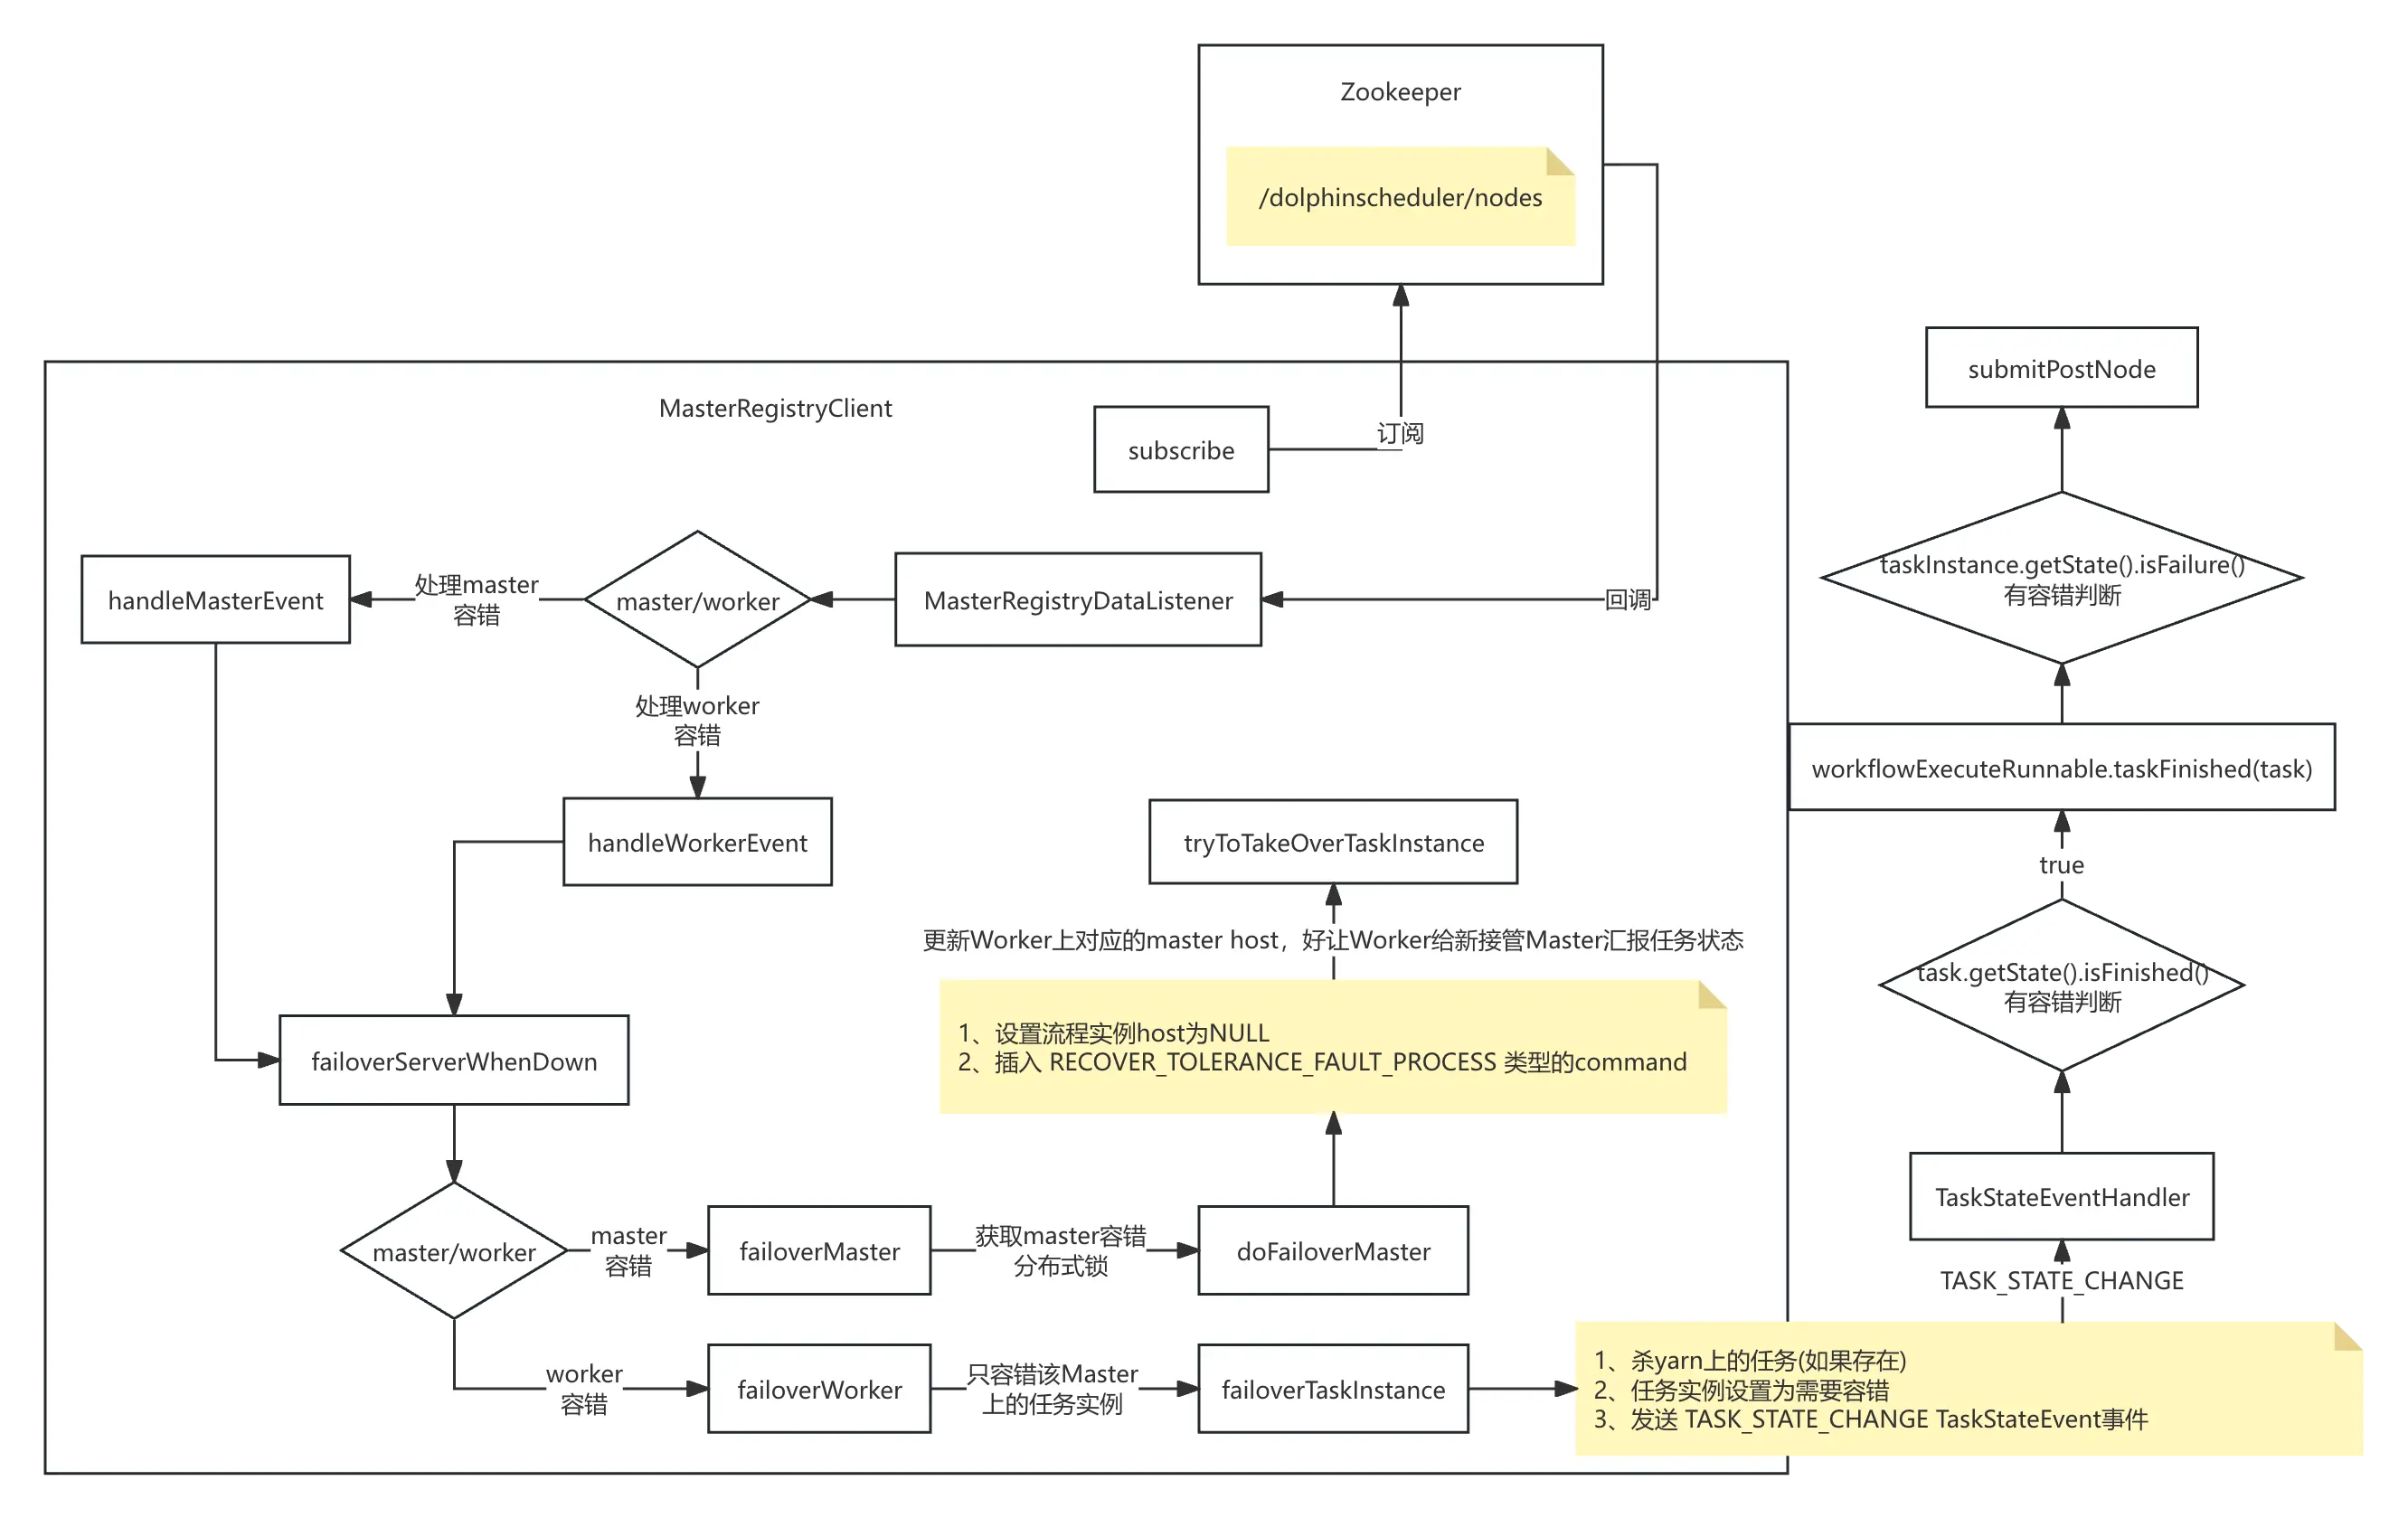
深入解析Apache DolphinScheduler容错机制

简述 Apache Dolphinscheduler Master和Worker都是支持多节点部署,无中心化的设计。 Master主要负责是流程DAG的切分,最终通过RPC将任务分发到Worker节点上以及Worker上任务状态的处理 Worker主要负责是真正任务的执行,最后将任务状态汇报给Master,Master进行状态处理 那问题来了: Master掉了怎么办?它是负责流程实例的管理的。这样Worker就没有办法给它汇报任务状态,当然它也不能做状态处理了? Worker掉了又怎么办?要知道Worker是真正任务执行的载体,它如果掉了。Master要怎么处理? 来来来,一张图说清楚它们。 容错 总结 其实说白了就是如果Master掉了,其他Master分布式锁来对Master进行容错。也就是流程实例由之前的down掉的Master切换到要接管的Master上,这个时候是需要给Worker下发新Master的host的,让Worker可以重新给新Master上报信息。 而Worker掉了就是任务的重试,但是任务重试之前是有前提的,那就是要kill掉正在运行YARN上的任务,当前DS做不到。为什么?因为对于在非客户端分离模式下,是需要ProcessBuilder的waitFor一直等待客户端进程退出的。而applicationId的解析是在客户端进程退出(也就是waitFor退出)之后做的。 那意思就是说只能等待程序运行完毕,我才能获取到applicationId。 org.apache.dolphinscheduler.server.master.service.WorkerFailoverService#killYarnTask private void killYarnTask(TaskInstance taskInstance, ProcessInstance processInstance) { try { if (!masterConfig.isKillApplicationWhenTaskFailover()) { return; } if (StringUtils.isEmpty(taskInstance.getHost()) || StringUtils.isEmpty(taskInstance.getLogPath())) { return; } TaskExecutionContext taskExecutionContext = TaskExecutionContextBuilder.get() .buildWorkflowInstanceHost(masterConfig.getMasterAddress()) .buildTaskInstanceRelatedInfo(taskInstance) .buildProcessInstanceRelatedInfo(processInstance) .buildProcessDefinitionRelatedInfo(processInstance.getProcessDefinition()) .create(); // only kill yarn/k8s job if exists , the local thread has exited log.info("TaskInstance failover begin kill the task related yarn or k8s job"); ILogService iLogService = SingletonJdkDynamicRpcClientProxyFactory.getProxyClient(taskInstance.getHost(), ILogService.class); GetAppIdResponse getAppIdResponse = iLogService.getAppId(new GetAppIdRequest(taskInstance.getId(), taskInstance.getLogPath())); ProcessUtils.killApplication(getAppIdResponse.getAppIds(), taskExecutionContext); } catch (Exception ex) { log.error("Kill yarn task error", ex); } } 怎么办?回顾 1.3.3 版本,是LoggerServer和Master是分离模式的,所以只要Master节点有yarn客户端,是可以通过master对yarn上的applicationId进行干掉的。而现在怎么办? 两种解决思路 : Master上kill,使用yarn rest api curl -X PUT -d '{"state":"KILLED"}' -H "Content-Type: application/json" http://xx.xx.xx.xx:8088/ws/v1/cluster/apps/application_1694766249884_1098/state?user.name=hdfs 注意 : 需要加用户。 Worker上kill 这个是需要标识该任务是容错任务 ,然后在任务重试运行的时候,调度到指定的Worker上。需要先kill当前运行的applicationId,然后再任务重试。其实这里有一个优化点就是,是Worker掉了,但是任务还在,所以需要判断的是yarn上的状态,如果异常,再kill也不迟,而不是上来就kill。如果是RUNNING,等待就好,可以设置等待超时时间。 转载自journey 原文链接:https://segmentfault.com/a/1190000045084857 本文由 白鲸开源科技 提供发布支持!

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册