首页 文章 精选 留言 我的

精选列表

搜索[服务器监控],共10000篇文章
优秀的个人博客,低调大师

MTS性能监控你知道多少

前言 说到MySQL的MTS,相信很多同学都不陌生,从5.6开始基于schema的并行回放,到5.7的LOGICAL_CLOCK支持基于事务的并行回放,这些内容都有文章讲解,在本篇文章不再赘述。今天要讲的是,你知道如何查看并行回放是否存在性能瓶颈吗,是由于主库事务行为导致无法并行回放,还是由于worker线程不足,限制了并行回放的天花板?这都得从一个Note信息说起。 MY-010559 在开启了多线程回放的从库error log,我们经常能看到Note级别的日志信息MY-010559 让我们来看看这些日志的含义 Seconds elapsed:当前时间与上次输出日志时间的间隔秒数 Events assigned:自slave协调线程启动后,累计处理分发给worker线程的event数量。简单理解为slave启动后处理的event数量。 Worker queues filled over overrun level:worker线程处理的event队列长度超过最大队列数(目前代码硬编码16384)的90%的次数,如果0则说明未发生该情况。 Waited due to worker queue full:worker线程处理的event队列长度达到最大(目前代码硬编码16384)的次数,如果为0则说明未发生该情况,是前面Worker queues filled over overrun level的情况升级。 Waited due to the total size:协调线程分发event大小达到replica_pending_jobs_size_max或者slave_pending_jobs_size_max限制而产生等待的次数。前面两个参数是限制worker线程处理event队列能够申请的最大内存(即大事务)。如果遇到此种大事务,在回放该大事务之前,会等待其他worker线程处理完已分配event,然后再进行该大事务的回放,回放过程中,后续的event回放,也会进入等待状态。总之,大事务回放特别影响并行回放的性能,只能串行回放。 Waited at clock conflicts:由于不能并行回放的累计等待时间,单位纳秒。如果并行回放策略设置的是DATABASE而不是LOGICAL_CLOCK,该值一直为0。 Waited (count) when workers occupied:协调线程休眠次数。有两种情况会累加此状态值:1、worker线程达到最大队列数(目前代码硬编码16384)的90%,此种情况协调线程最多休眠1毫秒;2、并行回放策略设置为LOGICAL_CLOCK时,由于没有空闲的worker线程导致无法分配事务的第一个event而产生的等待,此种情况协调线程会一直处于等待状态直到有空闲的worker线程能够处理回放。 Waited when workers occupied:等待空闲的worker线程累计时间,单位纳秒,对应Waited (count) when workers occupied的第二种等待情况。 代码分析 在8.0.26版本的代码中,我们通过错误信息关键字waited at clock conflicts查找,发现信息记录在变量ER_RPL_MTS_STATISTICS中, 继续按变量查找,发现其使用在rpl_replica.cc文件的apply_event_and_update_pos函数中,主要逻辑代码如下 可以看到,满足如下几个条件,日志信息就会输出 并行回放为开启状态 并行回放的累计event数量对1024取模余1 当前时间减去上次日志时间间隔大于mts_online_stat_period(硬编码120)秒 error log日志级别为info(log_error_verbosity=3) 上述几个条件,和并行回放的事务繁忙程度并没有太大的关系,满足条件即会记录日志。假如一个事务有4个event,参数设置正常,每两分钟执行256个事务,就会输出一条日志信息,一秒钟3个事务不到。 日志解析观察 在我的日志文件中,取了如下两条连续的信息 2023-07-09T08:58:01.001019+08:00 909 [Note] [MY-010559] [Repl] Multi-threaded slave statistics for channel 'group_replication_applier': seconds elapsed = 180; events assigned = 11515905; worker queues filled over overrun level = 8314; waited due a Worker queue full = 0; waited due the total size = 0; waited at clock conflicts = 136628031500 waited (count) when Workers occupied = 242457 waited when Workers occupied = 2223254351900 2023-07-09T09:00:01.648124+08:00 909 [Note] [MY-010559] [Repl] Multi-threaded slave statistics for channel 'group_replication_applier': seconds elapsed = 120; events assigned = 11518977; worker queues filled over overrun level = 8314; waited due a Worker queue full = 0; waited due the total size = 0; waited at clock conflicts = 136644607700 waited (count) when Workers occupied = 242491 waited when Workers occupied = 2223755727800 第一条解析信息如下: . 本次日志输出时间点为2023-07-09T08:58:01.001019 . 与上次日志输出间隔时间为180秒 . 累计处理event数量为11515905 . worker线程处理的event队列长度超过最大队列数(目前代码硬编码16384)的90%的累计次数8314次 . worker线程处理的event队列长度达到最大队列数(目前代码硬编码16384)的累计次数为0次 . 回放event大小达到replica_pending_jobs_size_max或者slave_pending_jobs_size_max的次数为0 . 由于不能并行回放而产生的累计等待时间为136628031500纳秒(约136.62秒) . 协调线程累计休眠242457次 . 累计等待空闲worker线程的时间为2223254351900纳秒(约2223.33秒) 第二条解析信息如下: . 本次日志输出时间点为2023-07-09T09:00:01.648124 . 与上次日志输出间隔时间为120秒 . 累计处理event数量为11518977,新增处理event数量3072(为1024的3倍) . worker线程处理的event队列长度超过最大队列数(目前代码硬编码16384)的90%的累计次数8314次,新增0次 . worker线程处理的event队列长度达到最大队列数(目前代码硬编码16384)的累计次数为0次 . 回放event大小达到replica_pending_jobs_size_max或者slave_pending_jobs_size_max的次数为0 . 由于不能并行回放而产生的累计等待时间为136644607700纳秒(约136.64秒,新增等待约0.02秒) . 协调线程累计休眠242457次,新增34次 . 累计等待空闲worker线程的时间为2223755727800纳秒(约2223.38,新增等待约0.05秒) 通过上述信息,可以看出,在日志阶段,系统处于空闲状态,处理事务数不多。 对比各个参数,在系统繁忙时,因为不能并行回放产生的等待时间为136.64秒,等待空闲的worker线程累计时间为2223.38,因此增大slave_parallel_workers的参数值,可以提升并行回放性能。 总结 [Note] [MY-010559]在我刚开始接触时,以为是系统出现了异常产生的日志,待真正了解其内容后,才发现通过该日志可以帮助我们了解MTS运行情况,针对性的做优化调整。 参考链接https://dev.mysql.com/doc/refman/8.0/en/replication-threads-monitor-worker.html Enjoy GreatSQL :) 关于 GreatSQL GreatSQL是适用于金融级应用的国内自主开源数据库,具备高性能、高可靠、高易用性、高安全等多个核心特性,可以作为MySQL或Percona Server的可选替换,用于线上生产环境,且完全免费并兼容MySQL或Percona Server。 相关链接: GreatSQL社区 Gitee GitHub Bilibili GreatSQL社区: 社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html 社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html (对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~) 技术交流群: 微信&QQ群: QQ群:533341697 微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

优秀的个人博客,低调大师

Vitals —— GNOME Shell 系统监控扩展

Vitals 是一个 GNOME Shell 扩展,用于在 GNOME Shell 的顶部菜单栏中显示计算机的温度、电压、风扇速度、内存使用情况、处理器负载、系统资源、网络速度和存储统计信息。Vitals 使用异步轮询来提供流畅的用户体验。 安装 1. 安装支持包 Ubuntu / Debian sudo apt install gir1.2-gtop-2.0 lm-sensors Fedora sudo dnf install libgtop2-devel lm_sensors Arch / Manjaro sudo pacman -Syu libgtop lm_sensors gnome-icon-theme-symbolic gnome-icon-theme git 2. 安装扩展 Ubuntu/Debian/Fedora 访问 Gnome Extensions 网站 ,搜索 Vitals 并单击 switch 图标 Arch/ Manjaro git clone https://aur.archlinux.org/gnome-shell-extension-vitals-git.git/ cd gnome-shell-extension-vitals-git # always verify content before installing less PKGBUILD makepkg # example filename, different each release pacman -U gnome-shell-extension-vitals-git-v52.0.4.r0.gb446cfc-1-any.pkg.tar.zst

优秀的个人博客,低调大师

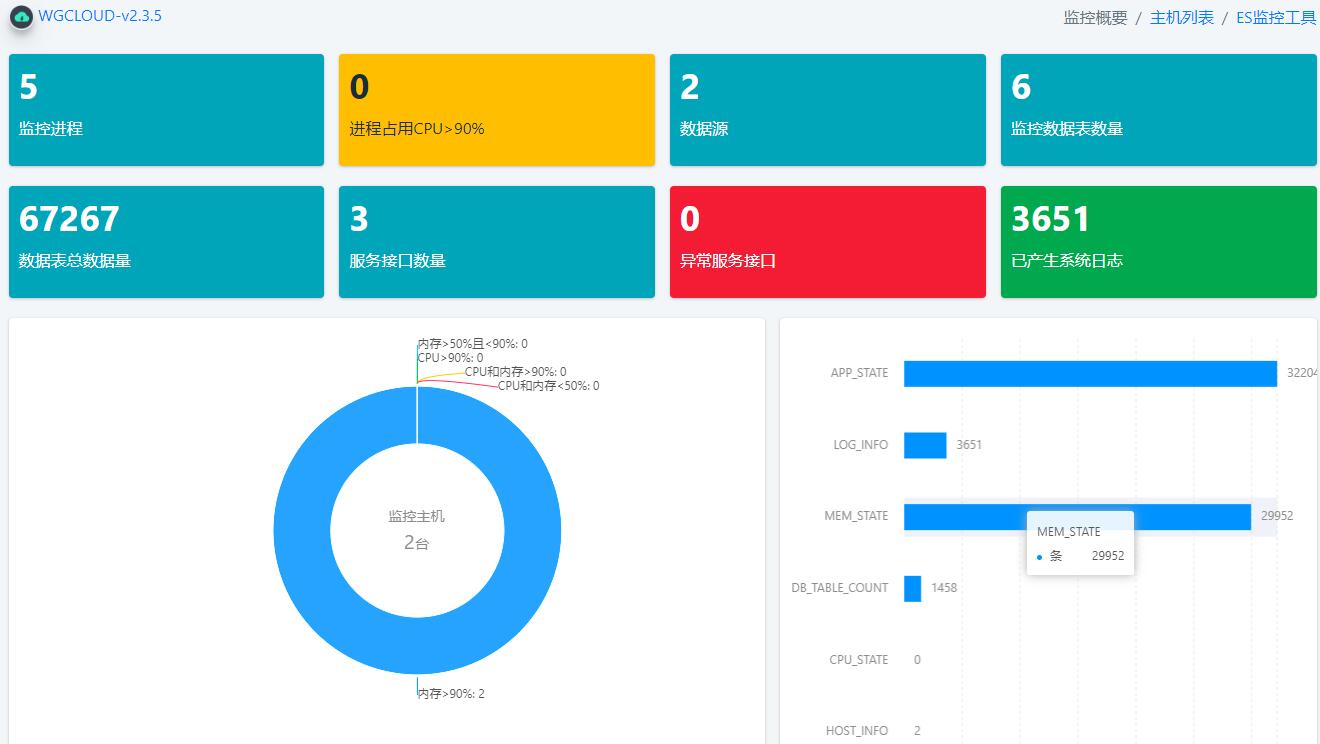
开源日志监控平台 0.6.2 发布

### Feature * 移除spi模块,相关功能移至monitor [2022-04-05] * 微信机器人、钉钉机器人和http报警消息格式支持markdown * 增加用户密码设置功能,方便没有部署ldap的团队使用。配置了ldap的将优先使用ldap认证。 * 移除xxl-job依赖,内置实现分布式调度,减小部署难度 * elasticsearch数据源https支持pkcs12证书 * 数据预览前端增加参数校验提示 * 数据源增加Elasticsearch8支持 * [0.6.2] Elasticsearch数据配置支持数据分桶,分桶类型支持:1. 按字段值分组,相当于ES里的Terms Aggregation. * [0.6.2] Elasticsearch数据配置支持数据分桶,分桶类型支持:2. 按时间分组,相当于ES里的DateHistogramAggregation. ### Bugfix * 解决查询elasticsearch索引字段查询报错的问题 [2022-04-27] ### Document * 增加0.5升级0.6的说明文档 * 增加markdown格式消息使用文档说明 * 增加0.6升级0.6.1的说明文档 * 增加k8s环境部署说明 * 增加项目代码规范说明文档 ### Others * 优化frostmourne-vue模块,支持较新版本node和npm支持; 引入frontend-maven-plugin插件,打包自动管理node和yarn使用特定版本

优秀的个人博客,低调大师

Prometheus监控神器-Kubernetes篇(三)

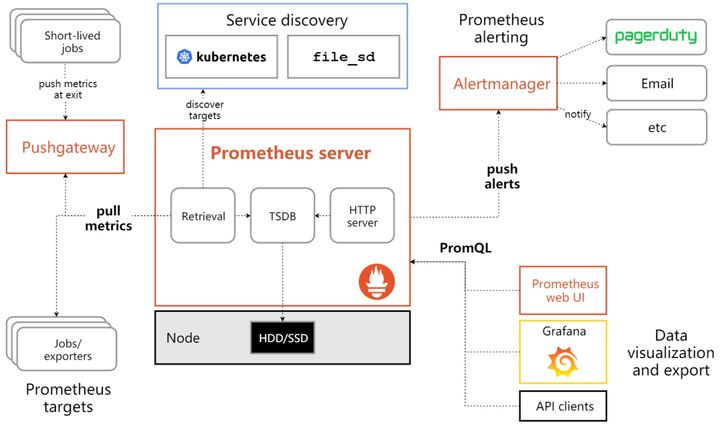
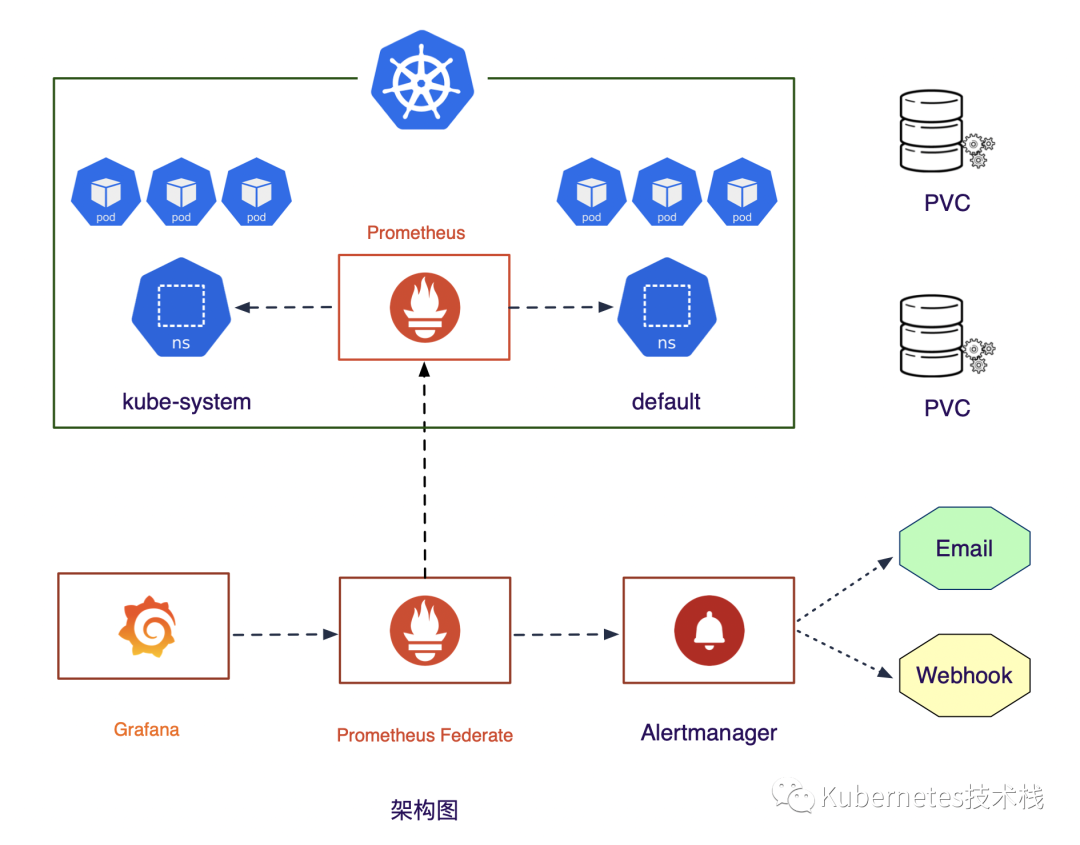
在Kubernetes中手动方式部署Prometheus联邦. monitor-prom 当我们有多个Kubernetes集群的时候,这个时候就需要需要指标汇总的需求了,如上图一样,我们假定在外部部署一个Prometheus的Federate,然后去采集当前k8s中的kube-system与default俩个 namespace。 环境 我的本地环境使用的 sealos 一键部署,主要是为了便于测试。 OS Kubernetes HostName IP Service Ubuntu 18.04 1.17.7 sealos-k8s-m1 192.168.1.151 node-exporter prometheus-federate-0 Ubuntu 18.04 1.17.7 sealos-k8s-m2 192.168.1.152 node-exporter grafana alertmanager-0 Ubuntu 18.04 1.17.7 sealos-k8s-m3 192.168.1.150 node-exporter alertmanager-1 Ubuntu 18.04 1.17.7 sealos-k8s-node1 192.168.1.153 node-exporter prometheus-0 kube-state-metrics Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.154 node-exporter prometheus-1 Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.155 node-exporter prometheus-2 部署 Prometheus联邦集群 创建prometheus-federate数据目录 #在m1上执行mkdir/data/prometheus-federate/chown-R65534:65534/data/prometheus-federate/ 创建Prometheus联邦 StorageClass 配置文件 cd/data/manual-deploy/prometheus/catprometheus-federate-storageclass.yamlapiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:prometheus-federate-lpvprovisioner:kubernetes.io/no-provisionervolumeBindingMode:WaitForFirstConsumer 创建Prometheus联邦pv配置文件 apiVersion:v1kind:PersistentVolumemetadata:name:prometheus-federate-lpv-0spec:capacity:storage:10GivolumeMode:FilesystemaccessModes:-ReadWriteOncepersistentVolumeReclaimPolicy:RetainstorageClassName:prometheus-federate-lpvlocal:path:/data/prometheus-federatenodeAffinity:required:nodeSelectorTerms:-matchExpressions:-key:kubernetes.io/hostnameoperator:Invalues:-sealos-k8s-m1 创建Prometheus联邦configmap配置文件 catprometheus-federate-configmap.yamlapiVersion:v1kind:ConfigMapmetadata:name:prometheus-federate-confignamespace:kube-systemdata:alertmanager_rules.yaml:|groups:-name:examplerules:-alert:InstanceDownexpr:up==0for:1mlabels:severity:pageannotations:summary:"Instance{{$labels.instance}}down"description:"{{$labels.instance}}ofjob{{$labels.job}}hasbeendownformorethan1minutes."-alert:NodeMemoryUsageexpr:(node_memory_MemTotal_bytes-(node_memory_MemFree_bytes+node_memory_Buffers_bytes+node_memory_Cached_bytes))/node_memory_MemTotal_bytes*100>80for:1mlabels:team:opsannotations:summary:"cluster:{{$labels.cluster}}{{$labels.instance}}:HighMemoryusagedetected"description:"{{$labels.instance}}:Memoryusageisabove55%(currentvalueis:{{$value}}"prometheus.yml:|global:scrape_interval:30sevaluation_interval:30salerting:alertmanagers:-static_configs:-targets:-alertmanager-0.alertmanager-operated:9093-alertmanager-1.alertmanager-operated:9093rule_files:-"/etc/prometheus/alertmanager_rules.yaml"scrape_configs:-job_name:'federate'scrape_interval:30shonor_labels:truemetrics_path:'/federate'params:'match[]':-'{job=~"kubernetes.*"}'-'{job="prometheus"}'static_configs:-targets:-'prometheus-0.prometheus:9090'-'prometheus-1.prometheus:9090'-'prometheus-2.prometheus:9090' 创建Prometheus联邦的statefulse文件 catprometheus-federate-statefulset.yamlapiVersion:apps/v1kind:StatefulSetmetadata:name:prometheus-federatenamespace:kube-systemlabels:k8s-app:prometheus-federatekubernetes.io/cluster-service:"true"spec:serviceName:"prometheus-federate"podManagementPolicy:"Parallel"replicas:1selector:matchLabels:k8s-app:prometheus-federatetemplate:metadata:labels:k8s-app:prometheus-federateannotations:scheduler.alpha.kubernetes.io/critical-pod:''spec:affinity:podAntiAffinity:requiredDuringSchedulingIgnoredDuringExecution:-labelSelector:matchExpressions:-key:k8s-appoperator:Invalues:-prometheus-federatetopologyKey:"kubernetes.io/hostname"priorityClassName:system-cluster-criticalhostNetwork:truednsPolicy:ClusterFirstWithHostNetcontainers:-name:prometheus-federate-configmap-reloadimage:"jimmidyson/configmap-reload:v0.4.0"imagePullPolicy:"IfNotPresent"args:---volume-dir=/etc/config---webhook-url=http://localhost:9091/-/reloadvolumeMounts:-name:config-volumemountPath:/etc/configreadOnly:trueresources:limits:cpu:10mmemory:10Mirequests:cpu:10mmemory:10MisecurityContext:runAsUser:0privileged:true-image:prom/prometheus:v2.20.0imagePullPolicy:IfNotPresentname:prometheuscommand:-"/bin/prometheus"args:-"--web.listen-address=0.0.0.0:9091"-"--config.file=/etc/prometheus/prometheus.yml"-"--storage.tsdb.path=/prometheus"-"--storage.tsdb.retention=24h"-"--web.console.libraries=/etc/prometheus/console_libraries"-"--web.console.templates=/etc/prometheus/consoles"-"--web.enable-lifecycle"ports:-containerPort:9091protocol:TCPvolumeMounts:-mountPath:"/prometheus"name:prometheus-federate-data-mountPath:"/etc/prometheus"name:config-volumereadinessProbe:httpGet:path:/-/readyport:9091initialDelaySeconds:30timeoutSeconds:30livenessProbe:httpGet:path:/-/healthyport:9091initialDelaySeconds:30timeoutSeconds:30resources:requests:cpu:100mmemory:100Milimits:cpu:1000mmemory:2500MisecurityContext:runAsUser:0privileged:trueserviceAccountName:prometheusvolumes:-name:config-volumeconfigMap:name:prometheus-federate-configvolumeClaimTemplates:-metadata:name:prometheus-federate-dataspec:accessModes:["ReadWriteOnce"]storageClassName:"prometheus-federate-lpv"resources:requests:storage:5Gi 创建Prometheus联邦的svc文件 catprometheus-service-statefulset.yamlapiVersion:v1kind:Servicemetadata:name:prometheusnamespace:kube-systemspec:ports:-name:prometheusport:9090targetPort:9090selector:k8s-app:prometheusclusterIP:None 部署 cd/data/manual-deploy/prometheus/prometheus-federate-configmap.yamlprometheus-federate-pv.yamlprometheus-federate-service-statefulset.yamlprometheus-federate-statefulset.yamlprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-pv.yamlkubectlapply-fprometheus-federate-configmap.yamlkubectlapply-fprometheus-federate-statefulset.yamlkubectlapply-fprometheus-federate-service-statefulset.yaml 验证 #pvkubectl-nkube-systemgetpvc|grepfederateprometheus-federate-data-prometheus-federate-0Boundprometheus-federate-lpv-010GiRWOprometheus-federate-lpv4hkubectl-nkube-systemgetpod|grepfederateprometheus-federate-02/2Running02d4h 对此,联邦的配置就完成了,可以在浏览器中访问192.168.1.151:9091查看相应的targets信息,以及配置的rules规则,触发下警报,看看Alertmanager集群已经部署成功了。 k8s-federate 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Prometheus监控神器-Alertmanager篇(四)

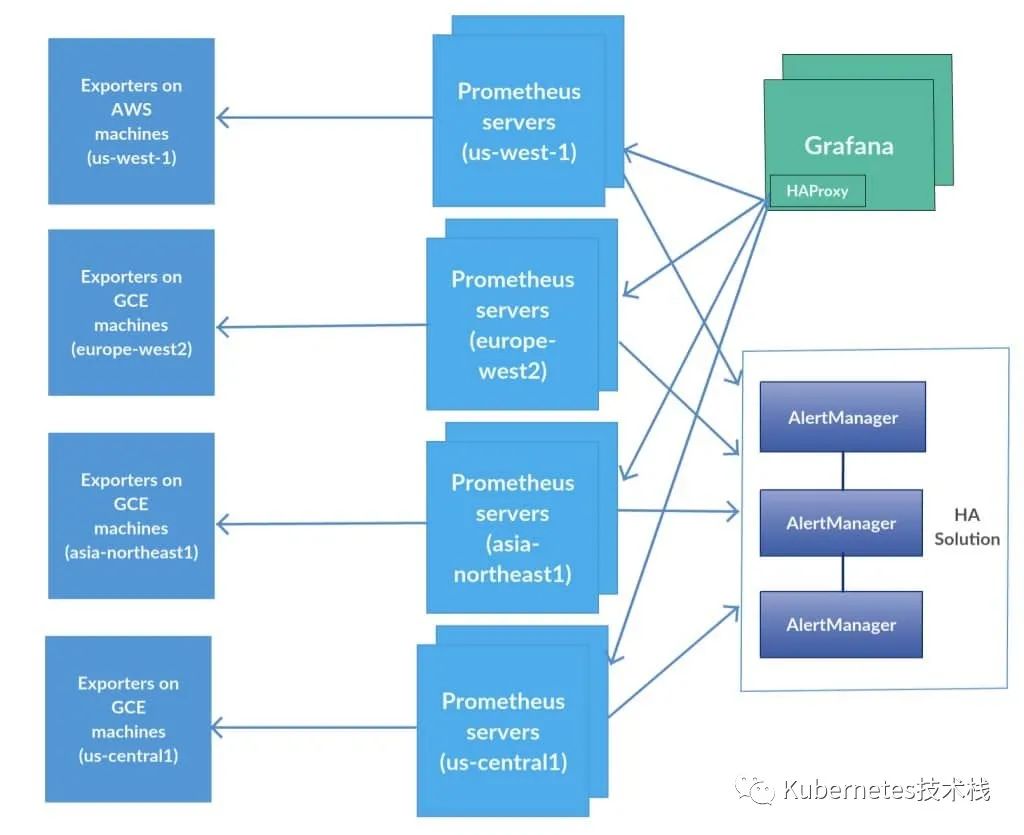
本章节主要讲解Alertmanager高可用的搭建与配置的详细的内容。 为了提升Prometheus的服务可靠性,我们会部署两个或多个的Prometheus服务,两个Prometheus具有相同的配置(Job配、告警规则、等),当其中一个Down掉了以后,可以保证Prometheus持续可用。 AlertManager自带警报分组机制,即使不同的Prometheus分别发送相同的警报给Alertmanager,Alertmanager也会自动把这些警报合并处理。 去重 分组 路由 Daduplicates Groups Route 将相同的警报合并成一个 根据定义的分组 经过路由分发给指定的receiver 虽然Alertmanager 能够同时处理多个相同的Prometheus的产生的警报,如果部署的Alertmanager是单节点,那就存在明显的的单点故障风险,当Alertmanager节点down机以后,警报功能则不可用。 解决这个问题的方法就是使用传统的HA架构模式,部署Alertmanager多节点。但是由于Alertmanager之间关联存在不能满足HA的需求,因此会导致警报通知被Alertmanager重复发送多次的问题。 alertmanager-ha Alertmanager为了解决这个问题,引入了Gossip机制,为多个Alertmanager之间提供信息传递机制。确保及时的在多个Alertmanager分别接受到相同的警报信息的情况下,不会发送重复的警报信息给Receiver. Gossip 机制 要知道什么是Gossip机制,必须了解清楚Alertmanager中的每一次警报通知是如何产生的,下面一图很详细的阐述了警报个流程: alertmanager-ha 阶段 描述 Silence 在这个阶段中Alertmanager会判断当前通知是否匹配任何静默规则;如果没有则进入下一个阶段,否则会中断流程不发送通知。 Wait Alertmanager 会根据当前集群中所处在的顺序[index],等待 index * 5s 的时间。 Dedup 当等待结束完成,进入 Dedup 阶段,这时会判断当前Alertmanager TSDB中警报是否已经发送,如果发送则中断流程,不发送警报。 Send 如果上面的未发送,则进入 Send 阶段,发送警报通知。 Gossip 警报发送成功以后,进入最后一个阶段 Gossip ,通知其他Alertmanager节点,当前警报已经发送成功。其他Alertmanager节点会保存当前已经发送过的警报记录。 Gossip俩个关键: Alertmanager 节点之间的Silence设置相同,这样确保了设置为静默的警报都不会对外发送 Alertmanager 节点之间通过Gossip机制同步警报通知状态,并且在流程中标记Wait阶段,保证警报是依次被集群中的Alertmanager节点读取并处理。 搭建本地 Alertmanager 集群 启动Alertmanager集群之前,需要了解一些集群相关的参数 参数 说明 --cluster.listen-address="0.0.0.0:9094" 集群服务监听端口 --cluster.peer 初始化关联其他节点的监听地址 --cluster.advertise-address 广播地址 --cluster.gossip-interval 集群消息传播时间,默认 200s --cluster.probe-interval 各个节点的探测时间间隔 # 直接复制之前已经安装过的Alertmanager文件夹cp -r alertmanager/ /usr/local/alertmanager01cp -r alertmanager/ /usr/local/alertmanager02cp -r alertmanager/ /usr/local/alertmanager03# 复制完成以后,写入启动脚本,# Alertmanager01cat << EOF> /lib/systemd/system/alertmanager01.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager01/bin/alertmanager \--config.file=/usr/local/alertmanager01/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager01/data \--web.listen-address=":19093" \--cluster.listen-address=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager02cat << EOF> /lib/systemd/system/alertmanager02.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager02/bin/alertmanager \--config.file=/usr/local/alertmanager02/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager02/data \--web.listen-address=":29093" \--cluster.listen-address=192.168.1.220:29094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager03cat <<EOF > /lib/systemd/system/alertmanager03.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager03/bin/alertmanager \--config.file=/usr/local/alertmanager03/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager03/data \--web.listen-address=":39093" \--cluster.listen-address=192.168.1.220:39094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# 开启systemd脚本启动systemctl enable alertmanager01 alertmanager02 alertmanager03systemctl start alertmanager01 alertmanager02 alertmanager03 启动完成后,就可以访问http://192.168.1.220:19093可以看到以下集群状态了,我这里是为了测试,本地启动了多个端口,如果是实际生产环境中,是不同节点以及不同的IP,这些根据自己的需求设计即可。 alert-gossip Prometheus中的配置: alerting: alert_relabel_configs: - source_labels: [dc] regex: (.+)\d+ target_label: dc alertmanagers: - static_configs: #- targets: ['127.0.0.1:9093'] - targets: ['192.168.1.220:19093','192.168.1.220:29093','192.168.1.220:39093'] 配置完成以后,重启或者reloadPrometheus服务,访问http://192.168.1.220:19090/config就可以看到具体的配置信息了。 prom-config 到此,Alertmanager集群配置就完成了,对于进群中的警报测试很简单,直接down掉一个端口,然后触发警报,看看警报是否可以正常发送。 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册