首页 文章 精选 留言 我的

精选列表

搜索[数仓建模],共10000篇文章
优秀的个人博客,低调大师

Apache Committer 数突破 10000

Apache 软件基金会 (ASF) 发文宣布迎来了一个新的重要里程碑:即,其 committer 人数达到了 10,000 位。 在 ASF 项目中,committer 是指那些长期以来对项目做出贡献并证明自身价值的项目贡献者。由于其贡献,项目内的其他 committer 可授予其此身份。社区赋予 committer 责任,帮助他们打造一款能够超越任何特定志愿者兴趣的产品。虽然 committer 并非 ASF 的正式成员(拥有基金会投票权),但他们仍然对项目负有诸多责任,包括: 制定发布计划和发布版本 应用补丁 帮助用户 监控commits 和 issues 对此,ASF 联合创始人 Brian Behlendorf 发言称,“尽管如今我们拥有各种 AI 软件开发工具,但最终决定软件功能、制定实现方式、编写测试、审查代码、调试结果、向上游提交补丁以及集成下游拉取请求的,仍然是人类。单打独斗的开发者神话或许浪漫,但现实是,真正的软件工程既是一项技术工作,也是一项社会工作。” “一万名开发者是一个了不起的里程碑——但同样令人印象深刻的是,如此多对现代世界运转至关重要的生产级软件,竟然是由一万名完全自愿的开发者共同编写的。每位开发者都值得我们致敬。” ASF 主席 Ruth Suehle 则表示,“突破 10,000 位提交者大关是一个里程碑,它彰显了社区的力量和成功,超越了代码本身,也体现了 Apache 之道。每一位提交者都为构建一个为了共同目标——为公共利益而开发的软件——而蓬勃发展的协作空间做出了贡献。今天,我们将回顾这段历史,并向这 10,000 位提交者致以诚挚的谢意,也期待未来更多提交者加入。”

优秀的个人博客,低调大师

详解数仓的3A安全能力

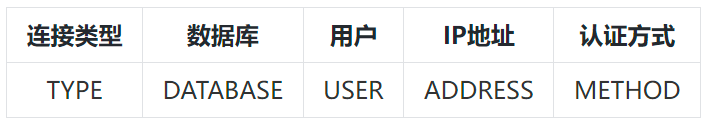
本文分享自华为云社区《GaussDB(DWS) 3A安全能力》,作者:yd_281561943。 1. 前言 适用版本:【8.0.0 (及以上)】 数据库安全是指保护数据库以防止未授权用户窃取、篡改和破坏数据库中数据信息的技术。数据库安全技术可以简单分为3个A: Authentication(认证):认证解决让谁进来的问题(进门) Authorization(授权):授权解决能干啥的问题(干活) Audit(审计):审计解决干了啥的问题(监控) 2. Authentication——认证 连接认证解决用户能否登录数据库的问题。本产品支持如下几种认证方式: 基于主机的认证:服务器端根据客户端的IP地址、用户名及要访问的数据库来查看配置文件从而判断用户是否通过认证。 口令认证:包括远程连接的加密口令认证和本地连接的非加密口令认证。 证书认证:此模式需进行SSL连接配置且需要客户端提供有效的SSL证书,不需要提供用户密码。 第三方认证:ldap、oneaccess等 这几种方式都需要配置“pg_hba.conf”文件,pg_hba.conf文件格式,pg_hba有若干行的HBA记录组成: 一条HBA记录的含义是允许哪些用户(USER),从哪些IP地址(ADDRESS),以哪种连接类型(TYPE),以哪种认证方式(METHOD),连接哪些数据库(DATABASE)。 认证时对每个连接请求从下到下依次检查hba文件中的记录,如果当前记录匹配,就返回。 HBA记录的顺序非常关键。hba的这种逻辑非常重要,轻易不应该变动,否则会引发非常严重的问题。 案例:hba逻辑变动引发的问题 ldap连接出现过一个问题,升级过程中pg_hba.conf文件中的记录会排序,导致升级前后ldap配置行顺序变化,到sha256配置行后面了。由于pg_hba.conf的顺序遍历机制,升级后ldap用户错误匹配到sha256配置行,连接失败。 为解决顺序变动引发的问题,第一版的修改方案是将ldap判断逻辑放在循环遍历的开始位置:先看认证类型,如果是ldap认证就判断配置行method字段是否为ldap,不是就跳到下一行,直到找到method是ldap的为止。 在这版修改方案下,ldap认证方式的连接匹配到的都是ldap的hba记录。用户连接数据库时,可以成功连接,但是业务却无法进行,报错:“Invalid username/password,login denied.”。原因是内部节点执行语句时会进行节点之间的认证,认证类型为trust,不会提供密码。修改之后只会匹配到ldap记录,ldap方式需要密码,从而报错。 升级前后,ldap与sha256配置行位置如下: 升级前: host all @/etc/ldap/ldap_user 0.0.0.0/0 ldap ldapserver=xxx.xxx.xxx.xxx ldapport=xxx ldapprefix="CN=" ldapsuffix="OU=test_dmj_group,DC=com" host all all 0.0.0.0/0 sha256 升级后: host all all 0.0.0.0/0 sha256 host all @/etc/ldap/ldap_user 0.0.0.0/0 ldap ldapserver=xxx.xxx.xxx.xxx ldapport=xxx ldapprefix="CN=" ldapsuffix="OU=test_dmj_group,DC=com" TYPE:type是local、host、hostssl、hostnossl四种之一。 分别表示: local: 仅允许unix domain socket连接。 host: 允许TCP/IP连接,可以匹配SSL和非SSL的连接请求。 hostssl: 允许TCP/IP连接,仅匹配SSL的连接请求。 hostnossl: 允许TCP/IP连接,仅匹配非SSL的连接请求。 DATABASE:可以用all表示所有数据库,也可以用逗号分隔显式指定数据库。 USER:可以用all表示所有用户,也可以用逗号分隔显式指定用户。可以是特定数据库用户的名称,也可以是前面带有+的组名称。+标记实际上意味着“匹配直接或间接属于该角色的任何角色” ,而没有+标记的名称仅匹配该特定角色。 ADDRESS:声明记录所匹配且允许访问的地址。type是local时,表示本机连接,不需要指定IP地址。 METHOD:认证方式有trust、reject、md5、sha256、ldap、cert、oneaccess等。 trust:白名单,无条件允许连接。 reject:黑名单,无条件拒绝连接。 md5: pg的password认证方式,不安全。 sha256: gaussdb的password认证。 ldap:使用LDAP进行第三方认证。 cert:客户端证书认证模式,此模式需进行SSL连接配置且需要客户端提供有效的SSL证书,不需要提供用户密码。 oneaccess:使用oneaccess进行第三方认证。 3.Authorization——授权 权限表示用户对某个数据库对象的操作是否被允许。GaussDB(DWS)中的权限包含三种场景:系统权限、数据对象权限、用户权限。 3.1 系统权限 3.1.1 三权分立 默认情况下拥有SYSADMIN属性的系统管理员,具备系统最高权限。在实际业务管理中,为了避免系统管理员拥有过度集中的权利带来高风险,可以设置三权分立,将系统管理员的CREATEROLE属性和AUDITADMIN属性权限分别给安全管理员和审计管理员。 3.1.2 系统权限授权 系统权限又称为用户属性,包括SYSADMIN、CREATEDB、CREATEROLE、AUDITADMIN和LOGIN。 系统权限可以在创建、修改角色或者用户时进行授权,CREATE/ALTER ROLE/USER user_name [WITH] option语句的option中,可以设置以下字段,来实现系统权限赋权。 SYSADMIN | NOSYSADMIN 决定一个新角色是否为“系统管理员”,具有SYSADMIN属性的角色拥有系统最高权限。缺省为NOSYSADMIN。 AUDITADMIN | NOAUDITADMIN 定义角色是否有审计管理属性。缺省为NOAUDITADMIN。 CREATEDB | NOCREATEDB 决定一个新角色是否能创建数据库。新角色没有创建数据库的权限。缺省为NOCREATEDB。 CREATEROLE | NOCREATEROLE 决定一个角色是否可以创建新角色(也就是执行CREATE ROLE和CREATE USER)。 一个拥有CREATEROLE权限的角色也可以修改和删除其他角色。缺省为NOCREATEROLE。 LOGIN | NOLOGIN 具有LOGIN属性的角色才可以登录数据库。一个拥有LOGIN属性的角色可以认为是一个用户。缺省为NOLOGIN。 3.2 数据对象权限 数据对象包括表和视图、指定字段、数据库、函数、模式等,对它们的创建、增、删、改、查等操作就是数据对象权限。授权语法格式为:GRANT [privileges] ON [objects] TO [users],回收权限语法格式为REVOKE [privileges] ON [objects] FROM [users]。 3.3 用户权限 3.3.1 用户权限授权 将一个角色或用户的权限授予一个或多个其他角色或用户。被授权的角色或用户就拥有授权的角色或用户的权限。当声明了WITH ADMIN OPTION,被授权的用户可以将该权限再次授予其他角色或用户,以及撤销所有由该角色或用户继承到的权限。当授权的角色或用户发生变更或被撤销时,所有继承该角色或用户权限的用户拥有的权限都会随之发生变更。语法格式为GRANT role TO user。 3.3.2 预置角色 GaussDB(DWS)提供了一组预置角色,以“gs_role_”开头命名,这些预置角色具有一些固定的权限。当某些用户需要进行相关操作,只需要把预置角色授给用户即可。目前GaussDB(DWS)的预置角色如下表: 4.Audit——审计 审计是指记录用户的登陆退出以及登陆后在数据库里的行为操作,使得数据库安全管理员可以利用这些日志信息,找出非法操作的用户,时间和内容等。 4.1 设置审计配置项 要使数据库能够审计到某项功能,需要打开审计的总开关(audit_enabled)和对应的审计项开关(audit_operation_exec),二者均支持动态加载,在数据库运行期间修改该配置项的值会立即生效,无需重启数据库。 有两点需要注意,其一如果审计ddl操作,需要另外配置audit_system_object 来审计具体某个对象的ddl 操作;其二如果是审计事务,事务内部的操作是否审计需要结合其具体的配置项是否配置。审计项的参数控制: 4.2 查看审计日志 审计查询命令是pgxc_query_audit: select * from pgxc_query_audit(timestamptz startime,timestamptz endtime,audit_log); startime 和 endtime 分别表示审计记录的开始时间和结束时间,audit_log 表示所查看的审计日志新的所在的物理文件路径,当不指定audit_log 时,默认查看连接当前实例的审计日志信息。审计查询结果如下例: postgres=# create table t1(id int); ERROR: relation "t1" already exists postgres=# select * from pgxc_query_audit('2021-03-21','2021-03-30') order by endtime desc limit 1; -[ RECORD 1 ]---+-------------------------------- begintime | 2021-03-21 11:49:41.643+08 endtime | 2021-03-21 11:49:41.652+08 operation_type | ddl audit_type | ddl_table result | failed username | perfadm database | postgres client_conninfo | gsql@[local] object_name | t1 command_text | create table t1(id int); detail_info | relation "t1" already exists transaction_xid | 0 query_id | 1062177 node_name | cn_5001 thread_id | 139916885260032@669613657906735 local_port | 6000 remote_port | 5. 其他数据仓库安全技术 数据安全展示:数据脱敏、行级访问控制。 数据安全存储:数据存储加密、透明加密。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

解读数仓常用模糊查询的优化方法

摘要:本文讲解了GaussDB(DWS)上模糊查询常用的性能优化方法,通过创建索引,能够提升多种场景下模糊查询语句的执行速度。 本文分享自华为云社区《GaussDB(DWS) 模糊查询性能优化》,作者: 黎明的风 。 在使用GaussDB(DWS)时,通过like进行模糊查询,有时会遇到查询性能慢的问题。 (一)LIKE模糊查询 通常的查询语句如下: select * from t1 where c1 like 'A123%'; 当表t1的数据量大时,使用like进行模糊查询,查询的速度非常慢。 通过explain查看该语句生成的查询计划: test=# explain select * from t1 where c1 like 'A123%'; QUERY PLAN ----------------------------------------------------------------------------- id | operation | E-rows | E-memory | E-width | E-costs ----+------------------------------+--------+----------+---------+--------- 1 | -> Streaming (type: GATHER) | 1 | | 8 | 16.25 2 | -> Seq Scan on t1 | 1 | 1MB | 8 | 10.25 Predicate Information (identified by plan id) --------------------------------------------- 2 --Seq Scan on t1 Filter: (c1 ~~ 'A123%'::text) 查询计划显示对表t1进行了全表扫描,因此在表t1数据量大的时候执行速度会比较慢。 上面查询的模糊匹配条件 'A123%',我们称它为后模糊匹配。这种场景,可以通过建立一个BTREE索引来提升查询性能。 建立索引时需要根据字段数据类型设置索引对应的operator,对于text,varchar和char分别设置和text_pattern_ops,varchar_pattern_ops和bpchar_pattern_ops。 例如上面例子里的c1列的类型为text,创建索引时增加text_pattern_ops,建立索引的语句如下: CREATE INDEX ON t1 (c1 text_pattern_ops); 增加索引后打印查询计划: test=# explain select * from t1 where c1 like 'A123%'; QUERY PLAN ---------------------------------------------------------------------------------------- id | operation | E-rows | E-memory | E-width | E-costs ----+-----------------------------------------+--------+----------+---------+--------- 1 | -> Streaming (type: GATHER) | 1 | | 8 | 14.27 2 | -> Index Scan using t1_c1_idx on t1 | 1 | 1MB | 8 | 8.27 Predicate Information (identified by plan id) ---------------------------------------------------------------------- 2 --Index Scan using t1_c1_idx on t1 Index Cond: ((c1 ~>=~ 'A123'::text) AND (c1 ~<~ 'A124'::text)) Filter: (c1 ~~ 'A123%'::text) 在创建索引后,可以看到语句执行时会使用到前面创建的索引,执行速度会变快。 前面遇到的问题使用的查询条件是后缀的模糊查询,如果使用的是前缀的模糊查询,我们可以看一下查询计划是否有使用到索引。 test=# explain select * from t1 where c1 like '%A123'; QUERY PLAN ----------------------------------------------------------------------------- id | operation | E-rows | E-memory | E-width | E-costs ----+------------------------------+--------+----------+---------+--------- 1 | -> Streaming (type: GATHER) | 1 | | 8 | 16.25 2 | -> Seq Scan on t1 | 1 | 1MB | 8 | 10.25 Predicate Information (identified by plan id) --------------------------------------------- 2 --Seq Scan on t1 Filter: (c1 ~~ '%A123'::text) 如上图所示,当查询条件变成前缀的模糊查询,之前建的索引将不能使用到,查询执行时进行了全表的扫描。 这种情况,我们可以使用翻转函数(reverse),建立一个索引来支持前模糊的查询,建立索引的语句如下: CREATE INDEX ON t1 (reverse(c1) text_pattern_ops); 将查询语句的条件采用reverse函数进行改写之后,输出查询计划: test=# explain select * from t1 where reverse(c1) like 'A123%'; QUERY PLAN ------------------------------------------------------------------------------------------ id | operation | E-rows | E-memory | E-width | E-costs ----+-------------------------------+--------+----------+---------+--------- 1 | -> Streaming (type: GATHER) | 5 | | 8 | 14.06 2 | -> Bitmap Heap Scan on t1 | 5 | 1MB | 8 | 8.06 3 | -> Bitmap Index Scan | 5 | 1MB | 0 | 4.28 Predicate Information (identified by plan id) ---------------------------------------------------------------------------------------- 2 --Bitmap Heap Scan on t1 Filter: (reverse(c1) ~~ 'A123%'::text) 3 --Bitmap Index Scan Index Cond: ((reverse(c1) ~>=~ 'A123'::text) AND (reverse(c1) ~<~ 'A124'::text)) 语句经过改写后,可以走索引, 查询性能得到提升。 (二)指定collate来创建索引 如果使用默认的index ops class时,要使b-tree索引支持模糊的查询,就需要在查询和建索引时都指定collate="C"。 注意:索引和查询条件的collate都一致的情况下才能使用索引。 创建索引的语句为: CREATE INDEX ON t1 (c1 collate "C"); 查询语句的where条件中需要增加collate的设置: test=# explain select * from t1 where c1 like 'A123%' collate "C"; QUERY PLAN ---------------------------------------------------------------------------------------- id | operation | E-rows | E-memory | E-width | E-costs ----+-----------------------------------------+--------+----------+---------+--------- 1 | -> Streaming (type: GATHER) | 1 | | 8 | 14.27 2 | -> Index Scan using t1_c1_idx on t1 | 1 | 1MB | 8 | 8.27 Predicate Information (identified by plan id) ------------------------------------------------------------------ 2 --Index Scan using t1_c1_idx on t1 Index Cond: ((c1 >= 'A123'::text) AND (c1 < 'A124'::text)) Filter: (c1 ~~ 'A123%'::text COLLATE "C") (三)GIN倒排索引 GIN(Generalized Inverted Index)通用倒排索引。设计为处理索引项为组合值的情况,查询时需要通过索引搜索出出现在组合值中的特定元素值。例如,文档是由多个单词组成,需要查询出文档中包含的特定单词。 下面举例说明GIN索引的使用方法: create table gin_test_data(id int, chepai varchar(10), shenfenzheng varchar(20), duanxin text) distribute by hash (id); create index chepai_idx on gin_test_data using gin(to_tsvector('ngram', chepai)) with (fastupdate=on); 上述语句在车牌的列上建立了一个GIN倒排索引。 如果要根据车牌进行模糊查询,可以使用下面的语句: select count(*) from gin_test_data where to_tsvector('ngram', chepai) @@ to_tsquery('ngram', '湘F'); 这个语句的查询计划如下: test=# explain select count(*) from gin_test_data where to_tsvector('ngram', chepai) @@ to_tsquery('ngram', '湘F'); QUERY PLAN ------------------------------------------------------------------------------------------------ id | operation | E-rows | E-memory | E-width | E-costs ----+------------------------------------------------+--------+----------+---------+--------- 1 | -> Aggregate | 1 | | 8 | 18.03 2 | -> Streaming (type: GATHER) | 1 | | 8 | 18.03 3 | -> Aggregate | 1 | 1MB | 8 | 12.03 4 | -> Bitmap Heap Scan on gin_test_data | 1 | 1MB | 0 | 12.02 5 | -> Bitmap Index Scan | 1 | 1MB | 0 | 8.00 Predicate Information (identified by plan id) ---------------------------------------------------------------------------------------------- 4 --Bitmap Heap Scan on gin_test_data Recheck Cond: (to_tsvector('ngram'::regconfig, (chepai)::text) @@ '''湘f'''::tsquery) 5 --Bitmap Index Scan Index Cond: (to_tsvector('ngram'::regconfig, (chepai)::text) @@ '''湘f'''::tsquery) 查询中使用了倒排索引,因此有比较的好的执行性能。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

核桃编程Delta Lake实时数仓应用实践

作者:卢圣刚,核桃编程数据架构师,拥有多年的大数据开发和架构经验。曾担任易观数据挖掘工程师,熊猫TV大数据架构师。 核桃编程简介 核桃编程成立于2017年8月9日,作为少儿编程教育行业的领导者,始终秉持“让每个孩子爱学习、会学习,让优质的教育触手可及”的使命,致力于以科技手段促进编程教育,凭借首创的AI人机双师教学模式与十级进阶课程体系,实现规模化因材施教,“启发中国孩子的学习力”。截止2019年8月,核桃编程已经成为付费学员规模最大的少儿编程教育机构,帮助超过65万名孩子收获学习兴趣,锻炼编程技能,养成良好思维习惯,学员复购率超91%,学员完课率高达98%,在线原创作品1873万份。 1.业务现状 业务需求 业务上固定时间开课,在开课时间内,班主任需要实时/准实时地知道学生的学习情况 数据统计维度一般都是按班级,学期汇总,时间范围可能是几个

优秀的个人博客,低调大师

数据仓库介绍与实时数仓案例

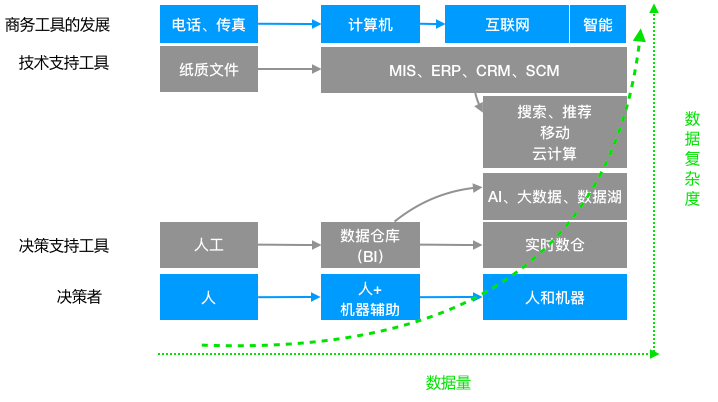
案例与解决方案汇总页:阿里云实时计算产品案例&解决方案汇总 PPT见附件 1.数据仓库简介 数据仓库是一个面向主题的(Subject Oriented)、集成的(Integrate)、相对稳定的(Non-Volatile)、反映历史变化(Time Variant)的数据集合,用于支持管理决策。 数据仓库是伴随着企业信息化发展起来的,在企业信息化的过程中,随着信息化工具的升级和新工具的应用,数据量变的越来越大,数据格式越来越多,决策要求越来越苛刻,数据仓库技术也在不停的发展。 数据仓库的趋势: 实时数据仓库以满足实时化&自动化决策需求; 大数据&数据湖以支持大量&复杂数据类型(文本、图像、视频、音频); 2.数据仓库的发展 数据仓库有两个环节:数据仓库的构建与数据仓库的应用。 早期数据仓库构建主要指的是把企业的业务数据库

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册