首页 文章 精选 留言 我的

精选列表

搜索[数仓建模],共10009篇文章
优秀的个人博客,低调大师

解密数仓的SQL ON ANYWHERE技术

本文分享自华为云社区《GaussDB DWS的SQL ON ANYWHERE技术解密》,作者:tooooooooooomy。 1. 前言 适用版本:【8.1.1(及以上)】 查询分析是大数据要解决的核心问题之一,虽然大数据相关的处理引擎组件种类繁多,并提供了丰富的接口供用户使用,但相对传统数据库用户来说,SQL语言依然是使用最简单、最广泛和方便的一种接口。如果能在一个客户端中使用SQL语句操作不同的大数据组件,将极大提升使用各种大数据组件的效率。 2. 什么是SQL On Anywhere GaussDB(DWS)的SQL On Anywhere,主要指对大数据的文件系统和与其他异构数据库的访问和交互,构筑起统一的大数据计算平台。大数据文件系统主要包括HDFS和OBS,其他异构数据库主要包括Oracle、Spark和Other GaussDB(DWS)。 3. GaussDB(DWS)SQL On Anywhere的作用及其应用场景 通过SQL On Anywhere特性可以实现与其他大数据组件和数据库互联互通访问,可以直接同时处理本地和HDFS/OBS上的数据集,甚至其他异构数据库的数据,而无需导入导出数据,将其分析能力从本地存储扩展到数据湖中,扩大GaussDB DWS的大数据分析的应用场景;通过该特性可以帮助客户实现冷热数据分离,将使用频度更高的热数据存储在本地,而使用频度更低的冷数据存储在成本更低廉的共享存储HDFS或者DWS上,降低用户成本。 从应用场景来看,可以满足如下业务需求: 针对多数据源需要构建虚拟的统一数据仓库,实现多数据源联邦查询,跨数据仓库热数据和HDFS/OBS冷数据的复杂混合查询,需要提供一致的、熟悉的数据仓库操作体验。 满足低频的业务全数据的低成本低延迟即席查询。 4. GaussDB(DWS)SQL On Anywhere的实现方式 GaussDB(DWS)SQL On Anywhere针对大数据的文件系统的访问主要通过FDW或ELK机制(已停止演进)实现的,而跨数据库的访问主要通过EC+ODBC的方式实现的。 3.1 利用FDW访问HDFS/OBS数据 GaussDB(DWS)对存储在HDFS上的Hadoop或者OBS原生数据的访问,采用FDW(Foreign Data Wrapper)机制,也称外表机制。首先通过创建Foreign Data Server来定义对HDFS数据源或同构其他集群的连接信息;之后创建Foreign Table,用于在GaussDB A数据库内部系统表中,定义对应的HDFS数据源上Hadoop原生结构化数据表的结构或对应同构其他集群结构化数据表的结构。 例如读取hdfs上的数据,其流程如下: ​ 1)建立一个hdfs_server,其中hdfs_fdw为数据库中存在的foreign data wrapper。 --创建hdfs_server。 postgres=# CREATE SERVER hdfs_server FOREIGN DATA WRAPPER HDFS_FDW OPTIONS (address '10.146.187.231:8000,10.180.157.130:8000' , hdfscfgpath '/opt/hadoop_client/HDFS/hadoop/etc/hadoop', type 'HDFS' ) ; ​ 2)创建一个hdfs外表读取hdfs上的数据 CREATE FOREIGN TABLE region ( R_REGIONKEY INT4, R_NAME TEXT, R_COMMENT TEXT ) SERVER hdfs_server OPTIONS( FORMAT 'orc', FOLDERNAME '/user/hive/warehouse/mppdb.db/region_orc11_64stripe/' ) DISTRIBUTE BY roundrobin; ​ 3)查询HDFS外表,例如: select * from region limit 10; 目前外表支持与普通表进行关联查询,并支持多种文件存储格式,其支持的文件格式如下(不同版本能力可能存在差异,以官方文档为准): 3.2 通过ELK访问HDFS(已停止演进,不推荐) ELK的方式类似于HAWQ,它是通过建立表空间为HDFS表空间,直接将数据存储和访问HDFS文件系统,目前只支持访问HDFS文件系统,而不支持访问OBS上的数据。首先通过创建HDFS表空间,然后会创建一个HDFS表,在创建时指定表空间为HDFS表空间,最后对HDFS表的操作如同普通表的操作,可进行插入修改删除数据。 以GaussDB数据库数据推到HDFS中 ​ 1)在数据库中创建HDFS表空间 CREATE TABLESPACE hdfs_table RELATIVE LOCATION ‘tmp/hdtest’ With (filesystem=’hdfs’, address=’28.4.136.221:9000’, cfgpath=’/opt/Huawei/bigdata/mppdb/hdfs_conf/zhndnrop/omm@HADOOP.COM/’, storepath=’/tmp/test’); ​ 2)数据库中创建HDFS表 CREATE TABLE abc( zjxxlh char(20), nbbsh char(20), khwybh char(20), zjlx char(20) )WITH (orientation=orc) TABLESPACE tables_hdfs; ​ 3)向表中插入数据 insert into abc select * from region10; 3.3 基于EC+ODBC的跨集群访问数据 GaussDB(DWS)支持通过 EC(全称Extension Connector)+ODBC统一访问其它大数据组件——将SQL发给其它大数据组件并接收执行结果,实现跨集群访问数据。目前EC+ODBC为用户提供了三种功能: SQL on Oracle、SQL on Spark和SQL on other GaussDB,分别用于连接Oracle数据库、Spark集群和其他GaussDB集群。 EC+ODBC的基本工作原理是:用户首先构建Data Source对象(其中包含目标库的一些连接信息和字符编码方式),然后用户获取该Data Source的使用权限,最后通过标准ODBC API连接目标库,发送SQL语句并获取执行结果。 为了方便使用,EC+ODBC为用户提供了统一的连接函数exec_on_extension(text, text)。其中,第一个参数为Data Source名称,第二个参数为发送的SQL语句,例如: postgres=# SELECT * FROM exec_on_extension('ds_spark', 'select * from a;') AS (c1 int); 5. GaussDB(DWS) SQL On Anywhere的实现方式优缺点对比 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓如何递归查询视图依赖

本文分享自华为云社区《GaussDB(DWS)如何递归查询视图依赖》,作者:半岛里有个小铁盒。 1. 前言 适用版本:【8.1.0(及以上)】 本文通过介绍with recursive递归查询的办法来实现查询视图的层级依赖关系 2. 实现简介 对于postgres生态来说,视图的依赖关系没有现成的查询方法,需要对系统表pg_depend及pg_rewrite编写复杂的组合查询才能得知,而对于Oracle和MySql,该需求都较易实现,分别查询USER_DEPENDENCIES和INFORMATION_SCHEMA.VIEWS即可轻易查出,因此在pg生态来说有必要编写一个直观的视图来查看各个视图与基表或与其他视图的层级依赖关系。本文通过with recursive递归查询的办法来实现视图的层级依赖关系查询。效果如下: 首先建立两个基表t1、t2,表结构随意,再建立一系列的视图进行层级关联,关联关系也随意。本文的建表及视图语句如下: create table t1 (a int, b int) distribute by hash(a); create table t2 (a int, b int) distribute by hash(a); create view v1 as select * from t1; create view v2 as select * from v1; create view v3 as select * from v2; create view v4 as select * from v3; create view v5 as select * from t2; create view v6 as select * from v5; create view v7 as select * from v6; create view v8 as select * from v2; 实际的局点中,用户的视图依赖关系肯定要比这复杂得多,本文仅讲解原理。对于上述的视图依赖关系,可以通过如下查询得出: SELECT c.ev_class::regclass::varchar AS objname, pc.oid::regclass::varchar AS refobjname, pc.relkind AS relkind FROM pg_depend a,pg_depend b,pg_class pc,pg_rewrite c WHERE a.refclassid=1259 AND a.classid=2618 AND b.deptype='i' AND a.objid=b.objid AND a.classid=b.classid AND a.refclassid=b.refclassid AND a.refobjid<>b.refobjid AND pc.oid=a.refobjid AND c.oid=b.objid AND (a.objid>=16384 or a.refobjid>=16384) GROUP BY c.ev_class,pc.oid,pc.relkind ORDER BY relkind; 其中倒数第二行的16384表示过滤掉系统对象,relkind表示上级依赖对象的类型,r说明依赖于基表,v表示依赖另一个视图。其查询结果如下: 可见这种查询并不直观,只能通过肉眼分析得出递归的依赖关系,对用户并不友好。莫急,先将上述查询保存为视图,例如起名为PUBLIC.gs_view_dependency。接下来我们来学习一下with recursive语法的使用方法,从pg官网可以get到的知识是,WITH语句通常被称为通用表表达式(Common Table Expressions)或者CTEs。WITH语句作为一个辅助语句依附于主语句,WITH语句和主语句都可以是SELECT,INSERT,UPDATE,DELETE中的任何一种语句。WITH语句还可以通过增加RECURSIVE修饰符来引入它自己,从而实现递归: WITH RECURSIVE语句包含了两个部分: (非递归部分)non-recursive term,即上图中的union all前面的部分 (递归部分)recursive term,即上图中union all后面的部分 执行步骤如下: 执行non-recursive term。(如果使用的是union而非union all,则需对结果去重)其结果作为recursive term中对result的引用,同时将这部分结果放入临时的working table中 重复执行如下步骤,直到working table为空:用working table的内容替换递归的自引用,执行recursive term,(如果使用union而非union all,去除重复数据),并用该结果(如果使用union而非union all,则是去重后的结果)替换working table 因此,照葫芦画瓢,我们可以先给这个CTE查询起个名字,例如: WITH RECURSIVE get_view_dependency AS ( ... ) 然后,我们可以把非递归部分写成: SELECT a.objname, a.refobjname, a.refobjname path FROM PUBLIC.gs_view_dependency a where a.relkind = 'r' 因为查找到类型为’r’的基表的时候,递归就应该结束了。并且我们需要将refobjname组装成一条path来实现依赖路径的直观表示。因为是递归,所以我们需要不止一次的调用PUBLIC.gs_view_dependency,因此我们给它起个别名a。而递归的条件显而易见,应该是用refobjname来与objname做内关联,因此我们可以写作: INNER JOIN get_view_dependency cte ON b.refobjname=cte.objname 其中cte就用来指代上一次的递归查询结果,而递归的退出条件就应该是最开始写的类型为’r’的情况。其中b就应该是递归部分每次调用的PUBLIC.gs_view_dependency。而我们除了要查询objname和refobjname外,更重要的是要组成一个path,而path每个节点最好通过一个’->'来直观表示,因此递归部分我们就可以写成: SELECT b.objname, b.refobjname, cte.path ||' -> '|| b.refobjname path FROM PUBLIC.gs_view_dependency b INNER JOIN get_view_dependency cte ON b.refobjname=cte.objname 因此,整个CTE递归查询便可以写成: WITH RECURSIVE get_view_dependency AS ( SELECT a.objname, a.refobjname, a.refobjname path FROM PUBLIC.gs_view_dependency a where a.relkind = 'r' UNION ALL SELECT b.objname, b.refobjname, cte.path ||' -> '|| b.refobjname path FROM PUBLIC.gs_view_dependency b INNER JOIN get_view_dependency cte ON b.refobjname=cte.objname ) SELECT * FROM get_view_dependency; 为了方便以后的使用,我们可以给它起个名字保存起来,例如CREATE VIEW PUBLIC.gs_view_table_dependency AS …。效果就是文章开头所示那样,便大功告成。 3. 总结 在数据库中,查询视图是一种非常有用的工具,它可以帮助我们更好地组织和管理数据。然而,查询视图的层级依赖关系可能会让人感到困惑。本文将介绍一种通过 with recursive 递归查询的办法来实现查询视图的层级依赖关系的方法,希望对你有所帮助。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

精打细算使用MaxCompute搭建数仓

MaxCompute是一套阿里自主研发的数据仓库解决方案。产品除了功能、性能、简单等优势外,还能在费用上节省下一大笔前。墨迹天气使用MaxCompute,除了性能和稳定性也有提升外,整体存储和计算的费用比之前节省70%。这是如何做到的呢,这里有一些常用的规则。 在讨论如何做到之前,我们先看下MaxCompute是如何计费的。根据目前的文档,目前的计费方式包含数据的存储、数据的下载以及计算费用。其中计算费用又分I/O后付费和预付费两种收费模式。I/O后付费根据实际的计算来进行收费;而预付费相当于包了几个CU只有购买者可以使用,这几个CU上随便怎么计算都不会产生计算费用。所以如何减少费用,也就是转换成如何减少存储的费用、如何减少下载的费用以及如何减少计算的费用。 存储 数据存储在MaxCompute上是使用列式存储并有压缩的,底层数据存储方

优秀的个人博客,低调大师

优化数仓业务视图:过滤条件传递

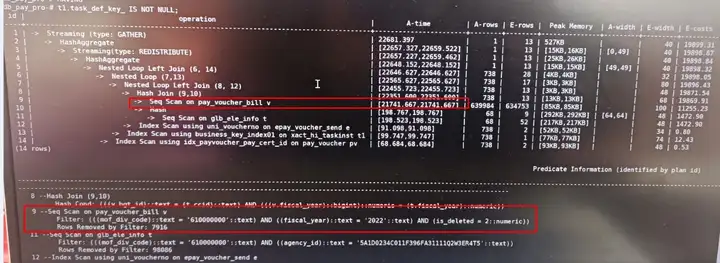
摘要:在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 本文分享自华为云社区《GaussDB(DWS)业务视图优化-过滤条件传递》,作者:卫小毛 。 在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 SQL举例 SELECT count(1) AS have_done_num, t1.task_def_key_ AS menuguid FROM vw_pay_voucher_bill t2 LEFT JOIN xact_hi_taskinst t1 ON t1.business_key_ = t2.id AND t1.proc_def_key_ = 'pay_voucher_bill' AND t1.operation_flag_ IN ('NORMAL', 'WITHDRAW') AND t1.suspension_state_ = 1 AND t1.org_code_ = t2.mof_div_code AND delete_reason_ = 'completed' AND ext1_ IS NULL WHERE t2.is_deleted = '2' AND t2.fiscal_year = '2022' AND t2.mof_div_code = 'xxxxxxxx0' AND ( agency_id = '5A1xxxxxxxxxxxxxxxxxxx4T5' ) GROUP BY t1.task_def_key_ HAVING t1.task_def_key_ IS NOT NULL; sql分析:以上SQL vw_pay_voucher_bill t2 、xact_hi_taskinst t1 视图和表进行关联查询 根据业务特性分析过滤效果较好的字段为 agency_id 优化前耗时:22s 分析执行计划: 时间主要耗时在 seq scan on pay_voucher_bill v 这一步 看到该表过滤条件仅有mof_div_code、fiscal_year、is_deleted 过滤效果差,几乎全表数据参与过程运算,执行代价高 视图及表结构分析: 视图中关联条件较为有效的过滤条件,bgt_id 字段查询时不会应用。分析视图中“v”和“t”表都存在agency_id 字段,当前t表过滤使用了agency_id字段,可以考虑视图定义中量表关联条件增加 agency_id 字段关联条件需要考虑业务需求。 同业务沟通后可进行优化 优化后耗时:0.4s 对比优化前后SQL查询结果一致 优化总结: 同业务侧研发沟通客户实际需要仅需要查询本单位 (agency_id) 下的数据,但因为SQL和视图设计时,并未将这一有效条件传递给每张表。导致数据库在针对 pay_voucher 进行数据过滤时需要将全表64万+ 数据筛选出来进行运算,仅仅这一步开销就占用了20s+。在优化后(视图中增加agency_id关联信息后,该操作可将agency_id 过滤条件传递给基表 pay_voucher),仅需从pay_voucher 表中获取738行数据进行运算,最终sql耗时降为 0.4s左右。 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

解析数仓lazyagg查询重写优化规则

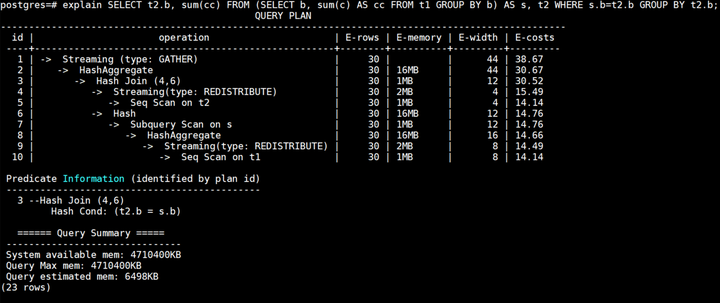
摘要:为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则。 本文分享自华为云社区《GaussDB(DWS) lazyagg查询重写优化解析【这次高斯不是数学家】》,作者: OreoreO 。 聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句eze聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句: SELECT a, count(a) FROM t1 GROUP BY a; -- 按a分组并计算分组内重复值的个数 一、Lazy Agg重写规则 数据量大的场景下,聚集运算由于数据量大导致下盘,聚集操作执行时间成为性能瓶颈,从而导致整个查询执行效率非常差。例如: SELECT t2.b, sum(cc) FROM (SELECT b, sum(c) AS cc FROM t1 GROUP BY b) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 子查询对t1.b列进行聚集,对t1.c列求和,在外部查询中,同样也存在聚集运算,对子查询的聚集求和列cc列求和。对于这类语句,当子查询的聚集运算较耗时的情况下,可以利用查询重写规则消除子查询的聚集运算,由外部查询的聚集函数统一完成聚集运算。消除子查询后可能导致子查询行数增多,但对于子查询聚集运算时t1.b列的distinct值较多的场景,子查询聚集运算后的行数较原表不会有明显缩减,不会导致外层JOIN运算量的大量增加。即语句可被重写为: SELECT t2.b, sum(cc) FROM (SELECT b, c AS cc FROM t1) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 这个改写规则称为Lazy Agg,适用于基表数据量大且distinct值较多的场景。如果重复值较少,那么消除了聚集操作会导致Join后的行数激增,Join性能较差,因此需要将Agg下推到Join之前进行,通过提前的Agg操作减少Join结果的行数,这个改写规则称为Eager Agg。 二、GaussDB(DWS) lazyagg优化 为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则,可以通过设置guc参数rewrite_rule包含’lazyagg’使用Lazy Agg查询重写优化。开启lazyagg查询重写优化后,对满足条件的场景会优化并消除子查询中的聚集操作。原计划如下所示: lazyagg重写优化后计划如下所示: 可以看到相比于原计划,lazyagg重写优化后消除掉了原计划中的聚集操作,即7号Subquery Scan算子和8号HashAggregate算子。 三、lazyagg优化规格 支持子查询为单一聚集查询或包含聚集子集合操作的查询。集合操作仅支持UNION ALL,可对部分分支子查询进行聚集运算消除。子查询需为JOIN表之一(不在TargetList、Where子句等其他位置)。 支持若外部查询的所有Agg参数列包含于其某个子查询的Agg函数列,则可对该子查询的聚集运算进行消除。 支持所有消除子查询聚集运算后结果正确的聚集函数种类。聚集函数种类结果正确性见下表: 4.场景约束 在上述场景扩展的基础上,对于可能导致结果错误的场景,不进行查询重写,包括但不限于: 不支持消除的Agg函数类型。 子查询中包含其它条件或算子,会导致重写后结果错误,例如HAVING、window agg、LIMIT、OFFSET、AP function、distinct、recursive等。 外层Agg参数列、GROUP BY列或JOIN列中包含volatile函数,如random、timeofday等。 子查询Agg函数外、外部查询Agg函数内有其他表达式或函数操作,如子查询Agg函数列为sum©+1、max©+max(d),外部查询Agg函数列为sum(cc+1)等。 外部查询的JOIN列、GROUP BY列或其它条件中包含子查询Agg函数列。 子查询在LEFT JOIN、RIGHT JOIN的inner边或FULL JOIN中,且子查询Agg函数为count,外部查询Agg函数为sum的。 四、结语 通过本文的分析,相信用户朋友已经充分了解了Lazy Agg重写优化的使用场景,以及GaussDB(DWS)的lazyagg实现方式。希望广大用户能够通过深入的了解,对GaussDB(DWS)的性能调优产生浓厚的兴趣并深度参与进来。 参考文档:GaussDB(DWS)性能调优系列实战篇四:十八般武艺之SQL改写 【这次高斯不是数学家】有奖征文火热进行中:https://bbs.huaweicloud.com/blogs/345260 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

深度剖析数仓CN增量备份技术

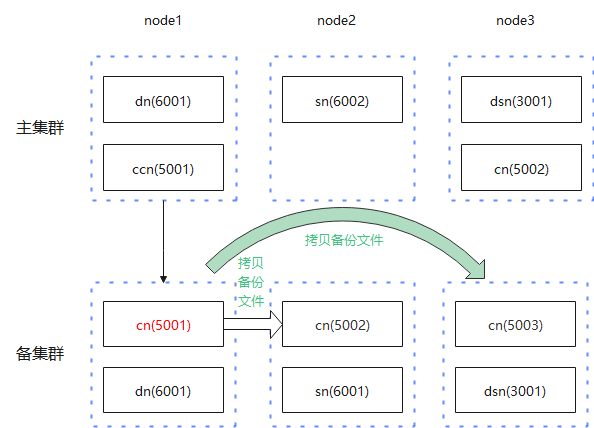
摘要:为了解决Roach的性能问题,提出了CN增量备份手段,从而达到进一步优化RPO目的。 本文分享自华为云社区《GaussDB(DWS)备份容灾之CN增量备份》,作者: zxy_db 。 1. 摘要 在数据量增大时,如果CN每次都做全量备份,则会导致每次的备份数据量很大,不仅会降低备份的性能,也从造成备份集恢复性能的降低。如果改成CN增量备份,则备份集只会备份差异数据,这样不仅会使得备份数据量变小,而且也会提升备份集恢复的性能。 2. CN备份原理 对于主备集群CN备份与恢复的过程,如下图所示: 在备份过程中,只备份主CN的数据,且只发送到备集群对应的主CN所在的节点上。 在恢复过程中,非主CN节点从主CN节点上拷贝rch文件,然后再将备份数据的rch文件恢复到实例目录。 CN备份同集群备份一样,先进行行存备份,后进行列存备份。 对于行存备份过程,首先是准备列表,然后备份文件。 准备列表主要分为3个步骤:第一步是获取CN备份类型,第二步是根据备份类型,决定LSN区间,第三步是根据LSN区间,准备备份列表(全量备份列表和增量备份列表)。 对于列存备份过程,同上述行存。 行存和列存区别在于增量备份LSN区间的取法: 行存文件来说,增量是上次startLSN到本次startLSN之间 列存文件来说,增量是上次barrierLSN到本次barrierLSN之间 3. CN备份判断逻辑 首先,CN增量需要有一个基础备份,因此,集群在做全量备份时,CN仍然做全量备份。 其次,集群在两次增量备份过程中,CN发生删除和加回后,新增的CN需要做全量备份。 对于支持异构的情况下,如果ID最小的CN发生变化,同样需要对CN做一次全量备份。 整体的备份逻辑如下图所示。 3.为了实现上述判断逻辑,通过创建标志文件backup_label.old来控制CN做全量备份还是增量备份。backup_label.old在Python侧创建。即在Python侧,调用gs_roach备份前,在最小的CN上,即要进行备份的CN上,创建backup_label.old文件。根据backup_label.old的修改时间和priorBackupKey转化的时间,判断CN做增量备份还是全量备份。流程图如下图所示。如右半部分所示,如果backup_label.old文件的修改时间比prriorBackupKey转换获得的时间大,则进行全量备份。否则,进行增量备份。 4. CN备份技术应用实测 4.1 CN删除和加回后做全量备份 初始状态,ecs-env-3038节点上的CN实例是最小CN编号,即主CN 第一步:修改XML配置文件xml,将主CN对应主机上的cooNum值从1改为0 第二步:使用gs_om工具执行删除CN操作 gs_om -t managecn -m delete -X /data1/xml/3_node_3.xml 第三步:将要加回CN对应主机上的cooNum值从0改为1 第四步:使用gs_om工具执行加回CN操作 gs_om -t managecn -m add -X /data1/xml/3_node_3.xml 删除和加回后,主CN的变化情况: 主CN由节点ecs-env-3038变为节点ecs-env-2998. 此时查看日志可以发现,由于CN发生了增删,集群做增量备份时,CN做全量备份。 4.2 备份集大小变化 第一步:拉起容灾,CN增量备份阶段停止容灾; 第二步:创建大量数据库和空表; 第三步:连续执行增量备份,增量备份中途不插入任何数据。 如下图所示,不增加数据,增量备份集大小小于全量备份集大小 5. 技术总结 本文主要从技术价值、应用场景、技术原理、技术实测展示几个维度对GaussDB(DWS) CN增量备份技术进行了剖析,可以看到增量备份是对已有全量备份恢复的一个有效的增强,可以节省宝贵的备份存储空间和cpu资源,同时达到进一步优化RPO目的,因此该技术拥有较为广阔的前景和深远的意义。 点击关注,第一时间了解华为云新鲜技术~​

优秀的个人博客,低调大师

数仓无损压缩算法:gzip算法

摘要:一种无损的压缩数据格式,是一个在类Unix上的一种文件解压缩软件。 本文分享自华为云社区《GaussDB(DWS) gzip算法简介》,作者:hw0086。 【算法原理】 gzip是一种无损压缩算法,其基础为Deflate,Deflate是LZ77与哈弗曼编码的一个组合体。它的基本原理是:对于要压缩的文件,首先使用LZ77算法的一个变种进行压缩,对得到的结果再使用哈夫曼编码(根据情况,使用静态哈弗曼编码或动态哈夫曼编码)的方法进行压缩。Deflate最初作为LZW以及其他受专利保护的数据压缩算法的替代版本而设计的,当时那些专利限制了compress以及其它一些流行的归档工具的应用。 【压缩核心Deflate】 1.LZ77算法 LZ77的核心思路是如果一个串中有两个重复的串中有两个重复的串,那么只需要知道后面的串与前面串重复的长度和后面串起始字符与前面串起始字符相对于起始位置的距离。 例如:ABCCDEFABCCDEGH 通过LZ77算法可压缩为ABCCDEF(7,6)GH,其中7表示重复串起始字符A到前面串起始字符的距离,5表示重复部分的长度(ABCCDE)。 LZ77采用滑动窗口(sliding-window compression)来实现这个算法,扫描头从串的头部开始扫描,在扫描头的前面有一个长度未N的滑动窗口。若发现扫描头处的串和窗口里的最长匹配串是相同的,则用(两个串之间的距离, 串长度)来代替后一个重复的串,同时还需要添加一个表示是真实串还是替换后的串的字节在前面以方便解压。实际过程中滑动窗口的大小固定,匹配的串也有最小长度的限制,以方便(标识+串之间距离+串长度)之和所占用的字节是固定的。 2.哈夫曼编码 哈夫曼编码是数据结构课程中一种常见的算法。哈夫曼编码使用变长编码表对源符号进行编码,变长编码表通过一种评估来源符号出现概率的方法得到,出现概率较高的字母使用较短的编码,反之出现概率低的使用较长的编码,这样使编码之后的字符串的平均长度、期望值降低,从而达到无损压缩数据的目的。通过构造Huffman Tree的方式给字符重新编码,避免一个叶子的路径是另一个叶子路径的前缀,以保证出现频率越高的字符占用的字节越少。 例如:给英文单字“F O R G E T”进行哈弗曼编码,将每个英文字母出现频率由小排到大,如下图。 每个字母与都代表一个终端节点(叶子节点),比较留个字母中每个字母出现的频率,将最小的两个字母相加合成一个新的节点。如下图。组成哈弗曼树。 将上图给定的哈弗曼树的所有左链接设为0.右链接设为1,从根节点到叶子节点一次记录每个字母的编码,所得每个字母的编码表如下图。 【文件格式】 10字节的头,包含幻数、版本号以及时间戳 可选的扩展头,如原文件名 文件体,包括DEFLATE压缩的数据 8字节的尾注,包括CRC-32校验和以及未压缩的原始数据长度 通常gzip仅用来压缩单个文件,再对多个文件的压缩归档通常会将这些文件合并成一个tar文件,再使用gzip对tar文件进行压缩,最后生成.tar.gz或者.tgz文件,即“tar压缩包”或者“tarball”。 【应用】 -c,--stdout将解压缩的内容输出到标准输出,原文件保持不变 -d,--decompress解压缩 -f,--force强制覆盖旧文件 -l,--list列出压缩包内储存的原始文件的信息(如,解压后的名字、压缩率等) -n,--no-name压缩时不保存原始文件的文件名和时间戳,解压缩时不恢复原始文件的文件名和时间戳(此时,解出来的文件,其文件名为压缩包的文件名) -N,--name压缩时保存原始文件的文件名和时间戳,解压缩时恢复原始文件的文件名和时间戳 -q,--quiet抑制所有警告信息 -r,--recursive递归 -t,--test测试压缩文件完整性 -v,--verbose冗余模式(即显示每一步的执行内容) -1、-2、...、-9压缩率依次增大,速度依次减慢,默认为-6 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册