首页 文章 精选 留言 我的

精选列表

搜索[数仓建模],共10009篇文章
优秀的个人博客,低调大师

数仓中长跳转问题复现及解决方案

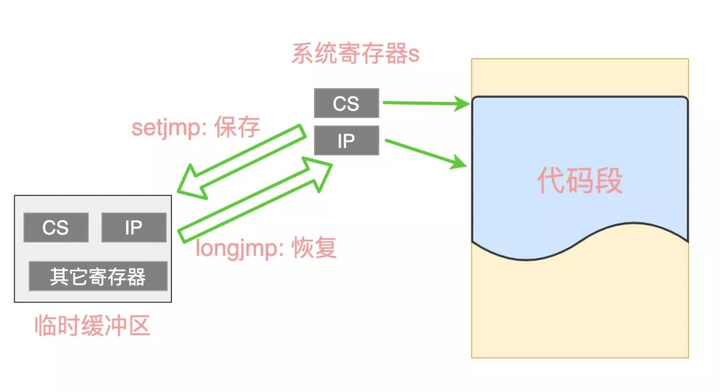
摘要:本文将GaussDB(DWS)中长跳转引发的错误抽象为例子,讨论了C语言在长跳转下可能会出现的问题,最后简单给出了解决方法和验证。 本文分享自华为云社区《GaussDB(DWS)中长跳转可能出现的问题》,作者: 雷电与骤雨。 问题描述,在GaussDB(DWS)编码实践中,发现在debug未进行编译器优化的版本未发生问题,但是在release版本,发生了一些变量赋值后失效,仍为旧值的bug,本文将对此在两个角度下进行简单分析。 什么是长跳转? 在C语言中,goto语句常常实现程序执行中的近程跳转(local jump),longjmp()和setjmp()函数实现程序执行中的远程跳转(nonlocaljump,也叫farjump)。 主要相关的为两个函数的签名: int setjmp(jmp_buf env); void longjmp(jmp_buf env, int value); 一般理解为:setjmp 函数把执行这个函数时的各种上下文信息保存起来,储存到jmp_buf中,主要就是当前栈的位置,寄存器状态。longjmp 函数跳转到参数 env 缓冲区中保存的上下文(快照)中去。并且也有人提出会与实现方式 implementation有关。 我觉得下面这句还是比较可信的: The setjmp() function saves the contents of most of the general purpose registers, in the same way as they would be saved on any function entry. It also saves the stack pointer and the return address. All these are placed in the buffer. It then arranges for the function to return zero. 编译器优化问题 问题发生于debug版本和release版本出现了不同的结果,其中的差异主要是编译器在编译构建中的优化过程。一般编译器优化常用的方法有:将内存变量缓存到寄存器。 由于访问寄存器要比访问内存单元快的多,编译器在存取变量时,为提高存取速度,编译器优化有时会先把变量读取到一个寄存器中;以后再取变量值时就直接从寄存器中取值。但在很多情况下会读取到脏数据,严重影响程序的运行效果。 解决方法 C++ Volatile关键字 Volatile,词典上的解释为:易失的;易变的;易挥发的。个人理解就是在每次给该变量赋值后,需要将其放入内存,而非直接使用寄存器,此时可以避免因为jump和函数跳转带来的未写入内存导致赋值未成功(仍为旧值),或者编译器优化,将值直接放于寄存器(此值可能因为多次使用,避免从内存中来回多次读取)。 问题复现 实例未优化,debug未优化版本 #include <stdio.h> #include <stdlib.h> #include <setjmp.h> static jmp_buf env; static void doJump(int nvar, int rvar, int vvar) { printf("Inside doJump(): nvar=%d, rvar=%d, vvar=%d\n" , nvar,rvar, vvar); //死代码块 int nvar0 = nvar; int rvar0 = rvar; int vvar0 = vvar; longjmp(env, 1); } int main(int argc, char** argv) { int nvar; register int rvar; volatile int vvar; nvar = 111; rvar = 222; vvar = 333; if(setjmp(env) == 0) { nvar = 777; rvar = 888; vvar = 999; doJump(nvar, rvar, vvar); } else { int nvar1 = nvar; int rvar1 = rvar; int vvar1 = vvar; printf("After longjmp(): nvar =%d, rvar=%d, vvar=%d\n", nvar, rvar, vvar); } exit(EXIT_SUCCESS); } 程序运行结果 将程序通过gcc编译构建,其中不使用任何优化。将产生的二进制文件运行,可得到如下结果: 从中可以发现,寄存器变量rvar的值未受后面赋值的影响,仍为旧值222,与期望值不同,但是普通int型和volatile型值均正确。说明经过长跳转,寄存器变量在跳转之中重新赋值容易产生丢失的问题。 汇编角度观察 下图发现,在赋值的时候,rvar是直接放到了ESI寄存器中,而未覆盖掉之前内存中保存的222值,也就是888赋值到了寄存器,而内存中应该还为222,其余的777,999均进入内存中。 并且进入下个自定function函数时,三个变量均放入了寄存器中。进行传值。 下图可以看出来,就是jump回来时,rvar的真实值(寄存器中的值888)已经丢失,寄存器的值被jump buffer缓存中值所冲掉,后面在打印变量值时,从内存中读取到旧的值。 内存角度观察 上图是赋值完777,888,999,此时发现,这个888赋值给了寄存器(从汇编中可以看出),这里发现222未被覆盖。 最后通过jump返回,读取值,这时候读取是从内存中读取出来,发现读出了777,222,999,程序发生了意外情况。其中下图展示了内存地址中的值,222在-0x28 + 0x7fffffffe160地址位。 实例优化O2,release版本 程序运行结果 编译中加入O2编译器优化,并运行程序。此时结果发现,nvar和rvar的值均发生了变化,并未存入我们预想中的777和888,而是old值未被改变。 因为存在编译器的优化问题,变量nvar和rvar在跳转中,其改写值放入了寄存器中,jump之后,寄存器的值被冲刷,到致出现此类问题。而变量vvar的值放入了内存中,jump之后,仍可以通过寄存器指针调取。 下面就对程序运行过程进行检查和对结果进行分析。 汇编角度观察 通过objdump -d volatile_og可以查看编译后文件的反汇编代码。我们主要观察main函数,其从10c0开始,上图根据判断env是否等于0为界限,分为了3块,方便理解阅读。 发现汇编中不存在对函数Dojump的调用(callq指令后未出现Dojump),猜测是由于编译器优化为内联函数。同时此函数中变量nvar0,rvar0,vvar0的初始化为死代码块,在优化过程中也进行了移除。 下图可以说明,仅有使用关键字volatile的vvar其值再栈内存中可以找到,其余的变量均不为lvalue。 内存角度观察 可以通过查看jump前后的内存中的值,进行查看到底在jump中发生了什么: 下图一为在jump之前,寄存器中的值,只有333进入到内存中了。亦可以通过图二方式查询,发现rvar和nvar并非可以通过内存地址访问到。 在jump之后,内存e15c中的值改为999。 Jump之后,栈内存的空间如下图所示: 下图中,此时只有vvar可以取地址操作。 附录 参考资料 什么是内存屏障? Why Memory Barriers ? why-do-we-use-volatile-keyword intro.races-13 Linux 汇编语言开发指南 Intel 格式--AT&T 格式 setjmp()与longjmp()详细分析 利用C语言中的Setjmp和Longjmp,来实现异常捕获和协程 Exactly what “program state” does setjmp save? 可能涉及到的具体优化参数 l -fforce-mem:在做算术操作前,强制将内存数据copy到寄存器中以后再执行。这会使所有的内存引用潜在的共同表达式,进而产出更高效的代码,当没有共同的子表达式时,指令合并将排出个别的寄存器载入。这种优化对于只涉及单一指令的变量, 这样也许不会有很大的优化效果. 但是对于再很多指令(必须数学操作)中都涉及到的变量来说, 这会时很显著的优化, 因为和访问内存中的值相比 ,处理器访问寄存器中的值要快的多。 l -fregmove:编译器试图重新分配move指令或者其他类似操作数等简单指令的寄存器数目,以便最大化的捆绑寄存器的数目。这种优化尤其对双操作数指令的机器帮助较大。 l -fschedule-insns:编译器尝试重新排列指令,用以消除由于等待未准备好的数据而产生的延迟。这种优化将对慢浮点运算的机器以及需要load memory的指令的执行有所帮助,因为此时允许其他指令执行,直到load memory的指令完成,或浮点运算的指令再次需要cpu。其允许数据处理时先完成其他的指令。 总结: -fforce-mem有可能导致内存与寄存器之间的数据产生类似脏数据的不一致等。对于某些依赖内存操作顺序而进行的逻辑,需要做严格的处理后才能进行优化。例如,采用volatile关键字限制变量的操作方式,或者利用barrier迫使cpu严格按照指令序执行的。 内存屏障 Memory Barriers Cache 一致性问题的根源是因为存在多个处理器独占的 Cache,而不是多个处理器。它的限制条件比较多:多核,独占 Cache,Cache 写策略。 当其中任一个条件不满足时便不存在cache一致性问题。 针对CPU的多级Cache和存储读写一致性 : CPU中为提高指令执行,增加了两个缓冲区store buffer,invalidate queue。 Store Buffer: 好处:store是为了CPU0和1之间读写,不需要等待从另外一个CPU的Cache中调取数据。(提高速度)。 坏处(问题描述):CPU0修改值,但是其发送的“读使无效”晚于CPU1真正读的时间,导致晚了一步,数据错了。 冲突问题的解决: 硬件上:store forwarding。如果本地Store Buffer有数据,直接先读本队Store Buffer。 软件上:硬件设计者提供了memory barrier指令,让软件来告诉CPU这类关系。 失效队列: store buffer一般很小,所以CPU执行几个store操作就会填满, 这时候CPU必须等待invalidation ACK消息(得到invalidation ACK消息后会将storebuffer中的数据存储到cache中,然后将其从store buffer中移除),来释放store buffer缓冲区空间。 好处:CPU1可能在重负荷下,执行大量失效命令会有更重的复合。提高了速度; 坏处(问题描述):可能本身值已无效,但是队列未执行到。(又是晚了)。 解决:仍然是加屏障可以解决。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

2个数仓中不等值关联优化案例

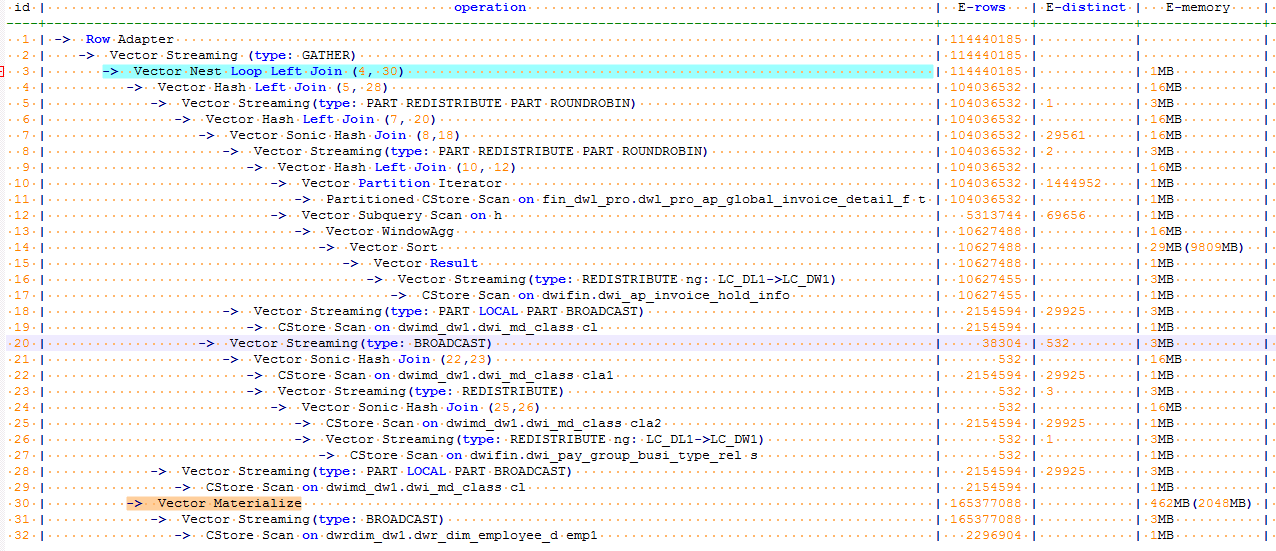
本文分享自华为云社区《GaussDB(DWS)性能调优:不等值关联优化》,作者: 门前一棵葡萄树。 场景1 使用场景:本案例适合满足以下条件的场景 关联条件使用OR连接 关联条件中使用同一列做数据筛选 原始语句 SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON ( t2.CHANNEL_ID = t1.CHANNEL_ID AND t1.TYPE = 'DR' ) OR ( t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID AND t1.TYPE = 'ALL' ) GROUP BY t2.PARTNER_CHANNEL_CODE ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID 性能分析 通过查询计划分析发现,t1表和t2表关联走了NEST LOOP,查询整体耗时45S,NEST LOOP耗时占用整个查询执行耗时的96%。因此考虑能否通过SQL改写或HINT规避NEST LOOP。观察发现t1表和t2表包含两个关联关联条件,两个关联条件之间使用OR连接,属于非等值关联,因此不能走HASH JOIN。进一步分析SQL发现两个关联条件中都使用t1.TYPE进行过滤筛选: (t2.CHANNEL_ID = t1.CHANNEL_ID AND t1.TYPE='DR') OR (t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID AND t1.TYPE='ALL' ) 该关联条件包含以下三种关联组合: t1表中t1.TYPE='DR'的行,只能使用第一个关联条件与t2表关联; t1表中t1.TYPE='ALL'的行,只能使用第二个关联条件与t2表关联; t1表中t1.TYPE NOT IN ('ALL','DR')的行,不与t2表关联,直接补空。 t1表中的一行数据只能选择这三个关联条件中的一个与t2表关联,因此该关联条件可以改写为不同关联条件的UNION ALL(UNION会去重,不等价)。 优化改写 改写后SQL如下所示: SELECT CHANNEL_ID ,COUNTRY_CODE ,BRAND ,CHANNEL_ID FROM ( SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON t2.CHANNEL_ID = t1.CHANNEL_ID WHERE t1.TYPE = 'DR' UNION ALL SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 t2 ON t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID WHERE t1.TYPE='ALL' UNION ALL SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON FALSE WHERE t1.TYPE NOT IN ('ALL','DR') ) GROUP BY CHANNEL_ID,COUNTRY_CODE,BRAND,CHANNEL_ID 改写后SQL变为三个子查询的UNION ALL,执行时间缩减至1s以内,性能优化45倍。 场景二 使用场景:本案例适合满足以下条件的场景 大表A不等值关联小表B B的等值关联字段为主键 【原始语句】 SELECT T.CREATE_INVOICE_USER, T.PERIOD_ID, T.AP_INVOICE_ID, T.AP_INVOICE_NUM, T.AP_BATCH_NAME, EMP1.EMPLOYEE_NO, EMP1.EMPLOYEE_NAME FROM DWACTDI.DWR_AP_GLOBAL_INVOICE_DETAIL_F_I T LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1 ON (EMP1.SCD_ACTIVE_IND = 1 AND(T.CREATE_INVOICE_USER = EMP1.EMPLOYEE_NO OR SUBSTR(T.CREATE_INVOICE_USER, 2) = EMP1.EMPLOYEE_NO)) 【性能分析】 原始语句执行超时(超过1h),执行计划如下。可以看到执行语句存在大表NestLoop操作 分析发现表dwrdim_dw1.dwr_dim_employee_d是维度表,且关联列employee_no是主键 【优化改写】 SELECT T.CREATE_INVOICE_USER, T.PERIOD_ID, T.AP_INVOICE_ID, T.AP_INVOICE_NUM, T.AP_BATCH_NAME, nvl(EMP1_0.EMPLOYEE_NO, EMP1_1.EMPLOYEE_NO) AS EMPLOYEE_NO, nvl(EMP1_0.EMPLOYEE_NAME, EMP1_1.EMPLOYEE_NAME) AS ERP_ACCOUNTANT_ENAME FROM DWACTDI.DWR_AP_GLOBAL_INVOICE_DETAIL_F_I T LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1_0 ON (EMP1_0.SCD_ACTIVE_IND = 1 AND(T.CREATE_INVOICE_USER = EMP1_0.EMPLOYEE_NO)) LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1_1 ON (EMP1_1.SCD_ACTIVE_IND = 1 AND(SUBSTR(T.CREATE_INVOICE_USER, 2) = EMP1_1.EMPLOYEE_NO)) 改写后执行信息如下 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓中典型的几种不下推语句整改案例

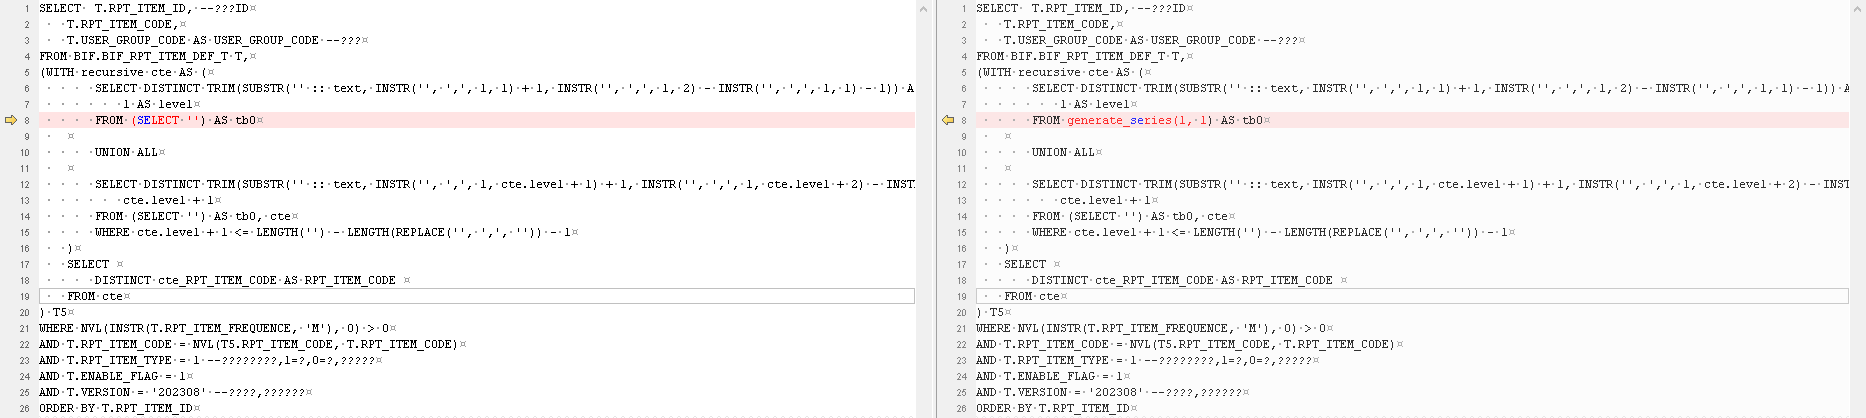
本文分享自华为云社区《GaussDB(DWS)性能调优:典型不下推语句整改案例》,作者: 譡里个檔 。 场景1:With-Recursive contains only values rte is not shippable 根因:递归语句的某个分支中没有FROM字句(只有 VALUES 或者类似 SELECT 1 这样的语句) 案例1:递归驱动分支没有FROM字句 原始语句 SELECT T.RPT_ITEM_ID, --报表项ID T.RPT_ITEM_CODE, T.USER_GROUP_CODE AS USER_GROUP_CODE --用户组 FROM BIF.BIF_RPT_ITEM_DEF_T T, (WITH recursive cte AS ( SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, 1) + 1, INSTR('', ',', 1, 2) - INSTR('', ',', 1, 1) - 1)) AS cte_RPT_ITEM_CODE, 1 AS level FROM (SELECT '') AS tb0 UNION ALL SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, cte.level + 1) + 1, INSTR('', ',', 1, cte.level + 2) - INSTR('', ',', 1, cte.level + 1) - 1)), cte.level + 1 FROM (SELECT '') AS tb0, cte WHERE cte.level + 1 <= LENGTH('') - LENGTH(REPLACE('', ',', '')) - 1 ) SELECT DISTINCT cte_RPT_ITEM_CODE AS RPT_ITEM_CODE FROM cte ) T5 WHERE NVL(INSTR(T.RPT_ITEM_FREQUENCE, 'M'), 0) > 0 AND T.RPT_ITEM_CODE = NVL(T5.RPT_ITEM_CODE, T.RPT_ITEM_CODE) AND T.RPT_ITEM_TYPE = 1 --是否是叶子报表项,1=是,0=否,基本报表项 AND T.ENABLE_FLAG = 1 AND T.VERSION = '202308' --使用快照,增加条件限制 ORDER BY T.RPT_ITEM_ID 改写语句 SELECT T.RPT_ITEM_ID, --报表项ID T.RPT_ITEM_CODE, T.USER_GROUP_CODE AS USER_GROUP_CODE --用户组 FROM BIF.BIF_RPT_ITEM_DEF_T T, (WITH recursive cte AS ( SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, 1) + 1, INSTR('', ',', 1, 2) - INSTR('', ',', 1, 1) - 1)) AS cte_RPT_ITEM_CODE, 1 AS level FROM generate_series(1, 1) AS tb0 UNION ALL SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, cte.level + 1) + 1, INSTR('', ',', 1, cte.level + 2) - INSTR('', ',', 1, cte.level + 1) - 1)), cte.level + 1 FROM (SELECT '') AS tb0, cte WHERE cte.level + 1 <= LENGTH('') - LENGTH(REPLACE('', ',', '')) - 1 ) SELECT DISTINCT cte_RPT_ITEM_CODE AS RPT_ITEM_CODE FROM cte ) T5 WHERE NVL(INSTR(T.RPT_ITEM_FREQUENCE, 'M'), 0) > 0 AND T.RPT_ITEM_CODE = NVL(T5.RPT_ITEM_CODE, T.RPT_ITEM_CODE) AND T.RPT_ITEM_TYPE = 1 --是否是叶子报表项,1=是,0=否,基本报表项 AND T.ENABLE_FLAG = 1 AND T.VERSION = '202308' --使用快照,增加条件限制 ORDER BY T.RPT_ITEM_ID 修改点比对 案例2:递归驱动分支没有FROM字句 原始语句 SELECT A.DYNM_COMP_ID, DECODE(B.LINE_NO, 1, '202308', A.VERSION) FROM BIF.BIF_DYNM_COMP_SOU_TBL_V A, (WITH recursive cte AS ( SELECT 1 AS level UNION ALL SELECT cte.level + 1 FROM cte WHERE cte.level + 1 < 3 ) SELECT level as LINE_NO FROM cte ) B WHERE EXISTS (SELECT 1 FROM BIF.BIF_RPT_ITEM_DEF_MV RPT, BIF.BIF_PUB_SUBJECT_AREA_T SBJ, BIF.BIF_SNAPSHORT_SUBJECT_V TYP WHERE A.DYNM_COMP_ID = RPT.DYNM_COMP_ID AND RPT.VERSION = 'current' AND RPT.SUBJECT_AREA_ID = SBJ.SUBJECT_AREA_ID AND SBJ.SUBJECT_AREA_CODE =TYP.SUBJECT_CODE AND TYP.SUBJECT_TYPE ='TAX') AND A.VERSION = 'current' 改写语句 SELECT A.DYNM_COMP_ID, DECODE(B.LINE_NO, 1, '202308', A.VERSION) FROM BIF.BIF_DYNM_COMP_SOU_TBL_V A, (SELECT * FROM generate_series(1, 2) AS cte(LINE_NO) ) B WHERE EXISTS (SELECT 1 FROM BIF.BIF_RPT_ITEM_DEF_MV RPT, BIF.BIF_PUB_SUBJECT_AREA_T SBJ, BIF.BIF_SNAPSHORT_SUBJECT_V TYP WHERE A.DYNM_COMP_ID = RPT.DYNM_COMP_ID AND RPT.VERSION = 'current' AND RPT.SUBJECT_AREA_ID = SBJ.SUBJECT_AREA_ID AND SBJ.SUBJECT_AREA_CODE =TYP.SUBJECT_CODE AND TYP.SUBJECT_TYPE ='TAX') AND A.VERSION = 'current' 修改点比对 案例3:递归驱动分支是VALUES字句 原始语句 WITH RECURSIVE t(n) AS ( VALUES (1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600) ) ) SELECT n AS LVL FROM t 改写语句 WITH RECURSIVE t(n) AS ( SELECT * FROM generate_series(1, 1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600) ) ) SELECT n AS LVL FROM t 修改点比对 案例4:递归驱动分支是VALUES字句 原始语句 WITH RECURSIVE t(n) AS ( VALUES (1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600)) ) SELECT n AS LVL FROM t 改写语句 SELECT * FROM generate_series(1, (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600)) ) AS t(lvl) 修改点比对 场景2:With-Recursive contains system table is not shippable 根因:递归语句的某个分支中没有FROM字句中只用系统表或者系统视图(DUAL也被视为系统视图) 案例1:递归驱动分支是FROM DUAL查询 原始语句 WITH recursive cte AS ( SELECT TO_DATE(201701, 'YYYYMM') as level ,TO_DATE(20170131, 'YYYYMMDD') LASTDAY FROM dual UNION ALL SELECT ADD_MONTHS(cte.LEVEL, 1) AS PERIOD, LAST_DAY(ADD_MONTHS(cte.LEVEL, 1)) AS LASTDAY FROM cte WHERE cte.LEVEL <=SYSDATE ) SELECT TO_CHAR(cte.level,'YYYYMMDD') AS PERIOD , cte.LASTDAY FROM cte WHERE TO_CHAR(cte.level,'YYYYMMDD')<= TO_CHAR(SYSDATE,'YYYYMMDD') 改写语句 WITH recursive cte AS ( SELECT TO_DATE(201701, 'YYYYMM') as level ,TO_DATE(20170131, 'YYYYMMDD') LASTDAY FROM generate_series(1, 1) UNION ALL SELECT ADD_MONTHS(cte.LEVEL, 1) AS PERIOD, LAST_DAY(ADD_MONTHS(cte.LEVEL, 1)) AS LASTDAY FROM cte WHERE cte.LEVEL <=SYSDATE ) SELECT TO_CHAR(cte.level,'YYYYMMDD') AS PERIOD , cte.LASTDAY FROM cte WHERE TO_CHAR(cte.level,'YYYYMMDD')<= TO_CHAR(SYSDATE,'YYYYMMDD') 修改点对比 场景3:SubPlan exec on CN can't be shipped 根因:某个子查询语句只能在CN上执行,通常是这个子查询有不下推因素,比如有系统表、系统视图调用,或者存在不下推函数等 案例1:子查询中系统表/系统视图查询 原始语句 WITH error_log AS NOT MATERIALIZED ( SELECT upper(log_column_name) AS log_column_name, log_error_code, s.char_length AS data_length, s.data_type,s.nullable FROM (SELECT distinct unnest(string_to_array(bad_log_column_name,',')) AS log_column_name, unnest(string_to_array(bad_log_error_code,',')) AS log_error_code FROM stgltc.BAD_cfs_inv_invoice_ad_2500 ) T, (SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500')) S WHERE upper(T.log_column_name)=upper(S.column_name) ) SELECT CASE WHEN upper('ACTIVITY_NAME') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ACTIVITY_NAME,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ACTIVITY_NAME'))) ELSE ACTIVITY_NAME END AS ACTIVITY_NAME, CASE WHEN upper('ADJUSTMENT_ID') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ADJUSTMENT_ID,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ADJUSTMENT_ID'))) ELSE ADJUSTMENT_ID END AS ADJUSTMENT_ID FROM stgltc.BAD_cfs_inv_invoice_ad_2500 改写语句 -- 识别不下推的子查询为WITH error_log字句中的 -- SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500') -- -- 因为这部分为系统表查询,无论如何都不能下推,所以此处把这部分结果转储到一个中间表中 -- 中间表创建成行存表 CREATE TEMP TABLE s WITH(orientation=row) DISTRIBUTE BY ROUNDROBIN AS SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500') -- 因为整个查询涉及到的表都是列存表,之后前面创建的临时表s为行存表 -- 所以此处加一个强制走向量化的hint WITH error_log AS NOT MATERIALIZED ( SELECT upper(log_column_name) AS log_column_name, log_error_code, s.char_length AS data_length, s.data_type,s.nullable FROM (SELECT distinct unnest(string_to_array(bad_log_column_name,',')) AS log_column_name, unnest(string_to_array(bad_log_error_code,',')) AS log_error_code FROM stgltc.bad_cfs_inv_invoice_ad_2500 ) T, pg_temp.S WHERE upper(T.log_column_name)=upper(S.column_name) ) SELECT /*+ set global(enable_force_vector_engine on)*/ CASE WHEN upper('ACTIVITY_NAME') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ACTIVITY_NAME,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ACTIVITY_NAME'))) ELSE ACTIVITY_NAME END AS ACTIVITY_NAME, CASE WHEN upper('ADJUSTMENT_ID') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ADJUSTMENT_ID,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ADJUSTMENT_ID'))) ELSE ADJUSTMENT_ID END AS ADJUSTMENT_ID FROM stgltc.bad_cfs_inv_invoice_ad_2500 修改点对比 场景4:Type of Record in TargetList can not be shipped 根因:输出列中存在record类型,这种类型的不下推一般是不会体现在最外层的输出列上,一般这类报错有两个场景 1.SQL书写逻辑错误,导致输出列上出现了(...)形式的输出列 2.SQL业务逻辑正确, 这种场景需要了解业务含义,把record字段强转为text类型,然后再使用record字段的地方做特殊适配 案例1:输出列书写错误,出现(...)形式的输出列 原始语句 SELECT d.id, coalesce(d.period, 'snull') AS period, (d.plan_unit_code, 'snull') AS plan_unit_code, coalesce(d.product_type_model, 'snull') AS product_type_model, coalesce(d.revision, 'snull') AS revision, d.start_date FROM (SELECT * FROM cdcscm.cdc_mp_d_forecast_t_6120 t WHERE t.cdc_timestamp > to_date('2023-07-06 00:00:00', 'yyyy-mm-dd hh24:mi:ss') - 7 AND t.cdc_timestamp < to_date('2023-08-08 00:00:00', 'yyyy-mm-dd hh24:mi:ss') ) t1, sdiscm.mp_d_forecast_t_6120 d WHERE (t1.audit_op_type = 'delete' AND t1.audit_op_option = 'before') AND d.id = t1.id 改写语句 SELECT d.id, coalesce(d.period, 'snull') AS period, coalesce(d.plan_unit_code, 'snull') AS plan_unit_code, coalesce(d.product_type_model, 'snull') AS product_type_model, coalesce(d.revision, 'snull') AS revision, d.start_date FROM (SELECT * FROM cdcscm.cdc_mp_d_forecast_t_6120 t WHERE t.cdc_timestamp > to_date('2023-07-06 00:00:00', 'yyyy-mm-dd hh24:mi:ss') - 7 AND t.cdc_timestamp < to_date('2023-08-08 00:00:00', 'yyyy-mm-dd hh24:mi:ss') ) t1, sdiscm.mp_d_forecast_t_6120 d WHERE (t1.audit_op_type = 'delete' AND t1.audit_op_option = 'before') AND d.id = t1.id 修改点对比 备注:改写前后语句不等价,不等价的原因是因为原始SQL书写有问题,正确的写法是就是coalesce(d.plan_unit_code, 'snull') AS plan_unit_code。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓现网案例丨超大结果集接收异常

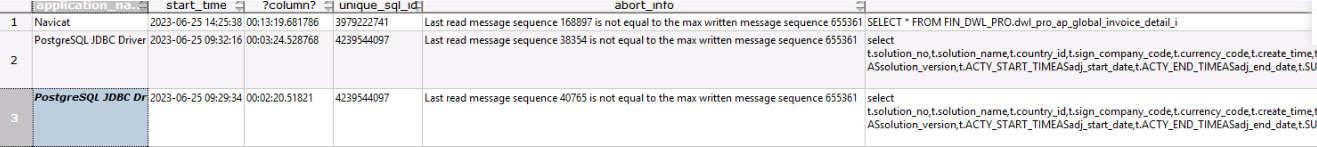
本文分享自华为云社区《GaussDB(DWS)现网案例之超大结果集接收异常》,作者:你是猴子请来的救兵吗 。 问题背景 内核版本GaussDB 8.1.3 问题描述用户使用数据库客户端工具如navicat、dbeaver等执行查询语句异常中断,中断信息"Last read message sequence %d is not equal to the max written message sequence %d" 问题定位 客户端异常中断后有些错误信息时不感知的,此时topsql就派上了用场。历史topsql记录了查询作业运行结束时的资源使用情况(包括内存、下盘、CPU时间等)和运行状态信息(包括报错、终止、异常等)以及性能告警信息。而对于由于FATAL、PANIC错误导致查询异常结束时,状态信息列只显示aborted,无法记录详细异常信息。 1,此时我们通过历史topsql查询视图查询语句执行情况 --当前CN select * from GS_WLM_SESSION_HISTORY; --所有CN select * from PGXC_WLM_SESSION_HISTORY; 根据topsql记录结果发现语句存在abort_info为 Last read message sequence %d is not equal to the max written message sequence %d 可知,查询执行遇到FATAL、PANIC错误导致查询异常结束 2,接着确认日志信息,通过线程ID查看当时语句执行情况,发现客户端存在异常中断 根因分析 前提: cn_retry开启+查询语句+max_cn_temp_file_size临时文件开启 发送逻辑: 服务端执行查询之后,会通过发送缓冲区往客户端发送数据;当查询结果集过大,则发送缓冲区满了之后,会往临时文件写数据;当临时文件超出max_cn_temp_file_size指定的最大值时(此时会禁用cn_retry),需要分批发送,此时会先将已写入临时文件的数据发送至客户端;然后继续将剩余数据写入新的临时文件发送,以此循环,直到所有数据发送完成。 问题场景: 当临时文件超出最大值时,先将其发送至客户端,此时客户端断连(如产生oom),数据发送中断,此时已发送数据量与已写入临时文件的数据量不一致,因此产生报错 Last read message sequence %d is not equal to the max written message sequence %d 此报错代表已写入临时文件的数据与已发送到客户端的数据量不一致,实际场景为客户端异常导致的发送数据中断,因此报错内容符合预期。 相关知识 相关guc参数: 1,cn_send_buffer_size:指定CN端数据发送数据缓存区的大小。整型,8~128, 单位为KB。默认8KB 2,max_cn_temp_file_size:指定SQL语句出错自动重试功能中CN端使用临时文件的最大值,设定为0表示不使用临时文件。默认5G 相关日志记录: 1,临时文件超出max_cn_temp_file_size,记录" %s temp file exceeded, max temp file size : %d KB, current result size : %ld KB" 2,客户端异常导致数据发送失败,记录"could not send data to client [ Remote IP: %s PORT: %s]. detail:%s" 3,数据发送中断或结束,当已发送数据和已写入临时文件的数据量不一致时,记录"Last read message sequence %d is not equal to the max written message sequence %d" 场景复现 创建普通表即可,导入一定量的数据,执行简单查询使其返回较大的结果集,如 select * from store_sales; 为了方便场景复现,临时将允许的临时文件最大值调整为500M,便于触发分批发送。 1,正常接收场景 此时客户端环境内存足够,可正常接收数据,超大结果集将通过临时文件下盘的方法分批发送,直到所有数据发送完成。 2,异常中断场景 此时客户端环境允许的数据量优先,超大结果集将分批发送的过程中,客户端触发OOM异常中断,服务端会记录客户端异常发送失败信息以及已发送数据不一致的错误信息。 改善办法 1,避免超大结果集的查询,如果无法避免,则通过分页或游标多次查询 2,增大客户端支持的运行内存,防止内存不足 知识小结 1,报错Last read message sequence %d is not equal to the max written message sequence %d为超大结果集返回异常中断时的报错,符合预期,需通过业务语句的改写或客户端环境的改善来解决。 2,TopSQL查询监控的原理和适用方法可参考:GaussDB for DWS 资源监控核心技术解密: TopSQL查询监控解密 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓实践丨主动预防-DWS关键工具安装确认

摘要:gdb确认是否安装,所带来的该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避。 本文分享自华为云社区《主动预防-DWS关键工具安装确认》,作者:上官寒雨。 【关键工具确认】 1、gdb确认是否安装(该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gdb --help 提示以下信息则已安装 2、gstack是否安装(与gdb关联工具,gdb安装后此工具会默认安装,作用与gdb相同) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gstack 提示以下信息则已安装 gdb与gstack安装请参考以下链接: https://bbs.huaweicloud.com/forumreview/thread-182292-1-1.html 3、core是否配置(该配置可以确保数据库实例触发core问题后能够抓取异常堆栈信息,以便使用gdb工具从所抓取信息中获取触发实例异常sql及时规避与根因定位) 集群状态为Normal时执行以下命令确认(集群normal情况下该操作不影响业务) kill -11 备dn进程号,检查对应的数据目录下是否生成core文件,若产生core文件则已配置。 若未配置请按照以下链接进行配置: HC/HCS/HCSO core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=181948 纯软core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=182036 4、pg_xlogdump是否存在(异常业务产生大量xlog后造成业务慢,磁盘使用率快速上涨等问题,使用此工具解析异常业务) pg_xlogdump提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) 5、pagehack是否存在(数据文件出现静默损坏使用该工具解析异常数据文件) pagehack提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) pg_xlogdump与pagehack工具获取如下链接: https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=142380 上传步骤如下: 步骤1:登录至第一个CN节点,使用omm(云上使用Ruby用户)将pagehack、pg_xlogdump工具上传至该节点$GAUSSHOME/bin/下步骤2:将工具分发至其他节点 gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pagehack $GAUSSHOME/bin/" gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pg_xlogdump $GAUSSHOME/bin/" $hostname为第一个cn节点的hostname。 6、 gs_detect工具上传步骤(此工具包未运维团队开发,其中包括集群状态异常诊断工具、IO高工具、数据文件损坏扫描等工具,方便出现问题后及时定位及恢复) 步骤1:omm用户登录第一个cn节点(云上使用Ruby),在附件获取gs_detect工具并重命名为gs_detect.tar.gz上传至第一个cn节点/home/omm路径下(HC/HCS/HCSO形态放在第一个cn节点/home/Ruby路径下) 步骤2:使用以下命令解压 cd /home/omm tar -zxvf gs_detect.tar.gz 步骤3:将gs_detect工具分发至其他节点 gs_ssh -c "scp -rhostname:/home/omm/gs_detect /home/omm" $hostname为第一个cn节点的hostname。 注:云上的分发命令需要在沙箱内执行 【系统加固】 1、arm加固项确认(x86机器不涉及) https://support.huawei.com/enterprise/zh/bulletins-product/ENEWS2000007743 2、Centos7.6impi模块导致服务器反复重启,修复方案见附件 《CentOS7.6 ipmi模块补丁合入指导.docx》 附件:gs_detect.tar.txt67.72KB 附件:ipmi模块补丁合入指导.docx2.33MB 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册