实践心得 | 用 Apache SeaTunnel 搞定 PostgreSQL 到平凯数据库云服务的数据迁移
 **作者 | bytehouse** ## **一、迁移背景** 我们业务初期采用 PostgreSQL 作为 OLTP 兼分析型数据库,采用本地自建部署方式。实际运维过程中,需要投入大量人力处理数据库高可用架构维护、定时备份、故障恢复等基础工作,运维成本高、复杂度高,且偶尔会出现运维疏漏,存在一定的业务连续性风险。考虑到 平凯数据库云服务 无需本地部署运维、使用便捷,且计费模式灵活可控,我们决定在优先保证业务连续性和稳定性的前提下,尝试将 PostgreSQL 数据库迁移至 平凯数据库云服务,同时也希望通过这次迁移,探索更适合业务的多元化数据存储与分析架构。我们的核心业务为**道路交通卡口数据分析**——基于海量车辆通行记录(车牌、车速、位置、驾驶行为特征等),为交通管理与安全监管提供数据支撑。核心数据表 driving\_data\_jsonb 采用 JSONB + 分区表设计,日均过车记录约 500 万条,单分区存储约 1.5 亿条车辆通行记录(约 60GB),是业务中数据量最大、查询最频繁的表。典型分析场景包括: * **道路拥堵指数分析**:按时间段、路段聚合车流量与平均车速,实时评估道路通行状态 * **区间超速检测**:基于卡口间通行时间与距离,计算车辆区间平均速度,识别超速行为 * **驾驶轨迹分析**:还原车辆行驶路径,分析驾驶习惯与异常行为模式 * **连续驾驶时长监控**:追踪单车连续驾驶时间,配合交通法规(如连续驾驶 4 小时需强制休息)进行预警这类分析查询涉及大量数据聚合与多维交叉计算,对数据库的 OLAP 能力要求较高。 ## **二、迁移环境概览** ### **2.1 ****源端环境** | 项目 | 详情 | | ---------- | ---------------------------------------------------------- | | 数据库 | PostgreSQL 18.2 | | 部署方式 | 本地虚拟机(测试环境) | | 数据库 | traffic(交通数据业务库) | | 核心表 | driving\_data\_jsonb(分区表,单分区约 1.5 亿行 / 60GB) | | 网络出口 | 500Mbps 宽带,直连公网 | ### **2.2 ****目标端环境** | 项目 | 详情 | | ---------- | ----------------------------------- | | 平台 | 平凯数据库云服务(PingKai Cloud) | | 区域 | cn-shanghai(上海) | | 存储消耗 | 约 62.62 GiB | ### **2.3 ****网络拓扑** 源端通过 500Mbps 宽带经公网直连平凯数据库云服务,未部署专线或 VPN。 ## **三、迁移工具选型** 迁移过程中,我们重点对比了 DataX 和 SeaTunnel 两款常用迁移工具。 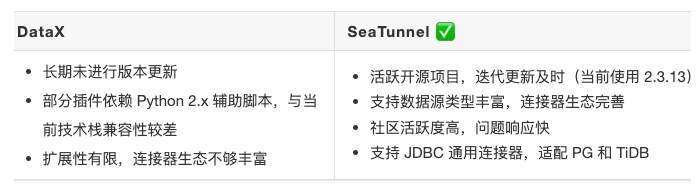 结合业务对"及时同步、稳定无丢失"的核心要求,最终选用 **SeaTunnel 2.3.13** 作为迁移工具。 ## **四、SeaTunnel 迁移实战** ### **4.1 ****迁移策略:全量****+****增量两步走** 由于 SeaTunnel 2.3.13 版本的 PG-CDC 连接器在"全量 + 增量一体化"模式下存在已知 Bug(已向社区反馈并协助修复),我们采用**全量初始化****+ CDC****增量同步两步走**的方案: **第一步**:通过 JDBC PostgreSQL 连接器进行全量数据初始化同步 **第二步**:基于 CDC 增量连接器实现实时数据同步 ### **4.2 ****全量同步配置(Jdbc Source → Jdbc Sink**) 以下为全量同步阶段的核心配置: ``` env { parallelism = 2 checkpoint.interval = 10000 pipeline.name = "PG_TO_TiDB_DRIVING" flink.execution.checkpointing.mode = "EXACTLY_ONCE" flink.execution.checkpointing.timeout = 600000 } source { Jdbc { url = "jdbc:postgresql://:5432/traffic" driver = "org.postgresql.Driver" user = "postgres" password = "******" query = "SELECT record_id, pass_time, plate_no, plate_color, vehicle_type, speed, speed_limit, status, longitude, latitude, speed_variance, lane_change_count, raw_behavior_features, create_time, update_time FROM driving_data_jsonb" column.filters = "update_time" start.time = "2025-01-01 00:00:00" fetch.size = 1000 parallelism = 2 } } sink { Jdbc { url = "jdbc:mysql://:4000/traffic?sslMode=VERIFY_IDENTITY" driver = "com.mysql.cj.jdbc.Driver" user = "******" password = "******" database = "traffic" table = "driving_data_jsonb" generate_sink_sql = true save_mode = "upsert" unique_key = ["record_id"] batch.size = 1000 batch.interval = 1000 parallelism = 2 } } ``` ### **4.3 ****增量同步配置(Postgres-CDC Source → Jdbc Sink**) 全量同步完成后,启动 CDC 增量连接器实时同步源端变更数据: ``` env { execution.parallelism = 1 job.mode = "STREAMING" checkpoint.interval = 5000 } source { Postgres-CDC { username = "postgres" password = "******" database-names = ["traffic"] schema-names = ["public"] table-names = ["traffic.public.driving_data_jsonb"] url = "jdbc:postgresql://:5432/traffic" decoding.plugin.name = "pgoutput" slot.name = "final_slot" startup.mode = "latest" plugin_output = "out" } } sink { Jdbc { url = "jdbc:mysql://:4000/traffic?sslMode=VERIFY_IDENTITY" driver = "com.mysql.cj.jdbc.Driver" user = "******" password = "******" database = "traffic" table = "driving_data_jsonb" generate_sink_sql = true save_mode = "upsert" unique_key = ["record_id"] batch.size = 1000 batch.interval = 1000 parallelism = 2 } } ``` ### **4.4 ****关键配置说明** 以下为全量同步与增量同步中的关键配置项说明: | 配置项 | 说明 | | ---------------------------------- | ----------------------------------------------- | | parallelism = 2 | 并行度设为 2,匹配源端资源 | | checkpoint.mode = EXACTLY\_ONCE | 端到端精确一次语义,保障数据一致性 | | checkpoint.interval = 10000 | Checkpoint 间隔 10 秒,平衡性能与容错 | | save\_mode = upsert | 基于 unique\_key 做 Upsert 写入,避免重复数据 | | unique\_key = ["record\_id"] | 以 record\_id 作为去重键 | | sslMode = VERIFY\_IDENTITY | 平凯数据库云服务强制 TLS 加密连接 | | batch.size / batch.interval | 批量写入 1000 条或每 1 秒刷写一次,取先到者 | | decoding.plugin.name = pgoutput | CDC 增量同步使用 PostgreSQL 原生逻辑解码插件 | | slot.name | 指定逻辑复制槽名称,确保增量数据不丢失 | | startup.mode = latest | 从最新位置开始消费增量数据,避免重复同步 | ### **4.5 ****迁移结果** | 指标 | 数据 | | --------------- | -------------------------------------------------------------------------------------------------------------------------------------------------- | | 全量同步耗时 | 单分区约 12 小时(源端为虚拟机测试环境) | | 增量同步延迟 | 迁移过程顺畅,未出现明显延迟 | | 数据一致性 | 每条记录包含唯一主键 record\_id,Sink 端采用 upsert 模式写入,基于主键去重,确保数据不丢不重。迁移完成后通过源端与目标端的行数比对进行最终验证。 | | Schema 兼容性 | 未遇到 PG → TiDB 的数据类型映射问题 | **说明**:本次迁移优先完成了数据量最大的主表(driving\_data\_jsonb),其他表数据量较小,后续按需同步。 ## **五、踩坑与经验** ### **5.1 PG-CDC****连接器****Bug** SeaTunnel 2.3.13 的 PG-CDC 连接器在全量 + 增量一体化模式下存在 Bug,导致流程无法正常完成。我们通过社区反馈联系到开发者并协助定位修复,最终采用全量与增量分步执行的方式规避了该问题。 **建议**:使用 SeaTunnel 进行 PG 迁移时,建议优先采用全量 + 增量两步走的方案,稳定性更有保障。如需使用一体化模式,请确认所用版本已修复该问题。 ### **5.2 ****网络带宽影响** 源端部署在本地虚拟机,通过 500Mbps 宽带经公网连接平凯数据库云服务,单分区 60GB 数据全量同步耗时约 12 小时。如果源端部署在云端同区域或使用专线,同步耗时预计可大幅缩短。 ## **六、迁移后业务表现** 迁移至平凯数据库云服务后,最直观的提升就是 **OLAP****场景下的业务表现**——统计分析、复杂查询的效率有了明显改善,业务端查询等待时间缩短,查询体验得到优化。后续我们计划结合具体业务场景,进一步探索启用 **TiFlash** 列式存储引擎,以此进一步优化分析查询性能,充分发挥 TiDB HTAP 架构在行列混用场景下的优势。 **说明**:目前我们尚未整理出详细的迁移后业务应用分析结果,具体的查询性能对比数据将在后续补充。 ## **七、总结与建议** **整体评价** 本次 PostgreSQL 到平凯数据库云服务的迁移整体达到了预期目标。SeaTunnel 作为迁移工具表现稳定,全量同步与增量同步均顺利完成,未出现数据丢失问题。平凯数据库云服务在 OLAP 分析场景下带来了可感知的性能提升,同时大幅降低了数据库运维负担。 **给其他****PG****用户的迁移建议** 1. **工具选择**:推荐 SeaTunnel,连接器生态丰富且社区活跃,JDBC 通用连接器可快速适配 PG 和 TiDB 2. **迁移策略**:建议采用全量 + 增量两步走,稳定性优于一体化模式 3. **数据一致性**:务必开启 EXACTLY\_ONCE Checkpoint 模式,使用 upsert 写入避免重复 4. **网络规划**:源端与 平凯数据库云服务 的网络质量对全量同步耗时影响显著,建议优先使用同云部署或专线连接 5. **安全连接**:平凯数据库云服务 强制 TLS,Sink 端配置 sslMode=VERIFY\_IDENTITY 确保传输加密