首页 文章 精选 留言 我的

精选列表

搜索[python],共10000篇文章
优秀的个人博客,低调大师

Python全栈 Web(Django框架、模板继承、模型)

模板的继承: 语法: 在父模板中 必须要标识出那些内容在子模板中允许为修改 {% block 名称 %} {% endblock %} 在子模板中 指定继承自那个父模板 {% extends '父模板名称' %} 增加block标签 改写属于自的内容 {% block 名称 %} {% endblock %} block的作用: 在父模板中正常显示 在子模板中 如果不修改的话 则按父模板的内容显示 要是修改的话则按照子模板的内容显示 <!doctype html> &

优秀的个人博客,低调大师

19、python操作系统的发展史

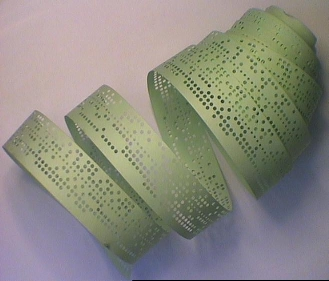
操作系统的发展史 手工操作 —— 穿孔卡片 1946年第一台计算机诞生--20世纪50年代中期,计算机工作还在采用手工操作方式。此时还没有操作系统的概念。 程序员将对应于程序和数据的已穿孔的纸带(或卡片)装入输入机,然后启动输入机把程序和数据输入计算机内存,接着通过控制台开关启动程序针对数据运行;计算完毕,打印机输出计算结果;用户取走结果并卸下纸带(或卡片)后,才让下一个用户上机。 手工操作方式两个特点: (1)用户独占全机。不会出现因资源已被其他用户占用而等待的现象,但资源的利用率低。 (2)CPU 等待手工操作。CPU的利用不充分。 20世纪50年代后期,出现人机矛盾:手工操作的慢速度和计算机的高速度之间形成了尖锐矛盾,手工操作方式已严重损害了系统资源的利用率(使资源利用率降为百分之几,甚至更低),不能容忍。唯一的解决办法:只有摆脱人的手工操作,实现作业的自动过渡。这样就出现了成批处理。 批处理 —— 磁带存储 批处理系统:加载在计算机上的一个系统软件,在它的控制下,计算机能够自动地、成批地处理一个或多个用户的作业(这作业包括程序、数据和命令)。 联机批处理系统 首先出现的是联机批处理系统,即作业的输入/输出由CPU来处理。 主机与输入机之间增加一个存储设备——磁带,在运行于主机上的监督程序的自动控制下,计算机可自动完成:成批地把输入机上的用户作业读入磁带,依次把磁带上的用户作业读入主机内存并执行并把计算结果向输出机输出。完成了上一批作业后,监督程序又从输入机上输入另一批作业,保存在磁带上,并按上述步骤重复处理。 监督程序不停地处理各个作业,从而实现了作业到作业的自动转接,减少了作业建立时间和手工操作时间,有效克服了人机矛盾,提高了计算机的利用率。 但是,在作业输入和结果输出时,主机的高速CPU仍处于空闲状态,等待慢速的输入/输出设备完成工作: 主机处于“忙等”状态。 脱机批处理系统 为克服与缓解:高速主机与慢速外设的矛盾,提高CPU的利用率,又引入了脱机批处理系统,即输入/输出脱离主机控制。 卫星机:一台不与主机直接相连而专门用于与输入/输出设备打交道的。 其功能是: (1)从输入机上读取用户作业并放到输入磁带上。 (2)从输出磁带上读取执行结果并传给输出机。 这样,主机不是直接与慢速的输入/输出设备打交道,而是与速度相对较快的磁带机发生关系,有效缓解了主机与设备的矛盾。主机与卫星机可并行工作,二者分工明确,可以充分发挥主机的高速计算能力。 脱机批处理系统:20世纪60年代应用十分广泛,它极大缓解了人机矛盾及主机与外设的矛盾。 不足:每次主机内存中仅存放一道作业,每当它运行期间发出输入/输出(I/O)请求后,高速的CPU便处于等待低速的I/O完成状态,致使CPU空闲。 为改善CPU的利用率,又引入了多道程序系统。 多道程序系统 多道程序设计技术 所谓多道程序设计技术,就是指允许多个程序同时进入内存并运行。即同时把多个程序放入内存,并允许它们交替在CPU中运行,它们共享系统中的各种硬、软件资源。当一道程序因I/O请求而暂停运行时,CPU便立即转去运行另一道程序。 在A程序计算时,I/O空闲, A程序I/O操作时,CPU空闲(B程序也是同样);必须A工作完成后,B才能进入内存中开始工作,两者是串行的,全部完成共需时间=T1+T2。 将A、B两道程序同时存放在内存中,它们在系统的控制下,可相互穿插、交替地在CPU上运行:当A程序因请求I/O操作而放弃CPU时,B程序就可占用CPU运行,这样 CPU不再空闲,而正进行A I/O操作的I/O设备也不空闲,显然,CPU和I/O设备都处于“忙”状态,大大提高了资源的利用率,从而也提高了系统的效率,A、B全部完成所需时间<<T1+T2。 多道程序设计技术不仅使CPU得到充分利用,同时改善I/O设备和内存的利用率,从而提高了整个系统的资源利用率和系统吞吐量(单位时间内处理作业(程序)的个数),最终提高了整个系统的效率。 单处理机系统中多道程序运行时的特点: (1)多道:计算机内存中同时存放几道相互独立的程序; (2)宏观上并行:同时进入系统的几道程序都处于运行过程中,即它们先后开始了各自的运行,但都未运行完毕; (3)微观上串行:实际上,各道程序轮流地用CPU,并交替运行。 多道程序系统的出现,标志着操作系统渐趋成熟的阶段,先后出现了作业调度管理、处理机管理、存储器管理、外部设备管理、文件系统管理等功能。 由于多个程序同时在计算机中运行,开始有了空间隔离的概念,只有内存空间的隔离,才能让数据更加安全、稳定。 出了空间隔离之外,多道技术还第一次体现了时空复用的特点,遇到IO操作就切换程序,使得cpu的利用率提高了,计算机的工作效率也随之提高。 多道批处理系统 20世纪60年代中期,在前述的批处理系统中,引入多道程序设计技术后形成多道批处理系统(简称:批处理系统)。 它有两个特点: (1)多道:系统内可同时容纳多个作业。这些作业放在外存中,组成一个后备队列,系统按一定的调度原则每次从后备作业队列中选取一个或多个作业进入内存运行,运行作业结束、退出运行和后备作业进入运行均由系统自动实现,从而在系统中形成一个自动转接的、连续的作业流。 (2)成批:在系统运行过程中,不允许用户与其作业发生交互作用,即:作业一旦进入系统,用户就不能直接干预其作业的运行。 批处理系统的追求目标:提高系统资源利用率和系统吞吐量,以及作业流程的自动化。 批处理系统的一个重要缺点:不提供人机交互能力,给用户使用计算机带来不便。 虽然用户独占全机资源,并且直接控制程序的运行,可以随时了解程序运行情况。但这种工作方式因独占全机造成资源效率极低。 一种新的追求目标:既能保证计算机效率,又能方便用户使用计算机。 20世纪60年代中期,计算机技术和软件技术的发展使这种追求成为可能。 分时系统 由于CPU速度不断提高和采用分时技术,一台计算机可同时连接多个用户终端,而每个用户可在自己的终端上联机使用计算机,好象自己独占机器一样。 分时技术:把处理机的运行时间分成很短的时间片,按时间片轮流把处理机分配给各联机作业使用。 若某个作业在分配给它的时间片内不能完成其计算,则该作业暂时中断,把处理机让给另一作业使用,等待下一轮时再继续其运行。由于计算机速度很快,作业运行轮转得很快,给每个用户的印象是,好象他独占了一台计算机。而每个用户可以通过自己的终端向系统发出各种操作控制命令,在充分的人机交互情况下,完成作业的运行。 具有上述特征的计算机系统称为分时系统,它允许多个用户同时联机使用计算机。 特点: (1)多路性。若干个用户同时使用一台计算机。微观上看是各用户轮流使用计算机;宏观上看是各用户并行工作。 (2)交互性。用户可根据系统对请求的响应结果,进一步向系统提出新的请求。这种能使用户与系统进行人机对话的工作方式,明显地有别于批处理系统,因而,分时系统又被称为交互式系统。 (3)独立性。用户之间可以相互独立操作,互不干扰。系统保证各用户程序运行的完整性,不会发生相互混淆或破坏现象。 (4)及时性。系统可对用户的输入及时作出响应。分时系统性能的主要指标之一是响应时间,它是指:从终端发出命令到系统予以应答所需的时间。 分时系统的主要目标:对用户响应的及时性,即不至于用户等待每一个命令的处理时间过长。 分时系统可以同时接纳数十个甚至上百个用户,由于内存空间有限,往往采用对换(又称交换)方式的存储方法。即将未“轮到”的作业放入磁盘,一旦“轮到”,再将其调入内存;而时间片用完后,又将作业存回磁盘(俗称“滚进”、“滚出“法),使同一存储区域轮流为多个用户服务。 多用户分时系统是当今计算机操作系统中最普遍使用的一类操作系统。 注意:分时系统的分时间片工作,在没有遇到IO操作的时候就用完了自己的时间片被切走了,这样的切换工作其实并没有提高cpu的效率,反而使得计算机的效率降低了。但是我们牺牲了一点效率,却实现了多个程序共同执行的效果,这样你就可以在计算机上一边听音乐一边聊qq了。 实时系统 虽然多道批处理系统和分时系统能获得较令人满意的资源利用率和系统响应时间,但却不能满足实时控制与实时信息处理两个应用领域的需求。于是就产生了实时系统,即系统能够及时响应随机发生的外部事件,并在严格的时间范围内完成对该事件的处理。 实时系统在一个特定的应用中常作为一种控制设备来使用。 实时系统可分成两类: (1)实时控制系统。当用于飞机飞行、导弹发射等的自动控制时,要求计算机能尽快处理测量系统测得的数据,及时地对飞机或导弹进行控制,或将有关信息通过显示终端提供给决策人员。当用于轧钢、石化等工业生产过程控制时,也要求计算机能及时处理由各类传感器送来的数据,然后控制相应的执行机构。 (2)实时信息处理系统。当用于预定飞机票、查询有关航班、航线、票价等事宜时,或当用于银行系统、情报检索系统时,都要求计算机能对终端设备发来的服务请求及时予以正确的回答。此类对响应及时性的要求稍弱于第一类。 实时操作系统的主要特点: (1)及时响应。每一个信息接收、分析处理和发送的过程必须在严格的时间限制内完成。 (2)高可靠性。需采取冗余措施,双机系统前后台工作,也包括必要的保密措施等。 分时——现在流行的PC,服务器都是采用这种运行模式,即把CPU的运行分成若干时间片分别处理不同的运算请求 linux系统 实时——一般用于单片机上、PLC等,比如电梯的上下控制中,对于按键等动作要求进行实时处理 通用操作系统 操作系统的三种基本类型:多道批处理系统、分时系统、实时系统。 通用操作系统:具有多种类型操作特征的操作系统。可以同时兼有多道批处理、分时、实时处理的功能,或其中两种以上的功能。 例如:实时处理+批处理=实时批处理系统。首先保证优先处理实时任务,插空进行批处理作业。常把实时任务称为前台作业,批作业称为后台作业。 再如:分时处理+批处理=分时批处理系统。即:时间要求不强的作业放入“后台”(批处理)处理,需频繁交互的作业在“前台”(分时)处理,处理机优先运行“前台”作业。 从上世纪60年代中期,国际上开始研制一些大型的通用操作系统。这些系统试图达到功能齐全、可适应各种应用范围和操作方式变化多端的环境的目标。但是,这些系统过于复杂和庞大,不仅付出了巨大的代价,且在解决其可靠性、可维护性和可理解性方面都遇到很大的困难。 相比之下,UNIX操作系统却是一个例外。这是一个通用的多用户分时交互型的操作系统。它首先建立的是一个精干的核心,而其功能却足以与许多大型的操作系统相媲美,在核心层以外,可以支持庞大的软件系统。它很快得到应用和推广,并不断完善,对现代操作系统有着重大的影响。 至此,操作系统的基本概念、功能、基本结构和组成都已形成并渐趋完善。 操作系统的进一步发展 进入20世纪80年代,大规模集成电路工艺技术的飞跃发展,微处理机的出现和发展,掀起了计算机大发展大普及的浪潮。一方面迎来了个人计算机的时代,同时又向计算机网络、分布式处理、巨型计算机和智能化方向发展。于是,操作系统有了进一步的发展,如:个人计算机操作系统、网络操作系统、分布式操作系统等。 个人计算机操作系统 个人计算机上的操作系统是联机交互的单用户操作系统,它提供的联机交互功能与通用分时系统提供的功能很相似。 由于是个人专用,因此一些功能会简单得多。然而,由于个人计算机的应用普及,对于提供更方便友好的用户接口和丰富功能的文件系统的要求会愈来愈迫切。 网络操作系统 计算机网络:通过通信设施,将地理上分散的、具有自治功能的多个计算机系统互连起来,实现信息交换、资源共享、互操作和协作处理的系统。 网络操作系统:在原来各自计算机操作系统上,按照网络体系结构的各个协议标准增加网络管理模块,其中包括:通信、资源共享、系统安全和各种网络应用服务。 分布式操作系统 表面上看,分布式系统与计算机网络系统没有多大区别。分布式操作系统也是通过通信网络,将地理上分散的具有自治功能的数据处理系统或计算机系统互连起来,实现信息交换和资源共享,协作完成任务。——硬件连接相同。 但有如下一些明显的区别: (1)分布式系统要求一个统一的操作系统,实现系统操作的统一性。 (2)分布式操作系统管理分布式系统中的所有资源,它负责全系统的资源分配和调度、任务划分、信息传输和控制协调工作,并为用户提供一个统一的界面。 (3)用户通过这一界面,实现所需要的操作和使用系统资源,至于操作定在哪一台计算机上执行,或使用哪台计算机的资源,则是操作系统完成的,用户不必知道,此谓:系统的透明性。 (4)分布式系统更强调分布式计算和处理,因此对于多机合作和系统重构、坚强性和容错能力有更高的要求,希望系统有:更短的响应时间、高吞吐量和高可靠性。 操作系统的作用 现代的计算机系统主要是由一个或者多个处理器,主存,硬盘,键盘,鼠标,显示器,打印机,网络接口及其他输入输出设备组成。 一般而言,现代计算机系统是一个复杂的系统。 其一:如果每位应用程序员都必须掌握该系统所有的细节,那就不可能再编写代码了(严重影响了程序员的开发效率:全部掌握这些细节可能需要一万年....) 其二:并且管理这些部件并加以优化使用,是一件极富挑战性的工作,于是,计算安装了一层软件(系统软件),称为操作系统。它的任务就是为用户程序提供一个更好、更简单、更清晰的计算机模型,并管理刚才提到的所有设备。 总结: 程序员无法把所有的硬件操作细节都了解到,管理这些硬件并且加以优化使用是非常繁琐的工作,这个繁琐的工作就是操作系统来干的,有了他,程序员就从这些繁琐的工作中解脱了出来,只需要考虑自己的应用软件的编写就可以了,应用软件直接使用操作系统提供的功能来间接使用硬件。 精简的说的话,操作系统就是一个协调、管理和控制计算机硬件资源和软件资源的控制程序。操作系统所处的位置如图 细说的话,操作系统应该分成两部分功能: #一:隐藏了丑陋的硬件调用接口,为应用程序员提供调用硬件资源的更好,更简单,更清晰的模型(系统调用接口)。应用程序员有了这些接口后,就不用再考虑操作硬件的细节,专心开发自己的应用程序即可。例如:操作系统提供了文件这个抽象概念,对文件的操作就是对磁盘的操作,有了文件我们无需再去考虑关于磁盘的读写控制(比如控制磁盘转动,移动磁头读写数据等细节),#二:将应用程序对硬件资源的竞态请求变得有序化例如:很多应用软件其实是共享一套计算机硬件,比方说有可能有三个应用程序同时需要申请打印机来输出内容,那么a程序竞争到了打印机资源就打印,然后可能是b竞争到打印机资源,也可能是c,这就导致了无序,打印机可能打印一段a的内容然后又去打印c...,操作系统的一个功能就是将这种无序变得有序。

优秀的个人博客,低调大师

python-进程之间通信、多线程介绍

一、进程之间通信 进程的任务有三种状态:运行,就绪,阻塞。 加锁可以让多个进程修改同一块数据时,同一时间只能由一个任务可以进行修改,即串行的修改。牺牲了速度,保证了数据安全。 虽然可以使用文件共享数据实现进程间的通信,但是效率太低,还需要自己加锁处理。为了解决这些问题,便使用到了multiprocessing模块为我们提供的基于消息的IPC通信机制:队列和管道 1.队列和管道都是将数据存放于内存中 2.队列是基于管道+锁的机制实现的。 我们应该尽量避免使用共享数据,多使用队列。 队列: 创建队列的类: Queue([maxsize]):创建共享的进程队列,Queue是多进程安全的队列,可以使用Queue实现多进程之间的数据传递。 maxsize是队列中允许的最大项数,省略则无大小限制 q = Queue() q.put() 括号里可以是任意类型,不能是大数据 主要方法: 1 q.put方法用以插入数据到队列中,put方法还有两个可选参数:blocked和timeout。如果blocked为True(默认值),并且timeout为正值,该方法会阻塞timeout指定的时间,直到该队列有剩余的空间。如果超时,会抛出Queue.Full异常。如果blocked为False,但该Queue已满,会立即抛出Queue.Full异常。没有参数时,q.put的个数大于队列数时,会一直阻塞住。 2 q.get方法可以从队列读取并且删除一个元素。同样,get方法有两个可选参数:blocked和timeout。如果blocked为True(默认值),并且timeout为正值,那么在等待时间内没有取到任何元素,会抛出Queue.Empty异常。如果blocked为False,有两种情况存在,如果Queue有一个值可用,则立即返回该值,否则,如果队列为空,则立即抛出Queue.Empty异常。没有参数时,q.get的个数大于队列数时,会一直阻塞住。 3.q.put_nowait()等价于q.put(block=False)队列满时再存也会抛异常 q.get_nowait()等价于q.get(block=False)队列为空取不出时会抛异常 from multiprocessing import Queue q=Queue(3) #1.不应该放大数据 2.可以任意类型 q.put(['first',]) q.put({'x':2,}) q.put(3) # q.put(6)#阻塞在存放的时候,当有内容被取出时才推出阻塞模式 print(q.get()) print(q.get()) print(q.get()) # print(q.get())#阻塞在取的时候,当有新内容添加进去才退出阻塞状态 test 生产者消费者模型: 在并发编程中使用生产者和消费者模式能够解决绝大多数并发问题。该模式通过平衡生产线程和消费线程的工作能力来提高程序的整体处理数据的速度。通俗的讲就是当程序中出现明显的两类任务,一类负责生产数据,一类负责处理数据,就可以引入这个模型来实现生产者与消费者的解耦合,平衡生产力与消费能力,从而提升效率。 初级版本: import time import random from multiprocessing import Process,Queue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() # if res ==None:break time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) if __name__ == '__main__': q = Queue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) p1.start() p2.start() p3.start() c1.start() c2.start() print('主') test1 这个时候就有一个问题,主进程一直在阻塞状态,永远不会结束。这是因为消费者在取空以后 还一直在原地阻塞着。 解决方法:让生产者在生产完毕后再往队列中发送一个结束信号,这样消费者在收到结束信号后跳出循环 版本二: import time import random from multiprocessing import Process,Queue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() if res ==None:break time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) if __name__ == '__main__': q = Queue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) p1.start() p2.start() p3.start() c1.start() c2.start() p1.join() p2.join() p3.join() q.put(None) q.put(None) q.put(None) print('主') test2 但是有几个生产者我们就要发送几个None,这不够优雅,于是我们导入了JoinableQueue模块 #JoinableQueue([maxsize]):这就像是一个Queue对象,但队列允许项目的使用者通知生成者项目已经被成功处理。通知进程是使用共享的信号和条件变量来实现的。 #参数介绍: maxsize是队列中允许最大项数,省略则无大小限制。 #方法介绍: JoinableQueue的实例p除了与Queue对象相同的方法之外还具有: q.task_done():使用者使用此方法发出信号,表示q.get()的返回项目已经被处理。如果调用此方法的次数大于从队列中删除项目的数量,将引发ValueError异常 q.join():生产者调用此方法进行阻塞,直到队列中所有的项目均被处理。阻塞将持续到队列中的每个项目均调用q.task_done()方法为止 版本三: import time import random from multiprocessing import Process,JoinableQueue def producer(name,food,q): for i in range(4): res = '%s%s'%(food,i) time.sleep(random.randint(1,3)) q.put(res) print('厨师[%s]生产了%s'%(name,res)) def consumer(name,q): while True: res = q.get() time.sleep(random.randint(1,3)) print('吃货%s吃了%s'%(name,res)) q.task_done() if __name__ == '__main__': q = JoinableQueue() #生产者 p1 = Process(target=producer,args=('egon','包子',q)) p2 = Process(target=producer,args=('lxx','豆浆',q)) p3 = Process(target=producer,args=('cw','油条',q)) #消费者 c1 = Process(target=consumer,args=('alex',q)) c2 = Process(target=consumer,args=('yxf',q)) c1.daemon=True c2.daemon=True p1.start() p2.start() p3.start() c1.start() c2.start() p1.join() p2.join() p3.join() q.join()#主进程等q结束,即q内数据被取干净了。 print('主') View Code 二、线程理论 进程是资源单位,由若干线程组成的,一个进程至少有一个线程,线程是操作系统直接支持的执行单元。一个进程相当于一块空间,空间内有若干的线程,就好比进程是一个车间,线程就是车间的流水线。同一个进程之间的线程是资源共享的。进程是程序执行的过程,那么线程就是程序执行的代码。 线程相比进程的优点:1.同一进程下,多个线程共享进程内的资源 2.创建线程的开销远远小于进程 三、线程的使用 (一).创建线程的两种方式(和进程类似) from threading import Thread import time def task(name): print('%s is running'%name) time.sleep(2) print('%s is done'%name) if __name__ == '__main__': t = Thread(target=task,args=('进程一',)) t.start() print('主') 方式一 直接导入threading模块 from threading import Thread import time class Mythead(Thread): def __init__(self,name): super().__init__() self.name = name def run(self): print('%s is running' % self.name) time.sleep(0.1) print('%s is done' % self.name) if __name__ == '__main__': t = Mythead('线程一') t.start() print('主') 方式二 继承Therad类重写run方法 (二).线程特性介绍 os模块下的getpid()线程也适用 current_thread#查看当前线程 active_count#查看线程的活跃个数(线程已结束的不是活跃状态) current_thread().name查看线程名字 略 (三).守护线程 无论是进程还是线程都遵循 某线程/进程等待 主线程/进程 运行完毕后才会被销毁。强调:运行完毕并非终止运行 #1.对主进程来说,运行完毕指的是主进程代码运行完毕。 主进程在其代码结束后就已经算运行完毕了(守护进程在此时就被回收),然后主进程会一直等非守护的子进程都运行完毕后回收子进程的资源(否则会产生僵尸进程),才会结束, #2.对主线程来说,运行完毕指的是主线程所在的进程内所有非守护线程统统运行完毕,主线程才算运行完毕。 主线程在其他非守护线程运行完毕后才算运行完毕(守护线程在此时就被回收)。因为主线程的结束意味着进程的结束,进程整体的资源都将被回收,而进程必须保证非守护线程都运行完毕后才能结束。 from threading import Thread from multiprocessing import Process import time def foo(): print(123) time.sleep(1) print("end123") def bar(): print(456) time.sleep(3) print("end456") if __name__ == '__main__': t1=Thread(target=foo) t2=Thread(target=bar) # t1=Process(target=foo) # t2=Process(target=bar) t1.daemon=True t1.start() t2.start() print("main-------") 进程与线程的区别 (四).线程的互斥锁 不加锁的情况 from threading import Thread,Lock import time mutex=Lock() n=100 def task(): global n # mutex.acquire() temp=n time.sleep(0.1) n=temp-1 # mutex.release() if __name__ == '__main__': t_l=[] for i in range(100): t=Thread(target=task) t_l.append(t) t.start() for t in t_l: t.join() print(n) View Code 结果永远为99,因为线程速度太快了,并发的时候都读到了n=100,所以需要给他加上锁 加上锁的情况 from threading import Thread,Lock import time mutex=Lock() n=100 def task(): global n mutex.acquire() temp=n time.sleep(0.1) n=temp-1 mutex.release() if __name__ == '__main__': t_l=[] for i in range(100): t=Thread(target=task) t_l.append(t) t.start() for t in t_l: t.join() print(n) View Code 焚膏油以继晷,恒兀兀以穷年。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册