首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Java编程思想学习录(连载之:内部类)

用thinkpad打字确实很爽啊! 内部类基本概念 可将一个类的定义置于另一个类定义的内部 内部类允许将逻辑相关的类组织在一起,并控制位于内部的类的可见性 甚至可将内部类定义于一个方法或者任意作用域内! 当然,内部类 ≠ 组合 内部类拥有其外围类 所有元素的 访问权 更有甚,嵌套多层的内部类能透明地访问所有它所嵌入的外围类的所有成员 一个典型的例子:利用 Java内部类 实现的 迭代器模式 // 接口 ------------------------------------------------------------- public interface Selector { boolean end(); Object current(); void next(); } // 外部类(集合类) + 内部类(迭代器类) ------------------------------------------------------------- public class Sequence { // 外部类(代表一个集合类) private Object[] items; private int next = 0; public Sequence( int size ) { items = new Object[size]; } public void add( Object x ) { if( next < items.length ) items[next++] = x; } // 迭代器类:实现了 Selector接口的 内部类 private class SequenceSelector implements Selector { private int i = 0; public boolean end() { return i == items.length; } public Object current() { return items[i]; } public void next() { if( i<items.length ) ++i; } } public Selector selector() { // 该函数也表明了:内部类也可以向上转型,这样在外部就隐藏了实现细节! return new SequenceSelector(); } public static void main( String[] args ) { Sequence sequence = new Sequence(10); for( int i=0; i<10; ++i ) { // 装填元素 sequence.add( Integer.toString(i) ); } Selector selector = sequence.selector(); // 获取iterator! while( !selector.end() ) { print( selector.current() + " " ); selector.next(); } } } // 输出 ------------------------------------------------------------- 0 1 2 3 4 5 6 7 8 9 .this 与 .new 的使用场景 .this用于在内部类中生成对其外部类对象的引用之时,举例: public class DotThis { void f() { print("DotThis.f()"); } public class Inner { // 内部类 public DotThis outer() { // 返回外部类对象的引用 return DotThis.this; // 若直接返回this,那指的便是内部类自身 } } public Inner inner() { return new Inner(); } public static void main( String[] args ) { DotThis dt = new DotThis(); DotThis.Inner dti = dt.inner(); dti.outer().f(); // 输出 DotThis.f() } } .new用于直接创建内部类的对象之时,距离: public class DotNew { public class Inner { } // 空内部类 public static void main( String[] args ) { DotNew dn = new DotNew(); DotNew.Inner dni = dn.new Inner(); //注意此处必须使用外部类的对象,而不能直接 DotNew.Inner dni = new DotNew.Inner() } } 嵌套类(static类型的内部类) 嵌套类是无需依赖其外部类的对象的。非static内部类通过一个特殊的this链接到其外围类的对象,而static类型的内部类无此this引用。 接口与内部类有着很有趣的关系:放到接口中的任何类自动都是public且static,即接口中的任何类都是嵌套类,我们甚至可以在接口的内部类中去实现其外围接口,举例: public interface ClassInInterface { void howdy(); class Test implements ClassInInterface { // 类Test默认static,所以是嵌套类 public void howdy() { print("Howdy!"); } public static void main( String[] args ) { new Test().howdy(); } } } 在 方法 和 作用域 内的内部类 可以称这类为 局部内部类! 方法中定义的内部类只能在方法内被使用,方法之外不可访问,举例: public class Parcel { // parcel是“包裹”之意 public Destination destination( String s ) { class PDestination implements Destination { // 方法中定义的内部类 private String label; private PDestination( String whereTo ) { label = whereTo; } public String readLabel() { return label; } } return new PDestination( s ); // 只有在方法中才能访问内部类PDestination } public static void main( String[] args ) { Parcel p = new Parcel(); Destination d = p.destination( "Hello" ); ... } } 更进一步,可在任意作用域内定义内部类,举例: public class Parcel { private void internalTracking( boolean b ) { if( b ) { // 局部作用域中定义了内部类,作用域之外不可访问! class TrackingSlip { private String id; TrackingSlip( String s ) { id = s; } String getSlip() { return id; } } } } public void track() { interTracking( true ); } public static void main( String[] args ) { Parcel p = new Parcel(); p.track(); } } 匿名内部类 直观上看,这种内部类没有“名字”,举例: public class Parcel { public Contents contents() { return new Contents() { // 此即匿名内部类!!! private int i = 11; public int value() { return i; } }; // !!!注意这里必须要加分号!!! } public static void main( String[] args ) { Parcel p = new Parcel(); Contents c = p.contents(); } } 若想将外部的参数传到匿名内部类中(典型的如将外部参数用于对匿名内部类中的定义字段进行初始化时)使用的话,该参数必须final,举例: public class Parcel { public Destination destination( final String s ) { // final必须! return new Destination() { private String label = s; public String readLabel() { return label; } }; // 分号必须! } public static void mian( String[] args ) { Parcel p = new Parcel(); Destination d = p.destination("Hello"); } } 匿名内部类中不可能有命名的显式构造器,此时只能使用实例初始化的方式来模仿,举例(当然下面这个例子还反映了匿名内部类如何参与继承): // 基类 --------------------------------------------- abstact class Base() { public Base( int i ) { print( "Base ctor, i = " + i ); } public abstract void f(); } //主类(其中包含了继承上面Base的派生匿名内部类!) ---------------------------------------------- public class AnonymousConstructor { public static Base getBase( int i ) { // 该处参数无需final,因为并未在下面的内部类中直接使用! return new Base(i){ // 匿名内部类 { // 实例初始化语法!!! print("Inside instance initializer"); } public void f() { print( "In anonymous f()" ); } }; // 分号必须! } public static void main( String[] args ) { Base base = getBase(47); base.f(); } } // 输出 ------------------------------------------ Base ctor, i = 47 // 先基类 Inside instance initializer // 再打印派生类 In anonymous f() 匿名内部类 + 工厂模式 = 更加简洁易懂: // Service接口 --------------------------------------------------- interface Service { void method1(); void method2(); } // ServiceFactory接口 --------------------------------------------------- interface ServiceFactory { Service getService(); } // Service接口的实现 --------------------------------------------------- class Implementation1 implements Service { private Implementation1() {} // 构造函数私有 public void method1() { print("Implementation1 method1"); } public void method2() { print("Implementation1 method2"); } public static ServiceFactory factory = new ServiceFactory() { public Service getService() { return new Implementation1(); } }; // 分号必须!!! } class Implementation2 implements Service { private Implementation2() {} public void method1() { print("Implementation2 method1"); } public void method2() { print("Implementation2 method2"); } public static ServiceFactory factory = new ServiceFactory() { public Service getService() { return new Implementation2(); } }; // 分号必须!!! } // 客户端代码 ---------------------------------------------------- public class Factories { public static void serviceConsumer( ServiceFactory fact ) { Service s = fact.getService(); s.method1(); s.method2(); } public static void main( String[] args ) { serviceComsumer( Implementation1.factory ); serviceComsumer( Implementation2.factory ); } } 总结:为什么需要内部类 内部类可以独立地继承自一个接口或者类而无需关注其外围类的实现,这使得扩展类或者接口更加灵活,控制的粒度也可以更细! 注意Java中还有一个细节:虽然Java中一个接口可以继承多个接口,但是一个类是不能继承多个类的!要想完成该特性,此时除了使用内部类来“扩充多重继承机制”,你可能别无选择,举例: class D { } // 普通类 abstract class E { } // 抽象类 class Z extend D { // 外围类显式地完成一部分继承 E makeE() { return new E() { }; // 内部类隐式地完成一部分继承 } } public class MultiImplementation { static void takesD( D d ) { } static void takesE( E e ) { } public static void main( String[] args ) { Z z = new Z(); takesD( z ); takesE( z.makeE() ); } }

优秀的个人博客,低调大师

【案例学习】最大锁具制造商怎样使用 Docker?

写在前面 亚萨合莱(ASSA ABLOY)是世界上最大的锁具制造商,在全球拥有47,000名员工,其产品组合中包括耶鲁(Yale),萨金特(Sargent)和阿萨(Assa)等知名品牌。亚萨合莱的目标是通过发展电子机械系统和数字输入解决方案来成为最具创新性的门锁解决方案供应商。随着越来越多的全球业务需要处理,亚萨合莱公司认识到这是一个利用公共云,微服务和容器技术来推动数字化转型的机会。 亚萨合莱公司的共享技术部门的云基础设施架构师 Jan Hedstrom和Docker 解决方案工程师 Patrick Van Der Bleek 在 DockerCon 欧洲大会上介绍了亚萨合莱如何利用 Docker 企业版(Docker EE)作为他们的中央安全容器管理平台来管理全球硬件和软件的工作流程。 从 Docker CE 到 Docker EE

优秀的个人博客,低调大师

docker学习笔记002-docker-engine安装过程

虚拟机内核版本: Linux SHDL009020142 2.6.32-642.el6.x86_64 #1 SMP Wed Apr 13 00:51:26 EDT 2016 x86_64 x86_64 x86_64 GNU/Linux 采用手动安装方式,安装docker-engine 直接下载文件安装 [baseuser@SHDL009020139 ~]$ wget https://yum.dockerproject.org/repo/main/centos/6/Packages/docker-engine-1.7.1-1.el6.x86_64.rpm 安装依赖 [baseuser@SHDL009020139 ~]$ sudo yum install -y libcgroup-* [baseuser@SHDL009020139 ~]$ rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY error: Failed dependencies: xz is needed by docker-engine-1.7.1-1.el6.x86_64 报错提示安装依赖XZ, [baseuser@SHDL009020139 ~]$ yum search xz Loaded plugins: product-id, search-disabled-repos, subscription-manager =========================================================== N/S Matched: xz =========================================================== xz.x86_64 : LZMA compression utilities xz-devel.i686 : Devel libraries & headers for liblzma xz-devel.x86_64 : Devel libraries & headers for liblzma xz-libs.i686 : Libraries for decoding LZMA compression xz-libs.x86_64 : Libraries for decoding LZMA compression xz-lzma-compat.x86_64 : Older LZMA format compatibility binaries Name and summary matches only, use "search all" for everything. [baseuser@SHDL009020139 ~]$ sudo yum install -y xz-* [baseuser@SHDL009020139 ~]$ rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY error: can't create transaction lock on /var/lib/rpm/.rpm.lock (Permission denied) [baseuser@SHDL009020139 ~]$ sudo rpm -ivh docker-engine-1.7.1-1.el6.x86_64.rpm warning: docker-engine-1.7.1-1.el6.x86_64.rpm: Header V4 RSA/SHA1 Signature, key ID 2c52609d: NOKEY Preparing... ########################################### [100%] 1:docker-engine ########################################### [100%] 查询已安装的docker [baseuser@SHDL009020139 ~]$ yum list installed | grep docker docker-engine.x86_64 1.7.1-1.el6 installed [baseuser@SHDL009020139 ~]$ [baseuser@SHDL009020139 ~]$ ps -ef|grep docker baseuser 4460 3491 0 11:43 pts/0 00:00:00 grep docker [baseuser@SHDL009020139 ~]$ sudo service docker start [sudo] password for baseuser: Starting cgconfig service: [ OK ] Starting docker: [ OK ] [baseuser@SHDL009020139 ~]$ ps -ef|grep docker root 4506 1 2 11:44 pts/0 00:00:00 /usr/bin/docker -d baseuser 4622 3491 0 11:44 pts/0 00:00:00 grep docker [baseuser@SHDL009020139 ~]$ sudo docker run hello-world Hello from Docker! This message shows that your installation appears to be working correctly. To generate this message, Docker took the following steps: 1. The Docker client contacted the Docker daemon. 2. The Docker daemon pulled the "hello-world" image from the Docker Hub. 3. The Docker daemon created a new container from that image which runs the executable that produces the output you are currently reading. 4. The Docker daemon streamed that output to the Docker client, which sent it to your terminal. To try something more ambitious, you can run an Ubuntu container with: $ docker run -it ubuntu bash Share images, automate workflows, and more with a free Docker ID: https://cloud.docker.com/ For more examples and ideas, visit: https://docs.docker.com/engine/userguide/ [baseuser@SHDL009020139 ~]$ sudo docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES e5f07cbd2647 hello-world "/hello" 33 seconds ago Exited (0) 32 seconds ago grave_turing [baseuser@SHDL009020139 ~]$ docker version Client version: 1.7.1 Client API version: 1.19 Go version (client): go1.4.2 Git commit (client): 786b29d OS/Arch (client): linux/amd64 Server version: 1.7.1 Server API version: 1.19 Go version (server): go1.4.2 Git commit (server): 786b29d OS/Arch (server): linux/amd64 [baseuser@SHDL009020139 ~]$ 卸载 [baseuser@SHDL009020139 ~]$ yum list installed | grep docker docker-engine.x86_64 1.7.1-1.el6 installed 删除安装包 [baseuser@SHDL009020139 ~]$ sudo yum -y remove docker-engine.x86_64 [baseuser@SHDL009020139 ~]$ yum list installed | grep docker [baseuser@SHDL009020139 ~]$ 以上安装过程。

优秀的个人博客,低调大师

Storm概念学习系列之Blot消息处理者

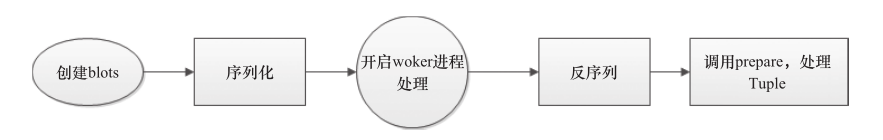
Bolt消息处理者 认识了消息源Spout和消息的数据存储元组Tuple,接下来了解消息的处理者Bolt。Bolt是接收Spout发出元组Tuple后处理数据的组件,所有的消息处理逻辑被封装在Bolt中,Bolt负责处理输入的数据流并产生输出的新数据流。 1. Bolt介绍 消息处理者Bolt在Storm中是一个被动的角色。Bolt把元组作为输入,然后产生新的元组作为输出。 1.1 Bolt的功能Bolt可以执行过滤、函数操作、合并、写数据库等操作。Bolt还可以简单地传递消息流,复杂的消息流处理往往需要很多步骤,因此也就需要很多Bolt来处理。 Bolt可以发出超过一个的流。为此,使用OutputFieldsDeclarer类的declareStream()方法声明多个流,并使用OutputCollector类的emit()方法指定发射的流。 1.2 Bolt的生命周期 首先,客户端机器创建Bolt,然后将其序列化为拓扑,并提交给集群中的主机。之后集群启动Worker进程,反序列化Bolt,调用prepare方法开始处理元组。 接下来,Bolt处理Tuple,Bolt处理一个输入Tuple,发射0个或者多个Tuple。 然后,调用ack通知Storm自己已经处理过这个Tuple了。Storm提供了一个IBasicBolt自动调用ack。 Bolt类接收由Spout或者其他上游Bolt类发来的Tuple,对其进行处理。Bolt的生命周期如图1所示。 图1 Bolt的生命周期 在创建Bolt对象时,通过构造方法初始化成员变量,当Bolt被提交到集群时,这些成员变量也会被序列化,所以通过反序列化,可以获取到这些成员变量。 1.3 Bolt的组件 IComponent顾名思义,是所有组件的接口:IBasicBolt、IRichBolt、IBatchBolt都继承自IComponent; IBolt接口是IRichBolt要继承的接口; 还有一些以Base开头的Bolt类,如BaseBasicBolt、BaseBatchBolt、BaseRichBolt、BaseTransactionalBolt等,在这些类中需要注意的是所实现的方法都为空,或者返回值为null,其中,还有一个接口BaseComponent,是Storm提供的一个比较方便的抽象类,这个抽象类及其子类都或多或少实现了其接口定义的部分方法。从图1中,可以从整体上看到这些类的关系图,从而理清这些类之间的关系及结构。 图2 Bolt相关组件的继承关系图 1.4 Bolt常用类 Bolt比较常用的类是BaseRichBolt、BaseBasicBolt等。这两个类继承的父类如图3和图4所示,它们的共同之处是父类中都有BaseComponent和ICompont。不同之处是BaseRichBolt的父接口中有IBolt和IRichBolt,而BaseBasicBolt只有IBasicBolt。 图3 BaseRichBolt类图 图4 BaseBasicBolt类图 比较完了父类,还没有真正从使用的本质上区别这两者。下面就比较这两个类的方法。图5为IBolt接口的方法,这是BaseRichBolt继承的父接口或者类之一,IBolt具备的方法与IBasicBolt的方法结构类似,但是有本质区别,那就是方法的作用不同。IBasicBolt接口的方法如图6所示。 图5 IBolt接口的主要方法 图6 IBasicBolt接口的主要方法 IBolt继承了java.io.Serializable,在Nimbus上提交Topology以后,创建出来的Bolt在序列化后被发送到具体执行的Worker上,Worker在执行该Bolt时,先调用prepare方法传入当前执行的上下文,然后调用execute方法,对Tuple进行处理,并用prepare方法传入的OutputCollector的ack方法(表示成功)或fail方法(表示失败)来反馈处理结果。而IBasicBolt接口在执行execute方法时,自动调用ack方法,其目的就是实现该接口的Bolt时,不用在代码中提供反馈结果,Storm内部会自动反馈成功。 Bolt实例 下面的ClassifyBolt实现了BaseRichBolt接口,该类需要实现的主要方法如图7所示。 图7 ClassifyBolt的主要方法 1、prepare方法 prepare方法和Spout中的open方法类似,为Bolt提供了OutputCollector,用来从Bolt中发送Tuple。在Bolt中载入新的线程进行异步处理。OutputCollector是线程安全的,并且随时都可以调用它。 在Bolt中,Tuple的发送可以在prepare、execute、cleanup等方法中进行,但一般都是在execute中进行。 示例代码如下: public void prepare(Map conf, TopologyContext context, OutputCollector collector) { _collector = collector; } 2、declareOutputFields方法 用于声明当前Bolt发送的Tuple中包含的字段,和Spout中的类似。当前Bolt类发送的Tuple包含了两个字段:gt和lt。 示例代码如下: public void declareOutputFields(OutputFieldsDeclarer declarer) { // 在geThan流中声明为gt declarer.declareStream("geThan", new Fields("gt")); // 在lessThan流中声明为lt declarer.declareStream("lessThan", new Fields("lt")); } Bolt可以发射多条消息流,使用OutputFieldsDeclarer.declareStream方法来定义流,之后使用OutputCollector.emit来选择要发射的流。 3、getComponentConf?iguration方法 和Spout类一样,在Bolt中也可以有getComponentConf?iguration方法。示例代码如下: public Map<String, Object> getComponentConf?iguration() { Map<String, Object> conf = new HashMap<String, Object>(); conf.put(Conf?ig.TOPOLOGY_TICK_TUPLE_FREQ_SECS, emitFrequencyInSeconds); return conf; } 此例定义了从系统组件“_system”的“_tick”流中发送Tuple到当前Bolt的频率,当系统需要每隔一段时间执行特定的处理时,就可以利用该系统组件的特性来完成。 4、execute方法 Bolt的主要方法是execute,它以一个Tuple作为输入,Bolt使用OutputCollector来发射Tuple,Bolt必须为它处理的每一个Tuple调用OutputCollector的ack方法,以通知Storm该Tuple被处理完成了,从而通知该Tuple的发射者Spout。 public void execute(Tuple input) { int randomInt = input.getIntegerByField("randomInt"); // 大于等于50的放在一起 if(randomInt >= CLASSIFY_FLAG){ collector.emit("geThan", new Values(randomInt)); }else{ // 小于50的放在一起 collector.emit("lessThan",new Values(randomInt)); } collector.ack(input); } execute是Bolt中最关键的一个方法,对Tuple的处理都可以放到此方法中进行。具体的发送也是通过emit方法来完成的。此时,emit方法有两种情况,一种是方法中只有一个参数,另一种是方法中有两个参数。 1)emit有一个参数:该参数是发送到下游Bolt的Tuple,此时,由上游发来的旧的Tuple在此隔断,新的Tuple和旧的Tuple不再属于同一棵Tuple树。新的Tuple另起一棵新的Tuple树。 2)emit有两个参数:第一个参数是旧的Tuple的输入流,第二个参数是发往下游Bolt的新的Tuple流。此时,新的Tuple和旧的Tuple仍然属于同一棵Tuple树,即如果下游的Bolt处理Tuple失败,则向上传递到当前Bolt,当前Bolt根据旧的Tuple继续往上游传递,申请重发失败的Tuple,保证Tuple处理的可靠性。 这两种情况都要根据用户的场景来确定。示例代码如下: public void execute(Tuple tuple) { _collector.emit(tuple, new Values(tuple.getString(0) + "!!!")); _collector.ack(tuple); } public void execute(Tuple tuple) { _collector.emit(new Values(tuple.getString(0) + "!!!")); } 此外还有ack、fail、cleanup等方法,其中cleanup方法和Spout中的close方法类似,都是在当前组件关闭时调用,但是针对实时计算来说,除非一些特殊的场景要求以外,这两个方法一般都很少用到。 如下面, 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5989707.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Storm概念学习系列之Spout数据源

Spout 数据源 消息源Spout是Storm的Topology中的消息生产者(即Tuple的创造者)。 Spout 介绍 1. Spout 的结构 Spout 是 Storm 的核心组件之一,最源头的接口是 IComponent,如图 1所示,几个Spout接口都继承自IComponent。 图 1 Spout 类图 2.Spout 发出的消息 Spout从外部获取数据后,向Topology中发出的Tuple可以是可靠的,也可以是不可靠的。 注意:一个可靠的消息源可以重新发射一个Tuple(如果该 Tuple 没有被 Storm 成功处理),但是一个不可靠的消息源Spout 一旦发出,一个Tuple 就把它彻底“遗忘”,也就不可能再发了。 3.Spout 发射的流 Spout 可以发射多个流。要达到这样的效果,使用 OutputFieldsDeclarer.declareStream 来定义多个流(即定义多个 Stream),然后使用 SpoutOutputCollector 的emit来发射指定的流。 4.Spout 的重要方法 Spout 的重要方法是nextTuple()。 nextTuple 方法发射一个新的元组到 Topology,如果没有新元组发射,则直接返回。注意任务 Spout 的 nextTuple 方法都不要实现成阻塞的,因为Storm 是在相同的线程中调用 Spout 的方法。 Spout 的另外两个重要方法是ack ()和 fail() 方法。当 Spout 发射的元组被拓扑成功处理时,调用 ack 方法;当处理失败时,调用 fail 方法。 ack和 fail 方法仅被可靠的 Spout 调用。 5.Spout 的组件 Spout的最顶层抽象是ISpout接口。在通常情况下(Shell和事务型的除外),实现一个Spout,可以直接实现接口IRichSpout,如果不想写多余的代码,可以直接继承BaseRichSpout。 Spout 实例 下面通过创建一个实例RandomSpout来介绍Spout, 图1为RandomSpout继承自BasicRichSpout及其实现的原理图。 图2 列出了实例 RandomSpout 继承自 BaseRichSpout 中的几个重要方法。 下面对图2 中的方法进行详细介绍。 (1) open 方法 当一个 Task 被初始化时会调用此 open 方法。一般都会在此方法中初始化发送 Tuple 的对象 SpoutOutputCollector 和配置对象 TopologyContext。 代码示例如下: public void open(Map conf, TopologyContext context, SpoutOutputCollector collector) { this.collector = collector; random = new Random(); } 图2 RandomSpout 类图 图 3-4 RandomSpout 类的主要方法 (2) declareOutputFields 方法 此方法用于声明当前 Spout 的 Tuple 发送流。流的定义是通过 OutputFieldsDeclare.declareStream方法完成的,其中的参数包括了发送的域 Fields。 示例代码如下: public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("randomInt")); } (3) nextTuple 方法 这是 Spout 类中最重要的一个方法。发射一个 Tuple 到 Topology 都是通过该方法来实现的。 示例代码如下: public void nextTuple() { while(true){ Values val = new Values(random.nextInt(100)); collector.emit(val); try { Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } } } 以上代码从 100 以内的整数中随机生成一个数作为 Tuple 的值,然后通过_collector 发送到 Topology。 另外,除了上述几个方法之外,还有 getComponentConf iguration、ack、fail 和 close 方法等。 getComponentConfiguration 方法用于配置当前组件的参数, Storm 监测到一个 Tuple 被成功处理时调用 ack 方法,处理失败时调用 fail 方法,这两个方法在 BaseRichSpout 类中已经被隐式实现了。 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5989285.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

【IBM Tivoli Identity Manager 学习文档】3 系统部署

ITIM 5.0 单服务器配置和部署。 部署ITIM之前要对其组件进行部署: IBM DB2 Enterprise 9.1 with FP2 IBM WebSphere Application Server 6.1 with FP9 IBM Tivoli Directory Server 6.2 IBM Tivoli Directory Integrator 6.1 我们安装系统的软硬件环境是: 地点:某公司 G3/G4机房。两台IBM的台式PC。 1.IP:9.123.108.101 Red Hat Enterprise Linux AS release 4 (Nahant Update 7) MemTotal: 513732 kB SwapTotal: 1048568 kB processor : 1 vendor_id : GenuineIntel model name : Intel(R) Pentium(R) 4 CPU 3.20GHz cpu MHz : 3201.973 cache size : 1024 KB 这台安装 IBM DB2 Enterprise 9.1 with FP2 IBM Tivoli Directory Server 6.2 2.IP:9.123.108.19 Red Hat Enterprise Linux AS release 4 (Nahant Update 4) MemTotal: 2063944 kB SwapTotal: 2031608 kB processor : 1 vendor_id : GenuineIntel model name : Intel(R) Pentium(R) D CPU 2.80GHz cpu MHz : 2793.843 cache size : 1024 KB 这台我们安装 IBM WebSphere Application Server 6.1 with FP9 ITIM 5.0 Fix Pack 3 首先进行DB2的安装配置: 1.运行安装程序: 选择Install a Product,然后按Install New。 在接受完协议后,选择典型安装,随后选择第一个选项,如下图: 进一步,选择安装路径,我们使用默认的路径/opt/ibm/db2/V9.1 然后我们新建一个对DB2 Adminstrator Server进行管理的用户,设定其密码: 选择创建一个DB2实例,并且使用单分区实例,并且设置DB2实例拥有者的信息: 设置保护用户的信息 第11步使用默认的,第十二步不安装DB2提醒。然后点击Finished。 然后就开始安装了: 安装完毕后在Terminal下验证安装是否成功: $su - db2inst1 $db2level 显示如下信息就是正确的了: DB21085I Instance "db2inst1" uses "32" bits and DB2 code release "SQL09010" with level identifier "02010107". Informational tokens are "DB2 v9.1.0.0", "s060629", "LINUXIA32", and Fix Pack "0". Product is installed at "/opt/ibm/db2/V9.1". 2.安装IBM DB2 Enterprise 9.1 Fixpack 2 首先关闭DB2实例和服务器: $su - db2inst1 $. /home/db2inst1/sqllib/db2profile $db2 terminate $db2stop 停止DAS的活动: $su - dasusr1 $. /home/dasusr1/das/dasprofile $db2admin stop 停止保护用户的活动: $su $. /home/db2inst1/sqllib/db2profile $cd /opt/ibm/db2/V9.1/bin $db2fmcu -d $db2fm -d 用grep查看关于db2的进程,没有一个就是对了。 看到所有停止的命令都是successfully就可以安装Fix Pack2了。 安装完毕后查看db2,发现Fix Pack2已经安装上了: 然后安装Tivoli Directory Server 6.2 1.运行安装脚本: 选择安装语言为English. 接受协议后选择自定义安装(Custom)。去掉TDI,稍后我们会另外安装。指定WAS目录时,选择稍后指定。 2.关闭配置工具 在安装完毕后可能会出现配置工具,我们在初次部署时暂时不用,请关闭。 接着部署WAS6.1 1.设置root的umask为0022: 用命令umask查看当前umask的值。 2.确保以下四个包的安装: compat-libstdc++-33-3.2.3-47.3 compat-db-4.1.25-9 xorg-x11-deprecated-libs-6.8.1 or xorg-x11-deprecated-libs-6.8.2 rpm-build-4.3.3-18.nonptl 用命令rpm -pa|grep XXXX检查 3.下载安装包: 在IBM内网中下载以下安装包: WebSphere Application Server V6.1 for Linux on x86Series, 32-bit Support German English International Spanish French Italian Japanese Korean Portuguese Brazilian Chinese Simplified Chinese Traditional (C87QXML) 4.开始安装: 运行launchpad.sh,然后选择“Launch the installation wizard for WebSphere Application Server” 进行安装。一直next就可以了(注意在选择安装类型时选择Application Server)。 然后在以下选项中选择第一个 5.安装IBM HTTP Server 我们暂时不配置Administration Server及其Authentication,在Plug-in里面进行如下配置: 6.安装IBM WebSphere Application Server 6.1 Update Installer 7.安装IBM WebSphere Application Server 6.1 Fixpack 9 和13 注意:在安装WAS 6.1FP9前,必须停掉IBM WebSphere Application Server, IBM HTTP Server, IBM HTTP Administration Server。 停掉服务:/opt/IBM/WebSphere/AppServer/bin/stopServer.sh server1 -username server1 -password XXXXXXX 运行:/opt/IBM/WebSphere/UpdateInstaller/update.sh 在这个地方指定升级的产品: 在这个步骤中指定升级包路径: 若出现CWUPI0026E错误,则说明你的UpdateInstaller版本太久,先删除UpdateInstaller的整个目录,然后再安装新的版本,我装的是7.0 8.启动Server /opt/IBM/WebSphere/AppServer/bin/startServer.sh server1 打开浏览器验证一下: http://localhost:9080/snoop http://localhost:9060/ibm/console 安装IBM Tivoli Directory Integrator 6.1.1 1.运行安装程序 最后我们部署TIM: 1.配置DB2 和 ITDS 6.1的中间件 解压配置中间件的应用程序,运行cfg_itim_mw_xLinux,选择英语 然后选择配置DB2和ITDS的中间件: 它会在DB2和ITDS中创建实例,一般设定密码就好了。 注意在我配置中发觉总是在创建TDS实例的时候失败,后来看了日志发现是默认的程序调用的竟然是V6.0目录中的TDS配置程序,而我安装的TDS是6.2.。。。太不智能了。。。解决方法就是ln -sf V6.2 V6.0就可以了,纯属蒙一下计算机,谁让他耍我。。。 2.安装ITIM 指定WAS,然后一路NEXT后INSTALL。 3.连接数据库 在以上这些需要填写的地方输入你配置中间件的一些信息。 若信息无错,则出现连接正确的提示 随后的配置如下: 大功告成! 4.测试安装结果 http://9.123.101.19:9080/itim/console/main 修改密码即可。 至此ITIM完全部署完毕 然后一步步进行就好了~ 本文转自gnuhpc博客园博客,原文链接:http://www.cnblogs.com/gnuhpc/archive/2012/01/16/2324006.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Webwork 学习之路【01】Webwork与 Struct 的前世今生

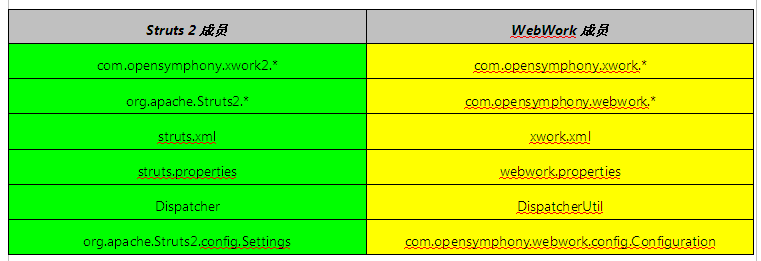
Struts 1是全世界第一个发布的MVC框架,它由Craig McClanahan在2001年发布,该框架一经推出,就得到了世界上Java Web开发者的拥护,经过长达6年时间的锤炼,Struts 1框架更加成熟、稳定,性能也有了很好的保证。 到目前为止,Struts 1依然是世界上使用最广泛的MVC框架。目前,基于Web的MVC框架非常多,发展也很快,每隔一段时间就有一个新的MVC框架发布。 虽然Struts 2号称是一个全新的框架,但这仅仅是相对Struts 1而言。Struts 2与 Struts 1相比,确实有很多革命性的改进,但它并不是新发布的新框架,而是在另一个赫赫有名的框架:WebWork基础上发展起来的。从某种程度上来讲,Strut2没有继承Struts 1的血统,而是继承了WebWork的血统。或者说,WebWork衍生出了Struts 2,而不是Struts 1衍生了Struts 2。因为Struts 2是WebWork的升级,而不是一个全新的框架,因此稳定性、性能等各方面都有很好的保证;而且吸收了Struts 1和WebWork两者的优势。 Struts 2以WebWork为核心,采用拦截器的机制来处理用户的请求,这样的设计也使得业务逻辑控制器能够与Servlet API完全脱离开。在很多方面Struts仅仅是改变了WebWork下的名称。Struts2对应的有自己的标签,并且功能强大。Webwork也有自己的标签。Struts 2和WebWork成员名称(命名上存在的改变)的对应表: 除此之外,Struts 2也删除了WebWork中少量特性: AroundInterceptor:Struts 2不再支持WebWork中的AroundInterceptor。如果应用程序中需要使用AroundInterceptor,则应该自己手动导入WebWork中的AroundInterceptor类。 富文本编辑器标签:Struts 2不再支持WebWork的富文本编辑器,如果应用中需要使用富文本编辑器,则应该使用Dojo的富文本编辑器。 IoC容器支持:Struts 2不再支持内建的IoC容器,而改为全面支持Spring的IoC容器,以Spring的IoC容器作为默认的Object工厂。 WebWork 框架流转图: WebWork的网站上提供了一个完整的WebWork架构图。它描述了从客户端的一次请求到最后服务器端响应的的整个执行过程。架构图如下: 此架构图一个分为五个部分,其中五个部分分别有五中不同颜色表示。 1、浅灰色方框。分别代表了客户端的一次Http请求,和服务器端运算结束之后的一次响应。 2、浅红色方框。表示一次Action请求所要经过的Servlet filters(Servlet过滤器)。我们可以看到最后一个filter就是我们前面介绍的WebWork的前端控制器。 3、蓝色方框。这是WebWork框架的核心部分。 1)一次请求到了WebWork的前端控制器,它首先会根据请求的URL解析出对应的action名称,然后去咨询ActionMapper这个action是否需要被执行。 2)如果ActionMapper决定这个action需要被执行,前端控制器就把工作委派给ActionProxy。接着她们会咨询WebWork的配置管理器,并读取在web.xml文件中定义的配置信息。接下来ActionProxy会创建ActionInvocation对象。 3)ActionInvocation是Xwork原理的(Command模式)实现部分。它会调用这个Action已定义的拦截器(before方法),Action方法,Result方法。 4)最后,看上面流程的图的方向,它会再执行拦截器(after方法),再回到Servlet Filter部分,最后结束并传给用户一个结果响应。 4、靛色方框。这是拦截器部分,在上面的拦截器章节我们已经有了详细的介绍。 5、黄色方框。这是我们在开发Web应用时,需要自己开发的程序。其中包括:Action类,页面模板,配置文件xwork.xml。 本文转自Orson博客园博客,原文链接:http://www.cnblogs.com/java-class/p/5016415.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册