首页 文章 精选 留言 我的

精选列表

搜索[springcloud],共1351篇文章
优秀的个人博客,低调大师

开发SpringCloud微服务三年,我才知道@EnableEurekaServer注解到底做了什么

全是干货的 Java 技术仓库: https://github.com/Wasabi1234/Java-Interview-Tutorial 当你在启动类上添加了启动 Eureka 服务注册中心注解时,到底发生了什么呢? 激活eureka服务器相关配置EurekaServerAutoConfiguration的注解 EurekaServerMarkerConfiguration点击到这里,我们发现 spring.factories文件 注意到如下注解 @ConditionalOnBean - 条件注入 也就是当有EurekaServerMarkerConfiguration.Marker.class时,才会注入 所以@EnableEurekaServer就是个开关,只要写了该注解,spring 就会帮你把EurekaServerAutoConfiguration类注入进来。 那么为什么注入他就行了? EurekaServerAutoConfiguration#jerseyFilterRegistration 注意如下类: ApplicationResource#addInstance 相当于 MVC 中的 controller /** * Registers information about a particular instance for an * {@link com.netflix.discovery.shared.Application}. * * @param info * {@link InstanceInfo} information of the instance. * @param isReplication * a header parameter containing information whether this is * replicated from other nodes. */ @POST @Consumes({"application/json", "application/xml"}) public Response addInstance(InstanceInfo info, @HeaderParam(PeerEurekaNode.HEADER_REPLICATION) String isReplication) { logger.debug("Registering instance {} (replication={})", info.getId(), isReplication); // validate that the instanceinfo contains all the necessary required fields if (isBlank(info.getId())) { return Response.status(400).entity("Missing instanceId").build(); } else if (isBlank(info.getHostName())) { return Response.status(400).entity("Missing hostname").build(); } else if (isBlank(info.getIPAddr())) { return Response.status(400).entity("Missing ip address").build(); } else if (isBlank(info.getAppName())) { return Response.status(400).entity("Missing appName").build(); } else if (!appName.equals(info.getAppName())) { return Response.status(400).entity("Mismatched appName, expecting " + appName + " but was " + info.getAppName()).build(); } else if (info.getDataCenterInfo() == null) { return Response.status(400).entity("Missing dataCenterInfo").build(); } else if (info.getDataCenterInfo().getName() == null) { return Response.status(400).entity("Missing dataCenterInfo Name").build(); } // handle cases where clients may be registering with bad DataCenterInfo with missing data DataCenterInfo dataCenterInfo = info.getDataCenterInfo(); if (dataCenterInfo instanceof UniqueIdentifier) { String dataCenterInfoId = ((UniqueIdentifier) dataCenterInfo).getId(); if (isBlank(dataCenterInfoId)) { boolean experimental = "true".equalsIgnoreCase(serverConfig.getExperimental("registration.validation.dataCenterInfoId")); if (experimental) { String entity = "DataCenterInfo of type " + dataCenterInfo.getClass() + " must contain a valid id"; return Response.status(400).entity(entity).build(); } else if (dataCenterInfo instanceof AmazonInfo) { AmazonInfo amazonInfo = (AmazonInfo) dataCenterInfo; String effectiveId = amazonInfo.get(AmazonInfo.MetaDataKey.instanceId); if (effectiveId == null) { amazonInfo.getMetadata().put(AmazonInfo.MetaDataKey.instanceId.getName(), info.getId()); } } else { logger.warn("Registering DataCenterInfo of type {} without an appropriate id", dataCenterInfo.getClass()); } } } registry.register(info, "true".equals(isReplication)); return Response.status(204).build(); // 204 to be backwards compatible } 注意如下继承体系图 InstanceRegistry#register PeerAwareInstanceRegistryImpl#register 这里取得微服务过期时间 90s,服务之间心跳请求 30s 一次,如果 90s 还没发生,就说明挂了 这就是责任链模式!!! AbstractInstanceRegistry#register 真正的注册 注册表K:微服务集群 V:微服务集群内的各个节点 当发生注册信息冲突时,咋办? 根据最后活跃时间,确定覆盖哪个 public void register(InstanceInfo registrant, int leaseDuration, boolean isReplication) { try { // 并发读锁 read.lock(); // 先获得微服务名,然后获得实例 Map<String, Lease<InstanceInfo>> gMap = registry.get(registrant.getAppName()); REGISTER.increment(isReplication); // 第一次注册时还不存在,所以 new 一个 if (gMap == null) { final ConcurrentHashMap<String, Lease<InstanceInfo>> gNewMap = new ConcurrentHashMap<String, Lease<InstanceInfo>>(); // 没有时才 put,有就不更新! 因为registry还是可能被写的!毕竟他不在读锁范围内! gMap = registry.putIfAbsent(registrant.getAppName(), gNewMap); if (gMap == null) { gMap = gNewMap; } } // 已存在的注册节点 Lease<InstanceInfo> existingLease = gMap.get(registrant.getId()); // Retain the last dirty timestamp without overwriting it, if there is already a lease if (existingLease != null && (existingLease.getHolder() != null)) { // 拿到已存在节点的注册时间 Long existingLastDirtyTimestamp = existingLease.getHolder().getLastDirtyTimestamp(); // 当前正在注册的节点的注册时间 Long registrationLastDirtyTimestamp = registrant.getLastDirtyTimestamp(); logger.debug("Existing lease found (existing={}, provided={}", existingLastDirtyTimestamp, registrationLastDirtyTimestamp); // this is a > instead of a >= because if the timestamps are equal, we still take the remote transmitted // InstanceInfo instead of the server local copy. // 注册ing 时,有更加新的节点注册了! if (existingLastDirtyTimestamp > registrationLastDirtyTimestamp) { logger.warn("There is an existing lease and the existing lease's dirty timestamp {} is greater" + " than the one that is being registered {}", existingLastDirtyTimestamp, registrationLastDirtyTimestamp); logger.warn("Using the existing instanceInfo instead of the new instanceInfo as the registrant"); // 那么就用已存在的替换当前注册节点,因为考虑到尽量保证可用性,因为既然还在活跃说明老的还能用 registrant = existingLease.getHolder(); } } else { // The lease does not exist and hence it is a new registration synchronized (lock) { if (this.expectedNumberOfRenewsPerMin > 0) { // Since the client wants to cancel it, reduce the threshold // (1 // for 30 seconds, 2 for a minute) this.expectedNumberOfRenewsPerMin = this.expectedNumberOfRenewsPerMin + 2; this.numberOfRenewsPerMinThreshold = (int) (this.expectedNumberOfRenewsPerMin * serverConfig.getRenewalPercentThreshold()); } } logger.debug("No previous lease information found; it is new registration"); } // 新的心跳续约对象,包括注册信息,最后操作时间,注册事件,过期时间,剔除时间 Lease<InstanceInfo> lease = new Lease<InstanceInfo>(registrant, leaseDuration); if (existingLease != null) { lease.setServiceUpTimestamp(existingLease.getServiceUpTimestamp()); } // 将新对象放入注册表 gMap.put(registrant.getId(), lease); synchronized (recentRegisteredQueue) { // 加入注册队列 recentRegisteredQueue.add(new Pair<Long, String>( System.currentTimeMillis(), registrant.getAppName() + "(" + registrant.getId() + ")")); } // This is where the initial state transfer of overridden status happens if (!InstanceStatus.UNKNOWN.equals(registrant.getOverriddenStatus())) { logger.debug("Found overridden status {} for instance {}. Checking to see if needs to be add to the " + "overrides", registrant.getOverriddenStatus(), registrant.getId()); if (!overriddenInstanceStatusMap.containsKey(registrant.getId())) { logger.info("Not found overridden id {} and hence adding it", registrant.getId()); overriddenInstanceStatusMap.put(registrant.getId(), registrant.getOverriddenStatus()); } } InstanceStatus overriddenStatusFromMap = overriddenInstanceStatusMap.get(registrant.getId()); if (overriddenStatusFromMap != null) { logger.info("Storing overridden status {} from map", overriddenStatusFromMap); registrant.setOverriddenStatus(overriddenStatusFromMap); } // Set the status based on the overridden status rules InstanceStatus overriddenInstanceStatus = getOverriddenInstanceStatus(registrant, existingLease, isReplication); registrant.setStatusWithoutDirty(overriddenInstanceStatus); // If the lease is registered with UP status, set lease service up timestamp if (InstanceStatus.UP.equals(registrant.getStatus())) { lease.serviceUp(); } registrant.setActionType(ActionType.ADDED); recentlyChangedQueue.add(new RecentlyChangedItem(lease)); registrant.setLastUpdatedTimestamp(); invalidateCache(registrant.getAppName(), registrant.getVIPAddress(), registrant.getSecureVipAddress()); logger.info("Registered instance {}/{} with status {} (replication={})", registrant.getAppName(), registrant.getId(), registrant.getStatus(), isReplication); } finally { read.unlock(); } } 服务续约 通知Eureka Server Service Provider还活着,避免服务被剔除。 和register实现思路基本一致 更新自身状态 再同步到其它Peer public boolean renew(String appName, String id, boolean isReplication) { RENEW.increment(isReplication); Map<String, Lease<InstanceInfo>> gMap = registry.get(appName); Lease<InstanceInfo> leaseToRenew = null; if (gMap != null) { // 拿到具体的注册节点 leaseToRenew = gMap.get(id); } if (leaseToRenew == null) { // 不存在,则重新注册续约 RENEW_NOT_FOUND.increment(isReplication); logger.warn("DS: Registry: lease doesn't exist, registering resource: {} - {}", appName, id); return false; } else { //存在 // 先得到节点信息 InstanceInfo instanceInfo = leaseToRenew.getHolder(); if (instanceInfo != null) { // touchASGCache(instanceInfo.getASGName()); InstanceStatus overriddenInstanceStatus = this.getOverriddenInstanceStatus( instanceInfo, leaseToRenew, isReplication); // 看是否处于宕机状态 if (overriddenInstanceStatus == InstanceStatus.UNKNOWN) { logger.info("Instance status UNKNOWN possibly due to deleted override for instance {}" + "; re-register required", instanceInfo.getId()); RENEW_NOT_FOUND.increment(isReplication); return false; } if (!instanceInfo.getStatus().equals(overriddenInstanceStatus)) { logger.info( "The instance status {} is different from overridden instance status {} for instance {}. " + "Hence setting the status to overridden status", instanceInfo.getStatus().name(), instanceInfo.getOverriddenStatus().name(), instanceInfo.getId()); instanceInfo.setStatusWithoutDirty(overriddenInstanceStatus); } } renewsLastMin.increment(); // 正常则续约 leaseToRenew.renew(); return true; } } public enum InstanceStatus { UP, // Ready to receive traffic DOWN, // Do not send traffic- healthcheck callback failed STARTING, // Just about starting- initializations to be done - do not // send traffic OUT_OF_SERVICE, // Intentionally shutdown for traffic UNKNOWN; public static InstanceStatus toEnum(String s) { if (s != null) { try { return InstanceStatus.valueOf(s.toUpperCase()); } catch (IllegalArgumentException e) { // ignore and fall through to unknown logger.debug("illegal argument supplied to InstanceStatus.valueOf: {}, defaulting to {}", s, UNKNOWN); } } return UNKNOWN; } } 续约,利用更新的持续时间,如果它是由相关联的指定T注册期间,否则默认持续时间是DEFAULT_DURATION_IN_SECS,即 90s 服务失效剔除 AbstractInstanceRegistry#postInit 剔除定时任务 public void evict(long additionalLeaseMs) { logger.debug("Running the evict task"); // 判断是否打开自我保护机制 if (!isLeaseExpirationEnabled()) { logger.debug("DS: lease expiration is currently disabled."); return; } // We collect first all expired items, to evict them in random order. For large eviction sets, // if we do not that, we might wipe out whole apps before self preservation kicks in. By randomizing it, // the impact should be evenly distributed across all applications. List<Lease<InstanceInfo>> expiredLeases = new ArrayList<>(); for (Entry<String, Map<String, Lease<InstanceInfo>>> groupEntry : registry.entrySet()) { Map<String, Lease<InstanceInfo>> leaseMap = groupEntry.getValue(); if (leaseMap != null) { for (Entry<String, Lease<InstanceInfo>> leaseEntry : leaseMap.entrySet()) { Lease<InstanceInfo> lease = leaseEntry.getValue(); if (lease.isExpired(additionalLeaseMs) && lease.getHolder() != null) { // 集合保存所有剔除节点 expiredLeases.add(lease); } } } } // To compensate for GC pauses or drifting local time, we need to use current registry size as a base for // triggering self-preservation. Without that we would wipe out full registry. // 注册表大小,即所有注册节点个数 int registrySize = (int) getLocalRegistrySize(); // 阈值,0.85 int registrySizeThreshold = (int) (registrySize * serverConfig.getRenewalPercentThreshold()); // 直接相减,得到剔除阈值 int evictionLimit = registrySize - registrySizeThreshold; // 将需要剔除节点个数 和 剔除阈值取最小值,作为自我保护机制下要剔除的节点个数。删多了还是 85 个开启,少了就降低点,这很合理! int toEvict = Math.min(expiredLeases.size(), evictionLimit); if (toEvict > 0) { logger.info("Evicting {} items (expired={}, evictionLimit={})", toEvict, expiredLeases.size(), evictionLimit); // 随机剔除这么多个 Random random = new Random(System.currentTimeMillis()); for (int i = 0; i < toEvict; i++) { // Pick a random item (Knuth shuffle algorithm) int next = i + random.nextInt(expiredLeases.size() - i); Collections.swap(expiredLeases, i, next); Lease<InstanceInfo> lease = expiredLeases.get(i); String appName = lease.getHolder().getAppName(); String id = lease.getHolder().getId(); EXPIRED.increment(); logger.warn("DS: Registry: expired lease for {}/{}", appName, id); internalCancel(appName, id, false); } } } 是否过期,该被剔除当前时间是否大于 最后操作时间+持续时间+服务集群之间同步的预留时间 自我保护机制 eureka 短时间内大量微服务被删除,会打开自我保护机制,避免自己宕机时疯狂删除 检查是否尤里卡服务器的自我保护功能。当启用时,服务器跟踪它应该从服务器接收更新的数量。 任何时候,续期次数低于按规定的阈值百分比getRenewalPercentThreshold() ,服务器关闭到期,以避免身处险境将有助于服务器维护的客户端和服务器之间的网络出现问题时注册表的信息。这些变化是在运行时有效15min 85%宕机则打开该机制 同步给其他peer 传入各种动作 InstanceInfo的状态有以下几种com.netflix.eureka.registry.PeerAwareInstanceRegistryImpl PeerAwareInstanceRegistryImpl#register InstanceInfo写入到本地registry之后,然后同步给其他peer节点 private void replicateToPeers(Action action, String appName, String id, InstanceInfo info /* 可选 */, InstanceStatus newStatus /* 可选 */, boolean isReplication) { Stopwatch tracer = action.getTimer().start(); try { if (isReplication) { numberOfReplicationsLastMin.increment(); } // 如果已经是副本,则不要再复制,因为这将创建有毒的复制! // 如果当前节点接收到的实例信息本就是另一个节点同步来的,则不会继续同步给其他节点,避免形成“广播效应”,造成死循环 if (peerEurekaNodes == Collections.EMPTY_LIST || isReplication) { return; } for (final PeerEurekaNode node : peerEurekaNodes.getPeerEurekaNodes()) { // If the url represents this host, do not replicate to yourself. if (peerEurekaNodes.isThisMyUrl(node.getServiceUrl())) { continue; } replicateInstanceActionsToPeers(action, appName, id, info, newStatus, node); } } finally { tracer.stop(); } } private void replicateInstanceActionsToPeers(Action action, String appName, String id, InstanceInfo info, InstanceStatus newStatus, PeerEurekaNode node) { try { InstanceInfo infoFromRegistry = null; CurrentRequestVersion.set(Version.V2); switch (action) { case Cancel: node.cancel(appName, id); break; case Heartbeat: InstanceStatus overriddenStatus = overriddenInstanceStatusMap.get(id); infoFromRegistry = getInstanceByAppAndId(appName, id, false); node.heartbeat(appName, id, infoFromRegistry, overriddenStatus, false); break; case Register: node.register(info); break; case StatusUpdate: infoFromRegistry = getInstanceByAppAndId(appName, id, false); node.statusUpdate(appName, id, newStatus, infoFromRegistry); break; case DeleteStatusOverride: infoFromRegistry = getInstanceByAppAndId(appName, id, false); node.deleteStatusOverride(appName, id, infoFromRegistry); break; } } catch (Throwable t) { logger.error("Cannot replicate information to {} for action {}", node.getServiceUrl(), action.name(), t); } } 我们看注册动作对应方法这里最终还是调用如下:只不过此时关键在于是否为副本节点

优秀的个人博客,低调大师

业余草 SpringCloud教程 | 第八篇: 消息总线(Spring Cloud Bus)(Finchley版本)

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/xmt1139057136/article/details/81412869 Spring Cloud Bus 将分布式的节点用轻量的消息代理连接起来。它可以用于广播配置文件的更改或者服务之间的通讯,也可以用于监控。本文要讲述的是用Spring Cloud Bus实现通知微服务架构的配置文件的更改。 一、准备工作 本文还是基于上一篇文章来实现。按照官方文档,我们只需要在配置文件中配置 spring-cloud-starter-bus-amqp ;这就是说我们需要装rabbitMq,点击rabbitmq下载。至于怎么使用 rabbitmq,搜索引擎下。 二、改造config-client 在pom文件加上起步依赖spring-cloud-starter-bus-amqp,完整的配置文件如下: <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-config</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-bus-amqp</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> 在配置文件application.properties中加上RabbitMq的配置,包括RabbitMq的地址、端口,用户名、密码。并需要加上spring.cloud.bus的三个配置,具体如下: spring.rabbitmq.host=localhost spring.rabbitmq.port=5672 spring.rabbitmq.username=guest spring.rabbitmq.password=guest spring.cloud.bus.enabled=true spring.cloud.bus.trace.enabled=true management.endpoints.web.exposure.include=bus-refresh ConfigClientApplication启动类代码如下: @SpringBootApplication @EnableEurekaClient @EnableDiscoveryClient @RestController @RefreshScope public class ConfigClientApplication { /** * http://localhost:8881/actuator/bus-refresh */ public static void main(String[] args) { SpringApplication.run(ConfigClientApplication.class, args); } @Value("${foo}") String foo; @RequestMapping(value = "/hi") public String hi(){ return foo; } } 依次启动eureka-server、confg-cserver,启动两个config-client,端口为:8881、8882。 访问http://localhost:8881/hi或者http://localhost:8882/hi浏览器显示: foo version 3 这时我们去代码仓库将foo的值改为“foo version 4”,即改变配置文件foo的值。如果是传统的做法,需要重启服务,才能达到配置文件的更新。此时,我们只需要发送post请求:http://localhost:8881/actuator/bus-refresh,你会发现config-client会重新读取配置文件 重新读取配置文件: 这时我们再访问http://localhost:8881/hi或者http://localhost:8882/hi浏览器显示: foo version 4 另外,/actuator/bus-refresh接口可以指定服务,即使用”destination”参数,比如 “/actuator/bus-refresh?destination=customers:**” 即刷新服务名为customers的所有服务。 三、分析 此时的架构图: 当git文件更改的时候,通过pc端用post 向端口为8882的config-client发送请求/bus/refresh/;此时8882端口会发送一个消息,由消息总线向其他服务传递,从而使整个微服务集群都达到更新配置文件。 本文源码下载: https://github.com/forezp/SpringCloudLearning/tree/master/sc-f-chapter8 五、参考资料 http://cloud.spring.io/spring-cloud-static/Finchley.RELEASE/single/spring-cloud.html 感谢您的关注!可加QQ1群:135430763,QQ2群:454796847,QQ3群:187424846。QQ群进群密码:xttblog,想加微信群的朋友,可以微信搜索:xmtxtt,备注:“xttblog”,添加助理微信拉你进群。备注错误不会同意好友申请。再次感谢您的关注!后续有精彩内容会第一时间发给您!原创文章投稿请发送至532009913@qq.com邮箱。商务合作可添加助理微信进行沟通!

优秀的个人博客,低调大师

阿里云Kubernetes SpringCloud 实践进行时(1): 分布式服务注册与发现

简介 为了更好地支撑日益增长的庞大业务量,我们常常需要把服务进行整合、拆分,使我们的服务不仅能通过集群部署抵挡流量的冲击,又能根据业务在其上进行灵活的扩展。随着分布式的普及、服务的快速增长与云计算技术的进步,微服务架构也因其特有的优势而备受关注。微服务架构的本质,是把整体的业务拆分成很多有特定明确功能的服务,通过很多分散的小服务之间的配合,去解决更大,更复杂的问题。对被拆分后的服务进行分类和管理,彼此之间使用统一的接口来进行交互。 本系列讲述了在阿里云Kubernetes容器服务基础之上,如何快速搭建基于Spring Cloud的微服务架构中的基础设施: 第一篇:分布式服务注册与发现系统 第二篇:分布式配置管理系统 第三篇:API网关服务Zuul 系统 第四篇:分布式追踪系统 第五篇:分布式弹性服务与容错处理框架Hystrix及其监控仪表板 第六

优秀的个人博客,低调大师

springcloud(十二):使用Spring Cloud Sleuth和Zipkin进行分布式链路跟踪

随着业务发展,系统拆分导致系统调用链路愈发复杂一个前端请求可能最终需要调用很多次后端服务才能完成,当整个请求变慢或不可用时,我们是无法得知该请求是由某个或某些后端服务引起的,这时就需要解决如何快读定位服务故障点,以对症下药。于是就有了分布式系统调用跟踪的诞生。 现今业界分布式服务跟踪的理论基础主要来自于 Google 的一篇论文《Dapper, a Large-Scale Distributed Systems Tracing Infrastructure》,使用最为广泛的开源实现是 Twitter 的 Zipkin,为了实现平台无关、厂商无关的分布式服务跟踪,CNCF 发布了布式服务跟踪标准 Open Tracing。国内,淘宝的“鹰眼”、京东的“Hydra”、大众点评的“CAT”、新浪的“Watchman”、唯品会的“Microscope”、窝窝网的“Tracing”都是这样的系统。 Spring Cloud Sleuth 一般的,一个分布式服务跟踪系统,主要有三部分:数据收集、数据存储和数据展示。根据系统大小不同,每一部分的结构又有一定变化。譬如,对于大规模分布式系统,数据存储可分为实时数据和全量数据两部分,实时数据用于故障排查(troubleshooting),全量数据用于系统优化;数据收集除了支持平台无关和开发语言无关系统的数据收集,还包括异步数据收集(需要跟踪队列中的消息,保证调用的连贯性),以及确保更小的侵入性;数据展示又涉及到数据挖掘和分析。虽然每一部分都可能变得很复杂,但基本原理都类似。 服务追踪的追踪单元是从客户发起请求(request)抵达被追踪系统的边界开始,到被追踪系统向客户返回响应(response)为止的过程,称为一个“trace”。每个 trace 中会调用若干个服务,为了记录调用了哪些服务,以及每次调用的消耗时间等信息,在每次调用服务时,埋入一个调用记录,称为一个“span”。这样,若干个有序的 span 就组成了一个 trace。在系统向外界提供服务的过程中,会不断地有请求和响应发生,也就会不断生成 trace,把这些带有span 的 trace 记录下来,就可以描绘出一幅系统的服务拓扑图。附带上 span 中的响应时间,以及请求成功与否等信息,就可以在发生问题的时候,找到异常的服务;根据历史数据,还可以从系统整体层面分析出哪里性能差,定位性能优化的目标。 Spring Cloud Sleuth为服务之间调用提供链路追踪。通过Sleuth可以很清楚的了解到一个服务请求经过了哪些服务,每个服务处理花费了多长。从而让我们可以很方便的理清各微服务间的调用关系。此外Sleuth可以帮助我们: 耗时分析: 通过Sleuth可以很方便的了解到每个采样请求的耗时,从而分析出哪些服务调用比较耗时; 可视化错误: 对于程序未捕捉的异常,可以通过集成Zipkin服务界面上看到; 链路优化: 对于调用比较频繁的服务,可以针对这些服务实施一些优化措施。 spring cloud sleuth可以结合zipkin,将信息发送到zipkin,利用zipkin的存储来存储信息,利用zipkin ui来展示数据。 这是Spring Cloud Sleuth的概念图: ZipKin Zipkin 是一个开放源代码分布式的跟踪系统,由Twitter公司开源,它致力于收集服务的定时数据,以解决微服务架构中的延迟问题,包括数据的收集、存储、查找和展现。 每个服务向zipkin报告计时数据,zipkin会根据调用关系通过Zipkin UI生成依赖关系图,显示了多少跟踪请求通过每个服务,该系统让开发者可通过一个 Web 前端轻松的收集和分析数据,例如用户每次请求服务的处理时间等,可方便的监测系统中存在的瓶颈。 Zipkin提供了可插拔数据存储方式:In-Memory、MySql、Cassandra以及Elasticsearch。接下来的测试为方便直接采用In-Memory方式进行存储,生产推荐Elasticsearch。 快速上手 创建zipkin-server项目 项目依赖 <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-eureka</artifactId> </dependency> <dependency> <groupId>io.zipkin.java</groupId> <artifactId>zipkin-server</artifactId> </dependency> <dependency> <groupId>io.zipkin.java</groupId> <artifactId>zipkin-autoconfigure-ui</artifactId> </dependency> </dependencies> 启动类 @SpringBootApplication @EnableEurekaClient @EnableZipkinServer public class ZipkinApplication { public static void main(String[] args) { SpringApplication.run(ZipkinApplication.class, args); } } 使用了@EnableZipkinServer注解,启用Zipkin服务。 配置文件 eureka: client: serviceUrl: defaultZone: http://localhost:8761/eureka/ server: port: 9000 spring: application: name: zipkin-server 配置完成后依次启动示例项目:spring-cloud-eureka、zipkin-server项目。刚问地址:http://localhost:9000/zipkin/可以看到Zipkin后台页面 项目添加zipkin支持 在项目spring-cloud-producer和spring-cloud-zuul中添加zipkin的支持。 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zipkin</artifactId> </dependency> Spring应用在监测到Java依赖包中有sleuth和zipkin后,会自动在RestTemplate的调用过程中向HTTP请求注入追踪信息,并向Zipkin Server发送这些信息。 同时配置文件中添加如下代码: spring: zipkin: base-url: http://localhost:9000 sleuth: sampler: percentage: 1.0 spring.zipkin.base-url指定了Zipkin服务器的地址,spring.sleuth.sampler.percentage将采样比例设置为1.0,也就是全部都需要。 Spring Cloud Sleuth有一个Sampler策略,可以通过这个实现类来控制采样算法。采样器不会阻碍span相关id的产生,但是会对导出以及附加事件标签的相关操作造成影响。 Sleuth默认采样算法的实现是Reservoir sampling,具体的实现类是PercentageBasedSampler,默认的采样比例为: 0.1(即10%)。不过我们可以通过spring.sleuth.sampler.percentage来设置,所设置的值介于0.0到1.0之间,1.0则表示全部采集。 这两个项目添加zipkin之后,依次进行启动。 进行验证 这样我们就模拟了这样一个场景,通过外部请求访问Zuul网关,Zuul网关去调用spring-cloud-producer对外提供的服务。 四个项目均启动后,在浏览器中访问地址:http://localhost:8888/producer/hello?name=neo 两次,然后再打开地址:http://localhost:9000/zipkin/点击对应按钮进行查看。 点击查找看到有两条记录 点击记录进去页面,可以看到每一个服务所耗费的时间和顺序 点击依赖分析,可以看到项目之间的调用关系 示例代码-github 示例代码-码云 参考: 分布式服务跟踪及Spring Cloud的实现 作者:纯洁的微笑 出处:www.ityouknow.com 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。 本文如对您有帮助,还请多帮 【推荐】 下此文。 如果喜欢我的文章,请关注我的公众号

优秀的个人博客,低调大师

springCloud(7):Ribbon实现客户端侧负载均衡-消费者整合Ribbon

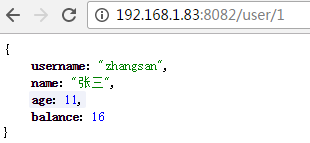
一、简介 Ribbon是Netfix发布的负载均衡器,它有助于控制HTTP和TCP客户端的行为。为Ribbon配置服务提供者地址列表后,Ribbon就可基于某种负载均衡算法,自动地帮助服务消费者去请求。Ribbon默认为我们提供了很多的负载均衡算法,例如轮询、随机等,当然,也可以为Ribbon实现自定义的负载均衡算法。 在Spring Cloud中,当Ribbon与Eureka配合使用时,Ribbon可自动从Eureka Server获取服务提供者地址列表,并基于负载均衡算法,请求其中一个服务提供者实例。 二、为服务消费者整合Ribbon 2.1、引入ribbon依赖 1 2 3 4 < dependency > < groupId >org.springframework.cloud</ groupId > < artifactId >spring-cloud-starter-ribbon</ artifactId > </ dependency > 2.2、为RestTemplate添加@LoadBalanced注解(Application) 1 2 3 4 5 @Bean @LoadBalanced public RestTemplaterestTemplate(){ return new RestTemplate(); } 2.3、调用其它微服务 1 2 3 4 5 6 7 8 9 10 11 12 13 14 @GetMapping ( "/user/{id}" ) public UserfindById( @PathVariable Longid) throws Exception{ ServiceInstanceserviceInstance= this .loadBalancerClient.choose( "spring-ribbon-eureka-client2" ); //打印当前选择的是哪个节点 System.out.println( "serviceId:" +serviceInstance.getServiceId()); System.out.println( "hoost:" +serviceInstance.getHost()); System.out.println( "port:" +serviceInstance.getPort()); System.out.println( "============================================================" ); if ( null ==id){ return null ; } return this .restTemplate.getForObject( "http://spring-ribbon-eureka-client2/" +id,User. class ); } 说明: 1、spring-ribbon-eureka-client2是服务提供者注册到Eureka Server上的应用名称 2、本次测试开启了两个spring-ribbon-eureka-client2服务提供者,一个端口是8080,一个是8083 2.4、测试 访问:http://192.168.1.83:8082/user/1 效果: 本文转自我爱大金子博客51CTO博客,原文链接http://blog.51cto.com/1754966750/1947059如需转载请自行联系原作者 我爱大金子

优秀的个人博客,低调大师

springCloud(14):使用Zuul构建微服务网关-路由端点与路由配置详解

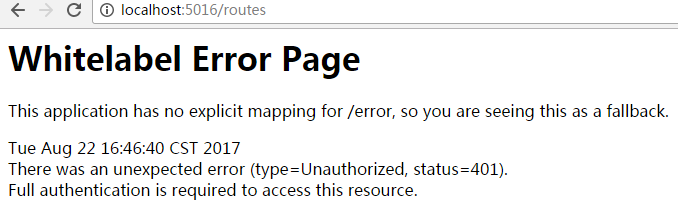
一、Zuul的路由端点 当@EnableZuulProxy与SpringBoot Actuator配合使用时,Zuul会暴露一个路由管理端点/routes。借助这个端点,可以方便、直观地查看以及管理Zuul的路由。 /routes端点的使用非常简单,使用GET方法访问该端点,即可返回Zuul当前映射的路由列表;使用POST方法访问该端点就会强制刷新Zuul当前映射的路由列表(尽管路由会自动刷新,Spring Cloud依然提供了强制立即刷新的方式)。 由于spring-cloud-starter-zuul已经包含了spring-boot-starter-actuator,因此之前编写的microservice-gateway-zuul已具备路由管理的能力。 测试: 1、依次启动eureka-server(4010)、eureka-server-2(5010)、provide-user(4011)、hystrix-consumer-movie(5012)、microservice-gateway-zuul(5016) 2、访问http://localhost:5016/routes,结果报401 解决:配置management.security.enabled=false 从中可以直观地看出路径到微服务的映射。 二、路由配置详解 前面已经编写了一个简单的Zuul网关,并让该网关代理了所有注册到Eureka Server的微服务。但在现实中可能只想让Zuul代理部分微服务,又或者需要对URL进行更加精确的控制。 2.1、自定义指定微服务的访问路径 配置zuul.routes.指定微服务的serverId = 指定路径即可。例如: 1 2 3 zuul: routes: hystrix-consumer-movie:/movie/** 效果: 2.2、忽略指定微服务 使用zuul.ignored-services配置需要忽略的服务,多个用逗号分隔,例如: 1 2 zuul: ignored-services:provide-user 效果: 2.3、忽略所有微服务,只路由指定微服务 将zuul.ignored-services设为'*',routes配置指定的微服务,例如: 1 2 3 4 zuul: ignored-services: '*' routes: hystrix-consumer-movie:/movie/** 效果: 2.4、同时指定微服务的serviceId和对应的路径 1 2 3 4 5 zuul: routes: user-route: #user-route只是给路由一个名称,可以随便命名 service-id:hystrix-consumer-movie path:/movie/** #service-id对应的路径 效果与2.1一样。 2.5、同时指定path和URL 1 2 3 4 5 zuul: routes: user-route: #user-route只是给路由一个名称,可以随便命名 url:http://localhost:5200/ #指定URL path:/movie/** #URL对应的路径 说明:当访问http://localhost:5016/movie/user/1时,则会转发至http://localhost:5200/user/1 效果: 注意:使用这种方式配置的路由不会作为HystrixCommand执行,同时也不能使用Ribbon来负载均衡多个URL 2.6、同时指定path和URL,并且不破坏Hystrix、Ribbon特性 1 2 3 4 5 6 7 8 9 10 11 zuul: routes: user-route: path:/user/** service-id:provide-user ribbon: eureka: enabled:false #为Ribbon禁用Eureka provide-user: #这边是serviceId ribbon: listOfServers:http://localhost:4011,http://localhost:4012 2.7、使用正则表达式指定Zuul的路由匹配规则 借助PatternServiceRouteMapper,实现从微服务到映射路由的正则配置。 1 2 3 4 5 6 7 8 9 10 11 12 13 @SpringBootApplication @EnableZuulProxy public class Application{ public static void main(String[]args){ SpringApplication.run(Application. class ,args); } /*正则表达式指定Zuul的路由匹配规则**/ @Bean public PatternServiceRouteMapperserviceRouteMapper(){ return new PatternServiceRouteMapper( "(?<name>^.+)-(?<version>v.+$)" , "${version}/${name}" ); } } 说明:上面将如provide-user-v2这个微服务,映射到/v2/provide-user/**这个路径上 例:我们队微服务的serviceId命名为provide-user-v2,那么我们可以这么来访问http://localhost:5017/v2/provide-user/1 2.8、路由前缀 设置 zuul.prefix 可以为所有的匹配增加前缀, 例如 /api,代理前缀默认会从请求路径中移除(通过zuul.stripPrefix=false可以关闭这个功能),zuul.stripPrefix默认为true. 如:配置全局的,与prefix一起使用 1 2 3 zuul: prefix:/api strip-prefix:true 当strip-prefix=true的时候 (http://localhost:5016/api/provide-user/1 -> http://localhost:4011/1) 当strip-prefix=false的时候(http://localhost:5016/api/provide-user/1 -> http://localhost:4011/api/1) 说明上面为true的配置,当访问zuul的/api/provide-user/1路径,请求将会被转发到provide-user微服务的/1路径 如:配置局部的,与path一起使用 1 2 3 4 5 zuul: routes: provide-user: path:/user/** strip-prefix:false 当strip-prefix=true的时候 (http://localhost:5016/user/1->http://localhost:4011/1) 当strip-prefix=false的时候(http://localhost:5016/user/1->http://localhost:4011/user/1) 说明上面为true的配置,当访问zuul的/user/1路径,请求将会被转发到provide-user微服务的/1路径 2.9、忽略某些路径 2.2中有讲有忽略微服务,但是有时需要更细粒度的路由控制。如,想让Zuul代理某个微服务,同时又想保护该微服务的某些敏感路径。此时,可使用ignored-patterns指定忽略的正则,如: 1 2 zuul: ignored-patterns:/**/provide-user/** #忽略所有包含/provide-user/的路径 本文转自我爱大金子博客51CTO博客,原文链接http://blog.51cto.com/1754966750/1958422如需转载请自行联系原作者 我爱大金子

优秀的个人博客,低调大师

Jboot v3.2.7 发布,基于 JFinal 的另一个 SpringCloud 的选择

Jboot 是一个基于 JFinal、JFinal-Undertow、Dubbo、Seata、Sentinel、ShardingSphere、Nacos 等开发的微服务框架,帮助开发者降低微服务开发门槛。同时完美支持在 idea、eclipse 下多 maven 模块,对 java 代码、html、css、js 等资源文件进行热加载。爽爽开发,快乐生活。 Jboot 目前已经开源超过了 3 年的时间,迭代了 100+ 个版本,已经被超过 1000+ 公司在使用。 Jboot 主要有以下特征: 1、基于 JFinal 的 MVC + ORM 快速开发。 2、基于ShardingSphere +Seata 分布式事务 和 分库分表。 3、基于 Dubbo 或 Motan 的 RPC 实现 4、基于 Sentinel 的分布式限流和降级 5、基于 Apollo 和 Nacos 的分布式配置中心 6、基于 EhCache 和 Redis 的分布式二级缓存 Jboot v3.2.7 更新内容如下: 新增:为 JbootJson 新增 camelCaseToLowerCaseAnyway 配置,默认为 false 新增:Columns 查询添加 safeMode ,safeMode 对添加 null 值的数据会自动抛出空指针异常。 优化:修改 JbootModel.buildIdCacheKey 为 protected 修饰,方便在某些情况下进行重写。 优化:Columns 在 safeMode 模式下,当传入 null 值时,直接抛出空指针异常,更加方便开发调试。 优化:ClassScanner 和 JbootJson 优化:升级 fastjson、jackson Json 等到最新版本 修复:JbootAppListener 无法进行正确注入的问题 修复:Model 的 getter 方法无法输出 json 的问题 maven 依赖: <dependency> <groupId>io.jboot</groupId> <artifactId>jboot</artifactId> <version>3.2.7</version> </dependency> Hello World: @RequestMapping("/") public class HelloworldController extends JbootController { public void index(){ renderText("hello world"); } public static void main(String[] args){ JbootApplication.run(args); } }

优秀的个人博客,低调大师

java B2B2C Springcloud电子商城系统-断路器(Hystrix)

原理在微服务架构中,服务之间形成调用链路,链路中的任何一个服务提供者都可能面临着相应超时、宕机等不可用的情况,在高并发的情况下,这种情况会随着并发量的上升恶化,形成“雪崩效应”,而断路器hystrix正是用来解决这一个问题的组件。 断路器基本原理为: 正常情况下,断路器关闭,服务消费者正常请求微服务 一段事件内,失败率达到一定阈值(比如50%失败,或者失败了50次),断路器将断开,此时不再请求服务提供者,而是只是快速失败的方法(断路方法) 断路器打开一段时间,自动进入“半开”状态,此时,断路器可允许一个请求方法服务提供者,如果请求调用成功,则关闭断路器,否则继续保持断路器打开状态。 断路器hystrix是保证了局部发生的错误,不会扩展到整个系统,从而保证系统的即使出现局部问题也不会造成系统雪崩。 配置/使用 下面讲解在restTemplate和feign中断路器的配置和使用步骤 restTemplate+ribbon整合Hystrix 引入hystrix依赖 <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-hystrix</artifactId> </dependency> 虽然Eureka依赖了ribbon,ribbon依赖了hystrix-core,但还是要引用了上面的maven依赖,因为下面用到的@HystrixCommand注解用到了hystrix-javanica包 启动类加上@EnableCircuitBreaker注解(@EnableHystrix也可以) 修改HelloWorldController的入口请求方法 @GetMapping("/message") @HystrixCommand(fallbackMethod = "getMessageFallback") public HelloworldMessage getMessage() { HelloMessage hello = getMessageFromHelloService(); WorldMessage world = getMessageFromWorldService(); HelloworldMessage helloworld = new HelloworldMessage(); helloworld.setHello(hello); helloworld.setWord(world); log.debug("Result helloworld message:{}", helloworld); return helloworld; } /** * 断路方法 * @return */ public HelloworldMessage getMessageFallback(){ HelloMessage helloMessage=new HelloMessage(); helloMessage.setName("hello"); helloMessage.setMessage("error occurs"); WorldMessage worldMessage=new WorldMessage(); worldMessage.setMessage("world error occurs"); HelloworldMessage helloworldMessage=new HelloworldMessage(); helloworldMessage.setHello(helloMessage); helloworldMessage.setWord(worldMessage); return helloworldMessage; } 通过@HystrixCommand注解的fallbackMethod指向断路方法,该方法会在调用hello服务或者world服务失败时被调用。 @HystrixCommand 注解还可以配置超时事件等其他属性。 测试 1)依次启动eureka server:discovery/trace/hello/world/helloword项目 2)在浏览器输入地址http:\localhost:8020/message,则返回正确的结果 3)停止hello项目,再次输入上述地址,则执行断路器中的方法。 feign下整合Hystrix feign禁用Hystrix 在Spring Cloud中,只要Hystrix在项目的classpath中,Feign就会用断路器包裹Feign客户端的所有方法,如果要禁用Hystrix则可以通过自定义feign的配置来解决。 @Configuration public class FeignConfiguration{ @Bean @Scope("prototype") public Feign Builder feignBuilder(){ return Feign.builder(); } } 要禁用Hystrix的接口引用该配置即可 @FeignClient(name="hello",configuration=FeignConfiguration.class) public interface HelloService{ ...... } feign使用Hystrix 启用Hystrix 默认情况下feign已经整合了Hystrix,在配置文件中开启即可(本人用的的Dalston.SR2版本的Spring Cloud,需要在配置文件开启) feign: hystrix: enabled: true 接口指定回退类 在HelloService中修改FeignClient类,指定fallback的类 package com.example.helloworldfeign.service; import com.example.helloworldfeign.model.HelloMessage; import org.springframework.cloud.netflix.feign.FeignClient; import org.springframework.web.bind.annotation.GetMapping; /** * @author billjiang 475572229@qq.com * @create 17-8-23 */ @FeignClient(value="hello",fallback = HelloServiceFallback.class) public interface HelloService { @GetMapping("/message") HelloMessage hello(); } 实现了接口fallback的类的实现: package com.example.helloworldfeign.service; import com.example.helloworldfeign.model.HelloMessage; import org.springframework.stereotype.Component; /** * @author billjiang 475572229@qq.com * @create 17-8-28 */ @Component public class HelloServiceFallback implements HelloService { @Override public HelloMessage hello() { HelloMessage helloMessage=new HelloMessage(); helloMessage.setName("hello"); helloMessage.setMessage("error occurs"); return helloMessage; } } world项目同上 测试 1)依次启动eureka server:discovery/trace/hello/world/helloword-feing项目 2)在浏览器输入地址http:\localhost:8030/message,则返回正确的结果 3)停止hello项目,再次输入上述地址,则执行断路器中的方法。 查看断路器错误日志 如果要查看详细的断路器的日志,可以通过注解@FeignClient的fallbackFactory来实现,如下代码所示: import com.example.helloworldfeign.model.HelloMessage; import org.springframework.cloud.netflix.feign.FeignClient; import org.springframework.web.bind.annotation.GetMapping; /** * @author billjiang 475572229@qq.com * @create 17-8-23 */ @FeignClient(value="hello",fallbackFactory = HelloServiceFallbackFactory.class) public interface HelloService { @GetMapping("/message") HelloMessage hello(); } HelloServiceFallbackFactory类: package com.example.helloworldfeign.service; import com.example.helloworldfeign.model.HelloMessage; import feign.hystrix.FallbackFactory; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.stereotype.Component; /** * @author billjiang 475572229@qq.com * @create 17-8-28 */ @Component public class HelloServiceFallbackFactory implements FallbackFactory<HelloService> { private final static Logger LOGGER= LoggerFactory.getLogger(HelloServiceFallbackFactory.class); @Override public HelloService create(Throwable throwable) { return new HelloService() { @Override public HelloMessage hello() { //print the error LOGGER.error("fallback ,the result is:",throwable); HelloMessage helloMessage=new HelloMessage(); helloMessage.setName("hello"); helloMessage.setMessage("error occurs"); return helloMessage; } }; //需要JAVA Spring Cloud大型企业分布式微服务云构建的B2B2C电子商务平台源码 一零三八七七四六二六 } } 这样会在控制台把具体导致熔断的信息输出,以便跟踪错误。 java B2B2C springmvc mybatis电子商务平台源码

优秀的个人博客,低调大师

java B2B2C Springcloud电子商城系统--------负载均衡(Load Balance)

负载均衡(Load Balance) 由于目前现有网络的各个核心部分随着业务量的提高,访问量和数据流量的快速增长,其处理能力和计算强度也相应地增大,使得单一的服务器设备根本无法承担。在此情况下,如果扔掉现有设备去做大量的硬件升级,这样将造成现有资源的浪费,而且如果再面临下一次业务量的提升时,这又将导致再一次硬件升级的高额成本投入,甚至性能再卓越的设备也不能满足当前业务量增长的需求。愿意了解源码的朋友直接求求交流分享技术:二一四七七七五六三三 负载均衡实现方式分类 1:软件负载均衡技术 该技术适用于一些中小型网站系统,可以满足一般的均衡负载需求。软件负载均衡技术是在一个或多个交互的网络系统中的多台服务器上安装一个或多个相应的负载均衡软件来实现的一种均衡负载技术。软件可以很方便的安装在服务器上,并且实现一定的均衡负载功能。软件负载均衡技术配置简单、操作也方便,最重要的是成本很低。 2:硬件负载均衡技术 由于硬件负载均衡技术需要额外的增加负载均衡器,成本比较高,所以适用于流量高的大型网站系统。不过在现在较有规模的企业网、政府网站,一般来说都会部署有硬件负载均衡设备(原因1.硬件设备更稳定,2.也是合规性达标的目的)硬件负载均衡技术是在多台服务器间安装相应的负载均衡设备,也就是负载均衡器来完成均衡负载技术,与软件负载均衡技术相比,能达到更好的负载均衡效果。 3:本地负载均衡技术 本地负载均衡技术是对本地服务器群进行负载均衡处理。该技术通过对服务器进行性能优化,使流量能够平均分配在服务器群中的各个服务器上,本地负载均衡技术不需要购买昂贵的服务器或优化现有的网络结构。 (如微软NLB网络负载均衡技术,该技术通过多台服务器上起应用完成负载均衡的实现,原理是几台服务器虚拟出一个IP地址,应用会使服务器轮循响应数据,但是在一次安全网关的部署当中就遇到了问题,大家以后可以注意本次经验,问题简单描述如下:当外部测试PC,向虚拟IP地址发了一个ping包之后,虚拟IP回应一个数据包,另外,实主机也均回应数据包,导致安全设备认为会话不是安全的。所以进行阻断,致使业务不正常。) 4:全局负载均衡技术(也称为广域网负载均衡) 全局负载均衡技术适用于拥有多个低于的服务器集群的大型网站系统。全局负载均衡技术是对分布在全国各个地区的多个服务器进行负载均衡处理,该技术可以通过对访问用户的IP地理位置判定,自动转向地域最近点。很多大型网站都使用的这种技术。 5:链路集合负载均衡技术 链路集合负载均衡技术是将网络系统中的多条物理链路,当作单一的聚合逻辑链路来使用,使网站系统中的数据流量由聚合逻辑链路中所有的物理链路共同承担。这种技术可以在不改变现有的线路结构,不增加现有带宽的基础上大大提高网络数据吞吐量,节约成本。 总结: 负载均衡至少有四种应用: 服务器负载均衡; 广域网络服务器负载均衡; 防火墙负载均衡; 透明网站加速器负载均衡。 服务器负载均衡负责将客户请求的任务分发到多台服务器,用以扩展服务能力并超出一台服务器的处理能力,并且能够使应用系统具有容错能力。 广域网络服务器负载均衡负责将客户的请求导向到不同的数据中心的服务器群中,以便为客户提供更快的响应速度和针对某一数据中心出现灾难性事故时智能的冗灾处理。 防火墙负载均衡将请求负载分发到多台防火墙,用来提高安全性能以便超出一台防火墙的处理能力。 透明网站加速器(Transparent cache)使导向流量交换到多台网站加速器中,用以卸载网站服务器的静态内容到网站加速器(Cache)中,从而提高网站服务的性能和加速cache的响应时间。 整体代码结构如下: 资料和源码来源

优秀的个人博客,低调大师

业余草 SpringCloud教程 | 第十一篇: 断路器监控(Hystrix Dashboard)(Finchley版本)

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/xmt1139057136/article/details/81413998 在我的第四篇文章断路器讲述了如何使用断路器,并简单的介绍了下Hystrix Dashboard组件,这篇文章更加详细的介绍Hystrix Dashboard。 一、Hystrix Dashboard简介 在微服务架构中为例保证程序的可用性,防止程序出错导致网络阻塞,出现了断路器模型。断路器的状况反应了一个程序的可用性和健壮性,它是一个重要指标。Hystrix Dashboard是作为断路器状态的一个组件,提供了数据监控和友好的图形化界面。 二、准备工作 本文的的工程栗子,来源于第一篇文章的栗子,在它的基础上进行改造。 三、开始改造service-hi 在pom的工程文件引入相应的依赖: <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix-dashboard</artifactId> </dependency> </dependencies> 其中,这三个依赖是必须的,缺一不可。 在程序的入口ServiceHiApplication类,加上@EnableHystrix注解开启断路器,这个是必须的,并且需要在程序中声明断路点HystrixCommand;加上@EnableHystrixDashboard注解,开启HystrixDashboard @SpringBootApplication @EnableEurekaClient @EnableDiscoveryClient @RestController @EnableHystrix @EnableHystrixDashboard @EnableCircuitBreaker public class ServiceHiApplication { /** * 访问地址 http://localhost:8762/actuator/hystrix.stream * @param args */ public static void main(String[] args) { SpringApplication.run( ServiceHiApplication.class, args ); } @Value("${server.port}") String port; @RequestMapping("/hi") @HystrixCommand(fallbackMethod = "hiError") public String home(@RequestParam(value = "name", defaultValue = "forezp") String name) { return "hi " + name + " ,i am from port:" + port; } public String hiError(String name) { return "hi,"+name+",sorry,error!"; } } 运行程序: 依次开启eureka-server 和service-hi. 四、Hystrix Dashboard图形展示 打开http://localhost:8762/actuator/hystrix.stream,可以看到一些具体的数据: 打开locahost:8762/hystrix 可以看见以下界面: 在界面依次输入:http://localhost:8762/actuator/hystrix.stream、2000 、miya ;点确定。 在另一个窗口输入:http://localhost:8762/hi?name=forezp 重新刷新hystrix.stream网页,你会看到良好的图形化界面: 源码下载:https://github.com/forezp/SpringCloudLearning/tree/master/sc-f-chapter12 五、参考资料 hystrix-dashboard 感谢您的关注!可加QQ1群:135430763,QQ2群:454796847,QQ3群:187424846。QQ群进群密码:xttblog,想加微信群的朋友,可以微信搜索:xmtxtt,备注:“xttblog”,添加助理微信拉你进群。备注错误不会同意好友申请。再次感谢您的关注!后续有精彩内容会第一时间发给您!原创文章投稿请发送至532009913@qq.com邮箱。商务合作可添加助理微信进行沟通!

优秀的个人博客,低调大师

第六章:SpringCloud Ribbon 自定义服务端口访问策略(Rule)

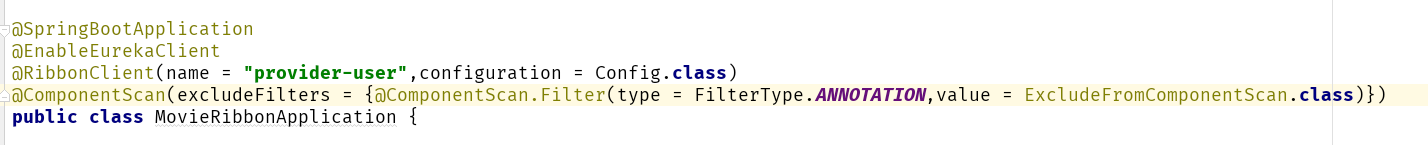
在使用ribbon的过程中,难免会遇到对不同服务的负载均衡策略不同。 我举个例子。 A服务开了两个端口 B服务开了两个端口 如果使用默认配置。ribbon使用的是轮询策略。 但是如果业务需要A轮询,B随机。 我们该怎么做呢。(提示:ribbon默认扫描包是启动类所在包下com.fantj.ribbon) 方案一: 写一段配置,扔到该包外面com.fantj下 /** * Created by Fant.J. * 2017/11/30 18:56 */ @SuppressWarnings("ALL") @Configuration //@RibbonClient(name = "provider-user",configuration = Config.class) public class Config { @Autowired IClientConfig clientConfig; @Bean @ConditionalOnMissingBean public IRule ribbonRule(IClientConfig clientConfig) { return new RandomRule(); //随机访问策略 } } 方案二: 自定义注解,并加载到启动类 自定义注解: package com.fantj.fantjconsumermovieribbon; /** * Created by Fant.J. * 2017/12/1 17:06 */ public @interface ExcludeFromComponentScan { } 启动项添加注解@ComponentScan image.png 其中 @RibbonClient(name = "provider-user",configuration = Config.class) 这个注解的作用是,告诉ribbon ,provider-user这个服务的策略配置在Config.class类里面。所以我在Config.java里把//@RibbonClient(name = "provider-user",configuration = Config.class)注释掉了。两者作用相同。 最后,在Config.java里添加注解@ExcludeFromComponentScan 重启,便会看到provider-user这个服务端口访问策略是随机,别的服务访问策略是轮询。 方案三 写入配置文件application.yml(ribbon读取配置文件的优先级最高) 看下官方的文档: users: #这里修改成自己的微服务id ribbon: NFLoadBalancerRuleClassName: com.netflix.loadbalancer.WeightedResponseTimeRule #这里是Rule 修改成自己的 provider-user: #微服务id ribbon: NFLoadBalancerRuleClassName: com.netflix.loadbalancer.WeightedResponseTimeRule #Rule,这个是权重响应事件Rule

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册