首页 文章 精选 留言 我的

精选列表

搜索[应用接续],共10000篇文章
优秀的个人博客,低调大师

Android应用框架之BroadcastReceiver

广播机制是Android系统中的一种消息传播机制,通过观察者模式实现了消息发送者与消息接收者之间的解耦。BroadcastReceiver的使用方式有两种,一种是静态注册,即在Manifest文件中注册,然后在需要发送广播时调用context.sendBroadcast(intent);;第二种是动态注册。BroadcastReceiver的使用不是本文的重点,本文将着重讲解广播的注册过程和消息发送及接收过程。 1 广播注册过程 广播的静态注册是通过PMS(PackageManagerService)来完成的,其余三大组件也是通过PMS来完成注册的。这里重点讲一下BroadcastReceiver的动态启动方法。和Activity以及Service一样,其启动过程也是通过ContextWrapper-->ContextImpl来完成的。其主要的启动函数是ContextImpl.registerReceiver: private Intent registerReceiverInternal(BroadcastReceiver receiver, int userId, IntentFilter filter, String broadcastPermission, Handler scheduler, Context context) { IIntentReceiver rd = null; ...... rd = mPackageInfo.getReceiverDispatcher(receiver, context, scheduler, mMainThread.getInstrumentation, true); ...... return ActivityManagerNatvice.getDefault().registerReceiver(mMainThread.getApplicationThread(), mBasePackageName, rd, filter, boradcastPermission, userId); ...... } 从上面的代码可以看出主要做了两件事: 从mPackageInfo获取IIntentReceiver对象,之所以这样和bindService是一样的,因为上述的注册过程是一个跨进程的通信方式,而BroadcastReceiver作为Android的一个组件是不能直接跨进程传递的,所以需要使用IIntentReceiver来中转。其具体是由LoadedApk.ReceiverDispatcher.InnerReceiver,ReceiverDispatcher内部同时保存了BroadcastReceiver和InnerReceiver,所以当接收到广播时,ReceiverDispatcher可以很方便地调用BroadcastReceiver.onReceive()方法。 通过ActivityManagerNative.getDefault()获取ActivityManagerService,然后通过AMS来完成广播的注册过程。 接下来具体看一下AMS的registerReceiver具体的实现: public Intent registerReceiver(IApplicationThread caller, String callerPackage, IIntentReceiver receiver, IntentFilter filter, String permission, int userId) { ...... mRegisterReceivers.put(receiver.asBinder(), rl); BroadcastFilter bf = new BroadcastFilter(filter, rl, callerPackage, permission, callingUid, userId); rl.add(bf); mReceiverResolver.addFilter(bf); } 2 广播的发送和接收过程 广播的发送通过ContextImpl.sendBroadcast方法: public void sendBroadcast(Intent intent) { ...... ActivityManagerNative.getDefault().broadcastIntent(mMainThread.getApplicationThread(), intent, resolvedType, null, Activity.RESULT_OK, null, null, null, AppOpsManager.OP_NONE, false, false, getUserId()); ...... } 不出意料,任务又转到了AMS中,AMS在接收到这个指令会调用内部的broadcastIntentLocked方法,在该方法中,AMS会根据intent-filter查找出匹配的广播接收者,并通过一系列的条件过滤,并将最终满足条件的广播接收者添加到BroadcastQueue中,然后BroadcastQueue会将广播发送到相应的广播接收者,核心代码如下: BroadcastQueue queue = broadcastQueueForIntent(intent); BroadcastRecord r = new BroadcastRecord(queue, intent, callerApp, callerPackage, callingPid, callingUid, resolvedType, requiredPermission, appOp, receivers, resultTo, resultCode, resultData, map, ordered, sticky, false, userId); ...... queue.enqueOrderedBroadcastLocked(r); queue.scheduleBroadcastsLocked(); 下面再看一下在BroadcastQueue中发送广播scheduleBroadcastsLocked的实现: public void scheduleBroadcastsLocked(){ ...... mHandler.sendMessage(mHandler.obtainMessage(BROADCAST_INTENT_MSG, this)); ...... } 实际上BroadcastQueue的scheduleBroadcastsLocked方法没有立即发送广播,而是发送了一个BROADCAST_INTENT_MSG类型的消息,BroadcastQueue收到该消息后会调用processNestBroadcast方法: while(mParallelBroadcasts.size() > 0) { r = mParallelBroadcasts.remove(0); r.dispatchTime = SystemClock.uptimeMillis(); r.dispatchClockTime = System.currentTimeMillis(); final int N = r.recivers.size(); for(int i = 0; i < N; i++) { Object target = r.receivers.get(i); deliverToRegisteredReceiverLocked(r, (BroadcastFilter)target, false); } addBroadcastToHistoryLocked(r); } 可以看到无序广播存储在mParallelBroadcasts中,系统遍历该队列,并将广播发送给它所有的接收者。具体的发送工作通过deliverToRegisteredReceiverLocked完成,在该函数内部通过performReceivedLocked来完成: private static void performReceiveLocked(ProcessRecord app, IIntentReceiver receiver, Intent intent, int resultCode, String data, Bundle extras, boolean ordered, boolean sticky, int sendingUser) throws RemoteException { ...... app.thread.scheduleRegisteredReceiver(receiver, intent, resultCode, data, extras, ordered, sticky, sendingUser, app.repProcState); ...... } ApplicationThread的scheduleRegisteredReceiver会调用InnerReceiver.performReceive来实现广播的接收。而在这个方法中会调用LoadedApk.ReceiverDispatcher.performReceive方法: public void performReceive(Intent intent, int resultCode, String data, Bundle extras, boolean ordered, boolean sticky, int sendingUser) { ...... Args args = new Args(intent, resultCode, data, extras, ordered, sticky, sendingUser); if(!mActivityThread.post(args)) { if(mRistered && ordered) { IActivityManager mgr = ActivityManagerNative.getDefault(); args.sendFinished(mgr); } } } 在上面的代码中,会创建一个Args对象,并通过mActivityThread的post方法来执行Args的逻辑,Args实际上是一个Runnable接口。mActivityThread是一个Handler,其实就是ActivityThread中的mH,类型是H。Args中的run方法有如下几行代码: final BroadcastReceiver receiver = mReceiver; receiver.setPendingResult(this); receiver.onReceive(mContext, intent); 这个时候BroadcastReceiver的onReceive方法才被执行,也就接收到广播了。

优秀的个人博客,低调大师

Docker实践--部署Nodejs应用

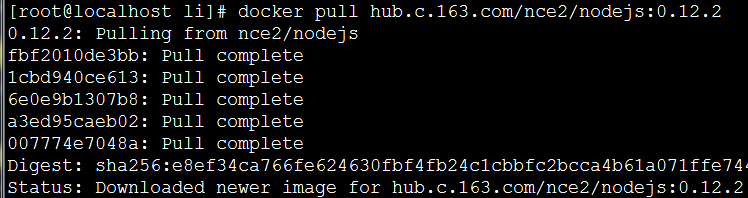
这个例子的目标是为了向大家展示如何在Docker的container里运行Node.js程序。我会先创建一个简单的Node.js web app,来构建一个镜像。然后基于这个Image运行一个container。从而实现快速部署。 由于网络的原因我的Node.js镜像从国内的镜像库下载,而不是Docker Hub。 先从国内的镜像网站上pull下一下nodejs镜像。 docker pull hub.c.163.com/nce2/nodejs:0.12.2 下载完后查看我们的镜像,找到他的名称,等会我们会用到 创建Node.js 程序 创建package.json,并写入相关信息和依赖 vi package.json { "name": "webtest", "version": "1.0.0", "description": "Node.js on Docker", "author": "lpxxn", "main": "server.js", "scripts": { "start": "node server.js" }, "dependencies": { "express": "^4.13.3" } } 创建server.js vi server.js 写一个最简单web 这个web基于express框架,返回Hello word.注意我们监听的是8888端口 'use strict'; var express = require('express'); var PORT = 8888; var app = express(); app.get('/', function (req, res) { res.send('Hello world\n'); }); app.listen(PORT); console.log('Running on http://localhost:' + PORT); 创建Dockerfile 接下来主角上场了创建Dockerfile文件 这个文件是创建镜像所必须的文件 vi Dockerfile Docker会依照Dockerfile的内容来构建一个镜像。我先给出完整的代码,再一行一行的给出解释 FROM hub.c.163.com/nce2/nodejs:0.12.2 # Create app directory RUN mkdir -p /home/Service WORKDIR /home/Service # Bundle app source COPY . /home/Service RUN npm install EXPOSE 8888 CMD [ "npm", "start" ] 我们来一句一句的解释 FROM hub.c.163.com/nce2/nodejs:0.12.2 FROM是构建镜像的基础源镜像,hub.c.163.com/nce2/nodejs:0.12.2 这个是镜像的名称,也就是我们一开始从国内服务器上拉下来的那个Image。如果本地没有Docker 会自己pull镜像。 # Create app directory RUN mkdir -p /home/Service WORKDIR /home/Service 第一句RUN 用于在Image里创建一个文件夹,将来用于保存我们的代码。 第二句WORKDIR是将我们创建的文件夹做为工作目录。 # Bundle app source COPY . /home/Service RUN npm install 第一句的COPY是把本机当前目录下的所有文件拷贝到Image的/home/Service文件夹下。 第二句的RUN 使用npm 安装我们的app据需要的所有依赖。 EXPOSE 8888 由于我们的web app监听的是8888端口,我们把这个端口暴露给主机,这样我就能从外部访问web了。 CMD [ "npm", "start" ] 这个我相信我不用解释你也能看出来他是做什么的。运行npm start命令,这个命令会运行 node service.js来 启动我们的web app。 构建Image 在你Dockerfile文件所在的目录下运行下面的命令来构建一个Image. docker build -t mynodeapp . 别忘了最的的那个点 构建完后查看一下我们的镜像 运行镜像 docker run -d -p 8888:8888 ac5 -d 表明容器会在后台运行,-p 表示端口映射,把本机的8888商品映射到container的8888端口这样外网就能通过本机的8888商品访问我们的web了。 后面的ac5是我们Image的ID因为前3个就已经能定位出这个Image所以我就没有把后边的再写出来。 通过docker ps查看我们刚运行的Container的ID 打印log 7370就是我们的Container ID,和Image ID一样,你也可以全写出来,我比较懒就写前4位,已经足够标识出这个Container了 docker logs 7350 如果你想到Container里可以执行下面的命令,进入到里边后就可以像操作普通的linux 一样。如果想退出可执行exit命令。 测试 我们先通过curl 看能不能访问我们的web。 curl -i localhost:8888 也可以通过浏览器来看一下 好了,这个小教程到此就结束了,希望能帮助你入门。

优秀的个人博客,低调大师

SparkSQL项目中的应用

Spark是一个通用的大规模数据快速处理引擎。可以简单理解为Spark就是一个大数据分布式处理框架。基于内存计算的Spark的计算速度要比Hadoop的MapReduce快上100倍以上,基于磁盘的计算速度也快于10倍以上。Spark运行在Hadoop第二代的yarn集群管理之上,可以轻松读取Hadoop的任何数据。能够读取HBase、HDFS等Hadoop的数据源。 从Spark 1.0版本起,Spark开始支持Spark SQL,它最主要的用途之一就是能够直接从Spark平台上面获取数据。并且Spark SQL提供比较流行的Parquet列式存储格式以及从Hive表中直接读取数据的支持。之后,Spark SQL还增加了对JSON等其他格式的支持。到了Spark 1.3 版本Spark还可以使用SQL的方式进行DataFrames的操作。我们通过JDBC的方式通过前台业务逻辑执行相关sql的增删改查,通过远程连接linux对文件进行导入处理,使项目能够初步支持Spark平台,现如今已支持Spark1.4版本。 SparkSQL具有内置的SQL扩展的基类实现Catalyst,提供了提供了解析(一个非常简单的用Scala语言编写的SQL解析器)、执行(Spark Planner,生成基于RDD的物理计划)和绑定(数据完全存放于内存中)。 前台我们使用ThriftServer连接后台SparkSQL,它是一个JDBC/ODBC接口,通过配置Hive-site.xml,就可以使前台用JDBC/ODBC连接ThriftServer来访问SparkSQL的数据。ThriftServer通过调用hive元数据信息找到表或文件信息在hdfs上的具体位置,并通过Spark的RDD实现了hive的接口。对于标签、客户群探索的增、删、改、查都是通过SparkSQL对HDFS上存储的相应表文件进行操作,突破了传统数据库的瓶颈,同时为以后的客户群智能分析作了铺垫。 1.数据的存储格式 我们使用Parquet面向列存存储的文件存储结构,因为Parquet具有高压缩比的特点且适合嵌套数据类型的存储,能够避免不必要的IO性能。Parquet建表如下所示: CREATE TABLE dw_coclbl_d01_20140512_lzo_256_parquet(op_time string, join_id double, city_id int, product_no string, brand_id int, vip_level int, county_id int, l2_01_01_04 double, l2_01_01_04_01 double) ROW FORMAT SERDE 'parquet.hive.serde.ParquetHiveSerDe'STORED AS INPUTFORMAT 'parquet.hive.DeprecatedParquetInputFormat' OUTPUTFORMAT 'parquet.hive.DeprecatedParquetOutputFormat'; 2、由于压缩文件占用的空间较少,文件load的速度比较快。故使用压缩文件进行数据的load.使用gzip进行压缩时,单个文件只能在一个节点上进行load,加载时间很长。使用split命令将解压后的csv文件分割成多个256M的小文件,机器上每个block块的大小为128M,故将小文件分割为128M或256M以保证效率。由于Parquet存储格式暂时只支持Gzip,项目中暂时使用Gzip压缩格式。通过在控制台输入set mapreduce.output.fileoutputformat.compress=true指令命令设置压缩格式为true。再执行set mapreduce.output. fileoutput format.compress.codec =org.apache.hadoop.io.compress.GzipCodec;将文件的压缩格式设置为Gzip压缩格式 3、数据的导入。使用的是Apache的一个项目,最早作为Hadoop的一个第三方模块存在,主要功能是在Hadoop(hive)与传统的数据库(mysql、oracle等)间进行数据的传递,可以将一个关系型数据库中的数据导入到Hadoop的HDFS中,也可以将HDFS的数据导进到关系数据库中。 由于执行sqoop导入需要通过yarn的任务调度进行mapreduce,由于spark开启后即便在空闲状态下也不释放内存,故修改spark-env.sh配置,分配多余内存以便sqoop执行。 Create job -f 3 -t 4 Creating job for links with from id 3 and to id 4 Please fill following values to create new job object Name: Sqoopy From database configuration Schema name: hive Table name: TBLS Table SQL statement: Table column names: Partition column name: Null value allowed for the partition column: Boundary query: ToJob configuration Output format: 0 : TEXT_FILE 1 : SEQUENCE_FILE Choose: 0 Compression format: successfully created with validation status OK and persistent id 2 0 : NONE 1 : DEFAULT 2 : DEFLATE 3 : GZIP 4 : BZIP2 5 : LZO 6 : LZ4 7 : SNAPPY 8 : CUSTOM Choose: 0 Custom compression format: Output directory: hdfs://hadoop000:8020/sqoop2 Throttling resources Extractors: Loaders: New job was 4、前台与后台交互工具类 工具类提供静态的方法,可以进行相应业务逻辑的调用,由于Hadoop集群存在于服务器端,前台需要实现跨平台服务器的连接,才能执行相应的Hadoop命令,实现对HDFS上文件的操作。此次设计的ShellUtils类,通过jsch连接Linux服务器执行shell命令. private static JSch jsch; private static Session session; public static void connect(String user, String passwd, String host) throws JSchException { jsch = new JSch(); session = jsch.getSession(user, host,22); session.setPassword(passwd); java.util.Properties config = new java.util.Properties(); config.put("StrictHostKeyChecking", "no"); session.setConfig(config); 通过传入的Linux命令、用户名、密码等参数对远程linux服务器进行连接。由于执行Hadoop命令根据不同文件的大小所需占用的时间是不同的,在hadoop尚未将文件完全从hdfs上合并到本地时,本地会提前生成文件但文件内容为空,至此这里需要多传入前台客户群探索出来的客户群数目与文件条数进行对比,倘若数目相同则说明执行完毕。 CodecUtil类,用来实现不同类型压缩文件的解压工作,通过传入的压缩类型,利用反射机制锁定压缩的类型,由于存储在hdfs上的文件都是以文件块的形式存在的,所以首先需要获取hdfs中文件的二级子目录,遍历查询到每一个文件块的文件路径,随后通过输入输出流进行文件的解压工作。然后将此类打包成jar包放入集群中,通过前台远程连接服务端,执行hadoop命令操作执行,实现类部分代码如下: public class CodecUtil{ public static void main(String[] args) throws Exception { //compress("org.apache.hadoop.io.compress.GzipCodec"); String listName = args[0]; String codecType = args[1]; String hdfsPath = args[2]; uncompress(listName,codecType,hdfsPath); //解压缩 public static void uncompress(String listName,String CodecType,String hdfsPath) throws Exception{ Class<?> codecClass = Class.forName(CodecType); Configuration conf = new Configuration(); FileSystem fs = FileSystem.get(conf); Path listf =new Path(hdfsPath+listName); //获取根目录下的所有2级子文件目录 FileStatus stats[]=fs.listStatus(listf); CompressionCodec codec = (CompressionCodec) ReflectionUtils.newInstance(codecClass, conf); int i; for ( i = 0; i < stats.length; i++){ //获得子文件块的文件路径 String Random = findRandom(); Path list = new Path(stats[i].getPath().toString()); InputStream in = codec.createInputStream(inputStream); FSDataOutputStream output = fs.create(new Path(hdfsPath + listName+"/"+unListName)); IOUtils.copyBytes(in, output, conf); IOUtils.closeStream(in); } } } 5、导入生成客户群 由于sparksql不支持insert into value语句,无法通过jdbc方式连接后台HDFS通过sparksql对文件进行导入数据的操作。于是将需要导入的csv文件通过ftp方式上传到远程服务器,再将文件通过load的方式导入表中,实现导入生成客户群的功能。 // 将文件上传到ftp服务器 CiFtpInfo ftp = customFileRelService.getCiFtpInfoByFtpType(1); FtpUtil.ftp(ftp.getFtpServerIp(),ftp.getFtpPort(),ftp.getFtpUser(),DES.decrypt (ftp.getFtpPwd()), ftpFileName, ftp.getFtpPath()); // 将文件load到表中 String ftpPath = ftp.getFtpPath(); if (!ftpPath.endsWith("/")) { ftpPath = ftpPath + "/"; } String sql = " LOAD DATA LOCAL INPATH '" + ftpPath + fileName + "' OVERWRITE INTO TABLE " + tabName; log.info("loadSql=" + sql); customersService.executeInBackDataBase(sql); log.info("load table=" + tabName + " successful"); 6、数据表或文件下载的实现 由于存储在hdfs上的数据为Gzip压缩格式,首先通过执行事先编好的解压代码对文件块进行解压,这里需要传入需要解压的文件名、解压类型、hdfs的完全路径,解压完毕后通过执行hadoop文件合并命令将文件从hdfs上合并到本地服务器,合并完毕后由于解压缩后的文件会占用hdfs的空间,同时执行hadoop文件删除命令将解压后的文件删除,再通过ftp传到前台服务器,完成客户群清单下载。 String command = "cd " + ftpPath + ";" + hadoopPath + "hadoop jar "+hadoopPath+"CodecTable.jar " + listRandomName +" "+ CodecType +" " + " "+ hdfsWholePath + ";" + hadoopPath + "hadoop fs -cat '" + hdfsPath + listRandomName + "/*'>" + listName1+".csv;" + hadoopPath +"hadoop fs -rm -r " + hdfsPath + listRandomName + ";" + "wc -l " + listName1 +".csv;"; LOG.debug(command); flag = ShellUtils.execCmd(command, user, passwd, host,num); 清单的推送也是通过文件合并传输的方式进行其他平台的推送,大大降低了读取数据插入表数据所消耗的时间。

优秀的个人博客,低调大师

进程绑定CPU简单应用

注:原发表在Hadoop技术论坛 相关函数:sched_setaffinity, sched_getaffinity,CPU_CLR, CPU_ISSET, CPU_SET, CPU_ZERO- set and get a process's CPU affinity mask大写数实际为宏,进行位操作的宏。 #define _GNU_SOURCE #include int sched_setaffinity(pid_t pid, unsigned int cpusetsize, cpu_set_t *mask); int sched_getaffinity(pid_t pid, unsigned int cpusetsize, cpu_set_t *mask); void CPU_CLR(int cpu, cpu_set_t *set); int CPU_ISSET(int cpu, cpu_set_t *set); void CPU_SET(int cpu, cpu_set_t *set); void CPU_ZERO(cpu_set_t *set);CPU_ZERO(&mask);CPU_SET(cpu_id, &mask);sched_setaffinity(pid, sizeof(mask), &mask);

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册