首页 文章 精选 留言 我的

精选列表

搜索[作者要求],共10000篇文章
优秀的个人博客,低调大师

Sysinternals 作者:是时候停用 C/C++ 开发新项目并使用 Rust 了

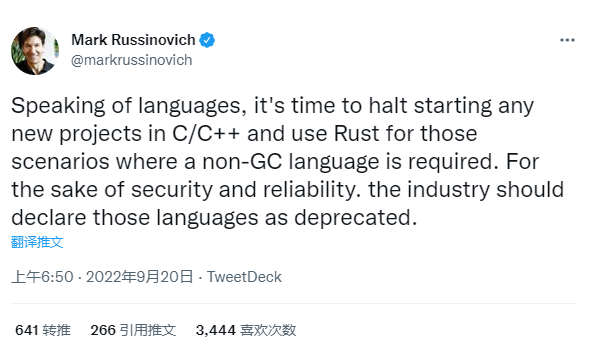
MicrosoftAzure CTO、Sysinternals 的主要开发者Mark Russinovich 在其社交账号上发布动态称,开发人员是时候停止使用 C/C++ 来启动新项目,并建议可在需要使用non-GC 语言的场景中使用 Rust。 “说到语言,现在是时候停止用 C/C++ 启动任何新项目了,并在那些需要使用 non-GC 语言的场景中使用 Rust。为了安全性和可靠性,业界应该宣布弃用这些语言。” 此言论一出,不可避免的引起了广泛地讨论。有人问这是他个人的观点,还是作为 CTO 的一个声明。.NET Foundation 成员 Shawn Wildermuth 则在评论区提出疑问,Rust 是否有足够的开发人员来推动工作的进行?对此则有开发者回复称,“想要舍下 C/C++ 确实非常困难,但这并不重要;年轻的开发者可以很快掌握 Rust,相较试图寻找有才华的 C/C++ 开发者,此举要容易得多”。 还有评论表示: George Ou:我是 Rust 的忠实粉丝,但对于那些认为有安全版本的 C 和 C++ 的人,你怎么说? Ted Mielczarek:要么他们在骗你,要么他们建议的东西需要有效地重写你的整个代码库,所以你最好使用 Rust。 而在反对的声音当中,一个ID 为ionCube24的用户称,Mark Russinovich的意思更像是在责怪语言而不是程序员。但事实是“C++ 很好,只是很多使用它(和其他语言)的人基本上不知道如何编程;切换语言并不会解决这一问题。” 有人以自身实践举例表明,Rust 存在局限性,并不能解决他所有的问题。然而该网友的论点似乎有点站不住脚: “它不必解决所有问题才能产生重大影响。” “为什么要以 ‘解决所有的问题’ 为标准,它是否需要 '解决你所有的问题' 才能在编程中产生实质性的差异?在我看来,想要 '在所有新项目中使用它' 这个标准远比让 '它能解决所有已知问题' 要低得多。” 还有人则颇为“痛心”的感叹Mark Russinovich 变了,不再“cool”了。也有相对理智的发声称,“或者更好的方式是:不要再过度的去宣传推广一种编程语言。不同的工具适合不同的问题。Rust 很好,但它不是所有编程问题的解决方案”。 更有甚者提出了自己认为更好的C/C++ 替代方案,“当 GCed 系统语言可以接受时,也不会再有新的 C/C++ 项目。 Go、Nim 和 Crystal 都是比 C/C++ 更好的选择。还有 Zig,它正在做一些很酷的事情,但尚未像 Rust 那样成熟或流行。” 目前,Hacker News和Reddit上也有相关的话题讨论。 Rust 最近确实有着较高的热度: Linus Torvalds 透露,没有意外的话Rust将在6.1 版本进入 Linux 内核 Cloudflare 放弃 Nginx,使用内部 Rust 编写的 Pingora GStreamer 准备将 Rust 编写的插件作为其官方二进制版本的一部分发布 Rust 成立专门的安全团队 Asahi Linux 计划使用 Rust 编写 Apple 芯片的 GPU 驱动程序 GCC Rust 得到 GCC 批准,将被纳入主线代码库

优秀的个人博客,低调大师

Magisk 创作者吴泓霖加入 Google,任职于 Android 安全团队

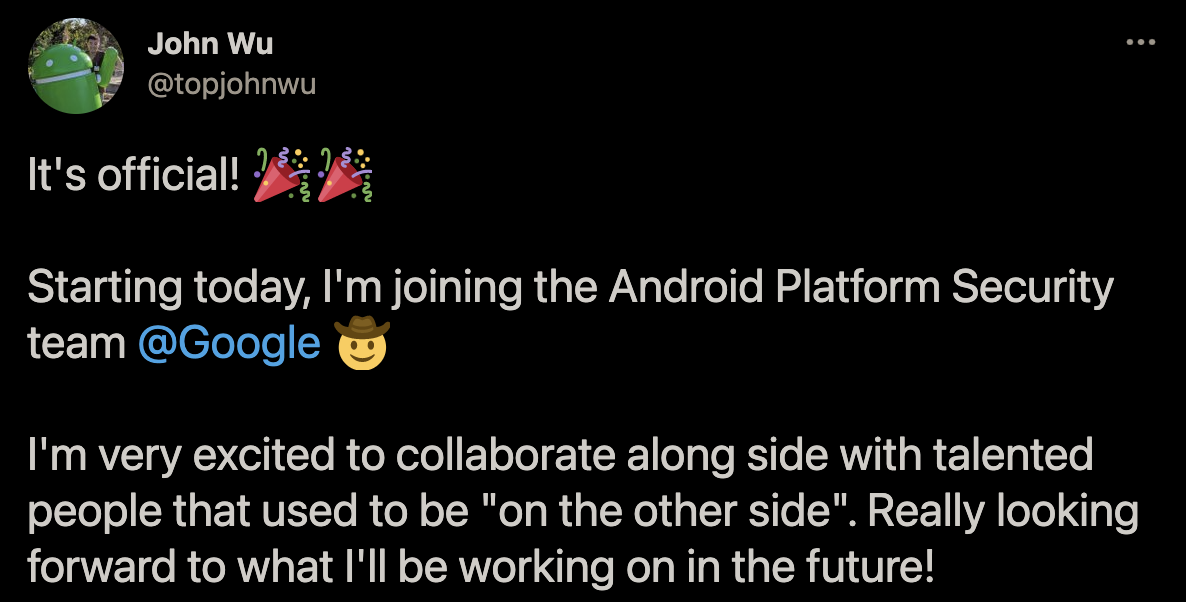
熟悉 Android 系统的用户都知道,要想获取系统的最高权限就需要对系统进行 root。如果你在过去几年里对 Android 手机进行了 root 并用来实现一些原本系统所不具备的功能,那么你一定听说过 Magisk 这款工具。今天,Magisk 的开发者吴泓霖(John Wu)宣布,他将加入 Google 的 Android 安全团队。 Magisk 是吴泓霖在 2016 年所开发的,作为一个工具,供已 root 的 Android 用户在 Google SafetyNet 的使用不断增加的情况下继续正常使用他们的设备。有了 Magisk,具有 root 权限的用户仍然可以访问那些受保护的应用程序(例如 Google Pay),而不会丧失 root Android 手机带来的额外功能和灵活性。 吴泓霖在 Twitter 上宣布了这一消息,目前尚不清楚他在团队中的确切职位。 Magisk 上周刚刚发布了第 23 版,并具有多项更新。至于这一职位上的变动,对 Magisk 的未来意味着什么,目前尚不清楚。我们也会持续关注这一事件的发展。

优秀的个人博客,低调大师

每日一博 | Flask 作者 Armin Ronacher:我不觉得有异步压力

英文 | I'm not feeling the async pressure【1】 原作 | Armin Ronacher,2020.01.01 译者 | 豌豆花下猫@Python猫 声明 :本翻译基于CC BY-NC-SA 4.0【2】授权协议,内容略有改动,转载请保留原文出处,请勿用于商业或非法用途。 异步(async)正风靡一时。异步Python、异步Rust、go、node、.NET,任选一个你最爱的语言生态,它都在使用着一些异步。异步这东西有多好,这在很大程度上取决于语言的生态及其运行时间,但总体而言,它有一些不错的好处。它使得这种事情变得非常简单:等待可能需要一些时间才能完成的操作。 它是如此简单,以至于创造了无数新的方法来坑人(blow ones foot off)。我想讨论的一种情况是,直到系统出现超载,你才意识到自己踩到了脚的那一种,这就是背压(back pressure)管理的主题。在协议设计中有一个相关术语是流量控制(flow control)。 什么是背压 关于背压的解释有很多,我推荐阅读的一个很好的解释是:Backpressure explained — the resisted flow of data through software【3】。因此,与其详细介绍什么是背压,我只想对其做一个非常简短的定义和解释:背压是阻碍数据在系统中流通的阻力。背压听起来很负面——谁都会想象浴缸因管道堵塞而溢出——但这是为了节省你的时间。 (译注:back pressure,除了背压,还有人译为“回压”、“反压”) 在这里,我们要处理的东西在所有情况下或多或少都是相同的:我们有一个系统将不同组件组合成一个管道,而该管道需要接收一定数量的传入消息。 你可以想象这就像在机场模拟行李运送一样。行李到达,经过分类,装入飞机,最后卸下。在这过程中,一件行李要跟其它行李一起,被扔进集装箱进行运输。当一个集装箱装满后,需要将其运走。当没有剩余的集装箱时,这就是背压的自然示例。现在,放行李者不能放了,因为没有集装箱。 此时必须做出决定。一种选择是等待:这通常被称为排队(queueing )或缓冲(buffering)。另一种选择是扔掉一些行李,直到有一个集装箱到达为止——这被称为丢弃(dropping)。这听起来很糟糕,但是稍后我们将探讨为什么有时很重要。 但是,这里还有另一件事。想象一下,负责将行李放入集装箱的人在较长的时间内(例如一周)都没等到集装箱。最终,如果他们没有丢弃行李,那么他们周围将有数量庞大的行李。最终,他们被迫要整理的行李数量太多,用光了存储行李的物理空间。到那时,他们最好是告诉机场,在解决好集装箱问题之前,不能再接收新的行李了。这通常被称为流量控制【4】,是一个至关重要的网络概念。 通常这些处理管道在每段时间内只能容纳一定数量的消息(如本例中的行李箱)。如果数量超过了它,或者更糟糕的是管道停滞,则可能发生可怕的事情。现实世界中的一个例子是伦敦希思罗机场 5 号航站楼开放,由于其 IT 基础架构无法正常运行,在 10 天内未能完成运送 42,000 件行李。他们不得不取消 500 多个航班,并且有一段时间,航空公司决定只允许随身携带行李。 背压很重要 我们从希思罗灾难中学到的是,能够交流背压至关重要。在现实生活中以及在计算中,时间总是有限的。最终人们会放弃等待某些事情。特别是即使某些事物在内部可以永远等待,但在外部却不能。 举一个现实的例子:如果你的行李需通过伦敦希思罗机场到达目的地巴黎,但是你只能在那呆 7 天,那么如果行李延迟成 10 天到达,这就毫无意义了。实际上,你希望将行李重新路由(re-routed)回你的家乡机场。 实际上,承认失败(你超负载了)比假装可运作并持续保持缓冲状态要好,因为到了某个时候,它只会令情况变得更糟。 那么,为什么在我们编写了多年的基于线程的软件时,背压都没有被提出,现在却突然成为讨论的话题呢?有诸多因素的结合,其中一些因素很容易使人陷入困境。 糟糕的默认方式 为了理解为什么背压在异步代码中很重要,我想为你提供一段看似简单的 Python asyncio 代码,它展示了一些我们不慎忘记了背压的情况: from asyncio import start_server, run async def on_client_connected(reader, writer): while True: data = await reader.readline() if not data: break writer.write(data) async def server(): srv = await start_server(on_client_connected, '127.0.0.1', 8888) async with srv: await srv.serve_forever() run(server()) 如果你刚接触 async/await 概念,请想象一下在调用 await 的时候,函数会挂起,直到表达式解析完毕。在这里,Python 的 asyncio 库提供的 start_server 函数会运行一个隐藏的 accept 循环。它侦听套接字,并为每个连接的套接字生成一个独立的任务运行着 on_client_connected 函数。 现在,这看起来非常简单明了。你可以删除所有的 await 和 async 关键字,最终的代码看起来与使用线程方式编写的代码非常相似。 但是,它隐藏了一个非常关键的问题,这是我们所有问题的根源:在某些函数调用的前面没有 await。在线程代码中,任何函数都可以 yield。在异步代码中,只有异步函数可以。在本例中,这意味着 writer.write 方法无法阻塞。那么它是如何工作的呢?它将尝试将数据直接写入到操作系统的无阻塞套接字缓冲区中。 但是,如果缓冲区已满并且套接字会阻塞,会发生什么?在用线程的情况下,我们可以在此处将其阻塞,这很理想,因为这意味着我们正在施加一些背压。然而,因为这里没有线程,所以我们不能这样做。因此,我们只能在此处进行缓冲或者删除数据。因为删除数据是非常糟糕的,所以 Python 选择了缓冲。 现在,如果有人向其中发送了很多数据却没有读取,会发生什么?好了在那种情况下,缓冲区会增大,增大,再增大。这个 API 缺陷就是为什么 Python 的文档中说,不要只是单独使用 write,还要接着写 drain(译注:消耗、排水): writer.write(data) await writer.drain() drain 会排出缓冲区上多余的东西。它不会排空整个缓冲区,只会做到令事情不致失控的程度。那么为什么 write 不做隐式 drain 呢?好吧,这会是一个大规模的 API 监控,我不确定该如何做到。 这里非常重要的是大多数套接字都基于 TCP,而 TCP 具有内置的流量控制。writer 只会按照 reader 可接受的速度写入(给予或占用一些缓冲空间)。这对开发者完全是隐藏的,因为甚至 BSD 套接字库都没有公开这种隐式的流量控制操作。 那我们在这里解决背压问题了吗?好吧,让我们看一看在线程世界中会是怎样。在线程世界中,我们的代码很可能会运行固定数量的线程,而 accept 循环会一直等待,直到线程变得可用再接管请求。 然而,在我们的异步示例中,有无数的连接要处理。这就意味着我们可能收到大量连接,即使这意味着系统可能会过载。在这个非常简单的示例中,可能不成问题,但请想象一下,如果我们做的是数据库访问,会发生什么。 想象一个数据库连接池,它最多提供 50 个连接。当大多数连接会在连接池处阻塞时,接受 10000 个连接又有什么用? 等待与等待着等待 好啦,终于回到了我最初想讨论的地方。在大多数异步系统中,特别是我在 Python 中遇到的大多数情况中,即使你修复了所有套接字层的缓冲行为,也最终会陷入一个将一堆异步函数链接在一起,而不考虑背压的世界。 如果我们以数据库连接池为例,假设只有 50 个可用连接。这意味着我们的代码最多可以有 50 个并发的数据库会话。假设我们希望处理 4 倍多的请求,因为我们期望应用程序执行的许多操作是独立于数据库的。一种解决方法是制作一个带有 200 个令牌的信号量(semaphore),并在开始时获取一个。如果我们用完了令牌,就需等待信号量发放令牌。 但是等一下。现在我们又变成了排队!我们只是在更前面排。如果令系统严重超负荷,那么我们会从一开始就一直在排队。因此,现在每个人都将等待他们愿意等待的最大时间,然后放弃。更糟糕的是:服务器可能仍会花一段时间处理这些请求,直到它意识到客户端已消失,而且不再对响应感兴趣。 因此,与其一直等待下去,我们更希望立即获得反馈。想象你在一个邮局,并且正在从机器上取票,票上会说什么时候轮到你。这张票很好地表明了你需要等待多长时间。如果等待时间太长,你会决定弃票走人,以后再来。请注意,你在邮局里的排队等待时间,与实际处理你的请求的时间无关(例如,因为有人需要提取包裹,检查文件并采集签名)。 因此,这是天真的版本,我们只知道自己在等待: from asyncio.sync import Semaphore semaphore = Semaphore(200) async def handle_request(request): await semaphore.acquire() try: return generate_response(request) finally: semaphore.release() 对于 handle_request 异步函数的调用者,我们只能看到我们正在等待并且什么都没有发生。我们看不到是因为过载而在等待,还是因为生成响应需花费很长时间而在等待。基本上,我们一直在这里缓冲,直到服务器最终耗尽内存并崩溃。 这是因为我们没有关于背压的沟通渠道。那么我们将如何解决呢?一种选择是添加一个中间层。现在不幸的是,这里的 asyncio 信号量没有用,因为它只会让我们等待。但是假设我们可以询问信号量还剩下多少个令牌,那么我们可以执行类似这样的操作: from hypothetical_asyncio.sync import Semaphore, Service semaphore = Semaphore(200) class RequestHandlerService(Service): async def handle(self, request): await semaphore.acquire() try: return generate_response(request) finally: semaphore.release() @property def is_ready(self): return semaphore.tokens_available() 现在,我们对系统做了一些更改。现在,我们有一个 RequestHandlerService,其中包含了更多信息。特别是它具有了准备就绪的概念。该服务可以被询问是否准备就绪。该操作在本质上是无阻塞的,并且是最佳估量。 现在,调用者会将这个: response = await handle_request(request) 变成这个: request_handler = RequestHandlerService() if not request_handler.is_ready: response = Response(status_code=503) else: response = await request_handler.handle(request) 有多种方法可以完成,但是思想是一样的。在我们真正着手做某件事之前,我们有一种方法来弄清楚成功的可能性,如果我们超负荷了,我们将向上沟通。 现在,我没有想到如何给这种服务下定义。其设计来自 Rust 的tower【5】和 Rust 的actix-service【6】。两者对服务特征的定义都跟它非常相似。 现在,由于它是如此的 racy,因此仍有可能堆积信号量。现在,你可以冒这种风险,或者还是在 handle 被调用时就抛出失败。 一个比 asyncio 更好地解决此问题的库是 trio,它会在信号量上暴露内部计数器,并提供一个 CapacityLimiter,它是对容量限制做了优化的信号量,可以防止一些常见的陷阱。 数据流和协议 现在,上面的示例为我们解决了 RPC 样式的情况。对于每次调用,如果系统过载了,我们会尽早得知。许多协议都有非常直接的方式来传达“服务器正在加载”的信息。例如,在 HTTP 中,你可以发出 503,并在 header 中携带一个 retry-after 字段,它会告知客户端何时可以重试。在下次重试时会添加一个重新评估的自然点,判断是否要使用相同的请求重试,或者更改某些内容。例如,如果你无法在 15 秒内重试,那么最好向用户显示这种无能,而不是显示一个无休止的加载图标。 但是,请求/响应(request/response)式的协议并不是唯一的协议。许多协议都打开了持久连接,让你传输大量的数据。在传统上,这些协议中有很多是基于 TCP 的,如前所述,它具有内置的流量控制。但是,此流量控制并没有真正通过套接字库公开,这就是为什么高级协议通常需要向其添加自己的流量控制的原因。例如,在 HTTP2 中,就存在一个自定义流量控制协议,因为 HTTP2 在单个 TCP 连接上,多路复用多个独立的数据流(streams)。 因为 TCP 在后台对流量控制进行静默式管理,这可能会使开发人员陷入一条危险的道路,他们只知从套接字中读取字节,并误以为这是所有该知道的信息。但是,TCP API 具有误导性,因为从 API 角度来看,流量控制对用户完全是隐藏的。当你设计自己的基于数据流的协议时,你需要绝对确保存在双向通信通道,即发送方不仅要发送,还要读取,以查看是否允许它们继续发。 对于数据流,关注点通常是不同的。许多数据流只是字节或数据帧的流,你不能仅在它们之间丢弃数据包。更糟糕的是:发送方通常不容易察觉到它们是否应该放慢速度。在 HTTP2 中,你需要在用户级别上不断交错地读写。你必然要在那里处理流量控制。当你在写并且被允许写入时,服务器将向你发送 WINDOW_UPDATE 帧。 这意味着数据流代码变得更为复杂,因为你首先需要编写一个可以对传入流量作控制的框架。例如,hyper-h2【7】Python 库具有令人惊讶的复杂的文件上传服务器示例,【8】该示例基于 curio 的流量控制,但是还未完成。 新步枪 async/await 很棒,但是它所鼓励编写的内容在过载时会导致灾难。一方面是因为它如此容易就排队,但同时因为在使函数变异步后,会造成 API 损坏。我只能假设这就是为什么 Python 在数据流 writer 上仍然使用不可等待的 write 函数。 不过,最大的原因是 async/await 使你可以编写许多人最初无法用线程编写的代码。我认为这是一件好事,因为它降低了实际编写大型系统的障碍。其缺点是,这也意味着许多以前对分布式系统缺乏经验的开发人员现在即使只编写一个程序,也遇到了分布式系统的许多问题。由于多路复用的性质,HTTP2 是一种非常复杂的协议,唯一合理的实现方法是基于 async/await 的例子。 遇到这些问题的不仅是 async/await 代码。例如,Dask【9】是数据科学程序员使用的 Python 并行库,尽管没有使用 async/await,但由于缺乏背压,【10】仍有一些 bug 报告提示系统内存不足。但是这些问题是相当根本的。 然而,背压的缺失是一种具有火箭筒大小的步枪。如果你太晚意识到自己构建了个怪物,那么在不对代码库进行重大更改的情况下,几乎不可能修复它,因为你可能忘了在某些本应使用异步的函数上使用异步。 其它的编程环境对此也无济于事。人们在所有编程环境中都遇到了同样的问题,包括最新版本的 go 和 Rust。即使在长期开源的非常受欢迎的项目中,找到有关“处理流程控制”或“处理背压”的开放问题(open issue)也并非罕见,因为事实证明,事后添加这一点确实很困难。例如,go 从 2014 年起就存在一个开放问题,关于给所有文件系统IO添加信号量,【11】因为它可能会使主机超载。aiohttp 有一个问题可追溯到2016年,【12】关于客户端由于背压不足而导致破坏服务器。还有很多很多的例子。 如果你查看 Python 的 hyper-h2文档,将会看到大量令人震惊的示例,其中包含类似“不处理流量控制”、“它不遵守 HTTP/2 流量控制,这是一个缺陷,但在其它方面是没问题的“,等等。在流量控制一出现的时候,我就认为它非常复杂。很容易假装这不是个问题,这就是为什么我们会处于这种混乱状态的根本原因。流量控制还会增加大量开销,并且在基准测试中效果不佳。 那么,对于你们这些异步库开发人员,这里给你们一个新年的解决方案:在文档和 API 中,赋予背压和流量控制其应得的重视。 相关链接 [1]I'm not feeling the async pressure:https://lucumr.pocoo.org/2020/1/1/async-pressure/ [2]CC BY-NC-SA 4.0:https://creativecommons.org/licenses/by-nc-sa/4.0/ [3]Backpressure explained — the resisted flow of data through software:https://medium.com/@jayphelps/backpressure-explained-the-flow-of-data-through-software-2350b3e77ce7 [4]流量控制:https://en.wikipedia.org/wiki/Flow_control_(data) [5]tower:https://github.com/tower-rs/tower [6]actix-service:https://docs.rs/actix-service/ [7]hyper-h2:https://github.com/python-hyper/hyper-h2 [8]文件上传服务器示例:https://python-hyper.org/projects/h2/en/stable/curio-example.html [9]Dask:https://dask.org/ [10]背压:https://github.com/dask/distributed/issues/2602 [11]关于给所有文件系统IO添加信号量:https://github.com/golang/go/issues/7903 [12]有一个问题可追溯到2016年,:https://github.com/aio-libs/aiohttp/issues/1368 公众号【Python猫】, 本号连载优质的系列文章,有喵星哲学猫系列、Python进阶系列、好书推荐系列、技术写作、优质英文推荐与翻译等等,欢迎关注哦。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册