首页 文章 精选 留言 我的

精选列表

搜索[云端运行],共10000篇文章
优秀的个人博客,低调大师

Docker创建运行多个mysql容器

1.使用mysql/mysql-server:latest镜像快速启动一个Mysql实例 docker run --name ilink_user_01 -e MYSQL_ROOT_PASSWORD=123456 0d 0p 3307:3306 mysql/mysql-server:latest ilink_user_01是容器名称,通过--name指令指定 123456为数据库root的密码,通过-e指定环境MYSQL_ROOT_PASSWORD为123456,-e (指定容器内的环境变量) -d 使用-d参数,容器会进入到后台,用户无法看到容器中的信息,也无法进行操作 3307:3306 为端口映射,指定本地主机端口3307映射到容器的3306端口 2.进入实例修改mysql配置信息 docker exec -it ilink_user_01 bash exec 可以在容器内部直接执行人员命令 参数 -it 用来保存表中输入的打开,在不影响容器内其他应用的潜艇先,用户可以很容易的与容器进行交互 3.查看MYSQL数据库中所有用户 SELECT DISTINCT CONCAT('User: ''',user,'''@''',host,''';') AS query FROM mysql.user; 4.修改mysql的root用户允许从任何ip登录用户 update mysql.user set host='%' where user='root'; flush privileges; 5.使用navicat测试连接 出现authentication plugin 'caching_sha2_password',因为mysql镜像是使用caching_sha2_password进行加密的,而navicat没有支持caching_sha2_password加密方式, 6.解决authentication plugin 'caching_sha2_password' ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY '123456'; 7.重新使用navicat 连接 博客内容仅代表个人观点,如发现阐述有误,麻烦指正,谢谢!

优秀的个人博客,低调大师

MySQL运行原理与基础架构!

下面是关于上述部件的介绍: connectors 与其他编程语言中的sql 语句进行交互,如php、java等。 Management Serveices & Utilities系统管理和控制工具 Connection Pool (连接池)管理缓冲用户连接,线程处理等需要缓存的需求 SQL Interface (SQL接口)接受用户的SQL命令,并且返回用户需要查询的结果。比如select from就是调用SQL Interface Parser (解析器)SQL命令传递到解析器的时候会被解析器验证和解析。 主要功能: a . 将SQL语句分解成数据结构,并将这个结构传递到后续步骤,后面SQL语句的传递和处理就是基于这个结构的 如果在分解构成中遇到错误,那么就说明这个sql语句是不合理的,语句将不会继续执行下去 Optimizer (查询优化器)SQL语句在查询之前会使用查询优化器对查询进行优化(产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果) 他使用的是“选取-投影-联接”策略进行查询。 用一个例子就可以理解: select uid,name from user where gender = 1; 这个select 查询先根据where 语句进行选取,而不是先将表全部查询出来以后再进行gender过滤 这个select查询先根据uid和name进行属性投影,而不是将属性全部取出以后再进行过滤 将这两个查询条件联接起来生成最终查询结果. Cache和Buffer (查询缓存)如果查询缓存有命中的查询结果,查询语句就可以直接去查询缓存中取数据。 这个缓存机制是由一系列小缓存组成的。比如表缓存,记录缓存,key缓存,权限缓存等 8.Engine (存储引擎) 存储引擎是MySql中具体的与文件打交道的子系统。也是Mysql最具有特色的一个地方。 Mysql的存储引擎是插件式的。它根据MySql AB公司提供的文件访问层的一个抽象接口来定制一种文件访问机制(这种访问机制就叫存储引擎) SQL 语句执行过程 数据库通常不会被直接使用,而是由其他编程语言通过SQL语句调用mysql,由mysql处理并返回执行结果。那么Mysql接受到SQL语句后,又是如何处理的呢? 首先程序的请求会通过mysql的connectors与其进行交互,请求到处后,会暂时存放在连接池(connection pool)中并由处理器(Management Serveices & Utilities)管理。当该请求从等待队列进入到处理队列,管理器会将该请求丢给SQL接口(SQL Interface)。SQL接口接收到请求后,它会将请求进行hash处理并与缓存中的结果进行对比,如果完全匹配则通过缓存直接返回处理结果;否则,需要完整的走一趟流程: (1)由SQL接口丢给后面的解释器(Parser),上面已经说到,解释器会判断SQL语句正确与否,若正确则将其转化为数据结构。 (2)解释器处理完,便来到后面的优化器(Optimizer),它会产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果。 (3)确定最优执行计划后,SQL语句此时便可以交由存储引擎(Engine)处理,存储引擎将会到后端的存储设备中取得相应的数据,并原路返回给程序。 这里有几点需要注意: (1)如何缓存查询数据? 存储引擎处理完数据,并将其返回给程序的同时,它还会将一份数据保留在缓存中,以便更快速的处理下一次相同的请求。具体情况是,mysql会将查询的语句、执行结果等进行hash,并保留在cache中,等待下次查询。 (2)buffer与cache的区别? 从上面的图可以看到,缓存那里实际上有buffer和cache两个,那它们之间是否有什么不同呢?简单的说就是,buffer是写缓存,cache是读缓存。 (3)如何判断缓存中是否已缓存需要的数据 这里可能有一个误区,觉得处理SQL语句的时候,为了判断是否已缓存查询结果,会将整个流程走一遍,取得执行结果后再与需要的进行对比,看看是否命中,并以此说,既然不管缓存中有没有缓存到查询内容,都要整个流程走一遍,那么缓存的优势又在哪里?? 实际上,并非如此,在第一次查询后,mysql便将查询语句以及查询结果进行hash处理并保留在缓存中,SQL查询到达之后,对其进行同样的hash处理后,将两个hash值进行对照,如果一样,则命中,从缓存中返回查询结果;否则,需要整个流程走一遍。 ​

优秀的个人博客,低调大师

Docker安装+HelloWorld+运行Tomcat

前言 只有光头才能变强。 文本已收录至我的GitHub仓库,欢迎Star:https://github.com/ZhongFuCheng3y/3y 上一篇已经讲解了为什么需要Docker?,相信大家已经对Docker有一个简单的认识了。 这篇我来讲讲Docker入门的相关概念和常用的命令,跟大家一起入门Docker! 一、Docker相关术语 一般从零学习一门技术(语言),都是从HelloWorld开始的,但这次我偏不。我先来讲讲Docker的相关术语~ 镜像 容器 仓库 在之前分享的Docker科普文,也通俗易懂地讲解了这三个术语: 镜像、容器、仓库的概念可以类比代码、进程、github 如果让我来给完全不懂Docker解释这三个术语,我会这样做: 镜像就是镜像,我们重装系统/搞虚拟机的时候都要用镜像,没镜像哪来系统 我们安装完镜像,就可以跑起来一个系统(

优秀的个人博客,低调大师

关于ncnn的运行环境安装

ncnn是一个为手机端极致优化的高性能神经网络前向计算框架。 其开源代码网址为https://github.com/Tencent/ncnn 说一下我使用的环境配置: 1、操作系统:Ubuntu 16.04 2、cuda 8.0 3、Open CV 3.0 因为这些库在本地环境上安装起来即复杂又费时,所以我推荐使用docker。这样只需要找到适合的镜像文件进行docker的创建。使用docker不仅不会破坏本地的环境,还可以拥有管理员权限,适合在限制个人操作权限的公用服务器上安装。下面,我说一下我在安装过程中遇到的问题和具体的配置步骤。 Ubuntu的版本最好使用16.04。一开始,我装的是Ubuntu14.04,系统默认安装protobuf 2.5.0,然后发现因为protobuf 版本过低而报错。改成Ubuntu 16.04, 默认安装protobuf 2.6.1,错误消失。 镜像文件可以从网上下载,例如使用linux 指令下载一个名称为caffe - opencv - cuda8.0的镜像文件。 docker pull caffe - opencv - cuda8.0 可以使用指令 docker images 查看新的镜像文件是否部署完成。完成后,创建新的docker。创建的同时需要挂载目录。即在docker中可以读写本地服务器文件。例如,我们将本地/home/data目录下的所有内容挂载到docker的根目录/data下,指令为 docker run -it -v /home/data:/data --name docker_name caffe - opencv - cuda8.0 /bin/bash 也可以挂载多个目录,只需要重复使用-v。其中,docker_name 是docker 的名字,如果不进行命名,则会随机分配docker名。因为docker被创建后,会自动进入docker环境,一般显示root@docker_ID。如果需要给docker改名,可通过指令 docker rename old_name new_name 来修改。查看自己的docker,可以使用 docker ps -a 查找,-a 指所有的docker。也可以通过docker ID来寻找,通过指令 docker ps -a | grep docker_ID 即可,可以看到docker对应的name,确定是否修改成功。初次创建后用exit退出了docker,重新进入需要两条连续指令。 docker start docker_name docker attach docker_name 到这里,环境就基本配置好了。

优秀的个人博客,低调大师

在 MaxCompute UDF 中运行 Scipy

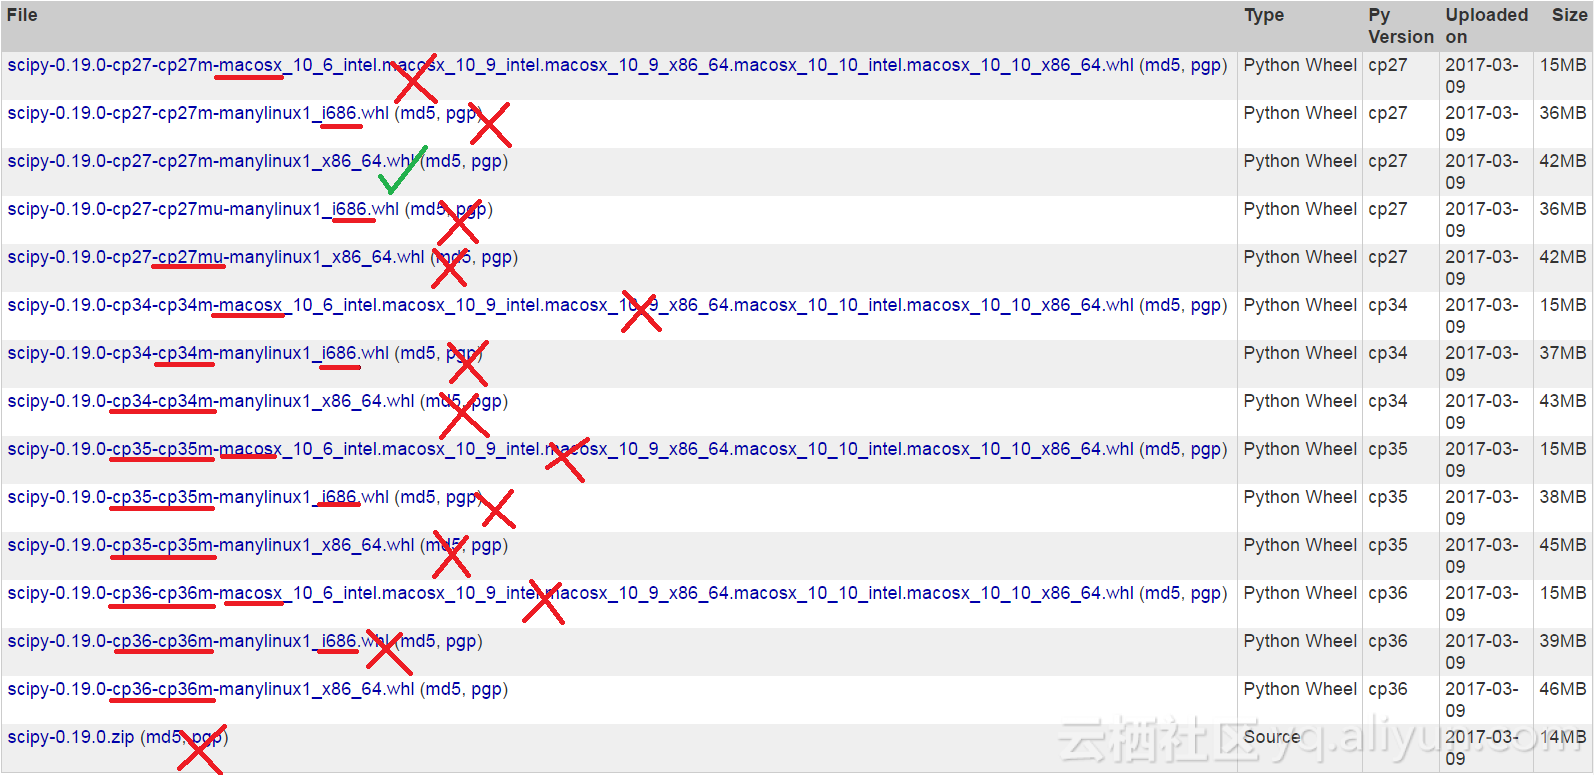
新版 MaxCompute Isolation Session 支持 Python UDF。也就是说,Python UDF 中已经可以跑二进制包。刚才以 Scipy 为例踩了一下坑,把相关的过程分享出来。 下载 Scipy 包并上传资源 首先,从 PyPI 或其他镜像下载 Scipy 包。你需要下载后缀为“cp27-cp27m-manylinux1_x86_64.whl”的包,其他的包会无法加载,包括名为“cp27-cp27mu”的包。以下的截图来自 https://pypi.python.org/pypi/scipy ,仅有打勾的包可以直接使用: 下载 whl 后,将文件名更改为 scipy.zip。此后,在 MaxCompute Console 中执行 add archive scipy.zip; 此后,scipy.zip 即被创建为

优秀的个人博客,低调大师

在docker中运行sql文件

搭建步骤 1、首先创建Dckerfile: FROMmysql:5.7#设置免密登录ENVMYSQL_ALLOW_EMPTY_PASSWORDyes#将所需文件放到容器中COPYsetup.sh/mysql/setup.sh COPYschema.sql/mysql/schema.sql COPYprivileges.sql/mysql/privileges.sql#设置容器启动时执行的命令CMD["sh","/mysql/setup.sh"] 2、编写容器启动脚本setup.sh: #!/bin/bashset-e#查看mysql服务的状态,方便调试,这条语句可以删除echo`servicemysqlstatus`echo'1.启动mysql....'#启动mysqlservicemysqlstart sleep3echo`servicemysqlstatus`echo'2.开始导入数据....'#导入数据mysql</mysql/schema.sqlecho'3.导入数据完毕....'sleep3echo`servicemysqlstatus`#重新设置mysql密码echo'4.开始修改密码....'mysql</mysql/privileges.sqlecho'5.修改密码完毕....'#sleep3echo`servicemysqlstatus`echo`mysql容器启动完毕,且数据导入成功` tail-f/dev/null 这里是先导入数据,然后才是设置用户和权限,是因为mysql容器一开始为免密登录,Dockerfile中有如下设置:ENV MYSQL_ALLOW_EMPTY_PASSWORD yes,此时执行导入数据命令不需要登录验证操作,如果是先执行权限操作,那么导入数据则需要登录验证,整个过程就麻烦了许多。 3、需要导入数据的mysql脚本命令schema.sql: --创建数据库createdatabase`docker_mysql`defaultcharactersetutf8collateutf8_general_ci;usedocker_mysql;--建表DROPTABLEIFEXISTS`user`;CREATETABLE`user`(`id`bigint(20)NOTNULL,`created_at`bigint(40)DEFAULTNULL,`last_modified`bigint(40)DEFAULTNULL,`email`varchar(255)DEFAULTNULL,`first_name`varchar(255)DEFAULTNULL,`last_name`varchar(255)DEFAULTNULL,`username`varchar(255)DEFAULTNULL, PRIMARYKEY(`id`) )ENGINE=InnoDBDEFAULTCHARSET=latin1;--插入数据INSERTINTO`user`(`id`,`created_at`,`last_modified`,`email`,`first_name`,`last_name`,`username`)VALUES (0,1490257904,1490257904,'john.doe@example.com','John','Doe','user'); 因为是测试,所以随便写了一个建表语句,如果是真实项目肯定不止这一张表,直接将建表语句覆盖过来就好。 4、mysql权限设置命令privileges.sql: usemysql;selecthost,userfromuser;--因为mysql版本是5.7,因此新建用户为如下命令:createuserdockeridentifiedby'123456';--将docker_mysql数据库的权限授权给创建的docker用户,密码为123456:grantallondocker_mysql.*todocker@'%'identifiedby'123456'withgrantoption;--这一条命令一定要有:flushprivileges; 5、创建镜像 docker build -t 13/docker-mysql . docker build 为创建镜像命令,名称为13/docker-mysql,'.'表示当前目录,即Dockerfile文件所在的目录,创建过程如下: 执行docker images查看该镜像是否存在于镜像列表中: 创建成功。 6、启动容器 docker run -d -p 13306:3306 13/docker-mysql 启动容器,并将端口映射到本地的13306端口,命令行如图所示: 容器启动成功。 查看容器的日志记录,启动过程与启动脚本setup.sh中所规范的步骤一致,数据导入和权限设置成功: 验证结果 1、通过进入容器在命令行验证 启动时容器的id为9db491b1d760,因此执行exec命令进入容器:docker exec -it 9db491b1d760 /bin/bash 这个命令不要直接使用,因为在你机器上id可能不同,替换掉id值即可。 前文中创建了docker_mysql数据库,并在此数据库中创建了user表,同时将数据库的连接授权赋予了新建的docker用户,因此验证过程为: 使用docker用户登录数据库:mysql -u docker -p 输入密码123456通过登录验证 切换至docker_mysql数据库:use docker_mysql; 查看数据库中的表:show tables; 查看表中的数据:select * from user; 整个过程如下: 通过图中的结果对比,与前文一致,验证成功。 2、通过mysql客户端管理软件验证 通过图中的结果对比,与前文一致,验证成功。 本文转自 zddnd 51CTO博客,原文链接:http://blog.51cto.com/13013666/1943104

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册