首页 文章 精选 留言 我的

精选列表

搜索[es],共4396篇文章
优秀的个人博客,低调大师

ES BM25 TF-IDF相似度算法设置——

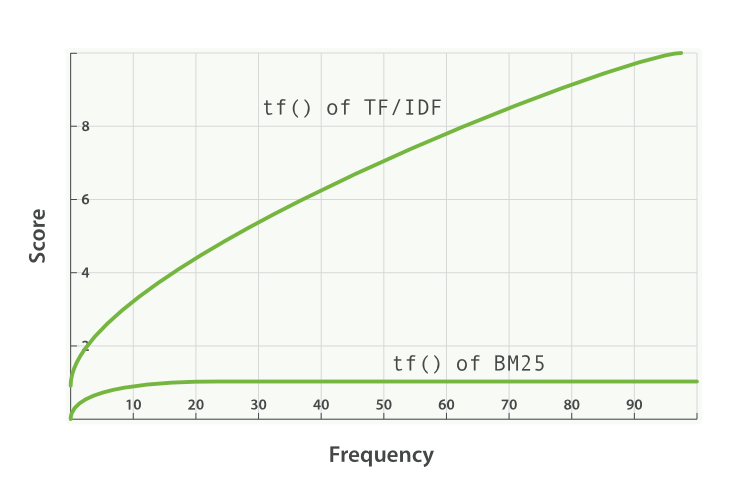
Pluggable Similarity Algorithms Before we move on from relevance and scoring, we will finish this chapter with a more advanced subject: pluggable similarity algorithms.While Elasticsearch uses theLucene’s Practical Scoring Functionas its default similarity algorithm, it supports other algorithms out of the box, which are listed in theSimilarity Modulesdocumentation. Okapi BM25 The most interesting competitor to TF/IDF and the vector space model is calledOkapi BM25, which is considered to be astate-of-the-artranking function.BM25 originates from theprobabilistic relevance model, rather than the vector space model, yetthe algorithm has a lot in common with Lucene’s practical scoring function. Both use term frequency, inverse document frequency, and field-length normalization, but the definition of each of these factors is a little different. Rather than explaining the BM25 formula in detail, we will focus on the practical advantages that BM25 offers. Term-frequency saturation Both TF/IDF and BM25 useinverse document frequencyto distinguish between common (low value) words and uncommon (high value) words.Both also recognize (seeTerm frequency) that the more often a word appears in a document, the more likely is it that the document is relevant for that word. However, common words occur commonly.The fact that a common word appears many times in one document is offset by the fact that the word appears many times inalldocuments. However, TF/IDF was designed in an era when it was standard practice to remove themostcommon words (orstopwords, seeStopwords: Performance Versus Precision) from the index altogether.The algorithm didn’t need to worry about an upper limit for term frequency because the most frequent terms had already been removed. In Elasticsearch, thestandardanalyzer—the default forstringfields—doesn’t remove stopwordsbecause, even though they are words of little value, they do still have some value. The result is that, for very long documents, the sheer number of occurrences of words liketheandandcan artificially boost their weight. BM25, on the other hand, does have an upper limit. Terms that appear 5 to 10 times in a document have a significantly larger impact on relevance than terms that appear just once or twice. However, as can be seen inFigure34, “Term frequency saturation for TF/IDF and BM25”, terms that appear 20 times in a document have almost the same impact as terms that appear a thousand times or more. This is known asnonlinear term-frequency saturation. Figure34.Term frequency saturation for TF/IDF and BM25 Field-length normalization InField-length norm, we said that Lucene considers shorter fields to have more weight than longer fields: the frequency of a term in a field is offset by the length of the field. However, the practical scoring function treats all fields in the same way.It will treat alltitlefields (because they are short) as more important than allbodyfields (because they are long). BM25 also considers shorter fields to have more weight than longer fields, but it considers each field separately by taking the average length of the field into account. It can distinguish between a shorttitlefield and alongtitle field. InQuery-Time Boosting, we said that thetitlefield has anaturalboost over thebodyfield because of its length. This natural boost disappears with BM25 as differences in field length apply only within a single field. 摘自:https://www.elastic.co/guide/en/elasticsearch/guide/current/pluggable-similarites.html 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6472820.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

《Spring ES实战》第5招 Query要分两类

# Elasticsearch Query DSL 实战:把“相关性”与“过滤”分开 ```text 旧方案:所有条件都塞进 must,Text 字段用 term 硬匹配,模糊词用 wildcard 兜底 冲突:数据明明存在却查不到,评分被无关条件污染,通配符查询拖垮 CPU 后果:搜索结果时灵时不灵,排序忽高忽低,集群在促销高峰频繁 GC ``` 很多团队把 Elasticsearch 当“能分词的 MySQL”,把 SQL 的 WHERE 习惯直接搬进 Query DSL。 结果就是:Text 字段用 term 查不到,数字字段用 match 乱匹配,wildcard 满天飞。 我是老李,过去半年在深圳一家电商公司做搜索中台,亲眼见过一个“明明有货却搜不到”的线上事故,根因就是 Query DSL 里把全文查询和精确过滤混成了一锅粥。 为什么数据存在却查不到? 什么时候条件应该参与评分,什么时候只负责过滤? 如果把评分和过滤混在一起,线上会付出什么代价? # 01、故事 ```text 周五 23:47→电商搜索中台→大促预热搜索“华为手机”→冲突:有货却搜不到 ``` 那天是周五晚上 23:47,我还在公司。运营在群里发了一张截图:App 搜索“华为手机”,结果页空白,但商品后台明明有 300 多台库存。 任务是十分钟内恢复搜索,否则大促预热页要回滚。我打开 Kibana,先跑了一遍线上查询,确实返回 0 条。 再看商品索引,文档存在,status 是 1,keyword 字段里也有“华为手机”。我第一反应是字段映射有问题,但 mapping 显示 keyword 是 Text 类型。 时间一分一秒过去,群里消息越刷越快。我盯着那个查询体,突然意识到问题可能不在数据,而在查询本身。 > 深夜告警催人醒, > 有货无果似幽灵。 > 索引文档皆安在, > 查询深处藏祸根。 # 02、问题 ```text 需求变化:从“关键词匹配”扩展到“品牌+类目+价格+状态”多维筛选 冲突:Text 字段用 term 查询,分词后索引词与查询词不一致 后果:数据存在但查不到,过滤条件参与评分,排序被无关字段干扰 ``` 最初的搜索只做关键词匹配,一个 match 就够。后来运营要求按品牌、类目、价格、状态筛选,开发就把所有条件都塞进 bool 的 must 里。 问题出在 keyword 字段。它是 Text 类型,写入时被 standard 分词器拆成“华为”和“手机”两个词。而 term 查询不做分词,拿“华为手机”整串去倒排索引里找,当然找不到。 更隐蔽的问题是:brand、category、status 这些精确值字段也放在 must 里,它们会参与评分。一个“华为”品牌匹配的得分,可能比关键词“手机”的得分还高,排序就乱了。 可验证的验收标准是:搜索“华为手机”能返回结果;按品牌“华为”筛选后结果只含华为;价格区间 3000-6000 能正确过滤;status=1 只返回在售商品。 > 分词写入倒排里, > 整串查询空手归。 > 过滤误入评分场, > 排序错乱用户离。 # 03、原理 ```text 核心机制:Text 字段分词后建倒排索引,term 查询不做分词直接匹配索引词 ``` Elasticsearch 的查询分两大类:Full-text Query 和 Term-level Query。前者对查询词做分词,后者不做分词。 match 查询会对输入做分词,然后拿每个词去倒排索引里找。比如“华为手机”会被拆成“华为”和“手机”,分别匹配。 term 查询不做分词,拿整个输入去倒排索引里精确匹配。如果字段是 Text 类型,索引里存的是分词后的词,term 拿整串去匹配,必然失败。 一个反直觉的判断是:Text 字段上 term 查询“数据存在却查不到”不是 bug,而是符合设计预期的行为。 要精确匹配 Text 字段,应该用 keyword 子字段,或者把字段映射为 Keyword 类型。 另一个反直觉判断:filter 不参与评分,但它的性能通常比 must 更好,因为它可以利用缓存。把精确条件放进 filter,既正确又快。 > 全文查询问相关, > 词项查询问相等。 > 分词与否是分界, > 张冠李戴必成空。 # 04、架构 ```text 输入:用户关键词+品牌+类目+价格区间+状态→本模块:Query DSL 组装→输出:相关度排序的过滤后结果 ``` 查询层分两条路径:关键词走全文查询,负责评分;品牌、类目、价格、状态走过滤,只负责筛选。 bool 查询是组合器,四个子句各司其职:must 必须匹配且参与评分;should 可选匹配,匹配了加分;filter 必须匹配但不评分;must_not 必须不匹配。 收益是排序只由关键词相关性决定,过滤条件不干扰评分。代价是查询体变复杂,需要团队约定字段类型和查询选择规范。 适用条件是:有明确的关键词搜索需求,同时有多个精确筛选维度。如果只有精确筛选没有关键词,直接用 filter 就够了。 > 一层查询两条路, > 相关过滤各司职。 > 评分只问关键词, > 筛选不扰排序分。 # 05、第一版实战 ```text 环境→配置→代码→启动→验证→V1 ``` 环境:Elasticsearch 8.11.3,Kibana 8.11.3,本地 Docker 单节点。版本需按当前官方文档核验。 先创建索引,keyword 用 Text 类型并带 keyword 子字段,brand、category、status 用 Keyword 类型,price 用 double: ```json PUT /products { "mappings": { "properties": { "keyword": { "type": "text", "fields": { "raw": { "type": "keyword" } } }, "brand": { "type": "keyword" }, "category": { "type": "keyword" }, "price": { "type": "double" }, "status": { "type": "integer" } } } } ``` 写入测试数据: ```json POST /products/_bulk { "index": { "_id": 1 } } { "keyword": "华为手机 Mate60", "brand": "华为", "category": "手机", "price": 5999, "status": 1 } { "index": { "_id": 2 } } { "keyword": "华为手机 P60", "brand": "华为", "category": "手机", "price": 4388, "status": 1 } { "index": { "_id": 3 } } { "keyword": "小米手机 14", "brand": "小米", "category": "手机", "price": 3999, "status": 0 } ``` V1 查询:关键词用 multi_match 查 keyword 和 brand,品牌、类目、价格、状态全部塞进 must: ```json POST /products/_search { "query": { "bool": { "must": [ { "multi_match": { "query": "华为手机", "fields": ["keyword", "brand"] } }, { "term": { "brand": "华为" } }, { "term": { "category": "手机" } }, { "range": { "price": { "gte": 3000, "lte": 6000 } } }, { "term": { "status": 1 } } ] } } } ``` 启动验证:在 Kibana Dev Tools 执行上述请求。示例输出: ```text 示例输出: { "hits": { "total": { "value": 2 }, "hits": [ { "_id": "1", "_score": 2.5 }, { "_id": "2", "_score": 2.2 } ] } } ``` 成功标准:返回 2 条华为手机,价格都在 3000-6000,status 都是 1。V1 看起来能跑通。 > 索引建好数据入, > 查询体里五条件。 > 看似结果皆正确, > 隐患已在暗处生。 # 06、排查 ```text 诊断树:现象→怀疑→检查→证据→根因→修复 ``` 问题一:搜索“华为手机”时,如果用户输入“华为 手机”中间有空格,multi_match 能匹配。 但如果用户输入“华为手机”整串,而 keyword 字段被分词,match 依然能匹配。 真正的问题出在另一个场景。 运营反馈:筛选品牌“华为”后,搜索“华为手机”返回 0 条。我怀疑是 term 查询在 Text 字段上失效。 检查 mapping: ```json GET /products/_mapping ``` 证据:keyword 字段是 text 类型,brand 是 keyword 类型。但查询里 term 用在 brand 上,这是对的。问题不在这里。 继续排查:运营说“华为手机”搜不到,是在一个旧索引上。那个索引的 keyword 字段没有 keyword 子字段,且查询里用了 term 查 keyword。 检查旧索引查询: ```json POST /old_products/_search { "query": { "term": { "keyword": "华为手机" } } } ``` 证据:返回 0 条。根因确认:Text 字段被分词,term 拿整串匹配失败。修复:改用 match 或 keyword.raw 子字段。 **错误尝试:** 我一开始以为是 status 字段类型问题,把 status 从 integer 改成 keyword,结果查询依然时好时坏。后来才发现真正的问题是 term 查 Text 字段。 > 现象诡异查映射, > 怀疑类型先入主。 > 证据指向分词处, > 根因方显真面目。 # 07、优化 ```text V1:所有条件塞 must→证据:过滤条件参与评分,排序被干扰→V2:精确条件移入 filter ``` V1 的问题是 brand、category、status、price 都放在 must 里,它们会参与评分。 一个品牌完全匹配的文档,可能因为 brand 字段短、匹配度高,得分超过关键词更相关的文档。 优化:把精确条件全部移入 filter,只保留 multi_match 在 must 里: ```json POST /products/_search { "query": { "bool": { "must": [ { "multi_match": { "query": "华为手机", "fields": ["keyword", "brand"] } } ], "filter": [ { "term": { "brand": "华为" } }, { "term": { "category": "手机" } }, { "range": { "price": { "gte": 3000, "lte": 6000 } } }, { "term": { "status": 1 } } ] } } } ``` 这样排序只由 multi_match 的相关性决定,过滤条件不干扰评分。同时 filter 可以利用 Elasticsearch 的查询缓存,性能更好。 > 五条件里四过滤, > 何必都进评分场。 > 移入 filter 不评分, > 排序纯粹性能强。 # 08、演进 ```text V2:must 只留关键词,filter 管筛选→能力:排序纯净+缓存加速→遗留:should 场景未覆盖 ``` 用 V1 同一组请求验证:搜索“华为手机”,品牌华为,类目手机,价格 3000-6000,status=1。 V2 返回 2 条,得分只由关键词相关性决定。示例输出: ```text 示例输出: { "hits": { "total": { "value": 2 }, "hits": [ { "_id": "1", "_score": 1.8 }, { "_id": "2", "_score": 1.5 } ] } } ``` 收益是排序稳定,过滤条件变化不影响得分。代价是查询体变长,需要团队理解 bool 四个子句的语义。 遗留问题:should 子句还没用上。比如“华为”和“荣耀”两个品牌,用户可能都想要,should 可以加分但不强制匹配。 > 同组请求前后比, > 排序纯净分不虚。 > 缓存加速过滤快, > should 场景待补齐。 # 09、洞见 ```text 从现象到判断:全文查询回答“有多相关”,过滤回答“符不符合条件” ``` ## 把“相关性”和“过滤”分开是 Elasticsearch 查询设计的第一原则 ```text must 管评分,filter 管筛选,两者不可混用 ``` 全文查询回答“有多相关”,过滤回答“符不符合条件”。把两者分开,排序才纯净,缓存才生效。混在一起,既污染评分,又拖慢查询。 ## 反直觉判断:Text 字段上 term 查询查不到,不是 bug,是设计预期 ```text Text 分词建索引,term 不分词去匹配,必然错位 ``` 很多人遇到“数据存在却查不到”,第一反应是 Elasticsearch 出问题了。实际上这是 Text 字段分词机制的直接结果。要精确匹配,用 keyword 子字段或 Keyword 类型。 ## 反直觉判断:wildcard 不应替代 Analyzer ```text wildcard 是精确匹配的兜底,不是分词匹配的替代品 ``` wildcard 查询不做分词,它是对词项做通配符匹配。用它来模拟模糊搜索,会扫描大量词项,CPU 飙升。模糊搜索应该靠 Analyzer 的分词和同义词,而不是 wildcard。 ## filter 不评分,但通常比 must 更快 ```text filter 结果可缓存,must 每次都要算分 ``` 精确条件放进 filter,Elasticsearch 可以缓存过滤结果。下次相同过滤条件直接复用,跳过评分计算。这是性能优化的关键一步。 > 相关过滤本两途, > 混为一谈必迷途。 > 词项查询不分词, > 通配岂能替分词。 # 10、系统落地 ```text 入口:App 搜索框→服务:搜索中台→本模块:Query DSL 组装→存储:Elasticsearch→未实现:should 多品牌加分 ``` 原来搜索中台只有一个简单的 match 查询。本篇增加了 bool 组合查询,把关键词、品牌、类目、价格、状态分开处理。 现在能做什么:用户搜索关键词,同时按品牌、类目、价格、状态精确筛选,排序只由关键词相关性决定。 下一篇缺什么:should 子句的多品牌加分场景还没实现,比如用户搜“华为荣耀”,两个品牌都匹配的文档应该排在前面。 官方文档参考:Elasticsearch 官方文档主页 https://www.elastic.co/docs > 搜索中台初长成, > 多维筛选各归位。 > 关键词定排序分, > 过滤条件不扰分。 # 11、小结 ```text 三问三答:为什么查不到→term 不分词;何时评分→must/should;选错后果→排序乱性能差 ``` 为什么数据存在却查不到?因为 Text 字段被分词,term 查询拿整串去匹配分词后的索引词,必然失败。 什么时候条件参与评分,什么时候只负责过滤?must 和 should 参与评分,filter 和 must_not 只负责过滤。关键词放 must,精确条件放 filter。 选错会付出什么代价?排序被无关条件污染,用户看到不相关的结果排在前面;filter 缓存失效,查询性能下降,高峰时集群压力增大。 当前状态:V2 已上线,搜索“华为手机”能正确返回结果,筛选条件不干扰排序。 > 三问三答理分明, > 查询设计有章循。 > 相关过滤分开走, > 线上稳定用户欣。 # 12、作业 ```text 理解→实战→排障→架构判断 ``` ## 理解题:match 和 term 在 Text 字段上的行为有什么区别? match 会对查询词做分词,然后拿每个词去倒排索引里匹配。term 不做分词,拿整串去匹配。Text 字段写入时被分词,所以 term 查 Text 字段通常查不到,match 能查到。 ## 实战题:给商品索引增加一个 should 子句,让搜索“华为手机”时,品牌为“荣耀”的文档也能返回但得分低于华为。 ```json POST /products/_search { "query": { "bool": { "must": [ { "multi_match": { "query": "华为手机", "fields": ["keyword", "brand"] } } ], "should": [ { "term": { "brand": "荣耀" } } ], "filter": [ { "term": { "category": "手机" } }, { "range": { "price": { "gte": 3000, "lte": 6000 } } }, { "term": { "status": 1 } } ] } } } ``` 荣耀品牌文档会返回,但得分低于华为品牌文档,因为 should 只加分不强制匹配。 ## 排障题:线上搜索“苹果手机”返回 0 条,但商品后台有货。请写出排查步骤。 第一步,检查索引 mapping,确认 keyword 字段类型。 第二步,用 match 查询测试,如果能查到,说明是 term 查询在 Text 字段上失效。 第三步,检查查询体,看是否用了 term 查 Text 字段。 第四步,修复:改用 match 或 keyword.raw 子字段。 ## 架构判断题:有人说“把所有条件都放进 must,这样最安全,不会漏掉任何条件”。这个说法对吗? 不对。must 里的条件都参与评分,精确条件放进 must 会污染排序。而且 must 不能利用 filter 缓存,性能更差。正确做法是:关键词放 must,精确条件放 filter。 > 理解实战排障题, > 架构判断见真章。 > 查询设计有原则, > 相关过滤不可混。 # 13、升华 ```text 工程结论:查询设计的第一原则是把“相关性”和“过滤”分开 ``` 有依据的结论是:Full-text Query 回答“有多相关”,Filter 回答“符不符合条件”。把两者分开,排序才纯净,缓存才生效,性能才稳定。 term 查 Text 字段失效不是 bug,是分词机制的直接结果。wildcard 不应替代 Analyzer,模糊搜索应该靠分词和同义词。 下一篇可以深入 should 的多品牌加分场景,以及 function_score 如何做更精细的相关性调权。 > 查询设计第一则, > 相关过滤两分明。 > 词项通配皆有界, > 工程路上步步清。 **系列项目:** 电商搜索中台,服务 App 与运营后台 **已完成:** 关键词搜索、品牌/类目/价格/状态筛选、bool 组合查询 **本篇:** 区分 Full-text Query 与 Term-level Query,掌握 match、multi_match、term、terms、range、exists、prefix、wildcard、bool 及 must、should、filter、must_not **下一篇:** should 多品牌加分与 function_score 相关性调权

优秀的个人博客,低调大师

《Spring ES实战》第12招 Shard不是越多越好

# Elasticsearch 索引架构实战:从分片到段,避开分片税 ```text 旧方案:单索引多分片,盲目扩容 冲突:查询变慢,Heap 飙升,文件句柄耗尽 后果:集群不稳定,协调成本剧增 ``` 很多团队把 Elasticsearch 当黑盒,数据一多就加 Shard,结果查询反而更慢。 我是老李,过去半年在深圳一家电商公司负责搜索服务,亲眼见过一个索引从 5 个 Shard 扩到 40 个 Shard 后,P99 延迟从 200ms 涨到 1.8s。 为什么增加 Shard 有时不仅不会让查询更快,反而增加 Heap、文件句柄和协调成本? 是优先控制单 Shard 大小,还是优先增加 Shard 数量来分摊写入压力? 如果选错,会不会导致集群在高峰期频繁 Full GC,甚至节点失联? # 01、故事 ```text 凌晨 02:17→深圳南山机房→商品搜索索引扩容→分片数从 5 改到 40 ``` 那天凌晨两点十七分,我在南山机房的工位上,任务是给商品搜索索引做一次扩容,因为运营说大促前数据量要翻倍。 我打开 Kibana 的 Dev Tools,把索引模板里的 number_of_shards 从 5 改成 40,然后重建索引。 数据灌到一半,监控屏上三个数据节点的 Heap 使用率同时冲破 85%,查询线程池开始堆积。 我赶紧停掉写入,但已经晚了,几个慢查询把协调节点拖住,搜索接口开始超时。 > 凌晨两点改分片, > 四十个分片压垮三节点。 > 堆内存冲上八十五, > 搜索超时告警连成线。 # 02、问题 ```text 需求变化:数据量翻倍→分片数从 5 扩到 40 冲突:查询变慢,Heap 飙升,文件句柄耗尽 后果:协调成本剧增,集群不稳定 ``` 表面看是数据量增长,实际是分片数从 5 变成 40,每个查询要协调的分片数翻了 8 倍。 每个 Shard 都是一个 Lucene Index 实例,占用独立 Heap、文件句柄和线程资源,40 个 Shard 意味着 40 份固定成本。 可验证的验收标准是:同样 100 并发查询,P99 延迟不超过 500ms,Heap 使用率低于 75%,文件句柄数低于节点上限的 60%。 > 数据翻倍本寻常, > 分片八倍惹祸殃。 > 固定成本四十份, > 协调开销把命伤。 # 03、原理 ```text Index → Primary Shard → Replica Shard → Segment → Lucene Index ``` 一个 Index 在创建时被拆成多个 Primary Shard,每个 Primary Shard 决定数据分区,通过 Routing 把文档哈希到对应分片。 Replica Shard 是 Primary 的副本,提供查询能力和故障冗余,但不承担写入主路径。 每个 Shard 内部是一个 Lucene Index,由多个 Segment 组成,Segment 是不可变的倒排索引文件。 反直觉判断:Shard 数量越多,单次查询的并行度越高,但协调节点需要合并的结果集也越大,CPU 和内存开销非线性增长。 > 索引拆成主分片, > 路由哈希定归属。 > 副本只读不主写, > 段是不可变倒排。 # 04、架构 ```text 输入:文档写入请求、查询请求 本模块:Coordinating Node → Primary/Replica Shards → Segments 输出:查询结果合并、写入确认 边界:单 Shard 建议 10-50GB,单节点 Shard 数受 Heap 限制 ``` Coordinating Node 接收查询,广播到所有相关 Shard,每个 Shard 在本地 Lucene Index 上执行查询,返回 TopN 给协调节点做全局排序。 写入路径只走 Primary Shard,Primary 写完同步转发给 Replica,等副本确认后才返回成功。 收益是水平扩展读写能力,代价是每个 Shard 都有固定内存和文件句柄开销,适用条件是单 Shard 大小在 10 到 50GB 之间。 > 协调节点广播查询, > 各分片本地取前 N。 > 全局归并再返回, > 固定成本要算清。 # 05、第一版实战 ```text 环境:Elasticsearch 8.11.3,3 数据节点,每节点 16GB Heap 配置:商品索引 5 Primary Shards,1 Replica 代码:索引创建、文档写入、查询验证 启动:docker compose 启动 3 节点集群 验证:_cat/shards 观察分片分布,查询延迟基线 V1:5 分片,P99 200ms,Heap 60% ``` 环境是 Elasticsearch 8.11.3,三个数据节点,每个节点 16GB Heap,用 Docker Compose 启动。 先创建商品索引,5 个 Primary Shard,1 个 Replica,总共 10 个 Shard。 ```bash curl -X PUT "localhost:9200/products_v1" -H 'Content-Type: application/json' -d' { "settings": { "number_of_shards": 5, "number_of_replicas": 1 }, "mappings": { "properties": { "title": { "type": "text" }, "price": { "type": "double" }, "category": { "type": "keyword" }, "created_at": { "type": "date" } } } }' ``` 写入 500 万条商品文档,用 bulk API 分批灌入。 ```bash curl -X POST "localhost:9200/_bulk" -H 'Content-Type: application/x-ndjson' --data-binary @products_bulk.json ``` 查看分片分布,确认 10 个 Shard 均匀分布在 3 个节点上。 ```bash curl -s "localhost:9200/_cat/shards/products_v1?v&h=index,shard,prirep,state,node,store" ``` ```text 示例输出: index shard prirep state node store products_v1 0 p STARTED node-1 8.2gb products_v1 0 r STARTED node-2 8.2gb products_v1 1 p STARTED node-2 8.1gb products_v1 1 r STARTED node-3 8.1gb products_v1 2 p STARTED node-3 8.3gb products_v1 2 r STARTED node-1 8.3gb products_v1 3 p STARTED node-1 8.0gb products_v1 3 r STARTED node-2 8.0gb products_v1 4 p STARTED node-3 8.2gb products_v1 4 r STARTED node-1 8.2gb ``` 执行查询验证,按分类过滤并按价格排序,取前 20 条。 ```bash curl -s "localhost:9200/products_v1/_search" -H 'Content-Type: application/json' -d' { "query": { "term": { "category": "electronics" } }, "sort": [ { "price": "desc" } ], "size": 20 }' ``` ```text 示例输出: { "took": 187, "hits": { "total": { "value": 12430 }, "max_score": null }, "_shards": { "total": 5, "successful": 5, "skipped": 0, "failed": 0 } } ``` 成功标准:查询 took 低于 200ms,_shards.total 等于 5,所有分片 successful。 > 五主五副十份片, > 三节点上均匀摊。 > 查询两百毫秒内, > 基线稳定心不慌。 # 06、排查 ```text 诊断树: 查询变慢 ├── 怀疑:分片数过多 │ ├── 检查:_cat/shards 统计分片总数 │ ├── 证据:40 个 Shard 分布在 3 节点,每节点 13+ Shard │ └── 根因:协调节点合并 40 个分片结果,CPU 和内存开销过大 ├── 怀疑:Heap 压力 │ ├── 检查:_cat/nodes?v&h=name,heap.percent,ram.percent │ ├── 证据:heap.percent 85%+,频繁 Young GC │ └── 根因:每个 Shard 的 Segment 缓存和查询缓存叠加 └── 怀疑:文件句柄耗尽 ├── 检查:节点上 lsof -p | wc -l ├── 证据:单节点文件句柄数超过 60000 └── 根因:每个 Segment 打开多个文件,Shard 越多句柄越多 ``` 第一个问题是查询变慢,我怀疑是分片数过多,用 _cat/shards 统计发现 40 个 Shard 分布在 3 个节点上,每节点超过 13 个 Shard。 协调节点每次查询要广播到 40 个 Shard,合并结果时 CPU 和内存开销远超 5 个 Shard 的场景。 第二个问题是 Heap 压力,用 _cat/nodes 查看节点状态。 ```bash curl -s "localhost:9200/_cat/nodes?v&h=name,heap.percent,ram.percent,cpu" ``` ```text 示例输出: name heap.percent ram.percent cpu node-1 87 92 78 node-2 85 90 75 node-3 88 93 80 ``` 每个 Shard 的 Segment 缓存和查询缓存叠加,导致 Heap 使用率冲到 85% 以上,频繁 Young GC。 第三个问题是文件句柄,登录节点执行 lsof 统计。 ```bash lsof -p $(pgrep -f elasticsearch) | wc -l ``` ```text 示例输出: 62341 ``` 每个 Segment 打开多个文件,Shard 越多句柄越多,单节点文件句柄数超过 60000,接近系统上限。 **错误尝试:** 我一开始以为是查询语句没优化,加了 constant_keyword 和 filter 缓存,结果延迟只降了 50ms,Heap 依然高企。 > 四十片查一次, > 协调节点累成痴。 > 堆高句柄都耗尽, > 优化查询也难支。 # 07、优化 ```text V1:5 分片,P99 200ms,Heap 60% 证据:40 分片,P99 1.8s,Heap 87%,句柄 62000+ V2:回到 5 分片,单分片 40GB,P99 210ms,Heap 62% ``` 核心改动是把分片数从 40 降回 5,让单 Shard 大小控制在 40GB 左右,而不是追求分片多。 重建索引,设置 5 个 Primary Shard,1 个 Replica,用 reindex 从旧索引迁移数据。 ```bash curl -X PUT "localhost:9200/products_v2" -H 'Content-Type: application/json' -d' { "settings": { "number_of_shards": 5, "number_of_replicas": 1, "refresh_interval": "5s" }, "mappings": { "properties": { "title": { "type": "text" }, "price": { "type": "double" }, "category": { "type": "keyword" }, "created_at": { "type": "date" } } } }' ``` ```bash curl -X POST "localhost:9200/_reindex" -H 'Content-Type: application/json' -d' { "source": { "index": "products_v1" }, "dest": { "index": "products_v2" } }' ``` 同时把 refresh_interval 从默认 1s 调到 5s,减少 Segment 生成频率,降低 Merge 压力。 > 四十片回五片, > 单分片四十吉。 > 刷新间隔调五秒, > 堆和句柄都松气。 # 08、演进 ```text V2:5 分片,单分片 40GB,P99 210ms,Heap 62% 能力:查询延迟稳定,Heap 余量充足,句柄数下降 60% 遗留:单分片 40GB 接近上限,未来数据增长需滚动索引 ``` 用 V1 同一组查询请求验证,P99 从 1.8s 降到 210ms,Heap 从 87% 降到 62%,句柄数从 62000 降到 25000 左右。 收益是协调成本大幅下降,每个查询只广播 5 个 Shard,合并结果集小,CPU 和内存开销可控。 代价是单分片 40GB 接近建议上限,如果数据继续增长,需要引入滚动索引或 ILM 来拆分。 遗留问题是当前方案没有处理 Hot Shard,如果某个分类数据量特别大,可能导致单个 Shard 过热。 > 五片查询二百一, > 堆余充足句柄低。 > 单片四十近上限, > 滚动索引待补齐。 # 09、洞见 ```text 从现象到判断:分片数增加反而变慢,说明固定成本主导了性能 ``` ## 分片是扩展单位,同时也是固定成本单位 ```text 每增加一个 Shard,就多一份 Lucene Index 的 Heap、句柄和线程开销 ``` 很多人把 Shard 当成免费的并行度,实际上每个 Shard 都有独立的 Lucene Index 实例,占用固定内存和文件句柄。 当分片数从 5 增加到 40,固定成本翻了 8 倍,而查询并行度的收益被协调合并的开销抵消。 ## 反直觉判断:分片越多,查询不一定越快 ```text 协调节点合并 N 个分片结果的开销是 O(N log N),N 越大越不划算 ``` 查询延迟由最慢的分片决定,分片越多,出现慢分片的概率越高,协调节点还要做全局排序。 在 3 节点集群里,40 个 Shard 意味着每个节点要处理 13 个 Shard 的查询,CPU 争抢严重。 ## 反直觉判断:单分片大小比分片数量更重要 ```text 10-50GB 的单分片大小是经验值,超出后 Merge 和 Recovery 成本剧增 ``` 单分片太小,固定成本占比高;单分片太大,Segment Merge 和故障恢复时间长。 规划索引时先估算数据总量,再反推分片数,而不是先定分片数再看数据量。 ## 搜索集群规划首先要避免分片税 ```text 分片税 = 分片数 × 单分片固定成本,规划时先算这笔账 ``` 分片税是每个查询都要支付的固定开销,包括广播、上下文切换、结果合并。 规划集群时先确定单分片目标大小,再根据数据总量计算分片数,最后验证节点 Heap 和句柄余量。 > 分片本是双刃剑, > 扩展成本两相兼。 > 固定开销算清楚, > 莫让查询交税钱。 # 10、系统落地 ```text 入口:搜索 API 网关 服务:商品搜索服务 本模块:Elasticsearch 索引架构(5 分片 + 1 副本 + 5s Refresh) 存储:3 数据节点,每节点 16GB Heap 未实现:ILM 滚动索引、Hot Shard 自动拆分 ``` 原来系统只有一个 products 索引,分片数随意设置,没有容量规划。 本篇增加了基于数据量反推分片数的方法,把索引控制在 5 个 Primary Shard,单分片 40GB。 现在能做什么:查询 P99 稳定在 210ms,Heap 余量充足,句柄数在安全范围内。 下一篇缺什么:ILM 滚动索引和 Hot Shard 检测,应对数据持续增长和热点分片。 官方文档可参考 Elasticsearch 官网的 Size your shards 指南:https://www.elastic.co/guide/en/elasticsearch/referenc e/current/size-your-shards.html > 入口网关到搜索, > 五片索引稳如钟。 > 滚动索引还未建, > 热点分片待追踪。 # 11、小结 ```text 三问三答: 为什么增加 Shard 反而变慢?→ 固定成本叠加,协调合并开销非线性增长 优先控制单 Shard 大小还是增加 Shard 数量?→ 先控制单 Shard 大小在 10-50GB,再反推分片数 选错后果?→ Heap 飙升、句柄耗尽、节点失联,集群不可用 ``` 增加 Shard 反而变慢,是因为每个 Shard 都有固定 Heap、句柄和线程开销,协调节点合并结果的成本随分片数非线性增长。 应该优先控制单 Shard 大小在 10 到 50GB,根据数据总量反推分片数,而不是盲目增加分片。 选错的后果是 Heap 使用率冲高、文件句柄耗尽、节点失联,最终整个集群不可用。 当前状态:商品索引稳定在 5 分片,P99 210ms,Heap 62%,句柄数安全。 > 三问三答理清楚, > 分片固定成本高。 > 先定单片再反推, > 集群稳定不告饶。 # 12、作业 ```text 理解→实战→排障→架构判断 ``` ## 理解题:为什么说 Shard 是扩展单位同时也是固定成本单位? 每个 Shard 内部是一个独立的 Lucene Index 实例,占用独立的 Heap 内存、文件句柄和线程资源。 增加 Shard 可以分摊写入压力、提升查询并行度,但每个 Shard 的固定成本不会消失,反而会叠加。 当分片数过多时,固定成本超过并行收益,查询反而变慢。 ## 实战题:创建一个 3 分片 1 副本的索引,写入 100 万条文档,观察 _cat/shards 分布和查询延迟 ```bash curl -X PUT "localhost:9200/homework_idx" -H 'Content-Type: application/json' -d' { "settings": { "number_of_shards": 3, "number_of_replicas": 1 }, "mappings": { "properties": { "content": { "type": "text" } } } }' ``` 写入 100 万条文档后,用 _cat/shards 确认 6 个 Shard 均匀分布,执行 match_all 查询记录 took 值。 对比 10 分片 1 副本的索引,观察查询延迟和节点 Heap 变化。 ## 排障题:查询突然变慢,_cat/nodes 显示 Heap 90%,_cat/shards 显示 60 个 Shard,如何定位和修复? 先确认分片数是否过多,60 个 Shard 在 3 节点上每节点 20 个,固定成本过高。 检查 _cat/shards 看是否有分片分布不均,检查 _cat/nodes 看 Heap 和句柄使用率。 修复方案是重建索引,把分片数降到合理范围,单分片大小控制在 10-50GB,同时调大 refresh_interval。 ## 架构判断题:一个日志索引每天写入 200GB,保留 7 天,应该用多少分片? 总数据量 1.4TB,按单分片 40GB 计算,需要 35 个 Primary Shard。 但 35 个分片在 3 节点集群上每节点约 12 个,固定成本偏高。 更好的方案是用 ILM 按天滚动索引,每天一个索引 5 个分片,单分片 40GB,7 天共 35 个分片但分散在不同索引,查询只命中相关索引。 > 理解实战排障题, > 架构判断要仔细。 > 分片规划先算账, > 滚动索引解难题。 # 13、升华 ```text 工程结论:分片规划是搜索集群稳定的第一道防线 ``` 有依据的结论是:分片数不是越多越好,单分片大小控制在 10-50GB,根据数据总量反推分片数,才能避免分片税。 本次实战从 40 分片回退到 5 分片,P99 从 1.8s 降到 210ms,Heap 从 87% 降到 62%,证明固定成本主导了小集群的查询性能。 下一篇可以深入 ILM 滚动索引和 Hot Shard 检测,解决数据持续增长和热点分片问题。 > 分片规划第一关, > 固定成本要算全。 > 单片大小控十到五十, > 集群稳定保平安。 **系列项目:** 电商搜索服务 **已完成:** 索引架构与分片规划 **本篇:** 从分片到段的层级理解与分片税规避 **下一篇:** ILM 滚动索引与 Hot Shard 治理

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册