首页 文章 精选 留言 我的

精选列表

搜索[PostgreSQL],共4400篇文章
优秀的个人博客,低调大师

最佳实践:基于Apache SeaTunnel从MySQL同步到PostgreSQL

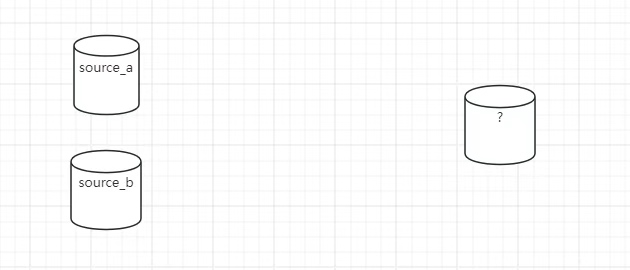
作者 | 陈飞 中付支付大数据工程师 今天和大家分享一个 简单但常见的 MySQL 到 MySQL 数据同步与合并场景案例,这个案例也是我在实际工作中遇到的问题,希望能抛砖引玉,欢迎有更丰富经验的大佬一起分享交流。 版本要求:Apache SeaTunnel --> Apache SeaTunnel-2.3.9 场景描述 在我们的业务系统中,存在两个 MySQL 源库: source_a source_b 这两个库中存在一张表结构相同的表,但数据来自不同的业务线,两边都会同时产生数据,因此存在 主键重复 的问题。 我们的目标是将这两个源库的表数据 合并同步到一个目标库(我们称为 C 库),以便于统一分析和查询。 面临的挑战 两个源库的表结构虽然一致,但主键重复,需要避免冲突 后续可能存在字段不一致或字段新增的需求 同步过程需尽量实时,且不能产生重复数据 解决方案 我们采用了如下方式来实现这个同步与合并的方案: 在 C 库新建目标表: 表结构需要覆盖两个源表的所有字段(当前一致,未来可能扩展) 增加一个额外的字段:data_source,用于标识数据来源(source_a 或 source_b) 不可为空的字段需要有默认值 设置联合主键与唯一约束 使用 原主键 + data_source 作为联合主键,确保不会因为两个源的主键重复而导致冲突 使用两个 Seatunnel 进程进行数据同步**: 分别使用 MySQL CDC 连接器 监听 source_a 与 source_b 在每条数据中打上来源标识字段 data_source 使用 JDBC Sink 写入到 C 库 实战演示 下面我们直接进入实战环节,关于 SeaTunnel 的基础知识,这里就不再赘述,上一期的大佬已经讲得非常清楚了,我们直接进入正题。 使用 MySQL CDC 前的准备工作 要使用 mysql-cdc 连接器,有两个必要的前置条件: MySQL 源库需开启 Binlog 日志 binlog_format 必须设置为 ROW binlog_row_image 设置为 FULL-- 检查当前配置 SHOWVARIABLESLIKE'binlog_format'; SHOWVARIABLESLIKE'binlog_row_image'; -- 如果未开启,可在 my.cnf 文件中添加以下配置: [mysqld] server-id = 1 log-bin = mysql-bin binlog-format = ROW binlog-row-image = FULL 以上权限说明及设置方式可以参考官网文档,文档中提供了详细的权限说明与示例,建议大家同步查阅。 准备拥有复制权限的账号 -- 创建同步账号 CREATE USER 'cdc_user'@'%' IDENTIFIED BY 'your_password'; -- 授予必要权限 GRANT SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE, REPLICATION CLIENT ON *.* TO 'cdc_user'@'%'; FLUSH PRIVILEGES; 准备 SeaTunnel 运行包与插件 方式一:下载官方二进制包 适合 服务器可访问外网 且 无需复杂定制 的场景。 下载地址:官方 Releases 页面 需要手动添加插件及插件驱动(如 mysql-cdc, jdbc) 插件安装说明可参考官方文档:插件管理 wget "https://archive.apache.org/dist/seatunnel/${version}/apache-seatunnel-${version}-bin.tar.gz" config/plugin_config保留需要的插件 bin/install-plugin.sh 方式二:从 GitHub 克隆源码自行编译 适合对插件有特殊需求或希望获得完整插件支持的用户。 sh ./mvnw clean install -DskipTests -Dskip.spotless=true seatunnel-dist/target/apache-seatunnel-2.3.9-bin.tar.gz 自行编译后生成的包中默认已集成所有插件及对应依赖,无需额外操作。 本案例使用的插件: mysql-cdc jdbc 插件说明与驱动依赖也可参考对应的文档! Apache SeaTunnel 部署方式简介 SeaTunnel 支持多种部署方式: 使用 Seatunnel 自带引擎(Zeta) 作为 Spark / Flink 作业运行 使用 Zeta 引擎时的三种模式: 配置文件结构说明 集群搭建完成后,我们开始准备配置文件。 一般情况下,SeaTunnel 的配置文件可以分为以下四个部分: Env:引擎相关配置 Source:源数据读取配置 Transform:数据转换信息(可选) Sink:写出目标库的配置 Env引擎配置 parallelism:并行度,表示任务运行的并发度,数值越大越快,具体要结合资源情况设置。 job.mode:作业运行模式。由于我们使用的是 mysql-cdc 插件,因此必须设置为 Streaming 模式。 checkpoint.interval:检查点间隔,Streaming 模式下默认是 30 秒一次,可以根据需要调整。 Source数据源配置(MySQL CDC) 使用的插件是 mysql-cdc,需要配置以下内容: 连接信息:包括数据库地址、用户名、密码等。 库名与表名:可以通过 database-names 和 table-names 显式指定,也可以使用正则表达式模糊匹配。 startup.mode:CDC 的启动模式,默认为“先全量后增量”,适合大多数同步场景。如需了解其他启动模式的区别,可以参考官方文档。 server-id:MySQL 的 CDC 读取服务 ID,虽然可以不写,但建议明确指定,防止与已有的从库 ID 冲突。 MySQL 配置建议:在使用 mysql-cdc 前,需要确保 binlog 功能已开启; binlog-format 设置为 ROW; binlog-row-image 设置为 FULL; MySQL 账号需具备读取 binlog、主从复制、查询所有表等权限。 Transform数据转换配置(可选) 在本案例中,我们需要给每条数据添加一个字段,用于标识数据来源,例如:data_source 字段,值可以是 source_a 或 source_b。 这个转换过程使用 sql 插件实现,通过添加常量字段的方式,将数据来源信息加到每条数据中。 需要注意: 每个源表可以单独指定转换规则; source_table 是保留字,表示上一个处理环节中的表名。 Sink写入配置 Sink 使用的是 jdbc 插件,配置项主要包括: 目标库地址、驱动、用户名、密码等连接信息; 根据目标表结构生成写入 SQL; 如果字段或结构不一致,可以自定义写入语句以匹配表结构。 小结 以上配置组合完成后,我们就可以实现从多个源库(如 source_a 和 source_b)实时同步数据到目标库的需求。在同步的同时,我们还增强了字段,使数据能够被标识来源并统一写入。整个流程既支持复杂数据结构,又能灵活适配业务场景,是一个适合实际生产的数据集成案例。 Sink 写入优化与效果验证 在配置 Sink 时,我们还可以做一些写入性能方面的优化: 批量写入策略 批量大小 和 写入间隔:满足任意一个条件就会触发写入操作。 关键配置参数说明 schema_save_mode:结构保存策略如果结构已存在则忽略; 如果不存在,则根据上一个环节的输出结构自动创建。 data_save_mode:数据保存策略 这里我们选择的是 追加(append) 模式。 support_upsert_by_query_primary_key_exist:是否支持根据主键做 Upsert 本次开启了该功能,用于支持主键冲突时的更新。 primary_keys:指定写入数据的主键 这里必须指定,包括原表的主键和我们 transform 阶段新增的 data_source 字段。 提交任务 ./seatunnel.sh --config ../config/demo/collect_a.config -e cluster --cluster sz-seatunnel --name collect_a --async ./seatunnel.sh --config ../config/demo/collect_b.config -e cluster --cluster sz-seatunnel --name collect_b --async --config:指定配置文件 -e:运行模式 cluster/local --cluster:集群名称,部署集群时配置,默认是seatunnel --name:任务名称 --async:后台运行 实际运行效果验证 到这里,配置部分就全部完成了。接下来我们来看下实际运行的效果: 当前有 a 表和 b 表,c 表为空。 先运行 a 的同步进程。 查看 c 表,已经写入了 a 表的数据,且 data_source 字段为 source_a。 接着运行 b 的同步进程。 再查看 c 表,写入了 b 表的数据,data_source 字段为 source_b。 修改一下 a 表的数据。 因为我们设置了批量写入策略,这里等个两秒,再去看 c 表。 对应的数据已更新,符合预期。 到这里整个数据同步和合并的流程就全部完成啦!非常感谢大家的聆听 🙏,希望这个案例能为大家提供一些思路,也欢迎大家分享自己在 Apache SeaTunnel 使用中的更多经验,我们一起交流学习!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册