日志服务(SLS)集成 Spark 流计算实战
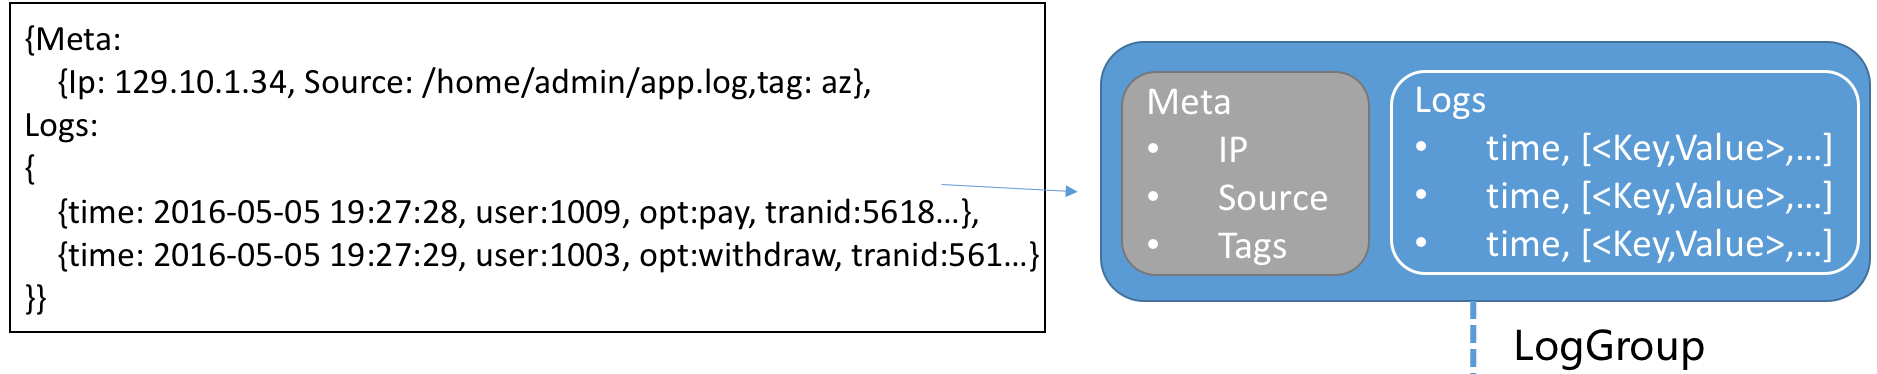
前言 日志服务作为一站式的日志的采集与分析平台,提供了各种用户场景的日志采集能力,通过日志服务提供的各种与·与SDK,采集客户端(Logtail),Producer,用户可以非常容易的把各种数据源中的数据采集到日志服务的Logstore中。同时为了便于用户对日志进行处理,提供了各种支持流式消费的SDK,如各种语言的消费组,与 Spark,Flink,Storm 等各种流计算技术无缝对接的Connector,以便于用户根据自己的业务场景非常便捷的处理海量日志。 从最早的Spark Streaming到最新的Stuctured Streaming,Spark 一直是最流行的流计算框架之一。使用日志服务的Spark SDK,可以非常方便的在Spark 中消费日志服务中的数据,同时也支持将 Spark 的计算结果写入日志服务。 日志服务基础概念 日志服务的存储层是一个类似Kafka的Append only的FIFO消息队列,包含如下基本概念: 日志(Log):由时间、及一组不定个数的Key-Value对组成。 日志组(LogGroup):一组日志的集合,包含相同Meta信息如Topic,Source,Tags等。是读写的基本单位。 图-1 Log与LogGroup的关系 Shard:分区,LogGroup读写基本单元,对应于Kafka的partition。 Logstore:日志库,用以存放同一类日志数据。Logstore会包含1个或多个Shard。 Project:Logstore存放容器,包含一个或者多个Logstore。 准备工作 1)添加Maven依赖: <dependency> <groupId>com.aliyun.emr</groupId> <artifactId>emr-logservice_2.11</artifactId> <version>1.9.0</version> </dependency> Github源码下载。2)计划消费的日志服务project,logstore以及对应的endpoint。3)用于访问日志服务Open API的Access Key。 对 Spark Streaming 的支持 Spark Streaming是Spark最早推出的流计算技术,现在已经进入维护状态,不再会增加新的功能。但是考虑到Spark Streaming 的使用仍然非常广泛,我们先从Spark Streaming开始介绍。Spark Streaming 提供了一个DStream 的数据模型抽象,本质是把无界数据集拆分成一个一个的RDD,转化为有界数据集的流式计算。每个批次处理的数据就是这段时间内从日志服务消费到的数据。 图-2 DStream Spark Streaming 从日志服务消费支持Receiver 和Direct两种消费方式。 Receiver模式 Receivers的实现内部实现基于日志服务的消费组(Consumer Library)。数据拉取与处理完全分离。消费组自动均匀分配Logstore内的所有shard到所有的Receiver,并且自动提交checkpoint到SLS。这就意味着Logstore内的shard个数与Spark 实际的并发没有对应关系。对于所有的Receiver,接收到的数据默认会保存在Spark Executors中,所以Failover的时候有可能造成数据丢失,这个时候就需要开启WAL日志,Failover的时候可以从WAL中恢复,防止丢失数据。 SDK将SLS中的每行日志解析为JSON字符串形式,Receiver使用示例如下所示: object SLSReceiverSample { def main(args: Array[String]): Unit = { val project = "your project" val logstore = "your logstore" val consumerGroup = "consumer group" val endpoint = "your endpoint" val accessKeyId = "access key id" val accessKeySecret = "access key secret" val batchInterval = Milliseconds(5 * 1000) val conf = new SparkConf().setAppName("Test SLS Loghub") val ssc = new StreamingContext(conf, batchInterval) val stream = LoghubUtils.createStream( ssc, project, logstore, consumerGroup, endpoint, accessKeyId, accessKeySecret, StorageLevel.MEMORY_AND_DISK, LogHubCursorPosition.END_CURSOR) stream.checkpoint(batchInterval * 2).foreachRDD(rdd => rdd.map(bytes => new String(bytes)).top(10).foreach(println) ) ssc.checkpoint("hdfs:///tmp/spark/streaming") ssc.start() ssc.awaitTermination() } } 除Project,Logstore,Access Key 这些基础配置外,还可以指定StorageLevel,消费开始位置等。 Direct模式 Direct模式不再需要Receiver,也不依赖于消费组,而是使用日志服务的低级API,在每个批次内直接从服务端拉取数据处理。对于Logstore中的每个Shard来说,每个批次都会读取指定位置范围内的数据。为了保证一致性,只有在每个批次确认正常结束之后才能把每个Shard的消费结束位置(checkpoint)保存到服务端。 为了实现Direct模式,SDK依赖一个本地的ZooKeeper,每个shard的checkpoint会临时保存到本地的ZooKeeper,等用户手动提交checkpoint时,再从ZooKeeper中同步到服务端。Failover时也是先从本地ZooKeeper中尝试读上一次的checkpoint,如果没有读到再从服务端获取。 object SLSDirectSample { def main(args: Array[String]): Unit = { val project = "your project" val logstore = "your logstore" val consumerGroup = "consumerGroup" val endpoint = "endpoint" val accessKeyId = "access key id" val accessKeySecret = "access key secret" val batchInterval = Milliseconds(5 * 1000) val zkAddress = "localhost:2181" val conf = new SparkConf().setAppName("Test Direct SLS Loghub") val ssc = new StreamingContext(conf, batchInterval) val zkParas = Map("zookeeper.connect" -> zkAddress) val loghubStream = LoghubUtils.createDirectStream( ssc, project, logstore, consumerGroup, accessKeyId, accessKeySecret, endpoint, zkParas, LogHubCursorPosition.END_CURSOR) loghubStream.checkpoint(batchInterval).foreachRDD(rdd => { println(s"count by key: ${rdd.map(s => { s.sorted (s.length, s) }).countByKey().size}") // 手动更新checkpoint loghubStream.asInstanceOf[CanCommitOffsets].commitAsync() }) ssc.checkpoint("hdfs:///tmp/spark/streaming") // set checkpoint directory ssc.start() ssc.awaitTermination() } } Direct模式示例 如何限速 在Receiver中,如果需要限制消费速度,我们只需要调整 Consumer Library 本身的参数即可。而Direct方式是在每个批次开始时从SLS拉取数据,这就涉及到一个问题:一个批次内拉取多少数据才合适。如果太多,一个批次内处理不完,造成处理延时。如果太少会导worker空闲,工作不饱和,消费延时。这个时候我们就需要合理配置拉取的速度和行数,实现一个批次尽可能多处理又能及时完成的目标。理想状态下Spark 消费的整体速率应该与SLS采集速率一致,才能实现真正的实时处理。 由于SLS的数据模型是以LogGroup作为读写的基本单位,而一个LogGroup中可能包含上万行日志,这就意味着Spark中直接限制每个批次的行数难以实现。因此,Direct限流涉及到两个配置参数: 参数 说明 默认值 spark.streaming.loghub.maxRatePerShard 每个批次每个Shard读取行数,决定了限流的下限 10000 spark.loghub.batchGet.step 每次请求读取LogGroup个数,决定了限流的粒度 100 可以通过适当缩小spark.loghub.batchGet.step来控制限流的精度,但是即便如此,在某些情况下还是会存在较大误差,如一个LogGroup中存在10000行日志,spark.streaming.loghub.maxRatePerShard设置为100,spark.loghub.batchGet.step设置为1,那一个批次内该shard还是会拉取10000行日志。 两种模式的对比 和Receiver相比,Direct有如下的优势: 降低资源消耗,不需要占用Executor资源来作为Receiver的角色。 鲁棒性更好,在计算的时候才会从服务端真正消费数据,降低内存使用,不再需要WAL,Failover 直接在读一次就行了,更容易实现exactly once语义。 简化并行。Spark partition 与 Logstore 的 shard 个数对应,增加shard个数就能提高Spark任务处理并发上限。 但是也存在一些缺点: 在SLS场景下,需要依赖本地的 ZooKeeper 来保存临时 checkpoint,当调用 commitAsync 时从ZooKeeper同步到日志服务服务端。所以当需要重置 checkpoint 时,也需要先删除本地ZooKeeper中的 checkpoint 才能生效。 上一个批次保存 checkpoint 之前,下一个批次无法真正开始,否则 ZooKeeper中的 checkpoint 可能会被更新成一个中间状态。目前SDK在每个批次会检查是否上一个批次的 checkpoint 还没有提交,如果没有提交则生成一个空批次,而不是继续从服务端消费。 在 SLS 场景下,限流方式不够精确。 Spark Streaming结果写入SLS 与消费SLS相反,Spark Streaming的处理结果也可以直接写入SLS。使用示例: ... val lines = loghubStream.map(x => x) // 转换函数把结果中每条记录转为一行日志 def transformFunc(x: String): LogItem = { val r = new LogItem() r.PushBack("key", x) r } val callback = new Callback with Serializable { override def onCompletion(result: Result): Unit = { println(s"Send result ${result.isSuccessful}") } } // SLS producer config val producerConfig = Map( "sls.project" -> loghubProject, "sls.logstore" -> targetLogstore, "access.key.id" -> accessKeyId, "access.key.secret" -> accessKeySecret, "sls.endpoint" -> endpoint, "sls.ioThreadCount" -> "2" ) lines.writeToLoghub( producerConfig, "topic", "streaming", transformFunc, Option.apply(callback)) ssc.checkpoint("hdfs:///tmp/spark/streaming") // set checkpoint directory ssc.start() ssc.awaitTermination() 对Structured Streaming的支持 Structured Streaming 并不是最近才出现的技术,而是早在16年就已经出现,但是直到 Spark 2.2.0 才正式推出。其数据模型是基于无界表的概念,流数据相当于往一个表上不断追加行。 图-3 无界表模型 与Spark Streaming相比,Structured Streaming主要有如下特点: 底层实现基于Spark SQL引擎,可以使用大多数Spark SQL的函数。和Spark SQL共用大部分API,如果对Spark SQL熟悉的用户,非常容易上手。复用Spark SQL的执行引用,性能更佳。 支持Process time 和Event time,而Spark Streaming只支持 Process Time。 批流同一的API。Structured Streaming 复用Spark SQL的 DataSet/DataFrame模型,和 RDD/DStream相比更High level,易用性更好。 实时性更好,默认基于micro-batch模式。在 Spark 2.3 中,还增加了连续处理模型,号称可以做到毫秒级延迟。 API 对用户更友好,只保留了SparkSession一个入口,不需要创建各种Context对象,使用起来更简单。 SDK使用示例 import org.apache.spark.sql.SparkSession import org.apache.spark.sql.types.{StringType, StructField, StructType} object StructuredStreamingDemo { def main(args: Array[String]) { val spark = SparkSession .builder .appName("StructuredLoghubWordCount") .master("local") .getOrCreate() import spark.implicits._ val schema = new StructType( Array(StructField("content", StringType))) val lines = spark .readStream .format("loghub") .schema(schema) .option("sls.project", "your project") .option("sls.store", "your logstore") .option("access.key.id", "your access key id") .option("access.key.secret", "your access key secret") .option("endpoint", "your endpoint") .option("startingoffsets", "latest") .load() .select("content") .as[String] val wordCounts = lines.flatMap(_.split(" ")).groupBy("value").count() val query = wordCounts.writeStream .outputMode("complete") .format("loghub") .option("sls.project", "sink project") .option("sls.store", "sink logstore") .option("access.key.id", "your access key id") .option("access.key.secret", "your access key secret") .option("endpoint", "your endpoint") .option("checkpointLocation", "your checkpoint dir") .start() query.awaitTermination() } } 代码解释:1)schema 声明了我们需要的字段,除了日志中的字段外,还有如下的内部字段: __logProject__ __logStore__ __shard__ __time__ __topic__ __source__ __sequence_number__ // 每行日志唯一id 如果没有指定schema,SDK默认提供一个__value__字段,其内容为由所有字段组成的一个JSON字符串。 2)lines 定义了一个流。startingoffsets:开始位置,支持: latest :日志服务最新写入位置。强烈建议从latest开始,从其他位置开始意味着需要先处理历史数据,可能需要等待较长时间才能结束。 earliest:日志服务中最早的日志对应的位置。 或者为每个shard指定一个开始时间,以JSON形式指定。 maxOffsetsPerTrigger:批次读取行数,SDK中默认是64*1024 。 3)结果写入到日志服务format 指定为Loghub即可。 不足之处 不支持手动提交checkpoint,SDK内部自动保存checkpoint到checkpointLocation中。 不再需要提供consumerGroup名称,也就是说checkpoint没有保存到SLS服务端,无法在日志服务里面监控消费延迟,只能通过Spark 任务日志观察消费进度。 参考资料 官方文档:https://spark.apache.org/docs/latest/structured-streaming-programming-guide.htmlSLS SDK例子:https://github.com/aliyun/aliyun-emapreduce-sdk/tree/master-2.x/examples/src/main/scala/com/aliyun/emr/examples/sql/streaming日志服务实时消费:https://help.aliyun.com/document_detail/28998.html 欢迎扫群加入日志服务技术交流钉钉群