首页 文章 精选 留言 我的

精选列表

搜索[GA4集成],共10008篇文章
优秀的个人博客,低调大师

CDH集成kafka

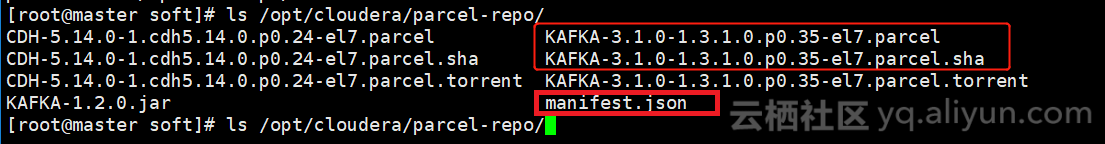
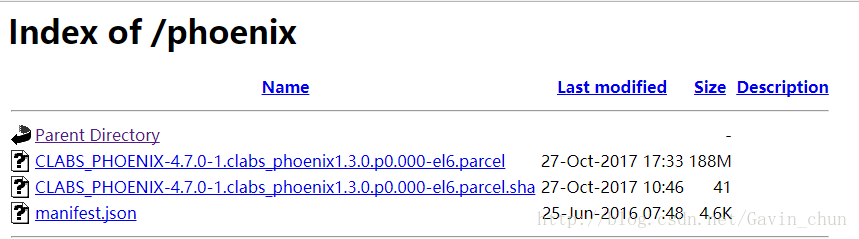
添加kafka(把包放到cm主机目录) 1.下载kafka包http://archive.cloudera.com/kafka/parcels/latest/ 把包放到parcel-repo 目录 2.下载csd包http://archive.cloudera.com/csds/kafka/ 放到csd目录 3.分配kafka包并激活 注意:如果进度卡在“已解压”,直接返回重新进来就会看到“激活” 4添加kafka角色 可根据需求填写各选项(我这里直接默认) 以下是容易踩坑的 安装后启动报错“Java heap space” 需要在cdh控制台上修改Java内存,默认50M,安装时也没提示让设置内存大小,结果自动安装后到最后的启动阶段报错(如下图) 这个时候可以返回到首页,点击kafka,进入“配置”修改java内存 找到Java Heap Size 改为1G(根据服务器配置改参数) 最后控制台重启kafka就可以了

优秀的个人博客,低调大师

Springboot集成MongoDB

简介 MongoDB(来自于英文单词“Humongous”,中文含义为“庞大”)是可以应用于各种规模的企业、各个行业以及各类应用程序的开源数据库。作为一个适用于敏捷开发的数据库,MongoDB的数据模式可以随着应用程序的发展而灵活地更新。与此同时,它也为开发人员 提供了传统数据库的功能:二级索引,完整的查询系统以及严格一致性等等。 MongoDB能够使企业更加具有敏捷性和可扩展性,各种规模的企业都可以通过使用MongoDB来创建新的应用,提高与客户之间的工作效率,加快产品上市时间,以及降低企业成本。 安装mongoDB https://www.cnblogs.com/woshimrf/p/linux-install-mongodb.html 创建项目 https://github.com/Ryan-Miao/springboot-with-mongodb pom <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.test</groupId> <artifactId>springboot-with-mongodb</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>springboot-with-mongodb</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.2.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-mongodb</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>io.springfox</groupId> <artifactId>springfox-swagger2</artifactId> <version>2.7.0</version> </dependency> <dependency> <groupId>io.springfox</groupId> <artifactId>springfox-swagger-ui</artifactId> <version>2.7.0</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <scope>runtime</scope> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <optional>true</optional> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 配置文件 spring.data.mongodb.uri=mongodb://localhost:27017/demo 创建一个表/集合 一个消费者 @Data public class Customer { @Id public String id; public String firstName; public String lastName; private List<Hobby> hobbies; public Customer() { } public Customer(String firstName, String lastName, List<Hobby> hobbies) { this.firstName = firstName; this.lastName = lastName; this.hobbies = hobbies; } } import org.springframework.data.annotation.Id; 是mongodb里的主键 创建Repository JPA的一个特性就是简化了CRUD, 通过解析方法名实现数据的传输 import com.test.springbootwithmongodb.entity.Customer; import java.util.List; import org.springframework.data.mongodb.repository.MongoRepository; public interface CustomerRepository extends MongoRepository<Customer, String> { Customer findByFirstName(String firstName); List<Customer> findByLastName(String lastName); } 方法名findBy字段名即可实现查询。 启动并测试 @SpringBootApplication public class SpringbootWithMongodbApplication implements CommandLineRunner { private final CustomerRepository repository; private final BookRepository bookRepository; private final AuthorRepository authorRepository; @Autowired public SpringbootWithMongodbApplication(CustomerRepository repository, BookRepository bookRepository, AuthorRepository authorRepository) { this.repository = repository; this.bookRepository = bookRepository; this.authorRepository = authorRepository; } public static void main(String[] args) { SpringApplication.run(SpringbootWithMongodbApplication.class, args); } @Override public void run(String... args) { repository.deleteAll(); // save a couple of customers repository.save(new Customer("Alice", "Smith", Lists.newArrayList(new Hobby("读书", 1), new Hobby("看电影", 2)))); repository.save(new Customer("Bob", "Smith", Lists.newArrayList())); // fetch all customers System.out.println("Customers found with findAll():"); System.out.println("-------------------------------"); for (Customer customer : repository.findAll()) { System.out.println(customer); } System.out.println(); // fetch an individual customer System.out.println("Customer found with findByFirstName('Alice'):"); System.out.println("--------------------------------"); System.out.println(repository.findByFirstName("Alice")); System.out.println("Customers found with findByLastName('Smith'):"); System.out.println("--------------------------------"); for (Customer customer : repository.findByLastName("Smith")) { System.out.println(customer); } } } 至此,hello world完成。基本实现了mongoDB持久层的工作,只要继续深入开发即可。 关联表 创建一个书籍的集合 import java.time.LocalDate; import lombok.Data; import org.springframework.data.annotation.Id; import org.springframework.data.mongodb.core.mapping.Document; import org.springframework.data.mongodb.core.mapping.Field; @Data @Document(collection = "books") public class Book { @Id private String id; private String title; @Field("published") private LocalDate publicationDate; // No args Constructor public Book(String title, LocalDate publicationDate) { this.title = title; this.publicationDate = publicationDate; } } @Field指定数据库映射的字段 @Transient标注的字段则不会映射到db @Document(collection = "books")可以指定集合名称,如果不指定则是类名首字母小写 创建一个作者,作者拥有书籍 @Data public class Author { @Id private ObjectId id; @Indexed(unique = true) private String name; @DBRef private Set<Book> books; // No args Constructor public Author(String name) { this.name = name; } } @DBRef会引用books的表 @Indexed(unique = true)设置索引,并且是唯一性索引 CRUD 暂时不自定义查询了,利用内置的查询即可 public interface AuthorRepository extends MongoRepository<Author, ObjectId> { } public interface BookRepository extends MongoRepository<Book, ObjectId> { } 测试 bookRepository.deleteAll(); authorRepository.deleteAll(); Book ci = new Book("Continous Integration", LocalDate.now()); // id will be generated after save bookRepository.save(ci); Book c2 = new Book("Java编程思想", LocalDate.now()); Book c3 = new Book("Java核心技术", LocalDate.now()); Book c4 = new Book("Effective Java", LocalDate.now()); Book c5 = new Book("深入理解虚拟机", LocalDate.now()); Book c6 = new Book("深入理解虚拟机", LocalDate.now()); bookRepository.save(c2); bookRepository.save(c3); bookRepository.save(c4); bookRepository.save(c5); bookRepository.save(c6); List<Book> books = bookRepository.findAll(); System.out.println(books); Author julius = new Author("Julius"); julius.setBooks(Stream.of(ci, c2, c3, c4, c5, c6).collect(Collectors.toSet())); authorRepository.save(julius); System.out.println(authorRepository.findAll()); 启动可以看到控制台输出: [Book(id=5b0bec767a49d017f0e46c63, title=Continous Integration, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c64, title=Java编程思想, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c65, title=Java核心技术, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c66, title=Effective Java, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c67, title=深入理解虚拟机, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c68, title=深入理解虚拟机, publicationDate=2018-05-28)] [Author(id=5b0bec767a49d017f0e46c69, name=Julius, books=[Book(id=5b0bec767a49d017f0e46c64, title=Java编程思想, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c68, title=深入理解虚拟机, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c67, title=深入理解虚拟机, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c63, title=Continous Integration, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c65, title=Java核心技术, publicationDate=2018-05-28), Book(id=5b0bec767a49d017f0e46c66, title=Effective Java, publicationDate=2018-05-28)])] 连接db,查询 db.author.find({}) { "_id" : ObjectId("5b0bec767a49d017f0e46c69"), "name" : "Julius", "books" : [ DBRef("books", ObjectId("5b0bec767a49d017f0e46c64")), DBRef("books", ObjectId("5b0bec767a49d017f0e46c68")), DBRef("books", ObjectId("5b0bec767a49d017f0e46c67")), DBRef("books", ObjectId("5b0bec767a49d017f0e46c63")), DBRef("books", ObjectId("5b0bec767a49d017f0e46c65")), DBRef("books", ObjectId("5b0bec767a49d017f0e46c66")) ], "_class" : "com.test.springbootwithmongodb.entity.Author" } MongoTemplate 可以自己注入MongoTemplate来实现更多操作, 比如 private final MongoTemplate mongoTemplate; List<Customer> list = mongoTemplate.findAll(Customer.class); 索引 还可以这样设置联合索引 @Document @CompoundIndexes({ @CompoundIndex(name = "email_age", def = "{'email.id' : 1, 'age': 1}") }) public class User { // } 查询索引 db.user.getIndexes(); { "v" : 1, "key" : { "email.id" : 1, "age" : 1 }, "name" : "email_age", "ns" : "test.user" } 关注我的公众号 唯有不断学习方能改变! -- Ryan Miao

优秀的个人博客,低调大师

SpringMVC集成UEditor

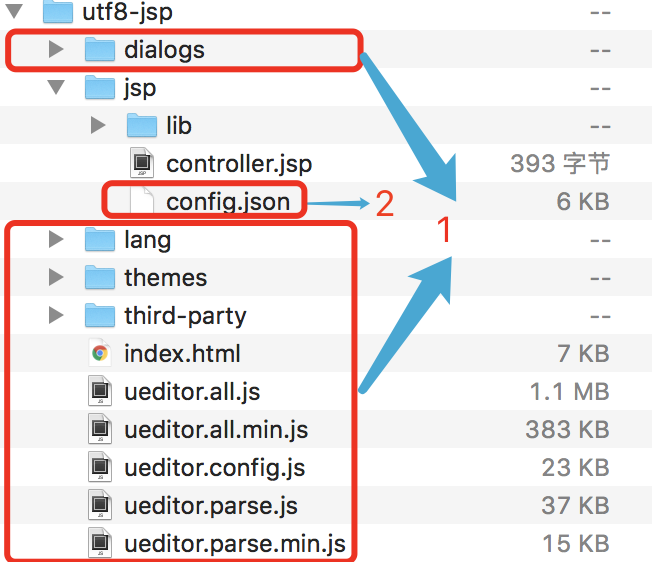
UEditor是由百度开发的富文本web编辑器。其后端jsp代码实现的文件保存/读取路径受限于传统文件系统且只能在应用的webapp目录下, 故作出修改。但是暂没有使用官方后端代码,且只实现了图片上传下载功能。 1. 下载 下载地址:http://ueditor.baidu.com/website/download.html, 下载其中的jsp版本 文件解压后目录结构如下所示 目录结构.png 2. 搭建项目 2.1. 新建一个maven项目 2.2. pom依赖 <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <maven.compiler.source>1.7</maven.compiler.source> <maven.compiler.target>1.7</maven.compiler.target> <junit.version>4.11</junit.version> <spring.version>4.3.9.RELEASE</spring.version> <fileupload.version>1.3.2</fileupload.version> <commons.io.version>2.3</commons.io.version> <slf4j.version>1.6.4</slf4j.version> <jackson.version>2.8.7</jackson.version> <fastjson.version>1.2.4</fastjson.version> <servlet.api.version>3.0.1</servlet.api.version> </properties> <dependencies> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>${junit.version}</version> <scope>test</scope> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-context</artifactId> <version>${spring.version}</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-webmvc</artifactId> <version>${spring.version}</version> </dependency> <dependency> <groupId>com.fasterxml.jackson.core</groupId> <artifactId>jackson-databind</artifactId> <version>${jackson.version}</version> </dependency> <dependency> <groupId>commons-io</groupId> <artifactId>commons-io</artifactId> <version>${commons.io.version}</version> </dependency> <dependency> <groupId>commons-fileupload</groupId> <artifactId>commons-fileupload</artifactId> <version>${fileupload.version}</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-log4j12</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson</artifactId> <version>${fastjson.version}</version> </dependency> <dependency> <groupId>javax.servlet</groupId> <artifactId>javax.servlet-api</artifactId> <version>${servlet.api.version}</version> </dependency> </dependencies> 2.3. spring-mvc.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:p="http://www.springframework.org/schema/p" xmlns:context="http://www.springframework.org/schema/context" xmlns:mvc="http://www.springframework.org/schema/mvc" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/mvc http://www.springframework.org/schema/mvc/spring-mvc-4.0.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context.xsd"> <mvc:annotation-driven/> <context:component-scan base-package="com.github.brandonbai.springmvcueditordemo.controller" /> <bean id="multipartResolver" class="org.springframework.web.multipart.commons.CommonsMultipartResolver"> <property name="defaultEncoding" value="utf-8" /> <property name="maxUploadSize" value="10485760000" /> <property name="maxInMemorySize" value="40960" /> </bean> <mvc:default-servlet-handler /> </beans> 2.4. applicationContext.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:context="http://www.springframework.org/schema/context" xmlns:p="http://www.springframework.org/schema/p" xmlns:aop="http://www.springframework.org/schema/aop" xmlns:tx="http://www.springframework.org/schema/tx" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-4.0.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context-4.0.xsd http://www.springframework.org/schema/aop http://www.springframework.org/schema/aop/spring-aop-4.0.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx-4.0.xsd http://www.springframework.org/schema/util http://www.springframework.org/schema/util/spring-util-4.0.xsd"> <context:component-scan base-package="com.github.brandonbai.springmvcueditordemo" /> </beans> 2.5. 将ueditor下载解压后目录下图目录结构.png第1部分的代码拷贝到项目的webapp下,如下图所示: 项目结构.jpg 2.6. 将ueditor下载解压后目录下图目录结构.png第2部分config.json的代码拷贝到项目的src/main/resources下,如下图所示: config.png 3. 前端配置 修改2.4图中的ueditor.config.js的服务器请求路径 32 // 服务器统一请求接口路径 33 , serverUrl: URL + "./ueConvert" 4. 后端实现 UEditorController.java package com.github.brandonbai.springmvcueditordemo.controller; import java.io.BufferedReader; import java.io.File; import java.io.FileInputStream; import java.io.InputStreamReader; import java.io.PrintWriter; import java.text.SimpleDateFormat; import java.util.Date; import java.util.HashMap; import java.util.Map; import javax.servlet.ServletOutputStream; import javax.servlet.http.HttpServletRequest; import javax.servlet.http.HttpServletResponse; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.stereotype.Controller; import org.springframework.web.bind.annotation.PathVariable; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.multipart.MultipartFile; import com.alibaba.fastjson.JSON; /** * * @author brandonbai * */ @Controller public class UEditorController { private static final String DIR_NAME = "~/Desktop"; private static final String PREFIX = "/editor/image"; private static final String FILE_SEPARATOR = File.separator; private static final String PATH_SEPARATOR = "/"; private static final String PATH_FORMAT = "yyyyMMddHHmmss"; private static final String CONFIG_FILE_NAME = "config.json"; private static final String ACTION_NAME_CONFIG = "config"; private static final String ACTION_NAME_UPLOAD_IMAGE = "uploadimage"; private static final Logger logger = LoggerFactory.getLogger(UEditorController.class); /** * 配置、图片处理 */ @RequestMapping("/ueConvert") public void ueditorConvert(HttpServletRequest request, HttpServletResponse response, String action, MultipartFile upfile) { try { request.setCharacterEncoding("utf-8"); response.setHeader("Content-Type", "text/html"); PrintWriter pw = response.getWriter(); if (ACTION_NAME_CONFIG.equals(action)) { String content = readFile(this.getClass().getResource(PATH_SEPARATOR).getPath() + CONFIG_FILE_NAME); pw.write(content); } else if (ACTION_NAME_UPLOAD_IMAGE.equals(action)) { Map<String, Object> map = new HashMap<String, Object>(16); String time = new SimpleDateFormat(PATH_FORMAT).format(new Date()); try { String originalFilename = upfile.getOriginalFilename(); String type = originalFilename.substring(originalFilename.lastIndexOf(".")); String dirName = DIR_NAME + PREFIX + FILE_SEPARATOR + time; File dir = new File(dirName); if(!dir.exists() || !dir.isDirectory()) { dir.mkdirs(); } String fileName = dirName + FILE_SEPARATOR + originalFilename; upfile.transferTo(new File(fileName)); map.put("state", "SUCCESS"); map.put("original", originalFilename); map.put("size", upfile.getSize()); map.put("title", fileName); map.put("type", type); map.put("url", "." + PREFIX + PATH_SEPARATOR + time + PATH_SEPARATOR + originalFilename); } catch (Exception e) { e.printStackTrace(); logger.error("upload file error", e); map.put("state", "error"); } response.setHeader("Content-Type", "application/json"); pw.write(JSON.toJSONString(map)); pw.close(); } } catch (Exception e) { e.printStackTrace(); } } /** * 图片读取 */ @RequestMapping(PREFIX + "/{time}/{path}.{type}") public void ueditorConvert(@PathVariable("time") String time, @PathVariable("path") String path, @PathVariable("type") String type, HttpServletRequest request, HttpServletResponse response) { try (FileInputStream fis = new FileInputStream(DIR_NAME + PREFIX + PATH_SEPARATOR + time + PATH_SEPARATOR + path + "." + type)) { int len = fis.available(); byte[] data = new byte[len]; fis.read(data); fis.close(); ServletOutputStream out = response.getOutputStream(); out.write(data); out.close(); } catch (Exception e) { logger.error("read file error", e); } } private String readFile(String path) { StringBuilder builder = new StringBuilder(); try(BufferedReader bfReader = new BufferedReader(new InputStreamReader(new FileInputStream(path), "UTF-8"))) { String tmpContent = null; while ((tmpContent = bfReader.readLine()) != null) { builder.append(tmpContent); } bfReader.close(); } catch (Exception e) { e.printStackTrace(); } return builder.toString().replaceAll("/\\*[\\s\\S]*?\\*/", ""); } } 5.演示 demo.gif 示例代码 https://github.com/brandonbai/springmvc-ueditor-demo

优秀的个人博客,低调大师

AutoMQ 生态集成 CubeFS

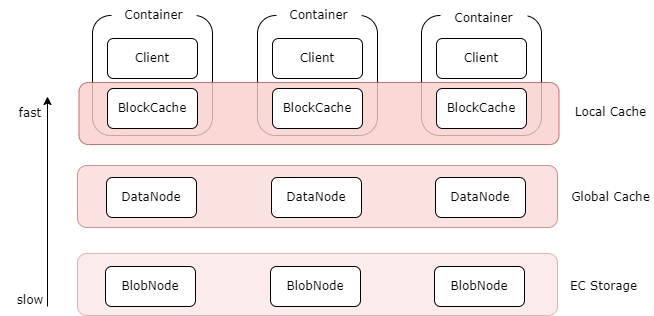
CubeFS [1] 是新一代云原生存储产品,目前是云原生计算基金会 CNCF托管的孵化阶段开源项目, 兼容 S3、POSIX、HDFS 等多种访问协议,支持多副本与纠删码两种存储引擎,为用户提供多租户、 多 AZ 部署以及跨区域复制等多种特性,广泛应用于大数据、AI、容器平台、数据库、中间件存算分离、数据共享以及数据保护等场景。 CubeFS的多级缓存[2] AutoMQ 创新的共享存储架构需要低成本的对象存储,而 CubeFS 支持 S3 兼容接口,其中 ObjectNode 提供兼容 S3 的对象存储接口来操作 CubeFS 中的文件,因此可以使用 S3Browser、S3Cmd 等开源工具或者原生的 Amazon S3 SDK 操作 CubeFS 中的文件。因此对于 AutoMQ 具有很好的适配性。因此你可以部署 AutoMQ 集群来获得一个与 Kafka 完全兼容,但是具备更好成本效益、极致弹性、个位数毫秒延迟的流系统。 本文将介绍如何将 AutoMQ 集群部署到您私有数据中心的 CubeFS 上。 01 前置条件 1.1 准备 CubeFS 集群 一个可用的 CubeFS 环境。如果您还没有 CubeFS 环境,可以参考官方文档进行依赖配置 [3] 以及搭建 CubeFS 基础集群 [4] 。 CubeFS 默认的安装包下的 build/bin 目录提供了一系列管理集群的命令行工具。本文中也将使用这些命令行工具做一些额外配置。通过 CubeFS 命令行工具查看集群状态,验证是否搭建成功: # 执行命令 ./build/bin/cfs-cli cluster info # 结果输出 [Cluster] Cluster name : cfs_dev Master leader : 172.16.1.101:17010 Master-1 : 172.16.1.101:17010 Master-2 : 172.16.1.102:17010 Master-3 : 172.16.1.103:17010 Auto allocate : Enabled MetaNode count (active/total) : 4/4 MetaNode used : 0 GB MetaNode available : 21 GB MetaNode total : 21 GB DataNode count (active/total) : 4/4 DataNode used : 44 GB DataNode available : 191 GB DataNode total : 235 GB Volume count : 2 ... 注意:这里的 CubeFS 集群的 master 节点的 ip 和端口将在接下来的对象网关配置中使用。 1.2 启用对象网关 为了让 CubeFS 支持对象存储协议,您需要开启对象网关 [5]。对象网关的作用在于,它提供了与 S3 兼容的对象存储接口,这使得 CubeFS 不仅能够支持传统的 POSIX 文件系统接口,还能够支持 S3 兼容的对象存储接口。通过这种方式,CubeFS 能够融合这两种通用类型接口的优势,进而为用户提供更为灵活的数据存储及访问方案。具体而言,开启对象网关后,用户便可以利用原生的 Amazon S3 SDK 来操作存储在 CubeFS 中的文件,从而享受到对象存储的便利性。 为了启动对象网关,首先需要在 CubeFS 根目录下创建 objectnode.json 配置文件,objectnode.json 配置文件示例内容如下: { "role": "objectnode", "listen": "17410", "domains": [ "object.cfs.local" ], "logDir": "/cfs/Logs/objectnode", "logLevel": "info", "masterAddr": [ "172.16.1.101:17010", "172.16.1.102:17010", "172.16.1.103:17010" ], "exporterPort": 9503, "prof": "7013" } 注意:此处的 masterAddr 的 ip 和端口信息可以从上一步的 CubeFS 集群信息中获取。 然后使用以下命令启动对象网关: nohup ./build/bin/cfs-server -c objectnode.json & 1.3 创建 CubeFS 用户 创建 CubeFS 用户,并查询得到 AccessKey 以及 Secret AccessKey 等信息。 可以参考用户管理文档 [6] 进行创建并查询对应用户的信息。 CubeFS 支持多种创建方式,比如可以通过 AWS SDK [7] 的方式进行创建或者 HTTP 请求的方式创建,这里我们将演示通过 HTTP 请求的方式进行创建: 指定用户id,密码以及 type,并请求创建接口: curl -H "Content-Type:application/json" -X POST --data '{"id":"automq","pwd":"12345","type":3}' "http://172.16.1.101:17010/user/create" 通过用户 ID 查询用户信息: curl -v "http://10.196.59.198:17010/user/info?user=automq" | python -m json.tool 响应示例 { "user_id": "automq", "access_key": "UZONf5FF6WKwFCj4", "secret_key": "TRZzfPitQkxOLXqPhKMBRrDYUyXXMpWG", "policy": { "own_vols": ["vol1"], "authorized_vols": { "ltptest": [ "perm:builtin:ReadOnly", "perm:custom:PutObjectAction" ] } }, "user_type": 3, "create_time": "2024-06-06 09:25:04" } 1.4 使用 S3 接口创建 Bucket 使用 aws cli 工具在 CubeFS 上创建需要的 bucket 以用于 AutoMQ 的集群部署。拿到用户的 key 等信息,通过 aws configure 进行配置,并使用 aws cli 工具进行 bucket 的创建。 aws s3api create-bucket --bucket automq-data --endpoint=http://127.16.1.101:17140 aws s3api create-bucket --bucket automq-ops --endpoint=http://127.16.1.101:17140 使用命令查看已经有的 bucket aws s3 ls --endpoint=http://172.16.1.101:17140 1.5 准备部署 AutoMQ 所需的机器 准备 5 台主机用于部署 AutoMQ 集群。建议选择 2 核 16GB 内存的 Linux amd64 主机,并准备两个虚拟存储卷。示例如下: Tips:请确保这些机器处于相同的网段,可以互相通信非生产环境也可以只部署 1 台 Controller,默认情况下该 Controller 也同时作为 Broker 角色 从 AutoMQ Github Releases 下载最新的正式二进制安装包,用于安装 AutoMQ。 02 安装并启动 AutoMQ 集群 配置S3 URL 第一步:生成 S3 URL AutoMQ 提供了 automq-kafka-admin.sh 工具,用于快速启动 AutoMQ。只需提供包含所需 S3 接入点和身份认证信息的 S3 URL,即可一键启动 AutoMQ,无需手动生成集群 ID 或进行存储格式化等操作。 ### 命令行使用示例 bin/automq-kafka-admin.sh generate-s3-url \ --s3-access-key=xxx \ --s3-secret-key=yyy \ --s3-region=cn-northwest-1 \ --s3-endpoint=s3.cn-northwest-1.amazonaws.com.cn \ --s3-data-bucket=automq-data \ --s3-ops-bucket=automq-ops 如果遇到报错,请注意验证参数正确性以及格式。 当使用 CubeFS 时,可以采用如下的配置来生成具体的 S3URL。 输出结果 执行该命令后,将自动按以下阶段进行: 根据提供的 accessKey 和 secret Key 对 S3 基本功能进行探测,以验证 AutoMQ 和 S3 的兼容性。 根据身份信息,接入点信息生成 s3url。 根据 s3url 获取启动 AutoMQ 的命令示例。在命令中,将 --controller-list 和 --broker-list 替换为实际需要部署的 CONTROLLER 和 BROKER。 执行结果示例如下: ############ Ping s3 ######################## [ OK ] Write s3 object [ OK ] Read s3 object [ OK ] Delete s3 object [ OK ] Write s3 object [ OK ] Upload s3 multipart object [ OK ] Read s3 multipart object [ OK ] Delete s3 object ############ String of s3url ################ Your s3url is: s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=xxx&s3-secret-key=yyy&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA ############ Usage of s3url ################ To start AutoMQ, generate the start commandline using s3url. bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" TIPS: Please replace the controller-list and broker-list with your actual IP addresses. 第 2 步:生成启动命令列表 将上一步生成的命令中的 --controller-list 和 --broker-list 替换为你的主机信息,具体来说,将它们替换为环境准备中提到的 3 台 CONTROLLER 和 2 台 BROKER 的 IP 地址,并且使用默认的 9092 和 9093 端口。 bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" 参数说明 输出结果 执行命令后,会生成用于启动 AutoMQ 的命令。 ############ Start Commandline ############## To start an AutoMQ Kafka server, please navigate to the directory where your AutoMQ tgz file is located and run the following command. Before running the command, make sure that Java 17 is installed on your host. You can verify the Java version by executing 'java -version'. bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=1 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.2:9092,CONTROLLER://192.168.0.2:9093 --override advertised.listeners=PLAINTEXT://192.168.0.2:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=2 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.3:9092,CONTROLLER://192.168.0.3:9093 --override advertised.listeners=PLAINTEXT://192.168.0.3:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=3 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.4:9092 --override advertised.listeners=PLAINTEXT://192.168.0.4:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=4 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.5:9092 --override advertised.listeners=PLAINTEXT://192.168.0.5:9092 TIPS: Start controllers first and then the brokers. 注意:node.id 默认从 0 开始自动生成。 第 3 步:启动 AutoMQ 要启动集群,请在预先指定的 CONTROLLER 或 BROKER 主机上依次执行上一步命令中的命令列表。例如,在 192.168.0.1 上启动第一个 CONTROLLER 进程,执行生成的启动命令列表中的第一条命令模板。 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 参数说明 使用启动命令时,未指定的参数将采用 Apache Kafka 的默认配置。对于 AutoMQ 新增的参数,将使用 AutoMQ 提供的默认值。要覆盖默认配置,可以在命令末尾添加额外的 --override key=value 参数来覆盖默认值。 Tips: 若需启用持续流量重平衡或运行 Example: Self-Balancing When Cluster Nodes Change,建议在启动时为 Controller 明确指定参数 --override autobalancer.controller.enable=true。 在私有数据中心部署 AutoMQ 用于生产环境,需确保本地 SSD 的可靠性。由于 CubeFS 不支持高可用的块设备协议,它无法直接管理磁盘的冗余或者备份。但是您可以通过 RAID [8] 方案进行解决。 后台运行如果需要以后台模式运行,请在命令末尾添加以下代码: command > /dev/null 2>&1 & 至此,你已经完成了基于 CubeFS 的 AutoMQ 集群部署,拥有了一个低成本、低延迟、秒级弹性的 Kafka 集群了。如果你需要进一步体验 AutoMQ 的秒级分区迁移、持续自平衡等特性,可以参考官方示例。 参考资料 [1] CubeFS: https://www.cubefs.io/zh/ [2] CubeFS 的多级缓存: https://www.cubefs.io/zh/docs/master/overview/introduction.html [3] 依赖配置: CubeFS | A Cloud Native Distributed Storage System [4] CubeFS 单机部署: www.cubefs.io [5] 对象网关: https://www.cubefs.io/zh/docs/master/design/objectnode.html [6] CubeFS 用户管理文档: CubeFS | A Cloud Native Distributed Storage System [7] CubeFS AWS SDK: https://www.cubefs.io/zh/docs/master/user-guide/objectnode.html#%E6%94%AF%E6%8C%81%E7%9A%84sdk [8] RAID: https://www.cnblogs.com/chuncn/p/6008173.html END 关于我们 我们是来自 Apache RocketMQ 和 Linux LVS 项目的核心团队,曾经见证并应对过消息队列基础设施在大型互联网公司和云计算公司的挑战。现在我们基于对象存储优先、存算分离、多云原生等技术理念,重新设计并实现了 Apache Kafka 和 Apache RocketMQ,带来高达 10 倍的成本优势和百倍的弹性效率提升。 🌟 GitHub 地址:https://github.com/AutoMQ/automq 💻 官网:https://www.automq.com

优秀的个人博客,低调大师

NetCore集成Quart说明

.NET Core可以创建“定时”后台服务在 ASP.NET Core 中使用托管服务实现后台任务(例如,每10分钟运行一次任务),但是自带的后台服务应用场景太局限。在实际场景中,我们通常需要指定更复杂的时间参数。例如 凌晨2点30,每天的上午10点,每两小时一次,当处理这些复杂的时间时,自带的解决方案就显得格格不入了。 为些Quartz.NET提供了强大的解决方案, 通过使用Cron表达式,您可以确保任务在特定时间运行,或仅在特定的几天运行,或这些时间的任意组合。 Quart.Net介绍 概述 Quartz主要有三部分组成任务(Job)、触发器(Trigger)和调度器(Schedule)。 任务 Job就是执行的作业,Job需要继承IJob接口,实现Execute方法。Job中执行的参数从Execute方法的参数中获取。 触发器 触发器常用的有两种:SimpleTrigger触发器和CronTrigger触发器。 调度器 调度器就是将任务和触发器绑定,让触发器触发的时候去执行任务。上一个简单的案例 案例 1、首先Nuget包引用 nuget install Quartz.AspNetCore 2、定义一个Job任务 /// <summary> /// 创建IJob的实现类,并实现Excute方法 /// </summary> public class TestJob : IJob { public Task Execute(IJobExecutionContext context) { return Task.Run(() => { Console.WriteLine("output testjob log"); }); } } 3、Api控制器调用方法创建任务 [Route("quart")] [ApiController] public class QuartController : Controller { private readonly ISchedulerFactory _schedulerFactory; public QuartController(ISchedulerFactory schedulerFactory) { _schedulerFactory = schedulerFactory; } [HttpGet("CreateTask")] public async Task<IActionResult> CreateTask() { //通过调度工厂获得调度器 var _scheduler = await _schedulerFactory.GetScheduler(); //开启调度器 await _scheduler.Start(); //创建一个触发器 var trigger = TriggerBuilder.Create() .WithSimpleSchedule(x => x.WithIntervalInSeconds(2).RepeatForever())//每两秒执行一次 .Build(); //创建任务 var jobDetail = JobBuilder.Create<TestJob>() .WithIdentity("job", "group") .Build(); //将触发器和任务器绑定到调度器中 await _scheduler.ScheduleJob(jobDetail, trigger); return new JsonResult(new { success = true }); } } 调用 localhost://quart/createtask 即可以看控制台看到每隔俩秒钟输出一段控制台信息。 实例使用场景 上述的案例是一种通过自己创建三元素的方式来创建任务,在一些通用场景下其实我们只关心定时任务的逻辑和执行的频率,其他我可以不考虑。 即领导给了我一个任务,任务的功能是:开发一个定时任务,每天02:30执行,清理数据库历史记录。那么开发者最方便的方式是什么? 伪代码 1、定义执行Job class CleanJob{ [cron表达式] public void cleanDatabase(){ 业务逻辑 } } 2、注入任务 services.Register(typeof(CleanJob)) 如何能够通过这样的方式实现是最好的,但是现实是NetCore的quart.net现在还不支持这样的定义方式,java好像是可以的。 那有没有其他类似的方式可以实现上面的效果呢? 我给大家推荐一种方式 案例说明 1、定义一个初始化配置的服务注册 public static class QuartzIocExtend { public static void AddJobAndTrigger<T>(this IServiceCollectionQuartzConfigurator quartz, IConfiguration config, string category = "Default") w { string quartKey = "Quartz"; // 泛型Job的name string jobName = typeof(T).Name; // 从appsetting.json中获取任务job的corn执行表达式 var configKey = $"{quartKey}:{category}:{jobName}"; var cronSchedule = config[configKey]; // 校验cron表达式存在 if (string.IsNullOrEmpty(cronSchedule)) { throw new Exception($"No Quartz.NET Cron schedule found for job in configuration at {configKey}"); } // 注册job var jobKey = new JobKey(jobName); quartz.AddJob<T>(opts => opts.WithIdentity(jobKey)); //为job添加调度器 quartz.AddTrigger(opts => opts .ForJob(jobKey) .WithIdentity(jobName + "-cron-trigger") .WithCronSchedule(cronSchedule)); } 2、ConfigureServices中注册 //quartz 定时服务 services.AddQuartz(q => { q.UseMicrosoftDependencyInjectionScopedJobFactory(); q.AddJobAndTrigger<TestJob>(configuration); }); 3、配置文件定义cron表达式 "Quartz": { "Default": { //5秒钟执行一次 "TestJob":"0/5 * * * * ? *" } } 4、执行测试 测试结果正确,每五秒钟输出文本 参考 Quart.net官方文档 在.NET Core 中使用Quartz.NET .Net Core中使用Quartz.NET Quartz.Net使用教程 在ASP.NET Core中创建基于Quartz.NET托管服务轻松实现作业调度 最后 本文到此结束,希望对你有帮助 😃 如果还有什么疑问或者建议,可以多多交流,原创文章,文笔有限,才疏学浅,文中若有不正之处,万望告知。 更多精彩技术文章汇总在我的 公众号【程序员工具集】,持续更新,欢迎关注订阅收藏。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册