Hadoop MapReduce编程 API入门系列之挖掘气象数据版本2(十)
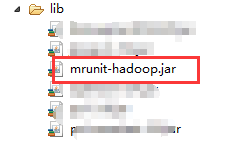
这篇博文,包括了,实际生产开发非常重要的,单元测试和调试代码。这里不多赘述,直接送上代码。 MRUnit 框架 MRUnit是Cloudera公司专为Hadoop MapReduce写的单元测试框架,API非常简洁实用。MRUnit针对不同测试对象使用不同的Driver: MapDriver:针对单独的Map测试 ReduceDriver:针对单独的Reduce测试 MapReduceDriver:将map和reduce串起来测试 PipelineMapReduceDriver:将多个MapReduce对串志来测试 记得,将这个jar包,放到工程项目里。我这里是在工程项目的根目录下的lib下。 代码版本2 编写TemperatureMapperTest.java的代码。 编译,出现以下,则说明无误。 在test()方法中,withInput的key/value参数分别为偏移量和一行气象数据,其类型要与TemperatureMapper的输入类型一致即为LongWritable和Text。 withOutput的key/value参数分别是我们期望输出的new Text("03103")和new IntWritable(200),我们要达到的测试效果就是我们的期望输出结果与 TemperatureMapper 的实际输出结果一致。 测试方法为 test() 方法,左边的对话框里显示"Runs:1/1,Errors:0,Failures:0",说明 Mapper 测试成功了。 创建TemperatureReduceTest.java,来对Reduce进行测试。 在test()方法中,withInput的key/value参数分别为new Text(key)和List类型的集合values。withOutput 的key/value参数分别是我们所期望输出的new Text(key)和new IntWritable(150),我们要达到的测试效果就是我们的期望输出结果与TemperatureReducer实际输出结果一致。 编写TemperatureReduceTest.java的代码。 编译,出现以下,则说明无误。 Reducer 端的单元测试,鼠标放在 TemperatureReduceTest 类上右击,选择 Run As ——> JUnit test,运行结果如下所示。 测试方法为 test() 方法,左边的对话框里显示"Runs:1/1,Errors:0,Failures:0",说明 Reducer 测试成功了。 MapReduce 单元测试 把 Mapper 和 Reducer 集成起来的测试案例代码如下。 创建TemperatureTest.java,来进行测试。 在 test() 方法中,withInput添加了两行测试数据line和line2,withOutput 的key/value参数分别为我们期望的输出结果new Text("03103")和new IntWritable(150)。我们要达到的测试效果就是我们期望的输出结果与Temperature实际的输出结果一致。 编写TemperatureTest.java的代码。 编译,出现以下,则说明无误。 Reducer 端的单元测试,鼠标放在 TemperatureTest.java类上右击,选择 Run As ——> JUnit test,运行结果如下所示。 测试方法为 test() 方法,左边的对话框里显示"Runs:1/1,Errors:0,Failures:0",说明 MapReduce 测试成功了。 Temperature.java代码 1 package zhouls.bigdata.myMapReduce.TemperatureTest; 2 3 import java.io.IOException; 4 5 import org.apache.hadoop.io.IntWritable; 6 import org.apache.hadoop.io.LongWritable; 7 import org.apache.hadoop.io.Text; 8 import org.apache.hadoop.mapreduce.Mapper; 9 import org.apache.hadoop.mapreduce.lib.input.FileSplit; 10 import org.apache.hadoop.conf.Configuration; 11 import org.apache.hadoop.conf.Configured; 12 import org.apache.hadoop.fs.FileSystem; 13 import org.apache.hadoop.fs.Path; 14 import org.apache.hadoop.io.IntWritable; 15 import org.apache.hadoop.io.Text; 16 import org.apache.hadoop.mapreduce.Job; 17 import org.apache.hadoop.mapreduce.Mapper; 18 import org.apache.hadoop.mapreduce.Reducer; 19 import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; 20 import org.apache.hadoop.mapreduce.lib.input.FileSplit; 21 import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; 22 import org.apache.hadoop.util.Tool; 23 import org.apache.hadoop.util.ToolRunner; 24 25 26 /* 27 Hadoop内置的数据类型: 28 BooleanWritable:标准布尔型数值 29 ByteWritable:单字节数值 30 DoubleWritable:双字节数值 31 FloatWritable:浮点数 32 IntWritable:整型数 33 LongWritable:长整型数 34 Text:使用UTF8格式存储的文本 35 NullWritable:当<key, value>中的key或value为空时使用 36 */ 37 38 39 /** 40 * 统计美国每个气象站30年来的平均气温 41 * 1、编写map()函数 42 * 2、编写reduce()函数 43 * 3、编写run()执行方法,负责运行MapReduce作业 44 * 4、在main()方法中运行程序 45 * 46 * @author zhouls 47 * 48 */ 49 //继承Configured类,实现Tool接口 50 public class Temperature extends Configured implements Tool{ 51 public static class TemperatureMapper extends Mapper<LongWritable, Text, Text, IntWritable>{ 52 //输入的key,输入的value,输出的key,输出的value 53 //输入的LongWritable键是某一行起始位置相对于文件起始位置的偏移量,不过我们不需要这个信息,所以将其忽略。 54 55 // 在这种情况下,我们将气象站id按 Text 对象进行读/写(因为我们把气象站id当作键),将气温值封装在 IntWritale 类型中。只有气温数据不缺失,这些数据才会被写入输出记录中。 56 57 58 // map 函数的功能仅限于提取气象站和气温信息 59 60 /** 61 * @function Mapper 解析气象站数据 62 * @input key=偏移量 value=气象站数据 63 * @output key=weatherStationId value=temperature 64 */ 65 public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException{ 66 //map()函数还提供了context实例,用于键值对的输出 或者说 map() 方法还提供了 Context 实例用于输出内容的写入 67 68 // 就本示例来说,输入键是一个长整数偏移量,输入值是一行文本,输出键是气象站id,输出值是气温(整数)。 69 // 同时context作为了map和reduce执行中各个函数的一个桥梁,这个设计和Java web中的session对象、application对象很相似 70 71 72 //第一步,我们将每行气象站数据转换为每行的String类型 73 String line = value.toString(); //每行气象数据 74 // values是1980 12 01 00 78 -17 10237 180 21 1 0 0 75 // line是"1980 12 01 00 78 -17 10237 180 21 1 0 0" 76 77 78 //第二步:提取气温值 79 int temperature = Integer.parseInt(line.substring(14, 19).trim());//每小时气温值 80 //需要转换为整形,截取第14位到19位,从第0位开始,trim()的功能是去掉首尾空格。 81 //substring()方法截取我们业务需要的值 82 83 // substring(start, stop)其内容是从 start 处到 stop-1 处的所有字符,其长度为 stop 减 start。 84 85 // 如Hello world! 若是substring(3,7) 则是lo w 86 87 // Integer.parseInt() 返回的是一个int的值。在这里, 给temperature 88 89 // new Integer.valueof()返回的是Integer的对象。 90 // Integer.parseInt() 返回的是一个int的值。 91 // new Integer.valueof().intValue();返回的也是一个int的值。 92 93 94 95 96 97 // 1980 12 01 00 78 -17 10237 180 21 1 0 0 98 //78是气温值 99 100 // temperature是78 101 102 // 30yr_03103.dat 103 // 30yr_03812.dat 104 // 30yr_03813.dat 105 // 30yr_03816.dat 106 // 30yr_03820.dat 107 // 30yr_03822.dat 108 // 30yr_03856.dat 109 // 30yr_03860.dat 110 // 30yr_03870.dat 111 // 30yr_03872.dat 112 113 114 // (0,1985 07 31 02 200 94 10137 220 26 1 0 -9999) 115 // (62,1985 07 31 03 172 94 10142 240 0 0 0 -9999) 116 // (124,1985 07 31 04 156 83 10148 260 10 0 0 -9999) 117 // (186,1985 07 31 05 133 78 -9999 250 0 -9999 0 -9999) 118 // (248,1985 07 31 06 122 72 -9999 90 0 -9999 0 0) 119 // (310,1985 07 31 07 117 67 -9999 60 0 -9999 0 -9999) 120 // (371,1985 07 31 08 111 61 -9999 90 0 -9999 0 -9999) 121 // (434,1985 07 31 09 111 61 -9999 60 5 -9999 0 -9999) 122 // (497,1985 07 31 10 106 67 -9999 80 0 -9999 0 -9999) 123 // (560,1985 07 31 11 100 56 -9999 50 5 -9999 0 -9999) 124 125 // (03103,[200,172,156,133,122,117,111,111,106,100]) 126 127 // 根据自己业务需要 , map 函数的功能仅限于提取气象站和气温信息 128 129 130 // 1998 #year 131 // 03 #month 132 // 09 #day 133 // 17 #hour 134 // 11 #temperature 感兴趣 135 // -100 #dew 136 // 10237 #pressure 137 // 60 #wind_direction 138 // 72 #wind_speed 139 // 0 #sky_condition 140 // 0 #rain_1h 141 // -9999 #rain_6h 142 143 144 if (temperature != -9999){//过滤无效数据 145 //第三步:提取气象站编号 146 //获取输入分片 147 FileSplit fileSplit = (FileSplit) context.getInputSplit();//提取问加你输入分片,并转换类型 148 // 即由InputSplit -> FileSplit 149 150 // context.getInputSplit() 151 // (FileSplit) context.getInputSplit()这是强制转换 152 // fileSplit的值是file:/D:/Code/MyEclipseJavaCode/myMapReduce/data/temperature/30yr_03870.dat:0+16357956 153 // 即,读的是30yr_03870.dat这个文件 154 155 156 //然后通过文件名称提取气象站编号 157 String weatherStationId = fileSplit.getPath().getName().substring(5, 10);//通过文件名称提取气象站id 158 //首先通过文件分片fileSplit来获取文件路径,然后再获取文件名字,然后截取第5位到第10位就可以得到气象站 编号 159 // fileSplit.getPath() 160 // fileSplit.getPath().getName() 161 162 // 30yr_03870.dat 我们只需获取03870就是气象站编号 163 164 // fileSplit.getPath().getName().substring(5, 10) //从0开始,即第5个开始截取,到第10个为止,第10个没有拿到,所以为03870 165 // weatherStationId是03870 166 167 168 169 context.write(new Text(weatherStationId), new IntWritable(temperature));//写入weatherStationId是k2,temperature是v2 170 // context.write(weatherStationId,temperature);等价 ,但是若是直接这样写会出错,因为, weatherStationId是String类型,注意与Text类型还是有区别的! 171 //气象站编号,气温值 172 } 173 } 174 } 175 176 177 178 public static class TemperatureReducer extends Reducer< Text, IntWritable, Text, IntWritable>{ 179 private IntWritable result = new IntWritable();//存取结果 180 //因为气温是IntWritable类型 181 public void reduce(Text key, Iterable<IntWritable> values,Context context) throws IOException, InterruptedException{ 182 // Iterable<IntWritable> values是iterable(迭代器)变量 183 184 185 // Iterable<IntWritable> values和IntWritable values这样有什么区别? 186 // 前者是iterable(迭代器)变量,后者是intwriteable(int的封装)变量 187 188 189 // Iterable<IntWritable> values 190 // 迭代器,valuses是 iterable(迭代器)变量,类型是IntWritable 191 192 193 //reduce输出的key,key的集合,context的实例 194 //第一步:统计相同气象站的所有气温 195 int sum = 0; 196 int count = 0; 197 for (IntWritable val : values) //星型for循环来循环同一个气象站的所有气温值,即将values的值一一传给IntWritable val 198 // IntWritable val是IntWritable(int的封装)变量 199 200 {//对所有气温值累加 201 sum += val.get();//去val里拿一个值,就sum下 202 203 // val.get()去拿值 204 205 count++; 206 } 207 result.set(sum / count);//设为v3 208 // result.set(sum / count)去设置,将sum / count的值,设给result 209 // sum是21299119 count是258616 = 82.3580869 210 211 212 context.write(key,result);//写入key是k3,result是v3 213 } 214 } 215 216 217 218 public int run(String[] args) throws Exception{ 219 // TODO Auto-generated method stub 220 //第一步:读取配置文件 221 Configuration conf = new Configuration();//程序里,只需写这么一句话,就会加载到hadoop的配置文件了 222 //Configuration类代表作业的配置,该类会加载mapred-site.xml、hdfs-site.xml、core-site.xml等配置文件。 223 224 // new Configuration() 225 226 //第二步:输出路径存在就先删除 227 Path mypath = new Path(args[1]);//定义输出路径的Path对象,mypath 228 229 230 // new Path(args[1])将args[1]的值,给mypath 231 232 FileSystem hdfs = mypath.getFileSystem(conf);//程序里,只需写这么一句话,就可以获取到文件系统了。 233 //FileSystem里面包括很多系统,不局限于hdfs,是因为,程序读到conf,哦,原来是hadoop集群啊。这时,才认知到是hdfs 234 235 if (hdfs.isDirectory(mypath))//如果输出路径存在 236 { 237 hdfs.delete(mypath, true);//则就删除 238 } 239 //第三步:构建job对象 240 Job job = new Job(conf, "temperature");//新建一个任务,job名字是tempreature 241 242 // new Job(conf, "temperature")有这么个构造方法 243 244 job.setJarByClass(Temperature.class);// 设置主类 245 //通过job对象来设置主类Temperature.class 246 247 //第四步:指定数据的输入路径和输出路径 248 FileInputFormat.addInputPath(job, new Path(args[0]));// 输入路径,args[0] 249 FileOutputFormat.setOutputPath(job, new Path(args[1]));// 输出路径,args[1] 250 251 //第五步:指定Mapper和Reducer 252 job.setMapperClass(TemperatureMapper.class);// Mapper 253 job.setReducerClass(TemperatureReducer.class);// Reducer 254 255 //第六步:设置map函数和reducer函数的输出类型 256 job.setOutputKeyClass(Text.class); 257 job.setOutputValueClass(IntWritable.class); 258 259 //第七步:提交作业 260 return job.waitForCompletion(true)?0:1;//提交任务 261 } 262 263 264 /** 265 * @function main 方法 266 * @param args 267 * @throws Exception 268 */ 269 public static void main(String[] args) throws Exception { 270 //第一步 271 // String[] args0 = 272 // { 273 // "hdfs://djt002:9000/inputData/temperature/", 274 // "hdfs://djt002:9000/outData/temperature/" 275 // }; 276 277 String[] args0 = {"./data/temperature/","./out/temperature/"}; 278 279 // args0是输入路径和输出路径的属组 280 281 //第二步 282 int ec = ToolRunner.run(new Configuration(), new Temperature(), args0); 283 284 // ToolRunner.run(new Configuration(), new Temperature(), args0)有这么一个构造方法 285 286 //第一个参数是读取配置文件,第二个参数是主类Temperature,第三个参数是输入路径和输出路径的属组 287 System.exit(ec); 288 } 289 290 } 291 TemperatureMapperTest.java 1 package zhouls.bigdata.myMapReduce.TemperatureTest; 2 3 import java.io.IOException; 4 5 6 import org.apache.hadoop.io.IntWritable; 7 import org.apache.hadoop.io.LongWritable; 8 import org.apache.hadoop.io.Text; 9 import org.apache.hadoop.mapreduce.Mapper; 10 import org.apache.hadoop.mrunit.mapreduce.MapDriver; 11 import org.junit.Before; 12 import org.junit.Test; 13 14 /** 15 * Mapper 端的单元测试,这里用MRUnit框架,需要使用mrunit-hadoop.jar 16 */ 17 @SuppressWarnings("all")//告诉编译器忽略指定的警告,不用在编译完成后出现警告信息 18 public class TemperatureMapperTest{ 19 private Mapper mapper;//定义一个Mapper对象,是mapper 20 private MapDriver driver;//定义一个MapDriver对象,是driver,因为是要MapDriver去做! 21 22 @Before//@Before是在所拦截单元测试方法执行之前执行一段逻辑,读艾特Before 23 public void init(){//初始化方法init 24 mapper = new Temperature.TemperatureMapper();//实例化一个Temperature中的TemperatureMapper对象 25 driver = new MapDriver(mapper);//实例化MapDriver对象 26 } 27 28 29 @Test//@Test是测试方法提示符,一般与@Before组合使用 30 public void test() throws IOException{ 31 //因为测试的是Map 32 //输入一行测试数据 33 String line = "1985 07 31 02 200 94 10137 220 26 1 0 -9999"; 34 driver.withInput(new LongWritable(), new Text(line))//withInput方法是第一行输入 跟TemperatureMapper输入类型一致 35 .withOutput(new Text("03103"), new IntWritable(200))//withOutput方法是输出 跟TemperatureMapper输出类型一致 36 .runTest();//runTest方法是调用运行方法 37 } 38 } TemperatureReduceTest.java代码 1 package zhouls.bigdata.myMapReduce.TemperatureTest; 2 3 import java.io.IOException; 4 5 import java.util.ArrayList; 6 import java.util.List; 7 import org.apache.hadoop.io.IntWritable; 8 import org.apache.hadoop.io.Text; 9 import org.apache.hadoop.mapreduce.Reducer; 10 import org.apache.hadoop.mrunit.mapreduce.ReduceDriver; 11 import org.junit.Before; 12 import org.junit.Test; 13 14 /** 15 * Reducer 单元测试,这里用MRUnit框架,需要使用mrunit-hadoop.jar 16 */ 17 @SuppressWarnings("all")//告诉编译器忽略指定的警告,不用在编译完成后出现警告信息 18 public class TemperatureReduceTest{ 19 private Reducer reducer;//定义一个Reducer对象,是 reducer 20 private ReduceDriver driver;//定义一个ReduceDriver对象,是driver,因为是要ReduceDriver去做! 21 22 @Before//@Before是在所拦截单元测试方法执行之前执行一段逻辑,读艾特Before 23 public void init(){//初始化方法init 24 reducer = new Temperature.TemperatureReducer();//实例化一个Temperature中的TemperatureReducer对象 25 driver = new ReduceDriver(reducer);//实例化ReduceDriver对象 26 } 27 28 @Test//@Test是测试方法提示符,一般与@Before搭配使用 29 public void test() throws IOException{//为了模拟在reduer端单元测试,所以需如下 30 String key = "03103";//声明一个key值 31 List values = new ArrayList(); 32 values.add(new IntWritable(200));//添加第一个value值 33 values.add(new IntWritable(100));//添加第二个value值 34 driver.withInput(new Text(key), values)//withInput方法是第一行输入 跟TemperatureReducer输入类型一致 35 .withOutput(new Text(key), new IntWritable(150))//withOutput方法是输出 跟TemperatureReducer输出类型一致 36 .runTest();//runTest方法是调用运行方法 37 } 38 } TemperatureTest.java代码 1 package zhouls.bigdata.myMapReduce.TemperatureTest; 2 3 import java.io.IOException; 4 5 import org.apache.hadoop.io.IntWritable; 6 import org.apache.hadoop.io.LongWritable; 7 import org.apache.hadoop.io.Text; 8 import org.apache.hadoop.mapreduce.Mapper; 9 import org.apache.hadoop.mapreduce.Reducer; 10 import org.apache.hadoop.mrunit.mapreduce.MapReduceDriver; 11 import org.junit.Before; 12 import org.junit.Test; 13 14 /** 15 * Mapper 和 Reducer 集成起来测试,这里用MRUnit框架 16 */ 17 @SuppressWarnings("all") 18 public class TemperatureTest { 19 private Mapper mapper;//定义一个Mapper对象 20 private Reducer reducer;//定义一个Reducer对象 21 private MapReduceDriver driver;//定义一个MapReduceDriver对象是driver,因为是对map和reducer联合起来测试,所以需要MapReduceDriver去做! 22 23 @Before//@Before是在所拦截单元测试方法执行之前执行一段逻辑,读艾特Before 24 public void init(){ //初始化方法init 25 mapper = new Temperature.TemperatureMapper();//实例化一个Temperature中的TemperatureMapper对象 26 reducer = new Temperature.TemperatureReducer();//实例化一个Temperature中的TemperatureReducer对象 27 driver = new MapReduceDriver(mapper, reducer);//实例化MapReduceDriver对象 28 } 29 30 @Test//@Test是测试方法提示符 31 public void test() throws RuntimeException, IOException{ 32 //输入两行行测试数据 33 String line = "1985 07 31 02 200 94 10137 220 26 1 0 -9999"; 34 String line2 = "1985 07 31 11 100 56 -9999 50 5 -9999 0 -9999"; 35 driver.withInput(new LongWritable(), new Text(line))//withInput方法是第一行输入 跟TemperatureMapper输入类型一致 36 .withInput(new LongWritable(), new Text(line2))//第二行输入 37 .withOutput(new Text("03103"), new IntWritable(150))//withOutput方法是输出 跟TemperatureReducer输出类型一致 38 .runTest();//runTest方法是调用运行方法 39 } 40 } 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6164003.html,如需转载请自行联系原作者