首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10000篇文章
优秀的个人博客,低调大师

【HarmonyOS NEXT】定位相关知识(Locationkit)

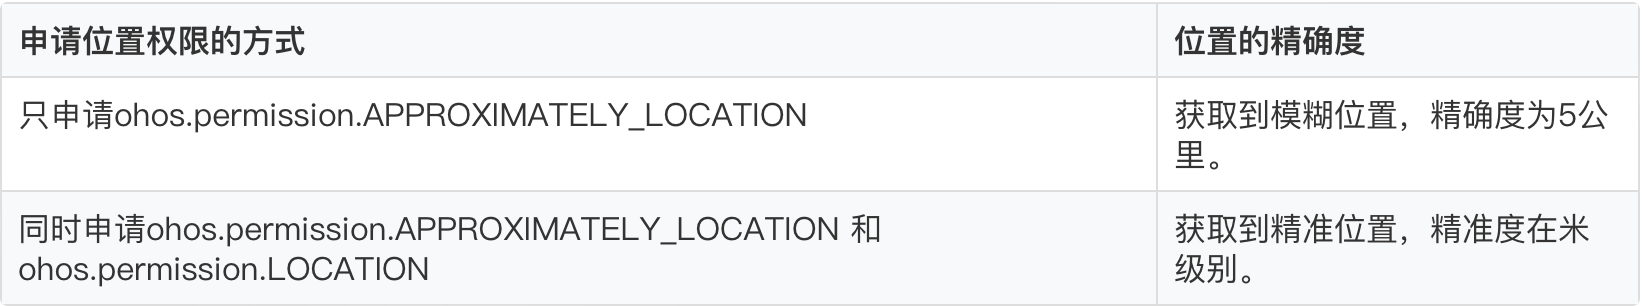
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-csdn&ha_sourceId=89000445 简介 LocationKit提供了定位服务、地理围栏、地理编码、逆地理编码和国家码等功能。 可以实现点击获取用户位置信息、持续获取位置信息和区域进出监控等多项功能。 需要注意,需要确定用户已经开启定位信息,一下的代码没有做这一步的操作,默认开启了。 权限 如果应用需要在后台运行时访问设备位置,还需要申请ohos.permission.LOCATION_IN_BACKGROUND权限。 这里强烈推荐大家去使用 旺旺崔冰冰 大佬的工具库(ef-tool)以下的权限获取代码来自大佬的工具库权限相关的代码。 定位信息Location参数 单次获取设备定位信息 有两种方式,分别是获取系统缓存的最新位置和获取当前位置。 获取缓存的位置,可以减少系统功耗。如果对时间精度要求较高,直接获取当前位置较好。 以下是完整的代码 持续获取设备定位信息 地理编码地址获取 两种方式:通过经纬度坐标获取和通过详细地址描述获取。 (转载自51CTO,作者:奥尼5354)

优秀的个人博客,低调大师

flv.js源码知识

1 网速计算 在音视频播放的场景中,用户的网速是影响体验的重要因素,播放器在播放的过程中,可以计算单位时间获取的数据量来衡量网速。flv.js的实例提供了statistics_info事件获取当前的网速。 flvPlayer.on('statistics_info', function(res) { console.log('statistics_info',res); }) res结构如下: { currentSegmentIndex: 0, decodedFrames: 15, droppedFrames: 0, hasRedirect: false, loaderType: "fetch-stream-loader", playerType: "FlvPlayer", speed: 395.19075278358656, totalSegmentCount: 1, url: "https:/example.com/1.flv" } 其中的speed字段就是网速,单位是KB/s, 下面就看关于网速计算相关的部分。statistics_info事件中获取网速的整体流程如下图: IOController中控制每次把加载的字节数添加到SpeedSampler中,对外提供的lastSecondKBps属性是最近有数据一秒的网速。 TransmuxingController中控制播放器在加载数据的时候开启定时器获取统计数据,向上触发事件。 核心的计算还是SpeedSampler类, lastSecondKBps是getter属性获取最近有数据一秒的网速,代码含义参考注释。 get lastSecondKBps () { // 如果够1s计算 this._lastSecondBytes this.addBytes(0) // 上1秒的_lastSecondBytes有数据 就直接返回 // 这个巧妙的是 感觉不是准确的1s 但是又是准确的 因为如果是超过1秒就不继续添加了 1秒内的就添加进去了。 // 如果上一秒有数据则返回 if (this._lastSecondBytes !== 0) { return this._lastSecondBytes / 1024 } else { // 如果上一秒的速度是0,并且距离上次计算超过了500ms 则用_intervalBytes和durationSeconds进行计算 if (this._now() - this._lastCheckpoint >= 500) { // if time interval since last checkpoint has exceeded 500ms // the speed is nearly accurate return this.currentKBps } else { // We don't know return 0 } } } 下面是addBytes方法,根据本次调用的时间和上一次计算时间的差值做不同处理,具体参见代码注释,这种计算的思路是挺巧妙的,开始以为不准切,但是仔细思考是能准确计算最近有数据一秒的网速。一直强调是最近有数据一秒的网速而不是上一秒的网速。 addBytes (bytes) { // 如果是第一次调用则 记录_firstCheckpoint _lastCheckpoint if (this._firstCheckpoint === 0) { this._firstCheckpoint = this._now() this._lastCheckpoint = this._firstCheckpoint this._intervalBytes += bytes this._totalBytes += bytes } else if (this._now() - this._lastCheckpoint < 1000) { // 小于1s 就添加 _intervalBytes this._intervalBytes += bytes this._totalBytes += bytes } else { // duration >= 1000 // 只有大于1秒的时候才计算_lastSecondBytes // 就是这1s内的_intervalBytes this._lastSecondBytes = this._intervalBytes this._intervalBytes = bytes // 并且重新开始计算_intervalBytes 大于1秒的这次数据算在下1秒 this._totalBytes += bytes this._lastCheckpoint = this._now() } } 下面是currentKBps getter属性,在lastSecondKBps中只有当超过因为如果durationSeconds大于0.5时才使用currentKBps属性,因为如果durationSeconds过小,会过大估计了网速。 get currentKBps () { this.addBytes(0) let durationSeconds = (this._now() - this._lastCheckpoint) / 1000 if (durationSeconds == 0) durationSeconds = 1 return (this._intervalBytes / durationSeconds) / 1024 } 平均网速averageKBps, 如果中途出现网络中断或者暂停的情况会拉低平均网速。 get averageKBps () { let durationSeconds = (this._now() - this._firstCheckpoint) / 1000 return (this._totalBytes / durationSeconds) / 1024 } 2 数据缓存处理 这里讲的缓存是指使用loader获取数据后到传给FLVDemuxer过程中的缓存。这个过程中为什么需要缓存呢?因为FLV格式数据的解封是以TAG为单位,而过来的数据是流式的字节,不可能每次是完整的TAG,所以FLVDemuxer每次只处理当前数据中完整的TAG,没有处理的部分就缓存起来,和下次获取的数据拼接。 通过上面的原理介绍,你应该可以猜到这个过程是放在IOController中,我们先分解缓存中使用到的几个关键API和操作方法。 2.1 二进制缓存区格式 ArrayBuffer 对象用来表示通用的、固定长度的原始二进制数据缓冲区。 你不能直接操作 ArrayBuffer 的内容,而是要通过类型数组对象或 DataView 对象来操作,它们会将缓冲区中的数据表示为特定的格式,并通过这些格式来读写缓冲区的内容。 这里的定义 关键有两点,一是ArrayBuffer是固定长度,所以扩展的话需要创建新的然后把数据复制过去,而是不能直接操作,二是 不能直接操作,需要用类型数据对象,我们这里用Uint8Array,因为8位无符号正好是以一个字节为单位。我们这里对缓存的处理,暂时不需要读取指定的字节,目前只需要能够读取指定位置的数据即可。 2.2 缓存区操作API Uint8Array 数组类型表示一个8位无符号整型数组,创建时内容被初始化为0。创建完后,可以以对象的方式或使用数组下标索引的方式引用数组中的元素。 new Uint8Array(buffer [, byteOffset [, length]]); 说明:在ArrayBuffer上创建Uint8Array对象,使缓存区可操作。 参数: buffer为ArrayBuffer对象,byteOffset指定ArrayBuffer的起始字节数,length指定创建的长度。 typedarray.set(typedarray[, offset]) 说明:Uint8Array属于typedarray, set方法可以从指定类型化数据中读取值,并将其存储在类型化数组中的指定位置。 参数:typedarray是指要拷贝的源数据,offset指拷贝到目标数据的起始位置。 2.3 方法一 扩展缓存 根据上面的api,把长度为100的ArrayBuffer扩展为长度为1000的ArrabyBuffer。 const oldbuffer = new ArrayBuffer(100); const u1 = new Uint8Array(oldbuffer, 0); const newbuffer = new ArrayBuffer(1000); const u2 = new Uint8Array(newbuffer,0); u2.set(u1,0); 2.4 方法二 消费缓存 记录缓存消费位置,消费一部分后重新设置缓存。 let stashUsed = 100; let bufferSize = 1024; let stashBuffer = new ArrayBuffer(1024); // 消费数据 返回消费的字节数 let consumed = dispatchChunks(stashBuffer.slice(0, stashUsed),stashUsed); let allBuffer = new Uint8Array(stashBuffer, 0, bufferSize); let remainBuffer = new Uint8Array(stashBuffer, consumed); allBuffer.set(remainBuffer,0); stashUsed = stashUsed-consumed; 2.5 缓存源码 下面就来看IOController中缓存数据的代码。 几个变量和方法的含义: this._stashBuffer ArrayBuffer类型 存放数据的缓存区 this._bufferSize 缓存区的大小 this._stashBuffer的长度 this._stashUsed 缓存区中使用的缓存大小 this._stashByteStart 已经消费的部分在整个流中的开始位置 this._expandBuffer() 扩展缓存的方法 this.this._dispatchChunks() 消费缓存数据的方法 返回消费的数量 chunk ajax获取的二进制数据 有了上面的准备,就可以直接看缓存处理的代码了 // 缓存中没有数据的情况 if (this._stashUsed === 0) { // 直接消费 let consumed = this._dispatchChunks(chunk, byteStart); // 如果有剩余 if (consumed < chunk.byteLength) { // 未处理的数据长度 let remain = chunk.byteLength - consumed; // 如果数据超过缓存 则扩展缓存 if (remain > this._bufferSize) { this._expandBuffer(remain); } // 在_stashBuffer上创建 Uint8Array使其可以操作 let stashArray = new Uint8Array(this._stashBuffer, 0, this._bufferSize); // 从chunk的 consumed开始获取数据 然后从第0位置开始写入stashArray中 stashArray.set(new Uint8Array(chunk, consumed), 0); // 记录stashUsed的大小 this._stashUsed += remain; // 记录整个流中的开始位置 this._stashByteStart = byteStart + consumed; } } else { // 缓存中有数据的情况 // 先扩展缓存 能够放下已存在的和当前获取的 if (this._stashUsed + chunk.byteLength > this._bufferSize) { this._expandBuffer(this._stashUsed + chunk.byteLength); } let stashArray = new Uint8Array(this._stashBuffer, 0, this._bufferSize); // 先把获取到的chunk 放入缓存中 从_stashUsed的offset开始存放 stashArray.set(new Uint8Array(chunk), this._stashUsed); // 重置_stashUsed this._stashUsed += chunk.byteLength; // 把缓存中的数据全部读出进行消费 let consumed = this._dispatchChunks(this._stashBuffer.slice(0, this._stashUsed), this._stashByteStart); // 如果消费了有剩余 if (consumed < this._stashUsed && consumed > 0) { // unconsumed data remain // 从consumed开始截取数据 let remainArray = new Uint8Array(this._stashBuffer, consumed); // 从0开始设置 剩下的数据作为缓存 并且改变_stashUsed 记录缓存的位置 stashArray.set(remainArray, 0); } // 重新设置_stashUsed this._stashUsed -= consumed; this._stashByteStart += consumed; } 上面的代码是每次来数据都会调用this._dispatchChunks进行消费操作,其实还有一种处理情况,通过变量this._enableStash控制,上面的情况是this._enableStash为false。如果为true的话区别是只有缓存的数据达到this._stashSize大小时,才会触发this._dispatchChunks进行消费操作。 总体的流程是如果数据小于this._stashSize 则往缓存中添加,如果大于继续下面的判断 如果缓存中没有数据 则直接消费本地来的数据,如果有数据则消费缓存中的数据 消费之后再把本地来的数据放入缓存。具体参见代码 if (this._stashUsed === 0 && this._stashByteStart === 0) { // seeked? or init chunk? // This is the first chunk after seek action this._stashByteStart = byteStart; } // 不满_stashSize 就会先往缓存中存放 _stashSize会动态调整 if (this._stashUsed + chunk.byteLength <= this._stashSize) { let stashArray = new Uint8Array(this._stashBuffer, 0, this._stashSize); stashArray.set(new Uint8Array(chunk), this._stashUsed); this._stashUsed += chunk.byteLength; } else { // stashUsed + chunkSize > stashSize, size limit exceeded let stashArray = new Uint8Array(this._stashBuffer, 0, this._bufferSize); if (this._stashUsed > 0) { // There're stash datas in buffer // 如果有缓存 先消费缓存中的数据 let buffer = this._stashBuffer.slice(0, this._stashUsed); let consumed = this._dispatchChunks(buffer, this._stashByteStart); if (consumed < buffer.byteLength) { if (consumed > 0) { let remainArray = new Uint8Array(buffer, consumed); stashArray.set(remainArray, 0); this._stashUsed = remainArray.byteLength; this._stashByteStart += consumed; } } else { this._stashUsed = 0; this._stashByteStart += consumed; } // 消费完缓存中的数据之后,然后再把这次过来的chunk放入缓存中 if (this._stashUsed + chunk.byteLength > this._bufferSize) { this._expandBuffer(this._stashUsed + chunk.byteLength); stashArray = new Uint8Array(this._stashBuffer, 0, this._bufferSize); } stashArray.set(new Uint8Array(chunk), this._stashUsed); this._stashUsed += chunk.byteLength; } else { // stash buffer empty, but chunkSize > stashSize (oh, holy shit) // dispatch chunk directly and stash remain data // 如果缓存中没有数据 直接消费本次来的数据 let consumed = this._dispatchChunks(chunk, byteStart); if (consumed < chunk.byteLength) { let remain = chunk.byteLength - consumed; if (remain > this._bufferSize) { this._expandBuffer(remain); stashArray = new Uint8Array(this._stashBuffer, 0, this._bufferSize); } stashArray.set(new Uint8Array(chunk, consumed), 0); this._stashUsed += remain; this._stashByteStart = byteStart + consumed; } } } 关于this._stashSize还有两个问题, 一是this._stashSize的大小会根据网速进行调整,二是this._stashSize是小于等于this._bufferSize缓存大小,所以this._stashSize变化时也需要扩展缓存。 // 先看获取网速的代码。 //网速计算 this._speedSampler.addBytes(chunk.byteLength); // adjust stash buffer size according to network speed dynamically // 获取当前网速 let KBps = this._speedSampler.lastSecondKBps; if (KBps !== 0) { // 正规化网速 let normalized = this._normalizeSpeed(KBps); if (this._speedNormalized !== normalized) { this._speedNormalized = normalized; this._adjustStashSize(normalized); } } 其中的_normalizeSpeed方法是在给定的速度中二分查找最接近网速的大小。 this._speedNormalizeList = [64, 128, 256, 384, 512, 768, 1024, 1536, 2048, 3072, 4096]; _normalizeSpeed(input) { let list = this._speedNormalizeList; let last = list.length - 1; let mid = 0; let lbound = 0; let ubound = last; if (input < list[0]) { return list[0]; } // binary search while (lbound <= ubound) { mid = lbound + Math.floor((ubound - lbound) / 2); if (mid === last || (input >= list[mid] && input < list[mid + 1])) { return list[mid]; } else if (list[mid] < input) { lbound = mid + 1; } else { ubound = mid - 1; } } } _adjustStashSize是调整this._stashSize的方法,当缓存的大小小于this._stashSize时,则进行扩展。 _adjustStashSize(normalized) { let stashSizeKB = 0; // 如果是直播 if (this._config.isLive) { // live stream: always use single normalized speed for size of stashSizeKB stashSizeKB = normalized; } else { if (normalized < 512) { stashSizeKB = normalized; } else if (normalized >= 512 && normalized <= 1024) { stashSizeKB = Math.floor(normalized * 1.5); } else { stashSizeKB = normalized * 2; } } // 最大是8K if (stashSizeKB > 8192) { stashSizeKB = 8192; } let bufferSize = stashSizeKB * 1024 + 1024 * 1024 * 1; // stashSize + 1MB // 如果缓存小则扩展缓存 if (this._bufferSize < bufferSize) { this._expandBuffer(bufferSize); } this._stashSize = stashSizeKB * 1024; } 扩展缓存的_expandBuffer方法和我们写的demo很相似。 _expandBuffer(expectedBytes) { let bufferNewSize = this._stashSize; // 每次*2 直到大于expectedBytes while (bufferNewSize + 1024 * 1024 * 1 < expectedBytes) { bufferNewSize *= 2; } bufferNewSize += 1024 * 1024 * 1; // bufferSize = stashSize + 1MB if (bufferNewSize === this._bufferSize) { return; } // 新的缓存区 let newBuffer = new ArrayBuffer(bufferNewSize); // 旧缓存区有数据 则进行拷贝 if (this._stashUsed > 0) { // copy existing data into new buffer let stashOldArray = new Uint8Array(this._stashBuffer, 0, this._stashUsed); let stashNewArray = new Uint8Array(newBuffer, 0, bufferNewSize); stashNewArray.set(stashOldArray, 0); } // 重设缓存区和缓存区大小 this._stashBuffer = newBuffer; this._bufferSize = bufferNewSize; }

优秀的个人博客,低调大师

知识卡片 回归性能度量 Log Loss

对数损失 Log Loss 又称交叉熵损失 cross-entropy loss,两者名称不同,其实是等价的 ,常用于评价逻辑回归和神经网络。 什么是逻辑回归 Logistics Regression? 与线性回归估计出Y的是一个连续型的计量数值不同,逻辑回归其实是一个分类方法。在二元逻辑回归中应变量Y是0和1,Y属于分类数据,估计结果是一个概率,自变量是可以包含多个对因变量有影响的因素,可以是连续也可是分类数据;通过逻辑回归,得出每个自变量的权重以及一个事件发生的概率。 二类分类问题的Log Loss: 注:pr 是按照回归模型得出的概率 举例说明: 假设有四个测试样本,y_true 列表是样本的真实值,y_pred 列表中有四个元素,每个样本元素有两个数值,分别表示不同类标签(0和1)的预测概率,其和为1。y_pred中的第一样本的两个元素[.9, .1] 表示样本1有90%的概率属于标签y=0, 10%的概率属于标签y=1;依次计算每个样本的逻辑损失,以e为底数算对数值,样本求平均得出Log Loss。 多类分类的交叉熵(cross-entropy loss)损失: 交叉熵公式中,N为测试样本总数,Yi,k 表示第 i 个样本中的第 k 个标签的真实值。pi,k 表示预测值。 举例说明: 好文章,我在看❤ 本文分享自微信公众号 - DataScience(DataScienceTeam)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

知识卡片 循环神经网络 RNN

前言:本文简要介绍了循环神经网络RNN以及其变体长短时记忆LSTM和双向循环网络。 循环神经网络 RNN-RecurrentNeural Network 序列数据 RNN建模的适合于序列数据,例如根据股票价格随时间的走势预测未来;视频中的每一帧属于帧序列,可以预测下一帧的内容,进行动作补偿。 自然语言处理中,如大话西游的台词,这里的括号填什么呢?不可能填写我没有去北京,上海,因为需要上下文的词序列来进行预判,输入法打字也是同样的原理;此外,在机器翻译中,将源语言和目标语言中,也存在着上下文衔接的词序列,因而RNN也可以被用在机器翻译中。 什么是循环神经网络? 传统的神经网络模型,层与层之间是全连接,但是隐藏层内的节点没有连接。序列信息中,节点存在被前一刻记忆的影响,隐藏层中的节点接收上一个节点的信息。RNN被称为循环神经网络是其对一组序列的输入进行循环,重复同样的操作。 RNN序列处理 RNN处理序列的类型根据输入和输出的数量,有四种类型。绿色是输入,蓝色是输出,灰色是隐藏层,可捕捉序列前后的信息;并不是每一步都需要输入或者输出,但是隐藏层是不可少的。 同步序列中,Many to many 多对多,输入和输出的数量相同,可用在词性标注,输入一个句子,输出句中每个词的词性;Many to one 多对一,文本的情感分析,输入一句话,输出这句话表达的情绪是积极还是消极。 非同步序列中,Many to many 多对多,可被用作机器翻译,即输入一种语言的文字,输出另外一种语言的文字;One to many,一对多,输入一张图片,输出对于图片内容的描述。 最基本的RNN结构 从左往右看,中间的圆圈是隐藏单元为S,x和O是输入和输出,通过折叠S神经单元,旁边加上一个顺时针的箭头,可以简化表示为S循环。 基本RNN的计算过程 以第二个神经元单元为例,xt 是向量,表示t时刻的输入,St是t时刻的记忆单元,St = f(U*xt + W*St-1),f是非线性的激活函数 tanh 双曲线正切函数,作用是将输入的数据规范化,取值在[-1,1],U和W是矩阵,对应 t时和 t-1时(左边单元)的权重参数,Ot是t时的输出,用softmax 函数归一化指数函数对矩阵V和向量st压缩并输出结果。 Softmax函数是逻辑函数Sigmoid的任意推广,将含有任意实数的k维的向量压缩至另外一个k维向量中,使得向量中的每个元素的范围都在[0,1],并且所有元素的和为1,满足概率的性质。 RNN的参数共享 RNN神经网络图中,每一条边都代表一个参数,不同于传统的神经网络,RNN在计算中共享U、V、W参数,即输出值Ot-1,Ot,Ot+1所用的U、V、W参数,这也是循环神经网络的特点,减少了需要学习的参数的数量,并提高了对数据进行训练的效率。 长短时记忆网络 LSTM-LongShort-TermMemory LSTM是RNN的一种变体,可以有效应对长期依赖的问题。 标准RNN难以应对长期依赖 在文本预测中,空歌词距离先关信息“clouds”的间隔不长,可以填上“sky”。 预测文本中,我出生在法国,我说“”,可填“法语”,但在文本中因为上下文的距离较长,上文对下文的影响消失或削弱,导致RNN不能预测远处的内容。 LSTM 的基本思路 标准的RNN其隐藏层只有一个h,可以对短期的内容保持敏感,难以捕捉长期的上下文;LSTM在隐藏层的基础上增加一个长时状态c, 也叫 cell state 单元或细胞状态用于保存长期状态,无论是c还是h都是一个向量。 Ct 是当前输入对应的长期状态,由上一时刻的长期状态Ct-1和当前时刻的即时状态C't组成。然而,不能将所有的上一时刻的长期状态都保留,需要选择性的接收,使用一个忘记门,有选择地忘记一些长期信息。 此外,当前时刻的长期状态还需要更新,因此通过输入门输入当前时刻的即时状态来更新。最后还有一个输出门,来控制如何使用当前时刻的长期状态来更新当前时刻的隐藏状态ht,此时ht中保存了一些长期的信息并和标准的RNN兼容;输出Ot时,还是使用当前时刻的ht来计算。 神经网络中的门 输入和输出都是尺寸相同的矩阵,对于其中的每个元素进行逐点操作。 LSTM 的整体框架图 LSTM的难点是如何计算Ct,红色的水平线表示了长期信息的计算。 LSTM的计算过程 σ是sigmoid函数,对应[0,1],选择忘记还是记忆;语言模型中,Germany是距离远的长期信息,尝试忘记。 语言模型中,应将当前词 France,更新到Ct中。 得到输出的结果ht,经过复制后去往上方和下方,上方为通过后续的softmax函数计算,输出结果Ot;下方的ht可以被送入下一个单元进行计算。 LSTM的变体-1 变体将Ct-1放入了ft,it和Ot中,使得门层接收长期状态的输入。 LSTM的变体-2 将遗忘的记忆(1-ft)和新记忆C't进行耦合,将只有新元素来填充的元素遗忘。 LSTM的变体-3 简单的理解,GRU通过重置门R和更新门U,将隐藏状态(ht-1 上一个时刻的ht)与长期状态~ht进行混合得到新的隐藏状态ht。 双向循环神经网络和注意力机制 Bidirectional RNNandAttentionMechanism 双向RNN(Bidirectional RNNs) 在文本中,一个词的预测不仅与上文有关,也与下文有关,因此采用双向的RNN来进行预测更为准确,图中Wt由正反向的两个向量拼接组成拼接向量concatenated vector,再经过softmax函数进行归一化,输出结果。 深层双向RNN(Deep Bidirectional RNNs) 深层双向RNN与RNN类似,增加了更多的隐藏层,具有更强大的学习和表达能力,同时也需要更多的数据来进行训练。 注意力模型(Attention model) 注意力机制的简单描述,人类会将注意力集中在有特点的位置,下次遇到类似的场景会注意相同特点的位置。 注意力模型基本原理 上图左边部分以文本分类为例,输入用W表示为一个语句连续的若干个词。总体上来看,采用的是双向RNN,不同点在于对每个词都加入一个权重α,在获取语义编码C的时候,不同的词的权重不同。αt的取值由Uw决定,可以看做哪一个词是关键词的抽象表示。在训练过程中随机初始化,逐渐更新。 具体的更新形式,参考上图右边的公式: (1)将拼接层的隐藏节点通过双曲拼接层的变化得到θt (2)将θt与uw点乘,得到归一化的αt,即不同词的注意力概率分布。 (3)αt和ht点乘求和,得到带注意分布的语义编码。 带有注意力机制的文本分词的好处是可以直观地看到每个词对分类的重要性。 案例推荐: https://blog.csdn.net/qq_33431368/article/details/85288590 此文讲解RNN和LSTM的原理,可阅读加深对其理解,并用LSTM模型进行实战训练PTB(Penn Treebank Dataset)宾州数据数据集。 好文章,我在看❤ 本文分享自微信公众号 - DataScience(DataScienceTeam)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

javaIO总结,最全面的IO知识

一、概览 二、磁盘操作 三、字节操作 实现文件复制 装饰者模式 四、字符操作 编码与解码 String 的编码方式 Reader 与 Writer 实现逐行输出文本文件的内容 五、对象操作 序列化 Serializable transient 六、网络操作 InetAddress URL Sockets Datagram 七、NIO 流与块 通道与缓冲区 缓冲区状态变量 文件 NIO 实例 选择器 套接字 NIO 实例 内存映射文件 对比 八、参考资料 一、概览 Java 的 I/O 大概可以分成以下几类: 磁盘操作:File 字节操作:InputStream 和 OutputStream 字符操作:Reader 和 Writer 对象操作:Serializable 网络操作:Socket 新的输入/输出:NIO 二、磁盘操作 File 类可以用于表示文件和目录的信息,但是它不表示文件的内容。 递归地列出一个目录下所有文件: public static void listAllFiles(File dir) { if (dir == null || !dir.exists()) { return; } if (dir.isFile()) { System.out.println(dir.getName()); return; } for (File file : dir.listFiles()) { listAllFiles(file); } } 从 Java7 开始,可以使用 Paths 和 Files 代替 File。 三、字节操作 实现文件复制 public static void copyFile(String src, String dist) throws IOException { FileInputStream in = new FileInputStream(src); FileOutputStream out = new FileOutputStream(dist); byte[] buffer = new byte[20 * 1024]; int cnt; // read() 最多读取 buffer.length 个字节 // 返回的是实际读取的个数 // 返回 -1 的时候表示读到 eof,即文件尾 while ((cnt = in.read(buffer, 0, buffer.length)) != -1) { out.write(buffer, 0, cnt); } in.close(); out.close(); } 装饰者模式 Java I/O 使用了装饰者模式来实现。以 InputStream 为例, InputStream 是抽象组件; FileInputStream 是 InputStream 的子类,属于具体组件,提供了字节流的输入操作; FilterInputStream 属于抽象装饰者,装饰者用于装饰组件,为组件提供额外的功能。例如 BufferedInputStream 为 FileInputStream 提供缓存的功能。 实例化一个具有缓存功能的字节流对象时,只需要在 FileInputStream 对象上再套一层 BufferedInputStream 对象即可。 FileInputStream fileInputStream = new FileInputStream(filePath); BufferedInputStream bufferedInputStream = new BufferedInputStream(fileInputStream); DataInputStream 装饰者提供了对更多数据类型进行输入的操作,比如 int、double 等基本类型。 四、字符操作 编码与解码 编码就是把字符转换为字节,而解码是把字节重新组合成字符。 如果编码和解码过程使用不同的编码方式那么就出现了乱码。 GBK 编码中,中文字符占 2 个字节,英文字符占 1 个字节; UTF-8 编码中,中文字符占 3 个字节,英文字符占 1 个字节; UTF-16be 编码中,中文字符和英文字符都占 2 个字节。 UTF-16be 中的 be 指的是 Big Endian,也就是大端。相应地也有 UTF-16le,le 指的是 Little Endian,也就是小端。 Java 的内存编码使用双字节编码 UTF-16be,这不是指 Java 只支持这一种编码方式,而是说 char 这种类型使用 UTF-16be 进行编码。char 类型占 16 位,也就是两个字节,Java 使用这种双字节编码是为了让一个中文或者一个英文都能使用一个 char 来存储。 String 的编码方式 String 可以看成一个字符序列,可以指定一个编码方式将它编码为字节序列,也可以指定一个编码方式将一个字节序列解码为 String。 String str1 = "中文"; byte[] bytes = str1.getBytes("UTF-8"); String str2 = new String(bytes, "UTF-8"); System.out.println(str2); 在调用无参数 getBytes() 方法时,默认的编码方式不是 UTF-16be。双字节编码的好处是可以使用一个 char 存储中文和英文,而将 String 转为 bytes[] 字节数组就不再需要这个好处,因此也就不再需要双字节编码。getBytes() 的默认编码方式与平台有关,一般为 UTF-8。 byte[] bytes = str1.getBytes(); Reader 与 Writer 不管是磁盘还是网络传输,最小的存储单元都是字节,而不是字符。但是在程序中操作的通常是字符形式的数据,因此需要提供对字符进行操作的方法。 InputStreamReader 实现从字节流解码成字符流; OutputStreamWriter 实现字符流编码成为字节流。 实现逐行输出文本文件的内容 public static void readFileContent(String filePath) throws IOException { FileReader fileReader = new FileReader(filePath); BufferedReader bufferedReader = new BufferedReader(fileReader); String line; while ((line = bufferedReader.readLine()) != null) { System.out.println(line); } // 装饰者模式使得 BufferedReader 组合了一个 Reader 对象 // 在调用 BufferedReader 的 close() 方法时会去调用 Reader 的 close() 方法 // 因此只要一个 close() 调用即可 bufferedReader.close(); } 五、对象操作 序列化 序列化就是将一个对象转换成字节序列,方便存储和传输。 序列化:ObjectOutputStream.writeObject() 反序列化:ObjectInputStream.readObject() 不会对静态变量进行序列化,因为序列化只是保存对象的状态,静态变量属于类的状态。 Serializable 序列化的类需要实现 Serializable 接口,它只是一个标准,没有任何方法需要实现,但是如果不去实现它的话而进行序列化,会抛出异常。 public static void main(String[] args) throws IOException, ClassNotFoundException { A a1 = new A(123, "abc"); String objectFile = "file/a1"; ObjectOutputStream objectOutputStream = new ObjectOutputStream(new FileOutputStream(objectFile)); objectOutputStream.writeObject(a1); objectOutputStream.close(); ObjectInputStream objectInputStream = new ObjectInputStream(new FileInputStream(objectFile)); A a2 = (A) objectInputStream.readObject(); objectInputStream.close(); System.out.println(a2); } private static class A implements Serializable { private int x; private String y; A(int x, String y) { this.x = x; this.y = y; } @Override public String toString() { return "x = " + x + " " + "y = " + y; } } transient transient 关键字可以使一些属性不会被序列化。 ArrayList 中存储数据的数组 elementData 是用 transient 修饰的,因为这个数组是动态扩展的,并不是所有的空间都被使用,因此就不需要所有的内容都被序列化。通过重写序列化和反序列化方法,使得可以只序列化数组中有内容的那部分数据。 private transient Object[] elementData; 六、网络操作 Java 中的网络支持: InetAddress:用于表示网络上的硬件资源,即 IP 地址; URL:统一资源定位符; Sockets:使用 TCP 协议实现网络通信; Datagram:使用 UDP 协议实现网络通信。 InetAddress 没有公有的构造函数,只能通过静态方法来创建实例。 InetAddress.getByName(String host); InetAddress.getByAddress(byte[] address); URL 可以直接从 URL 中读取字节流数据。 public static void main(String[] args) throws IOException { URL url = new URL("http://www.baidu.com"); /* 字节流 */ InputStream is = url.openStream(); /* 字符流 */ InputStreamReader isr = new InputStreamReader(is, "utf-8"); /* 提供缓存功能 */ BufferedReader br = new BufferedReader(isr); String line; while ((line = br.readLine()) != null) { System.out.println(line); } br.close(); } Sockets ServerSocket:服务器端类 Socket:客户端类 服务器和客户端通过 InputStream 和 OutputStream 进行输入输出。 Datagram DatagramSocket:通信类 DatagramPacket:数据包类 七、NIO 新的输入/输出 (NIO) 库是在 JDK 1.4 中引入的,弥补了原来的 I/O 的不足,提供了高速的、面向块的 I/O。 流与块 I/O 与 NIO 最重要的区别是数据打包和传输的方式,I/O 以流的方式处理数据,而 NIO 以块的方式处理数据。 面向流的 I/O 一次处理一个字节数据:一个输入流产生一个字节数据,一个输出流消费一个字节数据。为流式数据创建过滤器非常容易,链接几个过滤器,以便每个过滤器只负责复杂处理机制的一部分。不利的一面是,面向流的 I/O 通常相当慢。 面向块的 I/O 一次处理一个数据块,按块处理数据比按流处理数据要快得多。但是面向块的 I/O 缺少一些面向流的 I/O 所具有的优雅性和简单性。 I/O 包和 NIO 已经很好地集成了,java.io.* 已经以 NIO 为基础重新实现了,所以现在它可以利用 NIO 的一些特性。例如,java.io.* 包中的一些类包含以块的形式读写数据的方法,这使得即使在面向流的系统中,处理速度也会更快。 通道与缓冲区 1. 通道 通道 Channel 是对原 I/O 包中的流的模拟,可以通过它读取和写入数据。 通道与流的不同之处在于,流只能在一个方向上移动(一个流必须是 InputStream 或者 OutputStream 的子类),而通道是双向的,可以用于读、写或者同时用于读写。 通道包括以下类型: FileChannel:从文件中读写数据; DatagramChannel:通过 UDP 读写网络中数据; SocketChannel:通过 TCP 读写网络中数据; ServerSocketChannel:可以监听新进来的 TCP 连接,对每一个新进来的连接都会创建一个 SocketChannel。 2. 缓冲区 发送给一个通道的所有数据都必须首先放到缓冲区中,同样地,从通道中读取的任何数据都要先读到缓冲区中。也就是说,不会直接对通道进行读写数据,而是要先经过缓冲区。 缓冲区实质上是一个数组,但它不仅仅是一个数组。缓冲区提供了对数据的结构化访问,而且还可以跟踪系统的读/写进程。 缓冲区包括以下类型: ByteBuffer CharBuffer ShortBuffer IntBuffer LongBuffer FloatBuffer DoubleBuffer 缓冲区状态变量 capacity:最大容量; position:当前已经读写的字节数; limit:还可以读写的字节数。 状态变量的改变过程举例: ① 新建一个大小为 8 个字节的缓冲区,此时 position 为 0,而 limit = capacity = 8。capacity 变量不会改变,下面的讨论会忽略它。 ② 从输入通道中读取 5 个字节数据写入缓冲区中,此时 position 为 5,limit 保持不变。 ③ 在将缓冲区的数据写到输出通道之前,需要先调用 flip() 方法,这个方法将 limit 设置为当前 position,并将 position 设置为 0。 ④ 从缓冲区中取 4 个字节到输出缓冲中,此时 position 设为 4。 ⑤ 最后需要调用 clear() 方法来清空缓冲区,此时 position 和 limit 都被设置为最初位置。 文件 NIO 实例 以下展示了使用 NIO 快速复制文件的实例: public static void fastCopy(String src, String dist) throws IOException { /* 获得源文件的输入字节流 */ FileInputStream fin = new FileInputStream(src); /* 获取输入字节流的文件通道 */ FileChannel fcin = fin.getChannel(); /* 获取目标文件的输出字节流 */ FileOutputStream fout = new FileOutputStream(dist); /* 获取输出字节流的文件通道 */ FileChannel fcout = fout.getChannel(); /* 为缓冲区分配 1024 个字节 */ ByteBuffer buffer = ByteBuffer.allocateDirect(1024); while (true) { /* 从输入通道中读取数据到缓冲区中 */ int r = fcin.read(buffer); /* read() 返回 -1 表示 EOF */ if (r == -1) { break; } /* 切换读写 */ buffer.flip(); /* 把缓冲区的内容写入输出文件中 */ fcout.write(buffer); /* 清空缓冲区 */ buffer.clear(); } } 选择器 NIO 常常被叫做非阻塞 IO,主要是因为 NIO 在网络通信中的非阻塞特性被广泛使用。 NIO 实现了 IO 多路复用中的 Reactor 模型,一个线程 Thread 使用一个选择器 Selector 通过轮询的方式去监听多个通道 Channel 上的事件,从而让一个线程就可以处理多个事件。 通过配置监听的通道 Channel 为非阻塞,那么当 Channel 上的 IO 事件还未到达时,就不会进入阻塞状态一直等待,而是继续轮询其它 Channel,找到 IO 事件已经到达的 Channel 执行。 因为创建和切换线程的开销很大,因此使用一个线程来处理多个事件而不是一个线程处理一个事件,对于 IO 密集型的应用具有很好地性能。 应该注意的是,只有套接字 Channel 才能配置为非阻塞,而 FileChannel 不能,为 FileChannel 配置非阻塞也没有意义。 1. 创建选择器 Selector selector = Selector.open(); 2. 将通道注册到选择器上 ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); ssChannel.register(selector, SelectionKey.OP_ACCEPT); 通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了,因为如果通道在某个事件上被阻塞,那么服务器就不能响应其它事件,必须等待这个事件处理完毕才能去处理其它事件,显然这和选择器的作用背道而驰。 在将通道注册到选择器上时,还需要指定要注册的具体事件,主要有以下几类: SelectionKey.OP_CONNECT SelectionKey.OP_ACCEPT SelectionKey.OP_READ SelectionKey.OP_WRITE 它们在 SelectionKey 的定义如下: public static final int OP_READ = 1 << 0; public static final int OP_WRITE = 1 << 2; public static final int OP_CONNECT = 1 << 3; public static final int OP_ACCEPT = 1 << 4; 可以看出每个事件可以被当成一个位域,从而组成事件集整数。例如: int interestSet = SelectionKey.OP_READ | SelectionKey.OP_WRITE; 3. 监听事件 int num = selector.select(); 使用 select() 来监听到达的事件,它会一直阻塞直到有至少一个事件到达。 4. 获取到达的事件 Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } 5. 事件循环 因为一次 select() 调用不能处理完所有的事件,并且服务器端有可能需要一直监听事件,因此服务器端处理事件的代码一般会放在一个死循环内。 while (true) { int num = selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } } 套接字 NIO 实例 public class NIOServer { public static void main(String[] args) throws IOException { Selector selector = Selector.open(); ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); ssChannel.register(selector, SelectionKey.OP_ACCEPT); ServerSocket serverSocket = ssChannel.socket(); InetSocketAddress address = new InetSocketAddress("127.0.0.1", 8888); serverSocket.bind(address); while (true) { selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { ServerSocketChannel ssChannel1 = (ServerSocketChannel) key.channel(); // 服务器会为每个新连接创建一个 SocketChannel SocketChannel sChannel = ssChannel1.accept(); sChannel.configureBlocking(false); // 这个新连接主要用于从客户端读取数据 sChannel.register(selector, SelectionKey.OP_READ); } else if (key.isReadable()) { SocketChannel sChannel = (SocketChannel) key.channel(); System.out.println(readDataFromSocketChannel(sChannel)); sChannel.close(); } keyIterator.remove(); } } } private static String readDataFromSocketChannel(SocketChannel sChannel) throws IOException { ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder data = new StringBuilder(); while (true) { buffer.clear(); int n = sChannel.read(buffer); if (n == -1) { break; } buffer.flip(); int limit = buffer.limit(); char[] dst = new char[limit]; for (int i = 0; i < limit; i++) { dst[i] = (char) buffer.get(i); } data.append(dst); buffer.clear(); } return data.toString(); } } public class NIOClient { public static void main(String[] args) throws IOException { Socket socket = new Socket("127.0.0.1", 8888); OutputStream out = socket.getOutputStream(); String s = "hello world"; out.write(s.getBytes()); out.close(); } } 内存映射文件 内存映射文件 I/O 是一种读和写文件数据的方法,它可以比常规的基于流或者基于通道的 I/O 快得多。 向内存映射文件写入可能是危险的,只是改变数组的单个元素这样的简单操作,就可能会直接修改磁盘上的文件。修改数据与将数据保存到磁盘是没有分开的。 下面代码行将文件的前 1024 个字节映射到内存中,map() 方法返回一个 MappedByteBuffer,它是 ByteBuffer 的子类。因此,可以像使用其他任何 ByteBuffer 一样使用新映射的缓冲区,操作系统会在需要时负责执行映射。 MappedByteBuffer mbb = fc.map(FileChannel.MapMode.READ_WRITE, 0, 1024); 对比 NIO 与普通 I/O 的区别主要有以下两点: NIO 是非阻塞的; NIO 面向块,I/O 面向流。 八、参考资料 Eckel B, 埃克尔, 昊鹏, 等. Java 编程思想 [M]. 机械工业出版社, 2002. IBM: NIO 入门 Java NIO Tutorial Java NIO 浅析 IBM: 深入分析 Java I/O 的工作机制 IBM: 深入分析 Java 中的中文编码问题 IBM: Java 序列化的高级认识 NIO 与传统 IO 的区别 Decorator Design Pattern Socket Multicast 本文同步分享在 博客“码上代码”(CSDN)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册