首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10000篇文章
优秀的个人博客,低调大师

Redis专题(1):构建知识图谱

场景:Redis面试 (图片来源于网络) 面试官: 我看到你的简历上说你熟练使用Redis,那么你讲一下Redis是干嘛用的? 小明: (心中窃喜,Redis不就是缓存吗?)Redis主要用作缓存,通过内存高效地存储非持久化数据。 面试官: Redis可以用作持久化的存储吗? 小明 :嗯...应该可以吧... 面试官: 那Redis怎么进行持久化操作呢? 小明:嗯...不是太清楚。 面试官: Redis的内存淘汰机制有哪些? 小明:嗯...没了解过 面试官:我们还可以用Redis做哪些事情?分别利用了Redis的哪个指令? 小明:我只知道Redis还可以做分布式锁、消息队列... 面试官:好了,我们进入下一个话题... 思考:很明显,小明同学在面试过程中关于Redis的表现和回答肯定是比较失败的。Redis是我们工作中每天都会使用到的东西,为什么一到面试却

优秀的个人博客,低调大师

Python知识点:lambda, map, filter

通过示例介绍Python中的lambda,map,filter 函数的使用方法。 lambdalambda 操作符(或 lambda函数)通常用来创建小巧的,一次性的匿名函数对象。它的基本语法如下: lambda arguments : expression lambda操作符可以有任意数量的参数,但是它只能有一个表达式,且不能包含任何语句,返回一个可以赋值给任何变量的函数对象。 下面通过一个例子来理解一下。首先看看一个Python函数: def add(x, y): return x+y # call the function add(1, 2) # Output: 3 上述函数名为add, 它需要两个参数x和y,并返回它们的和。接下来,我们把上面的函数变成一个lambda函数: add = lambda x, y : x + y print(add(1,2)) # Output: 3 在lambda x, y : x + y中,x和y是函数的参数,x+y是表达式,它被执行并返回结果。 lambda x, y : x + y返回的是一个函数对象,它可以被赋值给任何变量。在本例中函数对象被赋值给了add变量。如果我们查看add的type,可以看到它是一个function type(add) # Output: function 绝大多数lambda函数作为一个参数传给一个需要函数对象为参数的函数,比如map,reduce,filter等函数。 **mapmap的基本语法如下:** map(function_object, iterable1, iterable2, ...) map函数需要一个函数对象和任意数量的iterables,如list,dictionary等。它为序列中的每个元素执行function_object,并返回由函数对象修改的元素组成的列表。示例如下: def add2(x): return x+2 map(add2, [1,2,3,4]) # Output: [3,4,5,6] 在上面的例子中,map对list中的每个元素1,2,3,4执行add2函数并返回[3,4,5,6]接着看看如何用map和lambda重写上面的代码: map(lambda x: x+2, [1,2,3,4]) #Output: [3,4,5,6] 仅仅一行即可搞定! 使用map和lambda迭代dictionary: dict_a = [{'name': 'python', 'points': 10}, {'name': 'java', 'points': 8}] map(lambda x : x['name'], dict_a) # Output: ['python', 'java'] map(lambda x : x['points']*10, dict_a) # Output: [100, 80] map(lambda x : x['name'] == "python", dict_a) # Output: [True, False] 以上代码中,dict_a中的每个dict作为参数传递给lambda函数。lambda函数表达式作用于每个dict的结果作为输出。 map函数作用于多个iterables list_a = [1, 2, 3] list_b = [10, 20, 30] map(lambda x, y: x + y, list_a, list_b) # Output: [11, 22, 33] 这里,list_a和list_b的第i个元素作为参数传递给lambda函数。 在Python3中,map函数返回一个惰性计算(lazily evaluated)的迭代器(iterator)或map对象。就像zip函数是惰性计算那样。我们不能通过index访问map对象的元素,也不能使用len()得到它的长度。但我们可以强制转换map对象为list: map_output = map(lambda x: x*2, [1, 2, 3, 4]) print(map_output) # Output: map object: list_map_output = list(map_output) print(list_map_output) # Output: [2, 4, 6, 8] filterfilter的基本语法如下: filter(function_object, iterable)filter函数需要两个参数,function_object返回一个布尔值(boolean),对iterable的每一个元素调用function_object,filter只返回满足function_object为True的元素。 和map函数一样,filter函数也返回一个list,但与map函数不同的是,filter函数只能有一个iterable作为输入。示例:返回偶数: a = [1, 2, 3, 4, 5, 6] filter(lambda x : x % 2 == 0, a) # Output: [2, 4, 6] 过滤dicts的list: dict_a = [{'name': 'python', 'points': 10}, {'name': 'java', 'points': 8}] filter(lambda x : x['name'] == 'python', dict_a) # Output: [{'name': 'python', 'points': 10}] 和map一样,filter函数在Python3中返回一个惰性计算的filter对象或迭代器。我们不能通过index访问filter对象的元素,也不能使用len()得到它的长度。 list_a = [1, 2, 3, 4, 5] filter_obj = filter(lambda x: x % 2 == 0, list_a) # filter object even_num = list(filter_obj) # Converts the filer obj to a list print(even_num) # Output: [2, 4] 有关Python技术文章优先发布在我的个人博客:猿人学公众号:猿人学Pyhton

优秀的个人博客,低调大师

Python高级知识点学习(八)

线程同步 - condition介绍 多线程中的另外一个重要点就是condition:条件变量。 condition是python多线程编程中用于复杂线程间通信的一个锁 叫做条件变量。 cond = threading.Condition() with self.cond: cond.notify() cond.wait() condition有两层锁, 一把底层锁会在线程调用了wait方法的时候释放, 上面的锁会在每次调用wait的时候分配一把并放入到cond的等待队列中,等到notify方法的唤醒。 有关condition的详情请查阅资料。(这里作者自己暂时还没理清楚原理,见谅) 线程同步 - Semaphore 介绍 信号量,Semaphore。 Semaphore 是用于控制进入数量的锁,控制进入某段代码的线程数。 文件, 读、写, 写一般只是用于一个线程写,读可以允许有多个。 ThreadPoolExecutor线程池 多线程和多进程对比 运算,耗cpu的操作,用多进程编程 对于io操作来说, 使用多线程编程 由于进程切换代价要高于线程,所以能使用线程就不用进程。 耗费cpu的操作: def fib(n): if n<=2: return 1 return fib(n-1)+fib(n-2) if __name__ == "__main__": with ThreadPoolExecutor(3) as executor: all_task = [executor.submit(fib, (num)) for num in range(1, 10)] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) 模拟IO操作: def random_sleep(n): time.sleep(n) return n if __name__ == "__main__": with ProcessPoolExecutor(3) as executor: all_task = [executor.submit(random_sleep, (num)) for num in [2]*30] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) multiprocessing 多进程 使用os.fork创建子进程,fork只能用于linux/unix中。 import os import time # fork新建子进程 fork只能用于linux/unix中 pid = os.fork() print("a") if pid == 0: print('子进程id:{} ,父进程id是: {}.' .format(os.getpid(), os.getppid())) else: print('我是父进程, 我fork出的子进程id是:{}.'.format(pid)) time.sleep(2) 运行结果: a 我是父进程, 我fork出的子进程id是:3093. a 子进程id:3093 ,父进程id是: 3092. 运行结果中,可以看到打印了两次a,因为在执行完pid = os.fork()这行代码后,就创建了一个子进程,且子进程把父进程中的数据原样拷贝了一份到自己的进程中,所以父进程中打印一次,子进程中又打印一次。 多进程编程: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": progress = multiprocessing.Process(target=get_html, args=(2,)) print(progress.pid) progress.start() print(progress.pid) progress.join() print("main progress end") 使用进程池: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) result = pool.apply_async(get_html, args=(3,)) # 等待所有任务完成 pool.close() pool.join() print(result.get()) 进程池另一种方法: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) for result in pool.imap_unordered(get_html, [1, 5, 3]): print("{} sleep success".format(result)) 进程间通信 Queue、Pipe,Manager 共享全局变量不能适用于多进程编程,可以适用于多线程。 进程间通信和线程间通信有相同也有不同,不同点是之前在多线程中用的线程间通信的类和线程间同步的锁在多进程中是不能用的。 使用multiprocessing中的Queue实现进程通信 import time from multiprocessing import Process, Queue, Pool, Manager, Pipe def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Queue(10) my_producer = Process(target=producer, args=(queue,)) my_consumer = Process(target=consumer, args=(queue,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() 一定要使用multiprocessing中的Queue,如果使用import queue这个queue是不行的。 pool中的进程间通信需要使用manager中的queue multiprocessing中的queue不能用于pool进程池。 pool中的进程间通信需要使用manager中的queue def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Manager().Queue(10) pool = Pool(2) pool.apply_async(producer, args=(queue,)) pool.apply_async(consumer, args=(queue,)) pool.close() pool.join() 使用Manager,多进程修改同一变量: def add_data(p_dict, key, value): p_dict[key] = value if __name__ == "__main__": progress_dict = Manager().dict() from queue import PriorityQueue first_progress = Process(target=add_data, args=(progress_dict, "a", 22)) second_progress = Process(target=add_data, args=(progress_dict, "b", 23)) first_progress.start() second_progress.start() first_progress.join() second_progress.join() print(progress_dict) 可以看到两个进程对一个dict变量做值得填充,最终主进程中打印出了最终的dict。 通过pipe实现进程间通信: pipe的性能高于queue。 pipe只能适用于两个进程。 def producer(pipe): pipe.send("a") def consumer(pipe): print(pipe.recv()) if __name__ == "__main__": recevie_pipe, send_pipe = Pipe() #pipe只能适用于两个进程 my_producer = Process(target=producer, args=(send_pipe, )) my_consumer = Process(target=consumer, args=(recevie_pipe,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() my_producer进程给my_consumer进程发送的a变量可以正常打印。

优秀的个人博客,低调大师

Python高级知识点学习(七)

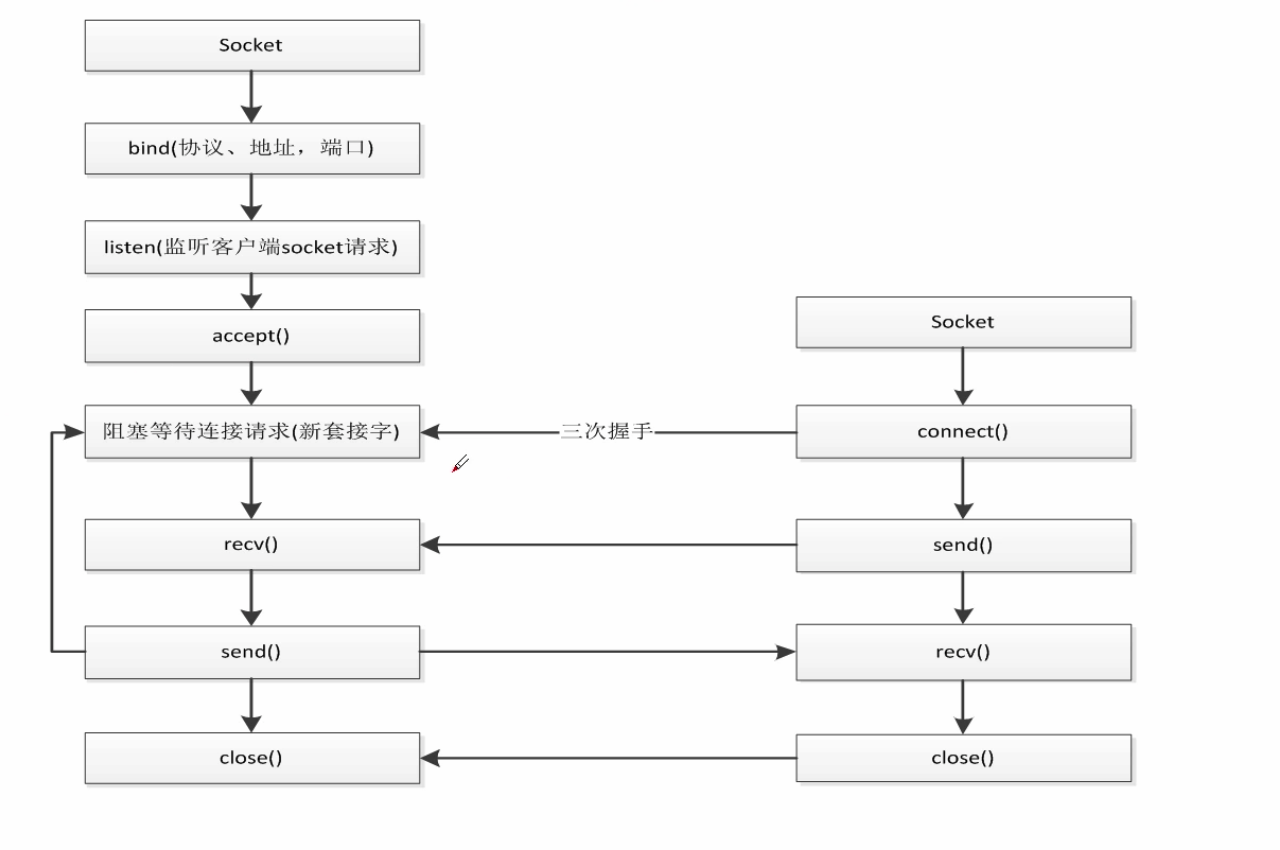
HTTP、Socket、TCP概念 socket属于常用的http协议之下的让我们可以使用tcp/ip协议的一个接口。 socket编程 image.png socket编程的模式其实是非常固定的。 上图: 左侧server端 右侧client端 server必须是随时处于一个监听的状态和服务的状态,因为不知道客户端什么时候会发送来请求。 绑定协议、地址、端口。 每一个应用程序只能占用一个端口,服务器a到服务器b发数据时,数据是不知道是由哪个应用程序接受的,这时候就需要端口机制,每一个应用程序提供一个端口。 socket连接后,只要不关闭连接,服务端可以一直给客户端发送请求,但是在http中,只完成一次发送数据就停止了。 编写测试代码: 新建文件sever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 绑定ip 端口 server.bind(('0.0.0.0', 8000)) # 监听 server.listen() sock, addr = server.accept() # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) # 给client发数据 sock.send("hello".encode("utf8")) # 关闭 server.close() sock.close() 新建文件client.py import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) # 给server端发数据 client.send("allen".encode("utf-8")) # 接受server端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) # 关闭 client.close() 首先运行server.py,再运行client.py,观察打印结果,可以看到,数据发送接收已经是实现。 socket实现简单聊天 要实现双向交流,肯定不能做close操作,改为一直while循环, 代码: 修改srever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(("0.0.0.0", 8000)) server.listen() sock, addr = server.accept() while True: # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) re_data = input() # 给client发数据 sock.send(re_data.encode("utf8")) 修改client.py: import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) while True: # 输入消息 re_data = input() client.send(re_data.encode("utf8")) # 接受client端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) 运行server.py ,再运行client.py,在client.py中输入要发送的文字,在server.py中观察接收到的文字,再在server.py中发送文字,在client.py中查看。 以上就是实现了最初级的基本聊天过程。 如果要在网页上做一个聊天模块,一般都是需要用web socket来实现。 socket多用户聊天 所谓多用户聊天,其实平时我们也经常遇到。 假如你是一位线上客服人员,你需要接待的人员可能同时有多位,当你和A用户聊天时,并不妨碍和B用户C用户给你发消息,而你回消息,回给A用户的消息只有A用户可以看到,B用户是看不到的,接着看如何实现这种功能。 首先client.py的代码不用改动,只需修改server.py: import socket import threading server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(('0.0.0.0', 8000)) server.listen() def handle_sock(sock, addr): while True: data = sock.recv(1024) print(data.decode("utf8")) re_data = input() sock.send(re_data.encode("utf8")) while True: sock, addr = server.accept() #用线程去处理新接收的连接(用户) client_thread = threading.Thread(target=handle_sock, args=(sock, addr)) client_thread.start() 上边代码把接受处理逻辑放到了线程中,每一个线程存放一个不同的socket,主线程来查看有哪些线程进入。 运行server.py,再运行多个client.py,client.py给server发消息,测试可发现可实现上边的客服功能。 注:真正客服系统要比这个复杂得多,以上代码仅供测试。 socket模拟http请求 我们平常所用到的requests包,是基于 urllib,urllib实际上是基于socket上来完成的。 requests - urlib - socket 如何通过socket去完成类似urllib中http请求呢? http请求无非就是在tcp协议之上加了一些协议,只要按照这个协议发,就会返回数据。 看代码: import socket from urllib.parse import urlparse def request_demo(url): # url拆分 url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect((host, 80)) client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) data = b"" # 每次读取1024大小,循环知道读取完毕 while True: d = client.recv(1024) if d: data += d else: break data = data.decode("utf8") print(data) client.close() if __name__ == "__main__": url = 'http://www.baidu.com' request_demo(url) 运行结果包含两部分: 第一部分request header 第二部分html源码 建立连接的过程是比较费时的,一般在使用socket编程都是为了解决长连接的问题,而不是说每发送一个请求数据返回就把它关掉。 很多时候我们需要一个交互的过程,这时候socket就派上用场了,有了socket后我们的代码灵活性高,它完全可以让我们将整个过程变得可以操控。

优秀的个人博客,低调大师

Python高级知识点学习(六)

围棋少年 Python中的迭代协议 迭代协议有两个概念: 可迭代类型(Iterable) 迭代器(Iterator) 迭代器:迭代器是访问集合内元素的一种方式, 一般用来遍历数据。 迭代器和以下标的访问方式不一样, 迭代器是不能返回的, 迭代器提供了一种惰性方式数据的方式。 可迭代对象(Iterable) 和 迭代器(Iterator) 是不同的。 可迭代对象: 实现__iter__这个魔法函数 迭代器: 实现__next__这个魔法函数 实现__iter__这个魔法函数 from collections.abc import Iterable, Iterator a = [1, 2] print(isinstance(a, Iterable)) print(isinstance(a, Iterator)) 打印结果: True False 上边代码,因为a是一个list,而list是一个可迭代对象并不是迭代器,因为list对象中没有__next__方法。 生成器 生成器函数:函数里只要有yield关键字,它就是生成器对象。 生成器对象在python编译字节码的时候就产生了。 生成器对象也是实现了迭代器协议的,所以可以使用for循环遍历到它的值。 def gen_func(): yield 1 gen = gen_func() for value in gen: print(value) 打印结果: 1 Python 中的GIL GIL:global interpreter lock (cpython) GIL:全局解释器锁。 python中一个线程对应于c语言中的一个线程。 GIL使得同一个时刻只有一个线程在一个cpu上执行字节码, 也就意味着无法将多个线程映射到多个cpu上执行。 GIL锁分配给某一线程后,并不是说这个线程执行完了之后它才会释放把它交给另外一个线程,它不是整个过程完全占有,它实际上是会在适当的时刻释放的,是结合了字节码执行的行数比如他执行了1000行字节码之后,它会释放,然后另外一个线程就可以得到运行。 GIL释放: 会根据执行的字节码行数以及时间片释放gil。 gil在遇到io的操作时候主动释放。 total = 0 def add(): global total for i in range(1000000): total += 1 def desc(): global total for i in range(1000000): total -= 1 thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 上边代码两个线程分别执行两个函数,两个函数对同一变量做加减操作,本来应该先加到1000000再减1000000最终打印出0,但事实上是不会打印0的。 多线程编程 IO密集型时,适合多线程。 CPU密集型时,适合多进程。 多线程编程是我们几乎所有编程语言中都会遇到的问题。 操作系统能够切换和调度的最小单元是线程。 在最开始的时候,操作系统能够调度的最小单元是进程,但是由于进程对系统资源消耗非常大,所以后期就演变出了线程。 第一种方式:通过Thread类实例化 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = threading.Thread(target=get_detail_html, args=("",)) thread2 = threading.Thread(target=get_detail_url, args=("",)) # 设置为守护线程,随着主线程退出,子线程也退出 #thread1.setDaemon(True) #thread2.setDaemon(True) start_time = time.time() thread1.start() thread2.start() # 等待线程1,2执行完成 再执行完主线程; thread1.join() thread2.join() print(time.time() - start_time) 上边代码中,两个线程分别执行两个函数,主线程下有两个子线程。 thread1.setDaemon(True)这个操作是把thread1设置为守护线程,随着主线程退出,thread1也退出。thread1.join()这个操作是把主线程等待thread1执行完再执行完主线程。 第二种方式:通过重载Thread来实现多线程 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") class GetDetailHtml(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail html started") time.sleep(2) print("get detail html end") class GetDetailUrl(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = GetDetailHtml("get_detail_html") thread2 = GetDetailUrl("get_detail_url") start_time = time.time() thread1.start() thread2.start() thread1.join() thread2.join() print("last time: {}".format(time.time()-start_time)) 上边代码继承threading.Thread必须重载run方法。 线程同步Lock、RLock 为什么要线程同步? 现有两个函数,分别是对全局变脸a进行加减操作,两个函数使用两个线程来运行,一个线程负责把a加一,另一个负责把a减一,上代码: a = 0 def add(a): a += 1 def desc(a): a-=1 首先使用内置方法dis()看一下两个函数字节码是什么样子的: import dis def add(a): a += 1 def desc(a): a-=1 print(dis.dis(add)) print(dis.dis(desc)) 打印结果: 63 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_ADD 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 66 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_SUBTRACT 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 上边代码打印结果: 看下add的里边字节码: LOAD_FAST:首先把 a LOAD 到内存中 LOAD_CONST :再把1 LOAD 到内存中 INPLACE_ADD:执行加的操作 STORE_FAST:将加完的值赋值给 a desc里边也是一样的,分四步,不同的是desc里执行的是减法。 如果同时执行add字节码和desc字节码时,之前笔记中提过,执行以上四个步骤时随时都可能释放gil锁,因为字节码的数量已经满了,以上四步任何一步骤都可能释放gil锁切换到另外一个线程,所以有可能造成一个结果,就是a要么等于1,要么等于-1,但是我们期望的是a 等于0,这时候就需要线程同步来解决问题。 我们希望在执行add函数的代码段时,另一个线程中的desc代码段是停止的,这就是线程同步机制。 python给我们提供了一个机制,叫做锁:from threading import Lock 在运行一个代码段时,加一把锁,等运行完了,再释放锁。 from threading import Lock total = 0 # 声明一把锁 lock = RLock() def add(): global lock global total for i in range(1000000): # 获得锁 lock.acquire() total += 1 # 释放锁 lock.release() def desc(): global total global lock for i in range(1000000): lock.acquire() total -= 1 lock.release() import threading thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 打印结果: 0 上边代码不管累加多少次最终结果都是0。 如果没有释放锁,会导致死锁。 使用锁会影响性能。 RLock: 在同一个线程里面,可以连续调用多次acquire, 一定要注意acquire的次数要和release的次数相等。 在同一个线程中,可以使用RLock。

优秀的个人博客,低调大师

Python高级知识点学习(五)

dict的子类 首先,不建议自己编写代码继承dict和list这种原生使用c语言编写的,因为有时候,用c语言写的dict不会调用python写的覆盖的方法。 如果确实有继承dict来写代码的需求,可以使用UserDict,继承这个UserDict。 UserDict这个内部使用了python语言实现了c语言写的逻辑。 from collections import UserDict class Mydict(UserDict): def __setitem__(self, key, value): super().__setitem__(key, value*2) my_dict = Mydict(one=1) print (my_dict) 打印结果: {'one': 2} set和fronzenset set集合: 无序 不重复 set 接受一个可迭代对象 frozenset集合: 一旦设置好就无法修改。 frozenset为不可变类型。 相对于可变类型来说的好处,可以作为dict的key。 set的初始化方法: set([a, b, c]) a = {a, b, c} 两种都可以初始化 dict、set实现原理 当我们了解了背后的实现原理,就可以判断什么情况下使用dict以及为什么要使用dict。 dict查找的性能远远大于list。 在list中随着list数据的增大 查找时间会增大。 在dict中查找元素不会随着dict的增大而增大。 dict原理实际上就是利用hash算法。 数组和链表相比来说最大的优势,就是它可以做到任何一个位置直接存取而不需要从头到尾遍历,因为数组是一段连续的空间,数组取数据的时间复杂度是O(1)。 dict的key或者set的值,都必须是可以hash的。不可变对象都是可hash的, str, fronzenset, tuple。 自己实现的类重载__hash__这个魔法函数,让它可以变为可哈希对象。 dict的内存花销大,但是查询速度快, 自定义的对象或者python内部的对象都是用dict包装的。 dict的存储顺序和元素添加顺序有关,添加数据有可能改变已有数据的顺序。 Python中的变量是什么 python和java中的变量本质不一样,python的变量实质上是一个指针。我们可以理解变量就是一个便利贴, 例如:a = 1 先成对象,然后贴便利贴,把a贴在1上面。 a = [1, 2, 3] b = a print(id(a), id(b)) 打印结果: a和b的地址值一样。 is 和 == 的区别 is是判断对象的id是否相同,但是注意看下边例子: a = [1, 2, 3, 4] b = [1, 2, 3, 4] print (id(a), id(b)) print (a is b) 输出结果: 4446597320 4446597640 False 上边这种用法得到的结果很正常,再看下边代码: a = 1 b = 1 print (id(a), id(b)) print (a is b) 运行结果: 4325627840 4325627840 True 这种情况下,a和b指向的是同一个。这是由于Python内部机制决定的,将小正数建立一个全局唯一的对象,小段字符串也是一样的。 a = [1, 2, 3] b = [1, 2, 3] print(a==b) 返回True 因为: list里边实现了一个魔法函数 __eq__,当我们调用a==b这种模式的时候,会调用__eq__这个魔法函数,从而来判断值是否相等。 它们的值是相等的,只是不是同一个对象而已,所有a==b是True。 垃圾回收和del语句 cpython中垃圾回收的算法是采用 引用计数 a = 1 b = a 此时,1这个对象上就又有一个计数器,a = 1 时会在计数器上加1,b如果指向的还是1,1上边的计数器会再加1,当不使用时,执行del a,他就会将引用计数器减1,当引用计数器减到0时,python解释器会将对象回收。 对象只有在计数器减到0时,才会被回收,del只是减计数器的功能。 a = object() b = a del a print(b) print(a) 打印结果: <object object at 0x104a86100> NameError: name 'a' is not defined 可以看到,执行del后,只是把a销毁了,b还在。 __del__魔法函数: 可以在__del__魔法函数中实现自己的逻辑,当python解释器回收对象的时候,会调用对象的__del__魔法函数,它可以帮我们在回收对象时做一些事。 @property的用法 我们在读源码时,往往会看到这这种方法: @property def hello(self): pass @property 这个装饰器会把函数变为属性描述符,怎么说? 看代码: class Allen(object): def word(self): return 'word' @property def hello(self): return 'hello' a = Allen() print(a.hello) print(a.word()) 运行结果: hello word 可以发现,@property这个装饰器把取方法的模式变为取属性。 魔法函数__getattr__、__getattribute__介绍 魔法函数是python解释器内部需要用的方法,它是整个python动态特性的最根本原因。 __getattr__:就是在查找不到属性的时候调用。 例1: class User: def __init__(self, info): self.info = info def __getattr__(self, item): return '2' if __name__ == "__main__": user = User('allen') print(user.info) print(user.age) 运行结果: allen 2 例2: class User: def __init__(self, info={}): self.info = info def __getattr__(self, item): return self.info[item] if __name__ == "__main__": user = User(info={"name": "allen", "age": "3"}) print(user.name) 打印结果: allen __getattribute__ : 比__getattr__更高级,只要查找属性,就会首先进入__getattribute__这个魔法函数,强制进入,无条件的。 __getattribute__这个魔法函数尽量不要去重写,因为如果一旦写不好,整个类的属性访问就会崩溃掉,一般写框架时会用到这个魔法函数。 class User: def __init__(self,info={}): self.info = info def __getattr__(self, item): return self.info[item] def __getattribute__(self, item): return "10" if __name__ == "__main__": user = User(info={"name":"allen"}) print(user.name) print(user.test) 打印结果: 10 10 属性描述符和属性查找过程 一个类只需要实现__get__、__set__、__delete__这三个中的任意一个方法,它就算是属性描述符。 通过属性描述符,可以控制在赋值的时候它的行为,在属性设置的时候参数检查。 属性描述符有两种: 数据属性描述符:实现__get__ 和 __set__就是数据属性描述符。 非数据属性描述符:只实现一个__get__方法就是非数据属性描述符。 数据属性描述符 和 非数据属性描述符 它们的属性查找过程是不一样的。 前边提到的属性查找过程,先查找实例中的属性,然后查找类中的属性,实际上它有更加详细的查找过程。 魔法函数__new__ 和 __init__ 区别 __new__ 魔法函数在python新式类才会有 python2.2之前没有这个。 class User: def __new__(cls, *args, **kwargs): print(" in new ") return super().__new__(cls) def __init__(self): print(" in init") pass if __name__ == "__main__": user = User() 打印结果: in new in init __new__魔法函数允许在生成对象之前加逻辑,自定义对象生成过程,传递进来的是类。 __init__方法传递进去的是对象。 __new__ 在 __init__ 之前调用。 __new__中必须return super().__new__(cls)才会调用__init__方法。 def __new__(cls, *args, **kwargs):这个中的*args,和**kwargs,代表的是传入的参数。

优秀的个人博客,低调大师

Python高级知识点学习(二)

深入类和对象 鸭子类型问:什么是鸭子类型?答:当看到一只鸟走起路来像鸭子,游泳像鸭子,叫起来也像鸭子,那么这只鸟就可以被看做鸭子。(所有的类或对象,都实现了共同的方法,方法名要一样,这样的话这些类就归为一种类型,在调用时同时调用同样的方法) 在java中,要实现多态,所有子类必须继承父类并重写父类的方法;在python中,python中对象和java不同,变量是动态的可以指向任何一个类型。 class Cat(): def say(): pass class Dog(): def say(): pass class Duck(): def say(): pass 三个类共同实现同一个方法且方法名相同,就实现了多态。Python多态比Java简单正是因为python是动态语言。 抽象基类abc模块 何为抽象基类?继续用java做比较,Python这里抽象基类可以当做java中的接口,java中是无法实现多继承的,java只能继承一个类,但是可以继承多个接口,接口是不能用来实例化的;所以Python里边抽象基类也是不能实例化的。 python是动态语言,动态语言是没有变量类型的,Python中变量只是个符号而已,它可以指向任何类型的对象。 所以在Python中也就不存在多态这种概念,我们可以赋值任何类型数据给Python中的变量,而且它是可以修改的,所以说它就不需要像java中一样去实现多态,因为本身从语言层面讲就是支持多态的语言。 动态语言和静态语言非常大的区别之一就是静态语言不需要我们指明变量类型,所以动态语言中也就少了编译时检查错误的环节,python中写错了代码只能在运行中发现错误。 不同魔法函数就赋予了类不同特性,和java非常大的区别就是不需要去继承某一个指定的类。 鸭子类型和魔法函数构成了Python语言的基础,也就是Python中的协议。我们只需要去实现指定的魔法函数,类就可以是某种类型的对象,不同魔法函数具有的特性不同,这种使用魔法函数事先约定好的做法我们都可以称之为一种协议。 抽象基类用途: 我们在某些情况之下希望判定某个对象的类型 我们需要强制某个子类必须实现某些方法 抽象基类用法: 在基础类中,我们去设定好一些方法,所有继承这个基类的类都必须覆盖抽象基类的方法, 抽象基类是无法实例化的 所有的抽象基类继承的必须是metaclass=ABCMeta 在做框架编程时,往往我们需要使用框架者在使用类时必须实现类中的一些方法,这时候可以使用抽象基类,举了例子: class CacheBase(metaclass=abc.ABCMeta): @abc.abstractmethod def get(self, key): pass @abc.abstractmethod def set(self, key, value): pass class RedisCache(CacheBase): pass redis_cache = RedisCache() 运行结果:TypeError: Can't instantiate abstract class RedisCache with abstract methods get, set在实例化RedisCache()这个时,就开始报错了,错误提示让我们必须实现get set方法。 补全这两个方法后运行就不报错了 class RedisCache(CacheBase): def set(self, key, value): pass def get(self, key): pass redis_cache = RedisCache() type和isinstance区别 尽量使用isinstance判断类型,避免使用type产生误差is 和 == 符号 区别: is用法判断id是否相同 ==用法判断值是否相等 类变量和实例变量(对象变量) 先看代码: class A: # 类变量 aa = 1 def __init__(self, x, y): # self是类的实例 # 实例变量 self.x = x self.y = y # 上边赋值后 x y 都属于实例了 不再属于类了 a是实例 A是类 aa是类变量 类变量在所有实例中是共享的 a = A(2, 3) A.aa = 11 a.aa = 100 # a实例新建一个属性 把aa放到a实例中 a.aa和A.aa是独立的 print(a.x, a.y, a.aa) print(A.aa) b = A(3, 5) print(b.aa) 运行结果: 2 3 100 11 11 解释代码: 新建了一个名为A的类,类中新建类属性aa = 1类中新建构造函数,绑定两个变量x y。 属性查找方式,向上查找,首先查找对象里有没有,再查找类中有没有类变量和实例变量是独立的存在 类变量在所有实例中是共享的 a.aa = 100:a实例新建一个属性 把aa放到a实例中 a.aa和A.aa是独立的。 建议以上代码反复测试加以记忆。

优秀的个人博客,低调大师

JavaScript—Ajax基础知识梳理(29)

Ajax用一句话来说就是无须刷新页面即可从服务器取得数据。注意,虽然Ajax翻译过来叫异步JavaScript与XML,但是获得的数据不一定是XML数据,现在服务器端返回的都是JSON格式的文件。 完整的Ajax请求过程完整的Ajax请求过程 1.创建XMLHttpRequest实例2.发出HTTP请求 3.接收服务器传回的数据4.更新网页数据 下面先看一个红宝书上给出的发起Ajax请求的例子,API的用法在后面章节给出。 var xhr = new XMLHttpRequest(); // 创建XMLHttpRequest实例 xhr.onreadystatechange = function(){ if (xhr.readyState == 4){ // 判断请求响应过程阶段,4 阶段代表已接收到数据 if (xhr.status >=200 && xhr.status < 300 || xhr.status == 304) { // 校验HTTP状态码 console.log(xhr.responseText); // 输出响应的文本 } else { console.error(xhr.status, xhr.statusText); // 打印其他HTTP状态码 } } }; xhr.open('get', 'example.txt', true); // 初始化xhr实例,或者说启动请求 xhr.send(null); // 设置HTTP请求携带参数,null为不带参数 Ajax请求过程详解 创建XMLHttpRequest实例从上面的的代码可以看出,创建一个XHR实例方式为: var xhr = new XMLHttpRequest(); 发出HTTP请求实例创建好后,首先需要启动一个HTTP请求,使用XHR的open()方法,open方法接受三个参数 XMLHttpRequest.open(method, url, isAsync) // 例如 xhr.open('get', 'http://www.baidu.com', true) 第一个参数为http请求使用方法,如('get','post'等),第二是参数是请求的url, 第三个参数代表是否异步发送请求(可选)。调用open()方法后会启动一个http请求,但它不会立即发送请求,处于待命状态。需要注意的是:请求的url必须要跟请求源域(origin)同域,也就是说协议、域名、端口号要一致,跨域请求要使用别的方法。接着调用send()方法就会发出这个http请求。 xhr.open('get', 'http://www.baidu.com', true) xhr.send(null) send()方法接受一个参数,为http请求发送的数据(通常用于'post'方法),如果为null,表示不发送数据。至此,一个异步的http请求就发送到了服务器。 接收服务器传回的数据3.1 发送同步请求 如果将open方法的第三个参数设为false,即为同步请求,当收到服务器的响应后,相应的数据会自动填充到XHR对象的属性中,主要包括以下四个: responseText:作为响应主体被返回的文本。 responseXML: 响应返回的XML文档,能接收到的前提是,响应的Content-Type字段的值为text/xml或者application/xml。 status: HTTP状态码。 statusText: HTTP状态码说明。 当客户端收到以上信息后,首先要判断HTTP状态码来确认响应是否成功,状态码在200-300之间表示请求成功,同时304代表请求资源未被修改,可使用浏览器本地缓存。如果成功就可以获取响应报文主体中的数据了。 xhr.open('get', 'http://www.baidu.com', false) xhr.send(null) if (xhr.status >=200 && xhr.status < 300 || xhr.status == 304) { // 校验HTTP状态码 console.log(xhr.responseText); // 输出响应的文本 } else { console.error(xhr.status, xhr.statusText); // 打印其他HTTP状态码 } 3.2 发送异步请求如果将open方法的第三个参数设为true,即为异步请求。那么就需要一个事件来通知程序异步请求的结果是否返回。XHR对象中的readyState属性,表示请求/响应整个过程所处的阶段,它有五个值分为对应五个阶段: 0:未初始化。未调用open()方法。1:启动。已经调用open()方法,但未调用send()方法。2:发送。已调用send()方法,但未收到响应。3: 接收。已经接收到部分响应数据。4:完成。已经接受到全部响应数据。 readyState的值每变化一次,都会触发一次readStatechange事件,我们定义一个事件处理函数onreadStatechange(),并监听readyState == 4状态,就可以得知响应数据已全部收到,并进行下一步操作。那么就是文章开头给出的代码: var xhr = new XMLHttpRequest(); // 创建XMLHttpRequest实例 xhr.onreadystatechange = function(){ if (xhr.readyState == 4){ // 判断请求响应过程阶段,4 阶段代表已接收到数据 if (xhr.status >=200 && xhr.status < 300 || xhr.status == 304) { // 校验HTTP状态码 console.log(xhr.responseText); // 输出响应的文本 } else { console.error(xhr.status, xhr.statusText); // 打印其他HTTP状态码 } } }; xhr.open('get', 'example.txt', true); // 初始化xhr实例,或者说启动请求 xhr.send(null); // 设置HTTP请求携带参数,null为不带参数 补充XHR中三个有用的事件 timeout事件当超出了设置时间还未收到响应,就会触发timeout事件,进而调用ontimeout事件处理程序。同时timeout也是XHR的一个属性,用于设置这个时间阈值。下面是用法: xhr.ontimeout = function() { alert('timeout!') } xhr.open('get', 'http://www.baidu.com', true) xhr.timeout = 1000 // 时间阈值设为1秒 xhr.send(null) load事件 load事件用于简化对readState值的判断,响应数据全部接收完毕后(也就是readState == 4)会触发load事件,使用onload事件处理函数进行后续操作,onload会接收一个event对象,它的target属性等于XHR对象,当然我们在定义这个事件处理函数时也可以不传入这个参数,来看下面的用法: var xhr = new XMLHttpRequest() xhr.onload = function () { if(xhr.status >=200 && xhr.status < 300 || xhr.status == 304) { console.log(xhr.responseText); // 输出响应的文本 } else { console.error(xhr.status, xhr.statusText); // 打印其他HTTP状态码 } } xhr.open('get', 'http://www.baidu.com', true) xhr.send(null) 这样就不用去关心readyState值的变化情况了。当然如果想在特定readyState值上做一些逻辑处理,还是要用之前的方法。 progress事件这个是很有用的一个事件,progress事件会在浏览器接收数据期间周期触发,代表整个请求过程的进度,它的事件处理程序onprogress接收一个event对象,event.target是XHR对象,另外event还有三个属性: lengthComputable:Boolean值,进度信息是否可用。position:已经接收到的字节数。totalSize:总共要接收的字节数,被定义在响应报文的Content-Length字段中。 如果响应报文中有Content-Length字段,那么我们就可以计算当前时刻响应数据的加载进度了,这也是之前看到的一个面试题。看下面的代码: xhr.onprogress = function(event) { if(event.lengthComputable) { console.log(`Received: ${(event.position/event.totalSize).toFixed(4)*100}%`); } } 其他还有很多有用的API,如FormData表单序列化,overrideMimeType()重写XHR响应的MIME类型等等

优秀的个人博客,低调大师

Python Flask学习知识点(七)

timg (11).jpg 静态文件访问原理 app文件夹下新建文件夹static,放入一张图片demo.jpg,然后访问服务器启动默认地址127.0.0.1:81/static/demo.jpg就可以访问到这张图片。 问:为什么Flask可以在任何代码不编写的情况下自动读取到static目录下的图片文件? 答:因为Flask对于静态文件是有默认值设置的,默认情况下,Flask认为静态文件夹的名字就叫ststic,并且位于应用程序的根目录下的,也就是app文件夹目录下。 image.png 问:为什么应用程序根目录是app目录而不是app上边的flaskDemo目录? 答:因为在实例化Flask核心对象是传入了一个参数,如下代码: def create_app(): app = Flask(__name__) app.config.from_object('app.secure') app.config.from_object('app.setting') register_blueprint(app) db.init_app(app) db.create_all(app=app) return app __name__这个参数决定了我们应用程序的根目录是app目录。 如果不想使用默认的static作为静态文件存储路径,可以通过更改配置来访问, app = Flask(__name__, static_folder='web/img') 更改成为这个路径,就要这样访问:127.0.0.1:81/img/demo.jpg, 还可以这么改: app = Flask(__name__, static_folder='web/img', static_path='') 但是我们一般还是使用Flask默认设置即可,如果确实有需求,具体使用详情请查阅官方文档。 静态文件放到蓝图中 之前说过,Flask里有两个层级: Flask核心对象:应用程序级别 蓝图 对于静态文件,也有两个级别: 应用程序static 蓝图static 如果你认为你的静态文件是针对你的蓝图的话,那么你其实是可以把静态文件注册到蓝图上边,而不是注册到应用程序上边。 image.png 蓝图的相关方法其实几乎就是复制了Flask核心对象的api,基本参数都是一致的。 蓝图注册静态文件夹: from flask import Blueprint # 蓝图 web = Blueprint("web", __name__, static_folder='', static_url_path='') 模板文件 模板就是html,但是和普通html不同,模板是没有数据的,它等待填充数据。 app文件夹下新建文件夹templates,新建html文件:test.html: image.png 同上边提到的static文件夹一样,我们可以自定义templates文件夹的位置,通过更改template_folder=参数来自定义templates文件夹的位置,例如,把templates文件夹移动到web文件夹下后需改动: 两种更改方法: Flask核心对象上更改:app = Flask(__name__, template_folder='web/templates') 在蓝图对象上更改:web = Blueprint("web", __name__, template_folder='templates') 现在要把视图函数中返回的数据填充到模板test.html中,使用Flask内置的方法:render_template() from flask import render_template @web.route('/test') def test(): r = { "name": "allen", 'age': 24 } r1 = { "name": "zhao", "age": 12 } return render_template('test.html', data=r, data1=r1) 模板语言 Jinja2 如何在模板中组织、解析相关数据 编辑test.html: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <h1>demo</h1> {{data.age}} {{data1.age}} </body> </html> 运行代码,浏览器输入127.0.0.1:8000/test image.png 可以看到,之前我们写在视图函数中的数据已经展示到页面了。 Flask为了让我们很好的在模板解析和展示数据,它引入了一个模板引擎,叫做Jinja2。 Jinja2有自己的语法,例如注释代码:{#hello word#},这里就把hello word注释掉了。 我们的pycharm默认是不会像写python代码一样智能提示Jinja2的语法,但是,更改设置即可: image.png Jinja2也叫做模板语言, Flask官方推荐我们使用Jinja2,大家也可以自己使用其他的模板语言。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册